

Nền tảng LangGraph
Hãy bắt đầu bằng cách thảo luận về các khối xây dựng cơ bản của LangGraph. Những yếu tố này cho phép chúng ta tạo các quy trình có cấu trúc, có trạng thái và có thể mở rộng để xây dựng các tác nhân AI tiên tiến.
State
State là một đối tượng bộ nhớ dùng chung chảy xuyên suốt đồ thị. Nó lưu trữ mọi thông tin liên quan như thông điệp, biến, kết quả trung gian và lịch sử quyết định. LangGraph quản lý state tự động, giúp việc phát triển hiệu quả hơn.
Bổ trợ cho State là các tính năng nâng cao như checkpointing, bộ nhớ theo luồng (thread-local) và lưu bền qua phiên. Trong suốt quá trình thực thi, state được cập nhật liên tục, như minh họa trong sơ đồ dưới đây: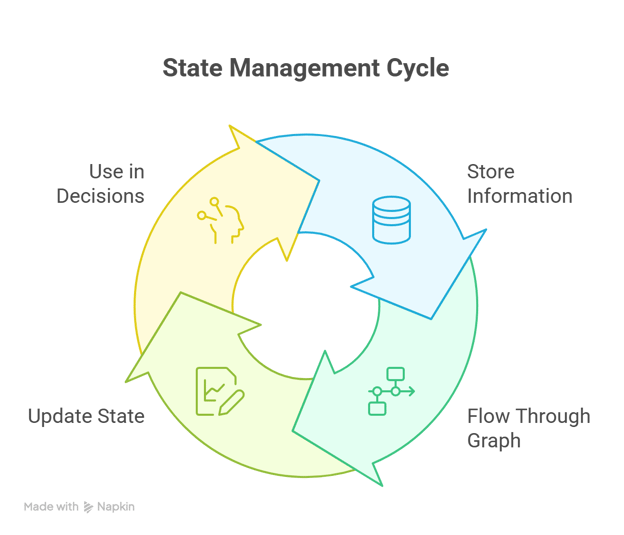
Chu trình quản lý State trong LangGraph thể hiện việc cập nhật liên tục giữa các node
Node
Một node là một đơn vị chức năng đơn lẻ trong quy trình. Nó có thể thực hiện nhiều hành động, chẳng hạn:
- Gọi một mô hình ngôn ngữ lớn (LLM)
- Gọi một công cụ hoặc API
- Chạy một hàm Python tùy chỉnh
- Điều phối logic hoặc quyết định phân nhánh
Mỗi node nhận state hiện tại và trả về state đã cập nhật.
Edges và conditional edges
Edges xác định các chuyển tiếp giữa các node. Chúng quyết định luồng điều khiển của đồ thị và có thể hỗ trợ:
- Kết nối tĩnh (cho tiến trình tuyến tính)
- Đường đi chu kỳ (cho hành vi lặp)
- Phân nhánh động (dựa trên điều kiện của state - tạo qua Conditional Edges)
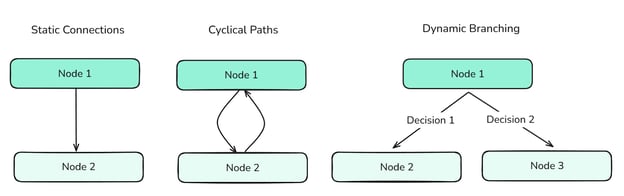
Các loại Edge khác nhau xác định luồng giữa các node và kiểm soát thông tin trong đồ thị.
Edges là chìa khóa để điều phối hành vi tác nhân phức tạp.
Graph và stategraph
Một đồ thị trong LangGraph xác định cấu trúc của quy trình tác nhân, gồm các node được kết nối bởi các edge.
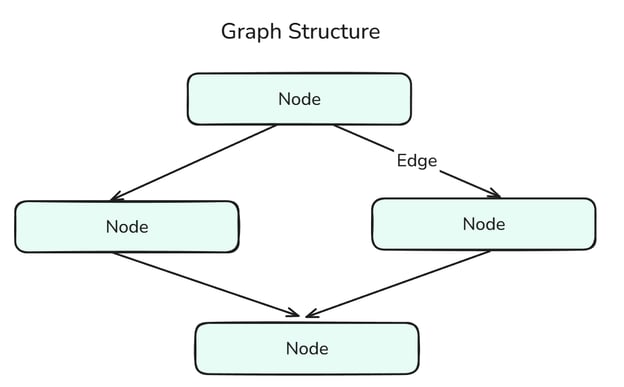
Cấu trúc Graph là sự kết hợp giữa Node và Edge.
StateGraph là một đồ thị chuyên biệt duy trì và cập nhật state dùng chung trong suốt quá trình thực thi. Nó cho phép ra quyết định theo ngữ cảnh và bộ nhớ bền qua các bước. Có thể coi đây là sự kết hợp của State và Graph.
Tool và toolnode
Một tool là bất kỳ hàm bên ngoài hoặc nội bộ nào mà tác nhân có thể gọi, như tìm kiếm web, máy tính hoặc tiện ích tùy chỉnh. Có hai loại Tool:
- Tool dựng sẵn: Các công cụ được LangChain chuẩn bị sẵn và có thể sử dụng ngay, có thể truy cập trong Tài liệu.
- Tool tùy chỉnh: Công cụ do chúng ta tự tạo và dùng trong ứng dụng (thực hiện qua gán decorator và DocString — sẽ minh họa trong mã sau).
ToolNode là một loại node chuyên dụng để thực thi tool trong đồ thị. Nó cho phép nhà phát triển tích hợp tool mà không cần viết logic bọc bổ sung. Có thể coi đây là sự kết hợp của Tool và Node.
Các loại message
Messages là các phần tử dữ liệu có cấu trúc (như đầu vào của người dùng, đầu ra của hệ thống, phản hồi trung gian, v.v.) di chuyển trong đồ thị và được lưu trong state. Chúng cho phép truy vết, ghi nhớ và cung cấp ngữ cảnh cho quyết định của tác nhân, giúp đưa ra quyết định có cơ sở hơn.
Có nhiều loại Message trong LangGraph:
- HumanMessage: Đại diện cho đầu vào từ người dùng. Đây là loại message phổ biến nhất để bắt đầu hoặc tiếp tục cuộc hội thoại trong đồ thị với tác nhân.
- AIMessage: Đại diện cho phản hồi do các mô hình ngôn ngữ nền tạo ra. Những phản hồi này được lưu để duy trì bộ nhớ hội thoại và thông tin cho các hành động sau.
- SystemMessage: Cung cấp ngữ cảnh hoặc hướng dẫn thiết lập hành vi cho LLM (ví dụ: “Bạn là trợ lý cá nhân của tôi.”). Thông điệp này ảnh hưởng cách mô hình phản hồi.
- ToolMessage: Đóng gói đầu ra từ một tool. Điều này rất quan trọng khi tác nhân phụ thuộc vào thao tác bên ngoài (như tính toán hoặc tìm kiếm) để quyết định bước tiếp theo.
- RemoveMessage: Dùng để xóa hoặc hoàn tác theo lập trình các message đã thêm trước đó khỏi state. Hữu ích cho sửa lỗi hoặc cắt tỉa ngữ cảnh không liên quan.
- BaseMessage: Lớp cha chính cho mọi loại message trong LangChain và LangGraph. Mỗi loại cụ thể — như
HumanMessage,AIMessagehoặcSystemMessage— đều kế thừa từBaseMessage.
Tác nhân LangGraph
Giờ chúng ta sẽ viết mã cho các tác nhân này trong LangGraph, tập trung vào việc hiểu các phương thức và bước liên quan khi lập trình cũng như trực quan hóa các tác nhân.
Quy trình một tác nhân
Hãy bắt đầu bằng cách tạo một tác nhân đơn không có tool hay bộ nhớ. Trước hết là các import:
from typing import TypedDict, List
from langchain_core.messages import HumanMessage
from langchain_openai import ChatOpenAI
from langgraph.graph import StateGraph, START, END
from dotenv import load_dotenvDòng đầu tiên đề cập đến TypedDict, là một chú thích kiểu (type annotation) được định nghĩa như sau trong Python:
from typing import TypedDict
class Student(TypedDict):
name: str
grade: float
s1: Student = {"name": "Sam", "grade": 92.5}Về bản chất, TypedDict là một dictionary có biện pháp an toàn kiểu mạnh mẽ, rất quan trọng cho phát triển tác nhân AI.
HumanMessage chắc hẳn giờ đã quen thuộc với bạn, vì chúng ta đã thảo luận trước đó.
ChatOpenAI thì mới. Hãy rẽ nhẹ để giải thích điều này.
Thông qua LangChain, chúng ta có thể dùng họ Chat, về cơ bản cho phép sử dụng mô hình từ nhiều nhà cung cấp LLM khác nhau, như OpenAI, Anthropic, Ollama, v.v. thông qua các thư viện tương ứng như ChatOpenAI, ChatAnthropic, ChatOllama, v.v.
Về cơ bản, tham số và cách dùng của chúng tương tự nhau, cho phép mã của chúng ta có tính mô-đun. Các bước chi tiết hơn có thể tìm thấy trong Tài liệu LangChain.
Cuối cùng, StateGraph chúng ta đã đề cập trước đó, còn Start và End là điểm bắt đầu và kết thúc của đồ thị.
Hãy tiếp tục:
load_dotenv() # Obtaining over secret keys
# Creation of the state using a Typed Dictionary
class AgentState(TypedDict):
messages: List[HumanMessage] # We are going to be storing Human Messages (the user input) as a list of messages
llm = ChatOpenAI(model="gpt-4o") # Our model choice
# This is an action - the underlying function of our node
def process(state: AgentState) -> AgentState:
response = llm.invoke(state["messages"])
print(f"\nAI: {response.content}")
return state
graph = StateGraph(AgentState) # Initialization of a Graph
graph.add_node("process_node", process) # Adding nodes
graph.add_edge(START, "process_node") # Adding edges
graph.add_edge("process_node", END)
agent = graph.compile() # Compiling the graphHãy bàn kỹ hơn về phương thức .add_node() và .add_edge().
add.node(): Có hai tham số chính cần chú ý; tên node và hành động nền tảng. Hành động nền tảng, trong trường hợp của chúng ta —process()— là logic chính của node, tức là các hành động được thực hiện khi đến giai đoạn này. Tên node có thể là bất kỳ tên gì, thậm chí trùng với tên hàm, dù việc đó có thể khá rối khi gỡ lỗi!add_edge.(): Cũng có hai tham số chính cần chú ý, đó là node bắt đầu và node kết thúc của Edge. Lưu ý là nhập tên node, không phải hành động nền tảng.
Xem một ví dụ thực tế:
user_input = input("Enter: ")
while user_input != "exit":
agent.invoke({"messages": [HumanMessage(content=user_input)]})
user_input = input("Enter: ")Đoạn mã trên cho phép chúng ta gọi tác nhân nhiều lần. Về trực quan, tác nhân AI mà chúng ta vừa xây dựng trông như sau:
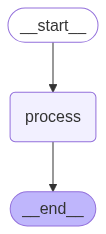
Tác nhân tuần tự hoàn thành tác vụ từng bước theo thứ tự xác định trước, không phân nhánh hay suy luận.
Để có được trực quan hóa như vậy, ta có thể dùng đoạn mã sau (Lưu ý: dùng đồ thị đã biên dịch):
from IPython.display import Image, display
display(Image(agent.get_graph().draw_mermaid_png()))Tác nhân ReAct
Tác nhân ReAct (Reasoning and Acting) cực kỳ phổ biến trong ngành, nhờ dễ tạo nhưng vẫn vững chắc. Vì quá phổ biến, LangGraph có sẵn phương thức dựng sẵn để chúng ta tạo các tác nhân như vậy.
May mắn là chúng ta chỉ cần thêm hai import:
from langgraph.prebuilt import create_react_agent
from langchain_google_community import GmailToolkitPhương thức create_react_agent sẽ tạo tác nhân ReAct cho chúng ta.
tools = [GmailToolkit()] # We are using the Inbuilt Gmail tool
llm = ChatOllama(model="qwen2.5:latest") # Leveraging Ollama Models
agent = create_react_agent(
model = llm, # Choice of the LLM
tools = tools, # Tools we want our LLM to have
name = "email_agent", # Name of our agent
prompt = "You are my AI assistant that has access to certain tools. Use the tools to help me with my tasks.", # System Prompt
)Điều hay nhất là chúng ta có thể tạo nhiều tác nhân và kiến trúc phức tạp hơn.
Chúng ta cũng có thể tạo tool tùy chỉnh của riêng mình.
@tool
def send_email(email_address: str, email_content: str) -> str:
"""
Sends an email to a specified recipient with the given content.
Args:
email_address (str): The recipient's email address (e.g., '[email protected]')
email_content (str): The body of the email message to be sent
Returns:
str: A confirmation message indicating success or failure
Example:
>>> send_email('[email protected]', 'Hello John, just checking in!')
'Email successfully sent to [email protected]'
"""
# Tool Logic goes here
return "Done!"Như đã nêu, có hai điểm chính quan trọng khi tạo tool tùy chỉnh:
- Decorator: Điều này cho LangGraph biết hàm này là một hàm chuyên biệt — một tool.
- Docstring: Cần có để cung cấp cho LLM ngữ cảnh về chức năng của tool. Nên đưa ví dụ và mô tả tham số để việc gọi tool vững chắc hơn.
Tác nhân ReAct trông như sau:
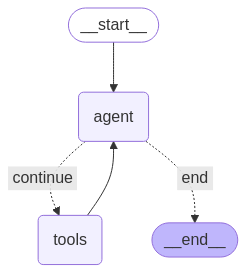
Tác nhân ReAct luân phiên giữa suy luận (ý nghĩ) và hành động để giải quyết nhiệm vụ từng bước.
Hàm reducer cho tăng trưởng state
Khi định nghĩa State cho các hệ thống tác nhân phức tạp, vững chắc hơn, nên dùng Hàm Reducer hay đơn giản là reducers. reducers là các chú thích dữ liệu đảm bảo mỗi lần một node trả về một message, message đó sẽ được nối vào danh sách hiện có trong state, thay vì ghi đè giá trị trước. Điều này cho phép state tích lũy ngữ cảnh.
# State with reducer function
class AgentState(TypedDict):
messages: Annotated[list[BaseMessage], operator.add]Đoạn mã này tích hợp hàm reducer operator.add với state, đảm bảo tất cả message được giữ lại.
Quản lý bộ nhớ trong LangGraph
Trong phần này, chúng ta tập trung vào một thành phần cốt lõi của mọi tác nhân — Bộ nhớ. Bộ nhớ cực kỳ quan trọng vì cung cấp ngữ cảnh cần thiết để tác nhân vững chắc và đáng tin cậy hơn. Hãy khám phá các cách quản lý bộ nhớ trong tác nhân.
Kho checkpoint bên ngoài
State là yếu tố quan trọng nhất trong LangGraph, và tự nhiên có nhiều cách để lưu state ra bên ngoài. Một số lưu trữ phổ biến:
- SQLite
- PostgreSQL
- Amazon S3
- Azure Blob Storage
- Google Cloud Storage
- Mem0
Tất cả các thư viện này có thể tìm thấy trong tài liệu.
Hiện tại, chúng ta sẽ xem SQLite:
from langgraph.checkpoint.sqlite import SqliteSaver
memory = SqliteSaver.from_conn_string(":memory:") # This is for connecting to the SQLite database
graph = graph_builder.compile(checkpointer=memory) # Compiling graph with checkpointer as SQLite backendSử dụng SQLite là cách dễ để bổ sung Tính bền (Persistence) cho tác nhân. Tính bền là khả năng duy trì ngữ cảnh qua các tương tác khác nhau.
Tất cả những điều này nhằm lưu và cập nhật state. Giờ hãy xem cách sử dụng và quản lý state hiệu quả, đặc biệt là danh sách messages vốn sẽ rất lớn khi cuộc trò chuyện tiếp diễn.
LangGraph hỗ trợ gốc cho bộ nhớ ngắn hạn và dài hạn. Cùng khám phá.
Bộ nhớ ngắn hạn
Bộ nhớ ngắn hạn cho phép tác nhân nhớ lịch sử message trong một phiên, hữu ích cho hội thoại nhiều lượt.
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
# Invoking the Graph with our message
agent_graph.invoke(
{"messages": [{"role": "user", "content": "What's the weather today?"}]},
{"configurable": {"thread_id": "session_42"}},
)Trong ví dụ trên, thread_id được dùng để định danh duy nhất một cuộc hội thoại hay phiên.
Bộ nhớ dài hạn
Bộ nhớ dài hạn tồn tại qua nhiều phiên và rất phù hợp để ghi nhớ những thứ như tên, mục tiêu hoặc thiết lập — các thông tin quan trọng cần dùng xuyên suốt các phiên.
from langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
long_term_store = InMemoryStore()
builder = StateGraph(...)
agent = builder.compile(store=long_term_store)Tuy nhiên, vì cuộc trò chuyện có thể dài, chúng ta cần cách giới hạn lịch sử message. Đây là lúc cần trimming.
Trimming
Trong ví dụ dưới đây, chúng ta xóa token từ đầu lịch sử message (do dòng: strategy="first") để sau khi cắt tỉa, còn tối đa 150 token.
from langchain_core.messages.utils import trim_messages, count_tokens_approximately
trimmed = trim_messages(
messages=state["messages"],
strategy="first", # remove the messages from beginning
token_counter=count_tokens_approximately,
max_tokens=150
)Cắt tỉa dựa trên tóm tắt
Một cách khác để giảm lịch sử message là tóm tắt. Cách này cho phép bảo tồn thông tin quan trọng trong suốt lịch sử, thay vì chỉ cắt token từ một phần hội thoại.
from langmem.short_term import SummarizationNode
from langchain_core.messages.utils import count_tokens_approximately
summary_node = SummarizationNode(
model=summary_llm, # Our summarization LLM
max_tokens=300, # Total token limit
max_tokens_before_summary=150, # when to start summarizing
max_summary_tokens=150, # summary size
token_counter=count_tokens_approximately
)Lưu ý quan trọng: việc tóm tắt do một LLM nền thực hiện, ở đây là summary_llm, có thể là bất kỳ LLM nào.
Xóa có chọn lọc
Thao tác chính cuối cùng trong Quản lý bộ nhớ là Xóa. Để xóa các message được chọn, ta dùng đoạn mã sau:
from langchain_core.messages import RemoveMessage
def clean_state(state):
# Remove all tool-related messages
to_remove = [RemoveMessage(id=msg.id) for msg in state["messages"] if msg.role == "tool"]
return {"messages": to_remove}Trong đoạn mã trên, chúng ta đã xóa toàn bộ message liên quan đến tool, vốn có thể dư thừa (vì trên thực tế, Tool-Message là để LLM tạo câu trả lời sau khi dùng tool).
Tuy nhiên, nếu muốn xóa toàn bộ lịch sử message, chúng ta có thể làm như sau:
from langgraph.graph.message import REMOVE_ALL_MESSAGES
from langchain_core.messages import RemoveMessage
def reset_history(state):
# Remove entire conversation history
return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}Kết luận
Tổng thể, LangGraph là một thư viện mạnh mẽ cung cấp cách tiếp cận có cấu trúc và có thể mở rộng để xây dựng hệ thống tác nhân. Mô hình hóa logic như một đồ thị gồm các node và edge, với state dùng chung và bộ nhớ bền, cho phép chúng ta phát triển các tác nhân vững chắc có thể suy luận, tương tác và thích nghi theo thời gian.
Khi hệ thống ngày càng phức tạp, framework này cung cấp các công cụ cần thiết để quản lý bộ nhớ, phối hợp sử dụng tool và duy trì ngữ cảnh dài hạn — đồng thời vẫn giữ tính mô-đun và khả năng mở rộng.
Với các thành phần cốt lõi đã sẵn sàng, bạn có thể thiết kế và triển khai các tác nhân AI vững chắc, có khả năng xử lý quy trình làm việc thực tế.
Để tiếp tục học, hãy xem khóa học Xây dựng Hệ thống Đa Tác nhân với LangGraph của chúng tôi. Bạn cũng có thể xem khóa học Thiết kế Hệ thống Tác nhân với LangChain và hướng dẫn về Agentic RAG của chúng tôi.
Câu hỏi thường gặp về tác nhân LangGraph
LangGraph chính xác là gì?
Một framework Python mô hình hóa logic của tác nhân AI như một đồ thị gồm các node và edge, cho phép suy luận, gọi công cụ và ghi nhớ.
Vì sao tôi nên chọn LangGraph thay vì các thư viện tác nhân khác?
LangGraph dùng cấu trúc Graph để định nghĩa logic, là điểm khác biệt chính mà các framework tác nhân phổ biến khác không dùng. LangGraph cũng hỗ trợ gốc cho vòng lặp, phân nhánh, bộ nhớ, tính bền và quy trình đa tác nhân — khiến nó lý tưởng cho hệ thống tác nhân thực tế, có thể mở rộng.
LangGraph quản lý và lưu bền bộ nhớ thế nào?
Nó dùng state dùng chung có thể lưu ngắn hạn (trong bộ nhớ) hoặc dài hạn (SQLite, S3, v.v.), cho phép tác nhân ghi nhớ tương tác trước đó.
Tôi có thể dùng mô hình cục bộ không?
Chắc chắn rồi! LangGraph hỗ trợ gốc cho mô hình Ollama, mô hình HuggingFace, LlamaCpp, v.v.
Làm sao để giảm kích thước lịch sử message dài?
Dùng trim_messages để loại bỏ token cũ hoặc SummarizationNode để nén các message trước đó mà vẫn giữ ngữ cảnh quan trọng.


LangGraph là một framework dựa trên đồ thị để xây dựng các tác nhân AI có thể suy luận, lập kế hoạch và thực thi qua các bước liên kết với nhau. Điểm khác biệt là nó cho phép chúng ta tạo các quy trình làm việc dạng chu kỳ, phân nhánh một cách dễ dàng, nơi mỗi node có thể chạy một LLM, tool hoặc function — đồng thời tự động quản lý state.
Điều này khiến LangGraph lý tưởng để xây dựng các hệ thống đa tác nhân phức tạp, vững chắc, cần bộ nhớ, xử lý lỗi và ra quyết định theo thời gian thực.
Trong hướng dẫn này, tôi sẽ dẫn bạn qua các kiến thức nền tảng và tính năng nâng cao của LangGraph, từ việc hiểu các thành phần cốt lõi đến xây dựng tác nhân AI có trạng thái và được tăng cường công cụ. Nếu bạn quan tâm đến xây dựng hệ thống đa tác nhân với LangGraph, hãy xem khóa học thực hành của chúng tôi. Bạn cũng có thể xem video hướng dẫn về xây dựng tác nhân LangGraph bên dưới.