单个结果本身并不能说明太多问题。假设您抛一次硬币,结果是正面。这并不能证明什么——也许只是偶然。但如果您抛硬币 100 次,您会看到正反面大致各占一半。此时,平均值才开始有意义。
这正是大数定律的核心。您收集的数据越多,平均值就越准确。它能帮助您看清全局。
在本指南中,我们将讲解大数定律的含义、其在现实生活中的运作方式,以及为什么在理解模式或做出更优决策时它如此有用。
什么是大数定律?
大数定律是概率和统计中的一个原理,用来解释随着数据增多,平均值的行为。随着样本量增加,该样本的平均值(称为样本均值)会越来越接近整个总体的真实平均值(称为总体均值)。
在现实世界中,我们通常无法获取整个总体的数据。相反,我们会抽取样本,比如调查 1,000 名选民,而不是全部 3 亿人。大数定律让我们有信心认为,只要数据足够多,样本平均值就会接近真实值。
随着样本增大,随机波动开始相互抵消。离群值的影响减小,平均值变得更加稳定和可预测。
该定律主要有两个版本,它们对这种效应的保证程度不同:
弱大数定律(依概率收敛)
弱大数定律指出,随着样本量增加,样本均值很可能接近总体均值。您收集的数据越多,平均值长期偏离真实值的可能性就越小。
例如,您抛一枚公平硬币。随着抛掷次数增多,正反面出现的比例会越来越接近 50/50。它未必完全相等,但会非常接近,这就是弱大数定律所描述的。
强大数定律(几乎处处收敛)
强大数定律更进一步。它指出样本均值不仅会接近总体均值,而且几乎必然会在那附近稳定下来。
通俗地说:如果您无限次地抛掷一枚公平硬币,正反面比例不会只是接近 50/50;它会稳定在该比例附近。因此,该定律几乎完全保证了长期平均能反映真实情况,只有极少数例外。
现实中的运作示例
来看几个现实案例,以理解该定律如何发挥作用:
抛硬币或掷骰子
想象您掷一枚常规六面骰三次,可能得到 6、2 和 5。平均值为 4.3,高于期望值 3.5。但如果您掷 100 次、再掷 1,000 次,随着次数增加,平均值会越发接近 3.5。大数定律会随着时间推移抚平随机性。
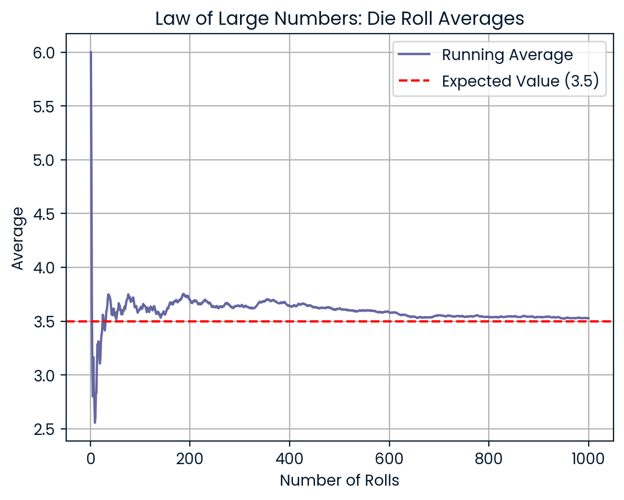
掷的次数越多,平均值越接近 3.5。图片来源:作者。
体育统计
运动员有时状态好、有时状态差。某个四分卫在一场比赛中 10 次传球命中 9 次,达到令人印象深刻的 90%。但这并不意味着他总能达到这个水平。
放到整个赛季来看,经过数百次传球,命中率会趋于平稳。赛季统计能更好地反映球员的真实水平。
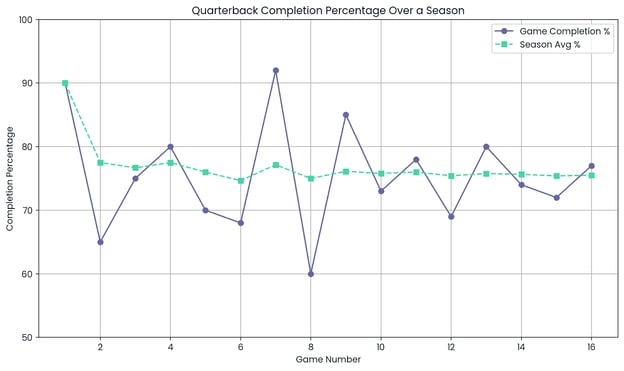
平均值。图片来源:作者。
保险业的风险共担
保险公司无法准确知道单个个体会带来多少成本。有些人几乎不使用医疗服务,而另一些人则会使用较多。
但当您观察一个大型人群时,这些起伏会相互抵消。通过将上千名投保人的风险进行池化,保险公司能更准确地预测平均成本。
这使他们能够在保持财务稳健的同时,设定公平的价格(保费)。
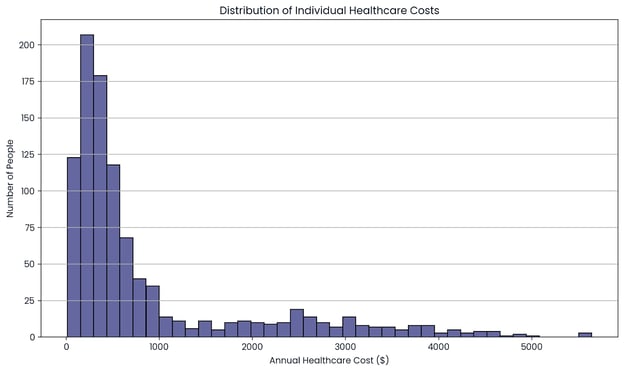
对许多人取平均能呈现真实成本。图片来源:作者。
赌场游戏与庄家优势
赌场在每款游戏中都设置了微小优势。打二十一点时,您可能连赢五局或连输十局。但在成千上万局之后,平均结果将偏向赌场。
例如,如果庄家优势为 0.5%,那么从长期来看,赌场预计平均每投注 100 美元可赚 50 美分。短时间内未必如此,但随着数百万次游戏的累积,结果会与预期高度一致。
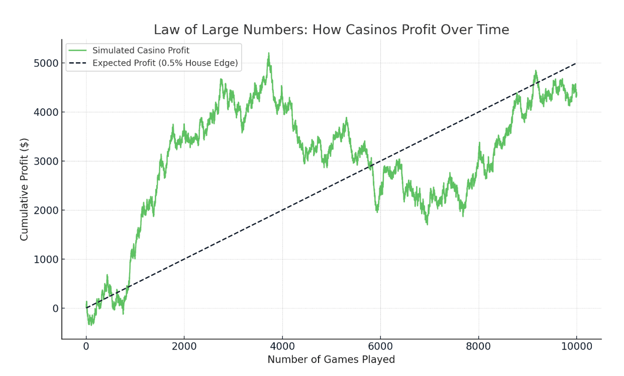
投注越多,赌场优势越能体现。图片来源:作者。
科技公司的 A/B 测试
假设一家公司想测试两种网站按钮:A 按钮和 B 按钮。各有 20 人试用后,A 按钮似乎更好。但这个数据量不足以让结果可信。
现在让 20,000 名用户看到两种按钮。随着样本量增加,平均点击率会更可靠,表现更好的按钮会更清晰地显现出来。
这就是为什么公司在 A/B 测试中依赖大样本。大数定律帮助他们避免伪阳性,做出更明智的选择。
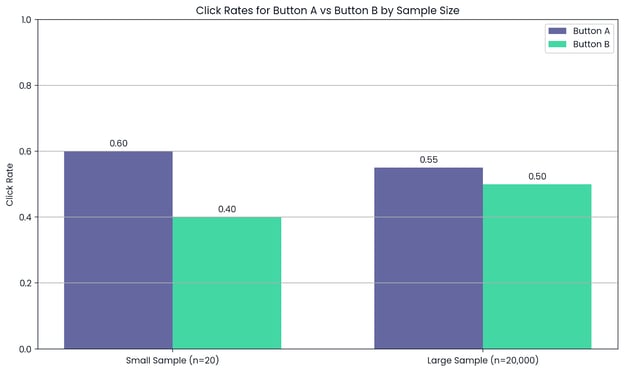
测试人数越多,结果越可靠。图片来源:作者。
为什么大数定律很重要
在数据科学中,我们经常用数据来训练模型。但如果数据集太小,少数异常值就可能扭曲结果。
例如,您仅用 10 位用户来测试一个新的推荐算法。如果一位用户什么都点,另一位什么都不点,您的平均表现可能看起来非常好或非常差。这并不意味着模型好坏,只是说明样本太小,不足以信任。
大数定律告诉我们,随着我们收集更多数据,随机波动会被抹平,平均结果会更可靠。这就是大型数据集能提供更好预测与洞见的原因。
您也会在模拟中见到这一点。以蒙特卡罗方法为例,这些方法通过使用随机输入,反复运行同一场景数千次。大数定律保证:我们运行的试验越多,平均结果就越接近真实的期望值。
在机器学习中,该定律主要体现在两个方面:
- 模型训练:在一个小而不均衡的数据集上训练的模型,可能学习到并不代表现实世界的模式。但当数据足够多且多样时,模型会学到真正有效的规律。
- 模型测试:仅用 50 位用户测试模型的结果,可能与用 5,000 位用户测试时大相径庭。更大的测试集能更清楚地展现模型在部署后将如何表现。
简而言之,数据越多,噪声越少,决策越佳。
常见误解
当人们期待大数定律立竿见影时,往往会产生误解。
如果您认为结果会很快“拉平”,那就是错误。例如,如果您连续 5 次抛硬币都是正面,您可能会觉得反面“该”出现以平衡之前的结果。但概率并非如此运作。
这种想法被称为赌徒谬误:错误地认为在真正随机的过程中,过去的结果会影响未来的结果。实际上,每次抛硬币仍然是 50/50 的机会,与之前发生的事无关。
大数定律并不承诺短期内随机性就会被抚平。它告诉我们的是,在大量反复试验中,平均结果会逐渐接近期望值。对于公平硬币,这意味着最终会大致各半,而非立刻如此。
在此过程中,短暂的连胜连败或不寻常的模式仍可能出现。这正是小样本中随机性的表现。只有当您放大视角、观察整体时,该定律才真正发挥意义。
与其他概念的关系
大数定律告诉我们,随着样本量增大,样本平均值会更接近真实平均值;而中心极限定理(CLT)则更进一步,解释这些平均值的分布形状。
根据中心极限定理,如果您抽取许多较大的样本并计算其均值,这些均值将形成一个钟形曲线(正态分布),无论原始数据是什么样子。
二者在统计中都很重要,但描述的内容不同:一个关注准确性,另一个关注形状。
|
收敛类型
|
含义
|
相关概念
|
|
依概率收敛
|
随着样本量增加,样本均值会接近真实均值
|
大数定律
|
|
依分布收敛
|
随着样本量增大,样本均值的分布会趋近于正态曲线
|
中心极限定理
|
要点回顾
大数定律强调了数据分析中的一个核心原则:更大的样本量能带来更稳定、更准确的结果,但前提是数据具备代表性。
尽管大型数据集能降低随机波动的影响,但数据并非越多越好。如果数据存在偏差或不均衡,即便数据量庞大,也可能得出误导性结果。要得出有效结论,既需要量,也需要质。
如果您希望在这些概念上夯实基础,建议从Statistical Thinking in Python课程开始。之后,您可以探索高斯分布,以了解大数定律如何与统计与机器学习中的其他关键工具相互关联。


单个结果本身并不能说明太多问题。假设您抛一次硬币,结果是正面。这并不能证明什么——也许只是偶然。但如果您抛硬币 100 次,您会看到正反面大致各占一半。此时,平均值才开始有意义。
这正是大数定律的核心。您收集的数据越多,平均值就越准确。它能帮助您看清全局。
在本指南中,我们将讲解大数定律的含义、其在现实生活中的运作方式,以及为什么在理解模式或做出更优决策时它如此有用。
什么是大数定律?
大数定律是概率和统计中的一个原理,用来解释随着数据增多,平均值的行为。随着样本量增加,该样本的平均值(称为样本均值)会越来越接近整个总体的真实平均值(称为总体均值)。
在现实世界中,我们通常无法获取整个总体的数据。相反,我们会抽取样本,比如调查 1,000 名选民,而不是全部 3 亿人。大数定律让我们有信心认为,只要数据足够多,样本平均值就会接近真实值。
随着样本增大,随机波动开始相互抵消。离群值的影响减小,平均值变得更加稳定和可预测。
该定律主要有两个版本,它们对这种效应的保证程度不同:
弱大数定律(依概率收敛)
弱大数定律指出,随着样本量增加,样本均值很可能接近总体均值。您收集的数据越多,平均值长期偏离真实值的可能性就越小。
例如,您抛一枚公平硬币。随着抛掷次数增多,正反面出现的比例会越来越接近 50/50。它未必完全相等,但会非常接近,这就是弱大数定律所描述的。
强大数定律(几乎处处收敛)
强大数定律更进一步。它指出样本均值不仅会接近总体均值,而且几乎必然会在那附近稳定下来。
通俗地说:如果您无限次地抛掷一枚公平硬币,正反面比例不会只是接近 50/50;它会稳定在该比例附近。因此,该定律几乎完全保证了长期平均能反映真实情况,只有极少数例外。
现实中的运作示例
来看几个现实案例,以理解该定律如何发挥作用:
抛硬币或掷骰子
想象您掷一枚常规六面骰三次,可能得到 6、2 和 5。平均值为 4.3,高于期望值 3.5。但如果您掷 100 次、再掷 1,000 次,随着次数增加,平均值会越发接近 3.5。大数定律会随着时间推移抚平随机性。
掷的次数越多,平均值越接近 3.5。图片来源:作者。
体育统计
运动员有时状态好、有时状态差。某个四分卫在一场比赛中 10 次传球命中 9 次,达到令人印象深刻的 90%。但这并不意味着他总能达到这个水平。
放到整个赛季来看,经过数百次传球,命中率会趋于平稳。赛季统计能更好地反映球员的真实水平。
平均值。图片来源:作者。
保险业的风险共担
保险公司无法准确知道单个个体会带来多少成本。有些人几乎不使用医疗服务,而另一些人则会使用较多。
但当您观察一个大型人群时,这些起伏会相互抵消。通过将上千名投保人的风险进行池化,保险公司能更准确地预测平均成本。
这使他们能够在保持财务稳健的同时,设定公平的价格(保费)。
对许多人取平均能呈现真实成本。图片来源:作者。
赌场游戏与庄家优势
赌场在每款游戏中都设置了微小优势。打二十一点时,您可能连赢五局或连输十局。但在成千上万局之后,平均结果将偏向赌场。
例如,如果庄家优势为 0.5%,那么从长期来看,赌场预计平均每投注 100 美元可赚 50 美分。短时间内未必如此,但随着数百万次游戏的累积,结果会与预期高度一致。
投注越多,赌场优势越能体现。图片来源:作者。
科技公司的 A/B 测试
假设一家公司想测试两种网站按钮:A 按钮和 B 按钮。各有 20 人试用后,A 按钮似乎更好。但这个数据量不足以让结果可信。
现在让 20,000 名用户看到两种按钮。随着样本量增加,平均点击率会更可靠,表现更好的按钮会更清晰地显现出来。
这就是为什么公司在 A/B 测试中依赖大样本。大数定律帮助他们避免伪阳性,做出更明智的选择。
测试人数越多,结果越可靠。图片来源:作者。
为什么大数定律很重要
在数据科学中,我们经常用数据来训练模型。但如果数据集太小,少数异常值就可能扭曲结果。
例如,您仅用 10 位用户来测试一个新的推荐算法。如果一位用户什么都点,另一位什么都不点,您的平均表现可能看起来非常好或非常差。这并不意味着模型好坏,只是说明样本太小,不足以信任。
大数定律告诉我们,随着我们收集更多数据,随机波动会被抹平,平均结果会更可靠。这就是大型数据集能提供更好预测与洞见的原因。
您也会在模拟中见到这一点。以蒙特卡罗方法为例,这些方法通过使用随机输入,反复运行同一场景数千次。大数定律保证:我们运行的试验越多,平均结果就越接近真实的期望值。
在机器学习中,该定律主要体现在两个方面:
简而言之,数据越多,噪声越少,决策越佳。
常见误解
当人们期待大数定律立竿见影时,往往会产生误解。
如果您认为结果会很快“拉平”,那就是错误。例如,如果您连续 5 次抛硬币都是正面,您可能会觉得反面“该”出现以平衡之前的结果。但概率并非如此运作。
这种想法被称为赌徒谬误:错误地认为在真正随机的过程中,过去的结果会影响未来的结果。实际上,每次抛硬币仍然是 50/50 的机会,与之前发生的事无关。
大数定律并不承诺短期内随机性就会被抚平。它告诉我们的是,在大量反复试验中,平均结果会逐渐接近期望值。对于公平硬币,这意味着最终会大致各半,而非立刻如此。
在此过程中,短暂的连胜连败或不寻常的模式仍可能出现。这正是小样本中随机性的表现。只有当您放大视角、观察整体时,该定律才真正发挥意义。
与其他概念的关系
大数定律告诉我们,随着样本量增大,样本平均值会更接近真实平均值;而中心极限定理(CLT)则更进一步,解释这些平均值的分布形状。
根据中心极限定理,如果您抽取许多较大的样本并计算其均值,这些均值将形成一个钟形曲线(正态分布),无论原始数据是什么样子。
二者在统计中都很重要,但描述的内容不同:一个关注准确性,另一个关注形状。
收敛类型
含义
相关概念
依概率收敛
随着样本量增加,样本均值会接近真实均值
大数定律
依分布收敛
随着样本量增大,样本均值的分布会趋近于正态曲线
中心极限定理
要点回顾
大数定律强调了数据分析中的一个核心原则:更大的样本量能带来更稳定、更准确的结果,但前提是数据具备代表性。
尽管大型数据集能降低随机波动的影响,但数据并非越多越好。如果数据存在偏差或不均衡,即便数据量庞大,也可能得出误导性结果。要得出有效结论,既需要量,也需要质。
如果您希望在这些概念上夯实基础,建议从Statistical Thinking in Python课程开始。之后,您可以探索高斯分布,以了解大数定律如何与统计与机器学习中的其他关键工具相互关联。