
{count, plural, one {Cursus} other {Cursussen}}
Basis van kansrekening in Python
{hours} uur
16.5K
Eén resultaat op zichzelf zegt niet zoveel. Stel dat je één keer een munt opgooit en kop krijgt. Dat bewijst niets — het kan gewoon toeval zijn. Maar als je de munt 100 keer opgooit, zie je dat kop en munt ongeveer even vaak voorkomen. Dán begint het gemiddelde ergens op te slaan.
En daar draait de wet van de grote aantallen om. Hoe meer data je verzamelt, hoe nauwkeuriger je gemiddelde wordt. Het helpt je het grotere plaatje te zien.
In deze gids leggen we uit wat de wet van de grote aantallen betekent, hoe die in de praktijk werkt en waarom ze zo nuttig is als je patronen wilt begrijpen of op de lange termijn betere beslissingen wilt nemen.
De wet van de grote aantallen is een principe uit de kansrekening en de statistiek dat uitlegt hoe gemiddelden zich gedragen naarmate er meer data wordt verzameld. Als je steekproef groter wordt, komt het gemiddelde van die steekproef (het steekproefgemiddelde) dichter bij het werkelijke gemiddelde van de hele groep (het populatiegemiddelde).
In de echte wereld hebben we meestal geen toegang tot data van een hele populatie. In plaats daarvan nemen we een steekproef, zoals het ondervragen van 1.000 kiezers in plaats van alle 300 miljoen mensen. De wet van de grote aantallen geeft ons het vertrouwen dat het steekproefgemiddelde, met genoeg data, dicht bij het echte gemiddelde ligt.
Naarmate de steekproef groeit, heffen willekeurige fluctuaties elkaar op. Uitschieters hebben minder invloed en het gemiddelde wordt stabieler en voorspelbaarder.
Er zijn twee hoofdversies van de wet, die verschillen in hoe sterk ze dit effect garanderen:
De zwakke wet van de grote aantallen zegt dat het steekproefgemiddelde waarschijnlijk dichter bij het populatiegemiddelde komt naarmate de steekproef groter wordt. Hoe meer data je verzamelt, hoe kleiner de kans dat je gemiddelde ver van de waarheid af blijft.
Neem bijvoorbeeld een eerlijke munt. Naarmate je vaker gooit, komt de verhouding kop-munt dichter bij 50/50. Het is misschien niet perfect, maar het komt aardig in de buurt — en daar gaat de zwakke wet over.
De sterke wet van de grote aantallen gaat een stap verder. Die zegt dat het steekproefgemiddelde bijna zeker dicht bij het populatiegemiddelde komt en daar blijft, niet alleen waarschijnlijk.
Eenvoudig gezegd: als je die eerlijke munt voor altijd blijft opgooien, komt de kop-muntverhouding niet alleen in de buurt van 50/50; die stabiliseert daar. Deze wet geeft ons dus nagenoeg de zekerheid dat langetermijngemiddelden de waarheid weerspiegelen, met slechts zeldzame uitzonderingen.
Laten we enkele praktijkvoorbeelden bekijken om te begrijpen hoe deze wet werkt:
Stel dat je een gewone zeskantige dobbelsteen drie keer rolt. Je krijgt bijvoorbeeld 6, 2 en 5. Het gemiddelde is 4,3, wat hoger is dan de verwachtingswaarde van 3,5. Maar nu rol je de dobbelsteen 100 keer, daarna 1.000 keer. Naarmate het aantal worpen toeneemt, komt je gemiddelde dichter bij 3,5. De wet van de grote aantallen vlakt de willekeur over de tijd uit.
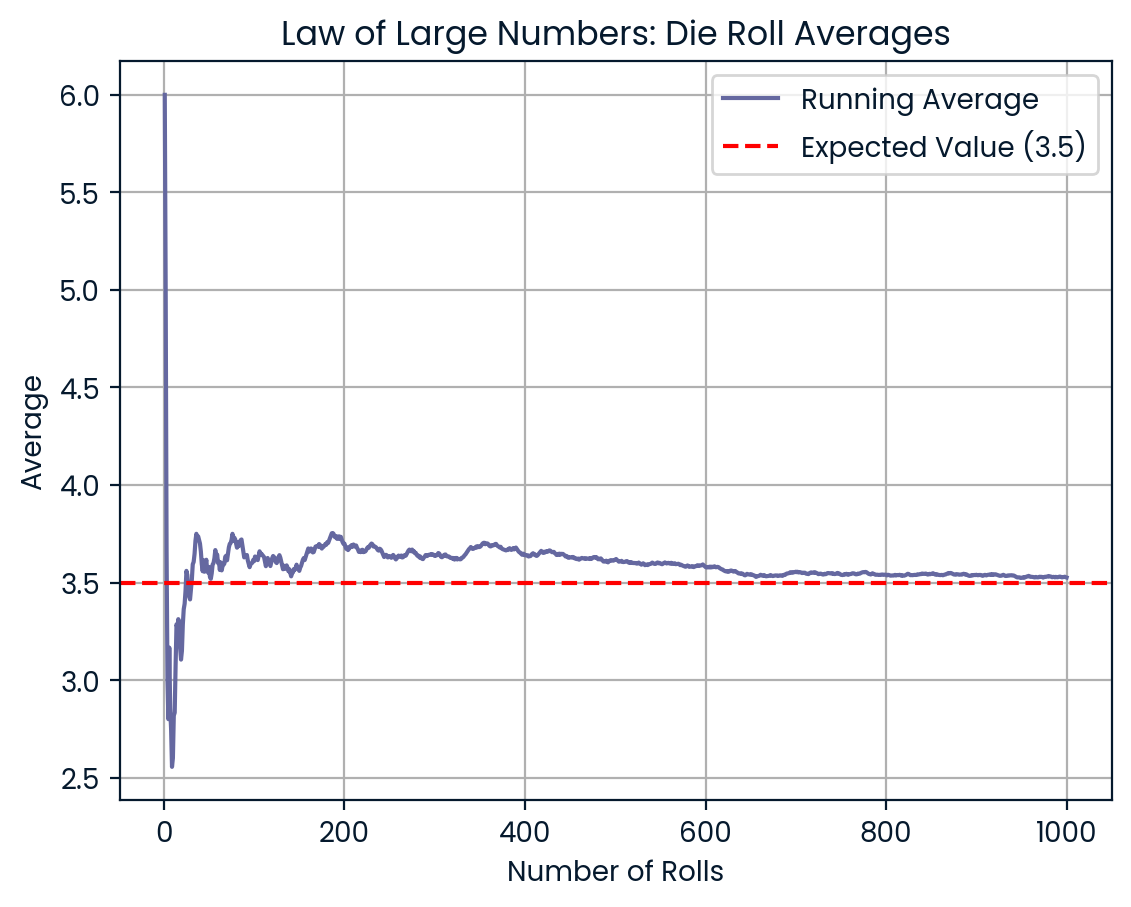
Meer worpen brengen het gemiddelde dichter bij 3,5. Afbeelding door de auteur.
Sporters hebben goede en slechte dagen. Een quarterback kan in één wedstrijd 9 van de 10 passes voltooien, een indrukwekkende 90%. Maar dat betekent niet dat die altijd op dat niveau speelt.
Over een heel seizoen, met honderden worpen, vlakt het voltooiingspercentage af. Die seizoensstatistiek geeft een veel beter beeld van het werkelijke niveau van de speler.
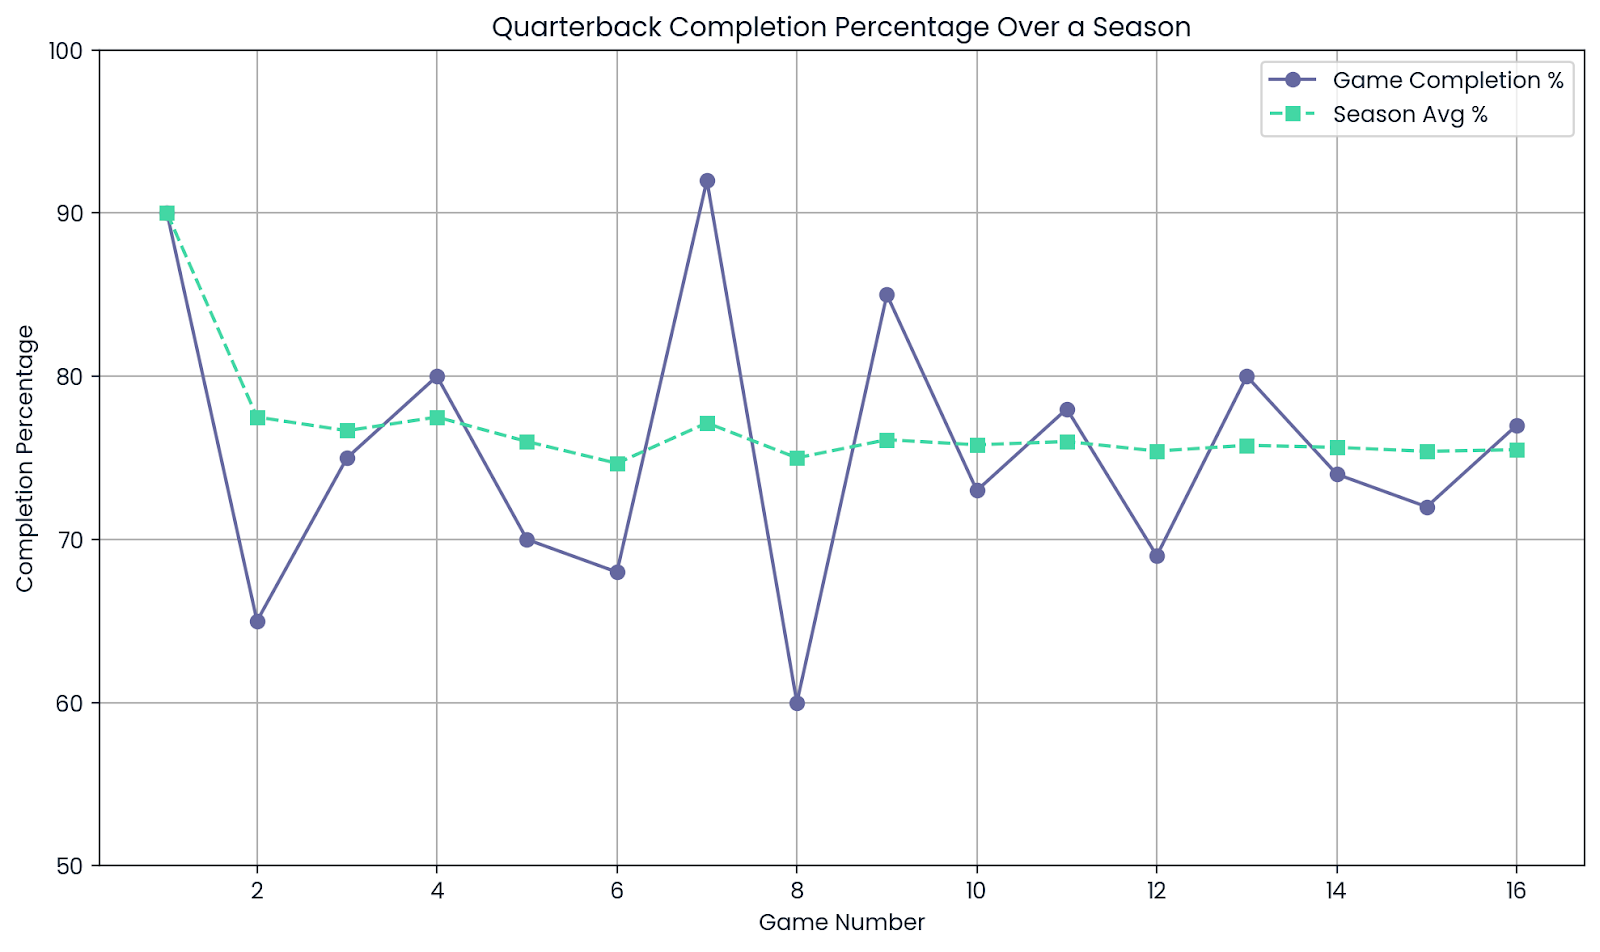
Gemiddelde. Afbeelding door de auteur.
Verzekeraars weten niet precies hoeveel één persoon hen zal kosten. Sommigen maken geen gebruik van zorg, anderen wel.
Maar bij een grote groep vlakken die pieken en dalen uit. Door risico te bundelen over duizenden polishouders kunnen verzekeraars het gemiddelde kostenplaatje nauwkeuriger voorspellen.
Zo kunnen ze eerlijke prijzen (premies) vaststellen en financieel stabiel blijven.
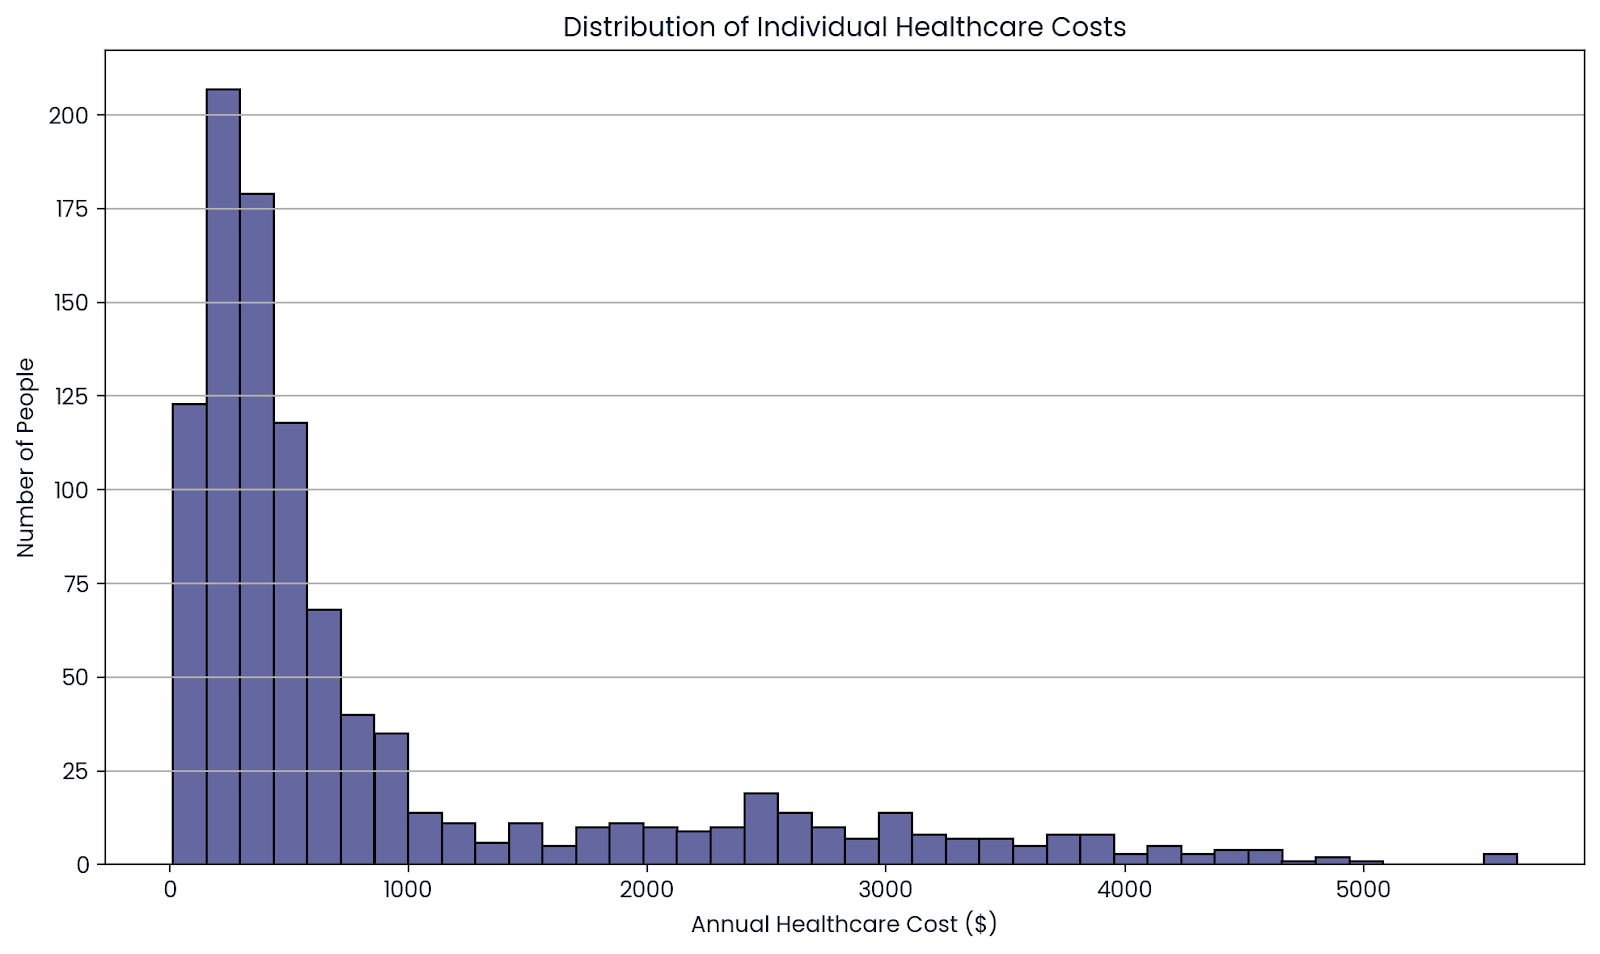
Het gemiddelde over veel mensen laat de werkelijke kosten zien. Afbeelding door de auteur.
Casino’s bouwen in elk spel een klein voordeel in. Speel je blackjack, dan kun je vijf handen op rij winnen of er tien verliezen. Maar over duizenden spellen genomen, valt het gemiddelde resultaat in het voordeel van het casino uit.
Als het huisvoordeel bijvoorbeeld 0,5% is, verwacht het casino over de tijd gemiddeld 50 cent te verdienen per $100 aan inzet. Dat hoeft niet in een korte sessie te gebeuren, maar over miljoenen spellen komt het precies zo uit als verwacht.
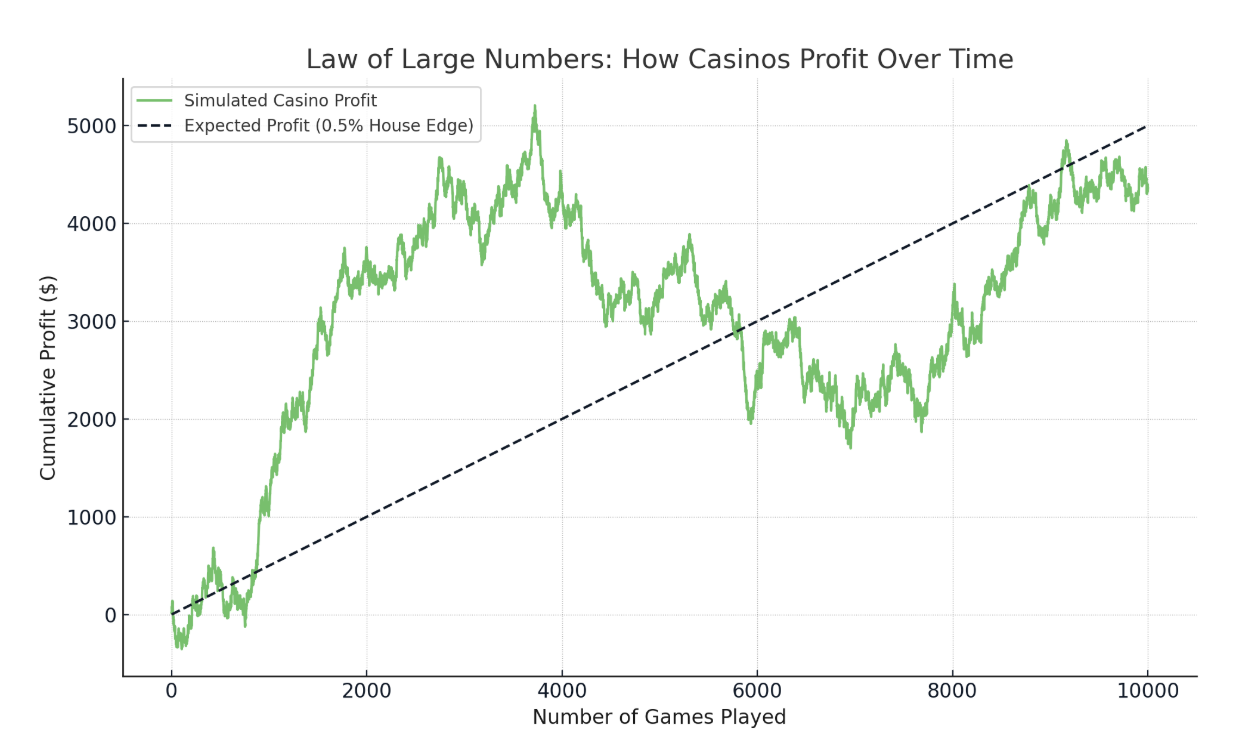
Met meer inzetten wint het huisvoordeel. Afbeelding door de auteur.
Stel dat een bedrijf twee versies van een websiteknop wil testen: Knop A en Knop B. Na 20 gebruikers per versie lijkt Knop A beter. Maar dat is te weinig data om op te vertrouwen.
Laat nu 20.000 gebruikers beide zien. Naarmate de steekproef groeit, worden de gemiddelde klikpercentages betrouwbaarder en komt de beter presterende knop duidelijk naar voren.
Daarom vertrouwen bedrijven bij A/B-testen op grote steekproeven. De wet van de grote aantallen helpt valse positieven te voorkomen en slimmere keuzes te maken.
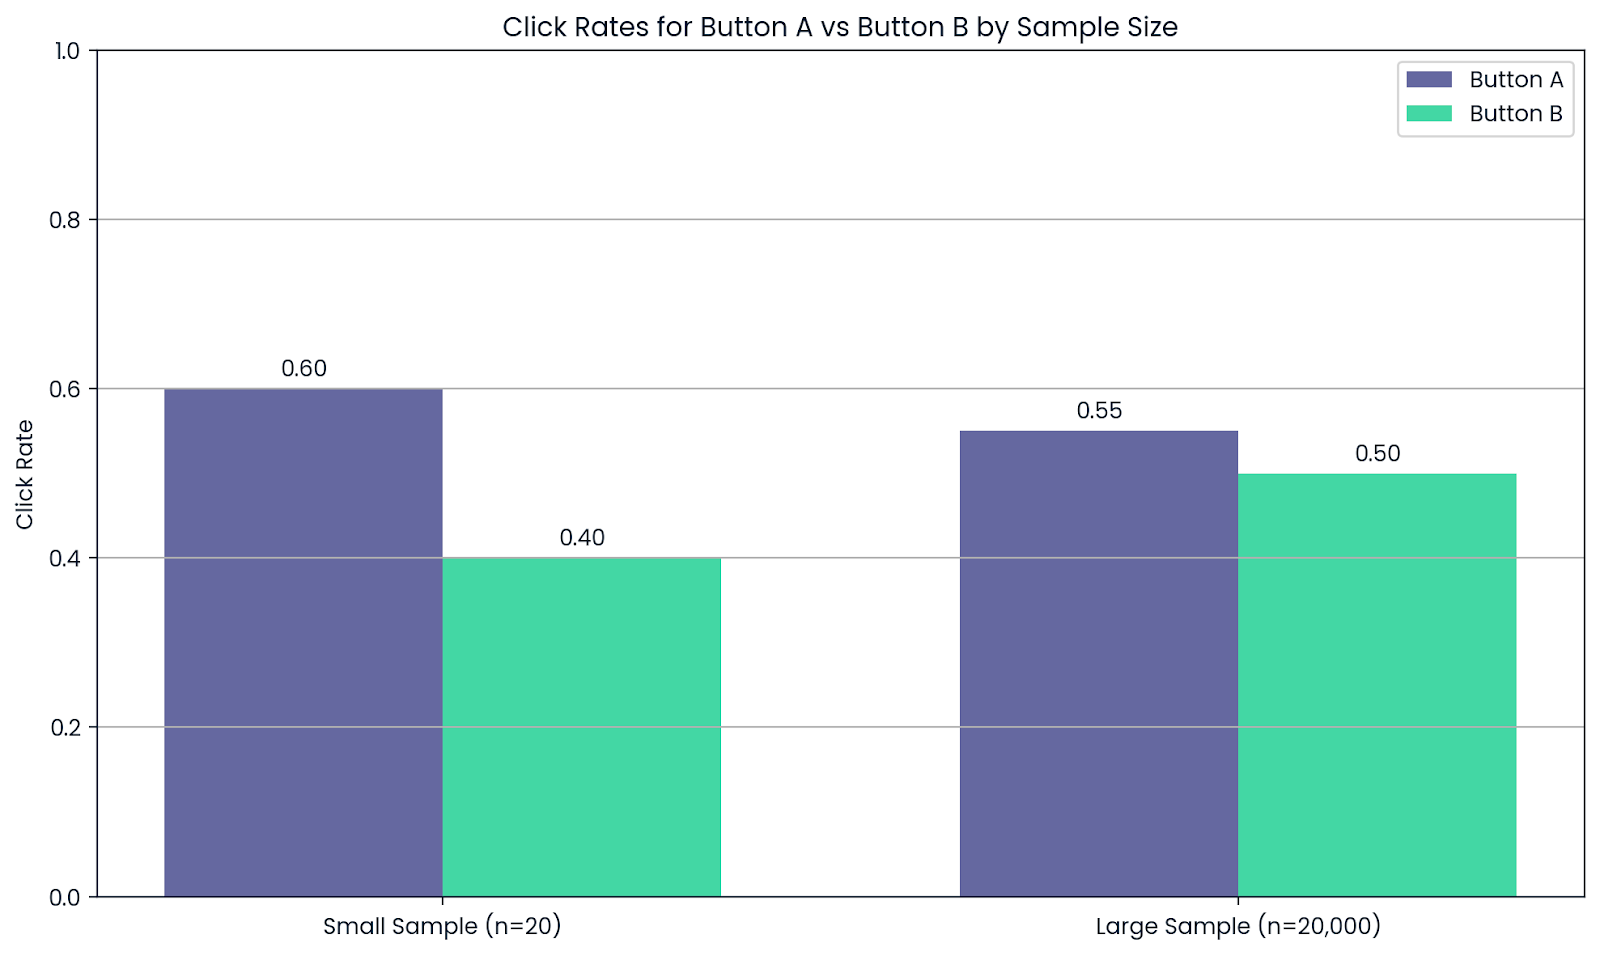
Meer geteste mensen betekent betrouwbaardere resultaten. Afbeelding door de auteur.
In data science gebruiken we vaak data om modellen te trainen. Maar als de dataset te klein is, kunnen een paar ongewone waarden de resultaten vertekenen.
Stel, je test een nieuw aanbevelingsalgoritme met slechts 10 gebruikers. Als één gebruiker overal op klikt en een ander nergens op, kan je gemiddelde prestatie geweldig of rampzalig lijken. Dat betekent niet dat het model goed of slecht is; het betekent dat je steekproef te klein is om op te vertrouwen.
De wet van de grote aantallen vertelt ons dat naarmate we meer data verzamelen, willekeurige schommelingen uitmiddelen en het gemiddelde resultaat betrouwbaarder wordt. Daarom leveren grote datasets betere voorspellingen en inzichten op.
Dit zie je ook in simulaties. Neem bijvoorbeeld Monte Carlo-methoden. Daarbij voer je hetzelfde scenario duizenden keren uit met willekeurige input. De wet van de grote aantallen garandeert dat hoe meer proeven we doen, hoe dichter het gemiddelde resultaat bij de ware verwachtingswaarde komt.
In machine learning zien we de wet op twee belangrijke manieren terug:
Kortom: meer data betekent minder ruis en betere beslissingen.
De wet van de grote aantallen wordt vaak verkeerd begrepen wanneer mensen verwachten dat die meteen werkt.
Als je denkt dat uitkomsten zich snel zullen “uitmiddelen”, is dat een vergissing. Als je bijvoorbeeld een munt vijf keer op rij kop ziet geven, kun je denken dat munt nu “moet” komen om het te balanceren. Maar zo werkt kansrekening niet.
Dit heet de gokkersmisvatting: het valse idee dat eerdere resultaten toekomstige beïnvloeden in een echt willekeurig proces. In werkelijkheid is elke worp nog steeds 50/50, ongeacht wat er eerder gebeurde.
De wet van de grote aantallen belooft niet dat willekeur op korte termijn gladgestreken wordt. Ze zegt juist dat over heel veel herhalingen het gemiddelde resultaat dichter bij de verwachtingswaarde komt. Bij een eerlijke munt betekent dat uiteindelijk ongeveer half kop en half munt — niet meteen.
Korte reeksen of ongewone patronen kunnen nog steeds voorkomen. Zo ziet willekeur eruit in kleine steekproeven. De wet wordt pas betekenisvol als je uitzoomt en naar het grote geheel kijkt.
Hoewel de wet van de grote aantallen zegt dat het steekproefgemiddelde dichter bij het ware gemiddelde komt naarmate de steekproef groeit, gaat de centrale limietstelling (CLT) een stap verder. Die legt uit hoe de verdeling van die gemiddelden eruitziet.
Volgens de CLT vormen de gemiddelden, als je veel grote steekproeven neemt en hun gemiddelden berekent, een klokvormige curve (een normale verdeling), ongeacht hoe de oorspronkelijke data eruitzag.
Beide zijn belangrijk in de statistiek, maar ze beschrijven verschillende dingen: de ene focust op nauwkeurigheid, de andere op vorm.
|
Type convergentie |
Wat het betekent |
Gerelateerd concept |
|
Convergentie in waarschijnlijkheid |
Het steekproefgemiddelde komt dichter bij het ware gemiddelde naarmate de steekproef groter wordt |
Wet van de grote aantallen |
|
Convergentie in verdeling |
De verdeling van steekproefgemiddelden nadert een normale curve naarmate de steekproef groeit |
Centrale limietstelling |
De wet van de grote aantallen benadrukt een kernprincipe in data-analyse: grotere steekproeven leveren stabielere en nauwkeurigere resultaten op — maar alleen als de data representatief is.
Hoewel grote datasets de effecten van willekeurige variatie verkleinen, is meer data niet altijd beter. Als de data bevooroordeeld of uit balans is, kan zelfs een enorme dataset misleidende uitkomsten opleveren. Voor valide conclusies heb je zowel volume als kwaliteit nodig.
Wil je deze concepten verder versterken, dan is de cursus Statistical Thinking in Python een goed startpunt. Verken daarna de Gauss-verdeling om te zien hoe de wet van de grote aantallen aansluit bij andere belangrijke tools in statistiek en machine learning.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

