एक अकेला परिणाम अपने आप में बहुत कुछ नहीं बताता। मान लीजिए आपने एक बार सिक्का उछाला और हेड आया। इससे कुछ सिद्ध नहीं होता — यह संयोग भी हो सकता है। लेकिन अगर आप सिक्का 100 बार उछालें, तो हेड और टेल लगभग बराबर बार आएंगे। तभी औसत मायने रखने लगता है।
यही लॉ ऑफ लार्ज नंबर्स का सार है। जितना अधिक डेटा आप इकट्ठा करते हैं, आपका औसत उतना ही सटीक होता जाता है। यह आपको बड़ी तस्वीर देखने में मदद करता है।
इस गाइड में, हम समझेंगे कि लॉ ऑफ लार्ज नंबर्स का अर्थ क्या है, यह वास्तविक जीवन में कैसे काम करता है, और समय के साथ पैटर्न समझने या बेहतर निर्णय लेने में यह क्यों इतना उपयोगी है।
लॉ ऑफ लार्ज नंबर्स क्या है?
यह प्रायिकता और सांख्यिकी का सिद्धांत है जो बताता है कि जैसे-जैसे अधिक डेटा इकट्ठा होता है, औसत कैसे व्यवहार करता है। जैसे-जैसे आपका सैंपल आकार बढ़ता है, उस सैंपल का औसत (सैंपल मीन) पूरे समूह के सच्चे औसत (पॉप्युलेशन मीन) के और करीब आता जाता है।
वास्तविक दुनिया में, हमारे पास आमतौर पर पूरी जनसंख्या का डेटा नहीं होता। इसके बजाय हम एक सैंपल लेते हैं, जैसे 300 मिलियन लोगों की जगह 1,000 मतदाताओं का सर्वेक्षण। लॉ ऑफ लार्ज नंबर्स हमें भरोसा देता है कि पर्याप्त डेटा के साथ सैंपल औसत असली औसत के करीब होगा।
जैसे-जैसे सैंपल बढ़ता है, यादृच्छिक उतार-चढ़ाव एक-दूसरे को संतुलित करने लगते हैं। आउट्लायर्स का असर कम हो जाता है, और औसत अधिक स्थिर और पूर्वानुमेय हो जाता है।
इस नियम के दो मुख्य संस्करण हैं, और वे इस प्रभाव की गारंटी की ताकत में भिन्न हैं:
वीक लॉ (प्रायिकता में अभिसरण)
वीक लॉ ऑफ लार्ज नंबर्स कहता है कि जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल मीन संभावतः पॉप्युलेशन मीन के करीब आता है। जितना अधिक डेटा आप जुटाते हैं, आपका औसत वास्तविक मान से बहुत दूर रहने की संभावना उतनी ही कम होती है।
उदाहरण के लिए, आप एक निष्पक्ष सिक्का उछालते हैं। जैसे-जैसे उछाल की संख्या बढ़ती है, हेड और टेल का अनुपात 50/50 के करीब आता जाता है। यह पूरी तरह बराबर न भी हो, फिर भी काफी नजदीक रहता है, और यही वीक लॉ बताता है।
स्ट्रॉन्ग लॉ (लगभग निश्चित अभिसरण)
स्ट्रॉन्ग लॉ ऑफ लार्ज नंबर्स एक कदम आगे जाता है। यह कहता है कि सैंपल मीन पॉप्युलेशन मीन के करीब आएगा और लगभग निश्चित रूप से वहीं ठहर जाएगा, सिर्फ संभावना मात्र नहीं।
सरल शब्दों में: अगर आप उस निष्पक्ष सिक्के को हमेशा के लिए उछालते रहें, तो हेड-टेल का अनुपात सिर्फ 50/50 के करीब नहीं आएगा; वह वहीं जम जाएगा। इसलिए यह नियम हमें लगभग पूरी निश्चितता देता है कि लंबे समय के औसत सच्चाई को दर्शाते हैं, सिवाय दुर्लभ अपवादों के।
वास्तविक जीवन में इस नियम के उदाहरण
आइए कुछ वास्तविक उदाहरण देखें ताकि समझ सकें कि यह नियम कैसे काम करता है:
सिक्का उछालना या पासा फेंकना
सोचिए आपने एक सामान्य छह-पक्षीय पासा तीन बार फेंका। मान लीजिए 6, 2 और 5 आए। औसत 4.3 है, जो अपेक्षित मान 3.5 से अधिक है। लेकिन अब पासा 100 बार, फिर 1,000 बार फेंकिए। जैसे-जैसे रोल्स की संख्या बढ़ती है, आपका औसत 3.5 के करीब आता है। लॉ ऑफ लार्ज नंबर्स समय के साथ यादृच्छिकता को समतल कर देता है।
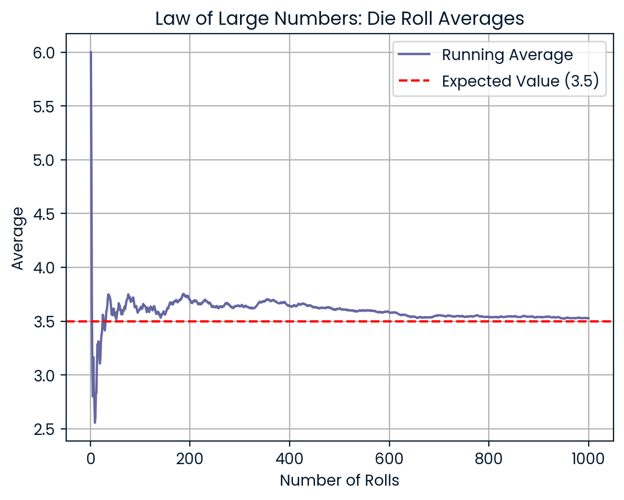
ज्यादा रोल करने पर औसत 3.5 के और करीब आता है। चित्र: लेखक द्वारा।
खेल के आँकड़े
खिलाड़ियों के अच्छे और बुरे दिन होते हैं। कोई क्वार्टरबैक एक मैच में 10 में से 9 पास पूरे कर सकता है, यानी प्रभावशाली 90%। लेकिन इसका मतलब यह नहीं कि वह हमेशा उसी स्तर पर खेलता है।
पूरे सीजन में, सैकड़ों थ्रो के साथ, कम्प्लीशन प्रतिशत समतल होने लगता है। सीजन-भर का यह आँकड़ा खिलाड़ी की वास्तविक क्षमता का कहीं बेहतर संकेत देता है।
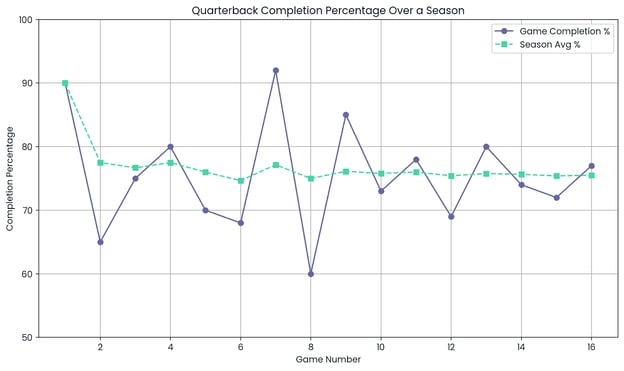
औसत। चित्र: लेखक द्वारा।
बीमा उद्योग में जोखिम का एकत्रीकरण
बीमा कंपनियों को पता नहीं होता कि एक व्यक्ति उन पर कितना खर्च डाल देगा। कुछ लोग चिकित्सा सेवाओं का बिल्कुल उपयोग नहीं करते, जबकि कुछ अधिक करते हैं।
लेकिन जब आप बड़े समूह को देखते हैं, तो ये उतार-चढ़ाव एक-दूसरे को संतुलित कर देते हैं। हजारों पॉलिसीधारकों में जोखिम फैलाकर, बीमाकर्ता औसत लागत का अधिक सटीक अनुमान लगा सकते हैं।
इससे वे उचित मूल्य (प्रीमियम) तय कर पाते हैं और वित्तीय रूप से स्थिर रहते हैं।
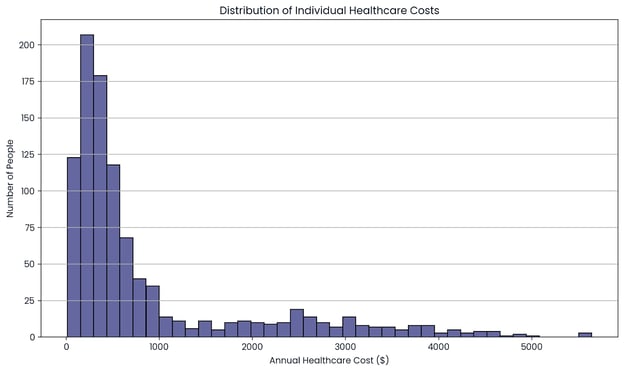
कई लोगों का औसत वास्तविक लागत दिखाता है। चित्र: लेखक द्वारा।
कसीनो गेम्स और हाउस ऐज
कसीनो हर गेम में थोड़ा-सा लाभ जोड़ते हैं। अगर आप ब्लैकजैक खेलते हैं, तो आप लगातार पांच हाथ जीत सकते हैं या दस हार सकते हैं। लेकिन हजारों खेलों में औसत परिणाम कसीनो के पक्ष में रहता है।
उदाहरण के लिए, अगर हाउस ऐज 0.5% है, तो समय के साथ कसीनो औसतन हर $100 की शर्त पर 50 सेंट कमाने की उम्मीद करता है। यह छोटी सेशन में जरूरी नहीं कि घटित हो, लेकिन लाखों खेलों में यह बिल्कुल अपेक्षित रूप से जुड़ता जाता है।
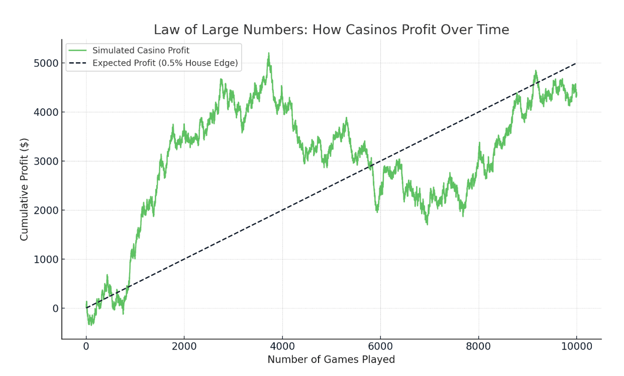
ज्यादा दांव के साथ कसीनो का ऐज जीतता है। चित्र: लेखक द्वारा।
टेक कंपनियों में A/B परीक्षण
मान लीजिए कोई कंपनी वेबसाइट बटन के दो संस्करणों का परीक्षण करना चाहती है: बटन A और बटन B। प्रत्येक को 20 लोगों ने आजमाया और बटन A बेहतर दिखता है। लेकिन परिणाम पर भरोसा करने के लिए यह डेटा पर्याप्त नहीं है।
अब 20,000 उपयोगकर्ताओं को दोनों दिखाइए। जैसे-जैसे सैंपल आकार बढ़ता है, औसत क्लिक दरें अधिक भरोसेमंद हो जाती हैं, और बेहतर प्रदर्शन करने वाला बटन स्पष्ट हो जाता है।
इसीलिए कंपनियाँ A/B परीक्षण के लिए बड़े सैंपल पर निर्भर रहती हैं। लॉ ऑफ लार्ज नंबर्स उन्हें झूठे पॉज़िटिव से बचाता है और समझदारी भरे फैसले लेने में मदद करता है।
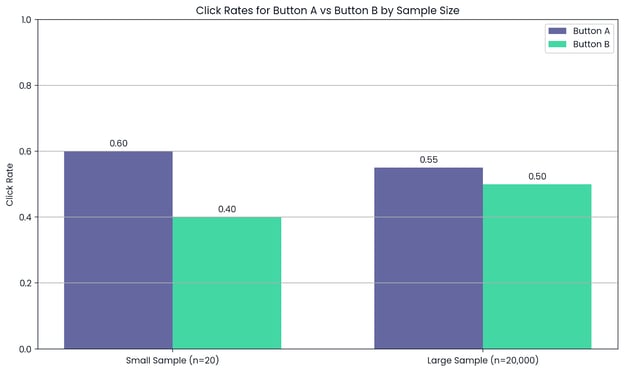
ज्यादा लोगों पर परीक्षण का मतलब अधिक भरोसेमंद परिणाम। चित्र: लेखक द्वारा।
लॉ ऑफ लार्ज नंबर्स क्यों महत्वपूर्ण है
डेटा साइंस में, हम अक्सर मॉडलों को प्रशिक्षित करने के लिए डेटा का उपयोग करते हैं। लेकिन अगर डेटासेट बहुत छोटा है, तो कुछ असामान्य मान परिणामों को टेढ़ा कर सकते हैं।
उदाहरण के लिए, आप केवल 10 उपयोगकर्ताओं के साथ एक नया रिकमेंडेशन एल्गोरिद्म परीक्षण कर रहे हैं। अगर एक उपयोगकर्ता सब पर क्लिक करता है और दूसरा किसी पर नहीं, तो आपका औसत प्रदर्शन बहुत अच्छा या बहुत खराब दिख सकता है। इसका मतलब यह नहीं कि मॉडल अच्छा या बुरा है; मतलब यह है कि आपका सैंपल भरोसे के लिए बहुत छोटा है।
लॉ ऑफ लार्ज नंबर्स बताता है कि जैसे-जैसे हम अधिक डेटा जुटाते हैं, यादृच्छिक उतार-चढ़ाव सम हो जाते हैं, और औसत परिणाम अधिक विश्वसनीय होता जाता है। यही कारण है कि बड़े डेटासेट बेहतर पूर्वानुमान और अंतर्दृष्टि देते हैं।
यह सिमुलेशन में भी दिखता है। उदाहरण के लिए, मोंटे कार्लो विधियाँ लें। इनमें यादृच्छिक इनपुट का उपयोग करके एक ही परिदृश्य को हजारों बार चलाया जाता है। लॉ ऑफ लार्ज नंबर्स गारंटी देता है कि जितनी अधिक बार हम ट्रायल चलाएँगे, औसत परिणाम सच्चे अपेक्षित परिणाम के उतना ही करीब होगा।
मशीन लर्निंग में, यह नियम दो महत्वपूर्ण तरीकों से सामने आता है:
- मॉडल प्रशिक्षण: एक छोटा, असंतुलित डेटासेट पर प्रशिक्षित मॉडल ऐसे पैटर्न सीख सकता है जो वास्तविक दुनिया को नहीं दर्शाते। लेकिन पर्याप्त विविध डेटा के साथ, मॉडल वही सीखता है जो वास्तव में काम करता है।
- मॉडल परीक्षण: सिर्फ 50 उपयोगकर्ताओं पर मॉडल का परीक्षण करना 5,000 पर परीक्षण करने से बिल्कुल अलग परिणाम दे सकता है। बड़ा टेस्ट सेट यह स्पष्ट तस्वीर देता है कि मॉडल परिनियोजन के बाद कैसा प्रदर्शन करेगा।
संक्षेप में, अधिक डेटा का मतलब कम शोर और बेहतर निर्णय।
सामान्य गलतफहमियाँ
लोग अक्सर यह उम्मीद कर बैठते हैं कि यह नियम तुरंत काम करेगा, और यहीं गलतफहमी होती है।
अगर आप मानते हैं कि परिणाम जल्दी ही "बराबर" हो जाएँगे, तो यह गलती है। उदाहरण के लिए, अगर आप सिक्का उछालें और लगातार पाँच बार हेड आए, तो आपको लग सकता है कि अब टेल "देय" है ताकि संतुलन बन जाए। लेकिन प्रायिकता ऐसे काम नहीं करती।
इसे जुआरी की भ्रांति कहते हैं: यह गलत धारणा कि एक वास्तविक यादृच्छिक प्रक्रिया में पिछले परिणाम भविष्य के परिणामों को प्रभावित करते हैं। वास्तविकता में, हर सिक्का उछाल अभी भी 50/50 की संभावना का ही है, चाहे पहले क्या हुआ हो।
लॉ ऑफ लार्ज नंबर्स यह वादा नहीं करता कि अल्पावधि में यादृच्छिकता सम हो जाएगी। यह बताता है कि बहुत-बहुत ट्रायल के बाद औसत परिणाम अपेक्षित मान के करीब जाता है। निष्पक्ष सिक्के के मामले में, इसका मतलब है कि अंततः लगभग आधे हेड और आधे टेल होंगे — तुरंत नहीं, पर समय के साथ।
रास्ते में छोटी-छोटी स्ट्रीक या असामान्य पैटर्न फिर भी हो सकते हैं। छोटी नमूनों में यादृच्छिकता ऐसी ही दिखती है। यह नियम तब मायने रखता है जब आप ज़ूम आउट करके बड़ी तस्वीर देखते हैं।
अन्य अवधारणाओं से संबंध
जहाँ लॉ ऑफ लार्ज नंबर्स बताता है कि जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल औसत सच्चे औसत के करीब आता है, वहीं सेंट्रल लिमिट थ्योरम (CLT) इससे आगे जाता है। यह बताता है कि उन औसतों का वितरण कैसा दिखता है।
CLT के अनुसार, अगर आप कई बड़े सैंपल लें और उनके औसत निकालें, तो वे औसत एक घंटी-आकार का वक्र (नॉर्मल वितरण) बनाएँगे, भले ही मूल डेटा कैसा भी रहा हो।
दोनों सांख्यिकी में महत्वपूर्ण हैं, लेकिन वे अलग बातें बताते हैं: एक सटीकता पर केंद्रित है, दूसरा आकार पर।
|
अभिसरण का प्रकार
|
इसका अर्थ
|
संबंधित अवधारणा
|
|
प्रायिकता में अभिसरण
|
जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल मीन सच्चे मीन के करीब आता है
|
लॉ ऑफ लार्ज नंबर्स
|
|
वितरण में अभिसरण
|
जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल औसतों का वितरण नॉर्मल कर्व के करीब आता है
|
सेंट्रल लिमिट थ्योरम
|
मुख्य बातें
लॉ ऑफ लार्ज नंबर्स डेटा विश्लेषण के एक मूल सिद्धांत को रेखांकित करता है: बड़े सैंपल आकार अधिक स्थिर और सटीक परिणाम देते हैं, लेकिन केवल तब जब डेटा प्रतिनिधिक हो।
हालाँकि बड़े डेटासेट यादृच्छिक भिन्नताओं के प्रभाव को कम करते हैं, पर अधिक डेटा हमेशा बेहतर नहीं होता। अगर डेटा पक्षपाती या असंतुलित है, तो बहुत बड़ा डेटासेट भी भ्रामक परिणाम दे सकता है। वैध निष्कर्ष निकालने के लिए, मात्रा के साथ गुणवत्ता भी चाहिए।
यदि आप इन अवधारणाओं में मजबूत नींव बनाना चाहते हैं, तो Statistical Thinking in Python कोर्स एक बेहतरीन शुरुआत है। इसके बाद, Gaussian वितरण को खोजें ताकि समझ सकें कि लॉ ऑफ लार्ज नंबर्स सांख्यिकी और मशीन लर्निंग के अन्य प्रमुख औज़ारों से कैसे जुड़ता है।


एक अकेला परिणाम अपने आप में बहुत कुछ नहीं बताता। मान लीजिए आपने एक बार सिक्का उछाला और हेड आया। इससे कुछ सिद्ध नहीं होता — यह संयोग भी हो सकता है। लेकिन अगर आप सिक्का 100 बार उछालें, तो हेड और टेल लगभग बराबर बार आएंगे। तभी औसत मायने रखने लगता है।
यही लॉ ऑफ लार्ज नंबर्स का सार है। जितना अधिक डेटा आप इकट्ठा करते हैं, आपका औसत उतना ही सटीक होता जाता है। यह आपको बड़ी तस्वीर देखने में मदद करता है।
इस गाइड में, हम समझेंगे कि लॉ ऑफ लार्ज नंबर्स का अर्थ क्या है, यह वास्तविक जीवन में कैसे काम करता है, और समय के साथ पैटर्न समझने या बेहतर निर्णय लेने में यह क्यों इतना उपयोगी है।
लॉ ऑफ लार्ज नंबर्स क्या है?
यह प्रायिकता और सांख्यिकी का सिद्धांत है जो बताता है कि जैसे-जैसे अधिक डेटा इकट्ठा होता है, औसत कैसे व्यवहार करता है। जैसे-जैसे आपका सैंपल आकार बढ़ता है, उस सैंपल का औसत (सैंपल मीन) पूरे समूह के सच्चे औसत (पॉप्युलेशन मीन) के और करीब आता जाता है।
वास्तविक दुनिया में, हमारे पास आमतौर पर पूरी जनसंख्या का डेटा नहीं होता। इसके बजाय हम एक सैंपल लेते हैं, जैसे 300 मिलियन लोगों की जगह 1,000 मतदाताओं का सर्वेक्षण। लॉ ऑफ लार्ज नंबर्स हमें भरोसा देता है कि पर्याप्त डेटा के साथ सैंपल औसत असली औसत के करीब होगा।
जैसे-जैसे सैंपल बढ़ता है, यादृच्छिक उतार-चढ़ाव एक-दूसरे को संतुलित करने लगते हैं। आउट्लायर्स का असर कम हो जाता है, और औसत अधिक स्थिर और पूर्वानुमेय हो जाता है।
इस नियम के दो मुख्य संस्करण हैं, और वे इस प्रभाव की गारंटी की ताकत में भिन्न हैं:
वीक लॉ (प्रायिकता में अभिसरण)
वीक लॉ ऑफ लार्ज नंबर्स कहता है कि जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल मीन संभावतः पॉप्युलेशन मीन के करीब आता है। जितना अधिक डेटा आप जुटाते हैं, आपका औसत वास्तविक मान से बहुत दूर रहने की संभावना उतनी ही कम होती है।
उदाहरण के लिए, आप एक निष्पक्ष सिक्का उछालते हैं। जैसे-जैसे उछाल की संख्या बढ़ती है, हेड और टेल का अनुपात 50/50 के करीब आता जाता है। यह पूरी तरह बराबर न भी हो, फिर भी काफी नजदीक रहता है, और यही वीक लॉ बताता है।
स्ट्रॉन्ग लॉ (लगभग निश्चित अभिसरण)
स्ट्रॉन्ग लॉ ऑफ लार्ज नंबर्स एक कदम आगे जाता है। यह कहता है कि सैंपल मीन पॉप्युलेशन मीन के करीब आएगा और लगभग निश्चित रूप से वहीं ठहर जाएगा, सिर्फ संभावना मात्र नहीं।
सरल शब्दों में: अगर आप उस निष्पक्ष सिक्के को हमेशा के लिए उछालते रहें, तो हेड-टेल का अनुपात सिर्फ 50/50 के करीब नहीं आएगा; वह वहीं जम जाएगा। इसलिए यह नियम हमें लगभग पूरी निश्चितता देता है कि लंबे समय के औसत सच्चाई को दर्शाते हैं, सिवाय दुर्लभ अपवादों के।
वास्तविक जीवन में इस नियम के उदाहरण
आइए कुछ वास्तविक उदाहरण देखें ताकि समझ सकें कि यह नियम कैसे काम करता है:
सिक्का उछालना या पासा फेंकना
सोचिए आपने एक सामान्य छह-पक्षीय पासा तीन बार फेंका। मान लीजिए 6, 2 और 5 आए। औसत 4.3 है, जो अपेक्षित मान 3.5 से अधिक है। लेकिन अब पासा 100 बार, फिर 1,000 बार फेंकिए। जैसे-जैसे रोल्स की संख्या बढ़ती है, आपका औसत 3.5 के करीब आता है। लॉ ऑफ लार्ज नंबर्स समय के साथ यादृच्छिकता को समतल कर देता है।
ज्यादा रोल करने पर औसत 3.5 के और करीब आता है। चित्र: लेखक द्वारा।
खेल के आँकड़े
खिलाड़ियों के अच्छे और बुरे दिन होते हैं। कोई क्वार्टरबैक एक मैच में 10 में से 9 पास पूरे कर सकता है, यानी प्रभावशाली 90%। लेकिन इसका मतलब यह नहीं कि वह हमेशा उसी स्तर पर खेलता है।
पूरे सीजन में, सैकड़ों थ्रो के साथ, कम्प्लीशन प्रतिशत समतल होने लगता है। सीजन-भर का यह आँकड़ा खिलाड़ी की वास्तविक क्षमता का कहीं बेहतर संकेत देता है।
औसत। चित्र: लेखक द्वारा।
बीमा उद्योग में जोखिम का एकत्रीकरण
बीमा कंपनियों को पता नहीं होता कि एक व्यक्ति उन पर कितना खर्च डाल देगा। कुछ लोग चिकित्सा सेवाओं का बिल्कुल उपयोग नहीं करते, जबकि कुछ अधिक करते हैं।
लेकिन जब आप बड़े समूह को देखते हैं, तो ये उतार-चढ़ाव एक-दूसरे को संतुलित कर देते हैं। हजारों पॉलिसीधारकों में जोखिम फैलाकर, बीमाकर्ता औसत लागत का अधिक सटीक अनुमान लगा सकते हैं।
इससे वे उचित मूल्य (प्रीमियम) तय कर पाते हैं और वित्तीय रूप से स्थिर रहते हैं।
कई लोगों का औसत वास्तविक लागत दिखाता है। चित्र: लेखक द्वारा।
कसीनो गेम्स और हाउस ऐज
कसीनो हर गेम में थोड़ा-सा लाभ जोड़ते हैं। अगर आप ब्लैकजैक खेलते हैं, तो आप लगातार पांच हाथ जीत सकते हैं या दस हार सकते हैं। लेकिन हजारों खेलों में औसत परिणाम कसीनो के पक्ष में रहता है।
उदाहरण के लिए, अगर हाउस ऐज 0.5% है, तो समय के साथ कसीनो औसतन हर $100 की शर्त पर 50 सेंट कमाने की उम्मीद करता है। यह छोटी सेशन में जरूरी नहीं कि घटित हो, लेकिन लाखों खेलों में यह बिल्कुल अपेक्षित रूप से जुड़ता जाता है।
ज्यादा दांव के साथ कसीनो का ऐज जीतता है। चित्र: लेखक द्वारा।
टेक कंपनियों में A/B परीक्षण
मान लीजिए कोई कंपनी वेबसाइट बटन के दो संस्करणों का परीक्षण करना चाहती है: बटन A और बटन B। प्रत्येक को 20 लोगों ने आजमाया और बटन A बेहतर दिखता है। लेकिन परिणाम पर भरोसा करने के लिए यह डेटा पर्याप्त नहीं है।
अब 20,000 उपयोगकर्ताओं को दोनों दिखाइए। जैसे-जैसे सैंपल आकार बढ़ता है, औसत क्लिक दरें अधिक भरोसेमंद हो जाती हैं, और बेहतर प्रदर्शन करने वाला बटन स्पष्ट हो जाता है।
इसीलिए कंपनियाँ A/B परीक्षण के लिए बड़े सैंपल पर निर्भर रहती हैं। लॉ ऑफ लार्ज नंबर्स उन्हें झूठे पॉज़िटिव से बचाता है और समझदारी भरे फैसले लेने में मदद करता है।
ज्यादा लोगों पर परीक्षण का मतलब अधिक भरोसेमंद परिणाम। चित्र: लेखक द्वारा।
लॉ ऑफ लार्ज नंबर्स क्यों महत्वपूर्ण है
डेटा साइंस में, हम अक्सर मॉडलों को प्रशिक्षित करने के लिए डेटा का उपयोग करते हैं। लेकिन अगर डेटासेट बहुत छोटा है, तो कुछ असामान्य मान परिणामों को टेढ़ा कर सकते हैं।
उदाहरण के लिए, आप केवल 10 उपयोगकर्ताओं के साथ एक नया रिकमेंडेशन एल्गोरिद्म परीक्षण कर रहे हैं। अगर एक उपयोगकर्ता सब पर क्लिक करता है और दूसरा किसी पर नहीं, तो आपका औसत प्रदर्शन बहुत अच्छा या बहुत खराब दिख सकता है। इसका मतलब यह नहीं कि मॉडल अच्छा या बुरा है; मतलब यह है कि आपका सैंपल भरोसे के लिए बहुत छोटा है।
लॉ ऑफ लार्ज नंबर्स बताता है कि जैसे-जैसे हम अधिक डेटा जुटाते हैं, यादृच्छिक उतार-चढ़ाव सम हो जाते हैं, और औसत परिणाम अधिक विश्वसनीय होता जाता है। यही कारण है कि बड़े डेटासेट बेहतर पूर्वानुमान और अंतर्दृष्टि देते हैं।
यह सिमुलेशन में भी दिखता है। उदाहरण के लिए, मोंटे कार्लो विधियाँ लें। इनमें यादृच्छिक इनपुट का उपयोग करके एक ही परिदृश्य को हजारों बार चलाया जाता है। लॉ ऑफ लार्ज नंबर्स गारंटी देता है कि जितनी अधिक बार हम ट्रायल चलाएँगे, औसत परिणाम सच्चे अपेक्षित परिणाम के उतना ही करीब होगा।
मशीन लर्निंग में, यह नियम दो महत्वपूर्ण तरीकों से सामने आता है:
संक्षेप में, अधिक डेटा का मतलब कम शोर और बेहतर निर्णय।
सामान्य गलतफहमियाँ
लोग अक्सर यह उम्मीद कर बैठते हैं कि यह नियम तुरंत काम करेगा, और यहीं गलतफहमी होती है।
अगर आप मानते हैं कि परिणाम जल्दी ही "बराबर" हो जाएँगे, तो यह गलती है। उदाहरण के लिए, अगर आप सिक्का उछालें और लगातार पाँच बार हेड आए, तो आपको लग सकता है कि अब टेल "देय" है ताकि संतुलन बन जाए। लेकिन प्रायिकता ऐसे काम नहीं करती।
इसे जुआरी की भ्रांति कहते हैं: यह गलत धारणा कि एक वास्तविक यादृच्छिक प्रक्रिया में पिछले परिणाम भविष्य के परिणामों को प्रभावित करते हैं। वास्तविकता में, हर सिक्का उछाल अभी भी 50/50 की संभावना का ही है, चाहे पहले क्या हुआ हो।
लॉ ऑफ लार्ज नंबर्स यह वादा नहीं करता कि अल्पावधि में यादृच्छिकता सम हो जाएगी। यह बताता है कि बहुत-बहुत ट्रायल के बाद औसत परिणाम अपेक्षित मान के करीब जाता है। निष्पक्ष सिक्के के मामले में, इसका मतलब है कि अंततः लगभग आधे हेड और आधे टेल होंगे — तुरंत नहीं, पर समय के साथ।
रास्ते में छोटी-छोटी स्ट्रीक या असामान्य पैटर्न फिर भी हो सकते हैं। छोटी नमूनों में यादृच्छिकता ऐसी ही दिखती है। यह नियम तब मायने रखता है जब आप ज़ूम आउट करके बड़ी तस्वीर देखते हैं।
अन्य अवधारणाओं से संबंध
जहाँ लॉ ऑफ लार्ज नंबर्स बताता है कि जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल औसत सच्चे औसत के करीब आता है, वहीं सेंट्रल लिमिट थ्योरम (CLT) इससे आगे जाता है। यह बताता है कि उन औसतों का वितरण कैसा दिखता है।
CLT के अनुसार, अगर आप कई बड़े सैंपल लें और उनके औसत निकालें, तो वे औसत एक घंटी-आकार का वक्र (नॉर्मल वितरण) बनाएँगे, भले ही मूल डेटा कैसा भी रहा हो।
दोनों सांख्यिकी में महत्वपूर्ण हैं, लेकिन वे अलग बातें बताते हैं: एक सटीकता पर केंद्रित है, दूसरा आकार पर।
अभिसरण का प्रकार
इसका अर्थ
संबंधित अवधारणा
प्रायिकता में अभिसरण
जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल मीन सच्चे मीन के करीब आता है
लॉ ऑफ लार्ज नंबर्स
वितरण में अभिसरण
जैसे-जैसे सैंपल आकार बढ़ता है, सैंपल औसतों का वितरण नॉर्मल कर्व के करीब आता है
सेंट्रल लिमिट थ्योरम
मुख्य बातें
लॉ ऑफ लार्ज नंबर्स डेटा विश्लेषण के एक मूल सिद्धांत को रेखांकित करता है: बड़े सैंपल आकार अधिक स्थिर और सटीक परिणाम देते हैं, लेकिन केवल तब जब डेटा प्रतिनिधिक हो।
हालाँकि बड़े डेटासेट यादृच्छिक भिन्नताओं के प्रभाव को कम करते हैं, पर अधिक डेटा हमेशा बेहतर नहीं होता। अगर डेटा पक्षपाती या असंतुलित है, तो बहुत बड़ा डेटासेट भी भ्रामक परिणाम दे सकता है। वैध निष्कर्ष निकालने के लिए, मात्रा के साथ गुणवत्ता भी चाहिए।
यदि आप इन अवधारणाओं में मजबूत नींव बनाना चाहते हैं, तो Statistical Thinking in Python कोर्स एक बेहतरीन शुरुआत है। इसके बाद, Gaussian वितरण को खोजें ताकि समझ सकें कि लॉ ऑफ लार्ज नंबर्स सांख्यिकी और मशीन लर्निंग के अन्य प्रमुख औज़ारों से कैसे जुड़ता है।