这篇博文将为您介绍 lda2vec,一种由 Chris Moody 于 2016 年发布的主题模型。lda2vec 在 Mikolov 等人在 2013 年提出的 word2vec 模型基础上,引入了主题与文档向量,融合了词向量和主题模型的思想。
主题模型的一般目标是生成可解释的文档表示,用于在一组无标签文档中发现主题或结构。例如,一种可解释的文档表示可以是:文档 X 由 20% 的主题 a、40% 的主题 b 和 40% 的主题 c 组成。
今天的文章将首先介绍潜在狄利克雷分配(LDA)。LDA 是一种概率主题模型,它将文档视为词袋(bag-of-words),因此您将先了解这种方法的优缺点。
另一方面,lda2vec 在词嵌入之上构建文档表示。您将进一步了解词嵌入,以及为什么它们如今是自然语言处理(NLP)模型中的首选构建块。
最后,您将了解 lda2vec 背后的总体思路。
潜在狄利克雷分配:简介
主题模型接收一组无标签文档,并尝试在其中找到结构或主题。请注意,主题模型通常假设词语使用与主题的出现相关。例如,您可以将一组新闻文章提供给主题模型,模型将根据词语使用情况把文档划分为若干簇。
主题模型是自动探索和组织大量文档的绝佳方式:它们根据文档中出现的词对文档进行分组或聚类。由于相似主题的文档往往使用相似的子词汇,最终得到的文档簇可以被解释为在讨论不同的“主题”。
潜在狄利克雷分配(LDA)是概率主题模型的一个例子。其确切含义将在下面的部分中说明:您将先了解 LDA 如何从词袋描述出发来表示不同的文档,然后看到这些表示如何用于发现文档集合中的结构。
词袋(Bag-of-words)
传统上,在 NLP 中,文本文档常用词袋来表示。
这意味着每个文档都表示为一个固定长度的向量,其长度等于词汇表大小。该向量的每个维度对应某个词在文档中的计数或出现情况。将可变长度的文档压缩为固定长度向量,使其更易于用于各种机器学习(ML)模型和任务(聚类、分类等)。
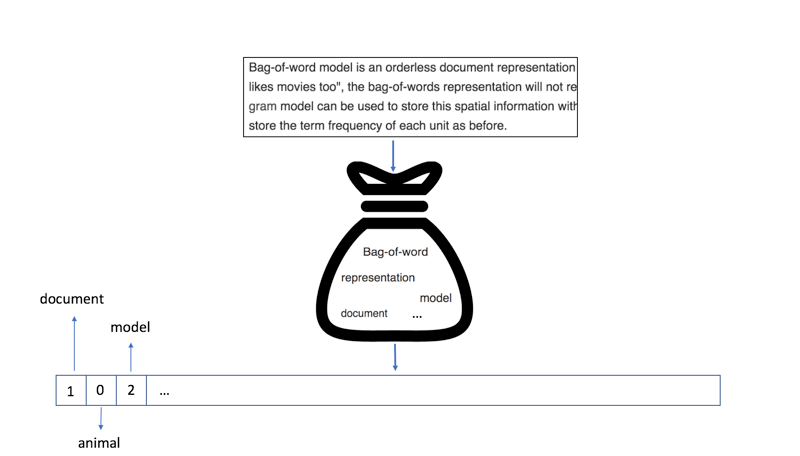
上图展示了在词袋模型中如何表示一个文档:“document”一词的计数为 1,而“model”在文本中出现了两次。
尽管词袋会产生稀疏且高维的文档表示,但在数据量充足的情况下,主题分类往往能取得不错的效果。您也可以阅读近期的Facebook 论文了解主题分类。
固定长度的文档表示意味着您可以轻松将不同长度的文档输入到 ML 模型(SVM、k-NN、随机森林等)中。这使您能够对文档进行聚类或主题分类。 文档的结构信息被移除,模型不得不自行发现哪些向量维度在语义上相似。比如将“feline”和“cat”映射到不同维度会不太直观,因为模型被迫去学习这些不同维度之间的相关性。
LDA 模型
训练 LDA 模型时,您从一组文档开始,每个文档用固定长度向量(词袋)表示。LDA 是一种通用的机器学习(ML)技术,这意味着当输入是一组固定长度向量、目标是探索数据结构时,它也可用于其他无监督的 ML 问题。
要实现 LDA 模型,您首先需要定义文档集合中包含的“主题”数量。听起来很直接,但在处理海量文档时往往没有看上去那么直观。
在对 $$N$$ 篇文档用 $$M$$ 个主题训练 LDA 模型时,本质上是在寻找能够最好地解释数据的文档向量与主题向量。
请注意,本教程不会详细覆盖 LDA 的全部理论(可参阅 Blei 等人的这篇论文),我们更侧重传达总体思路。
假设文档的词汇表由 $$V$$ 个词构成。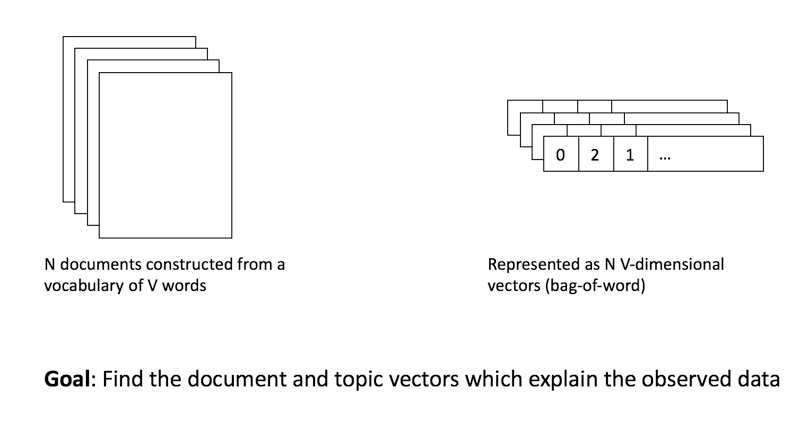
在 LDA 模型中,每个 $$N$$ 篇文档将由一个长度为 $$M$$ 的向量表示,指明该文档中出现了哪些主题。一个文档可以由 75% 的“主题 1”和 25% 的“主题 2”组成。LDA 的文档向量通常包含许多零,这意味着每篇文档只涉及有限数量的主题。这与“文档通常只讨论有限数量主题”的直觉相符,并显著提升了这些文档向量的可解释性。
每个 $$M$$ 个主题由一个长度为 $$V$$ 的向量表示,指明在该主题的文档中哪些词更可能出现。例如,在主题 1 中,“learning”“modelling”“statistics”可能是最常见的词。您可以据此称其为“数据科学”主题。对于主题 2,“GPU”“compute”“storage”可能最常见,您可以将其解释为“计算”主题。
下图直观展示了 LDA 模型。该模型的目标是找到能够解释不同文档原始词袋表示的主题与文档向量。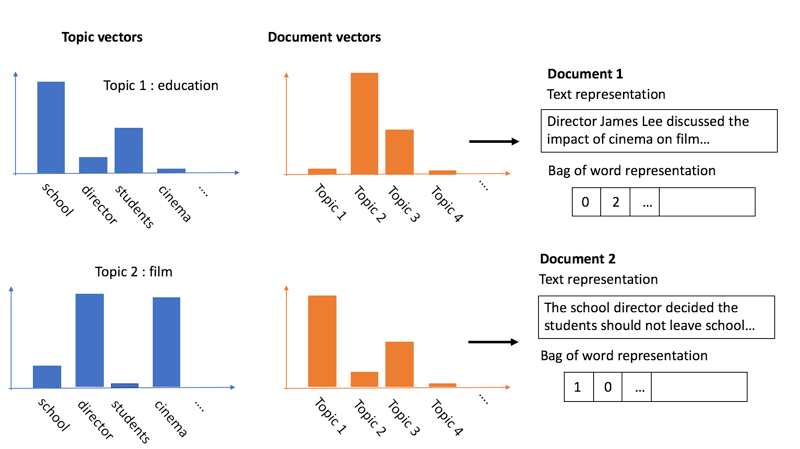
需要注意的是,您在依赖一个假设:主题向量应当是可解释的,否则模型的输出价值不大。实质上,您在假设只要数据足够,模型就能找出哪些词倾向于共现,并将它们聚成不同的“主题”。
LDA 是一个简单且通常效果不错的概率模型。 文档向量往往稀疏、低维且可解释性强,能突出文档中的模式和结构。 您需要估计文档集合中主题数量的合适取值;此外,还需要手动为不同的主题向量指派清晰的名称/“主题”。 由于用词袋来表示文档,LDA 也可能遭遇词袋模型的相同缺点。 LDA 学到的文档向量是通过预测该文档中的词来实现的,但会忽略任何结构或词在局部层面的相互作用。
词嵌入(Word Embeddings)
词袋表示的问题之一在于,模型必须自行找出文档向量中哪些维度在语义上相关。可以想见,如果能够利用词语之间的语义相关性,将有助于提升模型的表现,而这正是词嵌入所承诺的。
在词嵌入中,词被表示为固定长度的向量或嵌入。构建嵌入的模型有多种,但都基于分布式假设,即“词的特征由其上下文所决定”。
词嵌入的目标,是从诸如维基百科这类大型无监督文档集中,捕捉语言的语义与句法规律。出现在相同上下文中的词,其向量表示彼此相近。
图片来源:“Visualizing Word Embeddings with t-SNE”
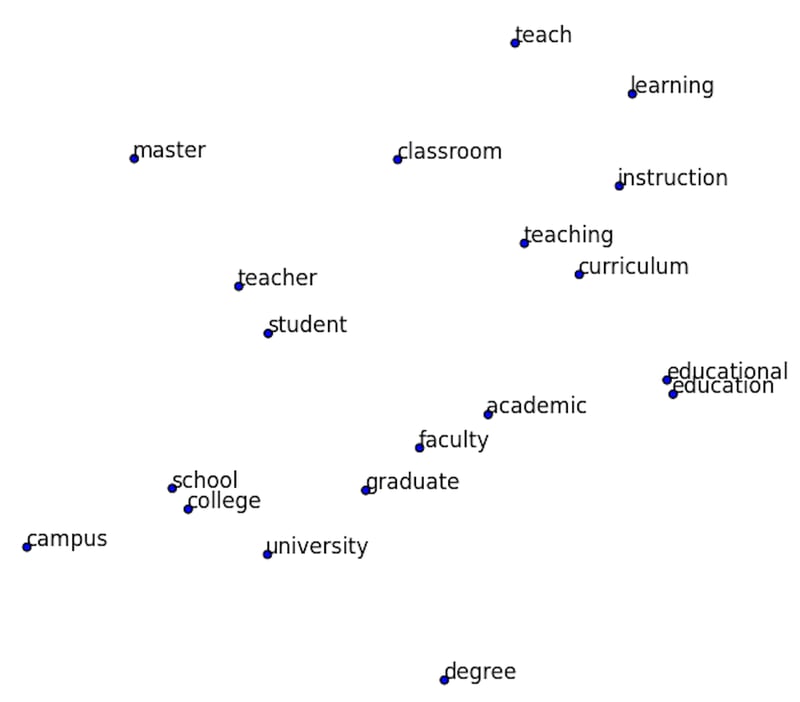
上图是将词嵌入空间用 t-SNE(t 分布随机邻域嵌入)投影到二维空间的结果。t-SNE 是一种用于可视化高维数据的降维方法。它以词嵌入为输入,并将其投影到易于在图中展示的二维空间。图中仅考察了词空间的一个子集,聚焦在与“teacher”相近的词。与用向量中缺乏信息量的维度来表示词不同,使用词嵌入可以用在语义上相关的向量来表示词。
使用词嵌入时,ML 模型可以通过向量表示来利用大型文档集合(语料库)的信息。这在词袋模型中无法做到,在数据量不大时会影响模型表现。 词嵌入会导致文档表示不再是固定长度。相反,文档由可变长度的词向量序列表示。虽然一些深度学习技术(如长短期记忆网络 LSTM、带自适应池化的卷积网络等)能够处理可变长度序列,但通常需要大量数据才能很好地训练。
word2vec
如开头所述,word2vec 是由 Mikolov 等人提出的、非常流行的词嵌入模型。需要注意的是,在分布语义领域还存在其他多种词嵌入模型。虽然要获得高质量的词嵌入需要一些技巧,但本教程只关注 word2vec 的核心思想。
word2vec 使用以下训练过程来获取词嵌入。
-
在文本中选择一个(中心)词。当前中心词的上下文词为其周围出现的词,即在固定长度的窗口内。中心词与上下文词的组合构成一组词-上下文配对。下图取自 Chris Moody 关于 lda2vec 的博文。在这个文本片段中,“awesome”是中心词,其周围的词作为上下文词,得到 7 个词-上下文配对。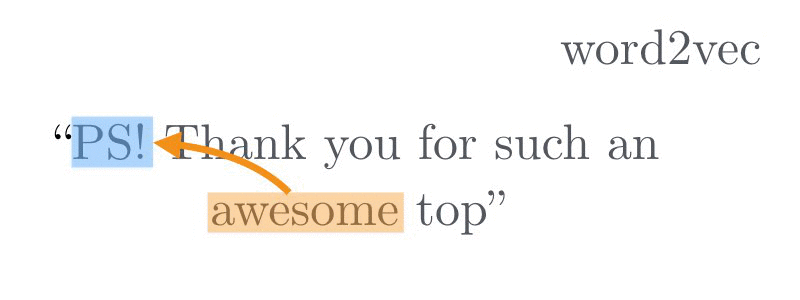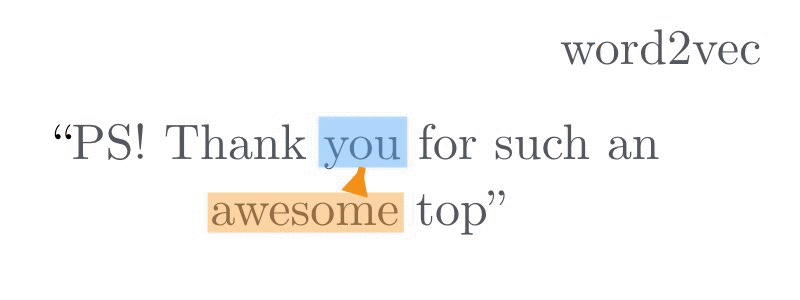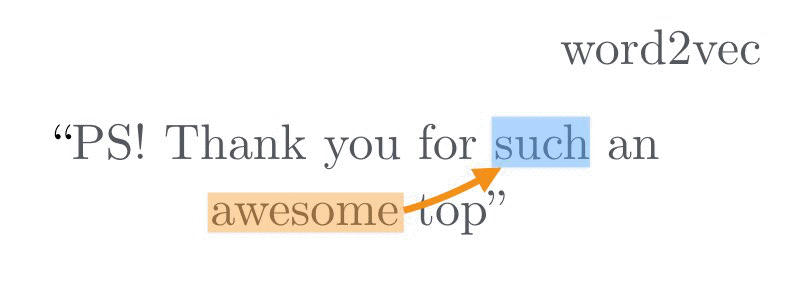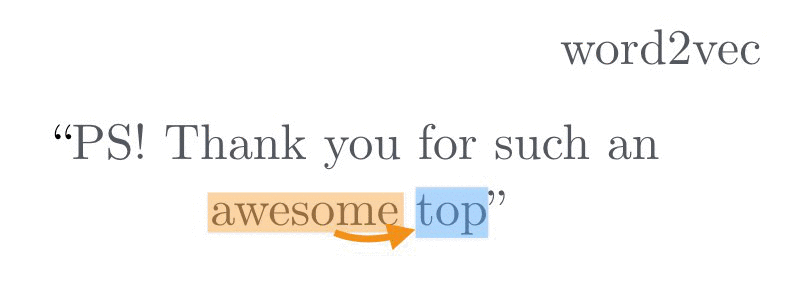
图片来源:“Introducing our Hybrid lda2vec Algorithm”
-
word2vec 有两种变体:a. 在连续词袋(CBOW)结构中,基于一组周围的上下文词来预测中心词(例如给定“thank”“such”“you”“top”,模型需预测“awesome”)。之所以称为词袋结构,是因为上下文词的顺序并不重要。b. 在 skip-gram 结构中,使用中心词来预测周围的上下文词(例如给定“awesome”预测“thank”“such”“you”“top”)。下图展示了两种不同的 word2vec 结构。请注意,相比计算机视觉中的深层神经网络,这里使用的是相对简单的(两层)神经模型。
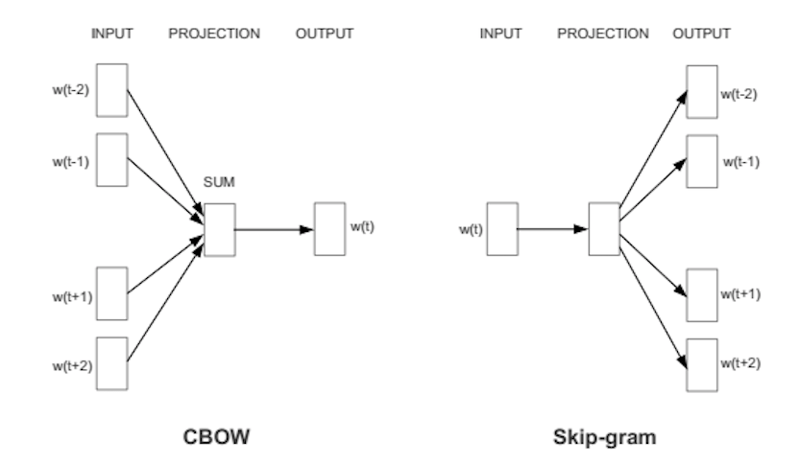
图片来源:“Efficient Estimation of Word Representations in Vector Space”(Mikolov 等,2013)
在大型语料上训练该模型后,您将获得编码了语义信息且具备一些有趣性质的词嵌入(投影层的权重):可以进行向量运算,例如 $$king - man + woman = queen$$。
与简单的独热编码表示相比,词向量是一种更有用的表示。它们允许将大型语料中的统计信息编码到其他模型中,如主题分类或对话系统。 词向量通常是稠密的、高维且不可解释的。考虑如下示例:[ -0.65, -1.223, ..., -0.252, +3.2]。在 LDA 中,维度大致对应于主题,而词向量通常不是这样。 每个词被分配一个与上下文无关的词向量。然而,词语的语义高度依赖于上下文。 word2vec 跨不同文档学习用于预测上下文词的词向量,因此文档特定的信息被混入了词嵌入中。
lda2vec
受潜在狄利克雷分配(LDA)启发,word2vec 模型被扩展为同时学习词、文档和主题向量。
lda2vec 通过修改 skip-gram 变体得到。在原始 skip-gram 方法中,模型基于中心词来预测上下文词。在 lda2vec 中,将中心词向量与文档向量相加得到上下文向量,然后用该上下文向量来预测上下文词。
在下一节中,您将看到这些文档向量如何被构建,以及如何像在 LDA 中那样使用它们。
lda2vec 架构
在 word2vec 中整合上下文向量并不是新想法。比如段落向量就探索了这一想法,以学习变长文本片段的固定长度表示。在他们的工作中,为每个文本片段(段落大小)学习一个稠密向量表示,类似于词向量。
这种方法的不足在于,上下文/段落向量与典型的词向量相似,因而不像 LDA 的输出那样易于解释。
lda2vec 更进一步,针对文档级的文本片段,并将文档向量分解为两个不同的组成部分。与 LDA 模型的思路一致,一个文档向量被分解为文档权重向量和主题矩阵。文档权重向量表示不同主题的占比,而主题矩阵由不同的主题向量组成。于是,上下文向量通过组合文档中出现的不同主题向量来构建。
考虑如下示例:在原始 word2vec 模型中,如果中心词是“French”,那么可能的上下文词是“German”“Dutch”“English”。在缺乏任何全局(与文档相关的)信息时,这些是最合理的猜测。
在 lda2vec 模型中提供一个附加的上下文向量后,就有可能更好地猜测上下文词。
如果文档向量是由“食物”和“饮品”主题的组合构成,那么“baguette”“cheese”“wine”可能更合适。如果文档向量更接近“城市”和“地理”主题,那么“Paris”“Lyon”“Grenoble”可能更合适。
请注意,这些主题向量是在词空间中学习得到的,便于解释:您只需查看哪些词向量最接近这些主题向量。此外,对文档权重向量施加了约束,以获得稀疏向量(类似 LDA),而非稠密向量。这使得不同文档的主题内容更易解释。
简而言之,lda2vec 的最终结果是一组稀疏的文档权重向量,以及易于解释的主题向量。
尽管性能往往与传统 LDA 相近,但借助自动微分方法,该方法可扩展到非常庞大的数据集。此外,通过结合上下文向量与词向量,您可以获得“专用”的词向量,可用于其他模型(并有可能优于更“通用”的词向量)。
lda2vec 库
lda2vec 是一种较新且较为专门化的 NLP 技术。由于它建立在已有方法之上,任何 word2vec 实现都可以扩展为 lda2vec。Chris Moody 使用 Chainer 实现了该方法,但也可以使用其他自动微分框架(CNTK、Theano 等)。基于 Tensorflow 的实现也已公开发布。
可在此处查看 lda2vec Python 模块的概览。由于训练 lda2vec 的计算开销较大,针对更大的语料建议使用 GPU 支持。此外,为加速训练,常将不同词向量用预训练的 word2vec 向量进行初始化。
最后,虽本文将 lda2vec 作为主题模型来讨论,但给 word2vec 增加上下文向量的理念也可更一般化。例如,考虑由来自不同地区的不同作者撰写的文档,那么也可以将作者与地区向量加入上下文向量,从而以无监督方式获得文档、地区和作者的向量表示。
结论
本文仅对 LDA、word2vec 和 lda2vec 做了快速概览。请注意,原作者还发布了一篇关于 lda2vec 技术细节的优秀博文。


这篇博文将为您介绍 lda2vec,一种由 Chris Moody 于 2016 年发布的主题模型。lda2vec 在 Mikolov 等人在 2013 年提出的 word2vec 模型基础上,引入了主题与文档向量,融合了词向量和主题模型的思想。
主题模型的一般目标是生成可解释的文档表示,用于在一组无标签文档中发现主题或结构。例如,一种可解释的文档表示可以是:文档 X 由 20% 的主题 a、40% 的主题 b 和 40% 的主题 c 组成。
今天的文章将首先介绍潜在狄利克雷分配(LDA)。LDA 是一种概率主题模型,它将文档视为词袋(bag-of-words),因此您将先了解这种方法的优缺点。
另一方面,lda2vec 在词嵌入之上构建文档表示。您将进一步了解词嵌入,以及为什么它们如今是自然语言处理(NLP)模型中的首选构建块。
最后,您将了解 lda2vec 背后的总体思路。
潜在狄利克雷分配:简介
主题模型接收一组无标签文档,并尝试在其中找到结构或主题。请注意,主题模型通常假设词语使用与主题的出现相关。例如,您可以将一组新闻文章提供给主题模型,模型将根据词语使用情况把文档划分为若干簇。
主题模型是自动探索和组织大量文档的绝佳方式:它们根据文档中出现的词对文档进行分组或聚类。由于相似主题的文档往往使用相似的子词汇,最终得到的文档簇可以被解释为在讨论不同的“主题”。
潜在狄利克雷分配(LDA)是概率主题模型的一个例子。其确切含义将在下面的部分中说明:您将先了解 LDA 如何从词袋描述出发来表示不同的文档,然后看到这些表示如何用于发现文档集合中的结构。
词袋(Bag-of-words)
传统上,在 NLP 中,文本文档常用词袋来表示。
这意味着每个文档都表示为一个固定长度的向量,其长度等于词汇表大小。该向量的每个维度对应某个词在文档中的计数或出现情况。将可变长度的文档压缩为固定长度向量,使其更易于用于各种机器学习(ML)模型和任务(聚类、分类等)。
上图展示了在词袋模型中如何表示一个文档:“document”一词的计数为 1,而“model”在文本中出现了两次。
尽管词袋会产生稀疏且高维的文档表示,但在数据量充足的情况下,主题分类往往能取得不错的效果。您也可以阅读近期的Facebook 论文了解主题分类。
固定长度的文档表示意味着您可以轻松将不同长度的文档输入到 ML 模型(SVM、k-NN、随机森林等)中。这使您能够对文档进行聚类或主题分类。 文档的结构信息被移除,模型不得不自行发现哪些向量维度在语义上相似。比如将“feline”和“cat”映射到不同维度会不太直观,因为模型被迫去学习这些不同维度之间的相关性。
LDA 模型
训练 LDA 模型时,您从一组文档开始,每个文档用固定长度向量(词袋)表示。LDA 是一种通用的机器学习(ML)技术,这意味着当输入是一组固定长度向量、目标是探索数据结构时,它也可用于其他无监督的 ML 问题。
要实现 LDA 模型,您首先需要定义文档集合中包含的“主题”数量。听起来很直接,但在处理海量文档时往往没有看上去那么直观。
在对 $$N$$ 篇文档用 $$M$$ 个主题训练 LDA 模型时,本质上是在寻找能够最好地解释数据的文档向量与主题向量。
请注意,本教程不会详细覆盖 LDA 的全部理论(可参阅 Blei 等人的这篇论文),我们更侧重传达总体思路。
假设文档的词汇表由 $$V$$ 个词构成。
在 LDA 模型中,每个 $$N$$ 篇文档将由一个长度为 $$M$$ 的向量表示,指明该文档中出现了哪些主题。一个文档可以由 75% 的“主题 1”和 25% 的“主题 2”组成。LDA 的文档向量通常包含许多零,这意味着每篇文档只涉及有限数量的主题。这与“文档通常只讨论有限数量主题”的直觉相符,并显著提升了这些文档向量的可解释性。
每个 $$M$$ 个主题由一个长度为 $$V$$ 的向量表示,指明在该主题的文档中哪些词更可能出现。例如,在主题 1 中,“learning”“modelling”“statistics”可能是最常见的词。您可以据此称其为“数据科学”主题。对于主题 2,“GPU”“compute”“storage”可能最常见,您可以将其解释为“计算”主题。
下图直观展示了 LDA 模型。该模型的目标是找到能够解释不同文档原始词袋表示的主题与文档向量。
需要注意的是,您在依赖一个假设:主题向量应当是可解释的,否则模型的输出价值不大。实质上,您在假设只要数据足够,模型就能找出哪些词倾向于共现,并将它们聚成不同的“主题”。
LDA 是一个简单且通常效果不错的概率模型。 文档向量往往稀疏、低维且可解释性强,能突出文档中的模式和结构。 您需要估计文档集合中主题数量的合适取值;此外,还需要手动为不同的主题向量指派清晰的名称/“主题”。 由于用词袋来表示文档,LDA 也可能遭遇词袋模型的相同缺点。 LDA 学到的文档向量是通过预测该文档中的词来实现的,但会忽略任何结构或词在局部层面的相互作用。
词嵌入(Word Embeddings)
词袋表示的问题之一在于,模型必须自行找出文档向量中哪些维度在语义上相关。可以想见,如果能够利用词语之间的语义相关性,将有助于提升模型的表现,而这正是词嵌入所承诺的。
在词嵌入中,词被表示为固定长度的向量或嵌入。构建嵌入的模型有多种,但都基于分布式假设,即“词的特征由其上下文所决定”。
词嵌入的目标,是从诸如维基百科这类大型无监督文档集中,捕捉语言的语义与句法规律。出现在相同上下文中的词,其向量表示彼此相近。
图片来源:“Visualizing Word Embeddings with t-SNE”
上图是将词嵌入空间用 t-SNE(t 分布随机邻域嵌入)投影到二维空间的结果。t-SNE 是一种用于可视化高维数据的降维方法。它以词嵌入为输入,并将其投影到易于在图中展示的二维空间。图中仅考察了词空间的一个子集,聚焦在与“teacher”相近的词。与用向量中缺乏信息量的维度来表示词不同,使用词嵌入可以用在语义上相关的向量来表示词。
使用词嵌入时,ML 模型可以通过向量表示来利用大型文档集合(语料库)的信息。这在词袋模型中无法做到,在数据量不大时会影响模型表现。 词嵌入会导致文档表示不再是固定长度。相反,文档由可变长度的词向量序列表示。虽然一些深度学习技术(如长短期记忆网络 LSTM、带自适应池化的卷积网络等)能够处理可变长度序列,但通常需要大量数据才能很好地训练。
word2vec
如开头所述,word2vec 是由 Mikolov 等人提出的、非常流行的词嵌入模型。需要注意的是,在分布语义领域还存在其他多种词嵌入模型。虽然要获得高质量的词嵌入需要一些技巧,但本教程只关注 word2vec 的核心思想。
word2vec 使用以下训练过程来获取词嵌入。
在文本中选择一个(中心)词。当前中心词的上下文词为其周围出现的词,即在固定长度的窗口内。中心词与上下文词的组合构成一组词-上下文配对。下图取自 Chris Moody 关于 lda2vec 的博文。在这个文本片段中,“awesome”是中心词,其周围的词作为上下文词,得到 7 个词-上下文配对。
word2vec 有两种变体:a. 在连续词袋(CBOW)结构中,基于一组周围的上下文词来预测中心词(例如给定“thank”“such”“you”“top”,模型需预测“awesome”)。之所以称为词袋结构,是因为上下文词的顺序并不重要。b. 在 skip-gram 结构中,使用中心词来预测周围的上下文词(例如给定“awesome”预测“thank”“such”“you”“top”)。下图展示了两种不同的 word2vec 结构。请注意,相比计算机视觉中的深层神经网络,这里使用的是相对简单的(两层)神经模型。
在大型语料上训练该模型后,您将获得编码了语义信息且具备一些有趣性质的词嵌入(投影层的权重):可以进行向量运算,例如 $$king - man + woman = queen$$。
与简单的独热编码表示相比,词向量是一种更有用的表示。它们允许将大型语料中的统计信息编码到其他模型中,如主题分类或对话系统。 词向量通常是稠密的、高维且不可解释的。考虑如下示例:[ -0.65, -1.223, ..., -0.252, +3.2]。在 LDA 中,维度大致对应于主题,而词向量通常不是这样。 每个词被分配一个与上下文无关的词向量。然而,词语的语义高度依赖于上下文。 word2vec 跨不同文档学习用于预测上下文词的词向量,因此文档特定的信息被混入了词嵌入中。
lda2vec
受潜在狄利克雷分配(LDA)启发,word2vec 模型被扩展为同时学习词、文档和主题向量。
lda2vec 通过修改 skip-gram 变体得到。在原始 skip-gram 方法中,模型基于中心词来预测上下文词。在 lda2vec 中,将中心词向量与文档向量相加得到上下文向量,然后用该上下文向量来预测上下文词。
在下一节中,您将看到这些文档向量如何被构建,以及如何像在 LDA 中那样使用它们。
lda2vec 架构
在 word2vec 中整合上下文向量并不是新想法。比如段落向量就探索了这一想法,以学习变长文本片段的固定长度表示。在他们的工作中,为每个文本片段(段落大小)学习一个稠密向量表示,类似于词向量。
这种方法的不足在于,上下文/段落向量与典型的词向量相似,因而不像 LDA 的输出那样易于解释。
lda2vec 更进一步,针对文档级的文本片段,并将文档向量分解为两个不同的组成部分。与 LDA 模型的思路一致,一个文档向量被分解为文档权重向量和主题矩阵。文档权重向量表示不同主题的占比,而主题矩阵由不同的主题向量组成。于是,上下文向量通过组合文档中出现的不同主题向量来构建。
考虑如下示例:在原始 word2vec 模型中,如果中心词是“French”,那么可能的上下文词是“German”“Dutch”“English”。在缺乏任何全局(与文档相关的)信息时,这些是最合理的猜测。
在 lda2vec 模型中提供一个附加的上下文向量后,就有可能更好地猜测上下文词。
如果文档向量是由“食物”和“饮品”主题的组合构成,那么“baguette”“cheese”“wine”可能更合适。如果文档向量更接近“城市”和“地理”主题,那么“Paris”“Lyon”“Grenoble”可能更合适。
请注意,这些主题向量是在词空间中学习得到的,便于解释:您只需查看哪些词向量最接近这些主题向量。此外,对文档权重向量施加了约束,以获得稀疏向量(类似 LDA),而非稠密向量。这使得不同文档的主题内容更易解释。
简而言之,lda2vec 的最终结果是一组稀疏的文档权重向量,以及易于解释的主题向量。
尽管性能往往与传统 LDA 相近,但借助自动微分方法,该方法可扩展到非常庞大的数据集。此外,通过结合上下文向量与词向量,您可以获得“专用”的词向量,可用于其他模型(并有可能优于更“通用”的词向量)。
lda2vec 库
lda2vec 是一种较新且较为专门化的 NLP 技术。由于它建立在已有方法之上,任何 word2vec 实现都可以扩展为 lda2vec。Chris Moody 使用 Chainer 实现了该方法,但也可以使用其他自动微分框架(CNTK、Theano 等)。基于 Tensorflow 的实现也已公开发布。
可在此处查看 lda2vec Python 模块的概览。由于训练 lda2vec 的计算开销较大,针对更大的语料建议使用 GPU 支持。此外,为加速训练,常将不同词向量用预训练的 word2vec 向量进行初始化。
最后,虽本文将 lda2vec 作为主题模型来讨论,但给 word2vec 增加上下文向量的理念也可更一般化。例如,考虑由来自不同地区的不同作者撰写的文档,那么也可以将作者与地区向量加入上下文向量,从而以无监督方式获得文档、地区和作者的向量表示。
结论
本文仅对 LDA、word2vec 和 lda2vec 做了快速概览。请注意,原作者还发布了一篇关于 lda2vec 技术细节的优秀博文。