Corso
Capire il Machine Learning
2 ore
310.7K
Questo post ti introdurrà a lda2vec, un modello di topic pubblicato da Chris Moody nel 2016. lda2vec amplia il modello word2vec, descritto da Mikolov et al. nel 2013, con vettori di argomento e di documento e integra idee sia dal word embedding sia dai topic model.
L'obiettivo generale di un topic model è produrre rappresentazioni dei documenti interpretabili che possano essere utilizzate per scoprire gli argomenti o la struttura in una collezione di documenti non etichettati. Un esempio di tale rappresentazione interpretabile è: il documento X è 20% argomento a, 40% argomento b e 40% argomento c.
Il post di oggi partirà introducendo la Latent Dirichlet Allocation (LDA). LDA è un topic model probabilistico e tratta i documenti come un bag-of-words, quindi per prima cosa esplorerai vantaggi e svantaggi di questo approccio.
Dall'altra parte, lda2vec costruisce rappresentazioni dei documenti sopra i word embedding. Imparerai di più sui word embedding e sul perché oggi sono il mattone di base preferito nei modelli di elaborazione del linguaggio naturale (NLP).
Infine, scoprirai meglio l'idea generale alla base di lda2vec.
Un topic model prende una collezione di documenti non etichettati e prova a trovare la struttura o gli argomenti in questa collezione. Nota che i topic model spesso assumono che l'uso delle parole sia correlato alla presenza degli argomenti. Potresti, per esempio, fornire a un topic model un insieme di articoli di giornale e il topic model dividerà i documenti in un certo numero di cluster in base all'uso delle parole.
I topic model sono un ottimo modo per esplorare e strutturare automaticamente un grande insieme di documenti: raggruppano o clusterizzano i documenti in base alle parole che contengono. Poiché i documenti su argomenti simili tendono a usare un sotto-vocabolario simile, i cluster risultanti possono essere interpretati come discussioni su diversi "argomenti".
La Latent Dirichlet Allocation (LDA) è un esempio di topic model probabilistico. Cosa significhi esattamente lo imparerai nelle sezioni seguenti: per prima cosa capirai come LDA parte da una descrizione bag-of-words per rappresentare i diversi documenti. Poi vedrai come queste rappresentazioni vengono usate per trovare la struttura nella collezione di documenti.
Tradizionalmente, i documenti testuali vengono rappresentati in NLP come un bag-of-words.
Ciò significa che ogni documento è rappresentato come un vettore di lunghezza fissa con lunghezza uguale alla dimensione del vocabolario. Ogni dimensione di questo vettore corrisponde al conteggio o alla presenza di una parola in un documento. Ridurre documenti di lunghezza variabile a vettori di lunghezza fissa li rende più adatti all'uso con un'ampia varietà di modelli e compiti di machine learning (ML) (clustering, classificazione, ...).
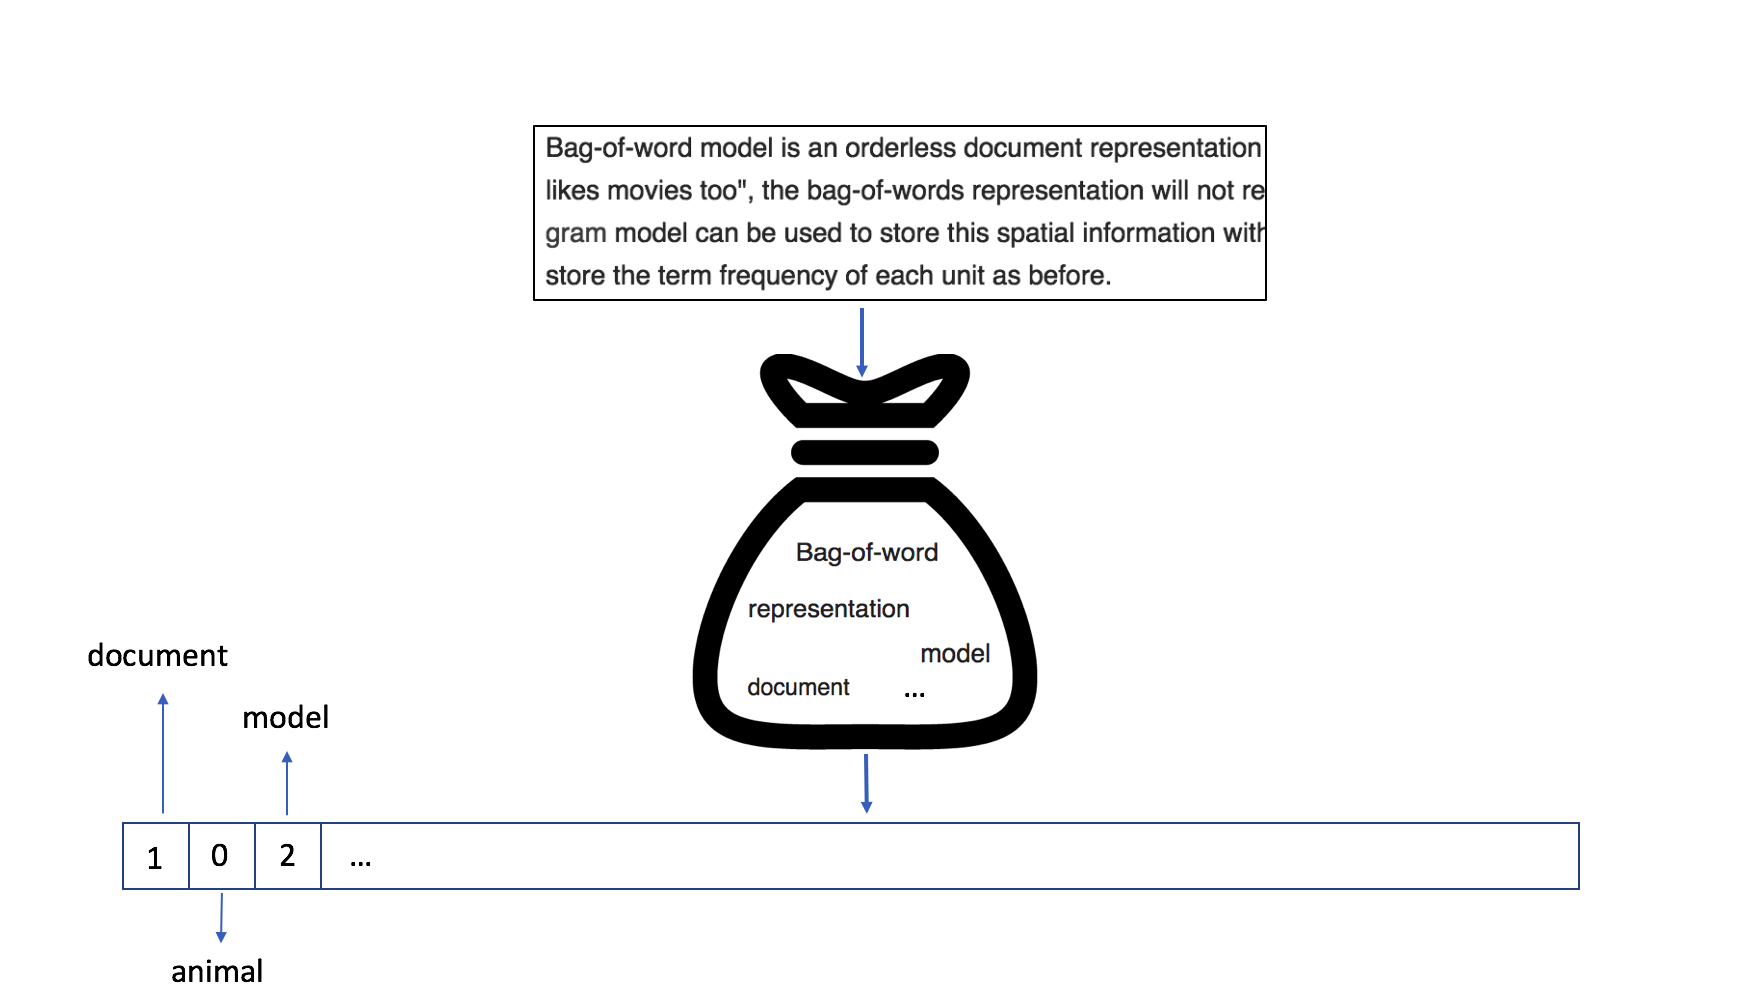
L'immagine sopra illustra come un documento è rappresentato in un modello bag-of-words: la parola "document" ha un conteggio di 1, mentre la parola "model" ricorre due volte nel testo.
Anche se il bag-of-words produce una rappresentazione del documento sparsa e ad alta dimensionalità, spesso si ottengono buoni risultati nella classificazione per argomenti se sono disponibili molti dati. Puoi sempre leggere il recente paper di Facebook sulla classificazione per argomenti.
Una rappresentazione del documento a lunghezza fissa significa che puoi facilmente dare in pasto ai modelli ML (SVM, k-NN, Random Forest, ...) documenti di lunghezza variabile. Questo ti consente di effettuare clustering o classificazione per argomenti sui documenti. L'informazione strutturale del documento viene rimossa e i modelli devono scoprire quali dimensioni del vettore sono semanticamente simili. Mappare, per esempio, "feline" e "cat" su dimensioni diverse è meno intuitivo, poiché il modello è costretto a imparare la correlazione tra queste dimensioni differenti.
Quando addestri un modello LDA, parti da una collezione di documenti e ognuno di questi è rappresentato da un vettore a lunghezza fissa (bag-of-words). LDA è una tecnica generale di Machine Learning (ML), il che significa che può essere utilizzata anche per altri problemi ML non supervisionati in cui l'input è una collezione di vettori a lunghezza fissa e l'obiettivo è esplorare la struttura di questi dati.
Per implementare un modello LDA, inizi definendo il numero di "argomenti" presenti nella tua collezione di documenti. Sembra semplice, ma è spesso meno intuitivo di quanto sembri se stai lavorando con grandi quantità di documenti.
Addestrare un modello LDA su $$N$$ documenti con $$M$$ argomenti corrisponde a trovare i vettori di documento e di argomento che spiegano meglio i dati.
Nota che questo tutorial non tratterà in dettaglio tutta la teoria dietro LDA (vedi questo paper di Blei et al. per quello), poiché l'obiettivo è trasmettere l'idea generale.
Supponi che il vocabolario nei documenti consista di $$V$$ parole. 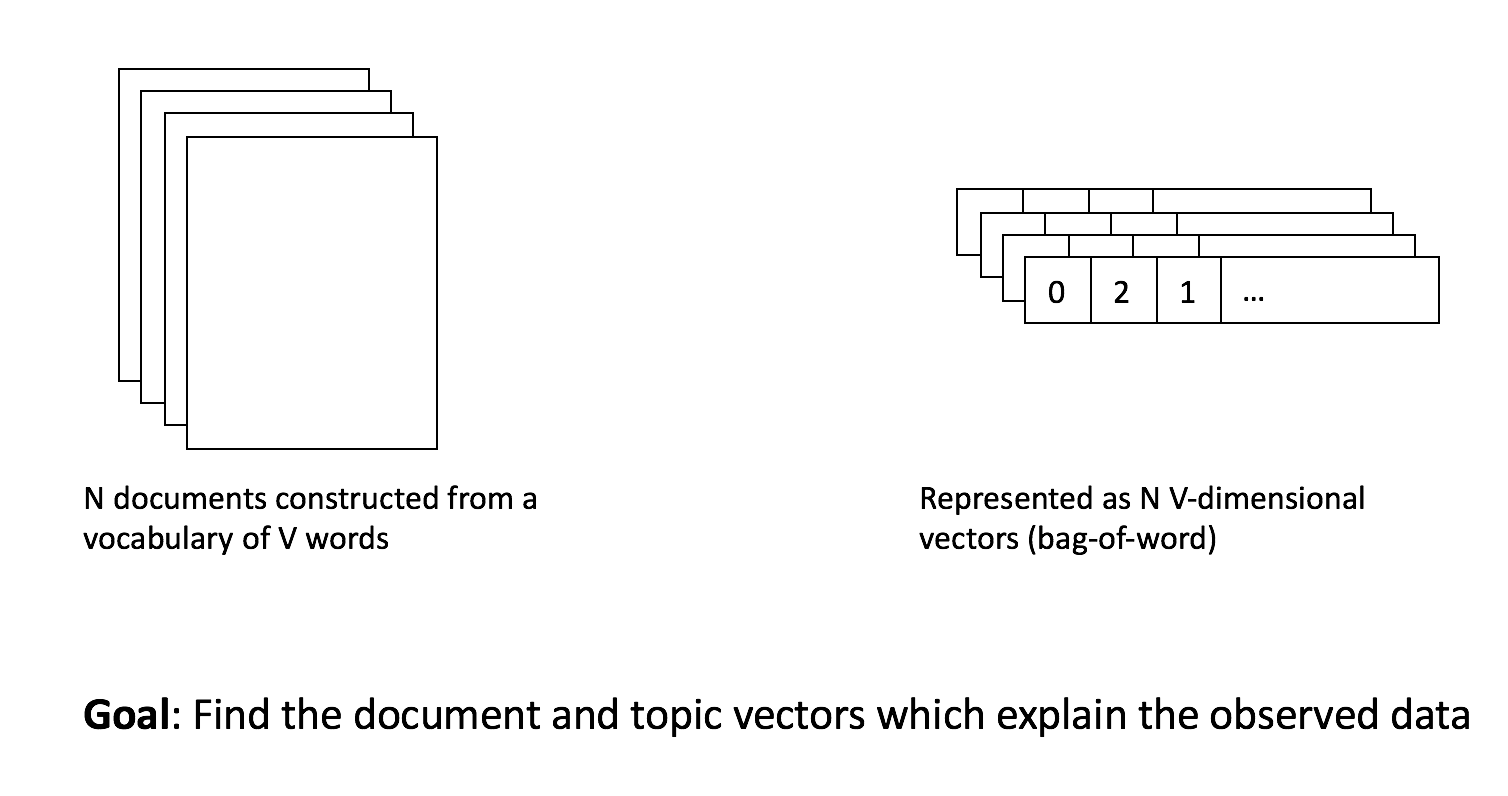
Ognuno dei $$N$$ documenti sarà rappresentato nel modello LDA da un vettore di lunghezza $$M$$ che dettaglia quali argomenti compaiono in quel documento. Un documento può essere composto per il 75% da "argomento 1" e per il 25% da "argomento 2". Spesso, LDA produce vettori di documento con molti zeri, il che significa che solo un numero limitato di argomenti compare per documento. Questo corrisponde all'idea che i documenti tipicamente trattino solo un numero limitato di argomenti. Ciò migliora significativamente l'interpretabilità umana di questi vettori di documento.
Ognuno dei $$M$$ argomenti è rappresentato da un vettore di lunghezza $$V$$ che dettaglia quali parole è probabile che compaiano, dato un documento su quell'argomento. Quindi, per l'argomento 1, "learning", "modelling" e "statistics" potrebbero essere alcune delle parole più comuni. Questo significa che potresti dire che si tratta dell'argomento "data science". Per l'argomento 2, le parole "GPU", "compute" e "storage" potrebbero essere le più comuni. Potresti interpretarlo come l'argomento "computing".
L'immagine seguente illustra visivamente il modello LDA. L'obiettivo del modello è trovare i vettori di argomento e di documento che spieghino l'originaria rappresentazione bag-of-words dei diversi documenti. 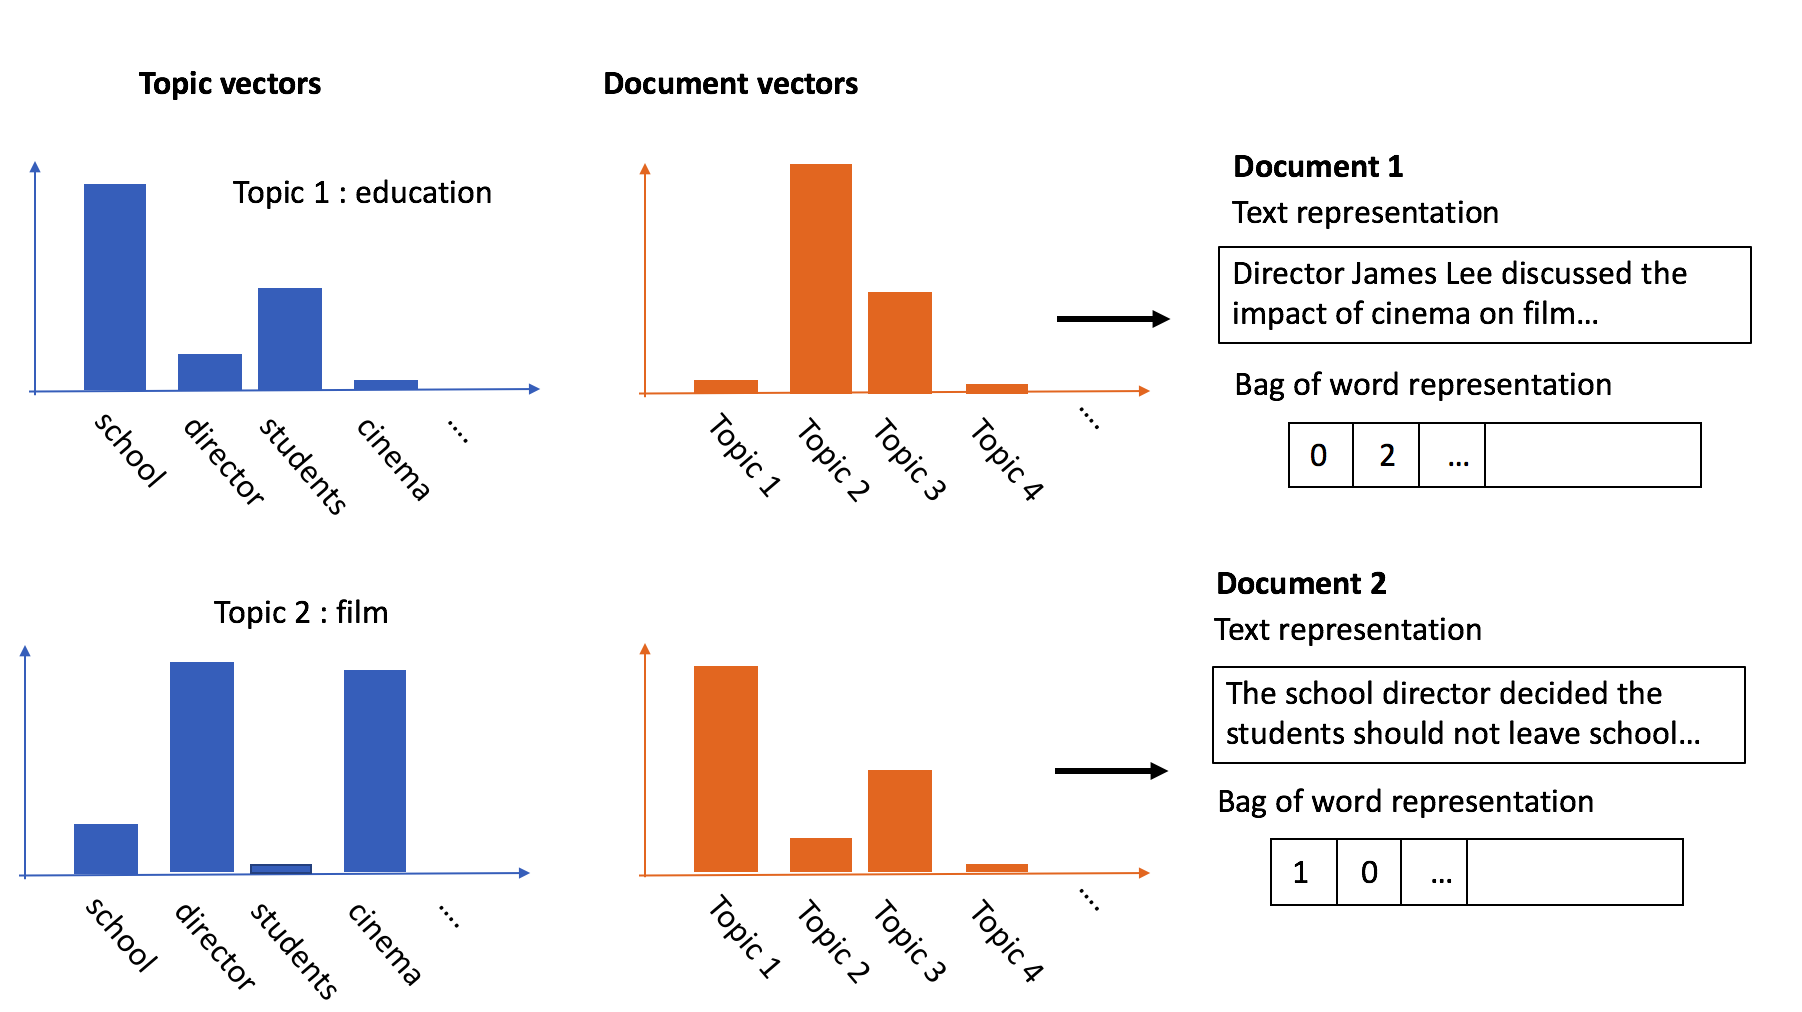
È importante notare che stai facendo affidamento sull'assunzione che i vettori di argomento saranno interpretabili, altrimenti l'output del modello è praticamente spazzatura. In sostanza, stai assumendo che il modello, con abbastanza dati, capirà quali parole tendono a co-occorre e le raggrupperà in "argomenti" distinti.
LDA è un semplice modello probabilistico che tende a funzionare piuttosto bene. I vettori di documento sono spesso sparsi, a bassa dimensionalità e altamente interpretabili, mettendo in evidenza pattern e struttura nei documenti. Devi determinare una buona stima del numero di argomenti presenti nella collezione di documenti. Inoltre, devi assegnare manualmente un'etichetta distinta/"argomento" ai diversi vettori di argomento. Poiché per rappresentare i documenti si usa un modello bag-of-words, LDA può soffrire degli stessi svantaggi del bag-of-words. Il modello LDA apprende un vettore di documento che predice le parole all'interno di quel documento ignorando qualsiasi struttura o come queste parole interagiscono a livello locale.
Uno dei problemi della rappresentazione bag-of-words è che il modello deve capire quali dimensioni nei vettori di documento sono semanticamente correlate. Si può immaginare che sfruttare le informazioni su come le parole sono semanticamente correlate tra loro migliori le prestazioni di un modello, ed è esattamente ciò che promettono i word embedding.
Con i word embedding, le parole sono rappresentate come vettori a lunghezza fissa o embedding. Esistono diversi modelli per costruire embedding, ma sono tutti basati sull'ipotesi distribuzionale. Significa che "una parola è caratterizzata dalla compagnia che tiene".
L'obiettivo dei word embedding è catturare regolarità semantiche e sintattiche nel linguaggio a partire da grandi insiemi non supervisionati di documenti, come Wikipedia. Le parole che compaiono nello stesso contesto sono rappresentate da vettori in stretta prossimità tra loro.
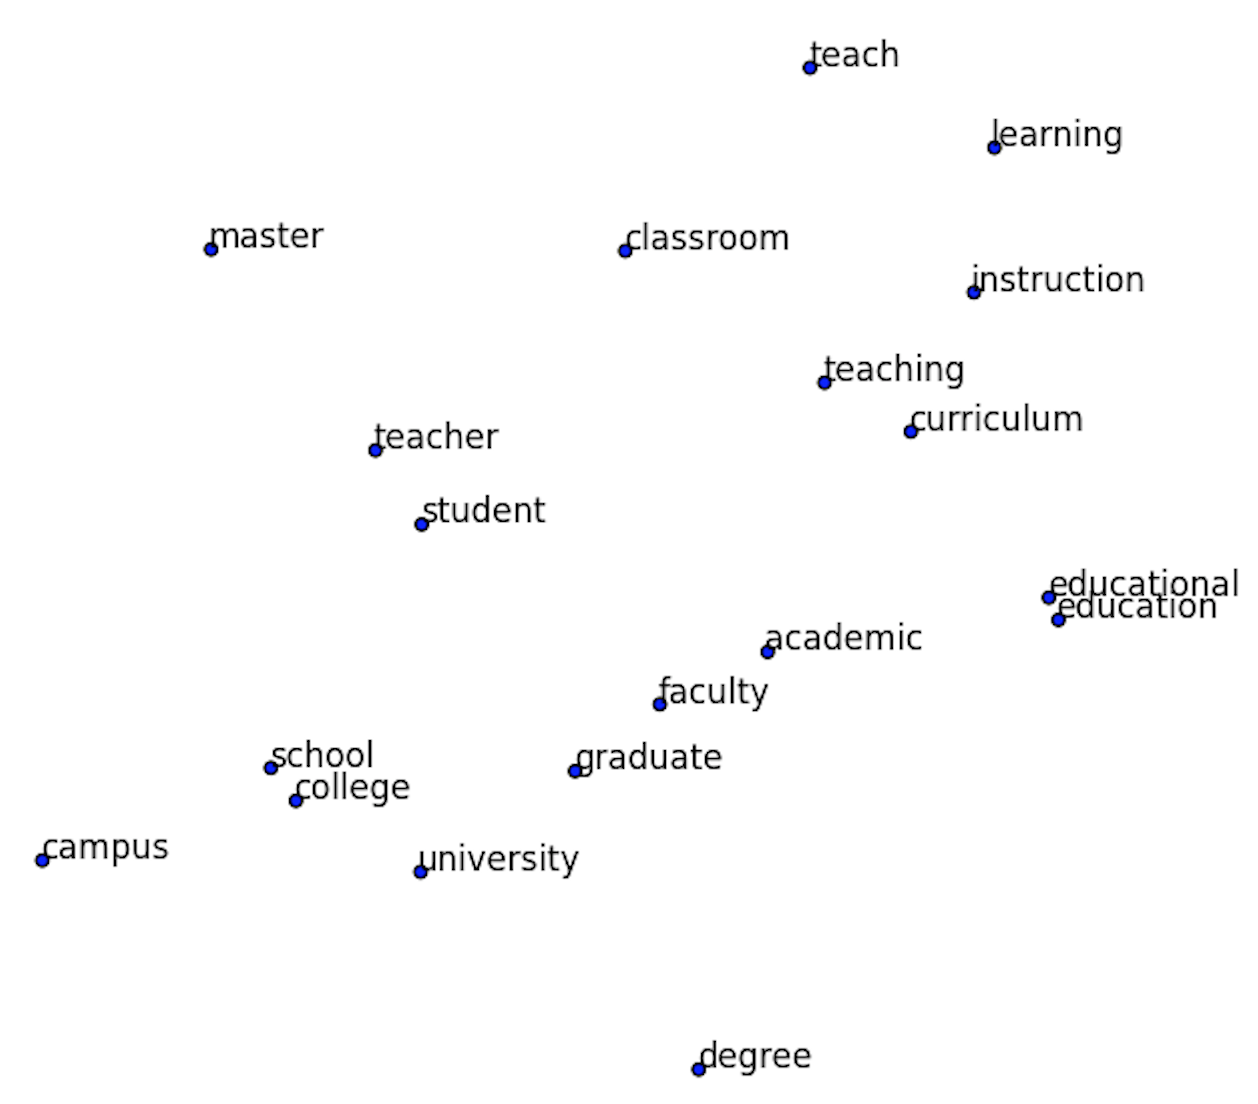
Immagine tratta da "Visualizing Word Embeddings with t-SNE"
L'immagine sopra è una proiezione dello spazio degli embedding di parole in 2D usando t-Distributed Stochastic Neighbor Embedding (t-SNE). t-SNE è un metodo di riduzione della dimensionalità che puoi usare per visualizzare dati ad alta dimensionalità. Il metodo prende gli embedding di parole come input e li proietta in uno spazio bidimensionale, facilmente visualizzabile in un grafico. Viene indagata solo una sottosezione dello spazio delle parole, concentrandosi su parole vicine a "teacher". Invece di rappresentare le parole con dimensioni poco informative in un vettore, con i word embedding le parole possono essere rappresentate da vettori semanticamente correlati.
Usando i word embedding, un modello ML può sfruttare informazioni da una grande collezione di documenti, anche detta "corpus", incorporandole nelle rappresentazioni vettoriali. Questo non è possibile con i modelli bag-of-words, il che può penalizzare le prestazioni del modello quando non sono disponibili molti dati. I word embedding portano a rappresentazioni dei documenti che non sono più a lunghezza fissa. Invece, i documenti sono rappresentati da una sequenza a lunghezza variabile di embedding di parole. Sebbene alcune tecniche di deep learning, come le Long Short-Term Memory (LSTM), le reti convoluzionali con pooling adattivo, ..., siano in grado di gestire sequenze a lunghezza variabile, spesso è necessario un grande quantitativo di dati per addestrarle correttamente.
Come hai letto nell'introduzione, word2vec è un modello di word embedding molto popolare, sviluppato da Mikolov et al. Nota che esistono diversi altri modelli di word embedding nell'ambito della semantica distribuzionale. Sebbene siano necessari diversi accorgimenti per ottenere embedding di alta qualità, questo tutorial si concentrerà solo sull'idea di base dietro word2vec.
La seguente procedura di addestramento è usata in word2vec per ottenere i word embedding.
Seleziona una parola (pivot) nel testo. Le parole di contesto dell'attuale parola pivot sono le parole che compaiono intorno alla parola pivot. Ciò significa che stai lavorando all'interno di una finestra di parole a lunghezza fissa. Le combinazioni di parola pivot e parole di contesto costituiscono un insieme di coppie parola-contesto. L'immagine sotto è tratta dal blog di Chris Moody su lda2vec. In questo frammento di testo, "awesome" è la parola pivot e le parole intorno vengono prese come parole di contesto, risultando in 7 coppie parola-contesto. 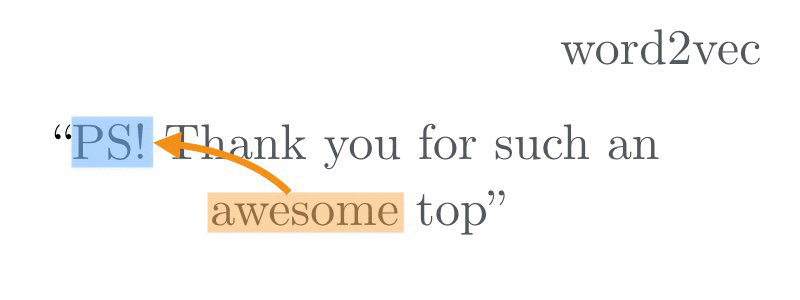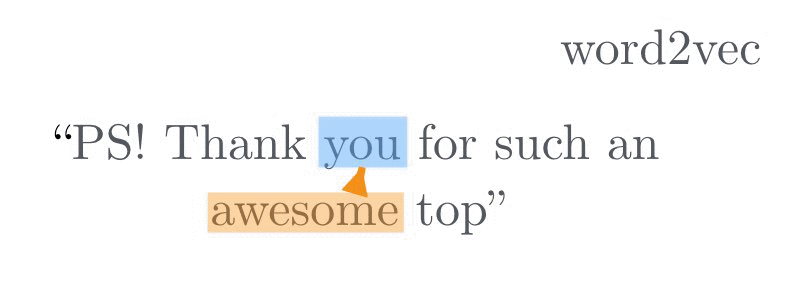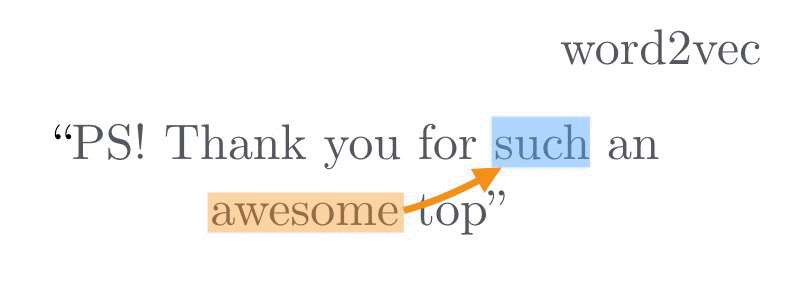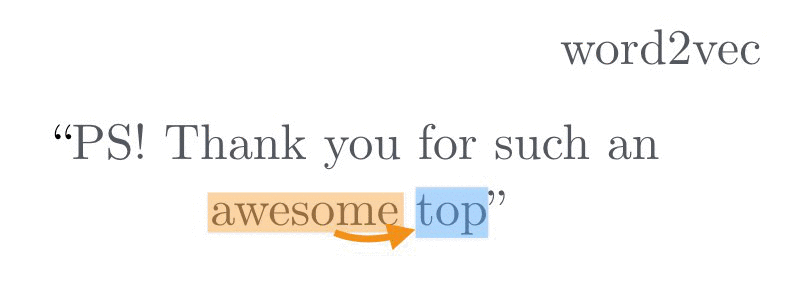
Esistono due varianti del modello word2vec: a. Nell'architettura continuous bag-of-words (CBOW) la parola pivot è predetta in base a un insieme di parole di contesto circostanti (cioè dato 'thank', 'such', 'you', 'top' il modello deve predire 'awesome'). Si chiama architettura bag-of-words perché l'ordine delle parole di contesto non conta. b. Nell'architettura skip-gram, la parola pivot è usata per predire le parole di contesto circostanti (cioè dato 'awesome' predire 'thank', 'such', 'you', 'top'). L'immagine seguente rappresenta le due diverse architetture di word2vec. Nota che viene usato un modello neurale relativamente semplice (a due livelli) (rispetto ai modelli neurali profondi nella visione artificiale).
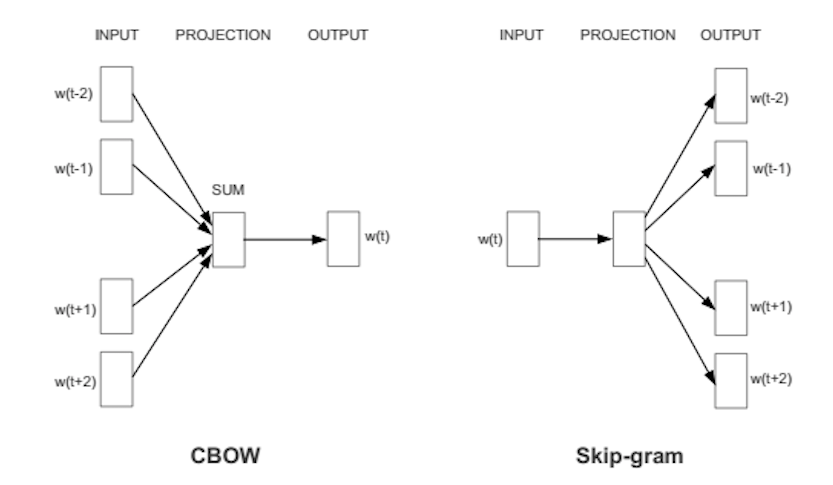
Addestrando il modello su un grande corpus, otterrai word embedding (i pesi nello strato di proiezione) che codificano informazioni semantiche e anche alcune proprietà interessanti: è possibile eseguire aritmetica vettoriale, come $$king - man + woman = queen$$.
I word vector sono una rappresentazione utile rispetto, per esempio, a una semplice rappresentazione one-hot. Consentono di incorporare informazioni statistiche da un grande corpus in altri modelli, come la classificazione per argomenti o i sistemi di dialogo. I word vector sono spesso densi, ad alta dimensionalità e non interpretabili. Considera il seguente esempio: [ -0.65, -1.223, ..., -0.252, +3.2]. Mentre in LDA le dimensioni corrispondono approssimativamente agli argomenti, questo tipicamente non è il caso per i word vector. A ogni parola è assegnato un word vector indipendente dal contesto. Il significato semantico delle parole è però altamente dipendente dal contesto. Il modello word2vec apprende un word vector che predice parole di contesto in diversi documenti. Di conseguenza, le informazioni specifiche del documento si mescolano nei word embedding.
Ispirandosi alla Latent Dirichlet Allocation (LDA), il modello word2vec viene esteso per apprendere simultaneamente vettori di parola, di documento e di argomento.
Lda2vec si ottiene modificando la variante skip-gram di word2vec. Nel metodo skip-gram originale, il modello è addestrato a predire le parole di contesto sulla base di una parola pivot. In lda2vec, il vettore della parola pivot e un vettore di documento vengono sommati per ottenere un vettore di contesto. Questo vettore di contesto è poi usato per predire le parole di contesto.
Nella prossima sezione vedrai come questi vettori di documento sono costruiti e come possono essere usati in modo simile ai vettori di documento in LDA.
L'idea di integrare vettori di contesto nel modello word2vec non è nuova. I paragraph vector, per esempio, hanno esplorato questa idea per apprendere rappresentazioni a lunghezza fissa di frammenti di testo a lunghezza variabile. Nel loro lavoro, per ogni frammento di testo (delle dimensioni di un paragrafo) si apprende una rappresentazione vettoriale densa, simile ai word vector appresi.
Lo svantaggio di questo approccio è che i vettori di contesto/paragrafo assomigliano ai tipici word vector, rendendoli meno interpretabili rispetto, per esempio, all'output di LDA.
Il modello lda2vec va un passo oltre l'approccio dei paragraph vector lavorando con frammenti di testo della dimensione di un documento e scomponendo i vettori di documento in due componenti diversi. Nello stesso spirito del modello LDA, un vettore di documento è scomposto in un vettore di pesi del documento e in una matrice di argomenti. Il vettore di pesi del documento rappresenta la percentuale dei diversi argomenti, mentre la matrice di argomenti è composta dai diversi vettori di argomento. Un vettore di contesto è quindi costruito combinando i diversi vettori di argomento che compaiono in un documento.
Considera il seguente esempio: nel modello word2vec originale, se la parola pivot è "French", allora possibili parole di contesto potrebbero essere "German", "Dutch", "English". Senza alcuna informazione globale (relativa al documento), queste sarebbero le ipotesi più plausibili.
Fornendo un ulteriore vettore di contesto nel modello lda2vec, è possibile fare ipotesi migliori sulle parole di contesto.
Se il vettore di documento è una combinazione degli argomenti "cibo" e "bevande", allora "baguette", "cheese" e "wine" potrebbero essere più adatti. Se il vettore di documento è simile agli argomenti "città" e "geografia", allora "Paris", "Lyon" e "Grenoble" potrebbero essere più adatti.
Nota che questi vettori di argomento sono appresi nello spazio delle parole, il che consente un'interpretazione semplice: guardi semplicemente i word vector più vicini ai vettori di argomento. Inoltre, si impongono vincoli ai vettori di pesi dei documenti, per ottenere un vettore sparso (simile a LDA), invece che denso. Questo abilita un'interpretazione semplice del contenuto di argomento dei diversi documenti.
In breve, il risultato finale di lda2vec è un insieme di vettori di pesi dei documenti sparsi, oltre a vettori di argomento facilmente interpretabili.
Anche se le prestazioni tendono a essere simili all'LDA tradizionale, l'uso di metodi di differenziazione automatica rende il metodo scalabile a dataset molto vasti. Inoltre, combinando il vettore di contesto e il word vector, ottieni word vector "specializzati", che possono essere usati in altri modelli (e potrebbero superare word vector più "generici").
Lda2vec è una tecnica NLP relativamente nuova e specializzata. Poiché si basa su metodi esistenti, qualsiasi implementazione di word2vec potrebbe essere estesa in lda2vec. Chris Moody ha implementato il metodo in Chainer, ma si potrebbero usare anche altri framework di differenziazione automatica (CNTK, Theano, ...). Una implementazione in Tensorflow è stata anche resa pubblicamente disponibile.
Una panoramica del modulo Python lda2vec si trova qui. Poiché l'addestramento di lda2vec può essere computazionalmente intensivo, si raccomanda il supporto GPU per corpora di grandi dimensioni. Inoltre, per velocizzare l'addestramento, i diversi word vector vengono spesso inizializzati con vettori word2vec pre-addestrati.
Infine, lda2vec è stato discusso come topic model, ma l'idea di aggiungere vettori di contesto al modello word2vec può anche essere definita più in generale. Considera per esempio documenti scritti da autori diversi provenienti da regioni diverse. Allora si potrebbero aggiungere anche vettori di autore e di regione al vettore di contesto, ottenendo un metodo non supervisionato per ricavare rappresentazioni vettoriali di documento, regione e autore.
Questo post ha fornito solo una rapida panoramica di LDA, word2vec e lda2vec. Nota che l'autore originale ha pubblicato anche un ottimo post sui dettagli tecnici di lda2vec.
Scopri di più sul Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



