Curso
Comprender el machine learning
2 h
308K
Esta entrada te presenta lda2vec, un modelo de temas publicado por Chris Moody en 2016. lda2vec amplía el modelo word2vec, descrito por Mikolov et al. en 2013, añadiendo vectores de tema y de documento e incorporando ideas tanto de los word embeddings como de los modelos de temas.
El objetivo general de un modelo de temas es generar representaciones de documentos interpretables que permitan descubrir los temas o la estructura en una colección de documentos sin etiquetar. Un ejemplo de representación interpretable sería: el documento X es un 20% tema a, 40% tema b y 40% tema c.
Hoy empezaremos presentando Latent Dirichlet Allocation (LDA). LDA es un modelo de temas probabilístico y trata los documentos como una bolsa de palabras (bag-of-words), así que primero vas a explorar las ventajas e inconvenientes de este enfoque.
Por otro lado, lda2vec construye representaciones de documentos sobre embeddings de palabras. Verás qué son los embeddings de palabras y por qué hoy son el bloque de construcción preferido en los modelos de procesamiento del lenguaje natural (NLP).
Por último, conocerás la idea general detrás de lda2vec.
Un modelo de temas toma una colección de documentos sin etiquetar e intenta encontrar la estructura o los temas en esa colección. Ten en cuenta que los modelos de temas suelen asumir que el uso de las palabras está correlacionado con la aparición de los temas. Por ejemplo, podrías proporcionar al modelo un conjunto de noticias y este dividiría los documentos en varios grupos según el uso de palabras.
Los modelos de temas son una gran forma de explorar y estructurar automáticamente un conjunto amplio de documentos: agrupan o clusterizan los documentos en función de las palabras que aparecen en ellos. Como los documentos sobre temas similares tienden a usar un sub-vocabulario parecido, los clusters resultantes pueden interpretarse como distintos "temas".
Latent Dirichlet Allocation (LDA) es un ejemplo de modelo de temas probabilístico. Qué significa exactamente, lo verás en las siguientes secciones: primero entenderás cómo LDA parte de una descripción bag-of-words para representar los diferentes documentos. Después, verás cómo se usan estas representaciones para encontrar la estructura en la colección.
Tradicionalmente, en NLP los documentos de texto se representan como una bolsa de palabras.
Esto significa que cada documento se representa como un vector de longitud fija igual al tamaño del vocabulario. Cada dimensión del vector corresponde al conteo o aparición de una palabra en el documento. Poder reducir documentos de longitud variable a vectores de longitud fija los hace más manejables para una gran variedad de modelos y tareas de machine learning (ML) (clustering, clasificación, ...).
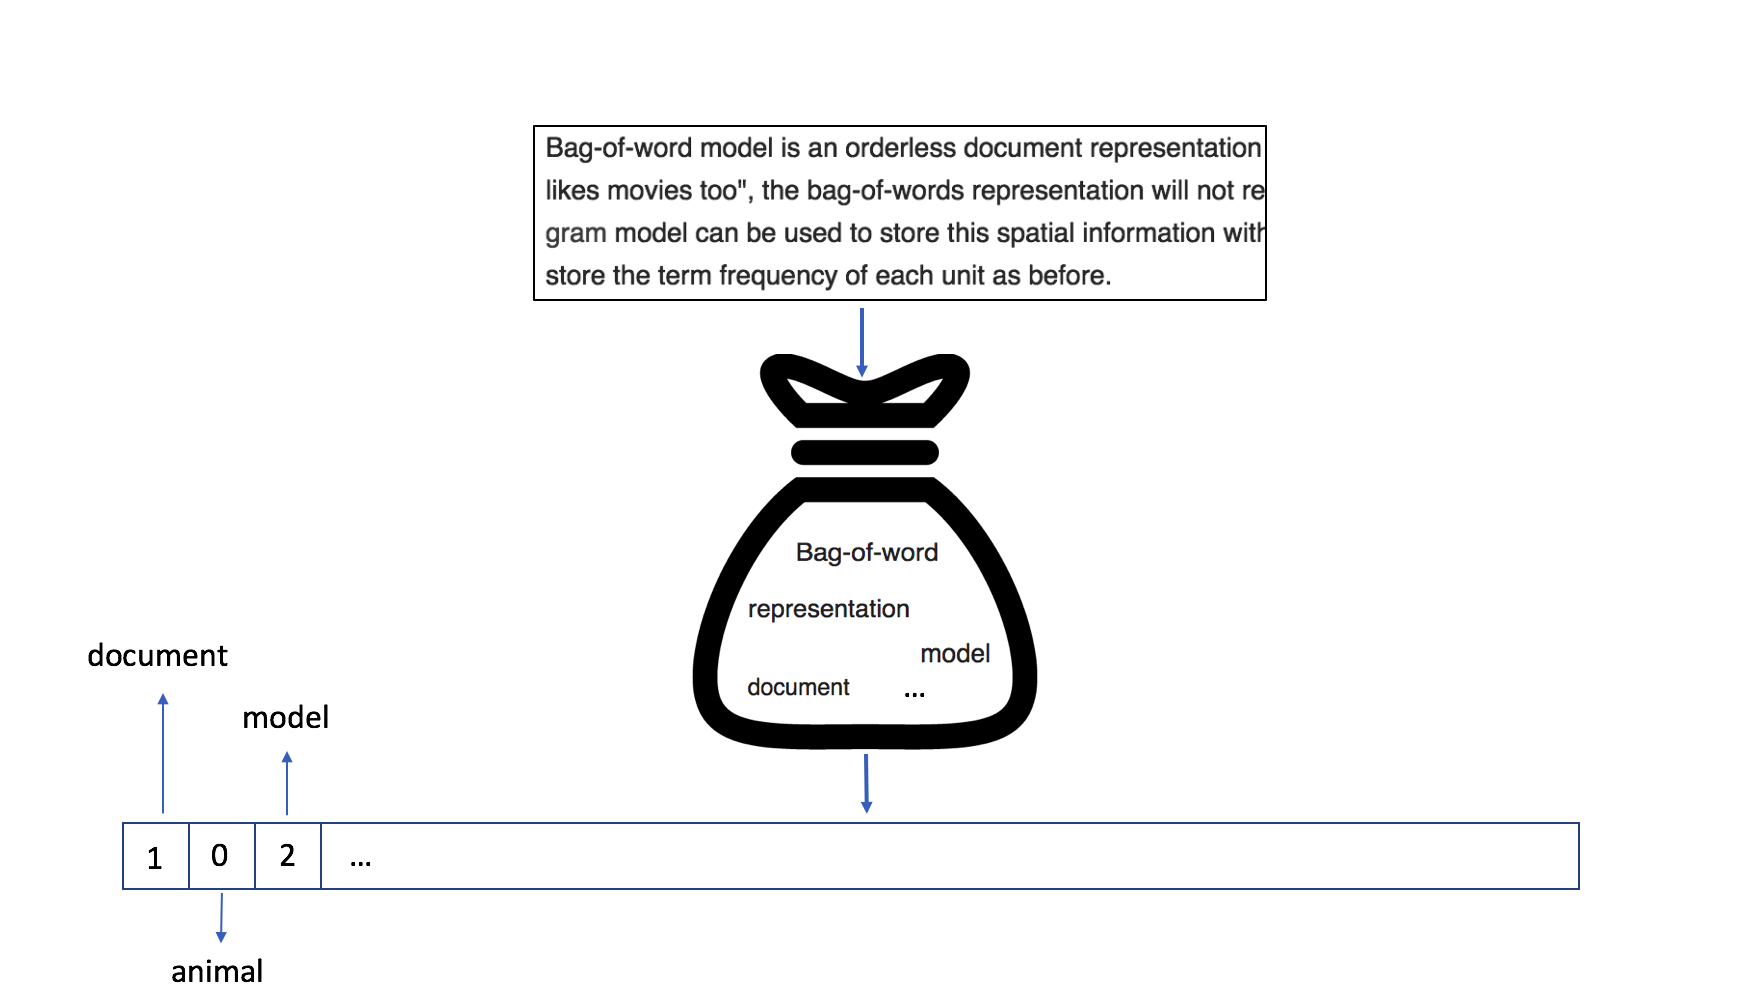
La imagen anterior ilustra cómo se representa un documento en un modelo de bolsa de palabras: la palabra "document" aparece 1 vez, mientras que la palabra "model" aparece dos veces en el texto.
Aunque la bolsa de palabras produce representaciones escasas y de alta dimensión, a menudo se obtienen buenos resultados en clasificación de temas si hay muchos datos disponibles. Puedes echar un vistazo al reciente artículo de Facebook sobre clasificación de temas.
Una representación de documento de longitud fija permite introducir fácilmente en modelos de ML (SVM, k-NN, Random Forests, ...) documentos con longitudes distintas. Esto te permite hacer clustering o clasificación por temas. Se elimina la información estructural del documento y los modelos deben descubrir qué dimensiones del vector son semánticamente similares. Por ejemplo, mapear «feline» y «cat» en dimensiones diferentes es menos intuitivo, ya que el modelo se ve forzado a aprender la correlación entre esas dimensiones.
Al entrenar un modelo LDA, partes de una colección de documentos y cada uno se representa como un vector de longitud fija (bag-of-words). LDA es una técnica general de Machine Learning (ML), lo que significa que también puede aplicarse a otros problemas no supervisados donde la entrada es una colección de vectores de longitud fija y el objetivo es explorar la estructura de los datos.
Para implementar LDA, primero defines el número de "temas" presentes en tu colección de documentos. Suena sencillo, pero suele ser menos intuitivo de lo que parece cuando trabajas con volúmenes masivos de documentos.
Entrenar un modelo LDA con $$N$$ documentos y $$M$$ temas equivale a encontrar los vectores de documento y de tema que mejor expliquen los datos.
Ten en cuenta que este tutorial no cubrirá toda la teoría de LDA en detalle (para eso, consulta este artículo de Blei et al.), ya que el foco está en transmitir la idea general.
Supón que el vocabulario de los documentos consta de $$V$$ palabras. 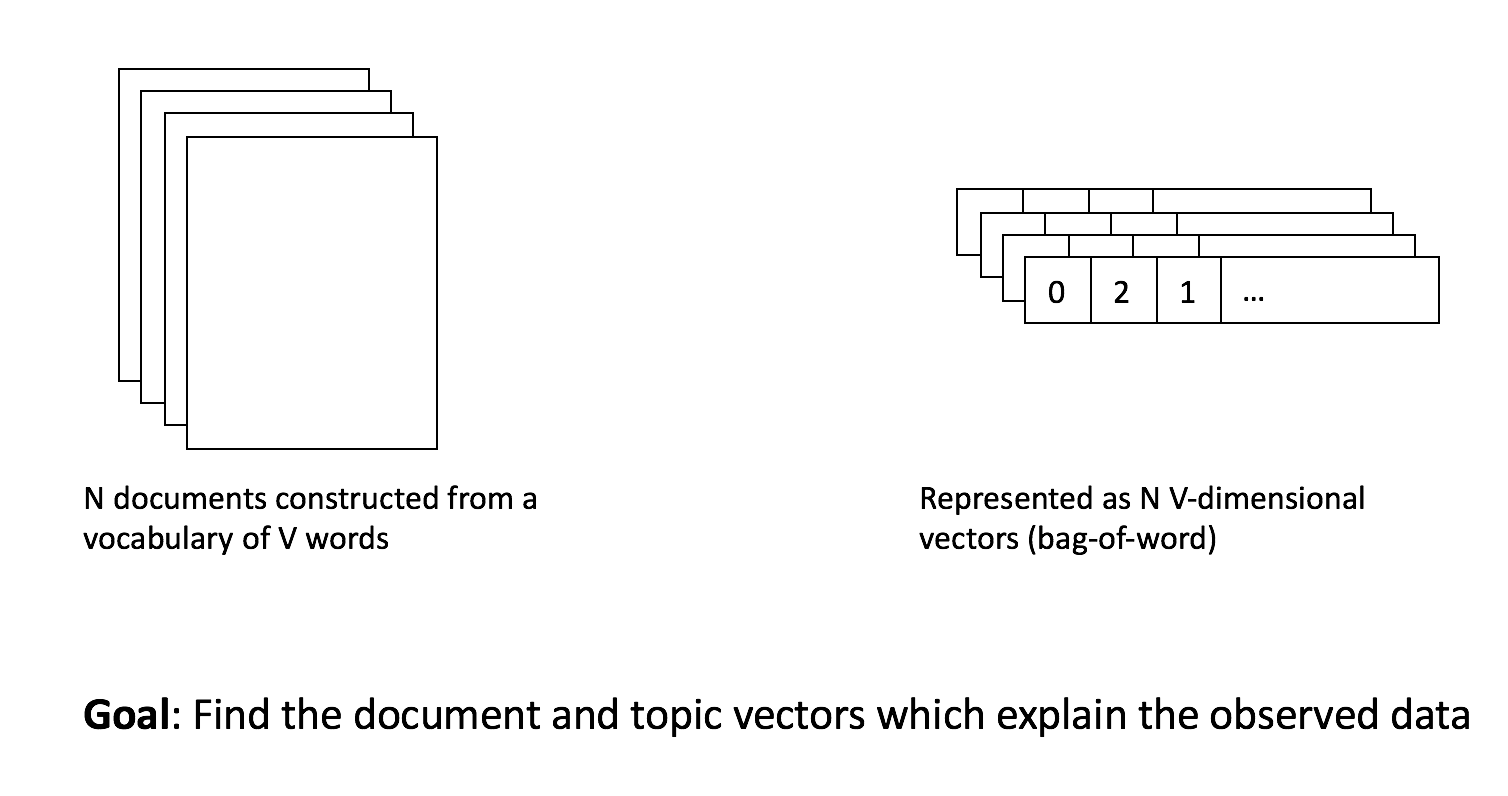
Cada uno de los $$N$$ documentos se representará en LDA por un vector de longitud $$M$$ que detalla qué temas aparecen en ese documento. Un documento puede ser 75% "tema 1" y 25% "tema 2". A menudo, LDA produce vectores de documento con muchos ceros, lo que implica que en cada documento solo aparecen unos pocos temas. Esto encaja con la idea de que los documentos suelen tratar un número limitado de temas y mejora notablemente su interpretabilidad.
Cada uno de los $$M$$ temas se representa con un vector de longitud $$V$$ que indica qué palabras son más probables dado un documento de ese tema. Así, para el tema 1, «learning», «modelling» y «statistics» pueden ser de las palabras más comunes. Podrías decir que es el tema de «data science». Para el tema 2, las palabras «GPU», «compute» y «storage» pueden ser las más comunes; podrías interpretarlo como el tema de «computación».
La siguiente imagen ilustra visualmente el modelo LDA. El objetivo es encontrar los vectores de tema y de documento que expliquen la representación original bag-of-words de los diferentes documentos. 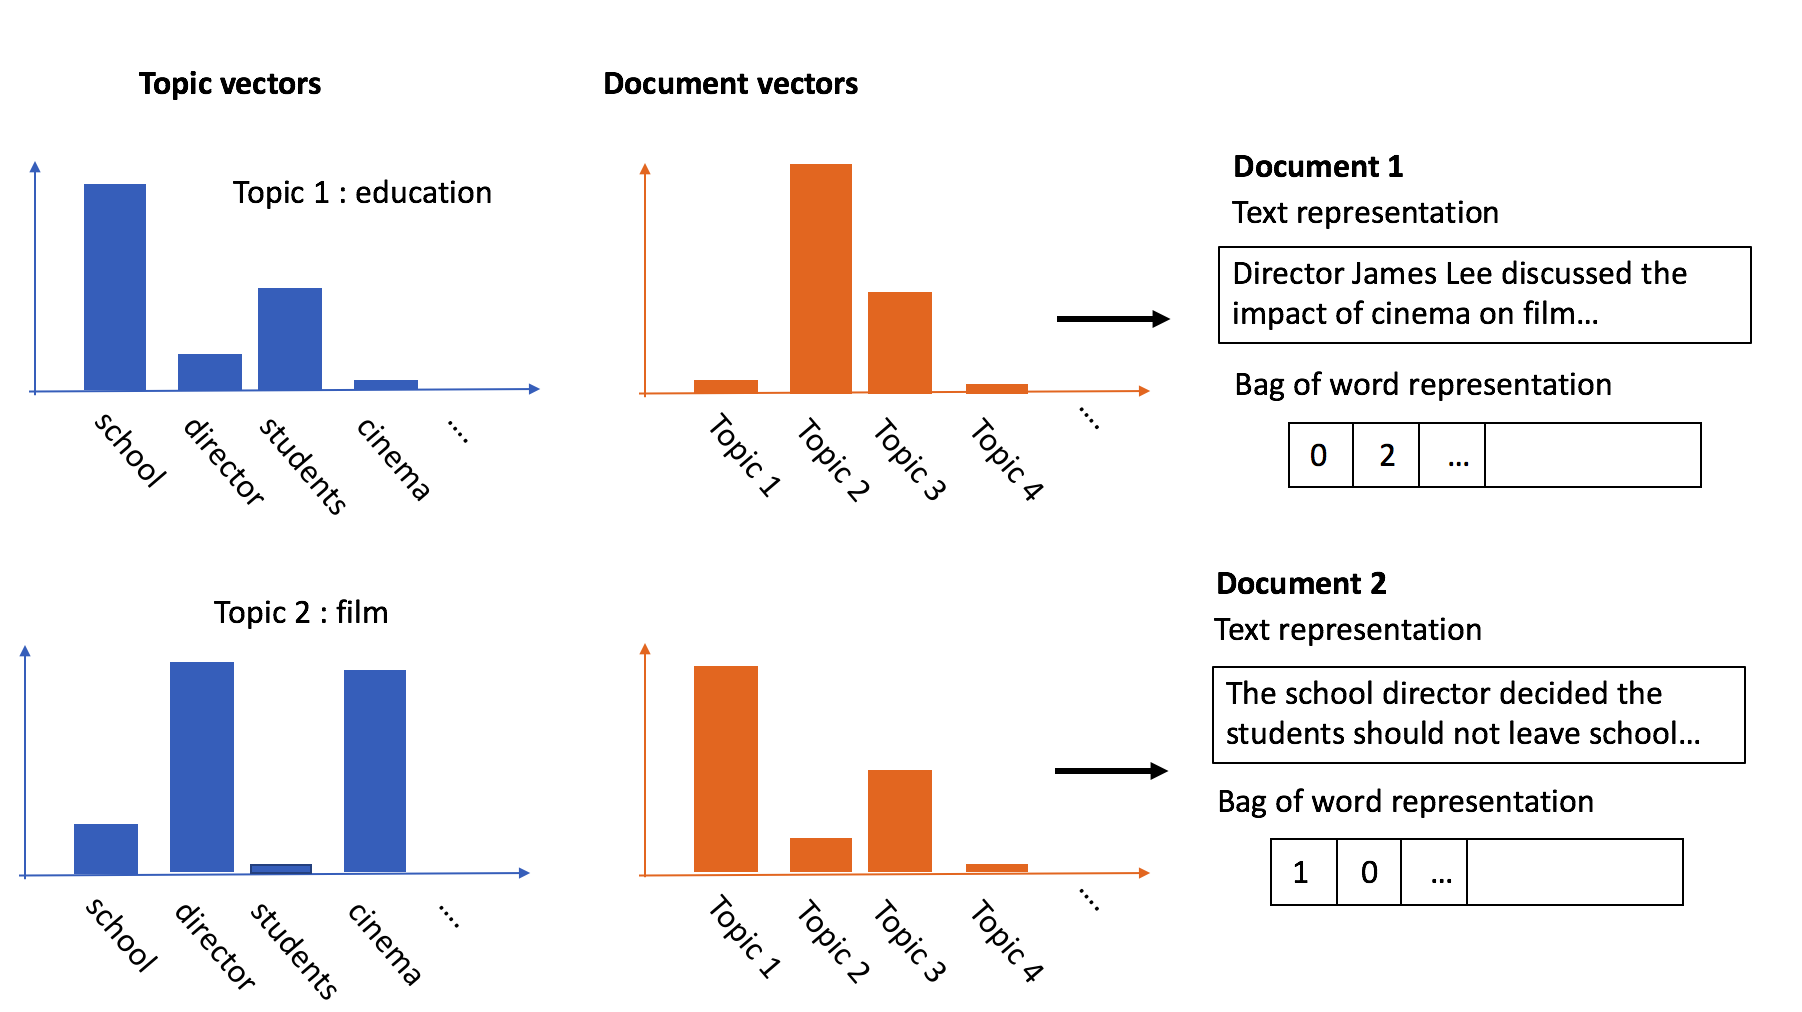
Es importante notar que confías en la suposición de que los vectores de tema serán interpretables; de lo contrario, la salida del modelo no sirve de mucho. En esencia, asumes que el modelo, con suficientes datos, descubrirá qué palabras tienden a coaparecer y las agrupará en «temas» distintos.
LDA es un modelo probabilístico sencillo que suele funcionar bastante bien. Los vectores de documento suelen ser escasos, de baja dimensión y muy interpretables, resaltando patrones y estructura en los textos. Tienes que estimar adecuadamente el número de temas que aparecen en la colección de documentos. Además, debes asignar manualmente una etiqueta/«tema» a cada vector de tema. Como se usa una bolsa de palabras para representar los documentos, LDA puede sufrir los mismos inconvenientes del enfoque bag-of-words. El modelo LDA aprende un vector de documento que predice palabras dentro de ese documento sin tener en cuenta la estructura ni cómo interactúan localmente.
Uno de los problemas de la representación bag-of-words es que el modelo debe averiguar qué dimensiones de los vectores de documento están relacionadas semánticamente. Es razonable pensar que aprovechar cómo se correlacionan semánticamente las palabras mejorará el rendimiento, y eso es justo lo que prometen los word embeddings.
Con los word embeddings, las palabras se representan como vectores de longitud fija o embeddings. Existen varios modelos para construir embeddings, pero todos se basan en la hipótesis distribucional: «una palabra se caracteriza por las compañías que frecuenta».
El objetivo de los word embeddings es capturar regularidades semánticas y sintácticas del lenguaje a partir de grandes conjuntos no supervisados, como Wikipedia. Las palabras que aparecen en contextos similares se representan mediante vectores cercanos entre sí.
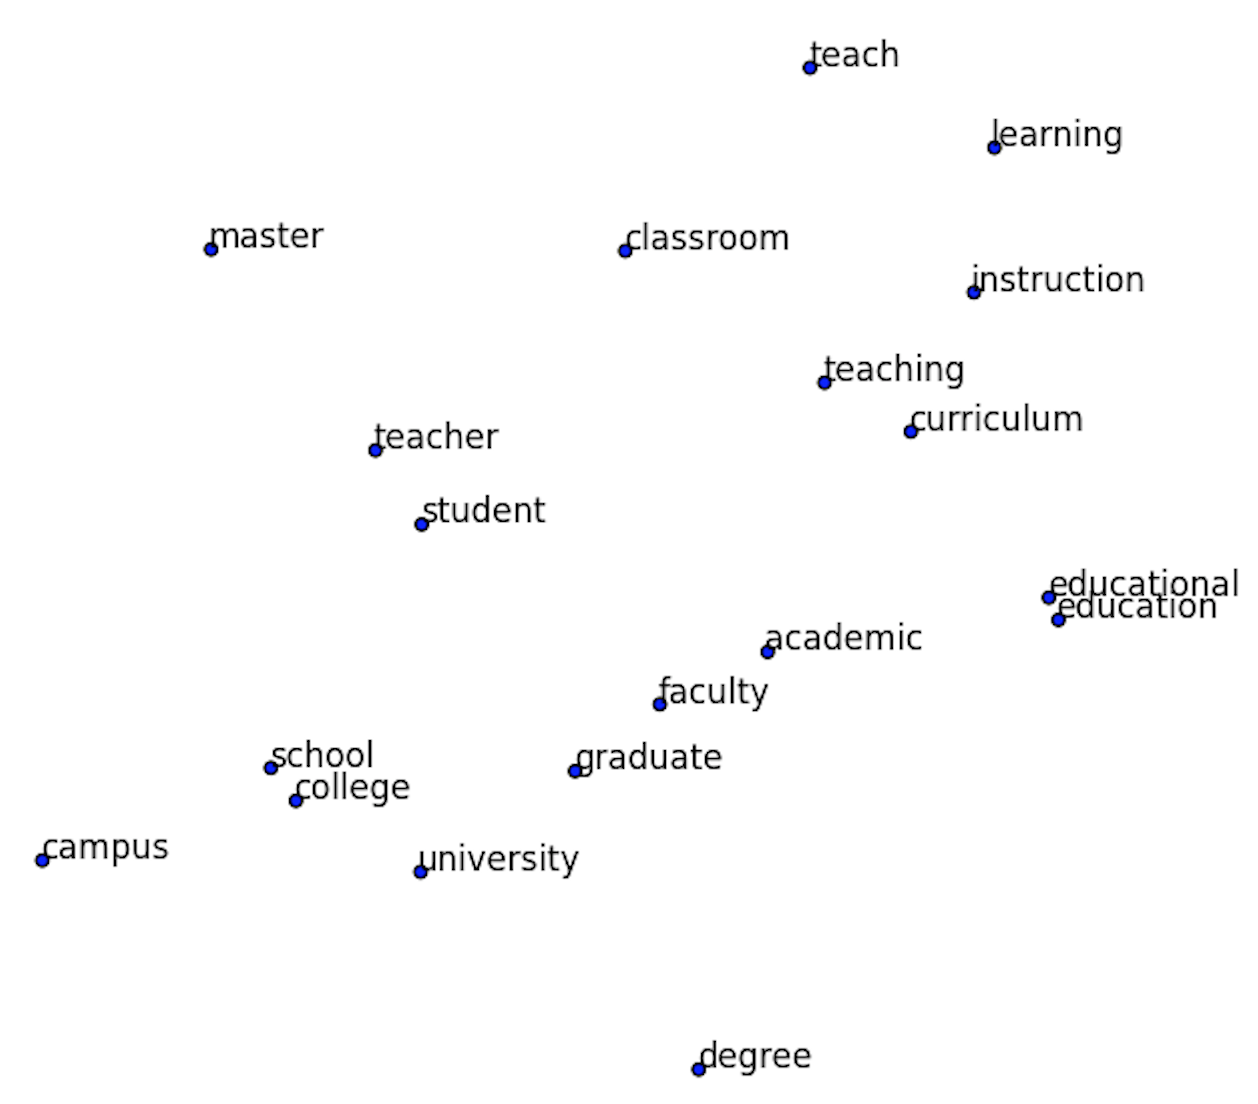
Imagen tomada de "Visualizing Word Embeddings with t-SNE"
La imagen anterior es una proyección del espacio de embeddings de palabras a 2D usando t-Distributed Stochastic Neighbor Embedding (t-SNE). t-SNE es un método de reducción de dimensión que puedes usar para visualizar datos de alta dimensión. Toma los embeddings como entrada y los proyecta a dos dimensiones para poder graficarlos. Solo se explora una subsección del espacio de palabras, centrándose en términos cercanos a «teacher». En lugar de representar palabras con dimensiones poco informativas en un vector, con embeddings las representas con vectores semánticamente correlacionados.
Al usar word embeddings, un modelo de ML puede aprovechar información de un gran conjunto de documentos, también llamado «corpus», ya que esta se incorpora a las representaciones vectoriales. Esto no es posible con bag-of-words y puede perjudicar el rendimiento cuando no hay muchos datos. Los embeddings conducen a representaciones de documento que dejan de ser de longitud fija. En su lugar, cada documento se representa como una secuencia de longitud variable de vectores de palabras. Aunque algunas técnicas de deep learning, como las Long Short-Term Memory (LSTM), redes convolucionales con pooling adaptativo, etc., pueden manejar secuencias de longitud variable, a menudo requieren muchos datos para entrenarse bien.
Como leíste en la introducción, word2vec es un modelo de embeddings de palabras muy popular, desarrollado por Mikolov et al. Existen otros modelos de embeddings dentro de la semántica distribucional. Aunque se necesitan varios trucos para obtener embeddings de alta calidad, aquí nos centraremos en la idea principal detrás de word2vec.
El procedimiento de entrenamiento en word2vec para obtener los embeddings es el siguiente.
Selecciona una palabra (pivote) en el texto. Las palabras de contexto de ese pivote son las que aparecen a su alrededor dentro de una ventana de longitud fija. Las combinaciones de palabra pivote y palabras de contexto forman pares palabra-contexto. La imagen siguiente se tomó del blog de Chris Moody sobre lda2vec. En este fragmento, «awesome» es la palabra pivote y las palabras a su alrededor son el contexto, dando lugar a 7 pares palabra-contexto. 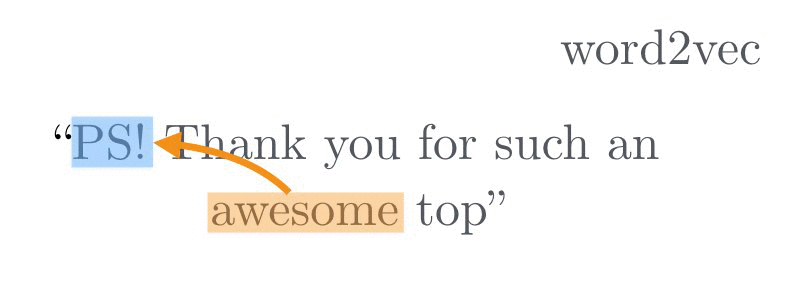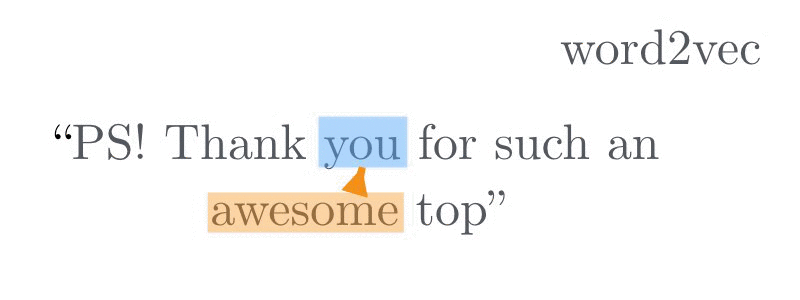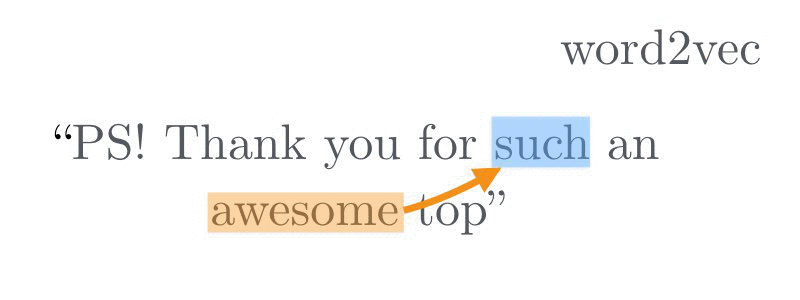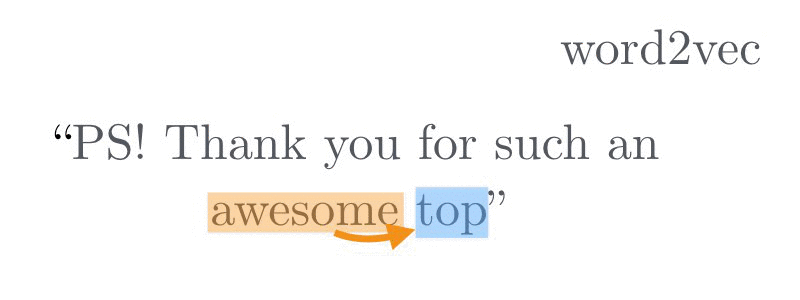
Existen dos variantes de word2vec: a) En la arquitectura bag-of-words (CBOW) se predice la palabra pivote a partir de un conjunto de palabras de contexto (p. ej., dado «thank», «such», «you», «top», el modelo debe predecir «awesome»). Se llama bag-of-words porque el orden del contexto no importa. b) En la arquitectura skip-gram, se usa la palabra pivote para predecir las palabras de contexto (p. ej., dado «awesome» predecir «thank», «such», «you», «top»). La siguiente imagen muestra ambas arquitecturas. Observa que se usa un modelo neuronal relativamente sencillo (dos capas) en comparación con modelos profundos en visión por computador.
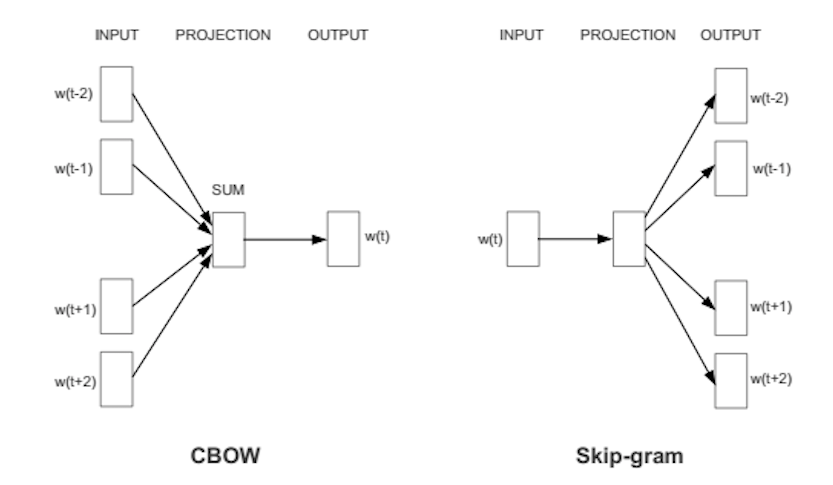
Al entrenar el modelo en un gran corpus, obtendrás embeddings (los pesos en la capa de proyección) que codifican información semántica y propiedades interesantes: es posible realizar aritmética vectorial, como $$king - man + woman = queen$$.
Los vectores de palabras son una representación muy útil frente, por ejemplo, a la codificación one-hot. Permiten incorporar información estadística de un gran corpus en otros modelos, como clasificación de temas o sistemas de diálogo. Los vectores suelen ser densos, de alta dimensión y poco interpretables. Considera el ejemplo: [ -0.65, -1.223, ..., -0.252, +3.2]. Mientras que en LDA las dimensiones se corresponden aproximadamente con temas, esto no suele ocurrir con los word vectors. A cada palabra se le asigna un vector independiente del contexto. Sin embargo, el significado de las palabras depende mucho del contexto. El modelo word2vec aprende un vector que predice palabras de contexto en distintos documentos. Como resultado, la información específica de cada documento se mezcla en los embeddings.
Inspirado en Latent Dirichlet Allocation (LDA), el modelo word2vec se amplía para aprender simultáneamente vectores de palabra, de documento y de tema.
Lda2vec se obtiene modificando la variante skip-gram de word2vec. En el método skip-gram original, el modelo se entrena para predecir palabras de contexto a partir de una palabra pivote. En lda2vec, se suman el vector de la palabra pivote y un vector de documento para obtener un vector de contexto. Este vector de contexto se usa después para predecir las palabras de contexto.
En la siguiente sección verás cómo se construyen estos vectores de documento y cómo pueden usarse de forma similar a los de LDA.
La idea de integrar vectores de contexto en word2vec no es nueva. Por ejemplo, los vectores de párrafo ya exploraron esta idea para aprender representaciones de longitud fija de fragmentos de texto de longitud variable. En su trabajo, para cada fragmento (tamaño párrafo) se aprende una representación densa, similar a los vectores de palabra aprendidos.
La desventaja es que los vectores de contexto/párrafo se parecen a vectores de palabra típicos, lo que los hace menos interpretables que, por ejemplo, la salida de LDA.
El modelo lda2vec va un paso más allá trabajando con fragmentos del tamaño de un documento y descomponiendo los vectores de documento en dos componentes. En la línea de LDA, un vector de documento se descompone en un vector de pesos del documento y una matriz de temas. El vector de pesos representa el porcentaje de cada tema, mientras que la matriz de temas contiene los distintos vectores de tema. El vector de contexto se construye combinando los vectores de tema que aparecen en un documento.
Considera este ejemplo: en el word2vec original, si la palabra pivote es «French», posibles palabras de contexto podrían ser «German», «Dutch», «English». Sin información global (relacionada con el documento), esas serían conjeturas plausibles.
Al aportar un vector de contexto adicional en lda2vec, es posible hacer mejores predicciones de palabras de contexto.
Si el vector de documento combina los temas «food» y «drinks», entonces «baguette», «cheese» y «wine» pueden ser más adecuadas. Si el vector es similar a los temas «city» y «geography», entonces «Paris», «Lyon» y «Grenoble» serían más apropiadas.
Observa que estos vectores de tema se aprenden en el espacio de palabras, lo que permite interpretarlos fácilmente: basta con mirar qué vectores de palabras están más cerca de cada vector de tema. Además, se imponen restricciones a los vectores de pesos del documento para obtener vectores escasos (similares a LDA) en lugar de densos. Esto facilita interpretar el contenido temático de los documentos.
En resumen, el resultado de lda2vec es un conjunto de vectores de pesos de documento escasos y vectores de tema fáciles de interpretar.
Aunque el rendimiento suele ser similar al de LDA tradicional, el uso de métodos de diferenciación automática hace que el método escale a conjuntos de datos muy grandes. Además, al combinar el vector de contexto y el de palabra, obtienes vectores de palabras «especializados» que pueden usarse en otros modelos (y a veces superan a vectores más «genéricos»).
Lda2vec es una técnica de NLP relativamente nueva y especializada. Como se basa en métodos existentes, cualquier implementación de word2vec podría ampliarse a lda2vec. Chris Moody implementó el método en Chainer, pero también podrían usarse otros frameworks de diferenciación automática (CNTK, Theano, ...). Existe una implementación en TensorFlow disponible públicamente.
Encontrarás una descripción general del módulo de Python de lda2vec aquí. Como entrenar lda2vec puede ser costoso computacionalmente, se recomienda usar GPU para corpus grandes. Además, para acelerar el entrenamiento, a menudo se inicializan los vectores de palabras con word2vec preentrenado.
Por último, hemos hablado de lda2vec como modelo de temas, pero la idea de añadir vectores de contexto a word2vec es más general. Imagina documentos escritos por autores de distintas regiones: se podrían añadir también vectores de autor y de región al vector de contexto, dando lugar a un método no supervisado para obtener representaciones vectoriales de documento, región y autor.
Esta entrada solo ofrece una visión rápida de LDA, word2vec y lda2vec. Ten en cuenta que el autor original también publicó una excelente entrada de blog con los detalles técnicos de lda2vec.
Descubre más sobre machine learning
Curso
Curso
Curso
blog
blog
Abid Ali Awan
7 min
blog
Moez Ali
14 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Avinash Navlani
15 min