
Last chance! 50% off DataCamp Premium
Sale ends in
Posting blog ini akan memberi Anda pengantar tentang lda2vec, sebuah model topik yang dipublikasikan oleh Chris Moody pada 2016. lda2vec memperluas model word2vec, yang dideskripsikan oleh Mikolov dkk. pada 2013, dengan vektor topik dan dokumen serta menggabungkan gagasan dari embedding kata dan model topik.
Tujuan umum dari model topik adalah menghasilkan representasi dokumen yang dapat ditafsirkan yang dapat digunakan untuk menemukan topik atau struktur dalam kumpulan dokumen tanpa label. Contoh representasi dokumen yang dapat ditafsirkan: dokumen X terdiri dari 20% topik a, 40% topik b, dan 40% topik c.
Post hari ini akan dimulai dengan memperkenalkan Latent Dirichlet Allocation (LDA). LDA adalah model topik probabilistik dan memperlakukan dokumen sebagai bag-of-words, jadi Anda akan menelusuri terlebih dahulu kelebihan dan kekurangan pendekatan ini.
Di sisi lain, lda2vec membangun representasi dokumen di atas embedding kata. Anda akan mempelajari lebih lanjut tentang embedding kata dan mengapa saat ini menjadi blok bangunan yang disukai dalam model pemrosesan bahasa alami (NLP).
Terakhir, Anda akan mempelajari lebih lanjut tentang gagasan umum di balik lda2vec.
Model topik mengambil kumpulan dokumen tanpa label dan berupaya menemukan struktur atau topik dalam kumpulan tersebut. Perlu dicatat bahwa model topik sering berasumsi bahwa penggunaan kata berkorelasi dengan kemunculan topik. Misalnya, Anda dapat memberikan serangkaian artikel berita kepada model topik dan model tersebut akan membagi dokumen ke dalam sejumlah klaster berdasarkan penggunaan kata.
Model topik adalah cara yang bagus untuk mengeksplorasi dan menstrukturkan sekumpulan besar dokumen secara otomatis: model ini mengelompokkan atau mengklaster dokumen berdasarkan kata-kata yang muncul di dalamnya. Karena dokumen tentang topik serupa cenderung menggunakan sub-kosakata yang serupa, klaster dokumen yang dihasilkan dapat ditafsirkan sebagai membahas 'topik' yang berbeda.
Latent Dirichlet Allocation (LDA) adalah contoh model topik probabilistik. Apa arti tepatnya, akan Anda pelajari di bagian berikut: pertama Anda akan memahami bagaimana LDA memulai dari deskripsi bag-of-words untuk merepresentasikan berbagai dokumen. Lalu, Anda akan melihat bagaimana representasi ini digunakan untuk menemukan struktur dalam koleksi dokumen.
Secara tradisional, dokumen teks direpresentasikan dalam NLP sebagai bag-of-words.
Ini berarti setiap dokumen direpresentasikan sebagai vektor berdimensi tetap dengan panjang sama dengan ukuran kosakata. Setiap dimensi vektor ini berkaitan dengan frekuensi atau kemunculan sebuah kata dalam dokumen. Kemampuan mengubah dokumen berdimensi variabel menjadi vektor berdimensi tetap membuatnya lebih mudah digunakan dengan berbagai macam model dan tugas machine learning (ML) seperti klastering, klasifikasi, dan lainnya.
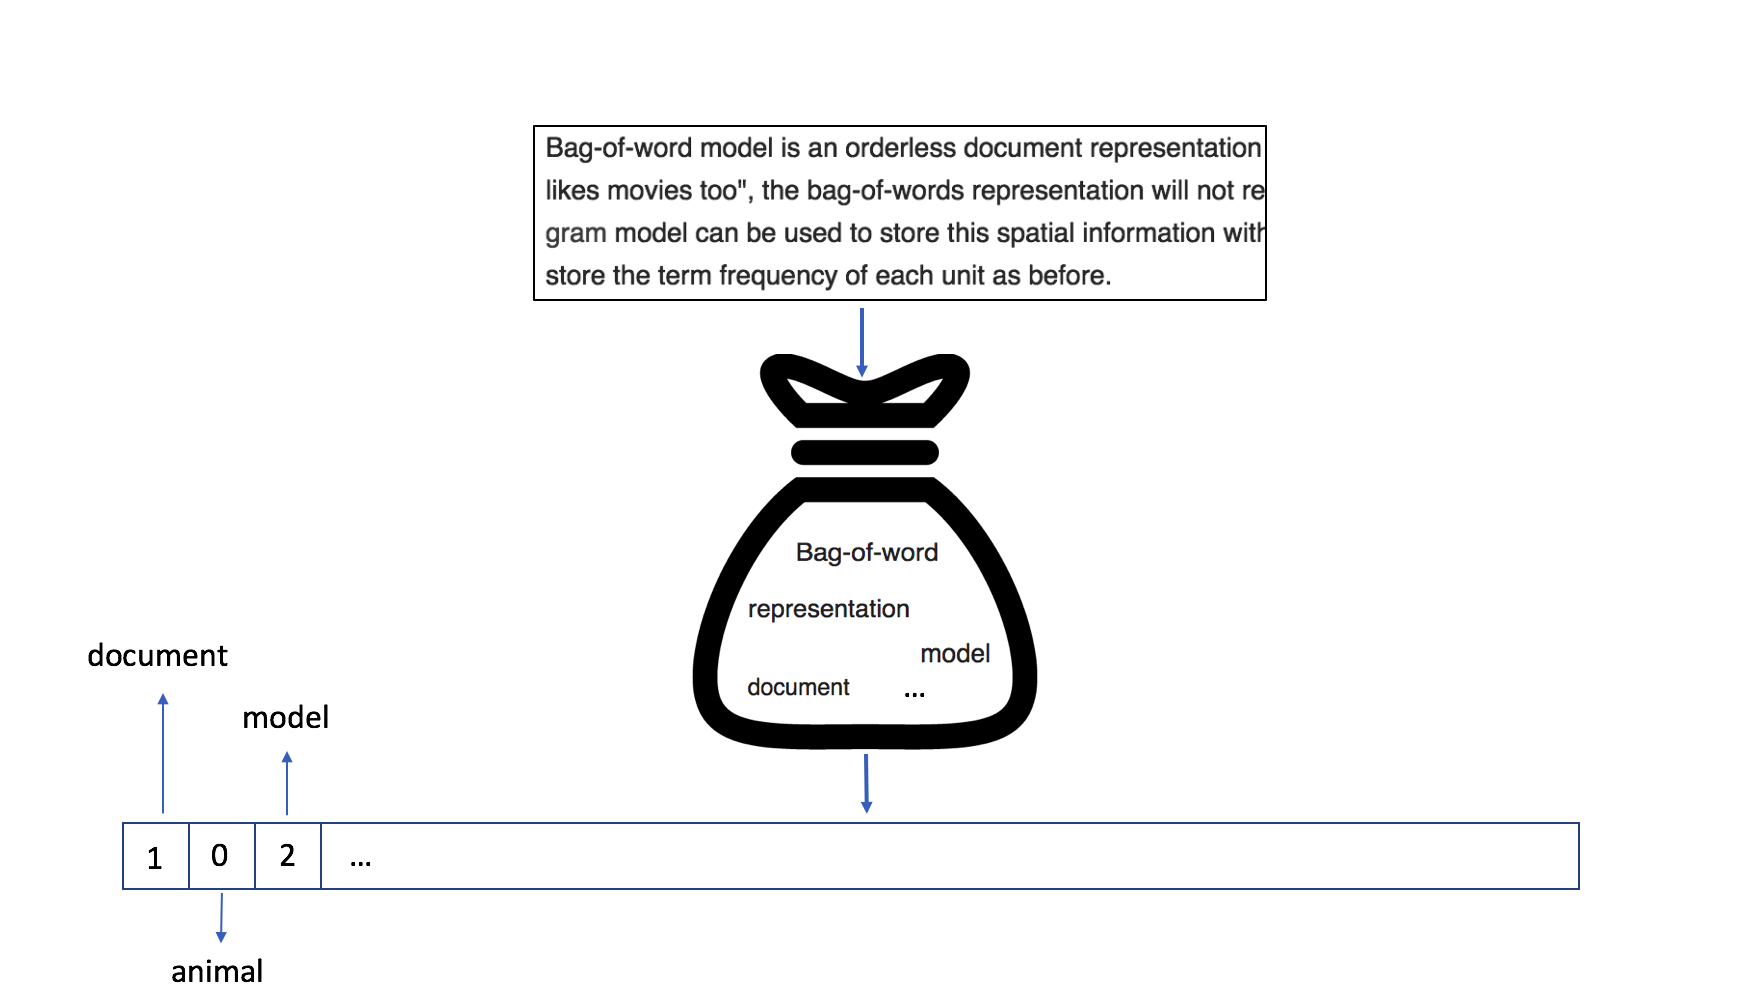
Gambar di atas mengilustrasikan bagaimana sebuah dokumen direpresentasikan dalam model bag-of-words: kata "document" memiliki hitungan 1, sedangkan kata "model" muncul dua kali dalam teks.
Meskipun bag-of-words menghasilkan representasi dokumen yang jarang dan berdimensi tinggi, hasil yang baik pada klasifikasi topik sering diperoleh jika banyak data tersedia. Anda selalu dapat membaca paper Facebook terbaru tentang klasifikasi topik.
Representasi dokumen berdimensi tetap berarti Anda dapat dengan mudah memasukkan dokumen dengan panjang bervariasi ke dalam model ML (SVM, k-NN, Random Forest, ...). Ini memungkinkan Anda melakukan klastering atau klasifikasi topik pada dokumen. Informasi struktural dokumen dihilangkan dan model harus menemukan dimensi vektor mana yang secara semantik serupa. Memetakan misalnya ‘feline’ dan ‘cat’ pada dimensi berbeda kurang intuitif, karena model dipaksa mempelajari korelasi antara dimensi-dimensi ini.
Saat melatih model LDA, Anda mulai dengan kumpulan dokumen dan masing-masing direpresentasikan oleh vektor berdimensi tetap (bag-of-words). LDA adalah teknik Machine Learning (ML) yang umum, yang berarti model ini juga dapat digunakan untuk masalah ML tanpa supervisi lain di mana masukan adalah kumpulan vektor berdimensi tetap dan tujuannya adalah mengeksplorasi struktur data tersebut.
Untuk mengimplementasikan model LDA, Anda terlebih dahulu mulai dengan mendefinisikan jumlah 'topik' yang ada dalam kumpulan dokumen Anda. Ini terdengar lugas, tetapi sering kali kurang intuitif daripada kedengarannya jika Anda bekerja dengan jumlah dokumen yang sangat besar.
Melatih model LDA pada $$N$$ dokumen dengan $$M$$ topik berkaitan dengan menemukan vektor dokumen dan topik yang paling menjelaskan data.
Perlu dicatat bahwa tutorial ini tidak akan membahas teori lengkap di balik LDA secara detail (lihat paper ini oleh Blei dkk. untuk itu), karena fokusnya lebih pada menyampaikan gagasan umum.
Asumsikan bahwa kosakata dalam dokumen terdiri dari $$V$$ kata. 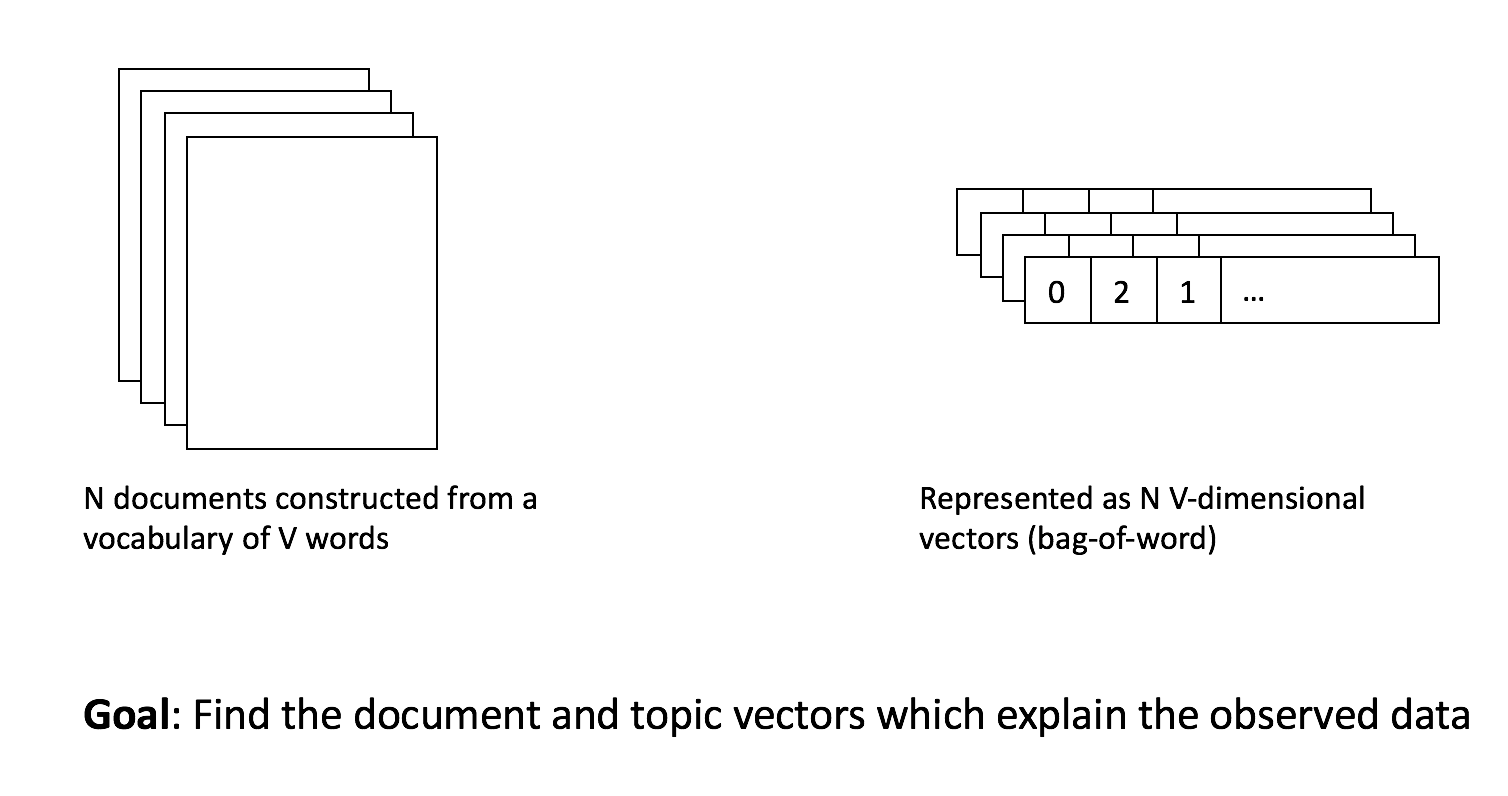
Masing-masing dari $$N$$ dokumen akan direpresentasikan dalam model LDA oleh vektor sepanjang $$M$$ yang merinci topik mana yang muncul dalam dokumen tersebut. Sebuah dokumen bisa terdiri dari 75% ‘topik 1’ dan 25% ‘topik 2’. Sering kali, LDA menghasilkan vektor dokumen dengan banyak nol, yang berarti hanya sejumlah terbatas topik yang muncul per dokumen. Ini sejalan dengan gagasan bahwa dokumen biasanya hanya membahas sejumlah topik terbatas. Hal ini secara signifikan meningkatkan keterjelasan bagi manusia terhadap vektor dokumen tersebut.
Masing-masing dari $$M$$ topik direpresentasikan oleh vektor sepanjang $$V$$ yang merinci kata-kata mana yang kemungkinan muncul, mengingat sebuah dokumen mengenai topik itu. Jadi untuk topik 1, 'learning', 'modelling', dan 'statistics' bisa menjadi beberapa kata yang paling umum. Ini berarti Anda bisa mengatakan bahwa ini adalah topik 'data science'. Untuk topik 2, kata-kata 'GPU', 'compute', dan 'storage' bisa menjadi yang paling umum. Anda bisa menafsirkannya sebagai topik 'computing'.
Gambar berikut mengilustrasikan model LDA secara visual. Tujuan model adalah menemukan vektor topik dan dokumen yang menjelaskan representasi bag-of-words asli dari berbagai dokumen. 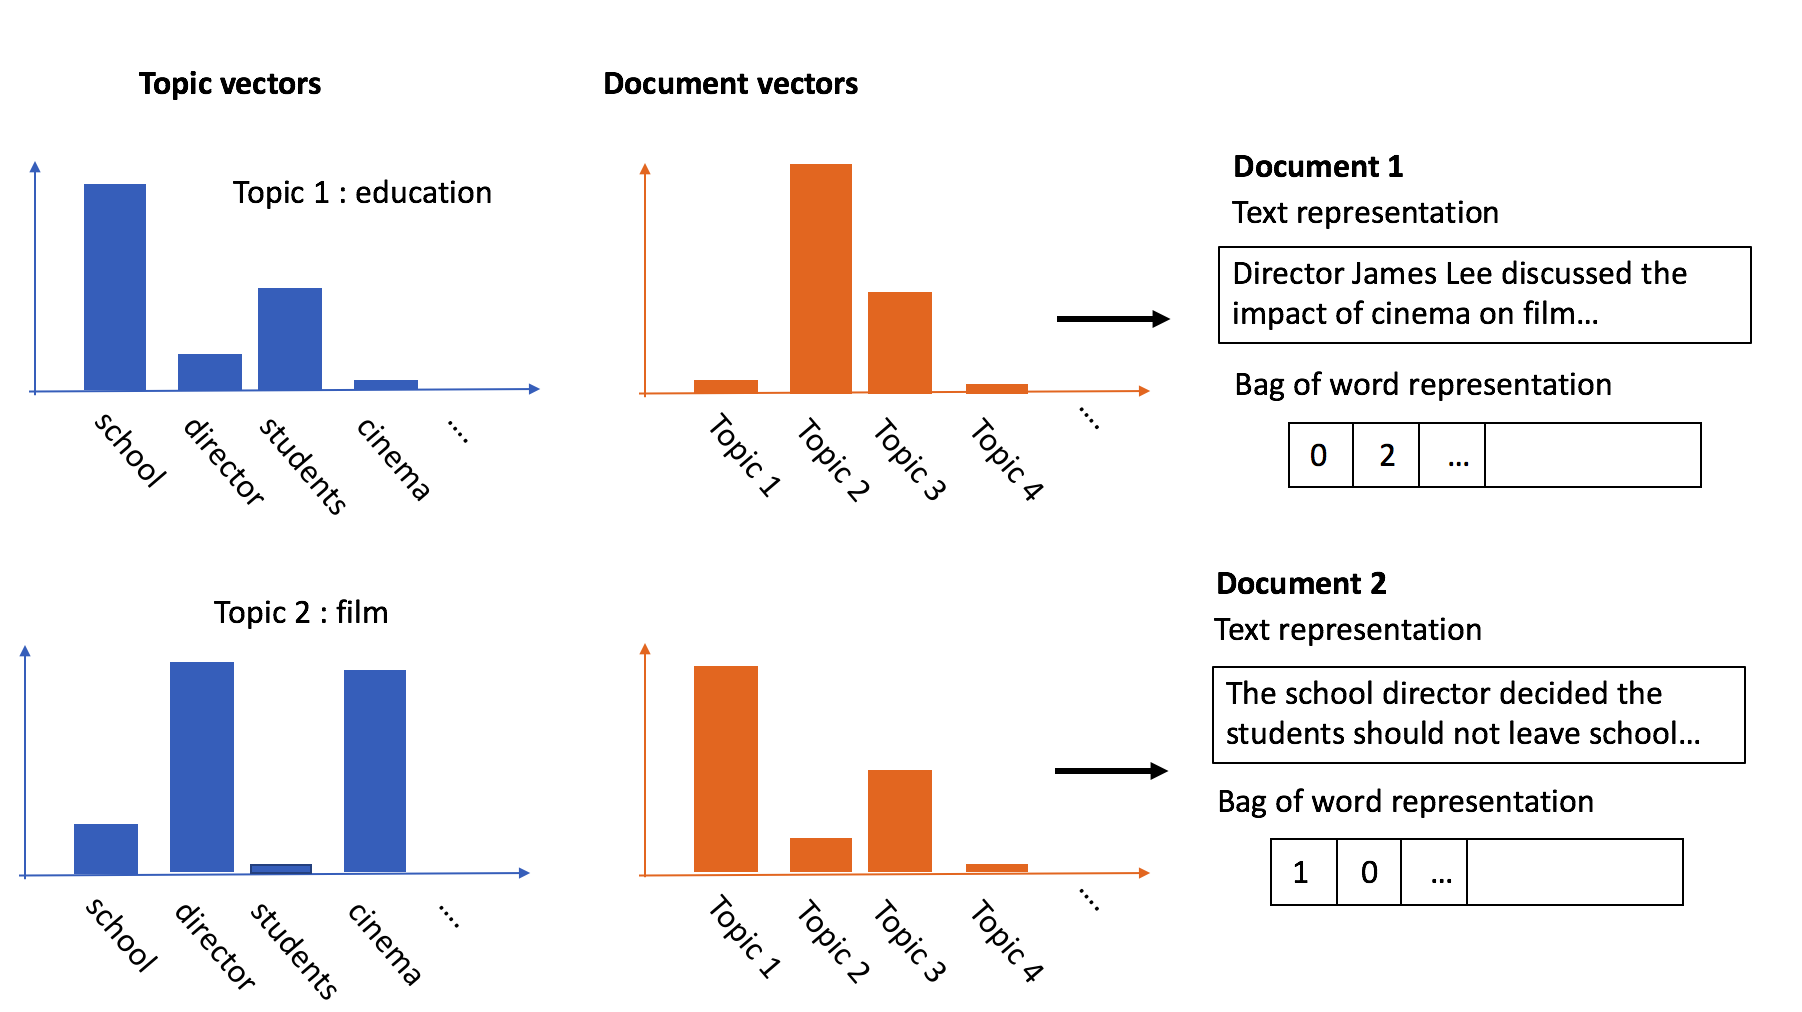
Penting untuk diperhatikan bahwa Anda mengandalkan asumsi bahwa vektor topik akan dapat ditafsirkan, jika tidak, keluaran model akan tidak berguna. Intinya, Anda mengasumsikan bahwa model, dengan data yang cukup, akan menemukan kata-kata yang cenderung muncul bersama, dan akan mengelompokkannya ke dalam 'topik' yang berbeda.
LDA adalah model probabilistik sederhana yang cenderung bekerja cukup baik. Vektor dokumen sering kali jarang, berdimensi rendah, dan sangat dapat ditafsirkan, menonjolkan pola dan struktur dalam dokumen. Anda harus menentukan perkiraan jumlah topik yang baik yang muncul dalam kumpulan dokumen. Selain itu, Anda harus secara manual menetapkan penamaan/‘topik’ yang berbeda pada berbagai vektor topik. Karena model bag-of-words digunakan untuk merepresentasikan dokumen, LDA dapat mengalami kekurangan yang sama seperti model bag-of-words. Model LDA mempelajari vektor dokumen yang memprediksi kata-kata di dalam dokumen tersebut sambil mengabaikan struktur atau bagaimana kata-kata ini berinteraksi pada tingkat lokal.
Salah satu masalah representasi bag-of-words adalah model bertanggung jawab untuk mencari tahu dimensi mana dalam vektor dokumen yang berhubungan secara semantik. Dapat dibayangkan bahwa memanfaatkan informasi tentang bagaimana kata-kata berkorelasi secara semantik satu sama lain akan meningkatkan kinerja model, dan inilah yang dijanjikan oleh word embeddings.
Dengan word embeddings, kata-kata direpresentasikan sebagai vektor berdimensi tetap atau embedding. Ada beberapa model berbeda untuk membangun embedding, tetapi semuanya didasarkan pada hipotesis distribusional. Artinya, "sebuah kata dicirikan oleh lingkungan kata-kata yang menyertainya".
Tujuan word embeddings adalah menangkap keteraturan semantik dan sintaktik dalam bahasa dari kumpulan dokumen tanpa supervisi yang besar, seperti Wikipedia. Kata-kata yang muncul dalam konteks yang sama direpresentasikan oleh vektor yang letaknya berdekatan satu sama lain.
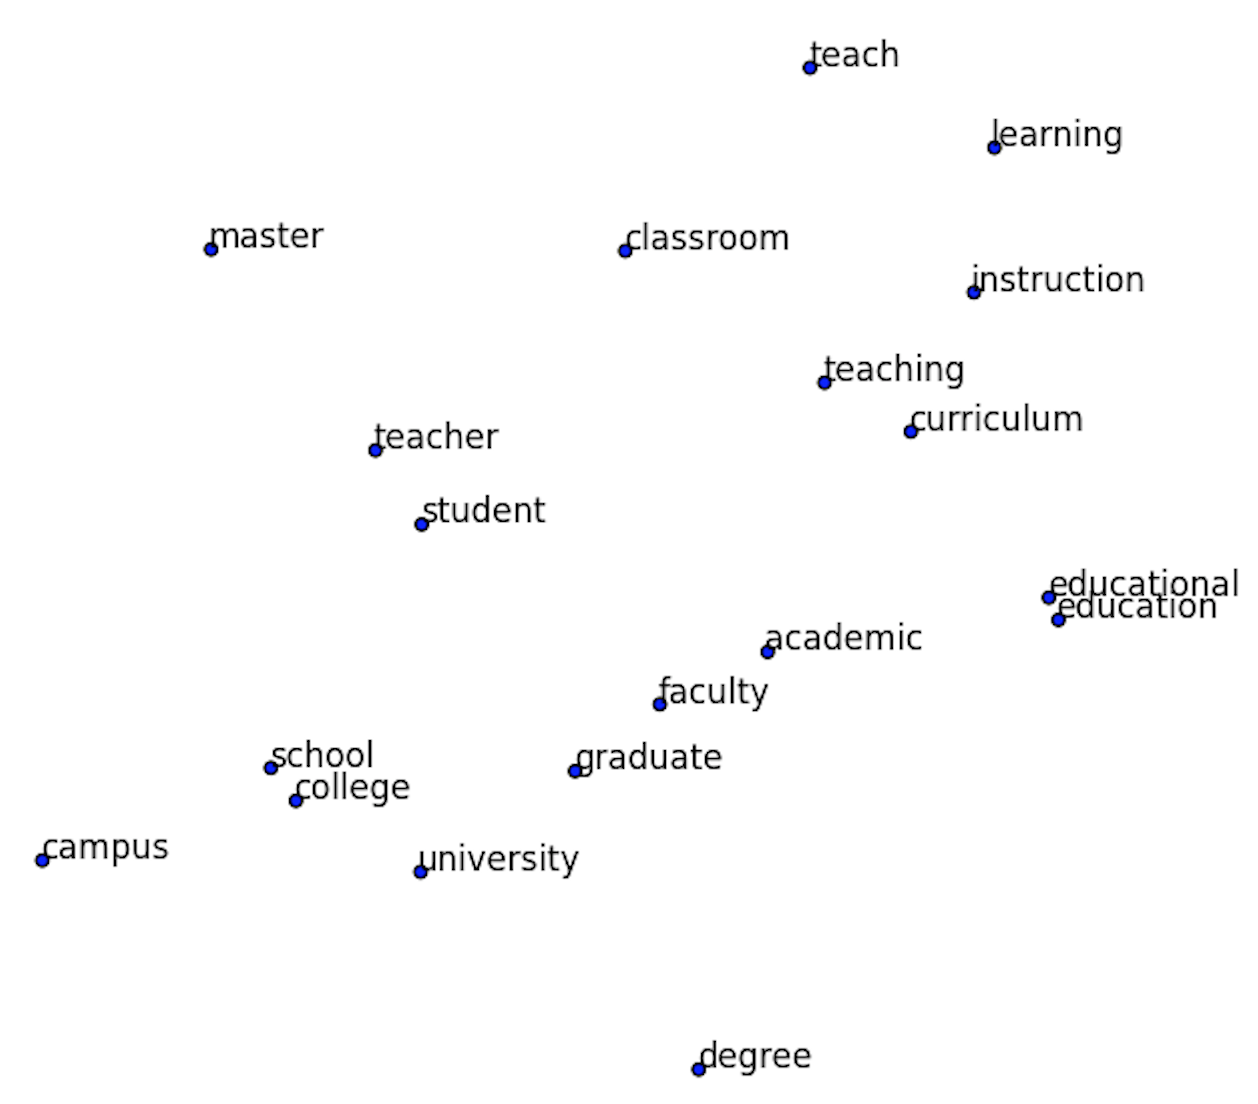
Gambar diambil dari "Visualizing Word Embeddings with t-SNE"
Gambar di atas adalah proyeksi ruang embedding kata ke ruang 2D menggunakan t-Distributed Stochastic Neighbor Embedding (t-SNE). t-SNE adalah metode reduksi dimensi yang dapat Anda gunakan untuk memvisualisasikan data berdimensi tinggi. Metode ini mengambil embedding kata sebagai masukan, dan memproyeksikannya ke ruang dua dimensi yang mudah divisualisasikan dalam plot. Hanya sebagian kecil dari ruang kata yang ditelusuri, berfokus pada kata-kata yang dekat dengan 'teacher’. Alih-alih merepresentasikan kata-kata dengan dimensi yang tidak informatif dalam sebuah vektor, kata-kata dapat direpresentasikan oleh vektor yang berkorelasi secara semantik menggunakan word embeddings.
Saat menggunakan word embeddings, model ML dapat memanfaatkan informasi dari kumpulan dokumen yang besar, juga dikenal sebagai "corpus", dengan menyematkannya dalam representasi vektor. Ini tidak dimungkinkan dengan model bag-of-words, yang dapat merugikan kinerja model ketika tidak banyak data tersedia. Word embeddings menghasilkan representasi dokumen yang tidak lagi berdimensi tetap. Sebaliknya, dokumen direpresentasikan oleh urutan embedding vektor kata berdimensi variabel. Walaupun beberapa teknik deep learning, seperti Long Short-Term Memory (LSTM), jaringan konvolusional dengan adaptive pooling, dan lainnya, mampu menangani urutan berdimensi variabel, sering kali diperlukan banyak data untuk melatihnya dengan baik.
Seperti yang Anda baca dalam pengantar, word2vec adalah model embedding kata yang sangat populer, dikembangkan oleh Mikolov dkk. Perlu dicatat bahwa beberapa model embedding kata lain ada dalam ranah semantik distribusional. Walaupun beberapa trik diperlukan untuk memperoleh embedding kata berkualitas tinggi, tutorial ini hanya akan berfokus pada gagasan inti di balik word2vec.
Prosedur pelatihan berikut digunakan dalam word2vec untuk memperoleh embedding kata.
Pilih sebuah kata (pivot) dalam teks. Kata-kata konteks dari kata pivot saat ini adalah kata-kata yang muncul di sekitar kata pivot. Ini berarti Anda bekerja dalam jendela kata berdimensi tetap. Kombinasi kata pivot dan kata konteks membentuk sekumpulan pasangan kata-konteks. Gambar di bawah diambil dari blog Chris Moody tentang lda2vec. Dalam potongan teks ini, 'awesome' adalah kata pivot dan kata-kata di sekitarnya diambil sebagai kata konteks, menghasilkan 7 pasangan kata-konteks. 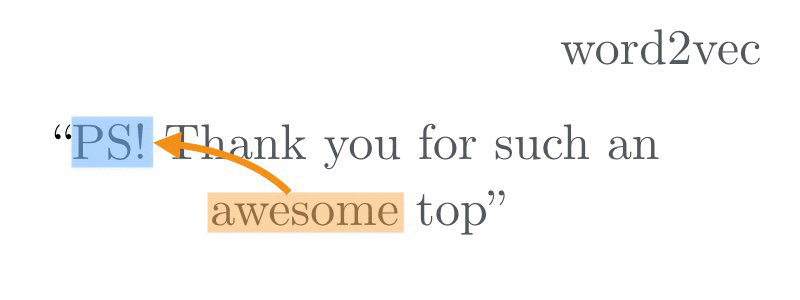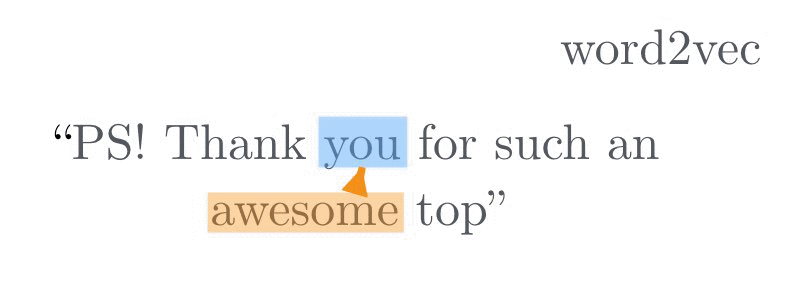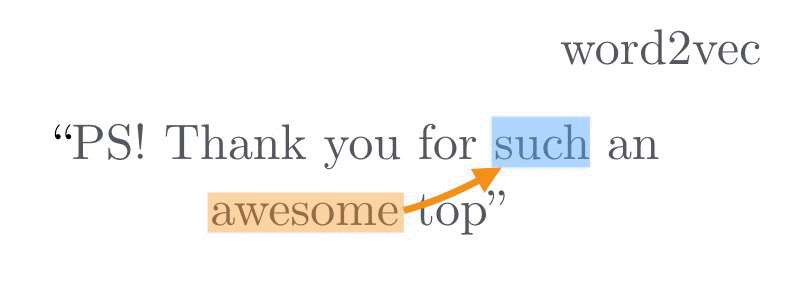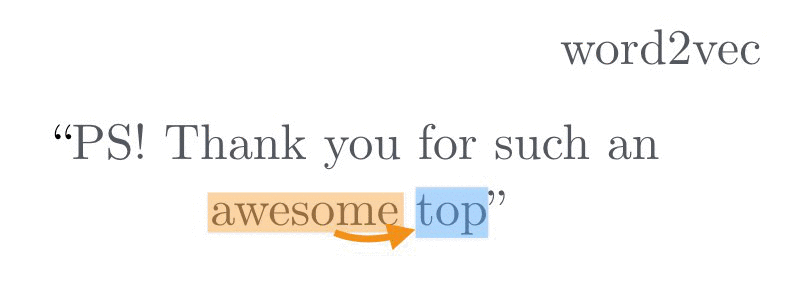
Ada dua varian model word2vec: a. Dalam arsitektur bag-of-words (CBOW) kata pivot diprediksi berdasarkan sekumpulan kata konteks di sekitarnya (mis. diberikan 'thank', 'such', 'you', 'top' model harus memprediksi 'awesome'). Ini disebut arsitektur bag-of-words karena urutan kata konteks tidak penting. b. Dalam arsitektur skip-gram, kata pivot digunakan untuk memprediksi kata konteks di sekitarnya (mis. diberikan 'awesome' prediksikan 'thank', 'such', 'you', 'top'). Gambar berikut menggambarkan dua arsitektur word2vec yang berbeda. Perlu dicatat bahwa model neural yang relatif sederhana (dua lapis) digunakan (dibanding model neural dalam-dalam pada visi komputer).
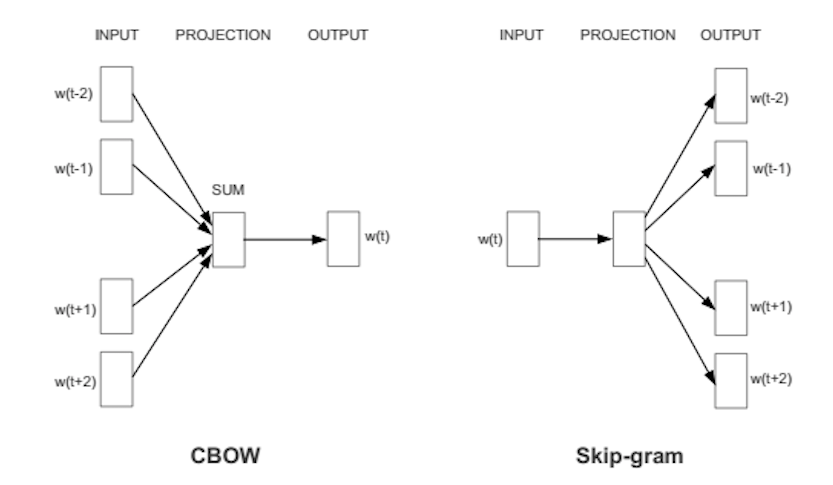
Dengan melatih model pada korpus besar, Anda akan memperoleh embedding kata (bobot pada lapisan proyeksi) yang mengodekan informasi semantik serta beberapa sifat menarik: dimungkinkan melakukan aritmetika vektor, seperti $$king - man + woman = queen$$.
Vektor kata adalah representasi yang berguna dibandingkan, misalnya, representasi one-hot sederhana. Vektor tersebut memungkinkan pengodean informasi statistik dari sebuah korpus besar ke dalam model lain, seperti klasifikasi topik atau sistem dialog. Vektor kata sering padat, berdimensi tinggi, dan tidak dapat ditafsirkan. Pertimbangkan contoh berikut: [ -0.65, -1.223, ..., -0.252, +3.2]. Sementara pada LDA dimensi kurang lebih berkaitan dengan topik, ini biasanya tidak terjadi pada vektor kata. Setiap kata diberi vektor kata yang tidak bergantung konteks. Namun, makna semantik kata sangat bergantung pada konteks. Model word2vec mempelajari vektor kata yang memprediksi kata-kata konteks lintas berbagai dokumen. Akibatnya, informasi spesifik dokumen tercampur dalam embedding kata.
Terinspirasi oleh Latent Dirichlet Allocation (LDA), model word2vec diperluas untuk secara simultan mempelajari vektor kata, dokumen, dan topik.
Lda2vec diperoleh dengan memodifikasi varian skip-gram dari word2vec. Dalam metode skip-gram asli, model dilatih untuk memprediksi kata konteks berdasarkan kata pivot. Dalam lda2vec, vektor kata pivot dan vektor dokumen dijumlahkan untuk memperoleh vektor konteks. Vektor konteks ini kemudian digunakan untuk memprediksi kata-kata konteks.
Pada bagian berikutnya, Anda akan melihat bagaimana vektor dokumen ini dikonstruksi dan bagaimana vektor tersebut dapat digunakan mirip seperti vektor dokumen pada LDA.
Gagasan mengintegrasikan vektor konteks dalam model word2vec bukanlah ide baru. Paragraph vectors, misalnya, juga mengeksplorasi gagasan ini untuk mempelajari representasi berdimensi tetap dari potongan teks berdimensi variabel. Dalam karya mereka, untuk setiap potongan teks (ukuran paragraf) dipelajari representasi vektor padat, mirip dengan vektor kata yang dipelajari.
Kelemahan pendekatan ini adalah vektor konteks/paragraf menyerupai vektor kata biasa, membuatnya kurang dapat ditafsirkan seperti, misalnya, keluaran LDA.
Model lda2vec melangkah lebih jauh dari pendekatan paragraph vector dengan bekerja pada potongan teks sebesar dokumen dan mendekomposisi vektor dokumen menjadi dua komponen berbeda. Sejalan dengan semangat model LDA, vektor dokumen diuraikan menjadi vektor bobot dokumen dan matriks topik. Vektor bobot dokumen merepresentasikan persentase berbagai topik, sedangkan matriks topik terdiri dari berbagai vektor topik. Vektor konteks dengan demikian dibangun dengan menggabungkan berbagai vektor topik yang muncul dalam sebuah dokumen.
Pertimbangkan contoh berikut: dalam model word2vec asli, jika kata pivot adalah 'French', maka kata konteks yang mungkin adalah 'German', 'Dutch', 'English'. Tanpa informasi global (terkait dokumen), itu akan menjadi tebakan paling masuk akal.
Dengan menyediakan vektor konteks tambahan dalam model lda2vec, dimungkinkan untuk membuat tebakan kata konteks yang lebih baik.
Jika vektor dokumen merupakan kombinasi topik ‘makanan’ dan ‘minuman’, maka 'baguette', 'cheese', dan 'wine' mungkin lebih sesuai. Jika vektor dokumen serupa dengan topik 'kota' dan ‘geografi’, maka 'Paris', 'Lyon', dan 'Grenoble' mungkin lebih cocok.
Perlu dicatat bahwa vektor topik ini dipelajari dalam ruang kata, yang memungkinkan interpretasi mudah: Anda cukup melihat vektor kata yang paling dekat dengan vektor topik. Selain itu, kendala diterapkan pada vektor bobot dokumen untuk memperoleh vektor jarang (mirip dengan LDA), alih-alih vektor padat. Ini memungkinkan interpretasi mudah atas konten topik dari berbagai dokumen.
Singkatnya, hasil akhir dari lda2vec adalah sekumpulan vektor bobot dokumen yang jarang, serta vektor topik yang mudah ditafsirkan.
Walaupun kinerjanya cenderung serupa dengan LDA tradisional, penggunaan metode diferensiasi otomatis membuat metode ini skalabel ke dataset yang sangat besar. Selain itu, dengan menggabungkan vektor konteks dan vektor kata, Anda memperoleh vektor kata ‘terspesialisasi’, yang dapat digunakan dalam model lain (dan mungkin melampaui vektor kata yang lebih ‘generik’).
Lda2vec adalah teknik NLP yang relatif baru dan khusus. Karena dibangun di atas metode yang ada, implementasi word2vec apa pun dapat diperluas menjadi lda2vec. Chris Moody mengimplementasikan metode ini di Chainer, tetapi kerangka kerja diferensiasi otomatis lainnya juga dapat digunakan (CNTK, Theano, ...). Implementasi Tensorflow juga telah tersedia untuk publik.
Tinjauan modul Python lda2vec dapat ditemukan di sini. Karena pelatihan lda2vec dapat intensif secara komputasi, dukungan GPU direkomendasikan untuk korpus yang lebih besar. Selain itu, untuk mempercepat pelatihan, berbagai vektor kata sering diinisialisasi dengan vektor word2vec pralatih.
Terakhir, lda2vec dibahas sebagai model topik, tetapi gagasan menambahkan vektor konteks ke model word2vec juga dapat didefinisikan secara lebih umum. Pertimbangkan misalnya dokumen yang ditulis oleh penulis berbeda dari wilayah berbeda. Maka vektor penulis dan wilayah juga dapat ditambahkan ke vektor konteks, menghasilkan metode tanpa supervisi untuk memperoleh representasi vektor dokumen, wilayah, dan penulis.
Posting blog ini hanya memberikan gambaran singkat tentang LDA, word2vec, dan lda2vec. Perlu dicatat bahwa penulis aslinya juga menerbitkan posting blog yang bagus tentang detail teknis lda2vec.
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



