Cursus
Inzicht in Machine Learning
2 uur
313.8K
Deze blogpost geeft je een introductie tot lda2vec, een topicmodel gepubliceerd door Chris Moody in 2016. lda2vec breidt het word2vec-model, beschreven door Mikolov et al. in 2013, uit met topic- en documentvectoren en verwerkt ideeën uit zowel woordembeddings als topicmodellen.
Het algemene doel van een topicmodel is om interpreteerbare documentrepresentaties te produceren die je kunt gebruiken om de topics of structuur in een verzameling niet-geannoteerde documenten te ontdekken. Een voorbeeld van zo’n interpreteerbare documentrepresentatie is: document X is 20% topic a, 40% topic b en 40% topic c.
De post van vandaag begint met een introductie van Latent Dirichlet Allocation (LDA). LDA is een probabilistisch topicmodel en behandelt documenten als een bag-of-words, dus je bekijkt eerst de voor- en nadelen van deze aanpak.
Daarentegen bouwt lda2vec documentrepresentaties boven op woordembeddings. Je leert meer over woordembeddings en waarom die momenteel de voorkeursbouwsteen zijn in natural language processing (NLP)-modellen.
Tot slot leer je meer over het algemene idee achter lda2vec.
Een topicmodel neemt een verzameling niet-geannoteerde documenten en probeert de structuur of topics in deze collectie te vinden. Let op dat topicmodellen vaak aannemen dat woordgebruik gecorreleerd is met topicvoorkomen. Je kunt bijvoorbeeld een topicmodel een set nieuwsartikelen aanbieden en het topicmodel zal de documenten in een aantal clusters verdelen op basis van woordgebruik.
Topicmodellen zijn een geweldige manier om automatisch een grote set documenten te verkennen en te structureren: ze groeperen of clusteren documenten op basis van de woorden die erin voorkomen. Omdat documenten over vergelijkbare onderwerpen de neiging hebben een vergelijkbare subvocabulaire te gebruiken, kunnen de resulterende clusters van documenten worden geïnterpreteerd als discussies over verschillende ‘topics’.
Latent Dirichlet Allocation (LDA) is een voorbeeld van een probabilistisch topicmodel. Wat dit precies betekent, leer je in de volgende secties: je begrijpt eerst hoe LDA vertrekt van een bag-of-words-beschrijving om de verschillende documenten te representeren. Vervolgens zie je hoe deze representaties worden gebruikt om de structuur in de documentcollectie te vinden.
Traditioneel worden tekstdocumenten in NLP vertegenwoordigd als een bag-of-words.
Dit betekent dat elk document wordt weergegeven als een vector met vaste lengte, met een lengte gelijk aan de vocabulairegrootte. Elke dimensie van deze vector komt overeen met de telling of het voorkomen van een woord in een document. Het kunnen reduceren van documenten met variabele lengte naar vectoren met vaste lengte maakt ze geschikter voor gebruik met een grote verscheidenheid aan machine learning (ML)-modellen en -taken (clustering, classificatie, ...).
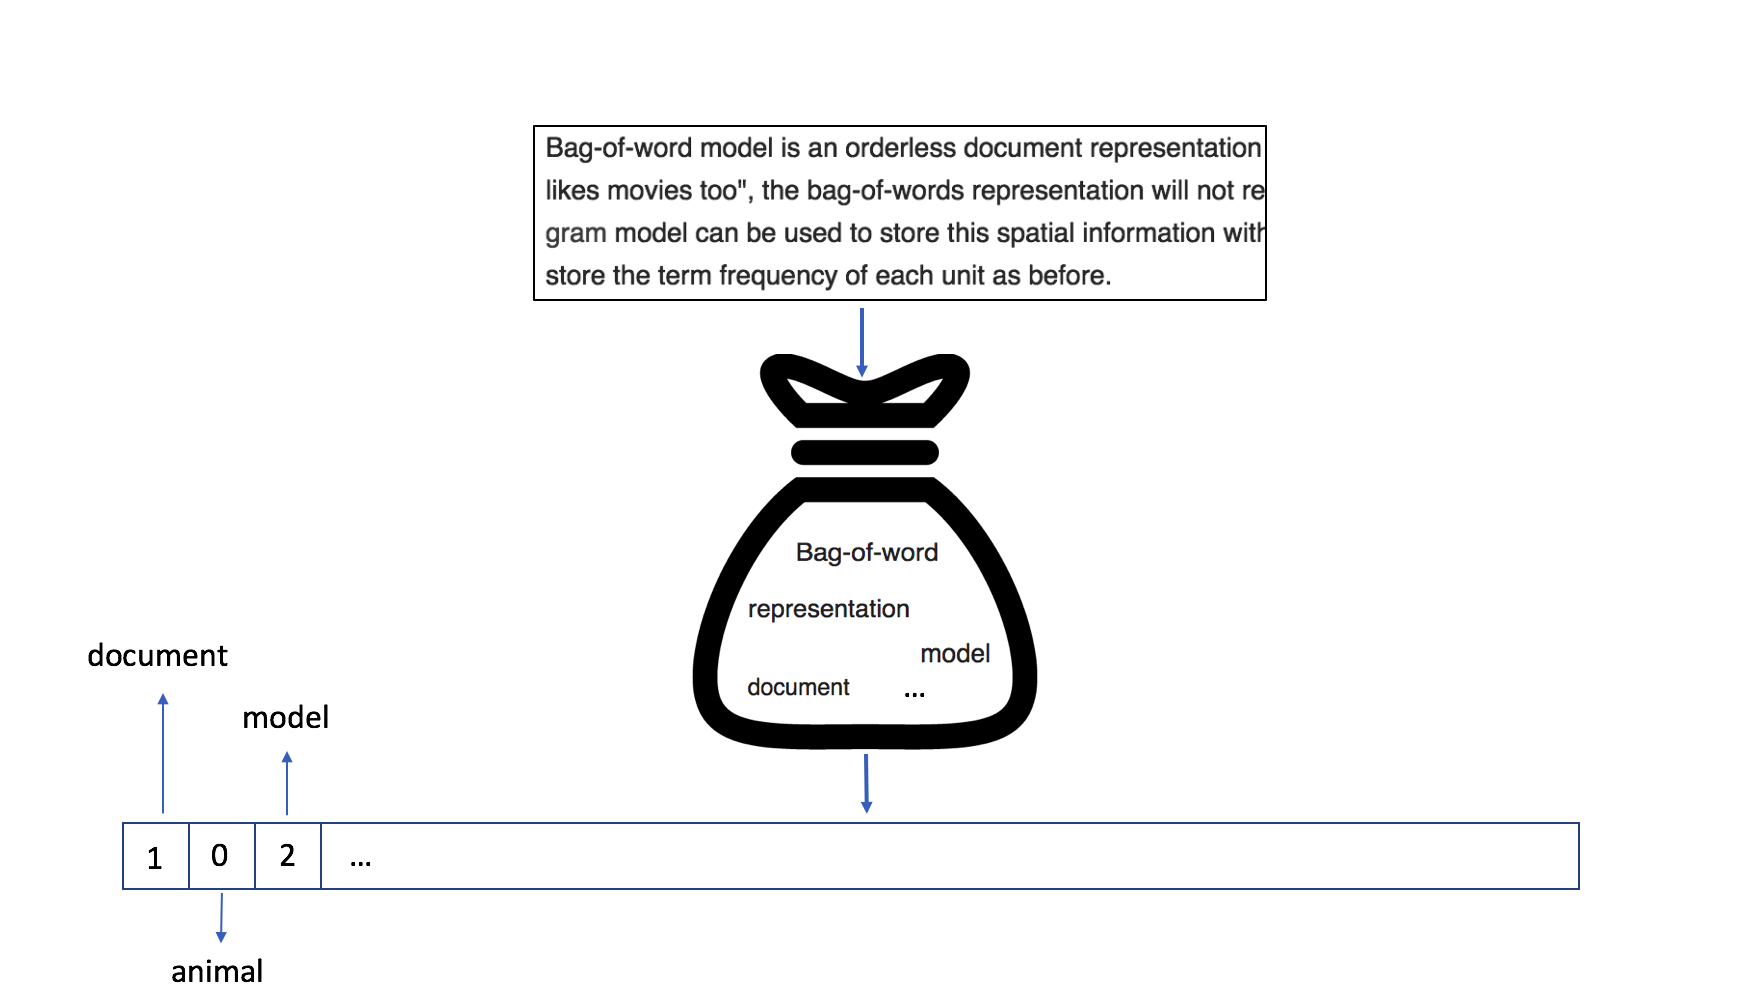
De afbeelding hierboven illustreert hoe een document wordt weergegeven in een bag-of-words-model: het woord "document" heeft een telling van 1, terwijl het woord "model" twee keer in de tekst voorkomt.
Hoewel de bag-of-words resulteert in een spaarzame en hoog-dimensionale documentrepresentatie, worden vaak goede resultaten op topicclassificatie verkregen als er veel data beschikbaar is. Je kunt altijd de recente Facebook-paper over topicclassificatie nalezen.
Een documentrepresentatie met vaste lengte betekent dat je documenten met verschillende lengtes eenvoudig kunt invoeren in ML-modellen (SVM’s, k-NN, Random Forests, ...). Dit stelt je in staat om clustering of topicclassificatie op documenten uit te voeren. De structurele informatie van het document wordt verwijderd en modellen moeten ontdekken welke vectordimensies semantisch vergelijkbaar zijn. Het is bijvoorbeeld minder intuïtief om ‘feline’ en ‘cat’ op verschillende dimensies te plaatsen, omdat het model gedwongen wordt de correlatie tussen deze verschillende dimensies te leren.
Bij het trainen van een LDA-model begin je met een verzameling documenten en elk daarvan wordt weergegeven door een vector met vaste lengte (bag-of-words). LDA is een algemene Machine Learning (ML)-techniek, wat betekent dat het ook kan worden gebruikt voor andere unsupervised ML-problemen waarbij de input een verzameling vectoren met vaste lengte is en het doel is om de structuur van deze data te verkennen.
Om een LDA-model te implementeren, begin je eerst met het definiëren van het aantal ‘topics’ dat aanwezig is in je collectie documenten. Dit klinkt eenvoudig, maar is vaak minder intuïtief dan het lijkt als je met enorme hoeveelheden documenten werkt.
Een LDA-model trainen op $$N$$ documenten met $$M$$ topics komt overeen met het vinden van de document- en topicvectoren die de data het best verklaren.
Merk op dat deze tutorial de volledige theorie achter LDA niet in detail zal behandelen (zie daarvoor deze paper van Blei et al.), omdat de focus meer ligt op het overbrengen van het algemene idee.
Ga ervan uit dat de vocabulaire in de documenten bestaat uit $$V$$ woorden. 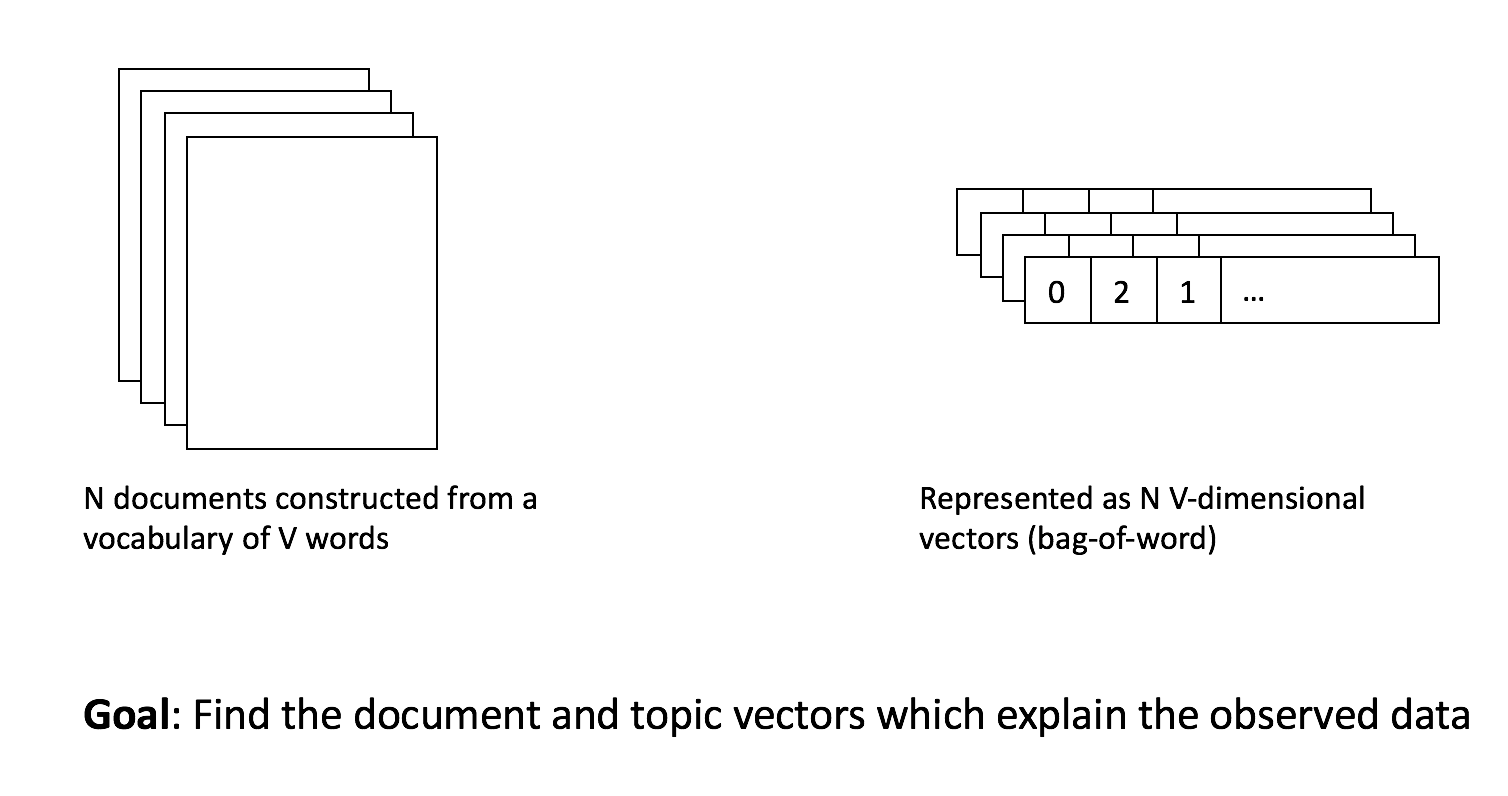
Elk van de $$N$$ documenten zal in het LDA-model worden weergegeven door een vector van lengte $$M$$ die aangeeft welke topics in dat document voorkomen. Een document kan bijvoorbeeld bestaan uit 75% ‘topic 1’ en 25% ‘topic 2’. Vaak levert LDA documentvectoren op met veel nullen, wat betekent dat er per document maar een beperkt aantal topics voorkomt. Dit komt overeen met het idee dat documenten typisch maar over een beperkt aantal onderwerpen gaan. Dit verbetert de menselijke interpreteerbaarheid van deze documentvectoren aanzienlijk.
Elk van de $$M$$ topics wordt weergegeven door een vector van lengte $$V$$ die aangeeft welke woorden waarschijnlijk voorkomen, gegeven een document over dat topic. Voor topic 1 zouden ‘learning’, ‘modelling’ en ‘statistics’ bijvoorbeeld enkele van de meest voorkomende woorden kunnen zijn. Dit betekent dat je dan zou kunnen zeggen dat dit het ‘data science’-topic is. Voor topic 2 zouden de woorden ‘GPU’, ‘compute’ en ‘storage’ het meest voorkomend kunnen zijn. Dit zou je kunnen interpreteren als het ‘computing’-topic.
De volgende afbeelding illustreert het LDA-model visueel. Het doel van het model is om de topic- en documentvectoren te vinden die de oorspronkelijke bag-of-words-representatie van de verschillende documenten verklaren. 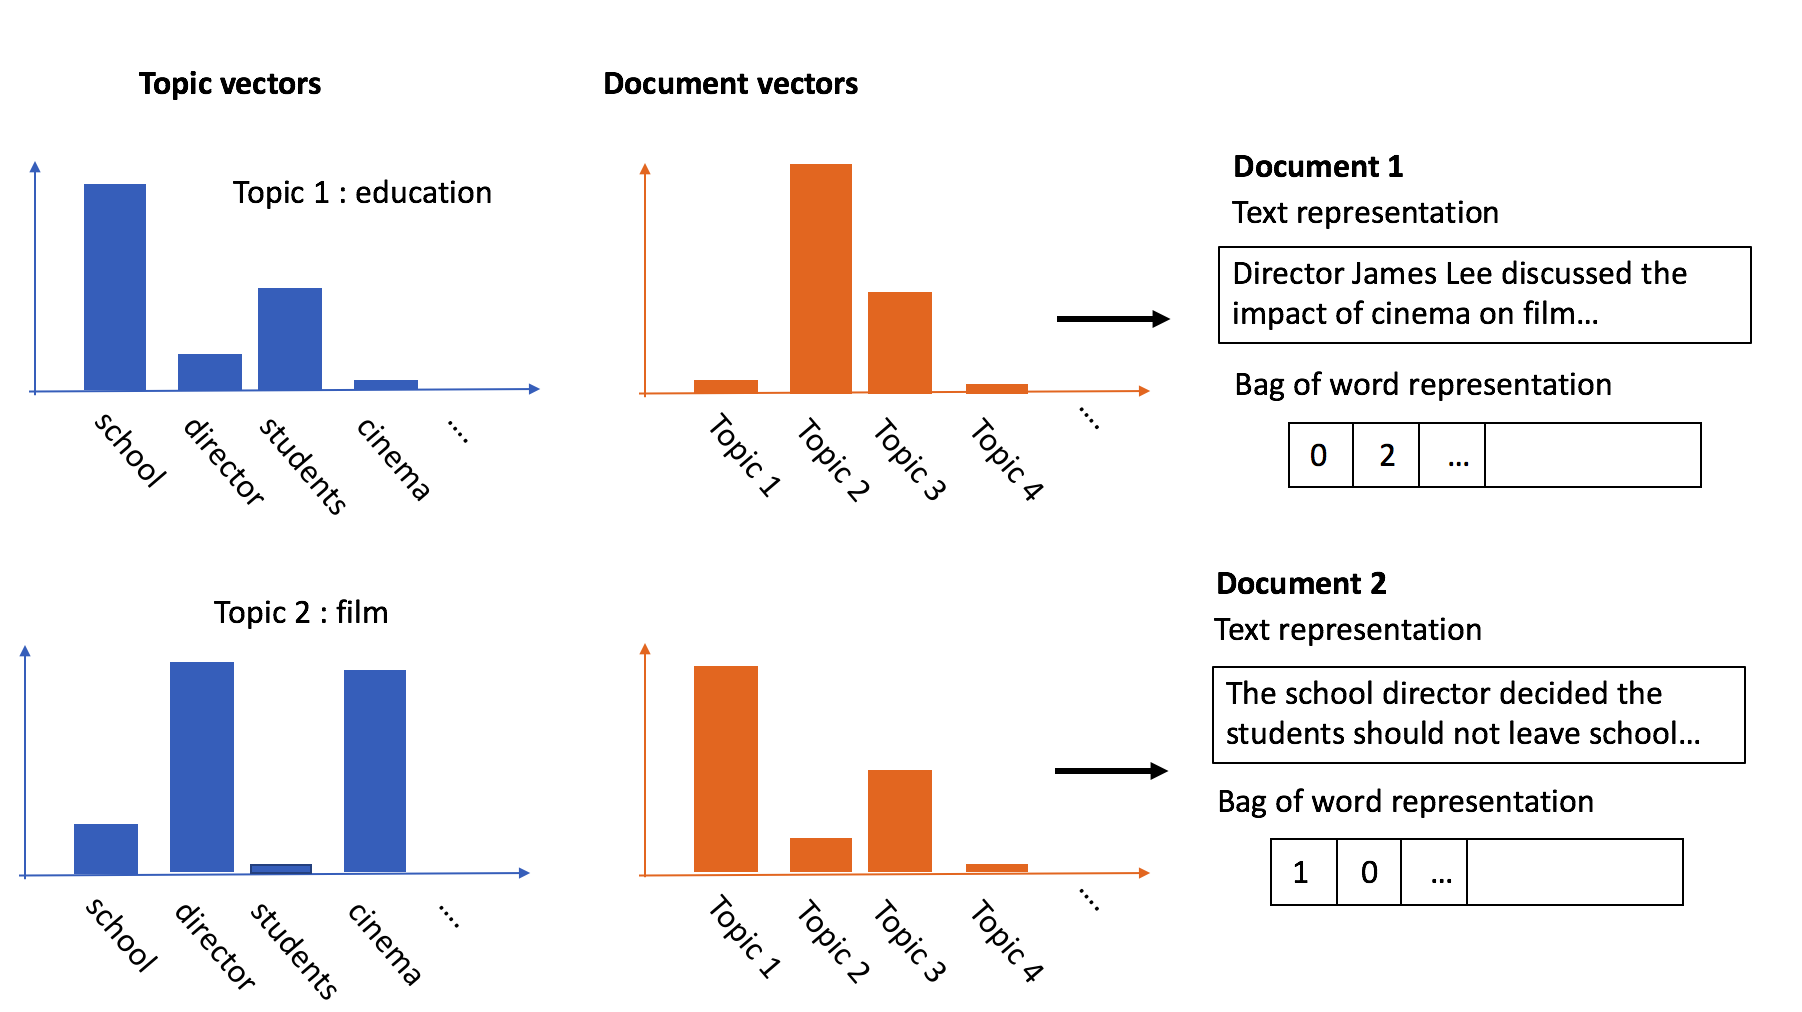
Het is belangrijk om op te merken dat je vertrouwt op de aanname dat de topicvectoren interpreteerbaar zullen zijn; anders is de output van het model vrijwel waardeloos. In essentie ga je ervan uit dat het model, gegeven genoeg data, zal uitvogelen welke woorden de neiging hebben samen voor te komen, en ze zal clusteren in afzonderlijke ‘topics’.
LDA is een simpel probabilistisch model dat vaak behoorlijk goed werkt. De documentvectoren zijn vaak spaarzaam, laag-dimensionaal en zeer interpreteerbaar, en brengen patronen en structuur in documenten naar voren. Je moet een goede schatting bepalen van het aantal topics dat voorkomt in de collectie documenten. Daarnaast moet je handmatig een duidelijke benaming/‘topic’ toekennen aan de verschillende topicvectoren. Omdat een bag-of-words-model wordt gebruikt om de documenten te representeren, kan LDA last hebben van dezelfde nadelen als het bag-of-words-model. Het LDA-model leert een documentvector die woorden in dat document voorspelt, terwijl het elke structuur of hoe deze woorden lokaal met elkaar interageren, negeert.
Een van de problemen van de bag-of-words-representatie is dat het model verantwoordelijk is voor het achterhalen welke dimensies in de documentvectoren semantisch gerelateerd zijn. Je kunt je voorstellen dat het benutten van informatie over hoe woorden semantisch met elkaar samenhangen, de prestaties van een model zal verbeteren, en dat is precies wat woordembeddings beloven.
Met woordembeddings worden woorden weergegeven als vectoren met vaste lengte of embeddings. Er bestaan verschillende modellen om embeddings te construeren, maar ze zijn allemaal gebaseerd op de distributionele hypothese. Dat betekent dat "een woord wordt gekarakteriseerd door het gezelschap dat het houdt".
Het doel van woordembeddings is om semantische en syntactische regelmatigheden in taal vast te leggen uit grote unsupervised verzamelingen documenten, zoals Wikipedia. Woorden die in dezelfde context voorkomen, worden gerepresenteerd door vectoren die dicht bij elkaar liggen.
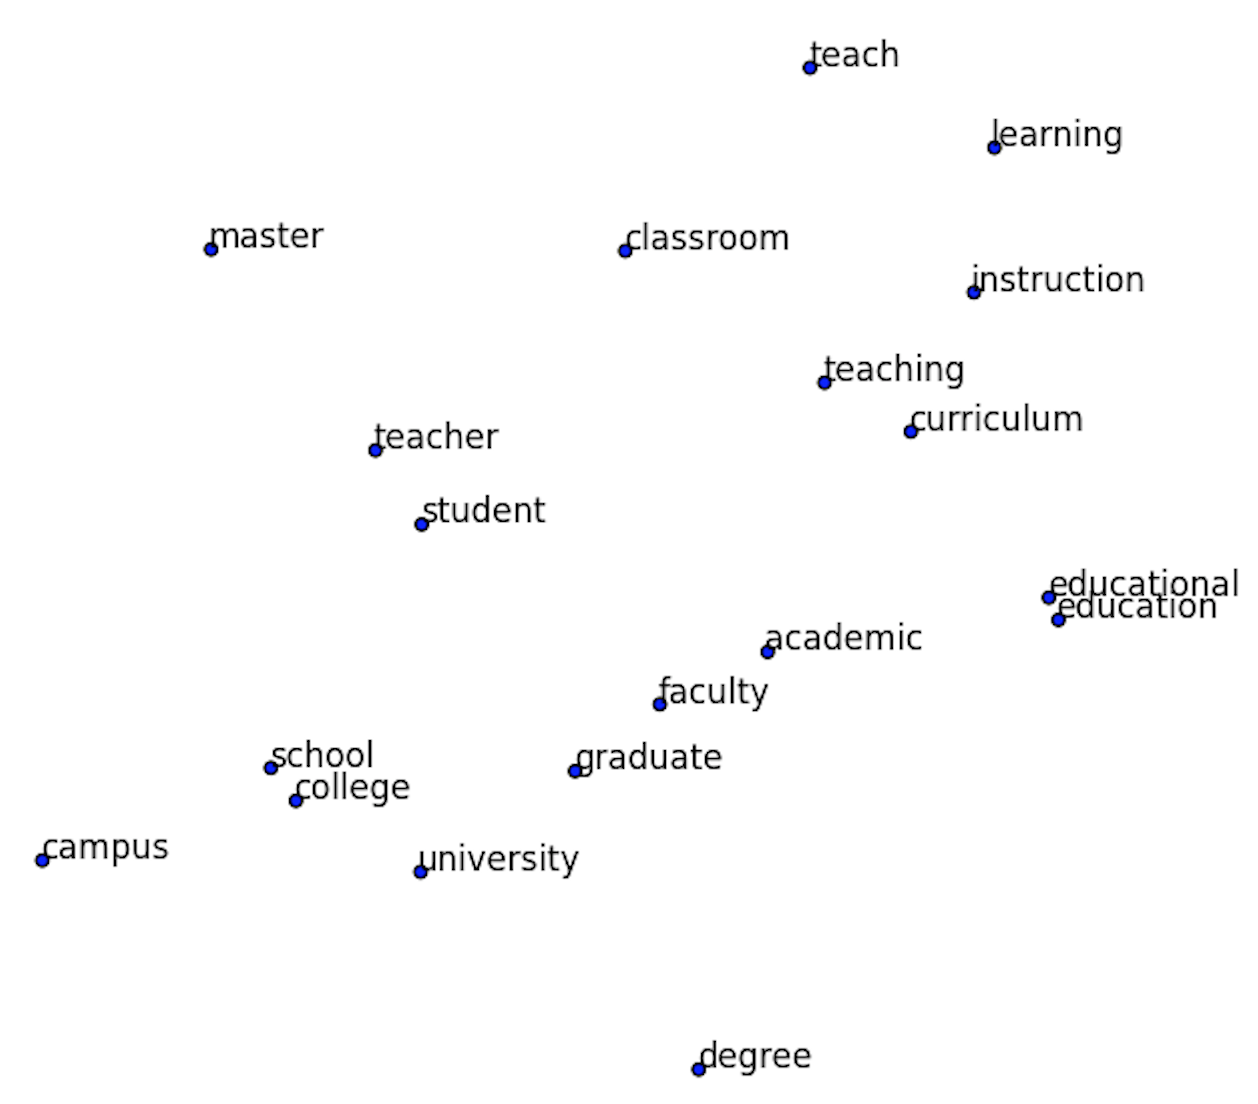
Afbeelding afkomstig uit "Visualizing Word Embeddings with t-SNE"
De afbeelding hierboven is een projectie van de woordembedding-ruimte naar 2D-ruimte met behulp van t-Distributed Stochastic Neighbor Embedding (t-SNE). t-SNE is een dimensionaliteitsreductiemethode die je kunt gebruiken om data met hoge dimensies te visualiseren. De methode neemt de woordembeddings als input en projecteert ze op een tweedimensionale ruimte die gemakkelijk in een plot te visualiseren is. Alleen een subsectie van de woordruimte wordt onderzocht, met focus op woorden dicht bij ‘teacher’. In plaats van woorden te representeren met nietszeggende dimensies in een vector, kunnen woorden met woordembeddings worden weergegeven door semantisch gecorreleerde vectoren.
Bij het gebruik van woordembeddings kan een ML-model informatie uit een grote verzameling documenten, ook wel een "corpus" genoemd, benutten door die in de vectorrepresentaties te verankeren. Dit is niet mogelijk met bag-of-words-modellen, wat de modelprestaties kan schaden wanneer er niet veel data beschikbaar is. Woordembeddings leiden tot documentrepresentaties die niet langer vaste lengte hebben. In plaats daarvan worden documenten weergegeven door een sequentie met variabele lengte van woordvector-embeddings. Hoewel sommige deep learning-technieken, zoals Long Short-Term Memory (LSTM)’s, convolutionele netwerken met adaptieve pooling, ..., met sequenties van variabele lengte kunnen omgaan, is vaak veel data nodig om ze goed te trainen.
Zoals je in de introductie las, is word2vec een zeer populair woordembedding-model, ontwikkeld door Mikolov et al. Let op dat er binnen het veld van distributionele semantiek verschillende andere woordembedding-modellen bestaan. Hoewel er verschillende trucjes nodig zijn om embeddings van hoge kwaliteit te verkrijgen, richt deze tutorial zich alleen op het kernidee achter word2vec.
De volgende trainingsprocedure wordt in word2vec gebruikt om de woordembeddings te verkrijgen.
Selecteer een (pivot)woord in de tekst. De contextwoorden van het huidige pivotwoord zijn de woorden die rond het pivotwoord voorkomen. Dit betekent dat je werkt binnen een venster van woorden met vaste lengte. De combinaties van de pivot- en contextwoorden vormen een set woord-context-paren. De onderstaande afbeelding is afkomstig van de blog van Chris Moody over lda2vec. In dit tekstfragment is ‘awesome’ het pivotwoord en de woorden eromheen worden genomen als contextwoorden, wat resulteert in 7 woord-context-paren. 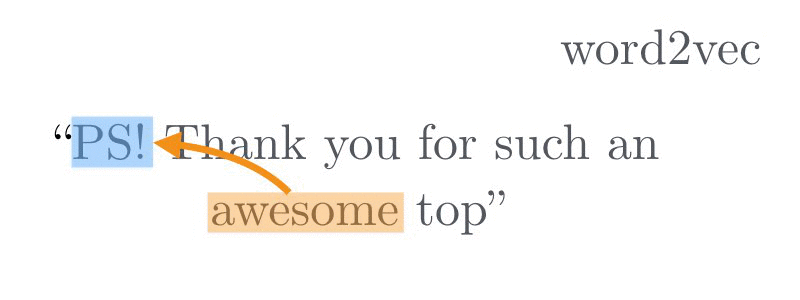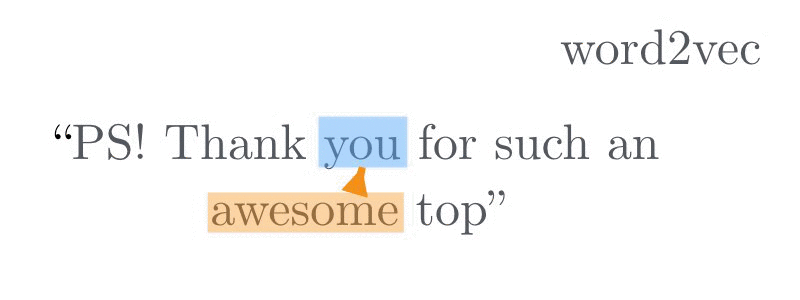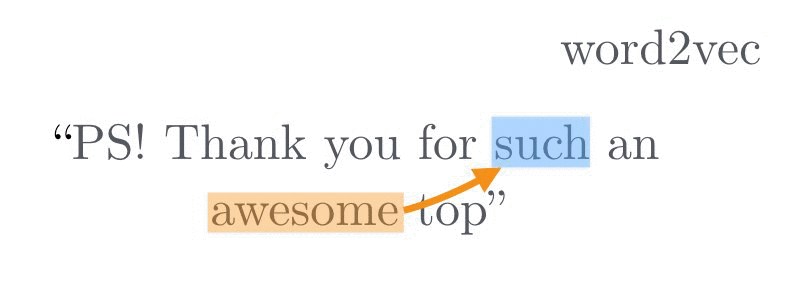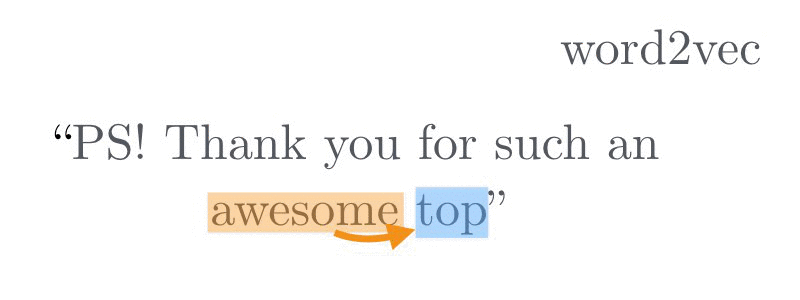
Er bestaan twee varianten van het word2vec-model: a. In de bag-of-words-architectuur (CBOW) wordt het pivotwoord voorspeld op basis van een set omliggende contextwoorden (d.w.z. gegeven ‘thank’, ‘such’, ‘you’, ‘top’ moet het model ‘awesome’ voorspellen). Dit wordt een bag-of-words-architectuur genoemd omdat de volgorde van contextwoorden niet uitmaakt. b. In de skip-gram-architectuur wordt het pivotwoord gebruikt om de omliggende contextwoorden te voorspellen (d.w.z. gegeven ‘awesome’ voorspel ‘thank’, ‘such’, ‘you’, ‘top’). De volgende afbeelding toont de twee verschillende word2vec-architecturen. Merk op dat een relatief simpel (twee lagen) neuraal model wordt gebruikt (vergeleken met diepe neurale modellen in computervisie).
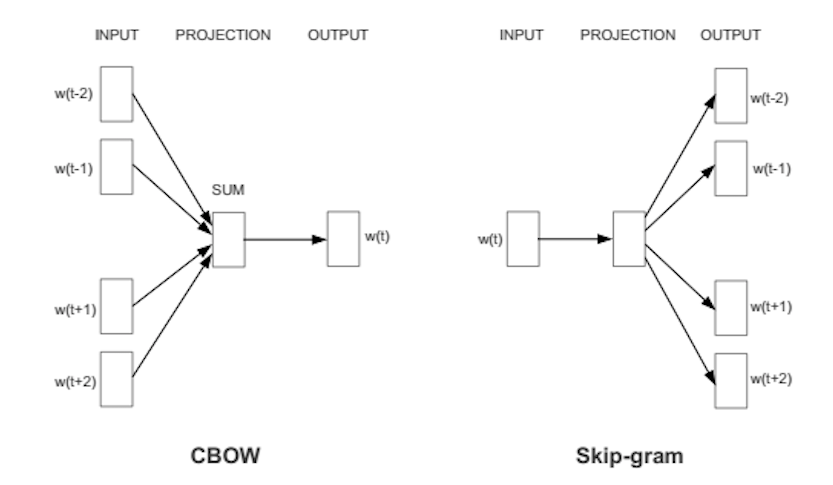
Door het model op een groot corpus te trainen, krijg je woordembeddings (de gewichten in de projectielaag) die semantische informatie én enkele interessante eigenschappen coderen: het is mogelijk om vectorrekenkunde uit te voeren, zoals $$king - man + woman = queen$$.
Woordvectoren zijn een bruikbare representatie vergeleken met bijvoorbeeld een eenvoudige one-hot-encoded representatie. Ze stellen je in staat statistische informatie uit een groot corpus in andere modellen te coderen, zoals topicclassificatie of dialoogsysteem. De woordvectoren zijn vaak dicht, hoog-dimensionaal en niet interpreteerbaar. Neem het volgende voorbeeld: [ -0.65, -1.223, ..., -0.252, +3.2]. Terwijl bij LDA dimensies ongeveer overeenkomen met topics, is dat typisch niet het geval voor woordvectoren. Elk woord krijgt een context-onafhankelijke woordvector. De semantische betekenis van woorden is echter sterk contextafhankelijk. Het word2vec-model leert een woordvector die contextwoorden voorspelt over verschillende documenten heen. Daardoor wordt document-specifieke informatie samengevoegd in de woordembeddings.
Geïnspireerd door Latent Dirichlet Allocation (LDA) wordt het word2vec-model uitgebreid om gelijktijdig woord-, document- en topicvectoren te leren.
Lda2vec wordt verkregen door de skip-gram-variant van word2vec aan te passen. In de oorspronkelijke skip-gram-methode wordt het model getraind om contextwoorden te voorspellen op basis van een pivotwoord. In lda2vec worden de pivotwoordvector en een documentvector opgeteld om een contextvector te verkrijgen. Deze contextvector wordt vervolgens gebruikt om contextwoorden te voorspellen.
In de volgende sectie zie je hoe deze documentvectoren worden geconstrueerd en hoe je ze op vergelijkbare wijze kunt gebruiken als documentvectoren in LDA.
Het idee om contextvectoren te integreren in het word2vec-model is niet nieuw. Paragraph vectors hebben dit idee bijvoorbeeld ook onderzocht om representaties met vaste lengte te leren van tekstfragmenten met variabele lengte. In hun werk wordt voor elk tekstfragment (ter grootte van een alinea) een dichte vectorrepresentatie geleerd, vergelijkbaar met de geleerde woordvectoren.
Het nadeel van deze aanpak is dat de context-/paragraafvectoren typische woordvectoren lijken, waardoor ze minder interpreteerbaar zijn dan bijvoorbeeld de output van LDA.
Het lda2vec-model gaat een stap verder dan de paragraph vector-aanpak door te werken met tekstfragmenten op documentgrootte en de documentvectoren op te splitsen in twee verschillende componenten. In dezelfde geest als het LDA-model wordt een documentvector ontbonden in een documentgewichtsvector en een topicmatrix. De documentgewichtsvector vertegenwoordigt het percentage van de verschillende topics, terwijl de topicmatrix uit de verschillende topicvectoren bestaat. Een contextvector wordt dus geconstrueerd door de verschillende topicvectoren te combineren die in een document voorkomen.
Neem het volgende voorbeeld: in het oorspronkelijke word2vec-model, als het pivotwoord ‘French’ is, dan zouden mogelijke contextwoorden ‘German’, ‘Dutch’, ‘English’ kunnen zijn. Zonder enige globale (documentgerelateerde) informatie zouden dit de meest plausibele gokjes zijn.
Door in het lda2vec-model een extra contextvector te voorzien, is het mogelijk betere gokjes voor contextwoorden te maken.
Als de documentvector een combinatie is van de ‘food’- en ‘drinks’-topics, dan zouden ‘baguette’, ‘cheese’ en ‘wine’ geschikter kunnen zijn. Als de documentvector lijkt op de ‘city’- en ‘geography’-topics, dan zouden ‘Paris’, ‘Lyon’ en ‘Grenoble’ geschikter kunnen zijn.
Merk op dat deze topicvectoren in woordruimte worden geleerd, wat eenvoudige interpretatie mogelijk maakt: je kijkt simpelweg naar de woordvectoren die het dichtst bij de topicvectoren liggen. Daarnaast worden er beperkingen opgelegd aan de documentgewichtsvectoren om een spaarzame vector te verkrijgen (vergelijkbaar met LDA), in plaats van een dichte vector. Dit maakt eenvoudige interpretatie van de topicinhoud van verschillende documenten mogelijk.
Kortom, het eindresultaat van lda2vec is een set spaarzame documentgewichtsvectoren, evenals gemakkelijk interpreteerbare topicvectoren.
Hoewel de prestaties de neiging hebben vergelijkbaar te zijn met traditionele LDA, maakt het gebruik van automatische differentiatiemethoden de methode schaalbaar naar zeer grote datasets. Bovendien krijg je door de contextvector en woordvector te combineren ‘gespecialiseerde’ woordvectoren, die in andere modellen kunnen worden gebruikt (en mogelijk beter presteren dan meer ‘generieke’ woordvectoren).
Lda2vec is een vrij nieuwe en gespecialiseerde NLP-techniek. Omdat het voortbouwt op bestaande methoden, zou elke word2vec-implementatie kunnen worden uitgebreid naar lda2vec. Chris Moody implementeerde de methode in Chainer, maar andere automatische differentiatiekaders zouden ook gebruikt kunnen worden (CNTK, Theano, ...). Een TensorFlow-implementatie werd ook publiekelijk beschikbaar gemaakt.
Een overzicht van de Python-module lda2vec is hier te vinden. Omdat het trainen van lda2vec computationeel intensief kan zijn, wordt GPU-ondersteuning aanbevolen voor grotere corpora. Daarnaast worden om het trainen te versnellen de verschillende woordvectoren vaak geïnitialiseerd met voorgetrainde word2vec-vectoren.
Tot slot is lda2vec besproken als een topicmodel, maar het idee om contextvectoren toe te voegen aan het word2vec-model kan ook algemener worden gedefinieerd. Neem bijvoorbeeld documenten die zijn geschreven door verschillende auteurs uit verschillende regio’s. Dan zouden auteur- en regiovectoren ook aan de contextvector kunnen worden toegevoegd, wat resulteert in een unsupervised methode om document-, regio- en auteurvectorrepresentaties te verkrijgen.
Deze blogpost gaf slechts een snel overzicht van LDA, word2vec en lda2vec. Let op dat de oorspronkelijke auteur ook een uitstekende blogpost over de technische details van lda2vec publiceerde.
Kom meer te weten over Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

