Curso
Entendendo Machine Learning
2 h
308K
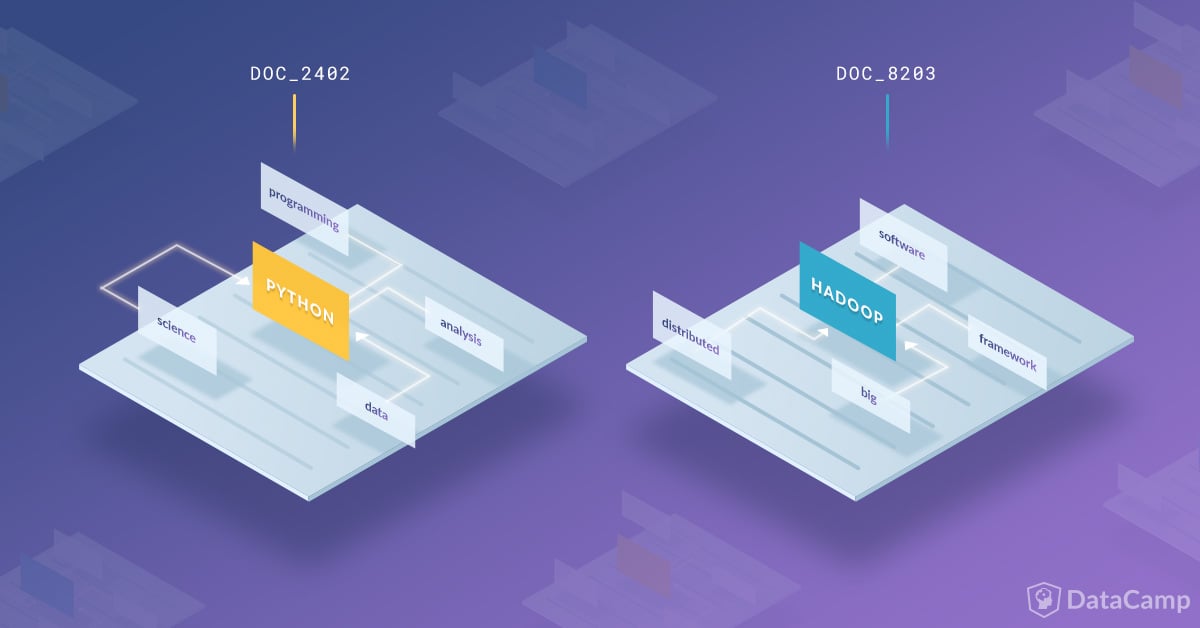
Este post traz uma introdução ao lda2vec, um modelo de tópicos publicado por Chris Moody em 2016. O lda2vec expande o modelo word2vec, descrito por Mikolov et al. em 2013, com vetores de tópicos e de documentos, incorporando ideias tanto de embeddings de palavras quanto de modelos de tópicos.
O objetivo geral de um modelo de tópicos é produzir representações de documentos interpretáveis, que possam ser usadas para descobrir os tópicos ou a estrutura em um conjunto de documentos sem rótulos. Um exemplo de representação interpretável é: o documento X tem 20% do tópico a, 40% do tópico b e 40% do tópico c.
No post de hoje, vamos começar apresentando a Latent Dirichlet Allocation (LDA). A LDA é um modelo probabilístico de tópicos e trata os documentos como um saco de palavras (bag-of-words). Primeiro, você vai explorar as vantagens e desvantagens dessa abordagem.
Por outro lado, o lda2vec constrói representações de documentos em cima de embeddings de palavras. Você vai entender melhor o que são embeddings de palavras e por que eles são hoje o principal bloco de construção em modelos de processamento de linguagem natural (NLP).
Por fim, você vai conhecer melhor a ideia geral por trás do lda2vec.
Um modelo de tópicos recebe um conjunto de documentos sem rótulos e tenta encontrar a estrutura ou os tópicos presentes nesse conjunto. Observe que modelos de tópicos geralmente assumem que o uso das palavras é correlacionado com a ocorrência de tópicos. Você poderia, por exemplo, fornecer ao modelo um conjunto de matérias jornalísticas, e ele dividiria os documentos em diversos clusters de acordo com o uso das palavras.
Modelos de tópicos são uma ótima forma de explorar e organizar automaticamente um grande volume de documentos: eles reúnem ou agrupam documentos com base nas palavras que aparecem neles. Como documentos sobre temas semelhantes tendem a usar um subvocabulário parecido, os clusters resultantes podem ser interpretados como discussões sobre "tópicos" diferentes.
A Latent Dirichlet Allocation (LDA) é um exemplo de modelo probabilístico de tópicos. O que isso significa exatamente, você vai ver nas próximas seções: primeiro, como a LDA parte de uma descrição bag-of-words para representar os diferentes documentos. Depois, como essas representações são usadas para encontrar a estrutura no conjunto de documentos.
Tradicionalmente, documentos de texto são representados em NLP como um bag-of-words.
Isso significa que cada documento é representado como um vetor de comprimento fixo, com tamanho igual ao vocabulário. Cada dimensão desse vetor corresponde à contagem ou ocorrência de uma palavra no documento. Reduzir documentos de comprimento variável a vetores de comprimento fixo os torna mais adequados para uso em uma grande variedade de modelos e tarefas de machine learning (ML) (clusterização, classificação, ...).
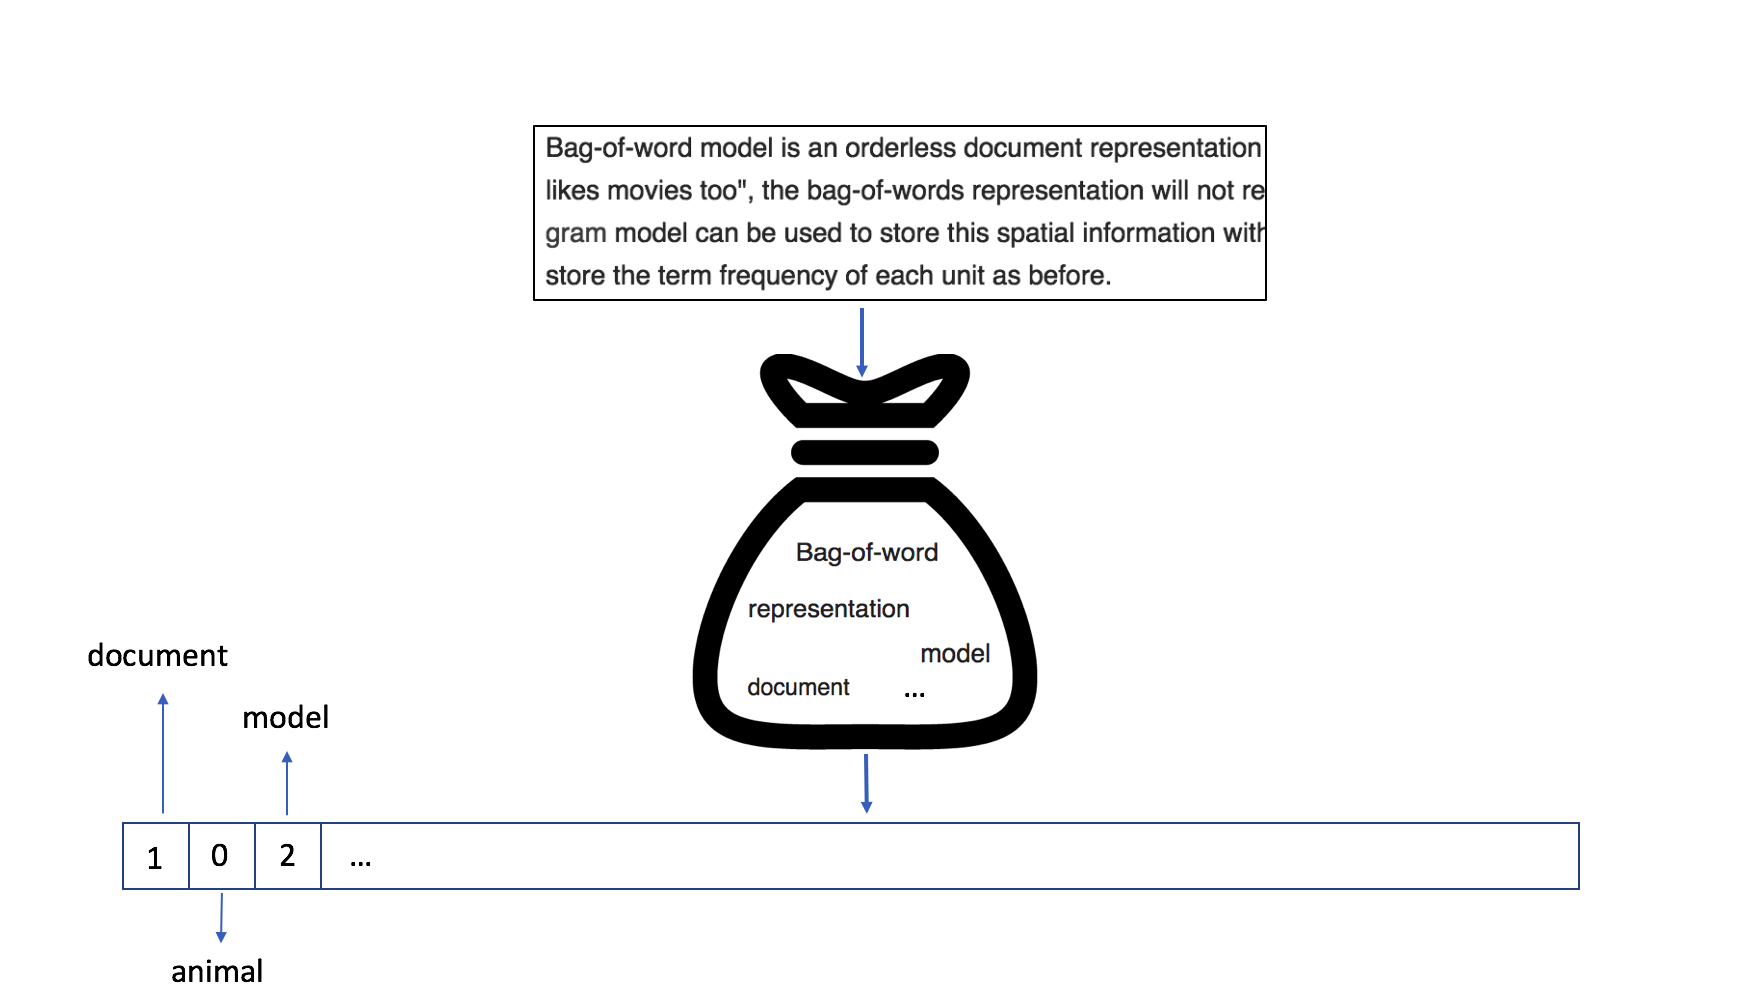
A imagem acima ilustra como um documento é representado em um modelo bag-of-words: a palavra "document" tem contagem 1, enquanto "model" aparece duas vezes no texto.
Embora o bag-of-words gere representações esparsas e de alta dimensionalidade, bons resultados em classificação de tópicos costumam ser obtidos quando há muitos dados disponíveis. Você pode conferir o recente artigo do Facebook sobre classificação de tópicos.
Uma representação de documento com comprimento fixo permite inserir facilmente documentos de diferentes tamanhos em modelos de ML (SVMs, k-NN, Random Forests, ...). Isso possibilita realizar clusterização ou classificação de tópicos em documentos. A informação estrutural do documento é descartada e os modelos precisam descobrir quais dimensões do vetor são semanticamente semelhantes. Mapear, por exemplo, ‘feline’ e ‘cat’ em dimensões diferentes é menos intuitivo, pois o modelo é forçado a aprender a correlação entre essas dimensões.
Ao treinar um modelo LDA, você começa com um conjunto de documentos, cada um representado por um vetor de comprimento fixo (bag-of-words). A LDA é uma técnica geral de Machine Learning (ML), o que significa que também pode ser usada para outros problemas não supervisionados em que a entrada é um conjunto de vetores de comprimento fixo e o objetivo é explorar a estrutura desses dados.
Para implementar a LDA, você primeiro define o número de "tópicos" presentes na sua coleção de documentos. Isso parece simples, mas costuma ser menos intuitivo do que parece quando se trabalha com grandes volumes de documentos.
Treinar uma LDA em $$N$$ documentos com $$M$$ tópicos corresponde a encontrar os vetores de documentos e de tópicos que melhor explicam os dados.
Observe que este tutorial não cobre toda a teoria por trás da LDA em detalhe (para isso, veja este artigo de Blei et al.), pois o foco aqui é transmitir a ideia geral.
Suponha que o vocabulário dos documentos tenha $$V$$ palavras. 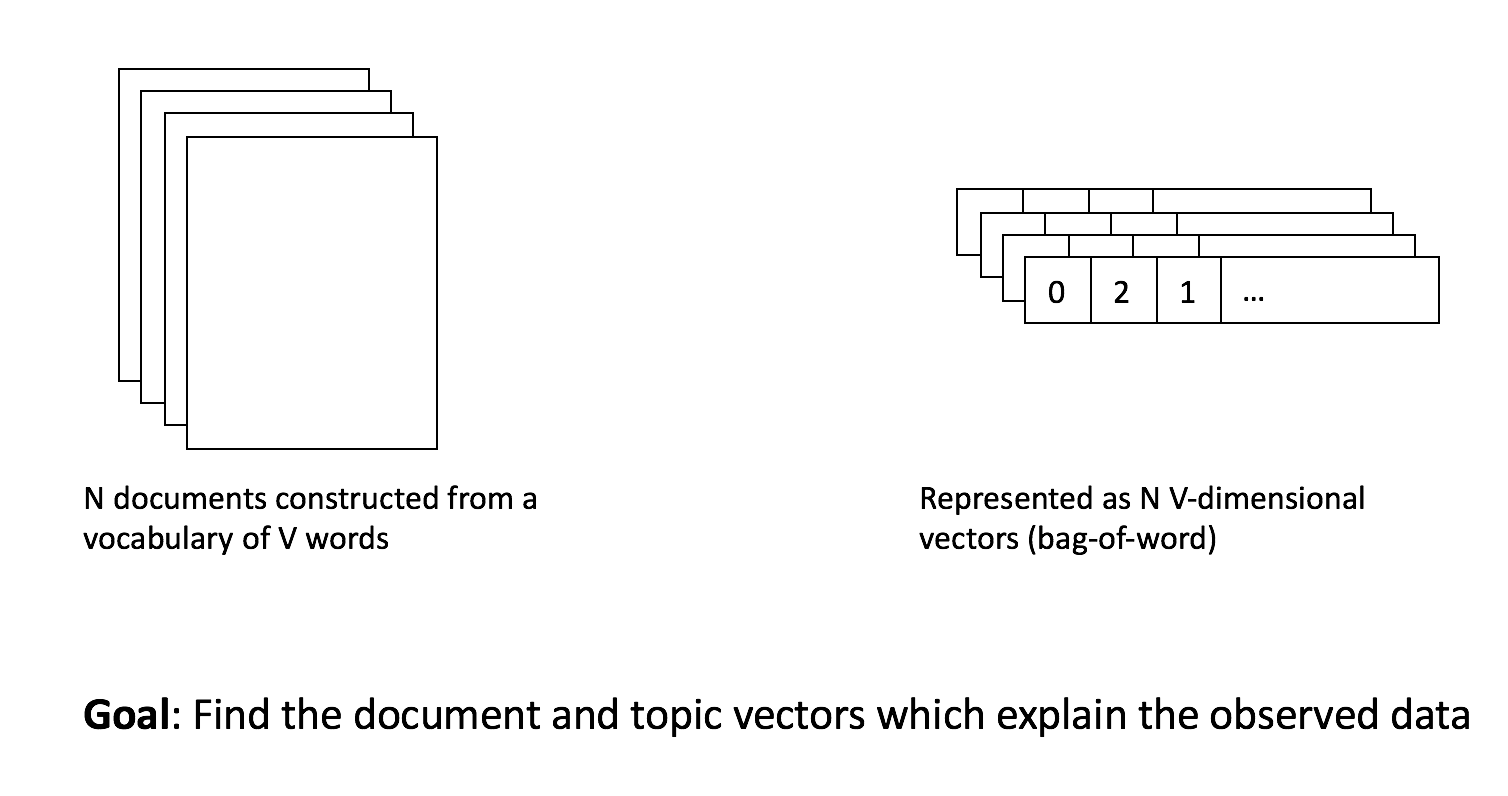
Cada um dos $$N$$ documentos será representado no modelo LDA por um vetor de comprimento $$M$$ que detalha quais tópicos ocorrem naquele documento. Um documento pode ser 75% ‘tópico 1’ e 25% ‘tópico 2’. Frequentemente, a LDA resulta em vetores de documentos com muitos zeros, indicando que apenas um número limitado de tópicos ocorre por documento. Isso está alinhado com a ideia de que documentos normalmente tratam de poucos tópicos. Esse fato melhora bastante a interpretabilidade humana desses vetores.
Cada um dos $$M$$ tópicos é representado por um vetor de comprimento $$V$$ que detalha quais palavras têm maior probabilidade de ocorrer em um documento sobre aquele tópico. Assim, para o tópico 1, ‘learning’, ‘modelling’ e ‘statistics’ podem ser algumas das palavras mais comuns. Você poderia então chamar isso de tópico ‘data science’. Para o tópico 2, as palavras ‘GPU’, ‘compute’ e ‘storage’ podem ser as mais comuns. Você poderia interpretar isso como o tópico ‘computação’.
A imagem a seguir ilustra o modelo LDA visualmente. O objetivo é encontrar os vetores de tópicos e de documentos que expliquem a representação original bag-of-words dos diferentes documentos. 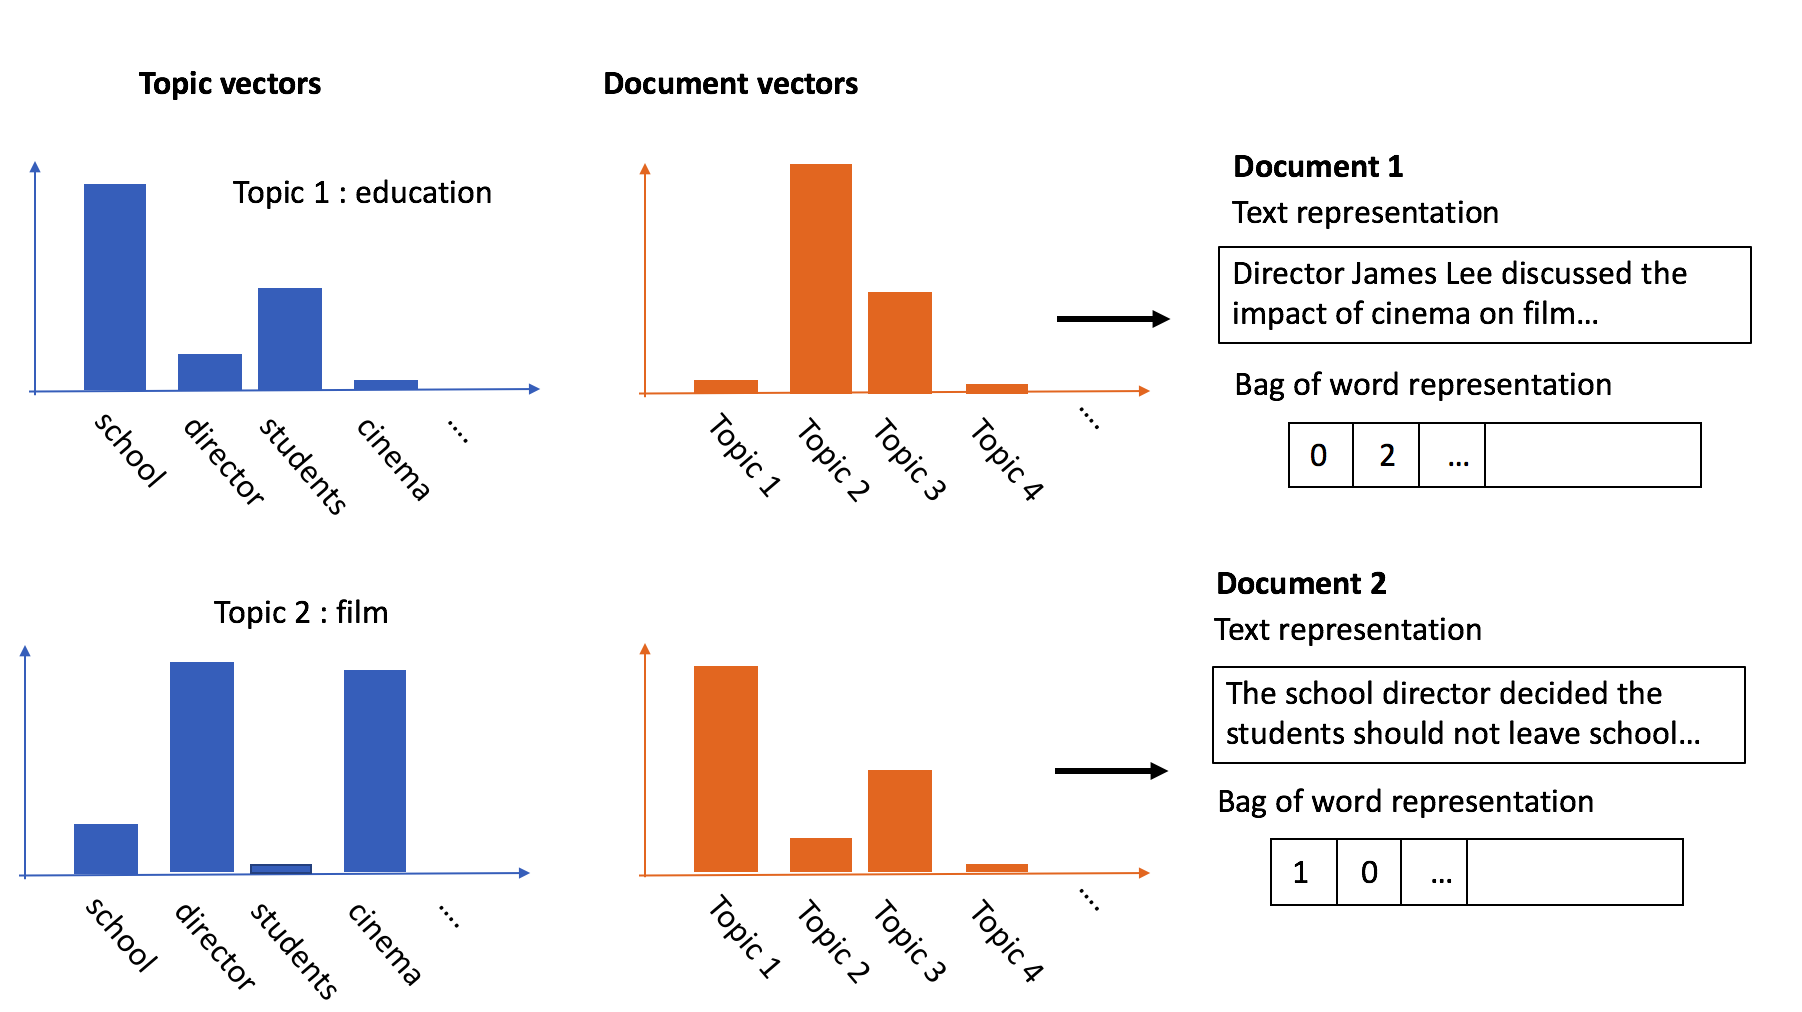
É importante notar que você está contando com a suposição de que os vetores de tópicos serão interpretáveis; caso contrário, a saída do modelo não terá utilidade. Essencialmente, você assume que o modelo, com dados suficientes, vai descobrir quais palavras tendem a coocorrer e vai agrupá-las em ‘tópicos’ distintos.
A LDA é um modelo probabilístico simples que costuma funcionar muito bem. Os vetores de documentos costumam ser esparsos, de baixa dimensionalidade e altamente interpretáveis, evidenciando padrões e estrutura nos textos. Você precisa estimar bem o número de tópicos presentes na coleção de documentos. Além disso, é preciso atribuir manualmente um rótulo/‘tópico’ distinto a cada vetor de tópico. Como a representação dos documentos é do tipo bag-of-words, a LDA pode sofrer das mesmas desvantagens desse modelo. A LDA aprende um vetor de documento que prevê palavras dentro daquele documento, desconsiderando a estrutura ou como essas palavras interagem localmente.
Um dos problemas da representação bag-of-words é que o modelo precisa descobrir quais dimensões dos vetores de documentos são semanticamente relacionadas. É razoável imaginar que aproveitar informações sobre como as palavras se correlacionam semanticamente melhora o desempenho do modelo — e é exatamente isso que os embeddings de palavras prometem.
Com embeddings de palavras, cada termo é representado como um vetor de comprimento fixo, ou embedding. Existem vários modelos para construir embeddings, mas todos se baseiam na hipótese distribucional. Isso significa que "uma palavra é caracterizada pela companhia que ela mantém".
O objetivo dos embeddings é capturar regularidades semânticas e sintáticas da linguagem a partir de grandes conjuntos não supervisionados, como a Wikipedia. Palavras que ocorrem no mesmo contexto são representadas por vetores em proximidade entre si.
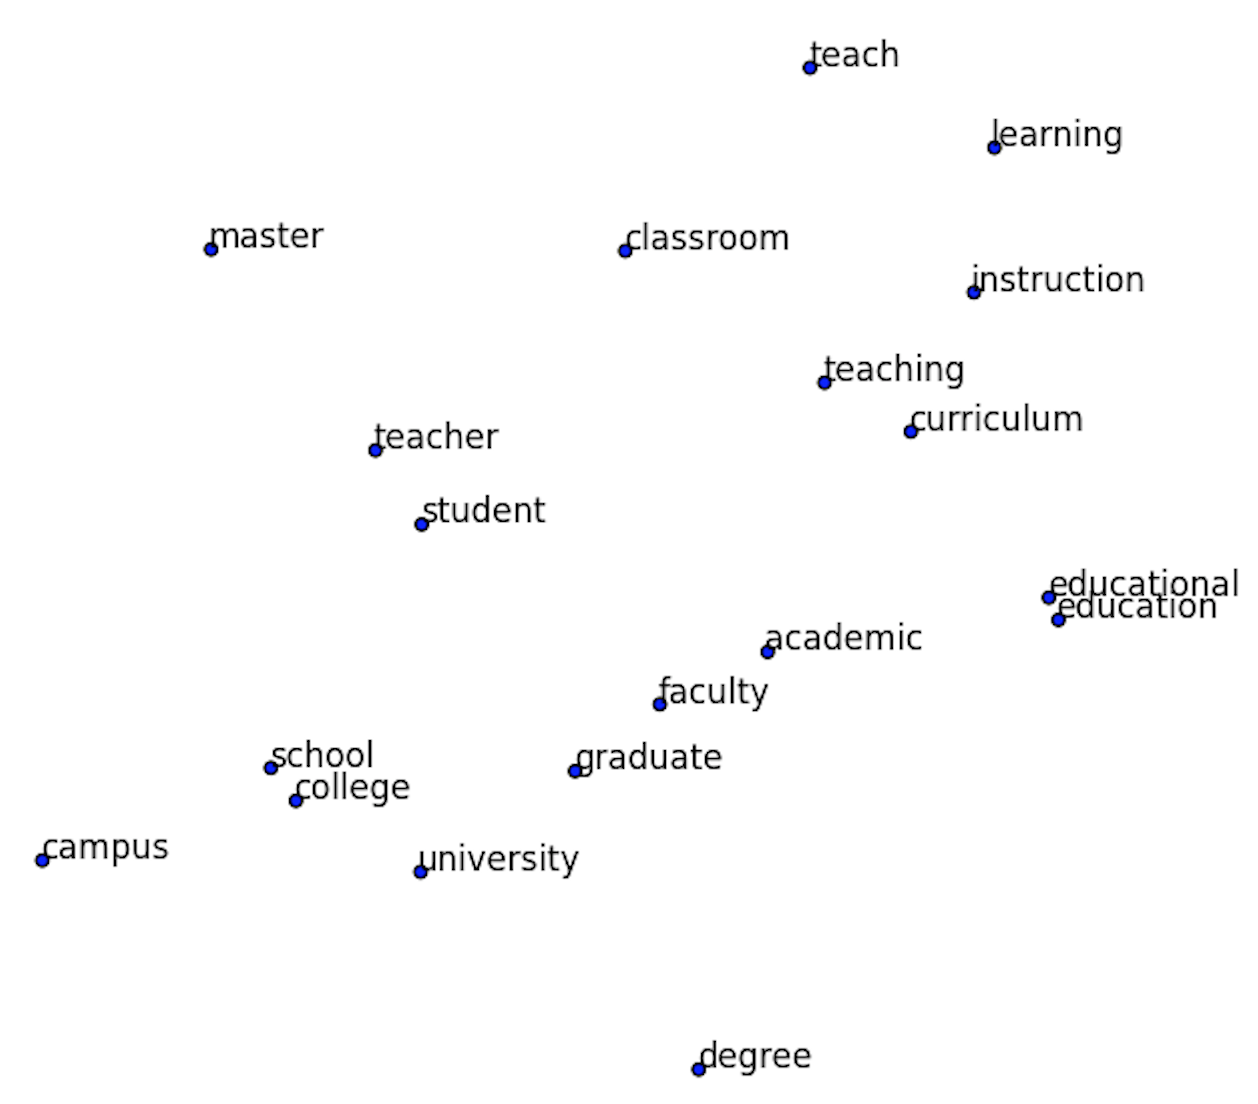
Imagem retirada de "Visualizing Word Embeddings with t-SNE"
A imagem acima é uma projeção do espaço de embeddings para 2D usando t-Distributed Stochastic Neighbor Embedding (t-SNE). O t-SNE é um método de redução de dimensionalidade que você pode usar para visualizar dados de alta dimensão. O método recebe os embeddings como entrada e os projeta em um espaço bidimensional, que pode ser facilmente visualizado em um gráfico. Apenas uma subseção do espaço de palavras é investigada, com foco em termos próximos de ‘teacher’. Em vez de representar palavras por dimensões pouco informativas em um vetor, os embeddings permitem representá-las por vetores semanticamente correlacionados.
Ao usar embeddings, um modelo de ML pode aproveitar informações de um grande conjunto de documentos, também conhecido como "corpus", incorporando-as nas representações vetoriais. Isso não é possível com modelos bag-of-words, o que pode prejudicar o desempenho quando há poucos dados disponíveis. Embeddings levam a representações de documentos que deixam de ser de comprimento fixo. Em vez disso, documentos passam a ser sequências de comprimento variável de vetores de palavras. Embora algumas técnicas de deep learning, como LSTMs, redes convolucionais com pooling adaptativo, etc., consigam lidar com sequências variáveis, geralmente é necessário muito dado para treiná-las bem.
Como você leu na introdução, o word2vec é um modelo de embeddings de palavras altamente popular, desenvolvido por Mikolov et al. Observe que existem outros modelos de embeddings dentro da semântica distribucional. Embora vários truques sejam necessários para obter embeddings de alta qualidade, este tutorial vai focar apenas na ideia central do word2vec.
O procedimento de treinamento a seguir é usado no word2vec para obter os embeddings.
Selecione uma palavra (pivô) no texto. As palavras de contexto da palavra pivô atual são aquelas que ocorrem ao seu redor. Isso significa trabalhar dentro de uma janela de tamanho fixo. As combinações de palavra pivô e palavras de contexto formam um conjunto de pares palavra–contexto. A imagem abaixo foi retirada do blog do Chris Moody sobre lda2vec. Neste trecho, ‘awesome’ é a palavra pivô e as palavras ao redor são tomadas como contexto, resultando em 7 pares palavra–contexto. 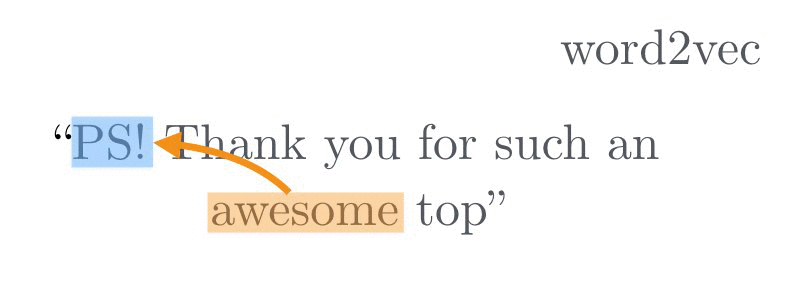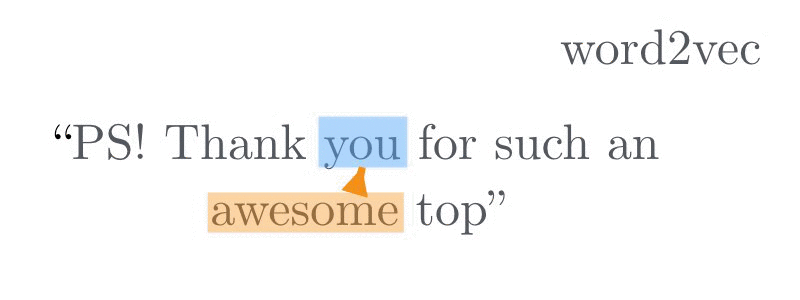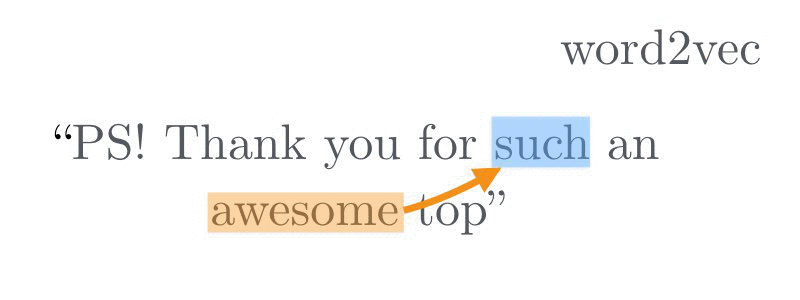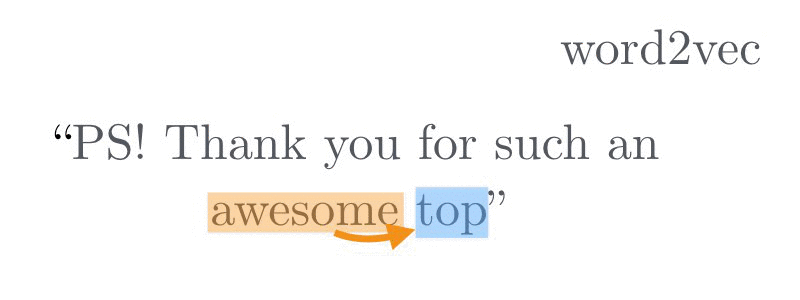
Existem duas variantes do word2vec: a. Na arquitetura bag-of-words (CBOW), a palavra pivô é prevista com base em um conjunto de palavras de contexto (ex.: dado ‘thank’, ‘such’, ‘you’, ‘top’, o modelo precisa prever ‘awesome’). É chamada de bag-of-words porque a ordem das palavras de contexto não importa. b. Na arquitetura skip-gram, a palavra pivô é usada para prever as palavras de contexto ao redor (ex.: dado ‘awesome’, prever ‘thank’, ‘such’, ‘you’, ‘top’). A imagem a seguir mostra as duas arquiteturas. Observe que é usado um modelo neural relativamente simples (duas camadas), se comparado a modelos profundos de visão computacional.
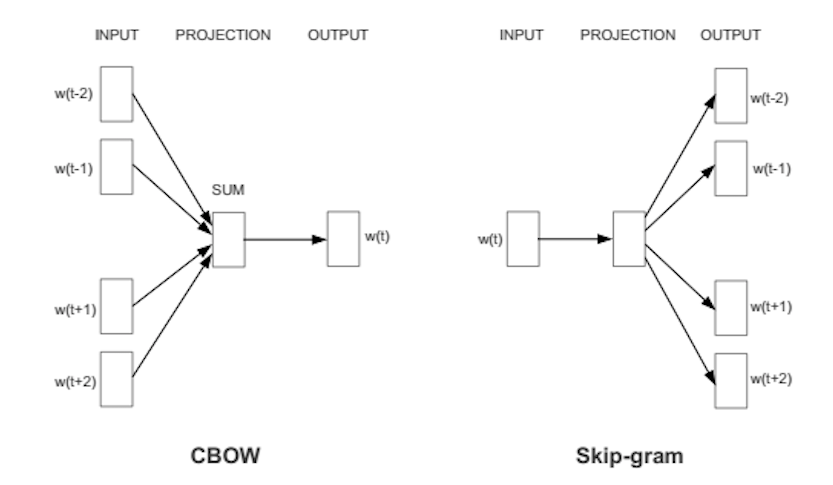
Treinando o modelo em um grande corpus, você obtém embeddings (os pesos na camada de projeção) que codificam informação semântica e algumas propriedades interessantes: é possível fazer aritmética vetorial, como $$king - man + woman = queen$$.
Vetores de palavras são uma representação útil em comparação, por exemplo, a uma codificação one-hot simples. Eles permitem incorporar informação estatística de um grande corpus em outros modelos, como classificação de tópicos ou sistemas de diálogo. Os vetores de palavras costumam ser densos, de alta dimensionalidade e não interpretáveis. Considere o exemplo: [ -0.65, -1.223, ..., -0.252, +3.2 ]. Enquanto na LDA as dimensões correspondem aproximadamente a tópicos, isso normalmente não acontece com vetores de palavras. Cada palavra recebe um vetor independente do contexto. Porém, o significado semântico das palavras depende muito do contexto. O word2vec aprende um vetor que prevê palavras de contexto em diferentes documentos. Como resultado, informações específicas de cada documento ficam misturadas nos embeddings.
Inspirado na Latent Dirichlet Allocation (LDA), o modelo word2vec é ampliado para aprender simultaneamente vetores de palavras, de documentos e de tópicos.
O lda2vec é obtido modificando a variante skip-gram do word2vec. No método skip-gram original, o modelo é treinado para prever palavras de contexto a partir de uma palavra pivô. No lda2vec, o vetor da palavra pivô é somado a um vetor de documento para obter um vetor de contexto. Esse vetor de contexto é então usado para prever as palavras do contexto.
Na próxima seção, você verá como esses vetores de documentos são construídos e como podem ser usados de forma semelhante aos vetores de documentos na LDA.
A ideia de integrar vetores de contexto ao word2vec não é nova. Os vetores de parágrafo, por exemplo, também exploraram essa ideia para aprender representações de comprimento fixo de trechos de texto de comprimento variável. No trabalho deles, para cada trecho (do tamanho de um parágrafo) é aprendido um vetor denso, semelhante aos vetores de palavras.
O problema dessa abordagem é que os vetores de contexto/parágrafo se parecem com vetores de palavras típicos, tornando-os menos interpretáveis do que, por exemplo, a saída da LDA.
O modelo lda2vec vai além da abordagem de vetores de parágrafo ao trabalhar com trechos do tamanho de documentos e decompor os vetores de documentos em dois componentes. No mesmo espírito da LDA, um vetor de documento é decomposto em um vetor de pesos do documento e uma matriz de tópicos. O vetor de pesos do documento representa a porcentagem dos diferentes tópicos, enquanto a matriz de tópicos contém os diferentes vetores de tópicos. Um vetor de contexto é, portanto, construído combinando os diferentes vetores de tópicos que ocorrem em um documento.
Considere o exemplo: no word2vec original, se a palavra pivô é ‘French’, as possíveis palavras de contexto poderiam ser ‘German’, ‘Dutch’, ‘English’. Sem qualquer informação global (relacionada ao documento), esses seriam palpites plausíveis.
Ao fornecer um vetor de contexto adicional no lda2vec, é possível fazer palpites melhores das palavras de contexto.
Se o vetor do documento for uma combinação dos tópicos ‘food’ e ‘drinks’, então ‘baguette’, ‘cheese’ e ‘wine’ podem ser mais adequadas. Se o vetor do documento se assemelhar aos tópicos ‘city’ e ‘geography’, então ‘Paris’, ‘Lyon’ e ‘Grenoble’ podem ser mais adequadas.
Note que esses vetores de tópicos são aprendidos no espaço de palavras, o que permite uma interpretação simples: basta olhar para os vetores de palavras mais próximos dos vetores de tópicos. Além disso, são impostas restrições aos vetores de pesos dos documentos para obter vetores esparsos (semelhantes aos da LDA), em vez de densos. Isso facilita a interpretação do conteúdo temático dos documentos.
Resumindo, o resultado final do lda2vec é um conjunto de vetores esparsos de pesos dos documentos, além de vetores de tópicos facilmente interpretáveis.
Embora o desempenho tenda a ser semelhante ao da LDA tradicional, o uso de métodos de diferenciação automática torna o método escalável para conjuntos de dados muito grandes. Além disso, ao combinar o vetor de contexto e o vetor da palavra, você obtém vetores de palavras ‘especializados’, que podem ser usados em outros modelos (e podem superar vetores mais ‘genéricos’).
O lda2vec é uma técnica de NLP relativamente nova e especializada. Como se baseia em métodos existentes, qualquer implementação de word2vec pode ser estendida para lda2vec. Chris Moody implementou o método em Chainer, mas outros frameworks de diferenciação automática também podem ser usados (CNTK, Theano, ...). Uma implementação em TensorFlow também foi disponibilizada publicamente.
Um panorama do módulo Python lda2vec pode ser encontrado aqui. Como treinar o lda2vec pode ser computacionalmente intenso, recomenda-se suporte a GPU para corpora maiores. Além disso, para acelerar o treinamento, os diferentes vetores de palavras costumam ser inicializados com vetores word2vec pré-treinados.
Por fim, discutimos o lda2vec como um modelo de tópicos, mas a ideia de adicionar vetores de contexto ao word2vec é mais geral. Considere, por exemplo, documentos escritos por autores de diferentes regiões. Vetores de autor e de região também poderiam ser adicionados ao vetor de contexto, resultando em um método não supervisionado para obter representações vetoriais de documentos, regiões e autores.
Este post apresentou um panorama rápido de LDA, word2vec e lda2vec. Observe que o autor original também publicou um excelente post com os detalhes técnicos do lda2vec.
Saiba mais sobre machine learning
Curso
Curso
Curso
blog
blog
Abid Ali Awan
7 min
blog
Moez Ali
14 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Zoumana Keita
7 min
Tutorial
Josep Ferrer
11 min