
Last chance! 50% off DataCamp Premium
Sale ends in
Bu blog yazısı, Chris Moody tarafından 2016’da yayımlanan lda2vec’e bir giriş sunacak. lda2vec, Mikolov ve arkadaşlarının 2013’te tanımladığı word2vec modelini konu ve belge vektörleriyle genişletir ve hem kelime gömme hem de konu modellerinden fikirler içerir.
Bir konu modelinin genel amacı, etiketlenmemiş belge koleksiyonundaki konuları veya yapıyı keşfetmek için kullanılabilecek, yorumlanabilir belge temsilleri üretmektir. Böyle bir yorumlanabilir belge temsilinin bir örneği şudur: belge X %20 konu a, %40 konu b ve %40 konu c’dir.
Bugünkü yazı Gizli Dirichlet Ayrımı’na (LDA) girişle başlayacak. LDA olasılıksal bir konu modelidir ve belgeleri kelime torbası (bag-of-words) olarak ele alır; bu nedenle önce bu yaklaşımın avantaj ve dezavantajlarını inceleyeceksiniz.
Öte yandan, lda2vec belge temsillerini kelime gömmelerinin üzerine inşa eder. Kelime gömmeleri hakkında ve neden günümüzde doğal dil işleme (NLP) modellerinde tercih edilen yapı taşı oldukları hakkında daha fazla bilgi edineceksiniz.
Son olarak, lda2vec’in arkasındaki genel fikri daha yakından öğreneceksiniz.
Bir konu modeli, etiketlenmemiş belgelerden oluşan bir koleksiyonu alır ve bu koleksiyondaki yapı veya konuları bulmaya çalışır. Konu modellerinin sıklıkla kelime kullanımının konu ortaya çıkışıyla ilişkili olduğunu varsaydığını unutmayın. Örneğin, bir konu modeline bir haber makalesi seti sağlayabilir ve model, belgeleri kelime kullanımına göre bir dizi kümeye ayırabilir.
Konu modelleri, büyük belge kümelerini otomatik olarak keşfetmek ve yapılandırmak için harika bir yöntemdir: belgeleri, içlerinde geçen kelimelere göre gruplar veya kümelerler. Benzer konulardaki belgeler benzer bir alt-sözcük dağarcığı kullanma eğiliminde olduğundan, ortaya çıkan belge kümeleri farklı ‘konular’ı tartışıyor olarak yorumlanabilir.
LDA, olasılıksal bir konu modeline örnektir. Bunun tam olarak ne anlama geldiğini, sonraki bölümlerde öğreneceksiniz: Önce LDA’nın farklı belgeleri temsil etmek için nasıl bir kelime torbası tanımından yola çıktığını anlayacaksınız. Ardından bu temsillerin belge koleksiyonundaki yapıyı bulmak için nasıl kullanıldığını göreceksiniz.
Geleneksel olarak, metin belgeleri NLP’de bir kelime torbası olarak temsil edilir.
Bu, her belgenin, uzunluğu sözlük boyutuna eşit sabit uzunlukta bir vektörle temsil edildiği anlamına gelir. Bu vektörün her bir boyutu, bir belgedeki bir kelimenin sayısına veya görülme sıklığına karşılık gelir. Değişken uzunluktaki belgeleri sabit uzunluklu vektörlere indirgemek, onları çok çeşitli makine öğrenimi (ML) modelleri ve görevleri (kümeleme, sınıflandırma, ...) ile kullanıma daha uygun hale getirir.
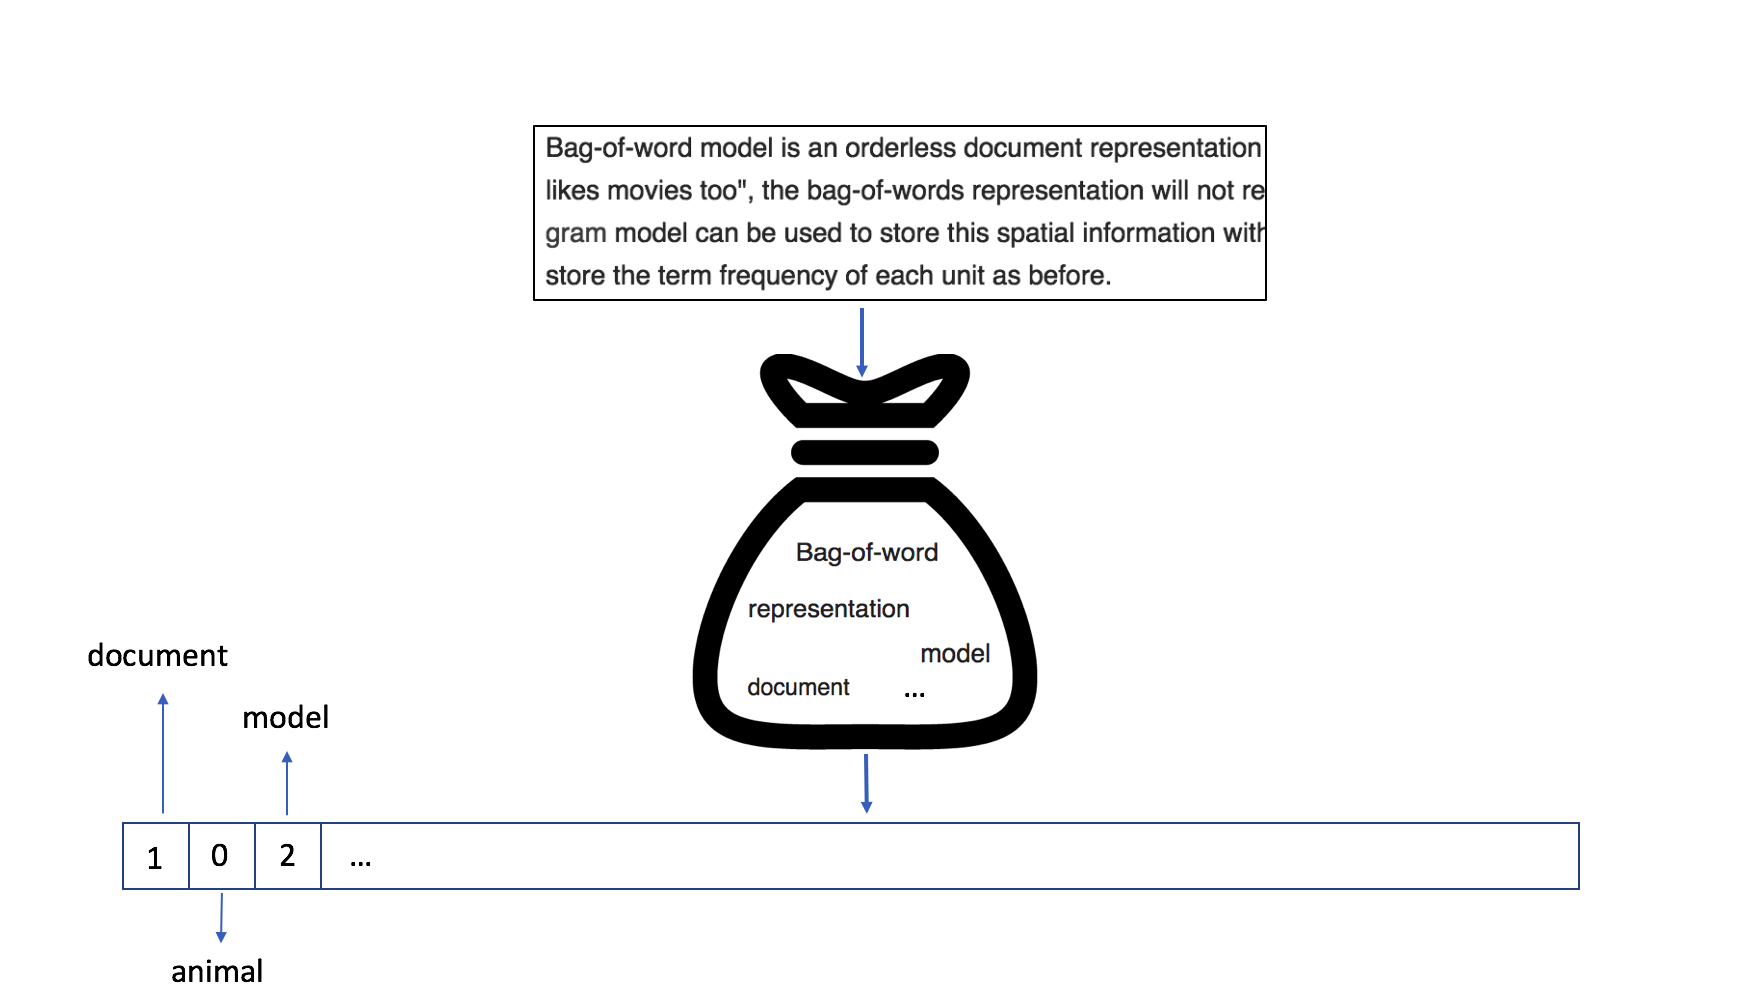
Yukarıdaki görsel, bir belgenin kelime torbası modelinde nasıl temsil edildiğini göstermektedir: "document" kelimesinin sayısı 1 iken, "model" kelimesi metinde iki kez geçmektedir.
Kelime torbası seyrek ve yüksek boyutlu bir belge temsiliyle sonuçlansa da, çok miktarda veri mevcutsa konu sınıflandırmasında sıklıkla iyi sonuçlar elde edilir. Yakın tarihli Facebook makalesini konu sınıflandırması üzerine her zaman okuyabilirsiniz.
Sabit uzunlukta belge temsili, farklı uzunluktaki belgeleri ML modellerine (SVM’ler, k-NN, Rastgele Ormanlar, ...) kolayca besleyebileceğiniz anlamına gelir. Bu da belgeler üzerinde kümeleme veya konu sınıflandırması yapmanıza olanak tanır. Belgenin yapısal bilgisi kaldırılır ve modellerin hangi vektör boyutlarının anlamsal olarak benzer olduğunu keşfetmesi gerekir. Örneğin ‘feline’ ve ‘cat’i farklı boyutlara eşlemek daha az sezgiseldir; çünkü model bu farklı boyutlar arasındaki ilişkiyi öğrenmeye zorlanır.
Bir LDA modeli eğitirken, bir belge koleksiyonuyla başlarsınız ve bunların her biri sabit uzunluklu bir vektörle (kelime torbası) temsil edilir. LDA genel bir Makine Öğrenimi (ML) tekniğidir; bu da, girdinin sabit uzunluklu vektörlerden oluşan bir koleksiyon olduğu ve amacın bu verinin yapısını keşfetmek olduğu diğer gözetimsiz ML sorunlarında da kullanılabileceği anlamına gelir.
Bir LDA modeli uygulamak için önce belge koleksiyonunuzda bulunan ‘konu’ sayısını tanımlayarak başlarsınız. Bu kulağa basit gelse de, çok büyük sayıda belgeyle çalışıyorsanız genellikle göründüğünden daha az sezgiseldir.
$$N$$ belge ve $$M$$ konuyla bir LDA modeli eğitmek, veriyi en iyi açıklayan belge ve konu vektörlerini bulmaya karşılık gelir.
Bu eğitim, LDA’nın arkasındaki tam teoriyi ayrıntılı olarak ele almayacaktır (bunun için Blei ve arkadaşlarının bu makalesine bakınız); odak daha çok genel fikri aktarmaktır.
Belgelerdeki sözlüğün $$V$$ kelimeden oluştuğunu varsayalım. 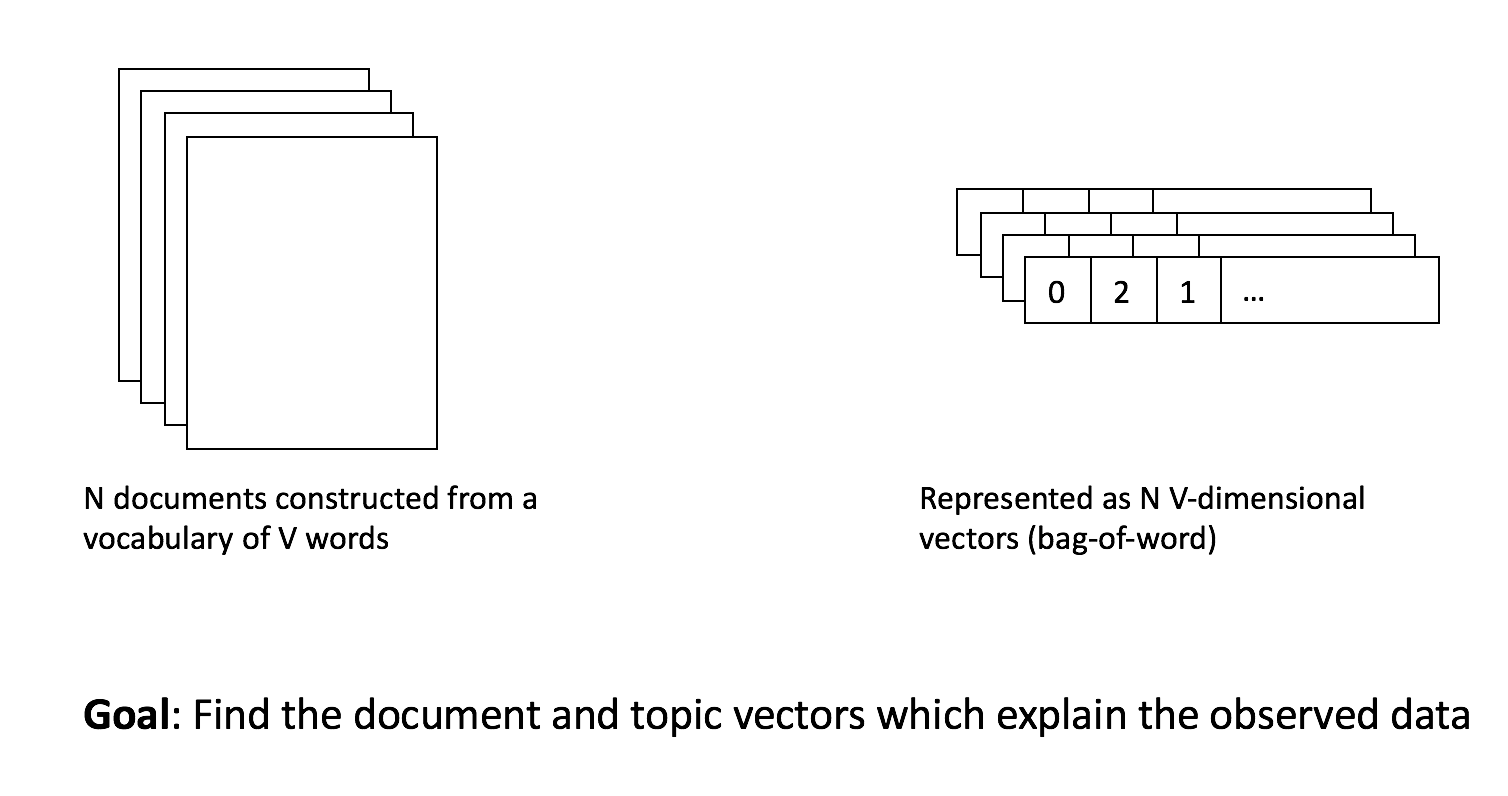
$$N$$ belgenin her biri, o belgede hangi konuların geçtiğini ayrıntılandıran, uzunluğu $$M$$ olan bir vektörle LDA modelinde temsil edilecektir. Bir belge, %75 ‘konu 1’ ve %25 ‘konu 2’den oluşabilir. LDA genellikle belge vektörlerinde çok sayıda sıfırla sonuçlanır; bu, belge başına yalnızca sınırlı sayıda konunun geçtiği anlamına gelir. Bu, belgelerin genellikle sınırlı sayıda konudan bahsettiği fikriyle uyumludur. Bu durum, bu belge vektörlerinin insan tarafından yorumlanabilirliğini önemli ölçüde artırır.
$$M$$ konunun her biri, bir belgede o konu söz konusu olduğunda hangi kelimelerin geçme olasılığının yüksek olduğunu ayrıntılandıran, uzunluğu $$V$$ olan bir vektörle temsil edilir. Örneğin, konu 1 için ‘learning’, ‘modelling’ ve ‘statistics’ en yaygın kelimeler olabilir. Bu durumda bunun ‘veri bilimi’ konusu olduğunu söyleyebilirsiniz. Konu 2 için ‘GPU’, ‘compute’ ve ‘storage’ en yaygın kelimeler olabilir. Bunu ‘bilgi-işlem’ konusu olarak yorumlayabilirsiniz.
Aşağıdaki görsel LDA modelini görsel olarak göstermektedir. Modelin hedefi, farklı belgelerin özgün kelime torbası temsillerini açıklayan konu ve belge vektörlerini bulmaktır. 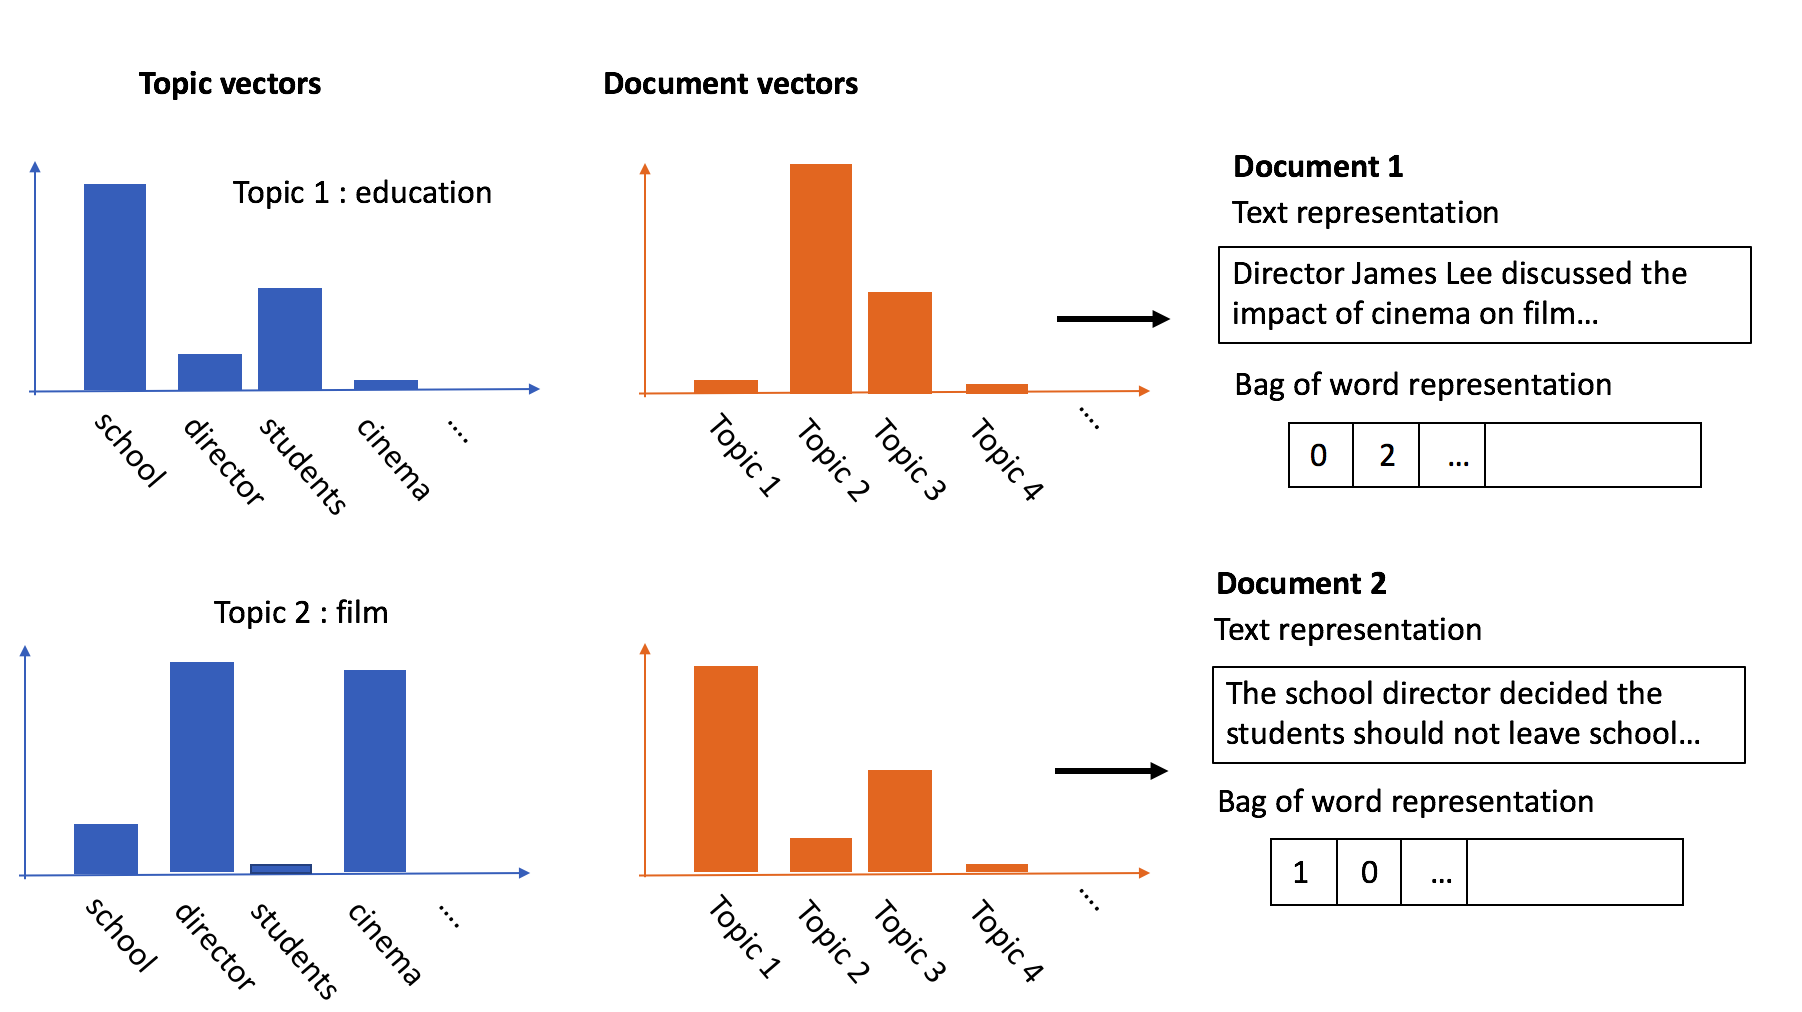
Yorumlanabilir konu vektörleri varsayımına dayandığınızı fark etmek önemlidir; aksi halde modelin çıktısı büyük ölçüde işe yaramaz. Özünde, yeterince veri verildiğinde modelin birlikte görülme eğilimindeki kelimeleri bulacağını ve bunları ayrı ‘konular’ halinde kümelendireceğini varsayıyorsunuz.
LDA, genellikle oldukça iyi çalışan basit bir olasılıksal modeldir. Belge vektörleri sıklıkla seyrek, düşük boyutlu ve oldukça yorumlanabilirdir; belgelerdeki örüntü ve yapıyı vurgular. Belge koleksiyonunda kaç konu olduğuna dair iyi bir tahmin belirlemeniz gerekir. Ayrıca, farklı konu vektörlerine elle belirgin bir adlandırma/‘konu’ atamalısınız. Belgeleri temsil etmek için bir kelime torbası modeli kullanıldığından, LDA kelime torbası modelinin aynı dezavantajlarından muzdarip olabilir. LDA modeli, belgelerdeki herhangi bir yapıyı veya kelimelerin yerel düzeyde nasıl etkileştiğini göz ardı ederek, o belgedeki kelimeleri öngören bir belge vektörü öğrenir.
Kelime torbası temsilinin sorunlarından biri, belge vektörlerindeki hangi boyutların anlamsal olarak ilişkili olduğunu bulma sorumluluğunun modele düşmesidir. Kelimelerin birbirleriyle anlamsal olarak nasıl ilişkili olduğuna dair bilgiden yararlanmanın bir modelin performansını artıracağını düşünebilirsiniz ve kelime gömmeleri tam olarak bunu vaat eder.
Kelime gömmelerinde, kelimeler sabit uzunluklu vektörler veya gömmeler olarak temsil edilir. Gömmeleri oluşturmak için çeşitli farklı modeller vardır, ancak hepsi dağıtımsal hipoteze dayanır. Bu da "bir kelime, birlikte bulunduğu kelimelerle tanımlanır" anlamına gelir.
Kelime gömmelerinin amacı, Wikipedia gibi büyük gözetimsiz belge kümelerinden dildeki anlamsal ve sözdizimsel düzenlilikleri yakalamaktır. Aynı bağlamda geçen kelimeler, birbirine yakın vektörlerle temsil edilir.
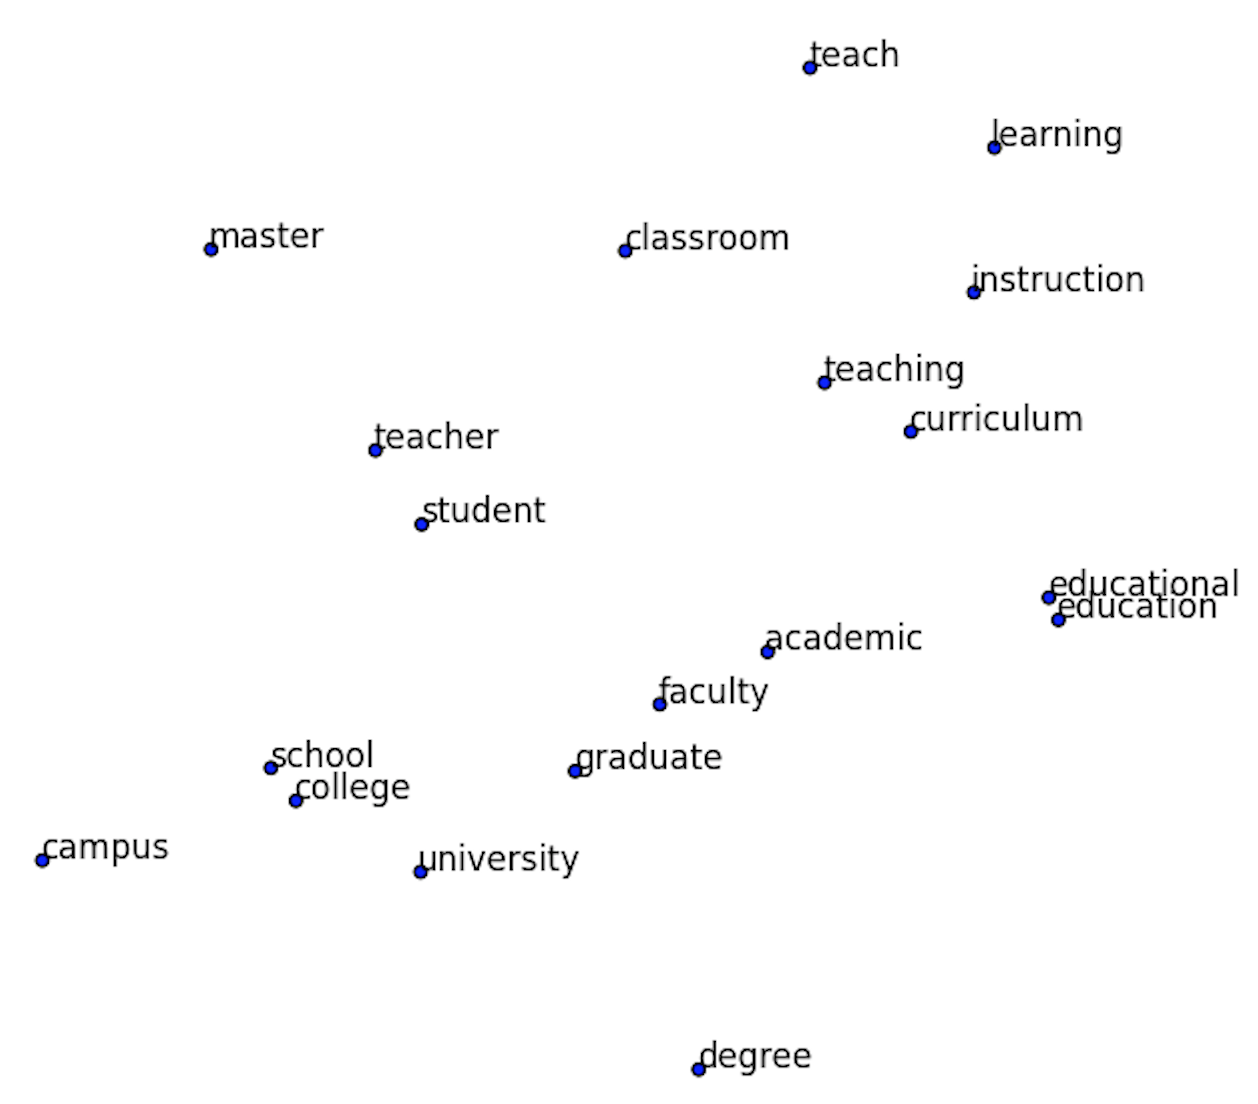
Görsel, "t-SNE ile Kelime Gömmelerini Görselleştirme" yazısından alınmıştır
Yukarıdaki görsel, kelime gömme uzayının t-Distributed Stochastic Neighbor Embedding (t-SNE) kullanılarak 2B uzaya izdüşümüdür. t-SNE, yüksek boyutlu veriyi görselleştirmek için kullanabileceğiniz bir boyut indirgeme yöntemidir. Yöntem, girdi olarak kelime gömmelerini alır ve kolayca grafiğe dökülebilen iki boyutlu bir uzaya yansıtır. Kelime uzayının yalnızca bir alt bölümü incelenir ve ‘teacher’a yakın kelimelere odaklanılır. Kelimeleri bir vektördeki bilgi vermeyen boyutlarla temsil etmek yerine, kelime gömmeleri kullanılarak kelimeler anlamsal olarak ilişkili vektörlerle temsil edilebilir.
Kelime gömmeleri kullanıldığında, bir ML modeli, bir "korpus" olarak da bilinen büyük bir belge koleksiyonundan bilgiyi vektör temsillerine gömerek yararlanabilir. Bu, yeterince veri olmadığında model performansına zarar verebilen kelime torbası modelleriyle mümkün değildir. Kelime gömmeleri, artık sabit uzunluklu olmayan belge temsillerine yol açar. Bunun yerine, belgeler değişken uzunluklu kelime vektör gömmeleri dizileriyle temsil edilir. Bazı derin öğrenme teknikleri, örneğin Uzun Kısa Süreli Bellek (LSTM)’ler, uyarlanabilir havuzlamalı evrişimli ağlar, ... değişken uzunluklu dizilerle başa çıkabilse de, bunları düzgün şekilde eğitmek için sıklıkla çok miktarda veriye ihtiyaç vardır.
Girişte de okuduğunuz gibi, word2vec Mikolov ve arkadaşları tarafından geliştirilen son derece popüler bir kelime gömme modelidir. Dağıtımsal anlambilim alanında başka kelime gömme modellerinin de bulunduğunu unutmayın. Yüksek kaliteli kelime gömmeleri elde etmek için çeşitli hileler gerekse de, bu eğitim yalnızca word2vec’in temel fikrine odaklanacaktır.
Kelime gömmelerini elde etmek için word2vec’te aşağıdaki eğitim prosedürü kullanılır.
Metindeki bir (eksen) kelimeyi seçin. Geçerli eksen kelimenin bağlam kelimeleri, eksen kelimenin etrafında geçen kelimelerdir. Bu, sabit uzunluklu bir kelime penceresi içinde çalıştığınız anlamına gelir. Eksen ve bağlam kelimelerinin kombinasyonları bir dizi kelime-bağlam çifti oluşturur. Aşağıdaki görsel Chris Moody’nin lda2vec üzerine blogundan alınmıştır. Bu metin parçasında ‘awesome’ eksen kelimedir ve çevresindeki kelimeler bağlam kelimeleri olarak alınır; bu da 7 kelime-bağlam çifti ile sonuçlanır. 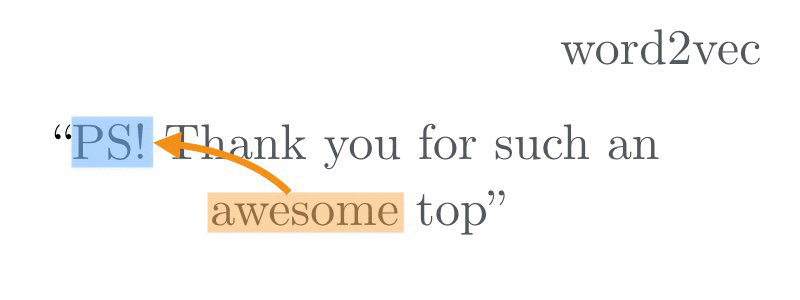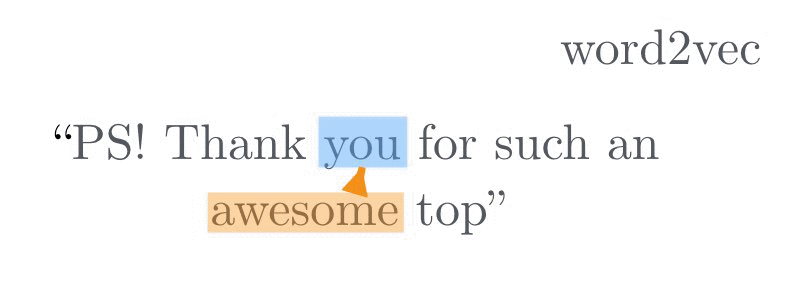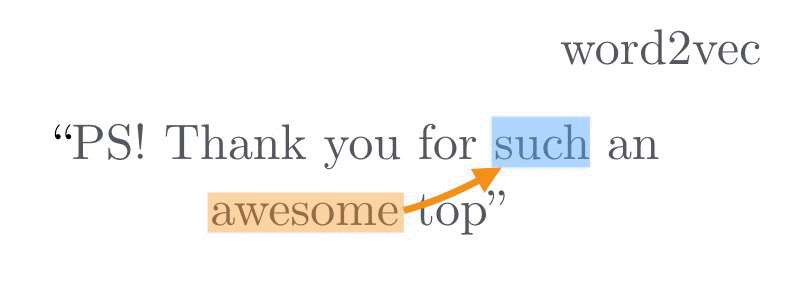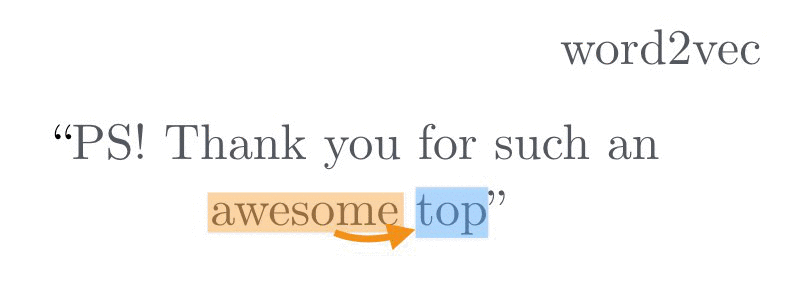
word2vec modelinin iki varyantı vardır: a. Torba-kelime (CBOW) mimarisinde, eksen kelime bir grup çevreleyen bağlam kelimesine göre tahmin edilir (ör. ‘thank’, ‘such’, ‘you’, ‘top’ verildiğinde model ‘awesome’ı tahmin etmelidir). Bu, bağlam kelimelerinin sırasının önemli olmaması nedeniyle bir torba-kelime mimarisi olarak adlandırılır. b. Skip-gram mimarisinde, eksen kelime çevredeki bağlam kelimelerini tahmin etmek için kullanılır (ör. ‘awesome’ verildiğinde ‘thank’, ‘such’, ‘you’, ‘top’u tahmin edin). Aşağıdaki görsel iki farklı word2vec mimarisini göstermektedir. Bilgisayarla görmede kullanılan derin sinir ağlarına kıyasla görece basit (iki katmanlı) bir sinirsel model kullanıldığını unutmayın.
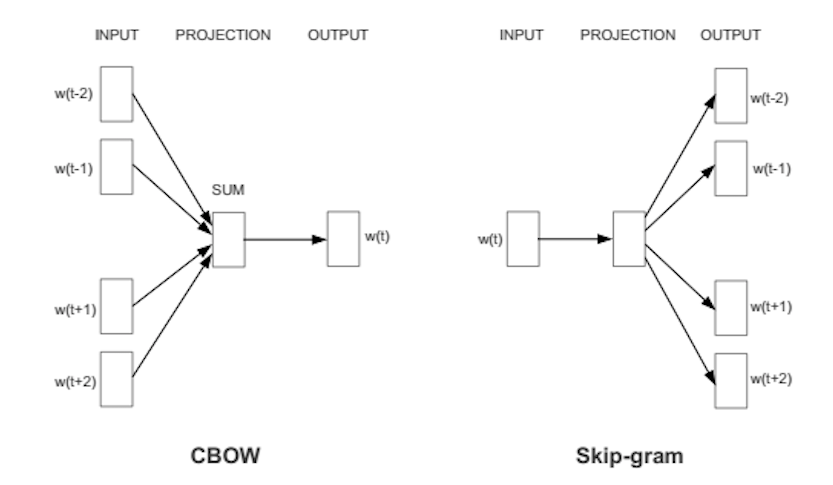
Modeli büyük bir korpus üzerinde eğiterek, anlamsal bilgi ve bazı ilginç özellikleri kodlayan kelime gömmeleri (projeksiyon katmanındaki ağırlıklar) elde edersiniz: $$king - man + woman = queen$$ gibi vektör aritmetiği yapmak mümkündür.
Kelime vektörleri, örneğin basit tek-sıcak (one-hot) kodlu temsile kıyasla kullanışlı bir temsildir. Büyük bir korpustan istatistiksel bilgiyi konu sınıflandırma veya diyalog sistemleri gibi diğer modellere kodlamaya olanak tanırlar. Kelime vektörleri çoğunlukla yoğun, yüksek boyutlu ve yorumlanamazdır. Şu örneği düşünün: [ -0.65, -1.223, ..., -0.252, +3.2]. LDA’da boyutlar yaklaşık olarak konulara karşılık gelirken, bu genellikle kelime vektörleri için geçerli değildir. Her kelimeye bağlamdan bağımsız bir kelime vektörü atanır. Oysa kelimelerin anlamsal anlamı bağlama büyük ölçüde bağlıdır. word2vec modeli, farklı belgelerde bağlam kelimelerini tahmin eden bir kelime vektörü öğrenir. Sonuç olarak, belgeye özgü bilgiler kelime gömmelerinde birbirine karışır.
LDA’dan esinle, word2vec modeli aynı anda kelime, belge ve konu vektörlerini öğrenmek üzere genişletilmiştir.
Lda2vec, skip-gram word2vec varyantının değiştirilmesiyle elde edilir. Özgün skip-gram yönteminde, model eksen kelimeye dayanarak bağlam kelimelerini tahmin etmek üzere eğitilir. lda2vec’te, eksen kelime vektörü ve bir belge vektörü toplanarak bir bağlam vektörü elde edilir. Bu bağlam vektörü daha sonra bağlam kelimelerini tahmin etmek için kullanılır.
Bir sonraki bölümde, bu belge vektörlerinin nasıl oluşturulduğunu ve LDA’daki belge vektörlerine benzer şekilde nasıl kullanılabildiklerini göreceksiniz.
Bağlam vektörlerini word2vec modeline entegre etme fikri yeni değildir. Örneğin, paragraf vektörleri de değişken uzunluktaki metin parçalarının sabit uzunluklu temsillerini öğrenmek için bu fikri araştırmıştır. Bu çalışmalarında, her bir metin parçası (paragraf boyutunda) için, öğrenilen kelime vektörlerine benzer şekilde yoğun bir vektör temsili öğrenilir.
Bu yaklaşımın dezavantajı, bağlam/paragraf vektörlerinin tipik kelime vektörlerine benzemesidir; bu da onları örneğin LDA çıkışı kadar yorumlanabilir kılmaz.
lda2vec modeli, belge boyutundaki metin parçalarıyla çalışarak ve belge vektörlerini iki farklı bileşene ayrıştırarak paragraf vektörü yaklaşımının bir adım ötesine geçer. LDA modelinin ruhuna uygun olarak, bir belge vektörü bir belge ağırlık vektörüne ve bir konu matrisine ayrıştırılır. Belge ağırlık vektörü farklı konuların yüzdesini temsil ederken, konu matrisi farklı konu vektörlerinden oluşur. Böylece bir bağlam vektörü, bir belgede geçen farklı konu vektörlerinin birleştirilmesiyle oluşturulur.
Şu örneği düşünün: özgün word2vec modelinde, eksen kelime ‘French’ ise olası bağlam kelimeleri ‘German’, ‘Dutch’, ‘English’ olabilir. Herhangi bir küresel (belgeyle ilgili) bilgi olmadan bunlar en makul tahminlerdir.
lda2vec modelinde ek bir bağlam vektörü sağlayarak bağlam kelimeleri için daha iyi tahminler yapmak mümkündür.
Eğer belge vektörü ‘yemek’ ve ‘içecekler’ konularının bir kombinasyonuysa, ‘baguette’, ‘cheese’ ve ‘wine’ daha uygun olabilir. Belge vektörü ‘şehir’ ve ‘coğrafya’ konularına benzerse, ‘Paris’, ‘Lyon’ ve ‘Grenoble’ daha uygun olabilir.
Bu konu vektörlerinin kelime uzayında öğrenildiğini ve bunun da kolay yorumlamaya imkân tanıdığını unutmayın: sadece konu vektörlerine en yakın kelime vektörlerine bakarsınız. Ayrıca, belge ağırlık vektörlerine, yoğun bir vektör yerine (LDA’ya benzer şekilde) seyrek bir vektör elde etmek için kısıtlar getirilir. Bu, farklı belgelerin konu içeriğinin kolay yorumlanmasını sağlar.
Kısacası, lda2vec’in nihai sonucu seyrek belge ağırlık vektörleri ile kolayca yorumlanabilir konu vektörlerinden oluşan bir settir.
Performans geleneksel LDA’ya benzer olma eğiliminde olsa da, otomatik türev alma yöntemlerini kullanmak yöntemi çok büyük veri kümelerine ölçeklenebilir kılar. Ayrıca, bağlam vektörü ile kelime vektörünü birleştirerek, diğer modellerde kullanılabilecek (‘genel’ kelime vektörlerinden daha iyi performans gösterebilecek) ‘uzmanlaşmış’ kelime vektörleri elde edersiniz.
Lda2vec oldukça yeni ve özel bir NLP tekniğidir. Mevcut yöntemlere dayandığı için herhangi bir word2vec uygulaması lda2vec’e genişletilebilir. Chris Moody yöntemi Chainer ile uygulamıştır, ancak diğer otomatik türev alma çerçeveleri de (CNTK, Theano, ...) kullanılabilir. Bir Tensorflow uygulaması da herkese açıklandı.
lda2vec Python modülüne genel bir bakış burada bulunabilir. lda2vec eğitimi hesaplama açısından yoğun olabileceğinden, daha büyük korpuslar için GPU desteği önerilir. Ayrıca, eğitimi hızlandırmak için farklı kelime vektörleri sıklıkla önceden eğitilmiş word2vec vektörleriyle başlatılır.
Son olarak, lda2vec bir konu modeli olarak tartışıldı; ancak bağlam vektörlerini word2vec modeline ekleme fikri daha genel olarak da tanımlanabilir. Örneğin, farklı bölgelerden farklı yazarlar tarafından yazılmış belgeleri düşünün. O zaman yazar ve bölge vektörleri de bağlam vektörüne eklenebilir; bu da belge, bölge ve yazar vektör temsillerini elde etmek için gözetimsiz bir yöntemle sonuçlanır.
Bu blog yazısı yalnızca LDA, word2vec ve lda2vec’e hızlı bir genel bakış sundu. Özgün yazarın, lda2vec’in teknik ayrıntıları üzerine harika bir blog yazısı yayımladığını da unutmayın.
Makine Öğrenimi hakkında daha fazlasını öğrenin
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




