Cours
Comprendre le Machine Learning
2 h
308.2K
Cet article vous propose une introduction à lda2vec, un modèle de thématisation publié par Chris Moody en 2016. lda2vec étend le modèle word2vec, décrit par Mikolov et al. en 2013, en y intégrant des vecteurs de sujets et de documents, et combine des idées issues à la fois des plongements lexicaux et des modèles de sujets.
L’objectif d’un modèle de sujets est de produire des représentations de documents interprétables, utilisables pour découvrir les thèmes ou la structure d’un corpus non étiqueté. Exemple de représentation interprétable : le document X est composé à 20 % du sujet a, 40 % du sujet b et 40 % du sujet c.
Aujourd’hui, nous commencerons par présenter la Latent Dirichlet Allocation (LDA). LDA est un modèle de sujets probabiliste qui traite les documents comme un sac de mots (bag‑of‑words) ; nous verrons d’abord les avantages et limites de cette approche.
À l’inverse, lda2vec construit les représentations de documents à partir de plongements de mots. Vous en apprendrez davantage sur ces plongements et pourquoi ils sont devenus les briques de base privilégiées des modèles de traitement automatique du langage (NLP).
Enfin, nous détaillerons l’intuition générale derrière lda2vec.
Un modèle de sujets prend un ensemble de documents non étiquetés et tente d’en extraire la structure ou les thèmes. Ces modèles supposent souvent que l’usage des mots est corrélé à l’occurrence de certains sujets. Vous pouvez, par exemple, donner au modèle un ensemble d’articles de presse ; il regroupera alors les documents en plusieurs clusters selon les mots employés.
Les modèles de sujets sont un excellent moyen d’explorer et d’organiser automatiquement un grand volume de documents : ils regroupent les textes en fonction du vocabulaire qu’ils contiennent. Comme des documents sur des thèmes proches partagent généralement un sous‑vocabulaire commun, les clusters obtenus peuvent être interprétés comme des « sujets » distincts.
La Latent Dirichlet Allocation (LDA) est un exemple de modèle de sujets probabiliste. Ce que cela recouvre exactement sera clarifié dans les sections suivantes : nous verrons comment LDA part d’une représentation sac de mots pour représenter les documents, puis comment ces représentations servent à découvrir la structure du corpus.
Traditionnellement, en NLP, on représente les textes sous forme de sac de mots.
Chaque document est alors encodé par un vecteur de longueur fixe, égale à la taille du vocabulaire. Chaque dimension de ce vecteur correspond au nombre d’occurrences d’un mot dans le document. Ramener des documents de longueur variable à des vecteurs de longueur fixe les rend plus faciles à utiliser avec toute une gamme de modèles et tâches de machine learning (clustering, classification, etc.).
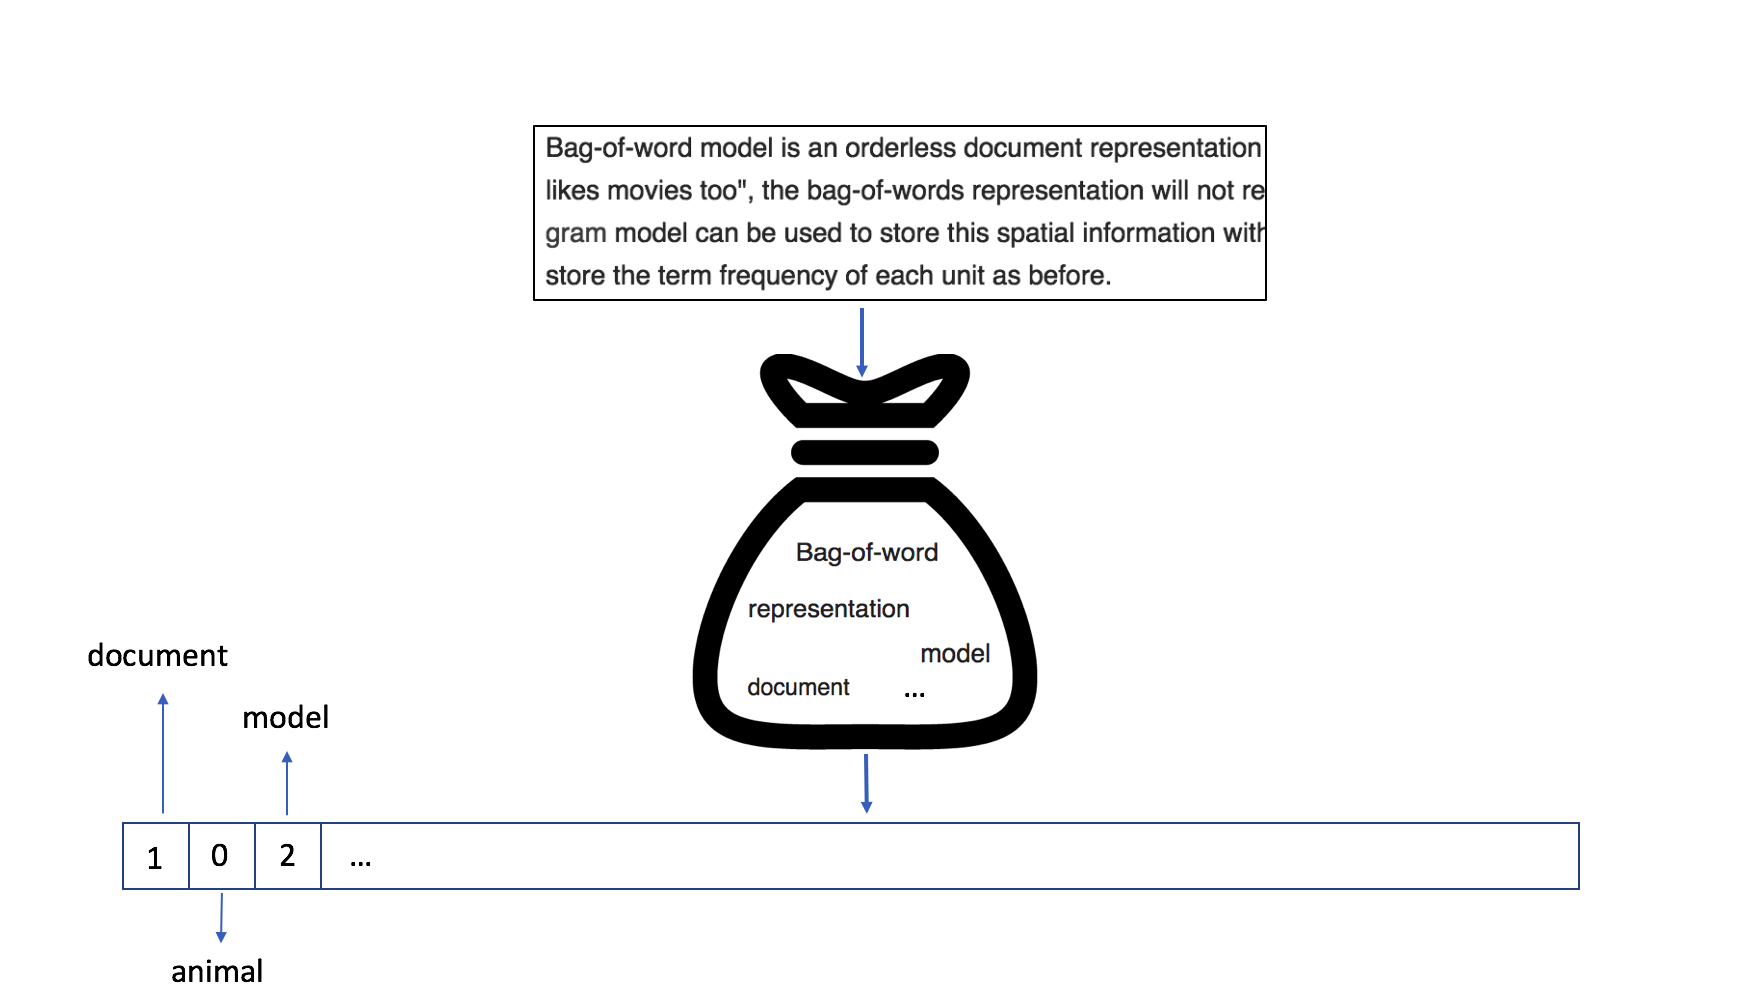
L’illustration ci‑dessus montre comment un document est représenté dans un modèle sac de mots : le mot « document » apparaît 1 fois, tandis que le mot « modèle » apparaît 2 fois.
Même si cette représentation est clairsemée et de grande dimension, elle donne souvent de bons résultats en classification de sujets lorsque l’on dispose de beaucoup de données. Vous pouvez consulter à ce propos le papier de Facebook sur la classification de sujets.
Une représentation de longueur fixe permet d’ingérer facilement des documents de longueur variable dans des modèles de ML (SVM, k‑NN, Random Forests, etc.). Vous pouvez ainsi effectuer du clustering ou de la classification thématique. En revanche, l’information structurelle du document est perdue et les modèles doivent découvrir quelles dimensions du vecteur sont sémantiquement proches. Par exemple, mapper « feline » et « cat » sur des dimensions différentes est moins intuitif : le modèle doit apprendre la corrélation entre ces dimensions.
Pour entraîner un modèle LDA, vous partez d’une collection de documents, chacun représenté par un vecteur de longueur fixe (sac de mots). LDA est une technique générale de machine learning non supervisée ; elle s’applique à tout problème où l’entrée est une collection de vecteurs de longueur fixe et où l’on cherche à explorer la structure des données.
Pour mettre en œuvre LDA, on commence par fixer le nombre de « sujets » présents dans la collection. Cela semble simple, mais devient rapidement moins intuitif avec des corpus volumineux.
Entraîner un modèle LDA sur $$N$$ documents avec $$M$$ sujets revient à trouver les vecteurs de documents et de sujets qui expliquent au mieux les données.
Nous n’entrerons pas dans tous les détails théoriques de LDA (voir cet article de Blei et al.), l’objectif étant de transmettre l’intuition générale.
Supposons que le vocabulaire des documents contienne $$V$$ mots. 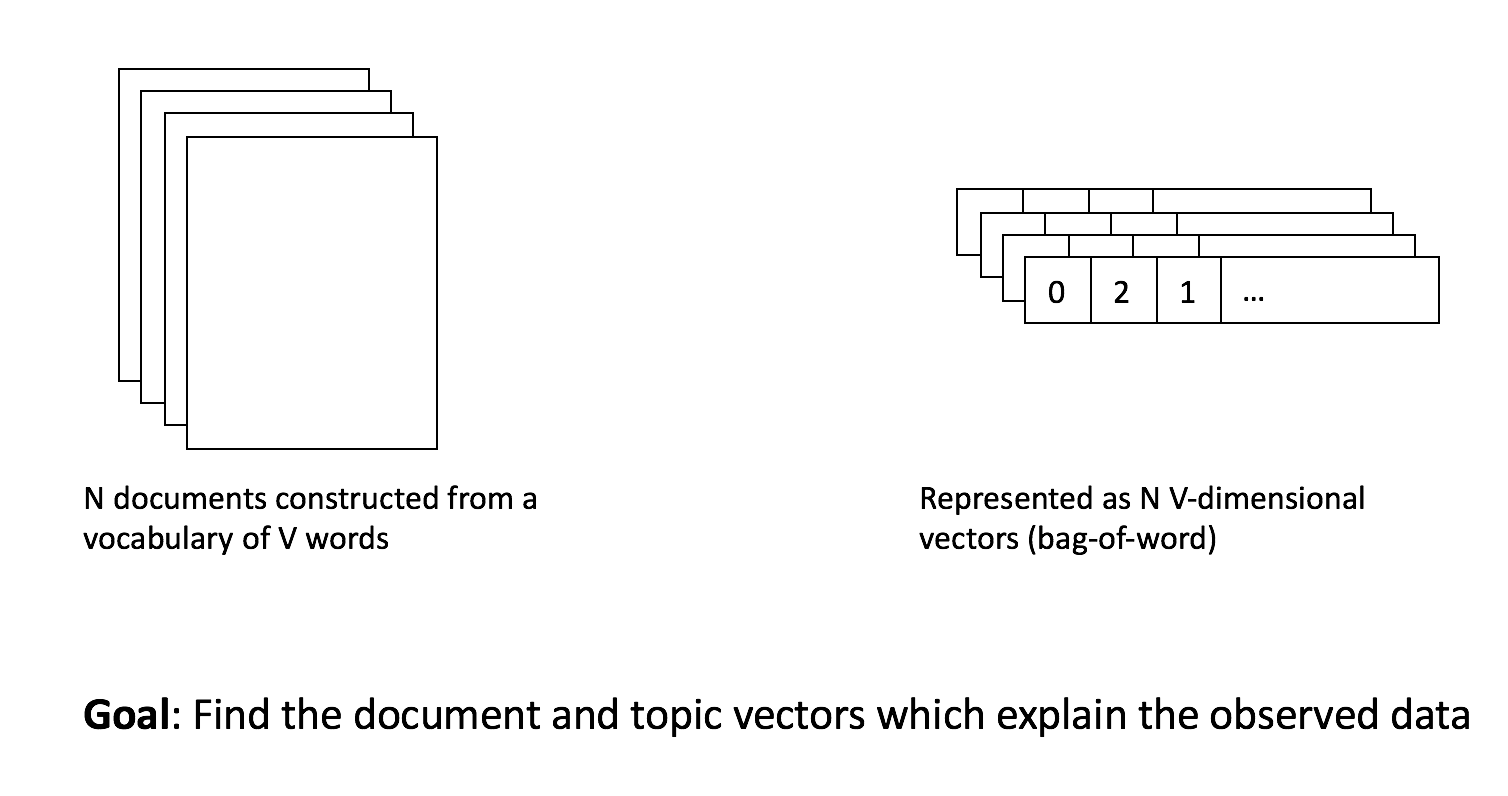
Chacun des $$N$$ documents est représenté dans LDA par un vecteur de longueur $$M$$ indiquant les sujets présents dans ce document. Un document peut, par exemple, être composé à 75 % du « sujet 1 » et à 25 % du « sujet 2 ». LDA produit souvent des vecteurs de documents clairsemés, avec beaucoup de zéros : peu de sujets par document, ce qui reflète le fait qu’un texte traite en général d’un nombre limité de thèmes. Cela améliore nettement l’interprétabilité humaine.
Chacun des $$M$$ sujets est représenté par un vecteur de longueur $$V$$ indiquant les mots susceptibles d’apparaître dans un document relevant de ce sujet. Pour le sujet 1, « learning », « modelling » et « statistics » peuvent être parmi les mots les plus fréquents : on pourra l’interpréter comme le sujet « data science ». Pour le sujet 2, « GPU », « compute » et « storage » domineront peut‑être : ce sera le sujet « informatique ».
L’image suivante illustre le modèle LDA. Le but est de trouver les vecteurs de sujets et de documents qui expliquent la représentation sac de mots des différents textes. 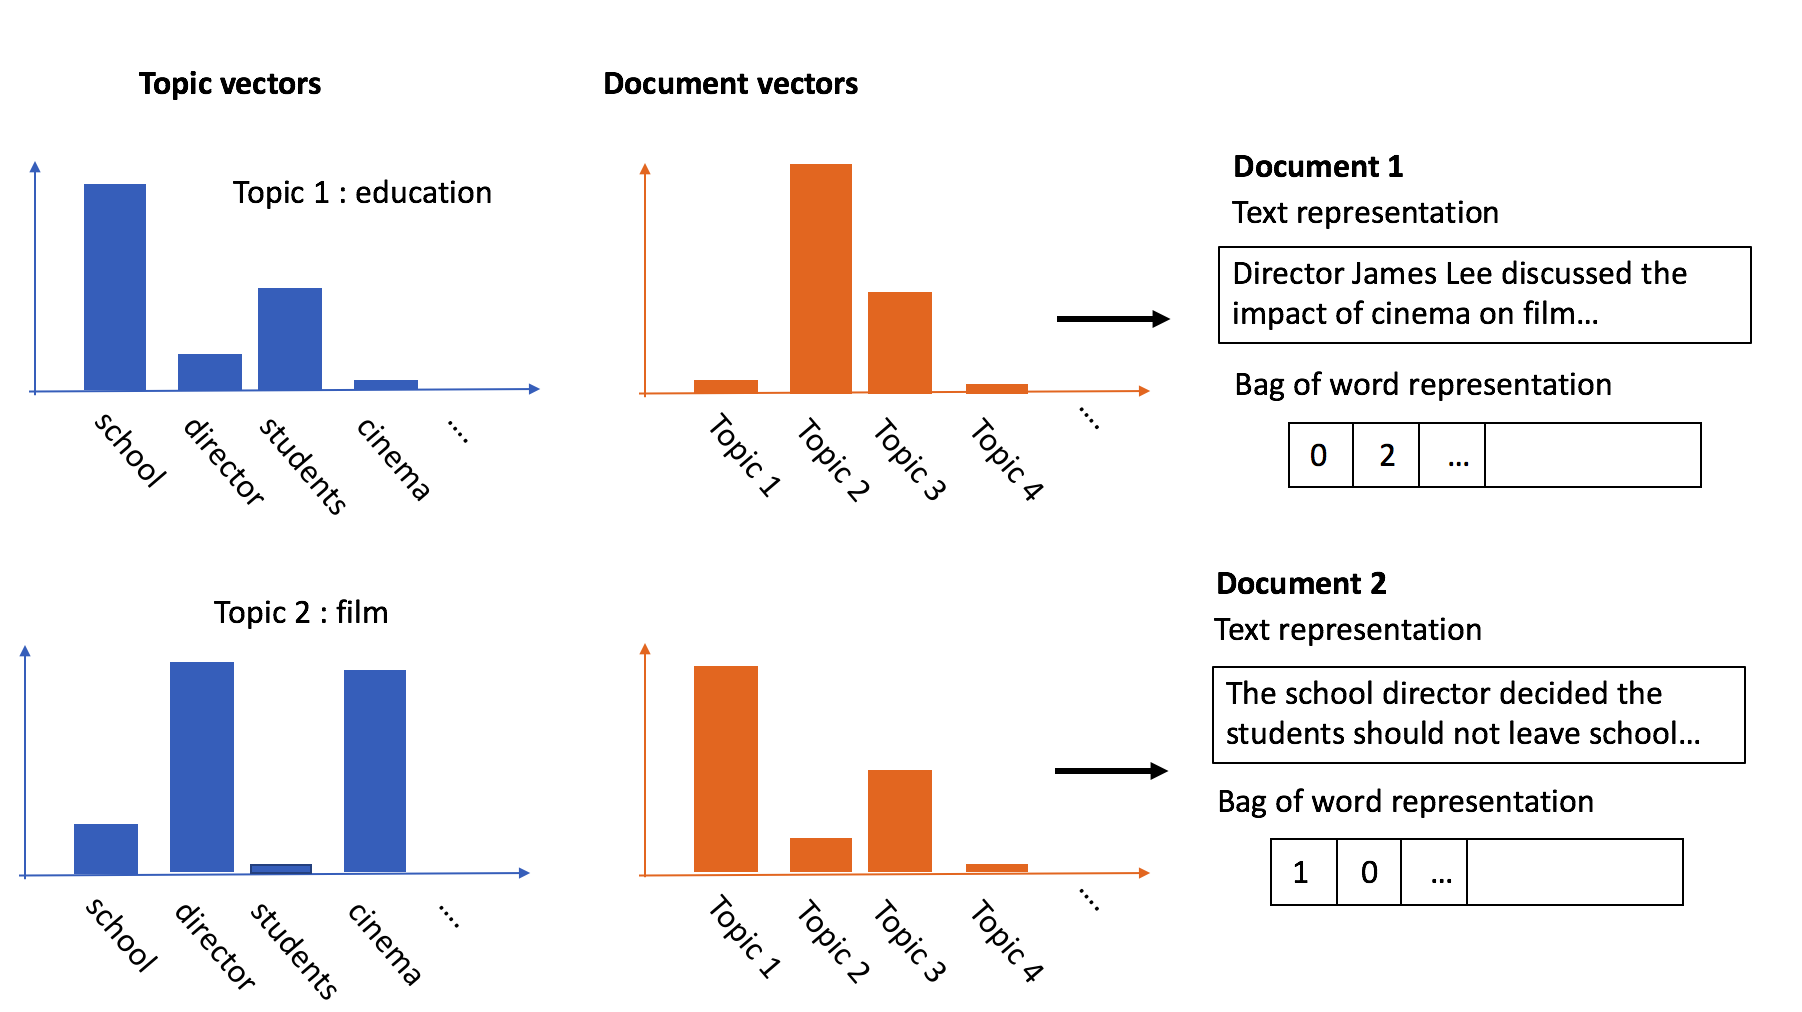
Il est important de garder à l’esprit que l’on mise sur l’interprétabilité des vecteurs de sujets ; sinon, la sortie du modèle perd tout intérêt. En substance, on suppose que, avec suffisamment de données, le modèle repère les mots qui co‑apparaissent et les regroupe en « sujets » distincts.
LDA est un modèle probabiliste simple qui fonctionne généralement très bien. Les vecteurs de documents sont souvent clairsemés, de faible dimension et très interprétables, ce qui met en évidence les motifs et la structure des textes. Il faut estimer de façon pertinente le nombre de sujets présents dans le corpus. De plus, il est nécessaire d’assigner manuellement un intitulé/« sujet » aux différents vecteurs de sujets. Comme LDA repose sur une représentation sac de mots, il hérite de ses limites. Le modèle LDA apprend un vecteur de document qui prédit les mots du document sans tenir compte de la structure locale ni des interactions entre mots.
L’une des limites du sac de mots est que le modèle doit déduire quelles dimensions des vecteurs de documents sont sémantiquement liées. Exploiter la proximité sémantique entre mots peut améliorer les performances ; c’est précisément la promesse des plongements lexicaux.
Avec les word embeddings, les mots sont représentés par des vecteurs de longueur fixe. Plusieurs modèles existent pour construire ces plongements, tous fondés sur l’hypothèse distributionnelle : « un mot se définit par la compagnie qu’il tient ».
Le but est de capturer des régularités sémantiques et syntaxiques à partir de vastes corpus non supervisés, comme Wikipedia. Des mots apparaissant dans des contextes similaires sont représentés par des vecteurs proches.
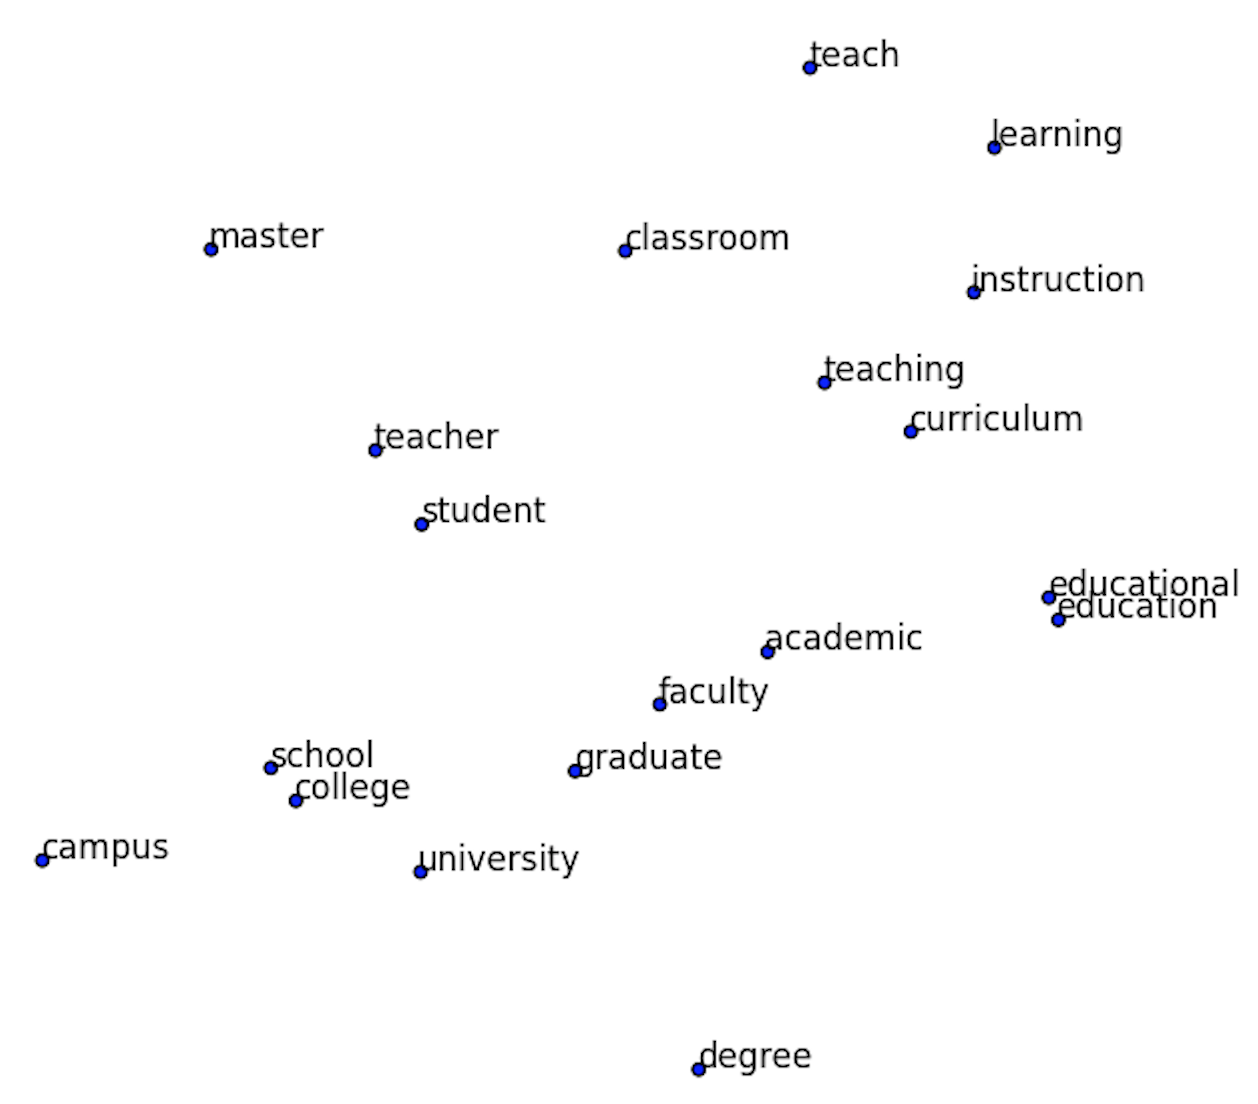
Image tirée de « Visualizing Word Embeddings with t‑SNE »
L’image ci‑dessus est une projection de l’espace des plongements de mots en 2D grâce au t‑Distributed Stochastic Neighbor Embedding (t‑SNE), une méthode de réduction de dimension utilisable pour visualiser des données de grande dimension. La méthode prend les plongements en entrée et les projette en deux dimensions pour un tracé lisible. Seule une sous‑portion de l’espace lexical est visualisée, en se concentrant sur les mots proches de « teacher ». Plutôt que de représenter les mots par des dimensions peu informatives, les plongements permettent de les représenter par des vecteurs corrélés sémantiquement.
Avec les word embeddings, un modèle de ML peut tirer parti d’un large corpus (le « corpus ») en intégrant cette information aux représentations vectorielles. Impossible avec le sac de mots, ce qui peut dégrader les performances quand les données sont limitées. Les plongements conduisent à des représentations de documents qui ne sont plus de longueur fixe : un document devient une séquence de vecteurs de mots de longueur variable. Certaines techniques de deep learning (LSTM, réseaux convolutionnels avec pooling adaptatif, etc.) gèrent ces séquences, mais requièrent souvent beaucoup de données pour un bon entraînement.
Comme indiqué en introduction, word2vec est un modèle de plongements très populaire, développé par Mikolov et al. D’autres modèles existent en sémantique distributionnelle. Même si plusieurs astuces sont nécessaires pour obtenir des plongements de haute qualité, nous nous concentrerons ici sur l’idée centrale de word2vec.
La procédure d’entraînement suivante est utilisée dans word2vec pour obtenir les plongements de mots.
Sélectionnez un mot pivot dans le texte. Les mots de contexte du pivot sont les mots qui l’entourent dans une fenêtre de taille fixe. Les couples (pivot, contexte) forment l’ensemble des paires mot‑contexte. L’animation ci‑dessous est tirée du blog de Chris Moody sur lda2vec. Dans cet extrait, « awesome » est le pivot et les mots alentour sont les contextes, produisant 7 paires mot‑contexte. 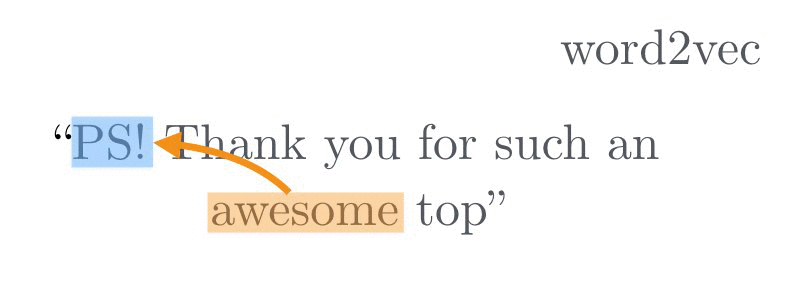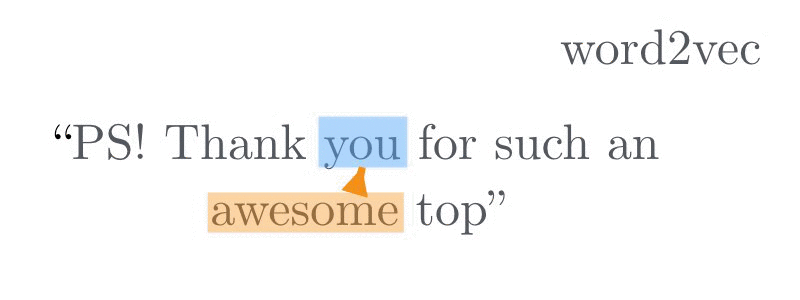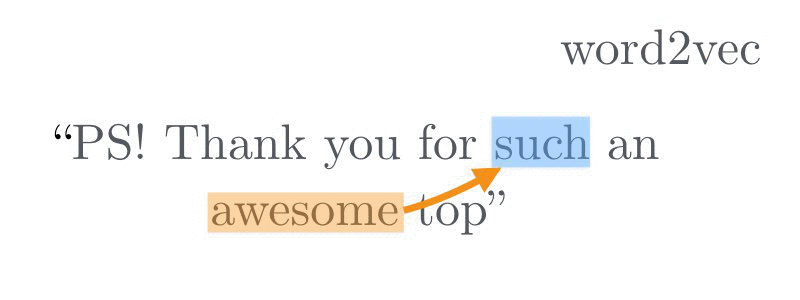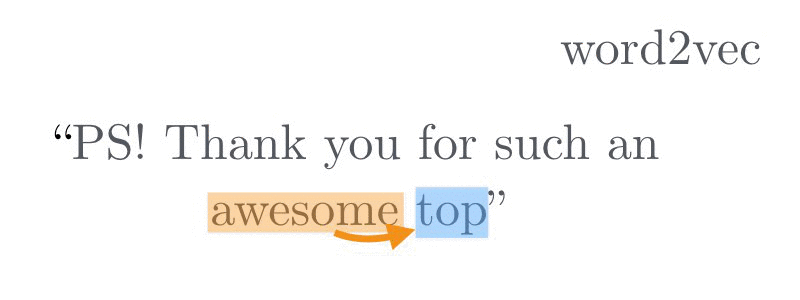
Deux variantes de word2vec existent : a) en architecture bag‑of‑words (CBOW), le pivot est prédit à partir des mots de contexte (par ex. avec « thank », « such », « you », « top », le modèle doit prédire « awesome »). On parle de bag‑of‑words car l’ordre des contextes n’importe pas. b) En architecture skip‑gram, le pivot sert à prédire les mots de contexte (par ex. connaissant « awesome », prédire « thank », « such », « you », « top »). L’image suivante illustre les deux architectures. Notez que le réseau utilisé est relativement simple (deux couches), comparé aux modèles profonds en vision.
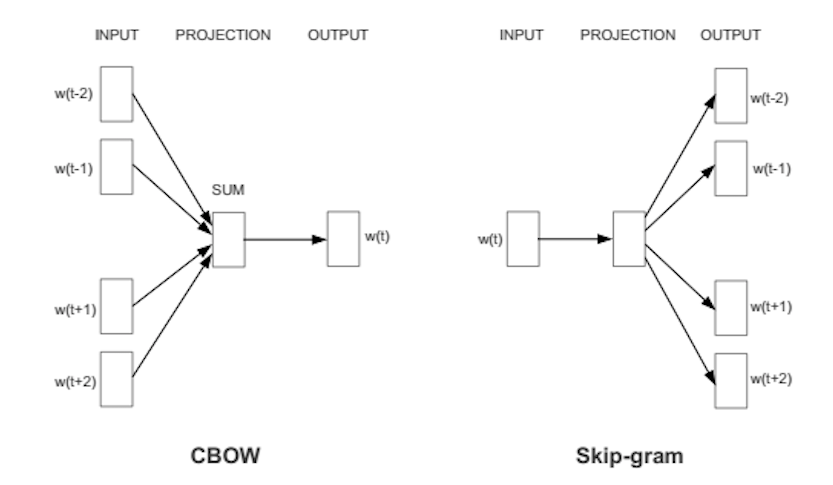
En entraînant le modèle sur un large corpus, vous obtenez des plongements de mots (les poids de la couche de projection) qui encodent des informations sémantiques et présentent des propriétés intéressantes : on peut effectuer des opérations vectorielles comme $$king - man + woman = queen$$.
Les vecteurs de mots offrent une représentation bien plus utile que, par exemple, un simple one‑hot. Ils permettent d’infuser des informations statistiques issues d’un grand corpus dans d’autres modèles (classification de sujets, systèmes de dialogue, etc.). Les vecteurs sont souvent denses, de grande dimension et peu interprétables. Exemple : [ -0.65, -1.223, ..., -0.252, +3.2 ]. Alors que, dans LDA, les dimensions se rapprochent de sujets, ce n’est généralement pas le cas ici. Chaque mot reçoit un vecteur indépendant du contexte, alors que le sens dépend fortement du contexte. Le modèle word2vec apprend un vecteur de mot qui prédit les contextes à travers différents documents ; l’information spécifique au document se trouve donc mélangée dans les plongements.
Inspiré par LDA, le modèle word2vec est étendu afin d’apprendre simultanément des vecteurs de mots, de documents et de sujets.
Lda2vec s’obtient en modifiant la variante skip‑gram de word2vec. Dans le skip‑gram original, le modèle prédit les mots de contexte à partir d’un mot pivot. Dans lda2vec, on additionne le vecteur du mot pivot et un vecteur de document pour former un vecteur de contexte, utilisé ensuite pour prédire les mots de contexte.
Dans la section suivante, nous verrons comment ces vecteurs de documents sont construits et comment ils peuvent s’utiliser à l’instar des vecteurs de documents de LDA.
L’idée d’intégrer des vecteurs de contexte dans word2vec n’est pas nouvelle. Les vecteurs de paragraphes, par exemple, explorent déjà cette piste pour apprendre des représentations de longueur fixe de fragments textuels de longueur variable. Dans leurs travaux, on apprend pour chaque fragment (taille paragraphe) un vecteur dense, à l’image des vecteurs de mots.
L’inconvénient, c’est que ces vecteurs de contexte/paragraphe ressemblent à des vecteurs de mots classiques et sont donc moins interprétables que, par exemple, la sortie de LDA.
Le modèle lda2vec va plus loin en travaillant à l’échelle du document et en décomposant le vecteur de document en deux composantes. Dans l’esprit de LDA, un vecteur de document est décomposé en un vecteur de pondération de sujets et une matrice de sujets. Le vecteur de pondération indique la proportion de chaque sujet, tandis que la matrice regroupe les différents vecteurs de sujets. Le vecteur de contexte est construit en combinant les vecteurs des sujets présents dans le document.
Considérons l’exemple suivant : dans word2vec, si le pivot est « French », les mots de contexte plausibles pourraient être « German », « Dutch », « English ». Sans information globale (liée au document), ce sont des choix naturels.
En ajoutant un vecteur de contexte supplémentaire dans lda2vec, on peut faire de meilleurs choix de mots de contexte.
Si le vecteur de document combine les sujets « alimentation » et « boissons », alors « baguette », « cheese » et « wine » seront plus adaptés. S’il est proche des sujets « ville » et « géographie », alors « Paris », « Lyon » et « Grenoble » seront plus pertinents.
Remarquez que ces vecteurs de sujets sont appris dans l’espace des mots, ce qui facilite l’interprétation : il suffit d’examiner les mots les plus proches de chaque vecteur de sujet. Par ailleurs, on impose des contraintes sur les vecteurs de pondération des documents afin d’obtenir des vecteurs clairsemés (comme en LDA), plutôt que denses. Cela facilite l’interprétation du contenu thématique des documents.
En bref, lda2vec produit des vecteurs de pondération de documents clairsemés et des vecteurs de sujets aisément interprétables.
Même si les performances sont en général comparables à celles de LDA, l’usage de méthodes d’autodifférentiation rend l’approche scalable à des jeux de données très vastes. En outre, en combinant le vecteur de contexte et le vecteur de mot, on obtient des vecteurs de mots « spécialisés », réutilisables dans d’autres modèles (et parfois meilleurs que des vecteurs plus « génériques »).
Lda2vec est une technique NLP relativement récente et spécialisée. Comme elle s’appuie sur des méthodes existantes, toute implémentation de word2vec peut être étendue en lda2vec. Chris Moody a implémenté la méthode dans Chainer, mais d’autres frameworks d’autodifférentiation peuvent convenir (CNTK, Theano, etc.). Une implémentation TensorFlow a également été mise à disposition.
Un aperçu du module Python lda2vec est disponible ici. L’entraînement pouvant être coûteux en calcul, l’usage du GPU est recommandé pour les grands corpus. Par ailleurs, pour accélérer l’entraînement, les vecteurs de mots sont souvent initialisés avec des vecteurs word2vec pré‑entraînés.
Enfin, si nous avons présenté lda2vec comme un modèle de sujets, l’idée d’ajouter des vecteurs de contexte à word2vec est plus générale. Imaginez des documents rédigés par des auteurs de régions différentes : on peut ajouter des vecteurs « auteur » et « région » au contexte, et obtenir ainsi une méthode non supervisée pour apprendre des représentations de documents, de régions et d’auteurs.
Cet article proposait un survol rapide de LDA, de word2vec et de lda2vec. Notez que l’auteur original a également publié un excellent billet détaillant les aspects techniques de lda2vec.
Approfondir le machine learning
Cours
Cours
Cours