Khóa học
Tìm hiểu Machine Learning
2 giờ
313.8K
Bài viết này sẽ giới thiệu đến bạn lda2vec, một mô hình chủ đề được Chris Moody công bố năm 2016. lda2vec mở rộng mô hình word2vec, được Mikolov và cộng sự mô tả năm 2013, bằng các vector chủ đề và vector tài liệu, đồng thời kết hợp các ý tưởng từ cả hai hướng: nhúng từ và mô hình chủ đề.
Mục tiêu chung của một mô hình chủ đề là tạo ra các biểu diễn tài liệu có thể diễn giải, từ đó khám phá các chủ đề hoặc cấu trúc trong một tập hợp tài liệu không gán nhãn. Ví dụ về một biểu diễn tài liệu có thể diễn giải là: tài liệu X gồm 20% chủ đề a, 40% chủ đề b và 40% chủ đề c.
Bài viết hôm nay sẽ bắt đầu bằng việc giới thiệu Latent Dirichlet Allocation (LDA). LDA là một mô hình chủ đề xác suất và xem tài liệu như một túi từ (bag-of-words), vì vậy trước tiên bạn sẽ tìm hiểu ưu và nhược điểm của cách tiếp cận này.
Ngược lại, lda2vec xây dựng biểu diễn tài liệu dựa trên nhúng từ. Bạn sẽ tìm hiểu thêm về nhúng từ và vì sao hiện nay chúng là viên gạch nền tảng được ưa chuộng trong các mô hình xử lý ngôn ngữ tự nhiên (NLP).
Cuối cùng, bạn sẽ hiểu rõ hơn về ý tưởng tổng quát đằng sau lda2vec.
Một mô hình chủ đề nhận vào một tập tài liệu không gán nhãn và cố gắng tìm ra cấu trúc hay các chủ đề trong tập đó. Lưu ý rằng các mô hình chủ đề thường giả định việc sử dụng từ có tương quan với sự xuất hiện của chủ đề. Chẳng hạn, bạn có thể cung cấp cho mô hình chủ đề một tập bài báo và mô hình sẽ chia tài liệu thành một số cụm dựa trên cách sử dụng từ.
Mô hình chủ đề là cách tuyệt vời để tự động khám phá và cấu trúc một tập tài liệu lớn: chúng gom nhóm hoặc phân cụm tài liệu dựa trên các từ xuất hiện trong đó. Vì các tài liệu cùng chủ đề có xu hướng dùng một tập con từ vựng tương tự, các cụm tài liệu kết quả có thể được diễn giải như đang bàn về các "chủ đề" khác nhau.
Latent Dirichlet Allocation (LDA) là một ví dụ về mô hình chủ đề xác suất. Chính xác điều đó có nghĩa gì, bạn sẽ học trong các phần tiếp theo: trước hết, bạn sẽ hiểu cách LDA bắt đầu từ mô tả bag-of-words để biểu diễn các tài liệu khác nhau. Sau đó, bạn sẽ thấy các biểu diễn này được dùng để tìm cấu trúc trong tập tài liệu như thế nào.
Truyền thống, các tài liệu văn bản trong NLP được biểu diễn dưới dạng bag-of-words.
Điều này có nghĩa mỗi tài liệu được biểu diễn bằng một vector độ dài cố định, có độ dài bằng kích thước từ vựng. Mỗi chiều của vector này tương ứng với số lần xuất hiện của một từ trong tài liệu. Việc có thể rút gọn tài liệu độ dài biến thiên về các vector độ dài cố định giúp chúng phù hợp hơn để sử dụng với nhiều mô hình và tác vụ machine learning (ML) khác nhau (phân cụm, phân loại, ...).
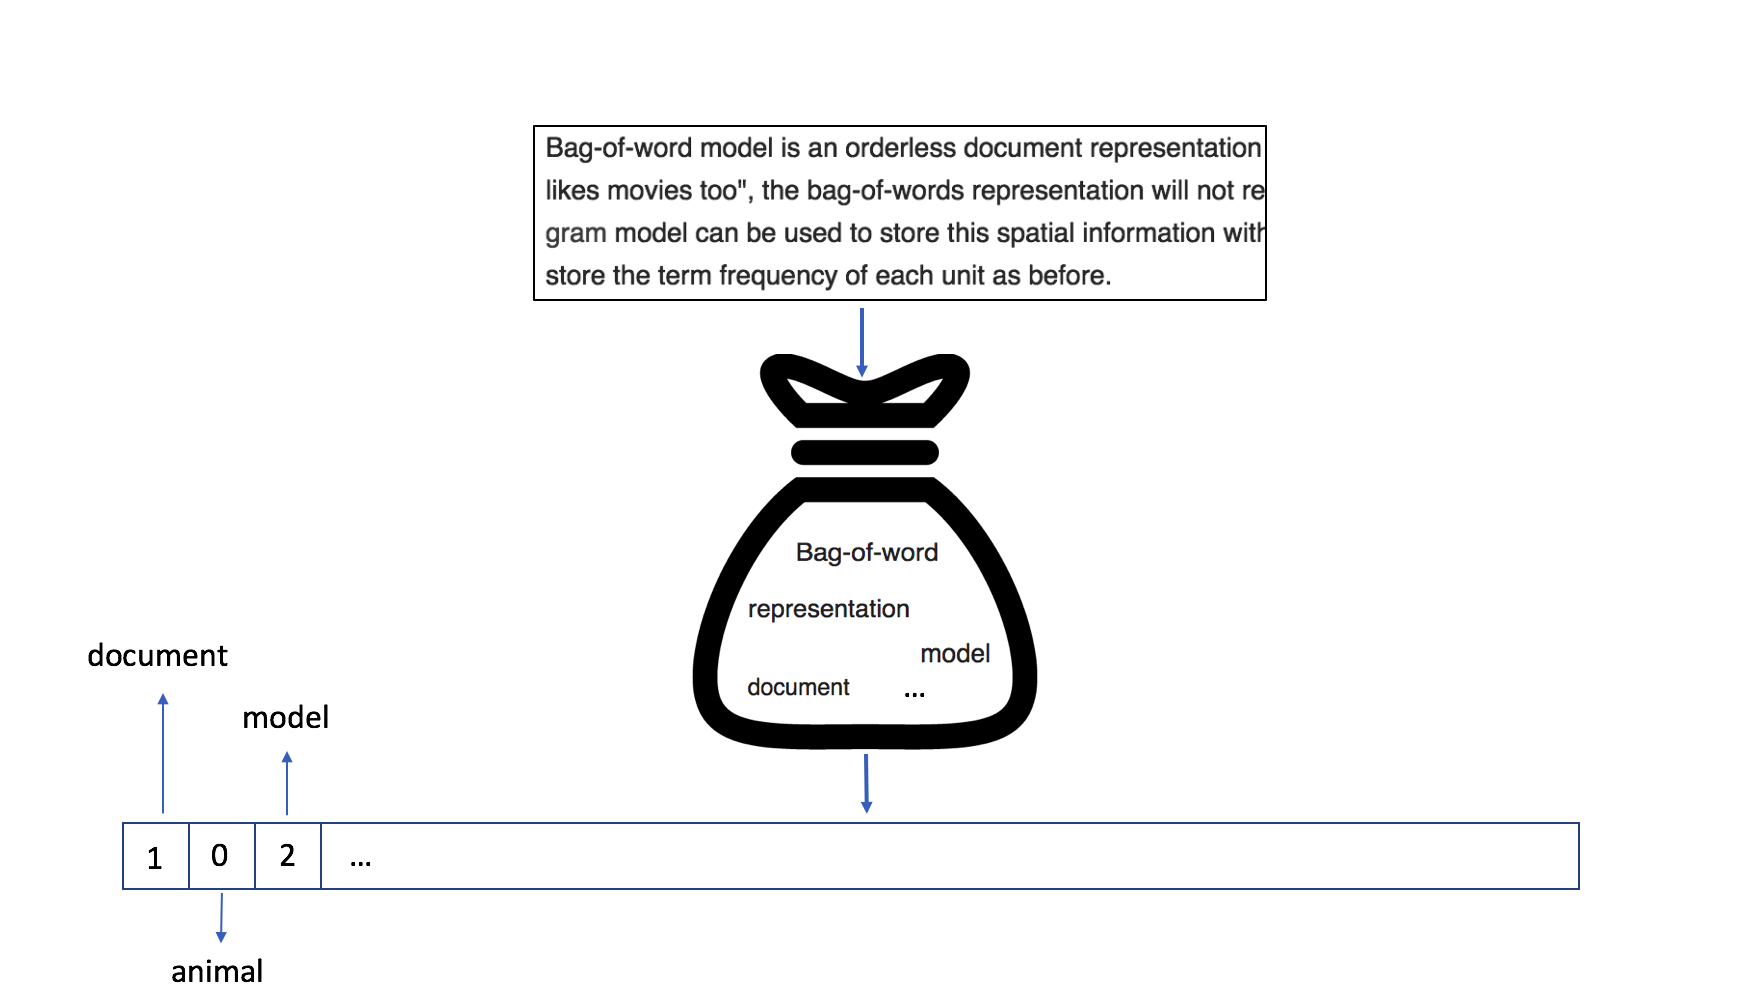
Hình trên minh họa cách một tài liệu được biểu diễn trong mô hình bag-of-words: từ "document" có số đếm là 1, trong khi từ "model" xuất hiện hai lần trong văn bản.
Mặc dù bag-of-words cho ra biểu diễn tài liệu thưa và có số chiều lớn, kết quả phân loại chủ đề thường rất tốt nếu có nhiều dữ liệu. Bạn có thể đọc thêm bài báo của Facebook gần đây về phân loại chủ đề.
Biểu diễn tài liệu độ dài cố định cho phép bạn dễ dàng đưa các tài liệu có độ dài khác nhau vào các mô hình ML (SVM, k-NN, Random Forest, ...). Điều này cho phép bạn thực hiện phân cụm hoặc phân loại chủ đề cho tài liệu. Thông tin cấu trúc của tài liệu bị loại bỏ và các mô hình phải tự phát hiện xem những chiều nào của vector là tương đồng về ngữ nghĩa. Việc ánh xạ, chẳng hạn, ‘feline’ và ‘cat’ lên các chiều khác nhau là ít trực quan, vì mô hình buộc phải học tương quan giữa các chiều khác nhau này.
Khi huấn luyện một mô hình LDA, bạn bắt đầu với một tập tài liệu và mỗi tài liệu được biểu diễn bằng một vector độ dài cố định (bag-of-words). LDA là một kỹ thuật Machine Learning (ML) tổng quát, nghĩa là nó cũng có thể dùng cho các bài toán ML không giám sát khác, nơi đầu vào là một tập các vector độ dài cố định và mục tiêu là khám phá cấu trúc của dữ liệu này.
Để triển khai một mô hình LDA, trước hết bạn xác định số lượng "chủ đề" có mặt trong tập tài liệu của mình. Nghe có vẻ đơn giản, nhưng thường kém trực quan hơn khi bạn xử lý lượng tài liệu rất lớn.
Huấn luyện một mô hình LDA trên $$N$$ tài liệu với $$M$$ chủ đề tương ứng với việc tìm ra các vector tài liệu và vector chủ đề giải thích tốt nhất dữ liệu.
Lưu ý hướng dẫn này sẽ không bao quát toàn bộ lý thuyết chi tiết phía sau LDA (xem bài báo này của Blei và cộng sự), vì trọng tâm là truyền tải ý tưởng tổng quát.
Giả sử từ vựng trong các tài liệu gồm $$V$$ từ. 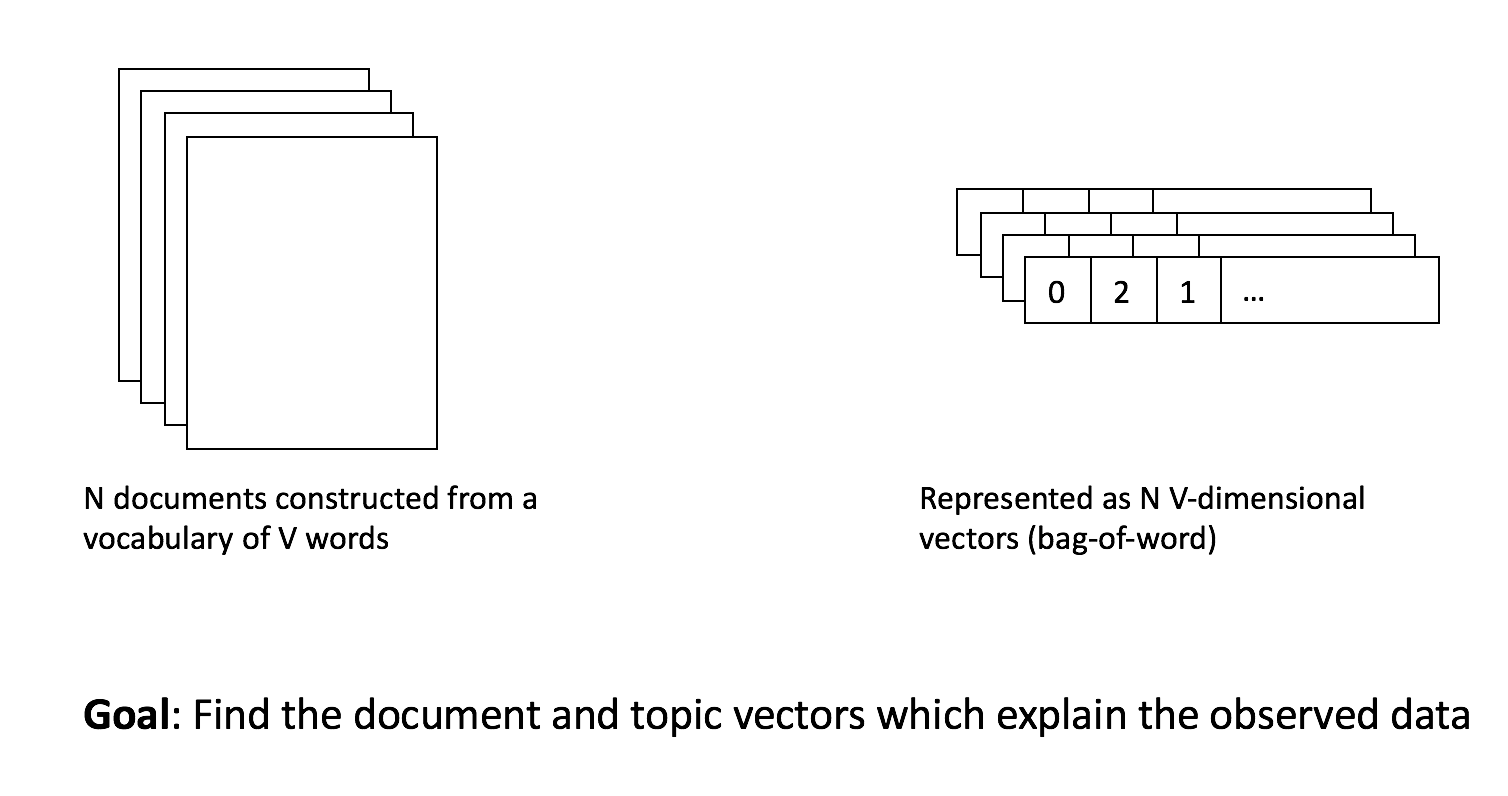
Mỗi trong số $$N$$ tài liệu sẽ được biểu diễn trong mô hình LDA bởi một vector độ dài $$M$$ chi tiết các chủ đề xuất hiện trong tài liệu đó. Một tài liệu có thể gồm 75% là ‘chủ đề 1’ và 25% là ‘chủ đề 2’. Thường thì LDA cho ra các vector tài liệu với nhiều số 0, nghĩa là chỉ có số lượng hữu hạn chủ đề xuất hiện trong mỗi tài liệu. Điều này phù hợp với ý tưởng rằng tài liệu thường chỉ bàn về một số chủ đề hạn chế. Nó cải thiện đáng kể khả năng diễn giải của các vector tài liệu này.
Mỗi trong số $$M$$ chủ đề được biểu diễn bằng một vector độ dài $$V$$ cho biết những từ nào có khả năng xuất hiện, khi xét một tài liệu thuộc chủ đề đó. Vậy với chủ đề 1, ‘learning’, ‘modelling’ và ‘statistics’ có thể là vài từ phổ biến nhất. Khi đó, bạn có thể gọi đây là chủ đề ‘data science’. Với chủ đề 2, các từ ‘GPU’, ‘compute’ và ‘storage’ có thể là những từ xuất hiện nhiều nhất. Bạn có thể diễn giải đây là chủ đề ‘computing’.
Hình sau minh họa trực quan mô hình LDA. Mục tiêu của mô hình là tìm các vector chủ đề và tài liệu giải thích được biểu diễn bag-of-words gốc của các tài liệu khác nhau. 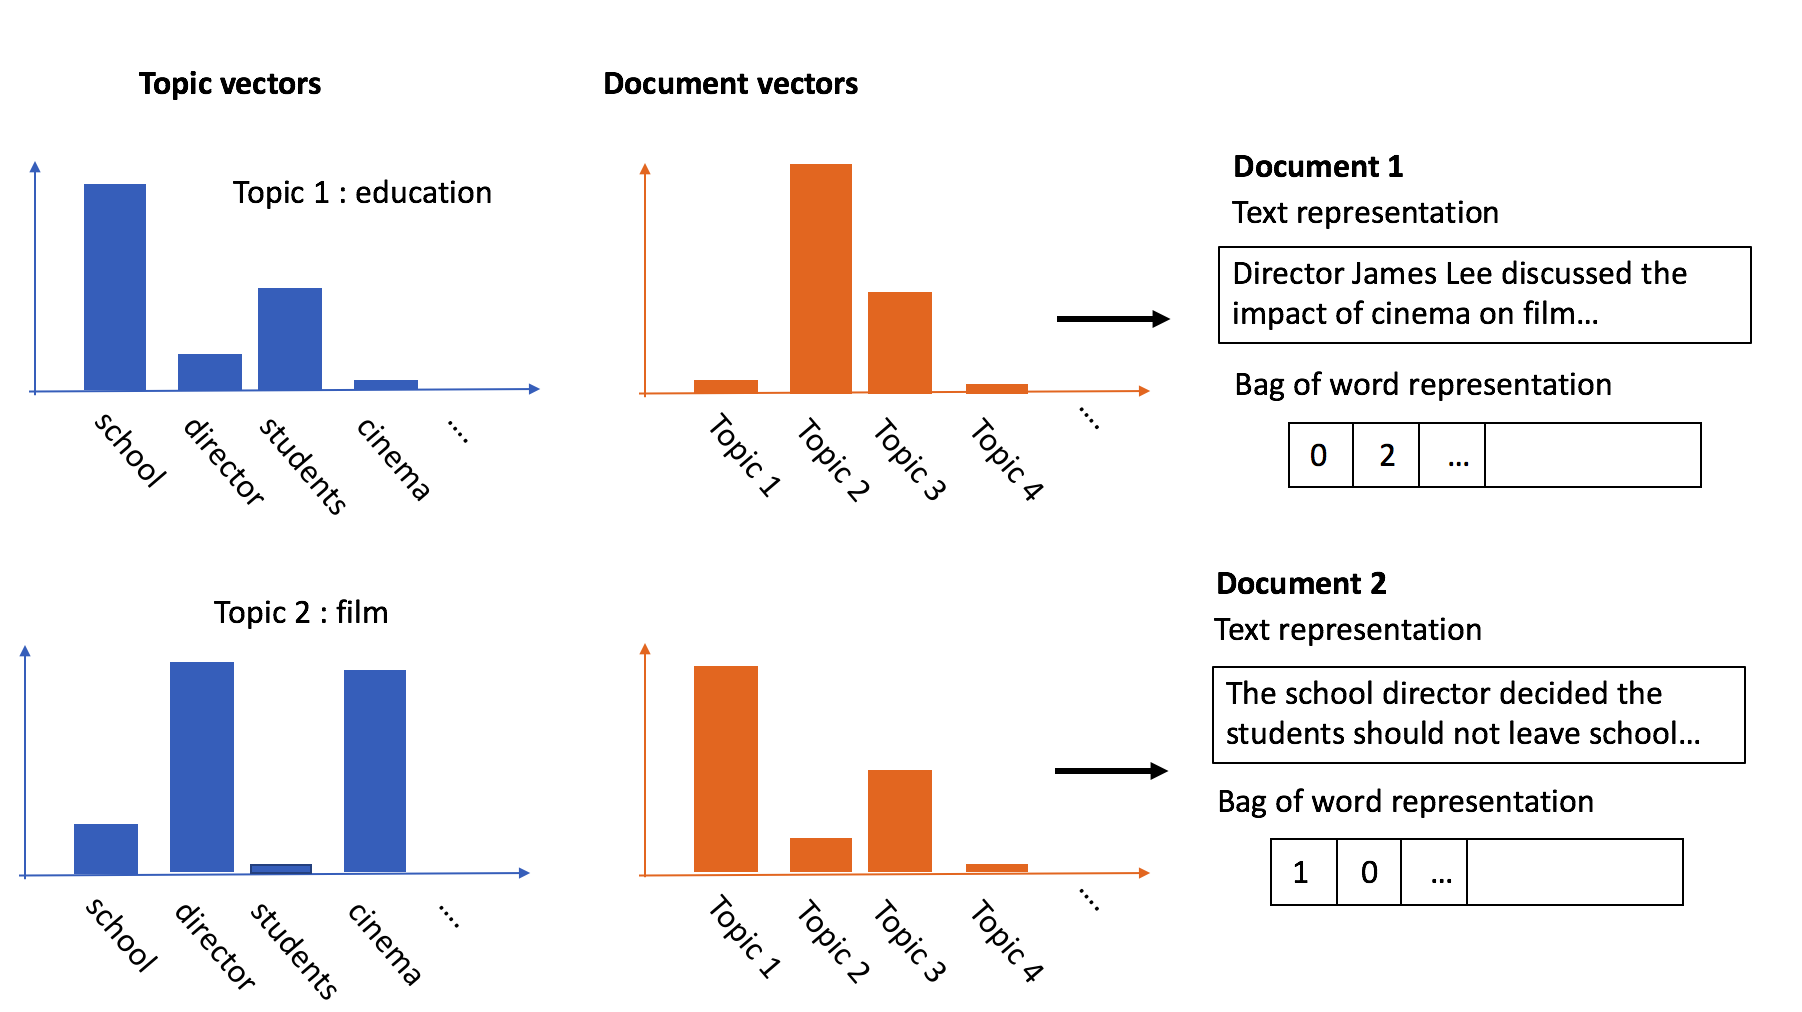
Điều quan trọng cần lưu ý là bạn đang dựa vào giả định các vector chủ đề sẽ có thể diễn giải được, nếu không đầu ra của mô hình hầu như vô nghĩa. Về bản chất, bạn giả định rằng mô hình, khi có đủ dữ liệu, sẽ tìm ra những từ có xu hướng đồng xuất hiện và gom chúng thành các ‘chủ đề’ riêng biệt.
LDA là một mô hình xác suất đơn giản nhưng thường hoạt động khá tốt. Các vector tài liệu thường thưa, ít chiều và rất dễ diễn giải, làm nổi bật mẫu hình và cấu trúc trong tài liệu. Bạn phải ước lượng hợp lý số lượng chủ đề xuất hiện trong tập tài liệu. Ngoài ra, bạn phải tự gán tên gọi/‘chủ đề’ khác nhau cho các vector chủ đề. Vì sử dụng mô hình bag-of-words để biểu diễn tài liệu, LDA có thể mắc cùng nhược điểm như bag-of-words. Mô hình LDA học một vector tài liệu để dự đoán các từ trong tài liệu đó, trong khi bỏ qua cấu trúc cũng như cách các từ tương tác ở mức cục bộ.
Một trong những vấn đề của biểu diễn bag-of-words là mô hình phải tự tìm ra những chiều nào trong vector tài liệu là liên quan về mặt ngữ nghĩa. Có thể hình dung rằng tận dụng thông tin về mối tương quan ngữ nghĩa giữa các từ sẽ cải thiện hiệu quả mô hình, và đó chính là điều nhúng từ hứa hẹn mang lại.
Với nhúng từ, các từ được biểu diễn dưới dạng các vector độ dài cố định hay embedding. Có nhiều mô hình khác nhau để xây dựng embedding, nhưng tất cả đều dựa trên giả thuyết phân bố: "một từ được đặc trưng bởi những từ đi kèm với nó".
Mục tiêu của nhúng từ là nắm bắt các quy luật ngữ nghĩa và cú pháp trong ngôn ngữ từ những tập tài liệu lớn không giám sát, như Wikipedia. Các từ xuất hiện trong cùng ngữ cảnh sẽ được biểu diễn bằng các vector gần nhau trong không gian.
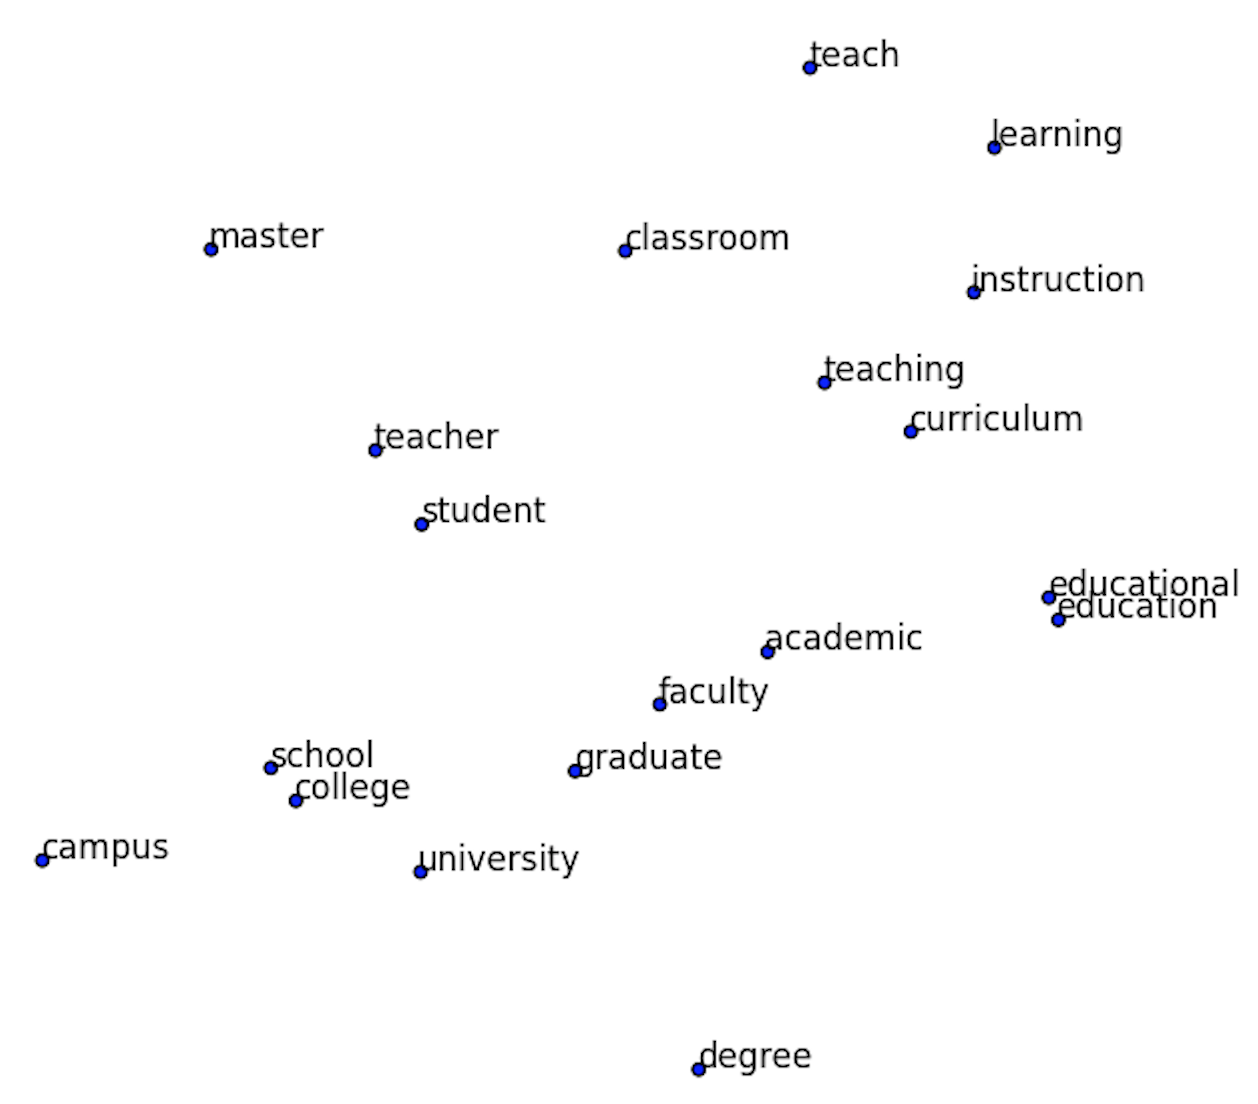
Hình lấy từ "Visualizing Word Embeddings with t-SNE"
Hình trên là phép chiếu không gian nhúng từ xuống không gian 2D bằng t-SNE (t-Distributed Stochastic Neighbor Embedding). t-SNE là phương pháp giảm chiều bạn có thể dùng để trực quan hóa dữ liệu nhiều chiều. Phương pháp này nhận nhúng từ làm đầu vào và chiếu chúng xuống không gian hai chiều để dễ biểu diễn trên đồ thị. Chỉ một phần không gian từ được khảo sát, tập trung vào các từ gần ‘teacher’. Thay vì biểu diễn từ bằng những chiều thiếu thông tin trong một vector, nhúng từ cho phép biểu diễn chúng bằng các vector tương quan ngữ nghĩa.
Khi dùng nhúng từ, một mô hình ML có thể tận dụng thông tin từ một tập tài liệu lớn, còn gọi là "corpus", bằng cách mã hóa nó vào các biểu diễn vector. Điều này không khả thi với mô hình bag-of-words, vốn có thể làm suy giảm hiệu năng khi dữ liệu không nhiều. Nhúng từ dẫn đến các biểu diễn tài liệu không còn độ dài cố định. Thay vào đó, tài liệu được biểu diễn bằng một chuỗi biến độ dài các vector nhúng từ. Dù một số kỹ thuật học sâu như Long Short-Term Memory (LSTM), mạng tích chập với pooling thích ứng, ... có thể xử lý chuỗi biến độ dài, thường cần rất nhiều dữ liệu để huấn luyện tốt.
Như bạn đã đọc ở phần mở đầu, word2vec là mô hình nhúng từ cực kỳ phổ biến, do Mikolov và cộng sự phát triển. Lưu ý rằng có nhiều mô hình nhúng từ khác trong lĩnh vực ngữ nghĩa phân bố. Mặc dù cần một số thủ thuật để thu được nhúng từ chất lượng cao, hướng dẫn này chỉ tập trung vào ý tưởng cốt lõi của word2vec.
Quy trình huấn luyện sau được dùng trong word2vec để thu được nhúng từ.
Chọn một từ (pivot) trong văn bản. Các từ ngữ cảnh của từ pivot hiện tại là những từ xuất hiện xung quanh nó. Điều này có nghĩa bạn làm việc trong một cửa sổ cố định số lượng từ. Các kết hợp của từ pivot và từ ngữ cảnh tạo thành một tập các cặp từ-ngữ cảnh. Hình dưới lấy từ blog của Chris Moody về lda2vec. Trong đoạn văn này, ‘awesome’ là từ pivot và các từ xung quanh được lấy làm từ ngữ cảnh, tạo ra 7 cặp từ-ngữ cảnh. 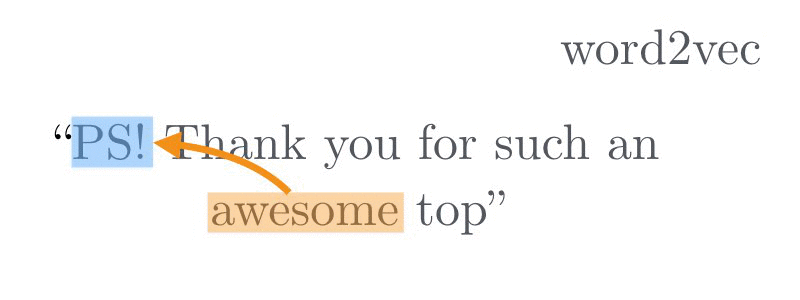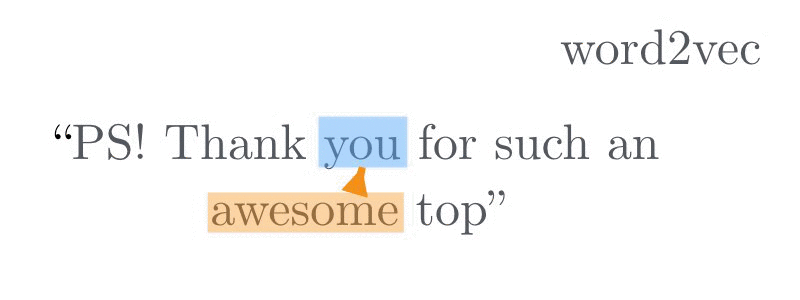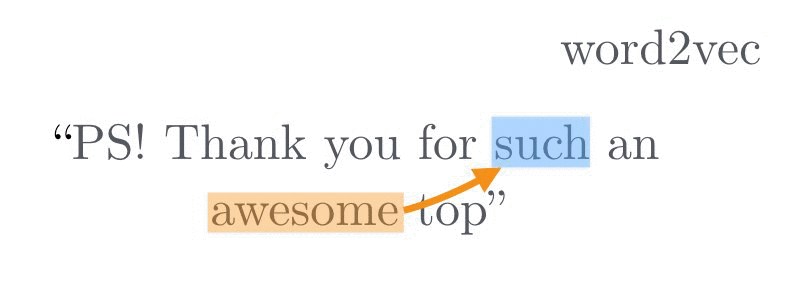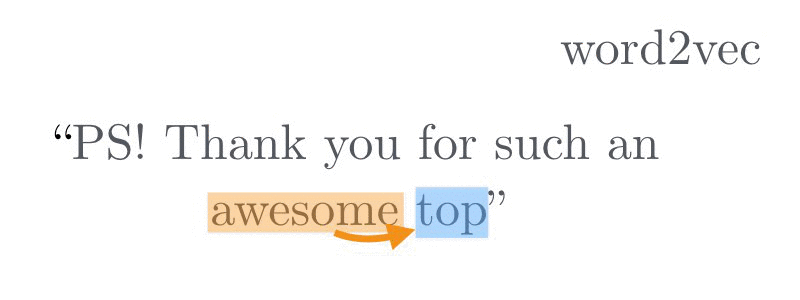
Có hai biến thể của mô hình word2vec: a. Trong kiến trúc bag-of-words (CBOW), từ pivot được dự đoán dựa trên một tập các từ ngữ cảnh xung quanh (ví dụ: cho ‘thank’, ‘such’, ‘you’, ‘top’ thì mô hình phải dự đoán ‘awesome’). Gọi là kiến trúc bag-of-words vì thứ tự của các từ ngữ cảnh không quan trọng. b. Trong kiến trúc skip-gram, từ pivot được dùng để dự đoán các từ ngữ cảnh xung quanh (ví dụ: cho ‘awesome’ thì dự đoán ‘thank’, ‘such’, ‘you’, ‘top’). Hình sau mô tả hai kiến trúc word2vec khác nhau. Lưu ý rằng một mô hình nơ-ron tương đối đơn giản (hai lớp) được sử dụng (so với các mô hình nơ-ron sâu trong thị giác máy tính).
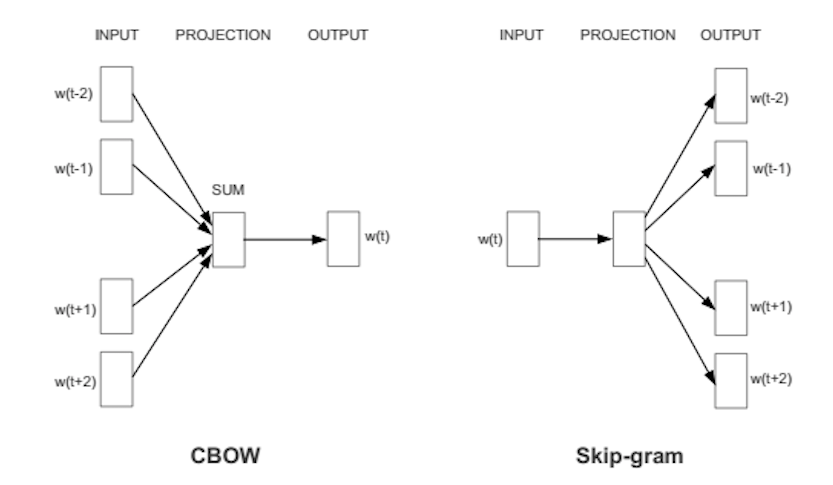
Bằng cách huấn luyện mô hình trên một corpus lớn, bạn sẽ thu được các nhúng từ (các trọng số ở lớp chiếu) mã hóa thông tin ngữ nghĩa cũng như một số tính chất thú vị: có thể thực hiện phép toán vector như $$king - man + woman = queen$$.
Các vector từ là một biểu diễn hữu ích so với, chẳng hạn, biểu diễn one-hot đơn giản. Chúng cho phép mã hóa thông tin thống kê từ một corpus lớn vào các mô hình khác, như phân loại chủ đề hoặc hệ thống hội thoại. Các vector từ thường dày đặc, nhiều chiều và khó diễn giải. Hãy xét ví dụ: [ -0.65, -1.223, ..., -0.252, +3.2]. Trong khi ở LDA, các chiều xấp xỉ tương ứng với chủ đề, điều này thường không đúng với vector từ. Mỗi từ được gán một vector từ độc lập với ngữ cảnh. Tuy nhiên, ý nghĩa ngữ nghĩa của từ lại phụ thuộc rất nhiều vào ngữ cảnh. Mô hình word2vec học một vector từ để dự đoán từ ngữ cảnh trên nhiều tài liệu khác nhau. Hệ quả là thông tin đặc thù theo tài liệu bị trộn lẫn trong các nhúng từ.
Lấy cảm hứng từ Latent Dirichlet Allocation (LDA), mô hình word2vec được mở rộng để đồng thời học các vector từ, tài liệu và chủ đề.
Lda2vec thu được bằng cách chỉnh sửa biến thể skip-gram của word2vec. Ở phương pháp skip-gram gốc, mô hình được huấn luyện để dự đoán các từ ngữ cảnh dựa trên một từ pivot. Trong lda2vec, vector từ pivot và một vector tài liệu được cộng lại để tạo ra vector ngữ cảnh. Vector ngữ cảnh này sau đó được dùng để dự đoán các từ ngữ cảnh.
Ở phần tiếp theo, bạn sẽ thấy các vector tài liệu này được xây dựng như thế nào và cách chúng có thể được dùng tương tự vector tài liệu trong LDA.
Ý tưởng tích hợp các vector ngữ cảnh vào mô hình word2vec không phải mới. Paragraph vectors, chẳng hạn, cũng khai thác ý tưởng này để học các biểu diễn độ dài cố định cho các đoạn văn bản độ dài biến thiên. Trong công trình đó, với mỗi đoạn văn (kích thước một đoạn), một vector dày đặc được học tương tự như vector từ.
Điểm hạn chế của cách tiếp cận này là các vector ngữ cảnh/đoạn giống với vector từ điển hình, khiến chúng kém dễ diễn giải hơn, ví dụ như đầu ra của LDA.
Mô hình lda2vec tiến xa hơn phương pháp paragraph vector bằng cách làm việc với các đoạn văn bản kích thước tài liệu và phân rã các vector tài liệu thành hai thành phần khác nhau. Cùng tinh thần với mô hình LDA, một vector tài liệu được phân rã thành vector trọng số tài liệu và ma trận chủ đề. Vector trọng số tài liệu biểu diễn tỷ lệ các chủ đề khác nhau, còn ma trận chủ đề gồm các vector chủ đề. Một vector ngữ cảnh được xây dựng bằng cách kết hợp các vector chủ đề xuất hiện trong một tài liệu.
Hãy xét ví dụ sau: trong mô hình word2vec gốc, nếu từ pivot là ‘French’, thì các từ ngữ cảnh có thể là ‘German’, ‘Dutch’, ‘English’. Không có thông tin toàn cục (liên quan đến tài liệu), đó sẽ là những dự đoán hợp lý nhất.
Bằng cách cung cấp thêm vector ngữ cảnh trong mô hình lda2vec, có thể đưa ra những dự đoán tốt hơn về từ ngữ cảnh.
Nếu vector tài liệu là sự kết hợp của các chủ đề ‘food’ và ‘drinks’, thì ‘baguette’, ‘cheese’ và ‘wine’ có thể phù hợp hơn. Nếu vector tài liệu gần với các chủ đề ‘city’ và ‘geography’, thì ‘Paris’, ‘Lyon’ và ‘Grenoble’ có thể phù hợp hơn.
Lưu ý rằng các vector chủ đề này được học trong không gian từ, giúp việc diễn giải dễ dàng: bạn chỉ cần xem các vector từ nào gần với vector chủ đề. Ngoài ra, các ràng buộc được áp lên vector trọng số tài liệu nhằm thu được vector thưa (tương tự LDA), thay vì dày đặc. Điều này giúp việc diễn giải nội dung chủ đề của các tài liệu khác nhau trở nên dễ dàng.
Tóm lại, kết quả cuối cùng của lda2vec là một tập các vector trọng số tài liệu thưa, cùng các vector chủ đề dễ diễn giải.
Mặc dù hiệu năng có xu hướng tương đương LDA truyền thống, việc sử dụng các phương pháp vi phân tự động giúp phương pháp mở rộng quy mô đến các bộ dữ liệu rất lớn. Thêm nữa, bằng cách kết hợp vector ngữ cảnh và vector từ, bạn thu được các vector từ ‘chuyên biệt’, có thể dùng trong các mô hình khác (và có thể vượt trội so với các vector từ ‘tổng quát’ hơn).
Lda2vec là một kỹ thuật NLP tương đối mới và chuyên biệt. Vì xây dựng trên các phương pháp sẵn có, bất kỳ triển khai word2vec nào cũng có thể được mở rộng thành lda2vec. Chris Moody đã hiện thực phương pháp này bằng Chainer, nhưng các khung vi phân tự động khác cũng có thể dùng (CNTK, Theano, ...). Một triển khai Tensorflow cũng đã được công bố.
Tổng quan về mô-đun Python của lda2vec có thể xem tại đây. Vì việc huấn luyện lda2vec có thể tốn nhiều tài nguyên tính toán, khuyến nghị dùng GPU cho các corpus lớn. Ngoài ra, để tăng tốc huấn luyện, các vector từ khác nhau thường được khởi tạo bằng các vector word2vec tiền huấn luyện.
Cuối cùng, lda2vec đã được bàn tới như một mô hình chủ đề, nhưng ý tưởng thêm các vector ngữ cảnh vào mô hình word2vec cũng có thể được khái quát rộng hơn. Chẳng hạn, xét các tài liệu do nhiều tác giả ở các vùng miền khác nhau viết. Khi đó, có thể thêm cả vector tác giả và vector vùng miền vào vector ngữ cảnh, dẫn đến một phương pháp không giám sát để thu được các biểu diễn vector cho tài liệu, vùng miền và tác giả.
Bài viết này chỉ cung cấp cái nhìn tổng quan nhanh về LDA, word2vec và lda2vec. Lưu ý rằng tác giả gốc cũng đã đăng một bài blog rất hay về các chi tiết kỹ thuật của lda2vec.
Tìm hiểu thêm về Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
