
Last chance! 50% off DataCamp Premium
Sale ends in
यह ब्लॉग पोस्ट आपको lda2vec का परिचय देगा, जो Chris Moody द्वारा 2016 में प्रकाशित एक टॉपिक मॉडल है। lda2vec, word2vec मॉडल को—जिसे Mikolov इत्यादि ने 2013 में वर्णित किया—टॉपिक और दस्तावेज़ वेक्टरों से विस्तारित करता है और शब्द एम्बेडिंग तथा टॉपिक मॉडलों दोनों के विचारों को समाहित करता है।
टॉपिक मॉडल का सामान्य लक्ष्य ऐसे व्याख्यायोग्य दस्तावेज़ निरूपण बनाना है जिनका उपयोग बिना लेबल वाले दस्तावेज़ों के संग्रह में टॉपिक या संरचना खोजने के लिए किया जा सके। ऐसे व्याख्यायोग्य दस्तावेज़ निरूपण का एक उदाहरण है: दस्तावेज़ X 20% टॉपिक a, 40% टॉपिक b और 40% टॉपिक c है।
आज की पोस्ट Latent Dirichlet Allocation (LDA) से शुरुआत करेगी। LDA एक प्रायिक (probabilistic) टॉपिक मॉडल है और यह दस्तावेज़ों को bag-of-words के रूप में देखता है, इसलिए आप पहले इस पद्धति के फायदे और नुकसान का अन्वेषण करेंगे।
दूसरी तरफ, lda2vec शब्द एम्बेडिंग्स के ऊपर दस्तावेज़ निरूपण बनाता है। आप शब्द एम्बेडिंग्स के बारे में और जानेंगे और क्यों वे वर्तमान में नैसर्गिक भाषा संसाधन (NLP) मॉडलों में पसंदीदा आधार-इकाई हैं।
अंत में, आप lda2vec के पीछे की सामान्य अवधारणा के बारे में और जानेंगे।
एक टॉपिक मॉडल बिना लेबल वाले दस्तावेज़ों का संग्रह लेता है और इस संग्रह में संरचना या टॉपिक खोजने का प्रयास करता है। ध्यान दें कि टॉपिक मॉडल अक्सर मानते हैं कि शब्द-प्रयोग टॉपिक की उपस्थिति से सह-संबद्ध होता है। उदाहरण के लिए, आप टॉपिक मॉडल को समाचार लेखों का एक सेट दे सकते हैं और टॉपिक मॉडल शब्द-प्रयोग के आधार पर दस्तावेज़ों को कुछ क्लस्टरों में विभाजित कर देगा।
टॉपिक मॉडल दस्तावेज़ों के बड़े सेट को स्वतः खोजने और संरचना देने का एक बढ़िया तरीका हैं: वे उन शब्दों के आधार पर दस्तावेज़ों को समूहित या क्लस्टर करते हैं जो उनमें प्रकट होते हैं। क्योंकि एक ही टॉपिक पर दस्तावेज़ आम तौर पर समान उप-शब्दावली का उपयोग करते हैं, परिणामस्वरूप दस्तावेज़ क्लस्टर अलग-अलग ‘टॉपिक’ पर चर्चा करते हुए व्याख्यायोग्य हो जाते हैं।
Latent Dirichlet Allocation (LDA) एक प्रायिक टॉपिक मॉडल का उदाहरण है। इसका सटीक अर्थ आप अगली धाराओं में जानेंगे: पहले आप समझेंगे कि LDA अलग-अलग दस्तावेज़ों को निरूपित करने के लिए bag-of-words विवरण से कैसे शुरू करता है। फिर, आप देखेंगे कि इन निरूपणों का प्रयोग दस्तावेज़-संग्रह की संरचना खोजने में कैसे किया जाता है।
परंपरागत रूप से, NLP में टेक्स्ट दस्तावेज़ों को bag-of-words के रूप में निरूपित किया जाता है।
इसका अर्थ है कि प्रत्येक दस्तावेज़ को एक स्थिर-लंबाई वाले वेक्टर के रूप में निरूपित किया जाता है, जिसकी लंबाई शब्दावली के आकार के बराबर होती है। इस वेक्टर का प्रत्येक आयाम दस्तावेज़ में किसी शब्द की गिनती या उपस्थिति के अनुरूप होता है। चर-लंबाई के दस्तावेज़ों को स्थिर-लंबाई वेक्टरों में घटा पाने से वे विभिन्न प्रकार के मशीन लर्निंग (ML) मॉडलों और कार्यों (क्लस्टरिंग, वर्गीकरण, ...) के साथ प्रयोग के लिए अधिक उपयुक्त हो जाते हैं।
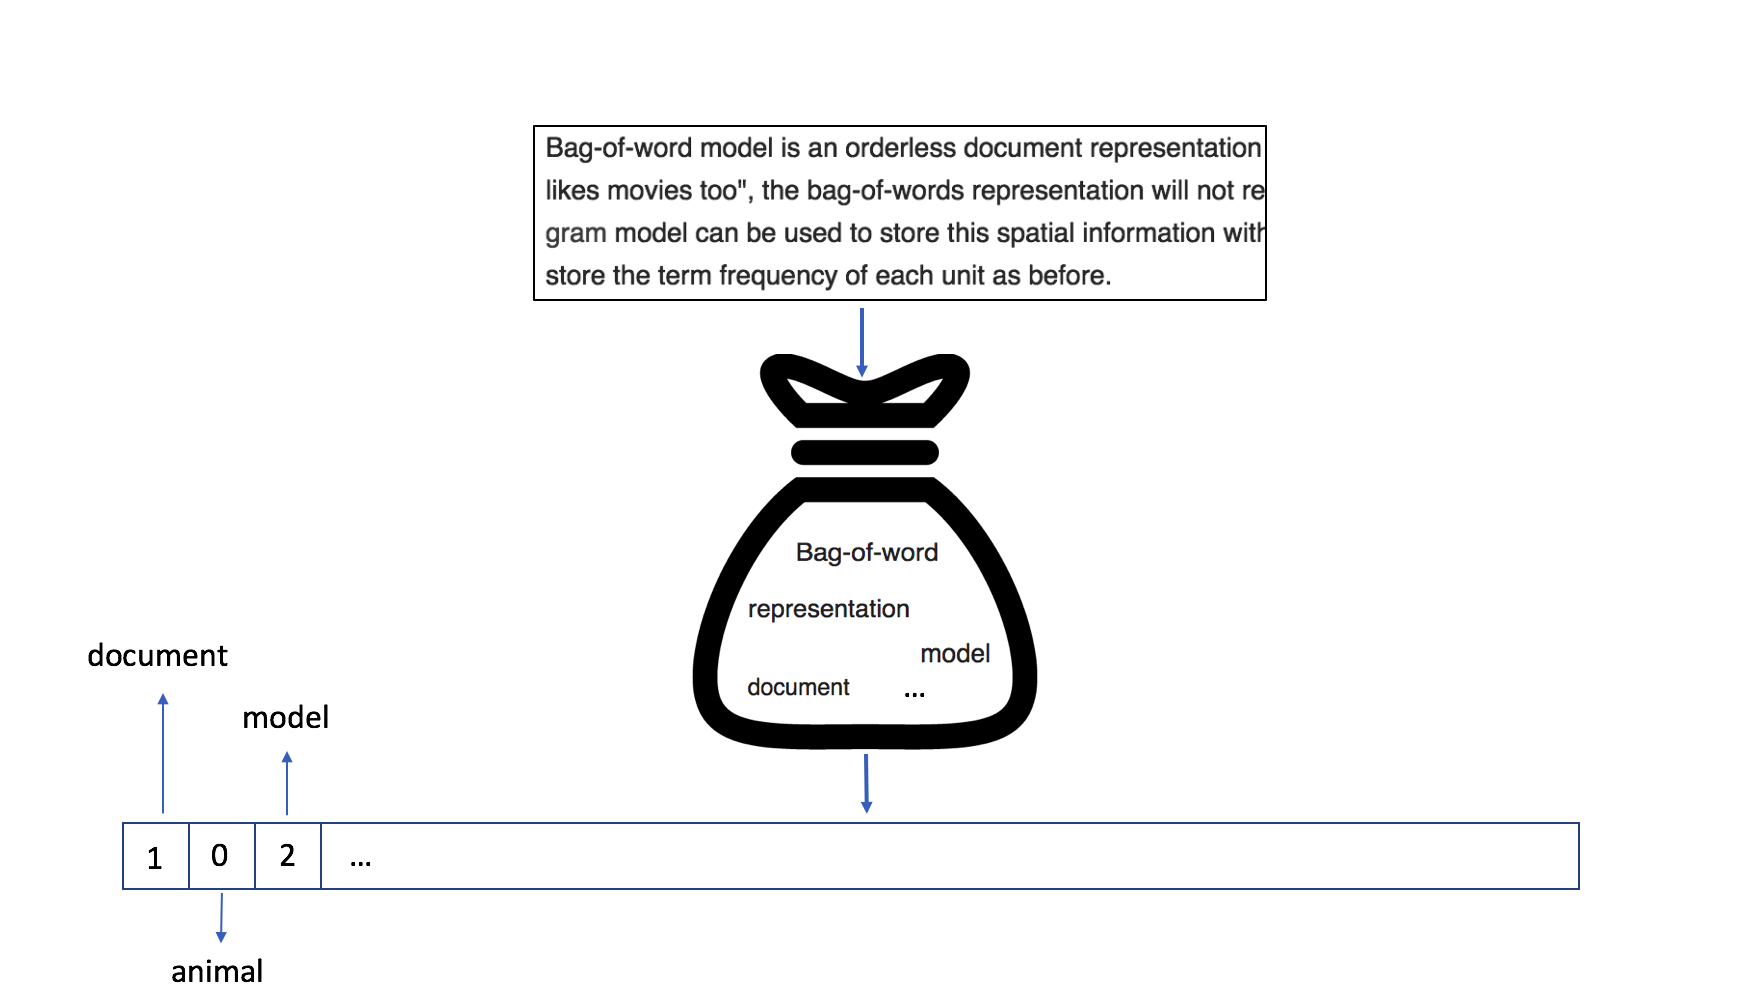
ऊपर दी गई छवि दर्शाती है कि bag-of-words मॉडल में एक दस्तावेज़ कैसे निरूपित होता है: शब्द "document" की गिनती 1 है, जबकि शब्द "model" टेक्स्ट में दो बार आता है।
हालांकि bag-of-words एक विरल (sparse) और उच्च-आयामी दस्तावेज़ निरूपण देता है, लेकिन यदि बहुत अधिक डेटा उपलब्ध हो, तो अक्सर टॉपिक वर्गीकरण पर अच्छे परिणाम मिलते हैं। आप टॉपिक वर्गीकरण पर हाल का Facebook पेपर पढ़ सकते हैं।
एक स्थिर-लंबाई दस्तावेज़ निरूपण का अर्थ है कि आप विभिन्न लंबाई के दस्तावेज़ों को आसानी से ML मॉडलों (SVM, k-NN, Random Forests, ...) में फ़ीड कर सकते हैं। यह आपको दस्तावेज़ों पर क्लस्टरिंग या टॉपिक वर्गीकरण करने देता है। दस्तावेज़ की संरचनात्मक जानकारी हटा दी जाती है और मॉडलों को यह खोजना पड़ता है कि कौन-से वेक्टर आयाम अर्थ-स्तर पर समान हैं। उदाहरण के लिए ‘feline’ और ‘cat’ का अलग-अलग आयामों पर मानचित्रण कम सहज है, क्योंकि मॉडल को इन अलग-अलग आयामों के बीच सहसंबंध सीखने के लिए मजबूर किया जाता है।
LDA मॉडल को प्रशिक्षित करते समय, आप दस्तावेज़ों के एक संग्रह से शुरू करते हैं और प्रत्येक को स्थिर-लंबाई वेक्टर (bag-of-words) द्वारा निरूपित किया जाता है। LDA एक सामान्य मशीन लर्निंग (ML) तकनीक है, जिसका अर्थ है कि इसे अन्य असUPERVISED ML समस्याओं में भी इस्तेमाल किया जा सकता है जहाँ इनपुट स्थिर-लंबाई वेक्टरों का संग्रह हो और लक्ष्य इस डेटा की संरचना का अन्वेषण करना हो।
LDA मॉडल को लागू करने के लिए, आप पहले यह परिभाषित करते हैं कि आपके दस्तावेज़-संग्रह में कितने ‘टॉपिक’ मौजूद हैं। यह सीधे-सीधे लगता है, लेकिन जब आप बहुत बड़े दस्तावेज़-समूह के साथ काम करते हैं, तो यह उतना सहज नहीं रहता।
$$N$$ दस्तावेज़ों पर $$M$$ टॉपिक के साथ LDA मॉडल का प्रशिक्षण उस डेटा की सबसे अच्छी व्याख्या करने वाले दस्तावेज़ और टॉपिक वेक्टरों को खोजने के बराबर है।
ध्यान दें कि यह ट्यूटोरियल LDA के पीछे की संपूर्ण थ्योरी को विस्तार से कवर नहीं करेगा (इसके लिए Blei इत्यादि का यह पेपर देखें), क्योंकि यहाँ फोकस सामान्य अवधारणा को समझाना है।
मान लीजिए कि दस्तावेज़ों की शब्दावली में $$V$$ शब्द हैं। 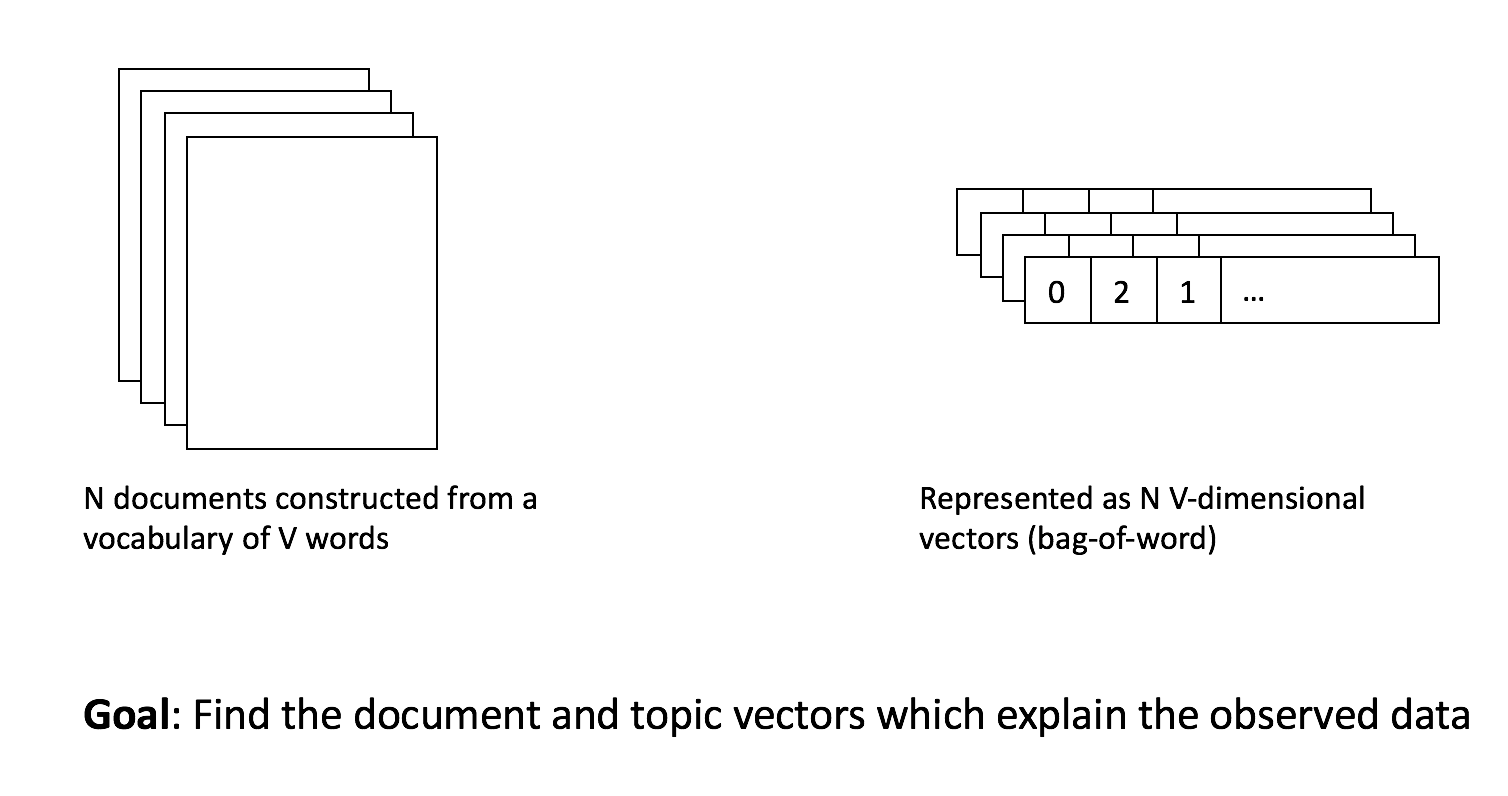
$$N$$ में से प्रत्येक दस्तावेज़ LDA मॉडल में लंबाई $$M$$ के वेक्टर द्वारा निरूपित होगा, जो बताता है कि उस दस्तावेज़ में कौन-से टॉपिक आते हैं। कोई दस्तावेज़ 75% ‘टॉपिक 1’ और 25% ‘टॉपिक 2’ का हो सकता है। अक्सर, LDA ऐसे दस्तावेज़ वेक्टर देता है जिनमें बहुत सारे शून्य होते हैं, जिसका अर्थ है कि प्रति दस्तावेज़ केवल सीमित संख्या में टॉपिक उपस्थित हैं। यह इस विचार के अनुरूप है कि दस्तावेज़ आमतौर पर सीमित संख्या के टॉपिक पर ही बात करते हैं। इससे इन दस्तावेज़ वेक्टरों की मानवीय व्याख्येयता में काफी सुधार होता है।
$$M$$ में से प्रत्येक टॉपिक लंबाई $$V$$ के वेक्टर से निरूपित होता है, जो यह बताता है कि उस टॉपिक के दस्तावेज़ में कौन-से शब्द आने की संभावना अधिक है। तो टॉपिक 1 के लिए ‘learning’, ‘modelling’ और ‘statistics’ कुछ सबसे आम शब्द हो सकते हैं। इसका अर्थ हुआ कि आप कह सकते हैं कि यह ‘data science’ टॉपिक है। टॉपिक 2 के लिए ‘GPU’, ‘compute’ और ‘storage’ सबसे आम शब्द हो सकते हैं। आप इसे ‘computing’ टॉपिक के रूप में व्याख्या कर सकते हैं।
निम्न छवि LDA मॉडल को दृश्य रूप से दर्शाती है। मॉडल का लक्ष्य वे टॉपिक और दस्तावेज़ वेक्टरों को खोजना है जो अलग-अलग दस्तावेज़ों के मूल bag-of-words निरूपण की व्याख्या करते हैं। 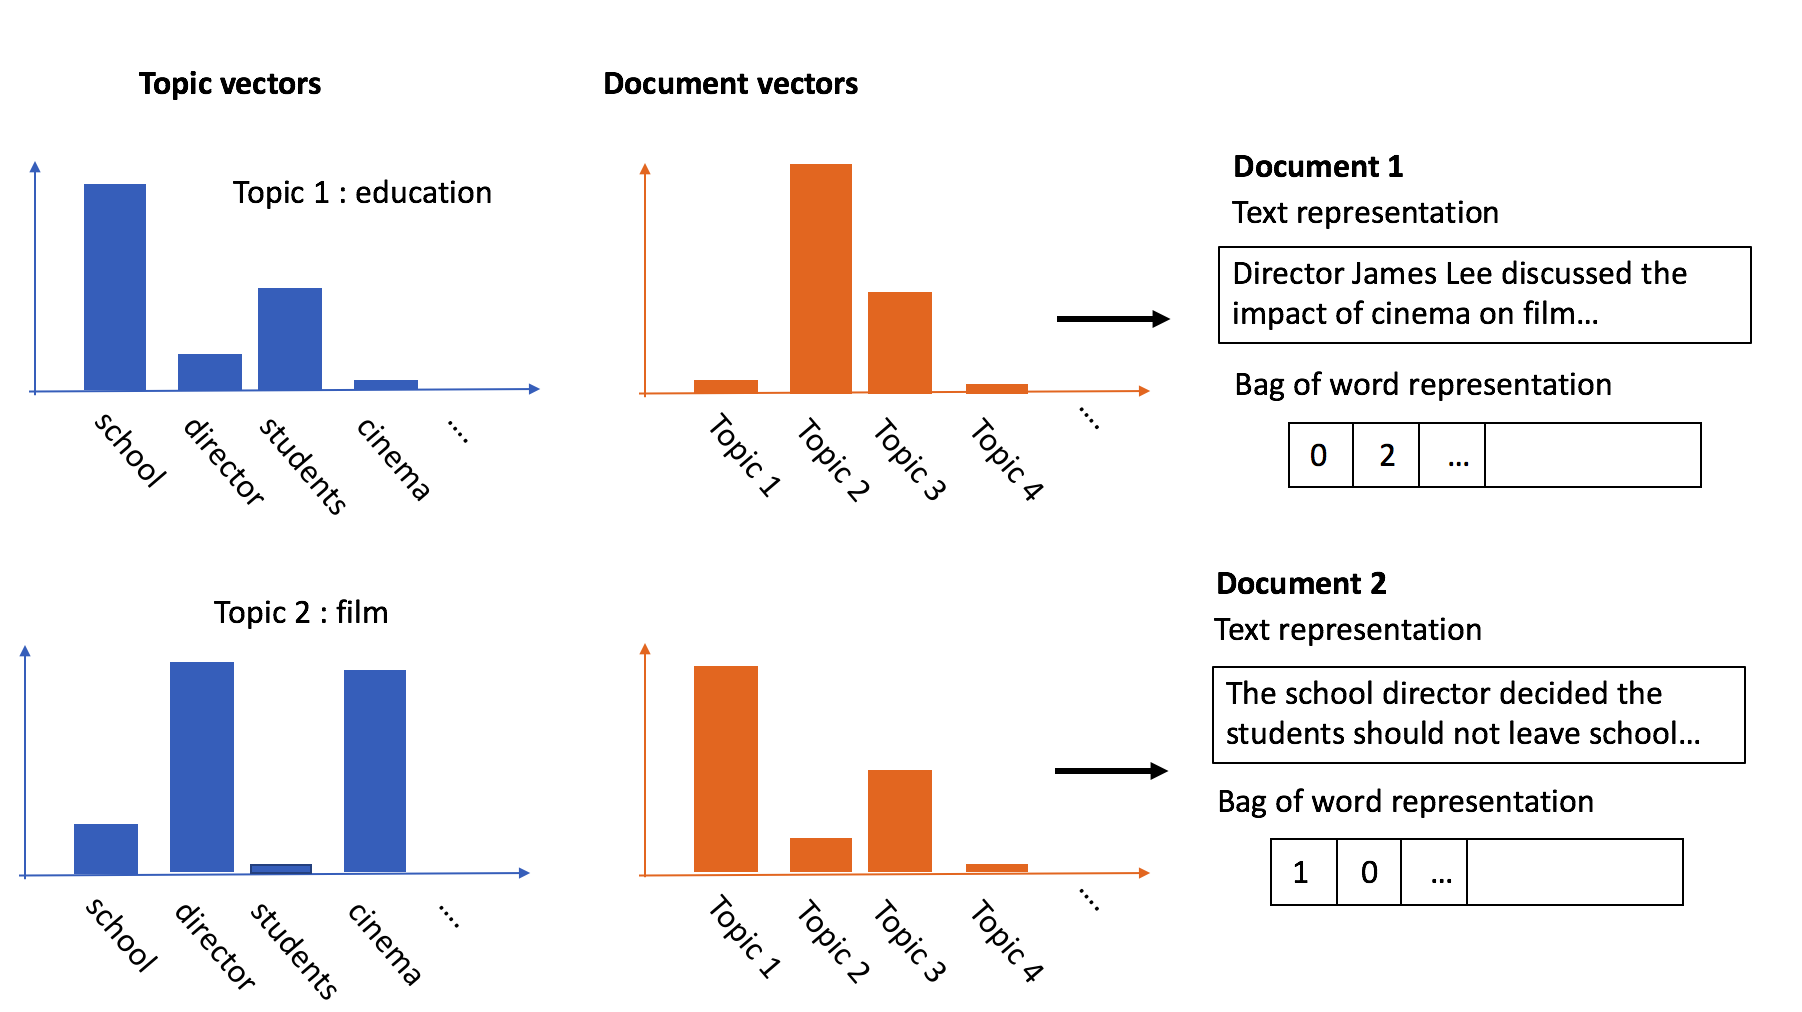
यह ध्यान देना महत्वपूर्ण है कि आप इस धारणा पर निर्भर हैं कि टॉपिक वेक्टर व्याख्यायोग्य होंगे, अन्यथा मॉडल का आउटपुट लगभग बेकार है। मूलतः, आप मानते हैं कि पर्याप्त डेटा मिलने पर मॉडल यह पता लगा लेगा कि कौन-से शब्द साथ-साथ आते हैं और उन्हें पृथक ‘टॉपिक’ में क्लस्टर करेगा।
LDA एक सरल प्रायिक मॉडल है जो अक्सर काफ़ी अच्छा काम करता है। दस्तावेज़ वेक्टर अक्सर विरल, निम्न-आयामी और अत्यधिक व्याख्यायोग्य होते हैं, जो दस्तावेज़ों में पैटर्न और संरचना को उजागर करते हैं। आपको दस्तावेज़-संग्रह में टॉपिकों की संख्या का एक अच्छा अनुमान निर्धारित करना पड़ता है। इसके अलावा, आपको अलग-अलग टॉपिक वेक्टरों को मैन्युअल रूप से एक विशिष्ट नाम/‘टॉपिक’ देना पड़ता है। क्योंकि दस्तावेज़ों को निरूपित करने के लिए bag-of-words मॉडल का उपयोग किया जाता है, LDA bag-of-words मॉडल जैसी ही कमियों से ग्रस्त हो सकता है। LDA मॉडल किसी दस्तावेज़ के भीतर शब्दों का पूर्वानुमान लगाने वाला दस्तावेज़ वेक्टर सीखता है, जबकि किसी भी संरचना या स्थानीय स्तर पर इन शब्दों के परस्पर संबंधों को नज़रअंदाज़ कर देता है।
bag-of-words निरूपण की समस्याओं में से एक यह है कि दस्तावेज़ वेक्टरों के किन आयामों में अर्थ-स्तर पर संबंध है, यह जानना मॉडल की जिम्मेदारी होती है। यह सोचा जा सकता है कि शब्दों के पारस्परिक अर्थ-सहसंबंध का लाभ उठाने से मॉडल का प्रदर्शन बेहतर होगा—और यही वादा शब्द एम्बेडिंग्स करती हैं।
शब्द एम्बेडिंग्स में शब्दों को स्थिर-लंबाई वेक्टरों या एम्बेडिंग्स के रूप में निरूपित किया जाता है। एम्बेडिंग्स बनाने के कई अलग-अलग मॉडल मौजूद हैं, लेकिन वे सभी वितरणात्मक परिकल्पना पर आधारित हैं। यानी "एक शब्द उसकी संगति से पहचाना जाता है"।
शब्द एम्बेडिंग्स का लक्ष्य विकिपीडिया जैसे बड़े, असUPERVISED दस्तावेज़-समुच्चयों से भाषा में अर्थ-स्तरीय और वाक्यविन्यास संबंधी नियमितताओं को पकड़ना है। जो शब्द एक ही संदर्भ में आते हैं, वे आपस में निकटता वाले वेक्टरों द्वारा निरूपित होते हैं।
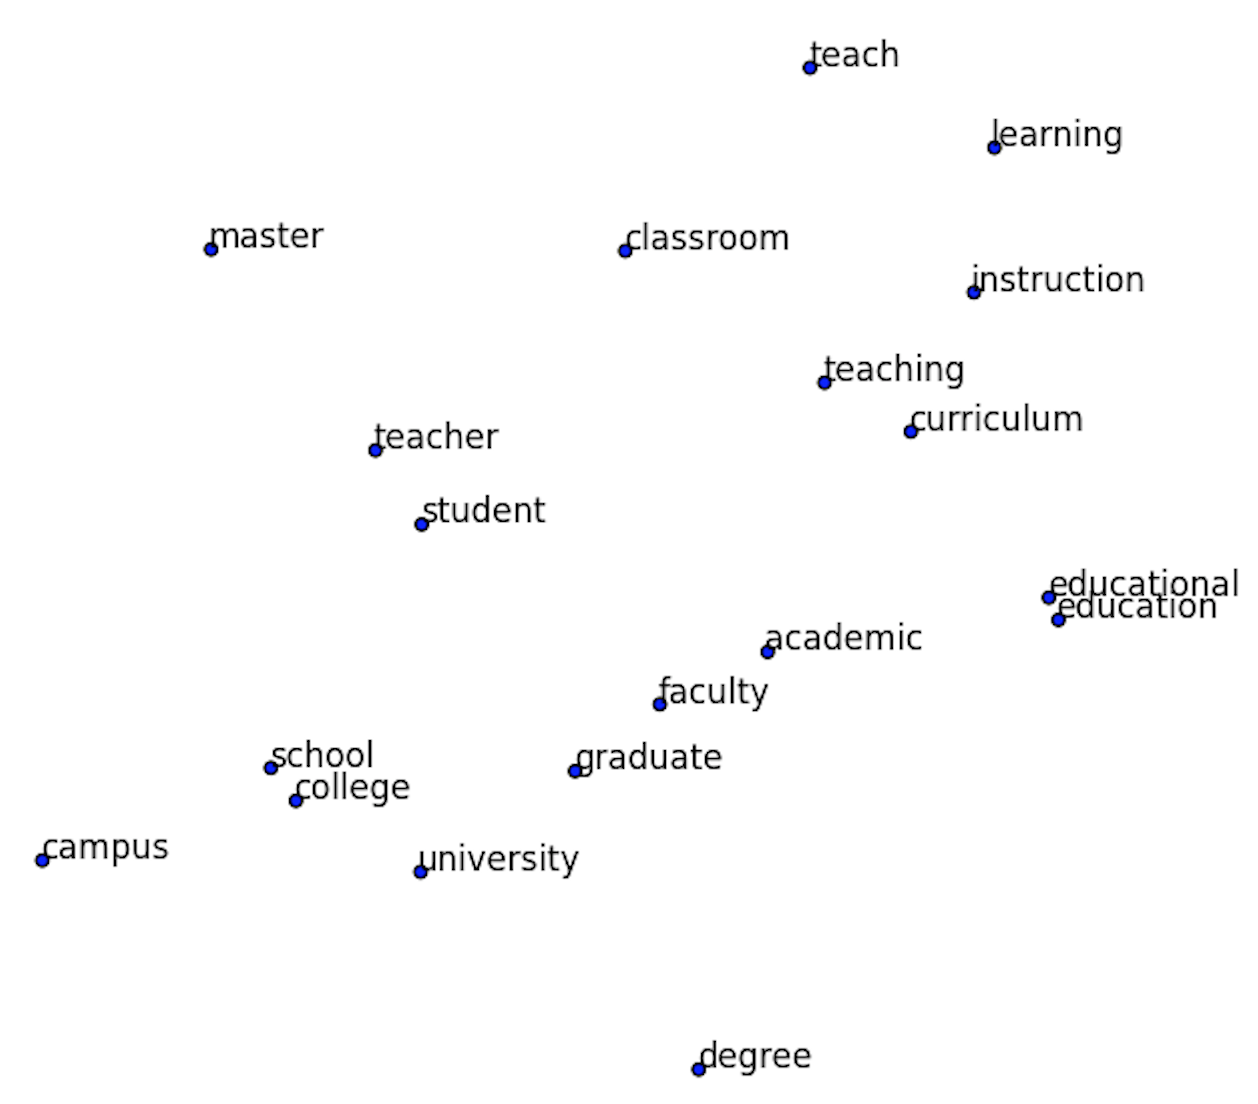
छवि यहाँ से ली गई है: "Visualizing Word Embeddings with t-SNE"
ऊपर की छवि t-Distributed Stochastic Neighbor Embedding (t-SNE) का उपयोग करके शब्द एम्बेडिंग स्पेस का 2D स्पेस में प्रोजेक्शन है। t-SNE एक आयाम-घटाव विधि है जिसका उपयोग आप उच्च-आयामी डेटा का दृश्यांकन करने के लिए कर सकते हैं। यह विधि शब्द एम्बेडिंग्स को इनपुट के रूप में लेती है और उन्हें द्वि-आयामी स्पेस पर प्रोजेक्ट करती है, जिसे प्लॉट में आसानी से दर्शाया जा सकता है। केवल शब्द-स्पेस का एक उपखंड जाँचा गया है, जो ‘teacher’ के निकट शब्दों पर केंद्रित है। शब्दों को वेक्टर में अनसूचनात्मक आयामों से निरूपित करने के बजाय, शब्द एम्बेडिंग्स का उपयोग करके शब्दों को अर्थ-सहसंबद्ध वेक्टरों से निरूपित किया जा सकता है।
शब्द एम्बेडिंग्स का उपयोग करने पर, कोई ML मॉडल वेक्टर निरूपणों में एक बड़े दस्तावेज़-संग्रह, जिसे "corpus" भी कहते हैं, की जानकारी समाहित कर सकता है। यह bag-of-words मॉडलों के साथ संभव नहीं है, जो तब मॉडल के प्रदर्शन को नुकसान पहुँचा सकता है जब पर्याप्त डेटा उपलब्ध न हो। शब्द एम्बेडिंग्स दस्तावेज़ निरूपणों को अब स्थिर-लंबाई नहीं रहने देतीं। इसके बजाय, दस्तावेज़ों को शब्द-वेक्टर एम्बेडिंग्स के चर-लंबाई अनुक्रम द्वारा निरूपित किया जाता है। जबकि कुछ डीप लर्निंग तकनीकें, जैसे Long Short-Term Memory (LSTM), adaptive pooling वाले convolutional नेटवर्क, ... चर-लंबाई अनुक्रमों से निपटने में सक्षम हैं, उन्हें ठीक से प्रशिक्षित करने के लिए अक्सर बहुत अधिक डेटा की आवश्यकता होती है।
जैसा कि आपने प्रस्तावना में पढ़ा, word2vec एक अत्यंत लोकप्रिय शब्द एम्बेडिंग मॉडल है, जिसे Mikolov इत्यादि ने विकसित किया। ध्यान दें कि वितरणात्मक सिमैंटिक्स के क्षेत्र में कई अन्य शब्द एम्बेडिंग मॉडल भी मौजूद हैं। हालाँकि उच्च-गुणवत्ता वाली शब्द एम्बेडिंग्स पाने के लिए कई तरकीबें आवश्यक होती हैं, यह ट्यूटोरियल केवल word2vec के मूल विचार पर केंद्रित रहेगा।
शब्द एम्बेडिंग्स प्राप्त करने के लिए word2vec में निम्न प्रशिक्षण प्रक्रिया उपयोग की जाती है।
टेक्स्ट में एक (pivot) शब्द चुनें। वर्तमान पिवट शब्द के संदर्भ (context) शब्द वे हैं जो उसके आसपास आते हैं। इसका मतलब है कि आप शब्दों की एक स्थिर-लंबाई विंडो के भीतर काम कर रहे हैं। पिवट और संदर्भ शब्दों के संयोजन मिलकर शब्द-संदर्भ युग्मों का एक सेट बनाते हैं। नीचे की छवि Chris Moody के ब्लॉग से ली गई है। इस पाठखंड में ‘awesome’ पिवट शब्द है और उसके आसपास के शब्द संदर्भ शब्द लिए गए हैं, जिससे 7 शब्द-संदर्भ युग्म बनते हैं। 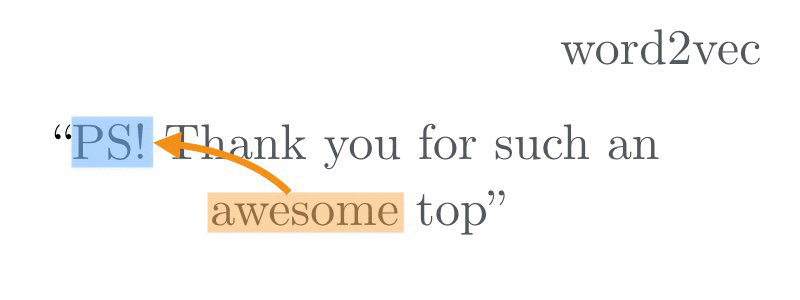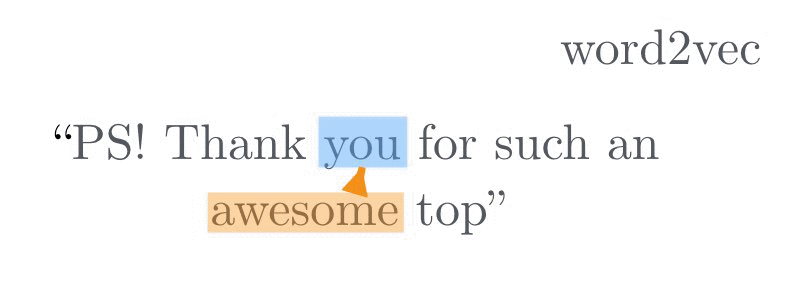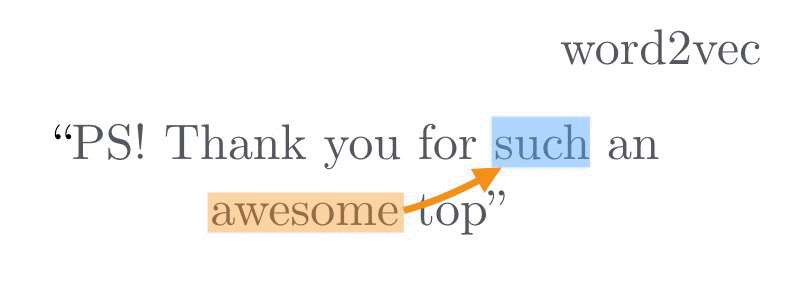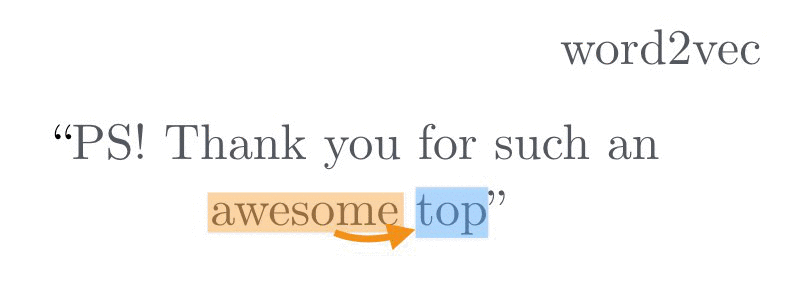
word2vec मॉडल की दो विविधताएँ हैं: a. bag-of-words आर्किटेक्चर (CBOW) में पिवट शब्द को आसपास के संदर्भ शब्दों के सेट के आधार पर अनुमानित किया जाता है (जैसे 'thank', 'such', 'you', 'top' दिए जाने पर मॉडल को 'awesome' का अनुमान लगाना है)। इसे bag-of-words आर्किटेक्चर कहा जाता है क्योंकि संदर्भ शब्दों का क्रम मायने नहीं रखता। b. skip-gram आर्किटेक्चर में, पिवट शब्द का उपयोग आसपास के संदर्भ शब्दों का पूर्वानुमान लगाने के लिए किया जाता है (जैसे 'awesome' दिए जाने पर 'thank', 'such', 'you', 'top' का अनुमान लगाना)। निम्न छवि दो अलग-अलग word2vec आर्किटेक्चर को दर्शाती है। ध्यान दें कि अपेक्षाकृत सरल (दो-लेयर) न्यूरल मॉडल का उपयोग किया जाता है (कंप्यूटर विज़न के डीप न्यूरल मॉडलों की तुलना में)।
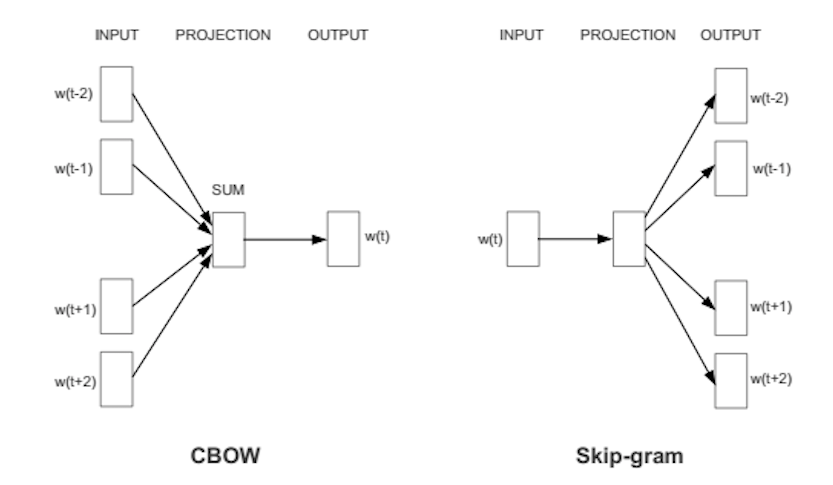
मॉडल को बड़े कॉर्पस पर प्रशिक्षित करके, आपको ऐसे शब्द एम्बेडिंग्स (प्रोजेक्शन लेयर के वज़न) मिलते हैं जो अर्थ-स्तरीय जानकारी के साथ कुछ रोचक गुण भी एन्कोड करते हैं: वेक्टर अंकगणित करना संभव हो जाता है, जैसे $$king - man + woman = queen$$।
शब्द वेक्टर, उदाहरण के लिए, एक साधारण one-hot एन्कोडेड निरूपण की तुलना में अधिक उपयोगी निरूपण हैं। वे किसी बड़े कॉर्पस की सांख्यिकीय जानकारी को अन्य मॉडलों, जैसे टॉपिक वर्गीकरण या संवाद प्रणालियों, में एन्कोड करने की अनुमति देते हैं। शब्द वेक्टर अक्सर घने, उच्च-आयामी और अव्याख्यायोग्य होते हैं। निम्न उदाहरण पर विचार करें: [ -0.65, -1.223, ..., -0.252, +3.2]। जबकि LDA में आयाम लगभग टॉपिक के अनुरूप होते हैं, यह आम तौर पर शब्द वेक्टरों के लिए सही नहीं होता। प्रत्येक शब्द को एक संदर्भ-स्वतंत्र शब्द वेक्टर सौंपा जाता है। लेकिन शब्दों का अर्थ-संदर्भ काफी हद तक सन्दर्भ-निर्भर होता है। word2vec मॉडल ऐसे शब्द वेक्टर सीखता है जो अलग-अलग दस्तावेज़ों में संदर्भ शब्दों का पूर्वानुमान लगाते हैं। परिणामस्वरूप, दस्तावेज़-विशिष्ट जानकारी शब्द एम्बेडिंग्स में मिल-जुल जाती है।
Latent Dirichlet Allocation (LDA) से प्रेरित होकर, word2vec मॉडल का विस्तार इस प्रकार किया गया है कि वह शब्द, दस्तावेज़ और टॉपिक वेक्टरों को एक साथ सीख सके।
lda2vec skip-gram word2vec रूपांतर में संशोधन करके प्राप्त होता है। मूल skip-gram विधि में, मॉडल पिवट शब्द के आधार पर संदर्भ शब्दों का पूर्वानुमान लगाने के लिए प्रशिक्षित किया जाता है। lda2vec में, पिवट शब्द वेक्टर और एक दस्तावेज़ वेक्टर को जोड़कर एक संदर्भ वेक्टर प्राप्त किया जाता है। फिर इस संदर्भ वेक्टर का उपयोग संदर्भ शब्दों की भविष्यवाणी करने के लिए किया जाता है।
अगले खंड में, आप देखेंगे कि ये दस्तावेज़ वेक्टर कैसे निर्मित किए जाते हैं और उन्हें LDA में दस्तावेज़ वेक्टरों की तरह कैसे उपयोग किया जा सकता है।
word2vec मॉडल में संदर्भ वेक्टरों को एकीकृत करने का विचार नया नहीं है। उदाहरण के लिए, Paragraph vectors ने भी इस विचार का अन्वेषण किया ताकि चर-लंबाई वाले पाठखंडों के स्थिर-लंबाई निरूपण सीखे जा सकें। अपने काम में, प्रत्येक पाठखंड (पैराग्राफ के आकार) के लिए एक घना वेक्टर निरूपण सीखा जाता है, जो सीखे गए शब्द वेक्टरों के समान है।
इस पद्धति की कमी यह है कि संदर्भ/पैराग्राफ वेक्टर विशिष्ट शब्द वेक्टर जैसे दिखते हैं, जिससे वे, उदाहरण के लिए, LDA के आउटपुट जितने व्याख्यायोग्य नहीं रहते।
lda2vec मॉडल पैराग्राफ वेक्टर दृष्टिकोण से एक कदम आगे जाता है, दस्तावेज़-आकार के पाठखंडों के साथ काम करके और दस्तावेज़ वेक्टरों को दो अलग-अलग घटकों में विघटित करके। LDA मॉडल की ही भावना में, एक दस्तावेज़ वेक्टर को दस्तावेज़ वेट वेक्टर और एक टॉपिक मैट्रिक्स में विभाजित किया जाता है। दस्तावेज़ वेट वेक्टर विभिन्न टॉपिक का प्रतिशत दर्शाता है, जबकि टॉपिक मैट्रिक्स अलग-अलग टॉपिक वेक्टरों से बना होता है। इस प्रकार, संदर्भ वेक्टर किसी दस्तावेज़ में उपस्थित अलग-अलग टॉपिक वेक्टरों को संयोजित करके बनाया जाता है।
निम्न उदाहरण पर विचार करें: मूल word2vec मॉडल में, यदि पिवट शब्द ‘French’ है, तो संभावित संदर्भ शब्द ‘German’, ‘Dutch’, ‘English’ हो सकते हैं। किसी भी वैश्विक (दस्तावेज़-संबंधित) जानकारी के बिना, ये सबसे संभावित अनुमान होंगे।
lda2vec मॉडल में एक अतिरिक्त संदर्भ वेक्टर उपलब्ध कराके, संदर्भ शब्दों के बेहतर अनुमान लगाना संभव हो जाता है।
यदि दस्तावेज़ वेक्टर ‘food’ और ‘drinks’ टॉपिक का संयोजन है, तो ‘baguette’, ‘cheese’ और ‘wine’ अधिक उपयुक्त हो सकते हैं। यदि दस्तावेज़ वेक्टर ‘city’ और ‘geography’ टॉपिक के समान है, तो ‘Paris’, ‘Lyon’ और ‘Grenoble’ अधिक उपयुक्त हो सकते हैं।
ध्यान दें कि ये टॉपिक वेक्टर शब्द-स्पेस में सीखे जाते हैं, जो आसान व्याख्या की अनुमति देता है: आप बस उन शब्द वेक्टरों को देखते हैं जो टॉपिक वेक्टरों के सबसे निकट हैं। इसके अलावा, दस्तावेज़ वेट वेक्टरों पर बाधाएँ लगाई जाती हैं, ताकि घने वेक्टर की बजाय (LDA के समान) एक विरल वेक्टर प्राप्त हो। यह अलग-अलग दस्तावेज़ों की टॉपिक-वस्तु की आसान व्याख्या में सहायक है।
संक्षेप में, lda2vec का अंतिम परिणाम विरल दस्तावेज़ वेट वेक्टरों का एक सेट, साथ ही आसानी से व्याख्यायोग्य टॉपिक वेक्टर होते हैं।
हालाँकि प्रदर्शन पारंपरिक LDA के समान रहने की प्रवृत्ति रखता है, स्वचालित अवकलन (automatic differentiation) विधियों का उपयोग इस पद्धति को अत्यंत बड़े डेटासेट पर स्केलेबल बनाता है। इसके अतिरिक्त, संदर्भ वेक्टर और शब्द वेक्टर को जोड़कर, आपको ‘विशेषीकृत’ शब्द वेक्टर मिलते हैं, जिन्हें अन्य मॉडलों में उपयोग किया जा सकता है (और जो अधिक ‘सामान्य’ शब्द वेक्टरों से बेहतर प्रदर्शन कर सकते हैं)।
lda2vec अपेक्षाकृत नया और विशिष्ट NLP तकनीक है। यह मौजूदा विधियों पर आधारित है, इसलिए किसी भी word2vec इम्प्लीमेंटेशन को lda2vec में विस्तारित किया जा सकता है। Chris Moody ने इस विधि को Chainer में लागू किया, लेकिन अन्य स्वचालित अवकलन फ्रेमवर्क (CNTK, Theano, ...) भी उपयोग किए जा सकते हैं। Tensorflow में एक इम्प्लीमेंटेशन भी सार्वजनिक रूप से उपलब्ध कराया गया।
lda2vec Python मॉड्यूल का एक अवलोकन यहाँ पाया जा सकता है। क्योंकि lda2vec को प्रशिक्षित करना संगणनात्मक रूप से गहन हो सकता है, बड़े कॉर्पस के लिए GPU समर्थन की सिफारिश की जाती है। साथ ही, प्रशिक्षण को तेज करने के लिए, अलग-अलग शब्द वेक्टरों को अक्सर प्री-ट्रेंड word2vec वेक्टरों से आरंभ किया जाता है।
अंततः, lda2vec को एक टॉपिक मॉडल के रूप में चर्चा की गई, लेकिन word2vec मॉडल में संदर्भ वेक्टर जोड़ने का विचार अधिक सामान्य रूप से भी परिभाषित किया जा सकता है। उदाहरण के लिए, अलग-अलग क्षेत्रों के अलग-अलग लेखकों द्वारा लिखे गए दस्तावेज़ों पर विचार करें। तब लेखक और क्षेत्र वेक्टर भी संदर्भ वेक्टर में जोड़े जा सकते हैं, जिसके परिणामस्वरूप दस्तावेज़, क्षेत्र और लेखक वेक्टर निरूपण प्राप्त करने की एक असUPERVISED विधि मिलती है।
इस ब्लॉग पोस्ट ने केवल LDA, word2vec और lda2vec का एक त्वरित अवलोकन प्रदान किया। ध्यान दें कि मूल लेखक ने lda2vec के तकनीकी विवरणों पर एक उत्कृष्ट ब्लॉग पोस्ट भी प्रकाशित की है।
मशीन लर्निंग के बारे में और जानें
कोर्स
कोर्स
कोर्स