Kurs
Machine Learning verstehen
2 Std.
308K
Dieser Blogpost gibt dir eine Einführung in lda2vec, ein Topic-Modell, das 2016 von Chris Moody veröffentlicht wurde. lda2vec erweitert das von Mikolov et al., 2013, beschriebene word2vec-Modell um Topic- und Dokumentvektoren und verbindet Ideen aus Word Embeddings und Topic-Modellen.
Das übergeordnete Ziel eines Topic-Modells ist es, interpretierbare Dokumentrepräsentationen zu erzeugen, mit denen sich Themen oder Strukturen in einer Sammlung unbeschrifteter Dokumente entdecken lassen. Ein Beispiel für eine solche interpretierbare Repräsentation wäre: Dokument X besteht zu 20% aus Topic A, zu 40% aus Topic B und zu 40% aus Topic C.
Heute starten wir mit einer Einführung in Latent Dirichlet Allocation (LDA). LDA ist ein probabilistisches Topic-Modell und behandelt Dokumente als Bag-of-Words. Zuerst beleuchten wir die Vor- und Nachteile dieses Ansatzes.
Im Gegensatz dazu baut lda2vec Dokumentrepräsentationen auf Word Embeddings auf. Du lernst, was Word Embeddings sind und warum sie derzeit der bevorzugte Baustein in NLP-Modellen (Natural Language Processing) sind.
Zum Schluss erfährst du mehr über die Grundidee hinter lda2vec.
Ein Topic-Modell nimmt eine Sammlung unbeschrifteter Dokumente und versucht, die darin verborgenen Strukturen oder Themen zu finden. Häufig wird dabei angenommen, dass die Wortverwendung mit dem Auftreten von Themen korreliert. Du könntest zum Beispiel ein Set von Nachrichtenartikeln einspeisen, und das Topic-Modell würde die Dokumente basierend auf der Wortverwendung in Cluster aufteilen.
Topic-Modelle eignen sich hervorragend, um große Dokumentmengen automatisch zu erkunden und zu strukturieren: Sie gruppieren bzw. clustern Dokumente anhand der darin vorkommenden Wörter. Da Texte zu ähnlichen Themen oft ein ähnliches Teilvokabular nutzen, lassen sich die resultierenden Cluster als unterschiedliche „Themen“ interpretieren.
Latent Dirichlet Allocation (LDA) ist ein Beispiel für ein probabilistisches Topic-Modell. Was das genau bedeutet, siehst du in den nächsten Abschnitten: Zuerst erfährst du, wie LDA mit einer Bag-of-Words-Beschreibung startet, um Dokumente darzustellen. Danach siehst du, wie diese Repräsentationen genutzt werden, um Struktur in der Dokumentensammlung zu finden.
Traditionell werden Textdokumente im NLP als Bag-of-Words dargestellt.
Das bedeutet: Jedes Dokument wird als Vektor fester Länge mit der Länge des Vokabulars repräsentiert. Jede Dimension entspricht der Häufigkeit bzw. dem Auftreten eines Wortes im Dokument. Variable Dokumentlängen auf feste Vektoren zu reduzieren, macht sie für eine Vielzahl von Machine-Learning-Modellen und -Aufgaben (Clustering, Klassifikation, …) handhabbar.
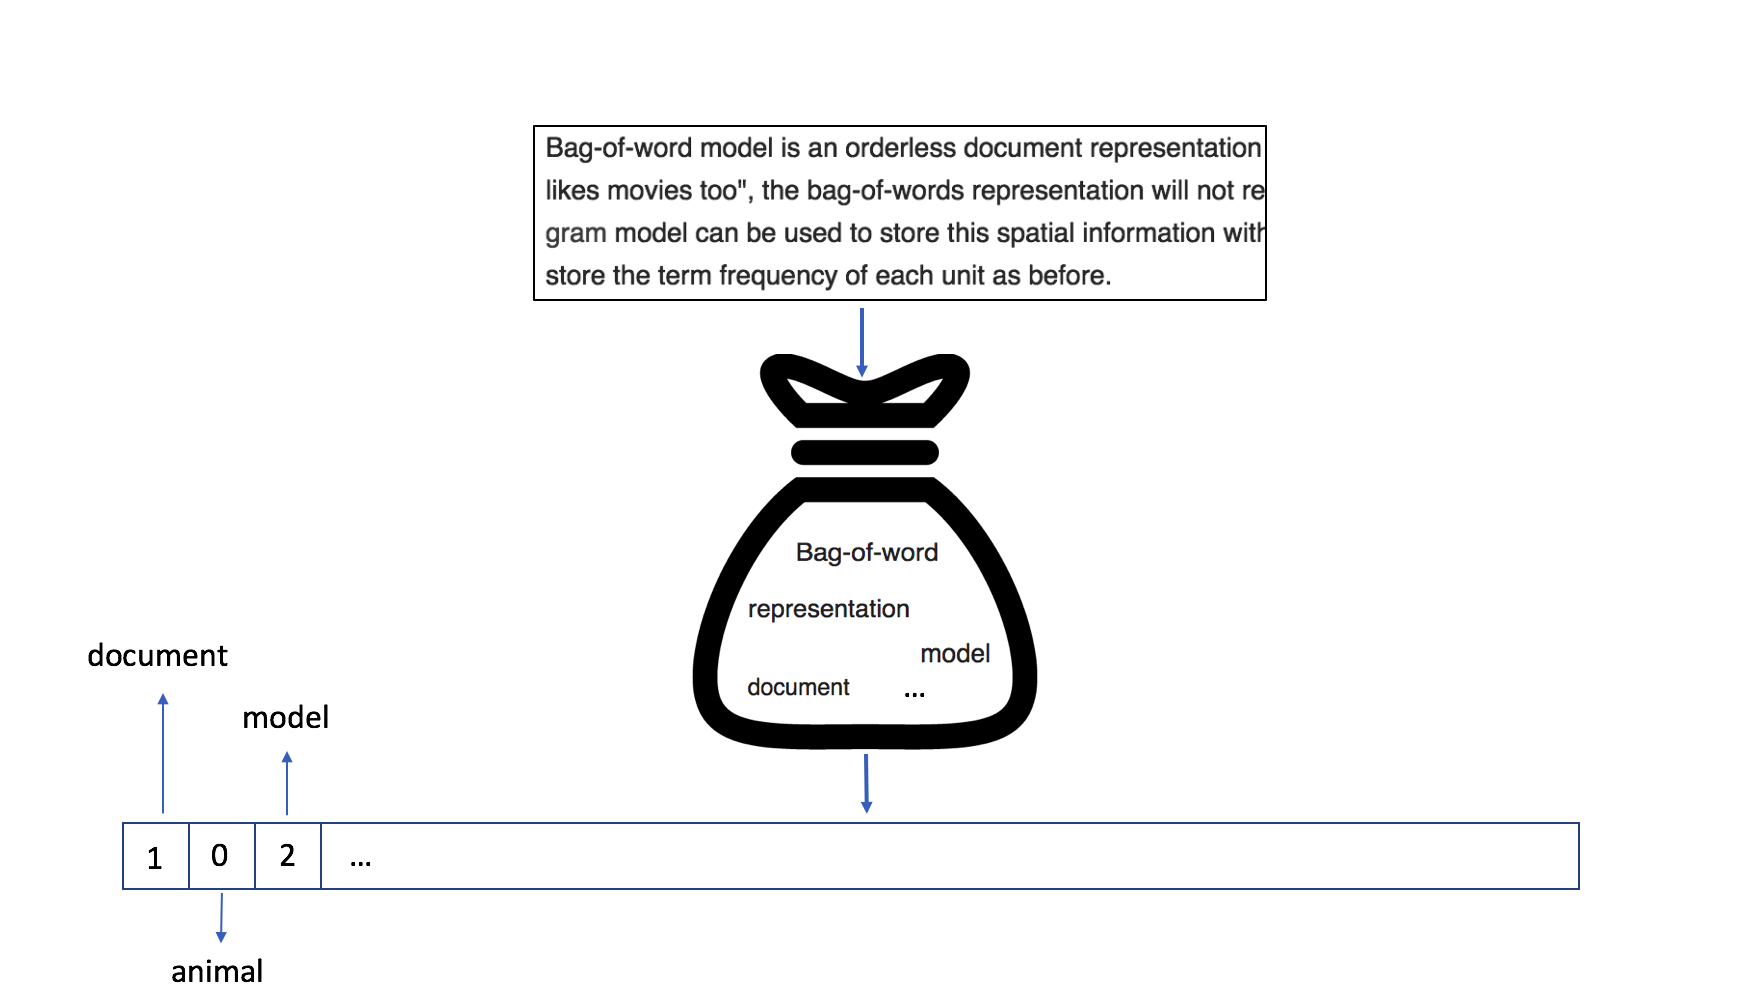
Das Bild oben zeigt, wie ein Dokument im Bag-of-Words-Modell dargestellt wird: Das Wort "document" hat die Häufigkeit 1, während "model" zweimal vorkommt.
Auch wenn Bag-of-Words eine spärliche, hochdimensionale Repräsentation liefert, lassen sich bei genügend Daten oft gute Ergebnisse in der Themenklassifikation erzielen. Lies dazu auch das aktuelle Facebook-Paper zur Topic-Klassifikation.
Eine Darstellung mit fester Länge ermöglicht es, Dokumente variabler Länge einfach in ML-Modelle (SVMs, k-NN, Random Forests, …) einzuspeisen. So kannst du Dokumente clustern oder Themen klassifizieren. Die Strukturinformation des Dokuments geht verloren, und Modelle müssen selbst herausfinden, welche Vektordimensionen semantisch ähnlich sind. Es ist zum Beispiel wenig intuitiv, „feline“ und „cat“ auf unterschiedliche Dimensionen abzubilden, da das Modell die Korrelation zwischen diesen Dimensionen erst lernen muss.
Beim Training eines LDA-Modells startest du mit einer Dokumentensammlung, wobei jedes Dokument als Vektor fester Länge (Bag-of-Words) dargestellt ist. LDA ist eine generelle Machine-Learning-Technik und lässt sich daher auch für andere unüberwachte ML-Probleme nutzen, bei denen der Input eine Sammlung fester Vektoren ist und das Ziel darin besteht, die Struktur der Daten zu erkunden.
Für die Implementierung legst du zuerst fest, wie viele „Topics“ in deiner Dokumentensammlung vorkommen. Das klingt einfach, ist in großen Korpora aber oft weniger intuitiv als gedacht.
Ein LDA-Modell auf $$N$$ Dokumenten mit $$M$$ Topics zu trainieren, bedeutet, die Dokument- und Topic-Vektoren zu finden, die die Daten am besten erklären.
Die vollständige Theorie hinter LDA decken wir hier nicht ab (siehe dafür dieses Paper von Blei et al.). Uns geht es um das Grundprinzip.
Nehmen wir an, das Vokabular der Dokumente umfasst $$V$$ Wörter. 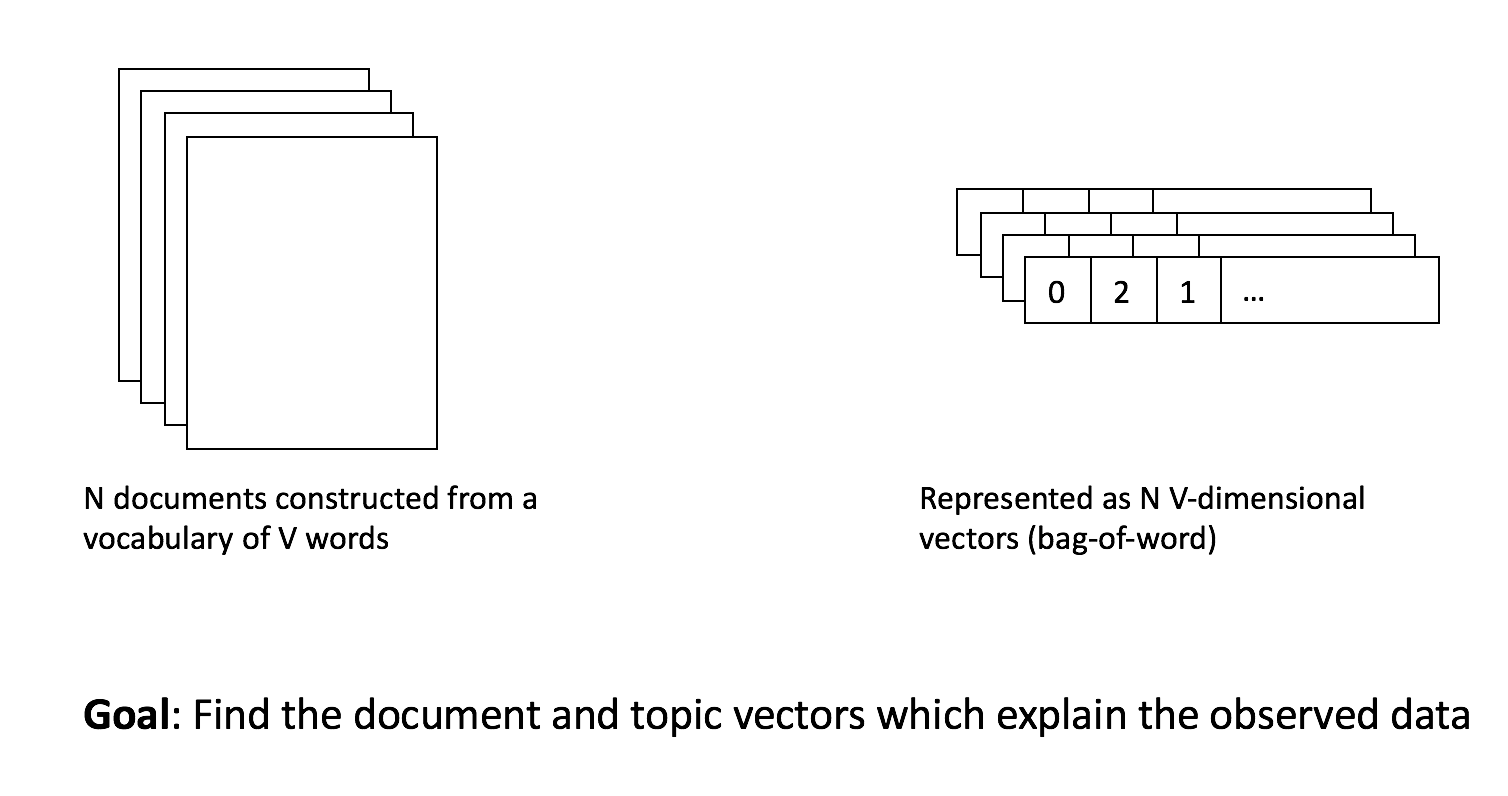
Jedes der $$N$$ Dokumente wird im LDA-Modell durch einen Vektor der Länge $$M$$ dargestellt, der angibt, welche Topics im Dokument vorkommen. Ein Dokument kann zum Beispiel zu 75% „Topic 1“ und zu 25% „Topic 2“ enthalten. Oft sind die LDA-Dokumentvektoren sehr spärlich, es treten also nur wenige Topics pro Dokument auf. Das passt zur Beobachtung, dass Texte in der Regel nur wenige Themen behandeln, und erhöht die Interpretierbarkeit deutlich.
Jedes der $$M$$ Topics wird durch einen Vektor der Länge $$V$$ dargestellt, der angibt, welche Wörter in einem Dokument zu diesem Topic wahrscheinlich sind. Für Topic 1 könnten „learning“, „modelling“ und „statistics“ besonders häufig sein – das ließe sich als „Data-Science“-Topic deuten. Für Topic 2 könnten „GPU“, „compute“ und „storage“ dominieren – also eher das „Computing“-Topic.
Die folgende Abbildung veranschaulicht LDA: Das Ziel ist, die Topic- und Dokumentvektoren zu finden, die die ursprüngliche Bag-of-Words-Darstellung der Dokumente erklären. 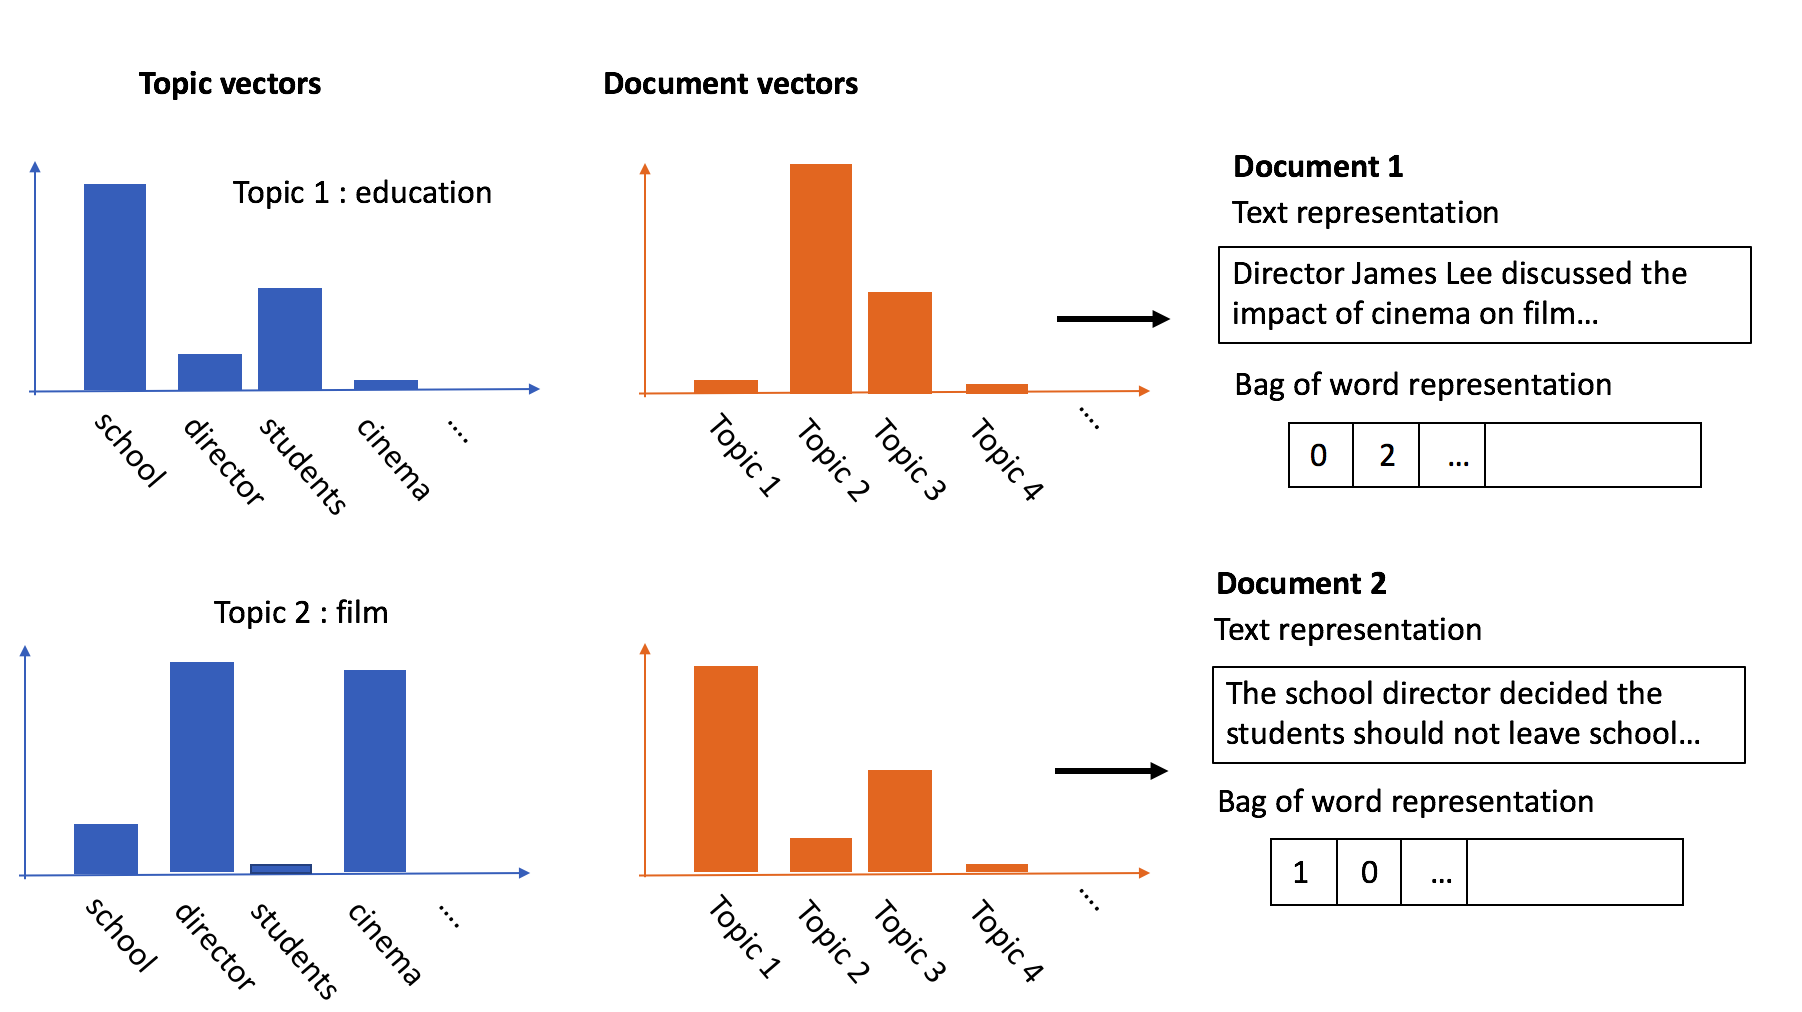
Wichtig ist die Annahme, dass die Topic-Vektoren interpretierbar sind. Andernfalls ist die Modellausgabe wenig brauchbar. Im Kern gehst du davon aus, dass das Modell mit genügend Daten Wörter, die gemeinsam auftreten, erkennt und in klar getrennte „Topics“ clustert.
LDA ist ein einfaches probabilistisches Modell, das oft sehr solide funktioniert. Die Dokumentvektoren sind häufig spärlich, niedrigdimensional und gut interpretierbar – Muster und Struktur werden sichtbar. Du musst die Themenanzahl in der Sammlung sinnvoll abschätzen. Außerdem musst du den Topic-Vektoren im Nachgang manuell sprechende Bezeichnungen/„Topics“ zuweisen. Da LDA auf Bag-of-Words basiert, kann es an denselben Nachteilen leiden wie dieser Ansatz. Das Modell lernt einen Dokumentvektor, der Wörter im Dokument vorhersagt, ignoriert dabei aber Struktur und lokale Wortinteraktionen.
Eines der Probleme der Bag-of-Words-Darstellung ist, dass das Modell selbst herausfinden muss, welche Vektordimensionen semantisch zusammengehören. Naheliegend ist, dass Wissen über semantische Zusammenhänge zwischen Wörtern die Performance verbessert – genau hier setzen Word Embeddings an.
Bei Word Embeddings werden Wörter als Vektoren fester Länge dargestellt. Es gibt verschiedene Modelle zur Erstellung solcher Embeddings, die alle auf der distributionellen Hypothese beruhen: „Ein Wort ist durch die Gesellschaft charakterisiert, die es hält.“
Das Ziel von Word Embeddings ist, semantische und syntaktische Regularitäten aus großen unüberwachten Textsammlungen wie Wikipedia zu erfassen. Wörter, die im selben Kontext auftreten, erhalten Vektoren, die im Raum nah beieinander liegen.
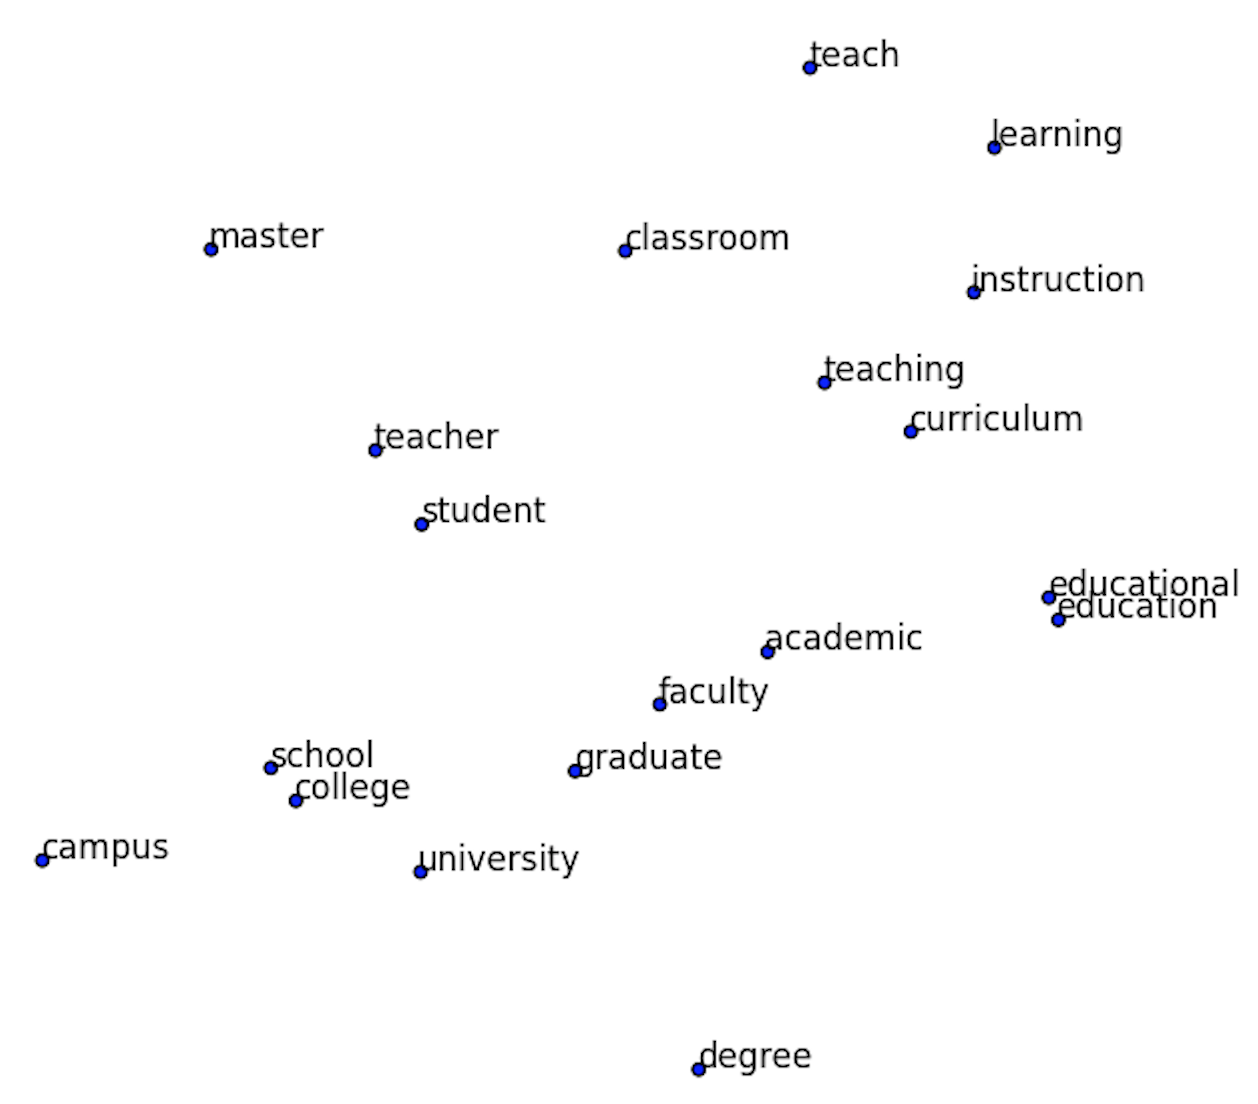
Bildquelle: "Visualizing Word Embeddings with t-SNE"
Das Bild zeigt eine Projektion des Word-Embedding-Raums in 2D mithilfe von t-SNE (t-Distributed Stochastic Neighbor Embedding), einer Methode zur Dimensionsreduktion, mit der sich hochdimensionale Daten visualisieren lassen. Als Input dienen die Embeddings, die auf zwei Dimensionen projiziert und anschließend geplottet werden. Untersucht wird nur ein Teilraum rund um „teacher“. Anstatt Wörter über wenig aussagekräftige Vektordimensionen zu repräsentieren, lassen sich mit Word Embeddings semantisch korrelierte Vektoren nutzen.
Mit Embeddings kann ein ML-Modell Informationen aus großen Dokumentensammlungen (dem „Korpus“) in die Vektorrepräsentation einbetten. Das ist mit Bag-of-Words nicht möglich und kann die Performance bei wenig Daten schmälern. Word Embeddings führen dazu, dass Dokumente nicht mehr als feste Vektoren darstellbar sind. Stattdessen bestehen sie aus Sequenzen variabler Länge von Wortvektoren. Einige Deep-Learning-Methoden wie LSTMs oder Convolutional Nets mit adaptivem Pooling können damit umgehen, benötigen dafür aber oft viele Daten.
Wie eingangs erwähnt, ist word2vec ein sehr populäres Embedding-Modell von Mikolov et al. Es gibt weitere Modelle in der distributionellen Semantik. Auch wenn verschiedene Tricks nötig sind, um hochwertige Embeddings zu erhalten, konzentriert sich dieses Tutorial auf die Kernidee von word2vec.
Das Training in word2vec läuft wie folgt ab:
Wähle ein (Pivot‑)Wort im Text. Die Kontextwörter des aktuellen Pivot-Worts sind die umliegenden Wörter innerhalb eines Fensters fester Länge. Aus Pivot- und Kontextwörtern entstehen Wort-Kontext-Paare. Die folgende Abbildung stammt aus dem Blog von Chris Moody zu lda2vec. In diesem Textausschnitt ist „awesome“ das Pivot-Wort, die umgebenden Wörter dienen als Kontext, woraus 7 Wort-Kontext-Paare entstehen. 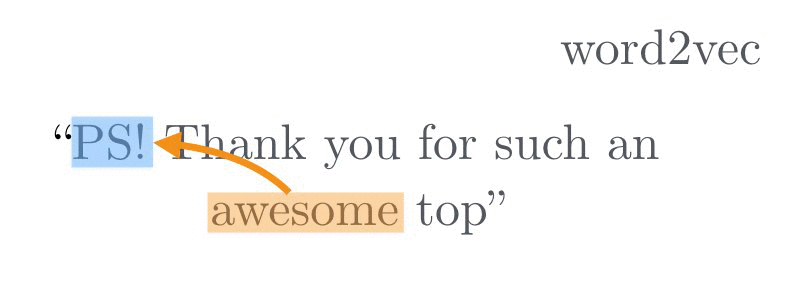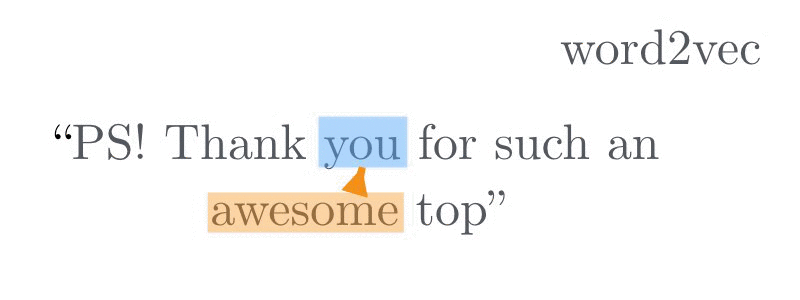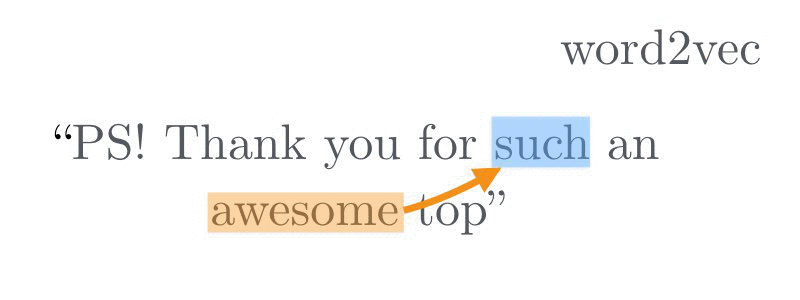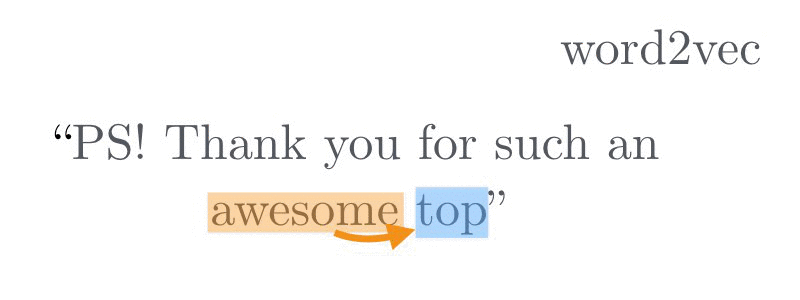
Es gibt zwei Varianten von word2vec: a. In der Continuous-Bag-of-Words-Architektur (CBOW) wird das Pivot-Wort aus den umgebenden Kontextwörtern vorhergesagt (z. B. aus „thank“, „such“, „you“, „top“ das Wort „awesome“). „Bag-of-Words“, weil die Reihenfolge der Kontextwörter egal ist. b. In der Skip-Gram-Architektur sagt das Pivot-Wort die Kontextwörter vorher (z. B. aus „awesome“ werden „thank“, „such“, „you“, „top“ vorhergesagt). Die folgende Abbildung zeigt beide Architekturen. Beachte, dass ein relativ einfaches (zweischichtiges) neuronales Modell verwendet wird (verglichen mit tiefen Netzen in der Bildverarbeitung).
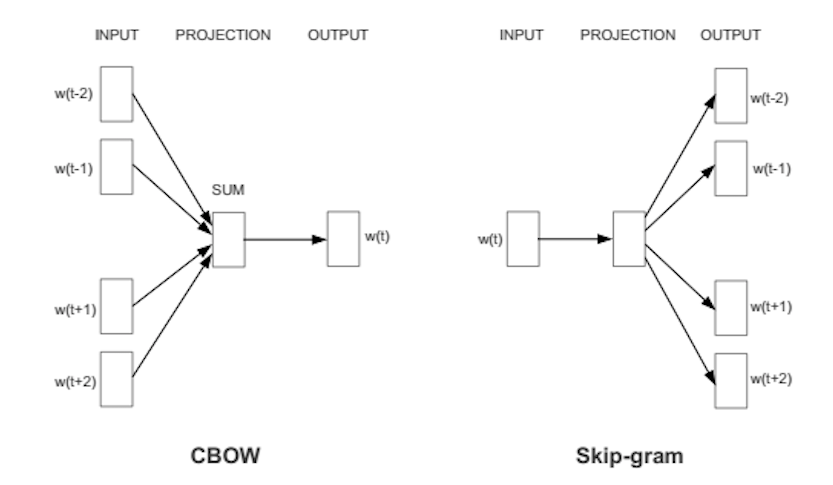
Durch Training auf einem großen Korpus entstehen Wort-Embeddings (die Gewichte in der Projektionsschicht), die semantische Informationen und interessante Eigenschaften kodieren: Vektorarithmetik wie $$king - man + woman = queen$$ ist möglich.
Wortvektoren sind eine nützliche Repräsentation gegenüber etwa One-Hot-Codierung. Sie erlauben, statistische Informationen aus großen Korpora in andere Modelle zu übertragen, z. B. für Themenklassifikation oder Dialogsysteme. Die Vektoren sind oft dicht, hochdimensional und schwer interpretierbar. Beispiel: [ -0.65, -1.223, ..., -0.252, +3.2 ]. Während bei LDA Dimensionen ungefähr Topics entsprechen, ist das bei Wortvektoren typischerweise nicht der Fall. Jedes Wort erhält einen kontextunabhängigen Vektor. Die Bedeutung hängt jedoch stark vom Kontext ab. word2vec lernt Wortvektoren, die Kontextwörter über verschiedene Dokumente hinweg vorhersagen. Dadurch vermischen sich dokumentenspezifische Informationen in den Embeddings.
Inspiriert von LDA erweitert lda2vec word2vec, sodass Wort-, Dokument- und Topic-Vektoren gleichzeitig gelernt werden.
lda2vec entsteht durch eine Modifikation der Skip-Gram-Variante von word2vec. Im ursprünglichen Skip-Gram sagt das Modell Kontextwörter aus einem Pivot-Wort vorher. In lda2vec werden Pivot-Wortvektor und ein Dokumentvektor zu einem Kontextvektor kombiniert. Dieser Kontextvektor dient dann zur Vorhersage der Kontextwörter.
Im nächsten Abschnitt siehst du, wie diese Dokumentvektoren aufgebaut sind und wie sie ähnlich wie bei LDA genutzt werden können.
Die Integration von Kontextvektoren in word2vec ist nicht neu. Paragraph Vectors verfolgen eine ähnliche Idee, um Repräsentationen fester Länge für Textfragmente variabler Länge zu lernen. Für jedes Textfragment (im Umfang eines Absatzes) wird – analog zu Wortvektoren – ein dichter Vektor gelernt.
Der Nachteil: Diese Absatz-/Kontextvektoren ähneln typischen Wortvektoren und sind daher weniger interpretierbar als etwa LDA-Ausgaben.
lda2vec geht einen Schritt weiter, arbeitet mit dokumentgroßen Texten und zerlegt Dokumentvektoren in zwei Komponenten. Analog zu LDA wird ein Dokumentvektor in einen Dokumentgewichtsvektor und eine Topic-Matrix zerlegt. Der Dokumentgewichtsvektor gibt die Anteile der Topics an, die Topic-Matrix enthält die einzelnen Topic-Vektoren. Ein Kontextvektor entsteht also, indem die im Dokument vorkommenden Topic-Vektoren kombiniert werden.
Beispiel: Im ursprünglichen word2vec könnten bei Pivot „French“ die Kontextwörter „German“, „Dutch“, „English“ plausibel sein – ohne globale, dokumentbezogene Information.
Mit einem zusätzlichen Kontextvektor in lda2vec lassen sich bessere Vorhersagen treffen.
Ist der Dokumentvektor eine Kombination aus den Topics „food“ und „drinks“, wären „baguette“, „cheese“ und „wine“ passender. Ist er nahe an den Topics „city“ und „geography“, wären „Paris“, „Lyon“ und „Grenoble“ sinnvoller.
Diese Topic-Vektoren werden im Wortraum gelernt und sind dadurch leicht zu interpretieren: Man betrachtet einfach die Wortvektoren, die den Topic-Vektoren am nächsten liegen. Zusätzlich werden die Dokumentgewichtsvektoren so beschränkt, dass sie spärlich sind (ähnlich wie bei LDA) statt dicht. Das erleichtert die Interpretation der Themeninhalte einzelner Dokumente.
Kurz gesagt: Das Ergebnis von lda2vec sind spärliche Dokumentgewichtsvektoren und gut interpretierbare Topic-Vektoren.
Die Performance ist oft ähnlich zu klassischem LDA. Dank automatischer Differenzierung skaliert die Methode jedoch auf sehr große Datensätze. Außerdem entstehen durch die Kombination aus Kontext- und Wortvektor „spezialisierte“ Wortvektoren, die in anderen Modellen genutzt werden können und unter Umständen „generische“ Embeddings übertreffen.
lda2vec ist eine noch relativ neue, spezialisierte NLP-Technik. Da sie auf bestehenden Methoden aufbaut, lässt sich jede word2vec-Implementierung zu lda2vec erweitern. Chris Moody hat die Methode in Chainer implementiert, aber auch andere Frameworks für automatische Differenzierung eignen sich (CNTK, Theano, …). Eine TensorFlow-Implementierung ist ebenfalls öffentlich verfügbar.
Eine Übersicht zum Python-Modul von lda2vec findest du hier. Da das Training rechenintensiv sein kann, empfiehlt sich für größere Korpora GPU-Unterstützung. Um das Training zu beschleunigen, werden die Wortvektoren oft mit vortrainierten word2vec-Vektoren initialisiert.
Abschließend: Wir haben lda2vec als Topic-Modell betrachtet, aber die Idee, Kontextvektoren zu word2vec hinzuzufügen, lässt sich allgemeiner fassen. Sind Dokumente z. B. von verschiedenen Autorinnen/Autoren aus unterschiedlichen Regionen, könnten Autoren- und Regionsvektoren in den Kontext einfließen – eine unüberwachte Methode, um Dokument-, Regions- und Autorenvektoren zu gewinnen.
Dieser Beitrag bietet einen kompakten Überblick über LDA, word2vec und lda2vec. Der ursprüngliche Autor hat außerdem einen hervorragenden Blogpost zu den technischen Details von lda2vec veröffentlicht.
Erfahre mehr über Machine Learning
Kurs
Kurs
Kurs