想一想收入数据。少数人收入数百万,大多数人在中间区间,分布向右拉出一条长尾。把它与标准钟形曲线对比,怎么都对不上——因为正态分布并不合适。
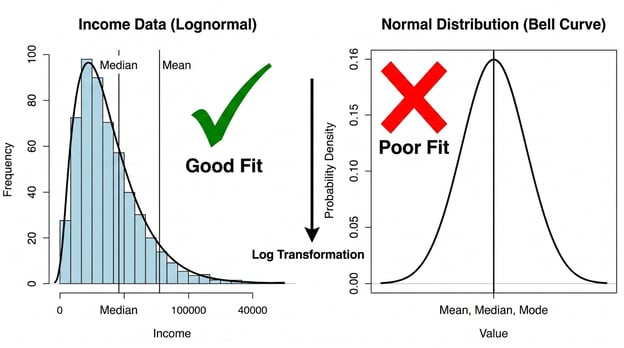
对数正态分布适用于严格为正且右偏的变量,其离散程度会随取值大小而增大。家庭收入、股票价格、文件大小以及生物测量都具有这种特征。
本文将介绍什么是对数正态分布、它与正态分布的比较、关键性质与公式、适用时机,以及如何在真实数据中识别它,并指出一些常见误区。
什么是对数正态分布?
若一个随机变量的自然对数服从正态分布,则该随机变量服从对数正态分布。
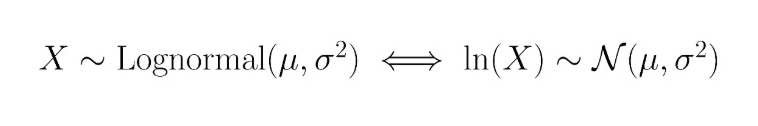
如果 X 服从对数正态分布,则 ln(X) 服从正态分布。名称也由此而来:对数-正态,即其对数是正态分布。
由此立即得到两点。其一,取值始终为正。因为对数只对正数有定义,所以对数正态变量不可能为零或负数。其二,分布右偏。物理下界为零而上界无穷,因此右尾远长于左尾。
连接这两种分布的关键是对数变换。对一个服从对数正态分布的变量,对每个观测取自然对数,结果就是正态分布的数据。这不仅是数学上的奇趣,更使对数正态可操作:一旦将数据变换到对数空间,所有针对正态分布建立的统计工具便可派上用场。
对数正态分布 vs. 正态分布
最直接的区别在形状。正态分布是对称的,均值、中位数与众数重合于中心点。对数正态分布是不对称的,向右偏,右尾很长。其均值、中位数与众数彼此不同。原因我们在下一节解释。
取值范围也不同。正态分布从负无穷延伸到正无穷。对数正态分布以下界零为界,向上无限延伸。当您的变量在物理上不可能为负时,它就是正确的建模选择。
|
性质
|
正态分布
|
对数正态分布
|
|
形状
|
对称的钟形曲线
|
右偏,右尾很长
|
|
对称性
|
对称
|
不对称
|
|
可能取值
|
全体实数(−∞ 到 +∞)
|
严格为正(0 到 +∞)
|
|
均值 = 中位数 = 众数?
|
是
|
否——三者不同
|
|
典型应用
|
身高、考试分数、测量误差
|
收入、股价、文件大小
|
|
变换关系
|
—
|
若 X 为对数正态,则 ln(X) 为正态
|
最后一行在实践中尤为重要。对一个对数正态变量取对数会得到正态分布。正是这一步变换让对数正态变得有用。它不只是对偏态数据的描述,更是与正态世界之间有直接桥梁的模型。
对数正态分布的性质
有几条关键性质使对数正态分布与众不同。
始终为正且具有长右尾
对数正态分布只产生正值。若 ln(X) 为正态,则 X = e^(ln(X)) 始终为正,因为指数恒为正。零是地板,但没有天花板。与右偏结合,这决定了其典型形状:自零急剧上升,在均值左侧某处达到峰值,然后长尾逐渐收敛。
均值、中位数与众数彼此不同
三种中心位置度量反映不同信息。众数(最常见值)最靠左;中位数更高;均值(算术平均)更高,被右尾向上拉动。在收入数据中,家庭收入的均值显著高于中位数。少数超高收入者抬高了平均值,却不改变分布的中间位置。这也是经济学家在描述典型家庭时通常报告中位数收入的原因。此处选错中心度量不仅是统计粗心,更会产生误导。
看到公式时请记住:μ 与 σ 描述的是 ln(X) 的底层正态分布,而非 X 本身的均值和标准差。这个区别常常让人措手不及。
对数正态分布的公式
对数正态分布的概率密度函数(PDF)为:
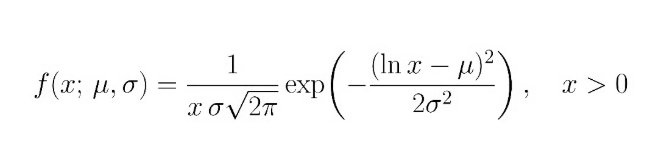
当 x > 0 时,其中:
- x 为随机变量的取值(必须为正)
- μ(mu)是 ln(X) 的均值。它控制分布的位置——μ 增大,峰值右移。
- σ(sigma)是 ln(X) 的标准差。它控制分布的离散程度与偏度。σ 越大,右尾越重。
μ 与 σ 不是 X 本身的均值和标准差,而是 ln(X) 的参数。X 的实际均值为 e(μ + σ²/2),因此位于中位数的右侧。若您在 Python 或 R 中拟合对数正态,库函数会处理这种参数转换,但了解参数真正代表什么很有价值。
何时应使用对数正态分布?
实用判断:如果变量严格为正,且增长过程是乘法性的而非加法性的,对数正态很可能是个好拟合。
加法过程往往产生正态分布。根据中心极限定理,许多小的随机效应之和会收敛到正态。乘法过程不同:当每一期的数值等于上一期数值乘以一个随机因子(复利、细菌倍增),经过多期后结果往往是对数正态。这就是它在金融和生物领域频繁出现的原因。
对数正态适用于如下变量:
- 长期金融收益——日对数收益以乘法方式复合
- 保险理赔——大多数很小,少数极大
- 收入分布——以下界零为界,现实中右偏
- 生物生长——个体大小、细胞计数、浓度测量
- 等待时间——维修时间与服务时长,偶尔出现异常大值
- 环境测量——水或空气中的污染物浓度
如果您不确定对数正态是否合适,我们的 Python 特征工程课程对对数变换有深入讲解,包括如何评估某个变换是否适合您的数据。
对数正态分布的真实案例
对数正态分布在许多真实场景中出现,下面列举其中一些。
收入与财富
收入数据是教科书式的对数正态示例。大多数人收入集中在适中范围,但没有上限——少数人收入比中位数高出几个数量级。绘制原始家庭收入直方图会出现明显右偏;取对数后则大致呈正态。财富数据也有相同模式,且往往偏度更强。
股票价格
日度股价变动在对数意义下近似正态,这意味着价格水平本身随时间服从对数正态分布。Black-Scholes 期权定价模型基于这一假设。股价不可能低于零,以乘法方式复合,并呈现典型的右尾。
互联网文件大小
文件大小跨度巨大,从几 KB 到数十 GB,且分布强烈右偏。对数正态在此拟合良好,因为文件大小以下界零为界并以乘法方式增长。网站流量分析与网络工程对此高度依赖。
生物测量
生物物质的浓度(激素水平、组织中的污染物浓度、微生物计数)往往服从对数正态分布。生物过程常涉及比率与增长率而非加性增量。医学研究中的潜伏期也呈现相同模式。
在上述各领域,逻辑一致:本质上为乘法过程、以下界零为界、且可能产生罕见极端值的量,是对数正态建模的天然候选。
对数正态分布在机器学习与数据科学中的应用
对数正态分布在机器学习中以几种不同方式出现,每种都需要稍有不同的处理。
建模正的连续变量
当目标变量严格为正且右偏——如房价、营收、用户终身价值——在建模前进行对数变换常能显著改善效果。线性回归假设残差服从正态;直接拟合原始的对数正态数据会违背该假设。解决办法:对目标取对数、拟合模型、再将预测值指数还原到原尺度。注意:在对数空间解读系数需要小心,因为自变量增加一个单位,对原尺度意味着乘法性的变化。
用对数变换进行特征工程
在将特征送入对尺度敏感的模型(线性回归、逻辑回归、k-means)前,对右偏特征进行对数变换可降低极端值的影响,并使关系更线性。这是右偏连续特征的标准预处理。该变换也隐式处理异常值:原空间中比中位数大 100 倍的数,在对数空间中大约只高出 4.6 个单位。
概率建模与仿真
一些概率模型会显式使用对数正态分布。在贝叶斯建模中,它常作为必须为正参数的先验。在仿真中,它用于建模如维修时间、理赔金额、网络时延等量,这些场景的乘法结构符合现实过程。实践中经常能见到。
如何识别对数正态分布
光看直方图不够。以下方法更有效,基本按严谨程度递增排列。
直方图与对数变换后的直方图
先画原始数据的直方图。如果它右偏、右尾很长且下界接近零,具有提示性。再画对数变换后数据的直方图。如果该直方图近似对称、呈钟形,那么对数正态是合理模型。这组双图对比快捷,但不要止步于此。
Q-Q 图
分位数-分位数(Q-Q)图将您的数据分位数与理论分布的分位数进行比较。对于对数正态数据,将 ln(X) 的分位数与标准正态的分位数作图。点大致落在一条直线上表示拟合良好。若出现系统性弯曲,尤其在尾部,则说明对数正态并不那么合适。我们的 Q-Q 图教程介绍了在 Python 与 R 中如何阅读和解读它们。
拟合优度检验
正式检验可对对数变换后的数据应用正态性检验(Shapiro-Wilk、Kolmogorov-Smirnov、Anderson-Darling)。如果 ln(X) 通过,您就有支持对数正态模型的统计证据。但对于超大数据集,这些检验会对微小偏差也变得敏感到足以拒绝对数正态性。务必将正式检验与可视化结合使用。
三种方法结合使用,远比单一方法可靠。
处理对数正态数据的常见错误
这里列出从业者常犯的几类错误。
想当然地认为数据服从正态分布
这是最常见的错误。用正态分布去拟合对数正态数据会低估极端值概率、偏倚均值估计,并可能使统计检验不可靠。若您的数据为正且右偏,请先检查再使用正态分布。
误解算术平均数
对数正态数据中,长右尾会将算术平均数显著拉高到中位数之上。将均值作为“典型值”是不准确的。中位数通常更能代表典型观测。请明确说明您报告的是哪一种度量以及原因。
忘记取值必须为正
对数正态分布对零或负值没有定义。如果数据集中包含零——在计数数据或有停滞期的销售数据中很常见——则不能直接应用对数正态。常见权宜之计包括在取对数前加一个很小的常数(统计上并不理想),或使用能单独处理零值的零膨胀模型。
使用不当的统计检验
为正态数据设计的检验(t 检验、标准置信区间、方差分析)不能直接用于对数正态数据。您有两种选择:对数据取对数后使用基于正态的方法,或使用不作形状假设的非参数方法。错误的检验并不总是会产生明显错误的答案,但可能出现难以察觉的偏差。
结论
对数正态分布通过对数变换将正的、右偏的变量与正态分布联系起来。一旦认识到当 X 为对数正态时 ln(X) 为正态,其余问题就顺理成章。您可以在对数空间中使用标准正态工具,再将结果转换回原尺度。
我们已介绍了该分布的关键性质,并追溯到那一步变换,同时考察了它在实践中的出现场景。实用要点很直接:在建模正的、右偏的数据之前,先检查是否为对数正态。绘制对数变换后的数据、进行正态性检验,并查看 Q-Q 图。我们的Python 统计学入门课程与Python 中的概率分布教程,是将这些理念应用到真实数据集的良好下一步。


想一想收入数据。少数人收入数百万,大多数人在中间区间,分布向右拉出一条长尾。把它与标准钟形曲线对比,怎么都对不上——因为正态分布并不合适。
对数正态分布适用于严格为正且右偏的变量,其离散程度会随取值大小而增大。家庭收入、股票价格、文件大小以及生物测量都具有这种特征。
本文将介绍什么是对数正态分布、它与正态分布的比较、关键性质与公式、适用时机,以及如何在真实数据中识别它,并指出一些常见误区。
什么是对数正态分布?
若一个随机变量的自然对数服从正态分布,则该随机变量服从对数正态分布。
如果 X 服从对数正态分布,则 ln(X) 服从正态分布。名称也由此而来:对数-正态,即其对数是正态分布。
由此立即得到两点。其一,取值始终为正。因为对数只对正数有定义,所以对数正态变量不可能为零或负数。其二,分布右偏。物理下界为零而上界无穷,因此右尾远长于左尾。
连接这两种分布的关键是对数变换。对一个服从对数正态分布的变量,对每个观测取自然对数,结果就是正态分布的数据。这不仅是数学上的奇趣,更使对数正态可操作:一旦将数据变换到对数空间,所有针对正态分布建立的统计工具便可派上用场。
对数正态分布 vs. 正态分布
最直接的区别在形状。正态分布是对称的,均值、中位数与众数重合于中心点。对数正态分布是不对称的,向右偏,右尾很长。其均值、中位数与众数彼此不同。原因我们在下一节解释。
取值范围也不同。正态分布从负无穷延伸到正无穷。对数正态分布以下界零为界,向上无限延伸。当您的变量在物理上不可能为负时,它就是正确的建模选择。
性质
正态分布
对数正态分布
形状
对称的钟形曲线
右偏,右尾很长
对称性
对称
不对称
可能取值
全体实数(−∞ 到 +∞)
严格为正(0 到 +∞)
均值 = 中位数 = 众数?
是
否——三者不同
典型应用
身高、考试分数、测量误差
收入、股价、文件大小
变换关系
—
若 X 为对数正态,则 ln(X) 为正态
最后一行在实践中尤为重要。对一个对数正态变量取对数会得到正态分布。正是这一步变换让对数正态变得有用。它不只是对偏态数据的描述,更是与正态世界之间有直接桥梁的模型。
对数正态分布的性质
有几条关键性质使对数正态分布与众不同。
始终为正且具有长右尾
对数正态分布只产生正值。若 ln(X) 为正态,则 X = e^(ln(X)) 始终为正,因为指数恒为正。零是地板,但没有天花板。与右偏结合,这决定了其典型形状:自零急剧上升,在均值左侧某处达到峰值,然后长尾逐渐收敛。
均值、中位数与众数彼此不同
三种中心位置度量反映不同信息。众数(最常见值)最靠左;中位数更高;均值(算术平均)更高,被右尾向上拉动。在收入数据中,家庭收入的均值显著高于中位数。少数超高收入者抬高了平均值,却不改变分布的中间位置。这也是经济学家在描述典型家庭时通常报告中位数收入的原因。此处选错中心度量不仅是统计粗心,更会产生误导。
看到公式时请记住:μ 与 σ 描述的是 ln(X) 的底层正态分布,而非 X 本身的均值和标准差。这个区别常常让人措手不及。
对数正态分布的公式
对数正态分布的概率密度函数(PDF)为:
当 x > 0 时,其中:
μ 与 σ 不是 X 本身的均值和标准差,而是 ln(X) 的参数。X 的实际均值为 e(μ + σ²/2),因此位于中位数的右侧。若您在 Python 或 R 中拟合对数正态,库函数会处理这种参数转换,但了解参数真正代表什么很有价值。
何时应使用对数正态分布?
实用判断:如果变量严格为正,且增长过程是乘法性的而非加法性的,对数正态很可能是个好拟合。
加法过程往往产生正态分布。根据中心极限定理,许多小的随机效应之和会收敛到正态。乘法过程不同:当每一期的数值等于上一期数值乘以一个随机因子(复利、细菌倍增),经过多期后结果往往是对数正态。这就是它在金融和生物领域频繁出现的原因。
对数正态适用于如下变量:
如果您不确定对数正态是否合适,我们的 Python 特征工程课程对对数变换有深入讲解,包括如何评估某个变换是否适合您的数据。
对数正态分布的真实案例
对数正态分布在许多真实场景中出现,下面列举其中一些。
收入与财富
收入数据是教科书式的对数正态示例。大多数人收入集中在适中范围,但没有上限——少数人收入比中位数高出几个数量级。绘制原始家庭收入直方图会出现明显右偏;取对数后则大致呈正态。财富数据也有相同模式,且往往偏度更强。
股票价格
日度股价变动在对数意义下近似正态,这意味着价格水平本身随时间服从对数正态分布。Black-Scholes 期权定价模型基于这一假设。股价不可能低于零,以乘法方式复合,并呈现典型的右尾。
互联网文件大小
文件大小跨度巨大,从几 KB 到数十 GB,且分布强烈右偏。对数正态在此拟合良好,因为文件大小以下界零为界并以乘法方式增长。网站流量分析与网络工程对此高度依赖。
生物测量
生物物质的浓度(激素水平、组织中的污染物浓度、微生物计数)往往服从对数正态分布。生物过程常涉及比率与增长率而非加性增量。医学研究中的潜伏期也呈现相同模式。
在上述各领域,逻辑一致:本质上为乘法过程、以下界零为界、且可能产生罕见极端值的量,是对数正态建模的天然候选。
对数正态分布在机器学习与数据科学中的应用
对数正态分布在机器学习中以几种不同方式出现,每种都需要稍有不同的处理。
建模正的连续变量
当目标变量严格为正且右偏——如房价、营收、用户终身价值——在建模前进行对数变换常能显著改善效果。线性回归假设残差服从正态;直接拟合原始的对数正态数据会违背该假设。解决办法:对目标取对数、拟合模型、再将预测值指数还原到原尺度。注意:在对数空间解读系数需要小心,因为自变量增加一个单位,对原尺度意味着乘法性的变化。
用对数变换进行特征工程
在将特征送入对尺度敏感的模型(线性回归、逻辑回归、k-means)前,对右偏特征进行对数变换可降低极端值的影响,并使关系更线性。这是右偏连续特征的标准预处理。该变换也隐式处理异常值:原空间中比中位数大 100 倍的数,在对数空间中大约只高出 4.6 个单位。
概率建模与仿真
一些概率模型会显式使用对数正态分布。在贝叶斯建模中,它常作为必须为正参数的先验。在仿真中,它用于建模如维修时间、理赔金额、网络时延等量,这些场景的乘法结构符合现实过程。实践中经常能见到。
如何识别对数正态分布
光看直方图不够。以下方法更有效,基本按严谨程度递增排列。
直方图与对数变换后的直方图
先画原始数据的直方图。如果它右偏、右尾很长且下界接近零,具有提示性。再画对数变换后数据的直方图。如果该直方图近似对称、呈钟形,那么对数正态是合理模型。这组双图对比快捷,但不要止步于此。
Q-Q 图
分位数-分位数(Q-Q)图将您的数据分位数与理论分布的分位数进行比较。对于对数正态数据,将 ln(X) 的分位数与标准正态的分位数作图。点大致落在一条直线上表示拟合良好。若出现系统性弯曲,尤其在尾部,则说明对数正态并不那么合适。我们的 Q-Q 图教程介绍了在 Python 与 R 中如何阅读和解读它们。
拟合优度检验
正式检验可对对数变换后的数据应用正态性检验(Shapiro-Wilk、Kolmogorov-Smirnov、Anderson-Darling)。如果 ln(X) 通过,您就有支持对数正态模型的统计证据。但对于超大数据集,这些检验会对微小偏差也变得敏感到足以拒绝对数正态性。务必将正式检验与可视化结合使用。
三种方法结合使用,远比单一方法可靠。
处理对数正态数据的常见错误
这里列出从业者常犯的几类错误。
想当然地认为数据服从正态分布
这是最常见的错误。用正态分布去拟合对数正态数据会低估极端值概率、偏倚均值估计,并可能使统计检验不可靠。若您的数据为正且右偏,请先检查再使用正态分布。
误解算术平均数
对数正态数据中,长右尾会将算术平均数显著拉高到中位数之上。将均值作为“典型值”是不准确的。中位数通常更能代表典型观测。请明确说明您报告的是哪一种度量以及原因。
忘记取值必须为正
对数正态分布对零或负值没有定义。如果数据集中包含零——在计数数据或有停滞期的销售数据中很常见——则不能直接应用对数正态。常见权宜之计包括在取对数前加一个很小的常数(统计上并不理想),或使用能单独处理零值的零膨胀模型。
使用不当的统计检验
为正态数据设计的检验(t 检验、标准置信区间、方差分析)不能直接用于对数正态数据。您有两种选择:对数据取对数后使用基于正态的方法,或使用不作形状假设的非参数方法。错误的检验并不总是会产生明显错误的答案,但可能出现难以察觉的偏差。
结论
对数正态分布通过对数变换将正的、右偏的变量与正态分布联系起来。一旦认识到当 X 为对数正态时 ln(X) 为正态,其余问题就顺理成章。您可以在对数空间中使用标准正态工具,再将结果转换回原尺度。
我们已介绍了该分布的关键性质,并追溯到那一步变换,同时考察了它在实践中的出现场景。实用要点很直接:在建模正的、右偏的数据之前,先检查是否为对数正态。绘制对数变换后的数据、进行正态性检验,并查看 Q-Q 图。我们的Python 统计学入门课程与Python 中的概率分布教程,是将这些理念应用到真实数据集的良好下一步。