Pense em dados de renda. Poucas pessoas ganham milhões, a maioria está em alguma faixa intermediária e a distribuição tem uma cauda longa à direita. Se você comparar com a curva em forma de sino padrão, nada encaixa, porque a distribuição normal não é um bom ajuste.
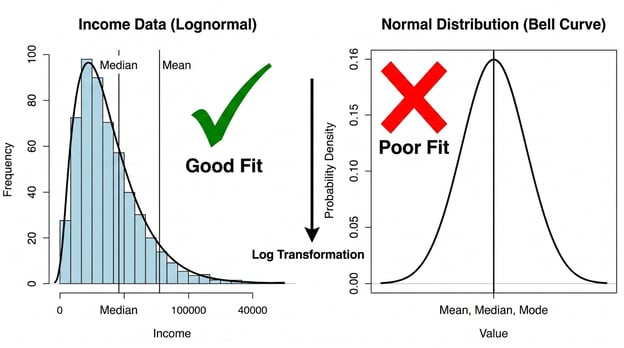
A distribuição lognormal foi feita para variáveis estritamente positivas e assimétricas à direita, nas quais a dispersão cresce com o tamanho do valor. Renda domiciliar, preços de ações, tamanhos de arquivos e medições biológicas costumam se comportar assim.
Aqui, vamos ver o que é a distribuição lognormal, como ela se compara à normal, suas principais propriedades e fórmula, quando usar e como identificá-la em dados reais, incluindo alguns erros comuns.
O que é a distribuição lognormal?
Uma variável aleatória segue uma distribuição lognormal se seu logaritmo natural for normalmente distribuído.
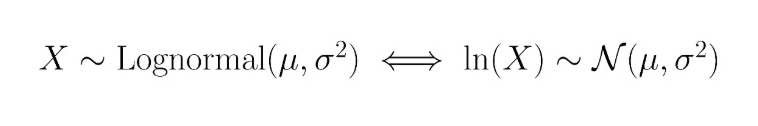
Se X é lognormal, então ln(X) é normal. O nome vem daí: log-normal, uma distribuição cujo log é normal.
Duas coisas decorrem imediatamente. Primeiro, os valores são sempre positivos. Logaritmos só estão definidos para números positivos, então variáveis lognormais nunca podem ser zero ou negativas. Segundo, a distribuição é assimétrica à direita. Há um limite inferior em zero, mas não há limite superior, o que significa que a cauda direita se estende muito mais do que a esquerda.
A transformação logarítmica é a chave que conecta as duas distribuições. Pegue uma variável lognormal, aplique o log natural a cada observação e o resultado são dados normalmente distribuídos. Isso vai além de uma curiosidade matemática: é o que torna a lognormal tratável. Todo o ferramental estatístico construído para a distribuição normal fica disponível depois que você transforma seus dados.
Distribuição lognormal vs. distribuição normal
A diferença mais imediata é o formato. A distribuição normal é simétrica, com média, mediana e moda no mesmo ponto central. A distribuição lognormal é assimétrica, enviesada à direita, com uma longa cauda à direita. A média, a mediana e a moda são todas diferentes. Vamos ver o porquê na próxima seção.
O intervalo de valores possíveis também difere. Uma distribuição normal vai de menos infinito a mais infinito. Uma distribuição lognormal é limitada inferiormente por zero e se estende para cima sem limite. Isso a torna o modelo certo sempre que sua variável simplesmente não pode ser negativa.
|
Propriedade
|
Distribuição normal
|
Distribuição lognormal
|
|
Formato
|
Curva simétrica em forma de sino
|
Assimetria à direita, cauda longa à direita
|
|
Simetria
|
Simétrica
|
Assimétrica
|
|
Valores possíveis
|
Todos os números reais (−∞ a +∞)
|
Estritamente positivos (0 a +∞)
|
|
Média = mediana = moda?
|
Sim
|
Não — as três diferem
|
|
Aplicações típicas
|
Altura, notas de provas, erro de medição
|
Renda, preços de ações, tamanhos de arquivos
|
|
Relação por transformação
|
—
|
Se X é lognormal, ln(X) é normal
|
A última linha é a que mais importa na prática. Tomar o logaritmo de uma variável lognormal produz uma distribuição normal. Essa transformação é o que torna a lognormal útil. Não é só uma descrição de dados enviesados; é um modelo com uma ponte direta de volta ao mundo normal.
Propriedades da distribuição lognormal
Algumas propriedades da distribuição lognormal a tornam especial.
A distribuição lognormal produz apenas valores positivos. Se ln(X) é normal, então X = e^(ln(X)) é sempre positivo, já que exponenciais são sempre positivas. Existe um piso em zero, mas não há teto. Combinada com a assimetria à direita, isso dá à distribuição seu formato característico: uma subida acentuada a partir de zero, um pico à esquerda da média e, depois, uma longa cauda que se afina.
As três medidas de tendência central contam histórias diferentes. A moda (o valor mais frequente) fica mais à esquerda. A mediana (o valor do meio) é maior. A média (a média aritmética) é maior ainda, puxada para cima pela cauda direita. Em dados de renda, a renda média domiciliar é substancialmente maior do que a mediana. Poucos salários muito altos deslocam a média sem mexer no meio da distribuição. Por isso economistas geralmente reportam a renda mediana ao descrever lares típicos. Escolher a medida errada aqui não é só estatística descuidada; é enganoso.
Guarde isso ao ver a fórmula: μ e σ descrevem a distribuição normal subjacente de ln(X), não a média e o desvio-padrão do próprio X. Essa distinção pega muita gente de surpresa.
A fórmula da distribuição lognormal
A função densidade de probabilidade (PDF) da distribuição lognormal é:
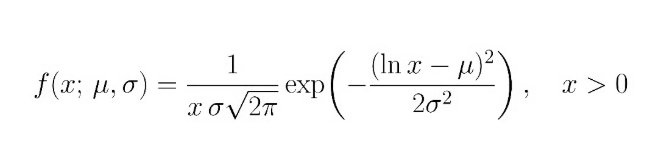
para x > 0, onde:
- x é o valor da variável aleatória (deve ser positivo)
- μ (mi) é a média de ln(X). Ela controla a localização da distribuição — aumentar μ desloca o pico para a direita.
- σ (sigma) é o desvio-padrão de ln(X). Ele controla a dispersão e o grau de assimetria. Um σ maior produz uma cauda direita mais pesada.
μ e σ não são a média e o desvio-padrão de X. Eles são os parâmetros de ln(X). A média de X é e(μ + σ²/2), por isso fica à direita da mediana. Se você ajustar uma lognormal a dados em Python ou R, as bibliotecas fazem essa conversão para você, mas vale saber o que os parâmetros realmente representam.
Quando usar uma distribuição lognormal?
O teste prático: se sua variável é estritamente positiva e o processo de crescimento é multiplicativo, não aditivo, a lognormal provavelmente é um bom ajuste.
Processos aditivos tendem a produzir distribuições normais. Pelo teorema do limite central, somas de muitos pequenos efeitos aleatórios convergem para a normal. Processos multiplicativos são diferentes. Quando o valor de cada período é o valor anterior multiplicado por um fator aleatório (juros compostos, duplicação de bactérias), o resultado ao longo de muitos períodos é lognormal. É por isso que a lognormal aparece tanto em finanças e biologia.
A lognormal se ajusta bem a variáveis como:
- Retornos financeiros em horizontes longos — retornos log diários se compõem multiplicativamente
- Sinistros de seguros — a maioria é pequena; alguns são muito grandes
- Distribuições de renda — limitadas inferiormente por zero, enviesadas à direita na prática
- Crescimento biológico — tamanho de organismos, contagem de células, medições de concentração
- Tempos de espera — tempos de reparo e duração de atendimentos com eventuais outliers
- Medições ambientais — concentrações de poluentes em água ou ar
Se você não tem certeza se a lognormal é adequada, nosso curso Feature Engineering for Machine Learning in Python aprofunda transformações logarítmicas, inclusive como avaliar se uma transformação serve para seus dados.
Exemplos reais de distribuição lognormal
A distribuição lognormal aparece em muitos cenários do mundo real; alguns deles estão destacados abaixo.
Renda e riqueza
Dados de renda são o exemplo clássico de lognormal. A maioria das pessoas tem rendas concentradas em uma faixa moderada, mas não há limite superior — um pequeno número de indivíduos ganha ordens de grandeza acima da mediana. Ao plotar a renda domiciliar bruta, você vê um histograma fortemente enviesado à direita; ao aplicar log, o gráfico fica aproximadamente normal. Dados de riqueza mostram o mesmo padrão, muitas vezes com viés ainda mais acentuado.
Preços de ações
Variações diárias de preços de ações são aproximadamente normais em termos logarítmicos, o que significa que o nível de preços em si segue uma distribuição lognormal ao longo do tempo. Essa suposição fundamenta o modelo de precificação de opções de Black-Scholes. Os preços não podem ficar abaixo de zero, se compõem multiplicativamente e geram aquela cauda direita característica.
Tamanhos de arquivos na internet
Tamanhos de arquivos variam enormemente, de poucos kilobytes a muitos gigabytes, e a distribuição é fortemente enviesada à direita. A lognormal se ajusta bem aqui porque o tamanho do arquivo é limitado por zero e cresce de forma multiplicativa. Análise de tráfego web e engenharia de redes dependem disso.
Medições biológicas
Concentrações de substâncias biológicas (níveis hormonais, concentrações de poluentes em tecidos, contagens microbianas) tendem a seguir distribuições lognormais. Processos biológicos muitas vezes envolvem razões e taxas de crescimento, não incrementos aditivos. Tempos de latência em estudos médicos mostram o mesmo padrão.
Em todas essas áreas, a lógica é a mesma: um processo de natureza multiplicativa, limitado em zero e capaz de produzir valores extremos raros é um candidato natural para modelagem lognormal.
Distribuição lognormal em machine learning e data science
A distribuição lognormal aparece em machine learning de algumas formas distintas, cada uma exigindo um tratamento um pouco diferente.
Modelagem de variáveis contínuas positivas
Quando a variável alvo é estritamente positiva e enviesada à direita — preços de imóveis, receita, valor do ciclo de vida do usuário — aplicar uma transformação log antes de modelar costuma melhorar bastante os resultados. Regressão linear assume resíduos normalmente distribuídos; ajustá-la em dados lognormais brutos viola essa premissa. A solução: faça log do alvo, ajuste o modelo e depois exponencie as previsões de volta para a escala original. Um cuidado: interpretar coeficientes no espaço log requer atenção, já que um aumento unitário em um preditor agora corresponde a uma mudança multiplicativa na escala original.
Transformar em log atributos enviesados antes de alimentá-los a modelos sensíveis à escala (regressão linear, regressão logística, k-means) reduz a influência de valores extremos e torna os relacionamentos mais lineares. Isso é pré-processamento padrão para atributos contínuos enviesados à direita. A transformação também lida, de forma implícita, com outliers: um valor 100 vezes acima da mediana no espaço bruto vira cerca de 4,6 unidades acima da mediana no espaço log.
Modelagem probabilística e simulação
Alguns modelos probabilísticos usam explicitamente a distribuição lognormal. Em modelagem bayesiana, ela é um prior comum para parâmetros que devem ser positivos. Em simulação, modela quantidades como tempos de reparo, valores de sinistros e atrasos de rede, em que a estrutura multiplicativa reflete processos reais. Esses casos aparecem com frequência no trabalho aplicado.
Como identificar uma distribuição lognormal
Só bater o olho em um histograma não basta. Aqui estão abordagens que realmente funcionam, em ordem crescente de rigor.
Comece com um histograma dos dados brutos. Se houver assimetria à direita com cauda longa e limite inferior próximo de zero, isso é sugestivo. Em seguida, plote um histograma dos valores transformados em log. Se esse histograma parecer aproximadamente simétrico e em forma de sino, a lognormal é um modelo plausível. Esse comparativo de dois gráficos é rápido. Mas não pare por aí.
Gráficos Q-Q
Um gráfico quantil-quantil (Q-Q) compara os quantis dos seus dados com os de uma distribuição teórica. Para dados lognormais, plote os quantis de ln(X) contra os quantis de uma normal padrão. Pontos aproximadamente em linha reta indicam bom ajuste. Curvaturas sistemáticas, especialmente nas caudas, sugerem que a lognormal não é a melhor opção. Nosso tutorial sobre Q-Q plots mostra como ler e interpretar esses gráficos em Python e R.
Testes de aderência
Para um teste formal, aplique um teste de normalidade (Shapiro–Wilk, Kolmogorov–Smirnov, Anderson–Darling) aos dados transformados em log. Se ln(X) passar, você tem evidência estatística a favor do modelo lognormal. Em conjuntos de dados muito grandes, porém, esses testes ficam tão sensíveis que rejeitam a lognormalidade por desvios mínimos. Sempre combine testes formais com inspeção visual.
Usar as três abordagens em conjunto dá um retrato bem mais confiável do que qualquer método isolado.
Alguns erros recorrentes cometidos por muitos profissionais estão destacados aqui.
Pressupor que os dados são normais
Este é o erro mais comum. Ajustar uma distribuição normal a dados lognormais subestima a probabilidade de valores extremos, enviesando estimativas da média e tornando testes estatísticos pouco confiáveis. Se seus dados são positivos e enviesados à direita, verifique antes de recorrer à normal.
Em dados lognormais, a média aritmética é puxada bem acima da mediana pela cauda direita. Apresentar a média como “típica” é enganoso. A mediana geralmente é a melhor medida do que é um caso típico. Seja claro sobre qual medida você está reportando e por quê.
Esquecer que os valores devem ser positivos
A distribuição lognormal é indefinida para valores zero ou negativos. Se seu conjunto de dados tem zeros — comum em contagens ou vendas com períodos inativos — a lognormal não se aplica diretamente. Alternativas comuns incluem somar uma constante pequena antes de aplicar log (estatisticamente não é o ideal) ou usar um modelo com inflação de zeros que trate os zeros separadamente.
Aplicar testes estatísticos inadequados
Testes projetados para dados normais (t-testes, intervalos de confiança padrão, ANOVA) não se aplicam diretamente a dados lognormais. Você tem duas opções: fazer log dos dados e aplicar métodos baseados na normal, ou usar métodos não paramétricos que não assumem formato. O teste errado nem sempre dá respostas dramaticamente erradas, mas pode gerar vieses sutis difíceis de detectar.
Conclusão
A distribuição lognormal modela variáveis positivas e enviesadas à direita conectando-as à distribuição normal por meio de uma transformação logarítmica. Ao reconhecer que ln(X) é normal sempre que X é lognormal, o resto se encaixa. Você pode trabalhar no espaço log usando as ferramentas padrão da normal e depois traduzir os resultados de volta para a escala original.
Vimos as principais propriedades da distribuição, relacionando-as a essa transformação, e onde ela aparece na prática. A recomendação é direta: antes de modelar dados positivos e enviesados à direita, verifique a lognormalidade. Plote os dados transformados em log, rode um teste de normalidade neles e veja um gráfico Q-Q. Nosso Introduction to Statistics in Python e o tutorial Probability Distributions in Python são próximos passos ideais para ver essas ideias aplicadas a conjuntos de dados reais.






Pense em dados de renda. Poucas pessoas ganham milhões, a maioria está em alguma faixa intermediária e a distribuição tem uma cauda longa à direita. Se você comparar com a curva em forma de sino padrão, nada encaixa, porque a distribuição normal não é um bom ajuste.
A distribuição lognormal foi feita para variáveis estritamente positivas e assimétricas à direita, nas quais a dispersão cresce com o tamanho do valor. Renda domiciliar, preços de ações, tamanhos de arquivos e medições biológicas costumam se comportar assim.
Aqui, vamos ver o que é a distribuição lognormal, como ela se compara à normal, suas principais propriedades e fórmula, quando usar e como identificá-la em dados reais, incluindo alguns erros comuns.
O que é a distribuição lognormal?
Uma variável aleatória segue uma distribuição lognormal se seu logaritmo natural for normalmente distribuído.
Se X é lognormal, então ln(X) é normal. O nome vem daí: log-normal, uma distribuição cujo log é normal.
Duas coisas decorrem imediatamente. Primeiro, os valores são sempre positivos. Logaritmos só estão definidos para números positivos, então variáveis lognormais nunca podem ser zero ou negativas. Segundo, a distribuição é assimétrica à direita. Há um limite inferior em zero, mas não há limite superior, o que significa que a cauda direita se estende muito mais do que a esquerda.
A transformação logarítmica é a chave que conecta as duas distribuições. Pegue uma variável lognormal, aplique o log natural a cada observação e o resultado são dados normalmente distribuídos. Isso vai além de uma curiosidade matemática: é o que torna a lognormal tratável. Todo o ferramental estatístico construído para a distribuição normal fica disponível depois que você transforma seus dados.
Distribuição lognormal vs. distribuição normal
A diferença mais imediata é o formato. A distribuição normal é simétrica, com média, mediana e moda no mesmo ponto central. A distribuição lognormal é assimétrica, enviesada à direita, com uma longa cauda à direita. A média, a mediana e a moda são todas diferentes. Vamos ver o porquê na próxima seção.
O intervalo de valores possíveis também difere. Uma distribuição normal vai de menos infinito a mais infinito. Uma distribuição lognormal é limitada inferiormente por zero e se estende para cima sem limite. Isso a torna o modelo certo sempre que sua variável simplesmente não pode ser negativa.
Propriedade
Distribuição normal
Distribuição lognormal
Formato
Curva simétrica em forma de sino
Assimetria à direita, cauda longa à direita
Simetria
Simétrica
Assimétrica
Valores possíveis
Todos os números reais (−∞ a +∞)
Estritamente positivos (0 a +∞)
Média = mediana = moda?
Sim
Não — as três diferem
Aplicações típicas
Altura, notas de provas, erro de medição
Renda, preços de ações, tamanhos de arquivos
Relação por transformação
—
Se X é lognormal, ln(X) é normal
A última linha é a que mais importa na prática. Tomar o logaritmo de uma variável lognormal produz uma distribuição normal. Essa transformação é o que torna a lognormal útil. Não é só uma descrição de dados enviesados; é um modelo com uma ponte direta de volta ao mundo normal.
Propriedades da distribuição lognormal
Algumas propriedades da distribuição lognormal a tornam especial.
Sempre positiva, com cauda longa à direita
A distribuição lognormal produz apenas valores positivos. Se ln(X) é normal, então X = e^(ln(X)) é sempre positivo, já que exponenciais são sempre positivas. Existe um piso em zero, mas não há teto. Combinada com a assimetria à direita, isso dá à distribuição seu formato característico: uma subida acentuada a partir de zero, um pico à esquerda da média e, depois, uma longa cauda que se afina.
Média, mediana e moda são diferentes
As três medidas de tendência central contam histórias diferentes. A moda (o valor mais frequente) fica mais à esquerda. A mediana (o valor do meio) é maior. A média (a média aritmética) é maior ainda, puxada para cima pela cauda direita. Em dados de renda, a renda média domiciliar é substancialmente maior do que a mediana. Poucos salários muito altos deslocam a média sem mexer no meio da distribuição. Por isso economistas geralmente reportam a renda mediana ao descrever lares típicos. Escolher a medida errada aqui não é só estatística descuidada; é enganoso.
Guarde isso ao ver a fórmula: μ e σ descrevem a distribuição normal subjacente de ln(X), não a média e o desvio-padrão do próprio X. Essa distinção pega muita gente de surpresa.
A fórmula da distribuição lognormal
A função densidade de probabilidade (PDF) da distribuição lognormal é:
para x > 0, onde:
μ e σ não são a média e o desvio-padrão de X. Eles são os parâmetros de ln(X). A média de X é e(μ + σ²/2), por isso fica à direita da mediana. Se você ajustar uma lognormal a dados em Python ou R, as bibliotecas fazem essa conversão para você, mas vale saber o que os parâmetros realmente representam.
Quando usar uma distribuição lognormal?
O teste prático: se sua variável é estritamente positiva e o processo de crescimento é multiplicativo, não aditivo, a lognormal provavelmente é um bom ajuste.
Processos aditivos tendem a produzir distribuições normais. Pelo teorema do limite central, somas de muitos pequenos efeitos aleatórios convergem para a normal. Processos multiplicativos são diferentes. Quando o valor de cada período é o valor anterior multiplicado por um fator aleatório (juros compostos, duplicação de bactérias), o resultado ao longo de muitos períodos é lognormal. É por isso que a lognormal aparece tanto em finanças e biologia.
A lognormal se ajusta bem a variáveis como:
Se você não tem certeza se a lognormal é adequada, nosso curso Feature Engineering for Machine Learning in Python aprofunda transformações logarítmicas, inclusive como avaliar se uma transformação serve para seus dados.
Exemplos reais de distribuição lognormal
A distribuição lognormal aparece em muitos cenários do mundo real; alguns deles estão destacados abaixo.
Renda e riqueza
Dados de renda são o exemplo clássico de lognormal. A maioria das pessoas tem rendas concentradas em uma faixa moderada, mas não há limite superior — um pequeno número de indivíduos ganha ordens de grandeza acima da mediana. Ao plotar a renda domiciliar bruta, você vê um histograma fortemente enviesado à direita; ao aplicar log, o gráfico fica aproximadamente normal. Dados de riqueza mostram o mesmo padrão, muitas vezes com viés ainda mais acentuado.
Preços de ações
Variações diárias de preços de ações são aproximadamente normais em termos logarítmicos, o que significa que o nível de preços em si segue uma distribuição lognormal ao longo do tempo. Essa suposição fundamenta o modelo de precificação de opções de Black-Scholes. Os preços não podem ficar abaixo de zero, se compõem multiplicativamente e geram aquela cauda direita característica.
Tamanhos de arquivos na internet
Tamanhos de arquivos variam enormemente, de poucos kilobytes a muitos gigabytes, e a distribuição é fortemente enviesada à direita. A lognormal se ajusta bem aqui porque o tamanho do arquivo é limitado por zero e cresce de forma multiplicativa. Análise de tráfego web e engenharia de redes dependem disso.
Medições biológicas
Concentrações de substâncias biológicas (níveis hormonais, concentrações de poluentes em tecidos, contagens microbianas) tendem a seguir distribuições lognormais. Processos biológicos muitas vezes envolvem razões e taxas de crescimento, não incrementos aditivos. Tempos de latência em estudos médicos mostram o mesmo padrão.
Em todas essas áreas, a lógica é a mesma: um processo de natureza multiplicativa, limitado em zero e capaz de produzir valores extremos raros é um candidato natural para modelagem lognormal.
Distribuição lognormal em machine learning e data science
A distribuição lognormal aparece em machine learning de algumas formas distintas, cada uma exigindo um tratamento um pouco diferente.
Modelagem de variáveis contínuas positivas
Quando a variável alvo é estritamente positiva e enviesada à direita — preços de imóveis, receita, valor do ciclo de vida do usuário — aplicar uma transformação log antes de modelar costuma melhorar bastante os resultados. Regressão linear assume resíduos normalmente distribuídos; ajustá-la em dados lognormais brutos viola essa premissa. A solução: faça log do alvo, ajuste o modelo e depois exponencie as previsões de volta para a escala original. Um cuidado: interpretar coeficientes no espaço log requer atenção, já que um aumento unitário em um preditor agora corresponde a uma mudança multiplicativa na escala original.
Engenharia de atributos com transformações log
Transformar em log atributos enviesados antes de alimentá-los a modelos sensíveis à escala (regressão linear, regressão logística, k-means) reduz a influência de valores extremos e torna os relacionamentos mais lineares. Isso é pré-processamento padrão para atributos contínuos enviesados à direita. A transformação também lida, de forma implícita, com outliers: um valor 100 vezes acima da mediana no espaço bruto vira cerca de 4,6 unidades acima da mediana no espaço log.
Modelagem probabilística e simulação
Alguns modelos probabilísticos usam explicitamente a distribuição lognormal. Em modelagem bayesiana, ela é um prior comum para parâmetros que devem ser positivos. Em simulação, modela quantidades como tempos de reparo, valores de sinistros e atrasos de rede, em que a estrutura multiplicativa reflete processos reais. Esses casos aparecem com frequência no trabalho aplicado.
Como identificar uma distribuição lognormal
Só bater o olho em um histograma não basta. Aqui estão abordagens que realmente funcionam, em ordem crescente de rigor.
Histograma e histograma transformado em log
Comece com um histograma dos dados brutos. Se houver assimetria à direita com cauda longa e limite inferior próximo de zero, isso é sugestivo. Em seguida, plote um histograma dos valores transformados em log. Se esse histograma parecer aproximadamente simétrico e em forma de sino, a lognormal é um modelo plausível. Esse comparativo de dois gráficos é rápido. Mas não pare por aí.
Gráficos Q-Q
Um gráfico quantil-quantil (Q-Q) compara os quantis dos seus dados com os de uma distribuição teórica. Para dados lognormais, plote os quantis de ln(X) contra os quantis de uma normal padrão. Pontos aproximadamente em linha reta indicam bom ajuste. Curvaturas sistemáticas, especialmente nas caudas, sugerem que a lognormal não é a melhor opção. Nosso tutorial sobre Q-Q plots mostra como ler e interpretar esses gráficos em Python e R.
Testes de aderência
Para um teste formal, aplique um teste de normalidade (Shapiro–Wilk, Kolmogorov–Smirnov, Anderson–Darling) aos dados transformados em log. Se ln(X) passar, você tem evidência estatística a favor do modelo lognormal. Em conjuntos de dados muito grandes, porém, esses testes ficam tão sensíveis que rejeitam a lognormalidade por desvios mínimos. Sempre combine testes formais com inspeção visual.
Usar as três abordagens em conjunto dá um retrato bem mais confiável do que qualquer método isolado.
Erros comuns ao trabalhar com dados lognormais
Alguns erros recorrentes cometidos por muitos profissionais estão destacados aqui.
Pressupor que os dados são normais
Este é o erro mais comum. Ajustar uma distribuição normal a dados lognormais subestima a probabilidade de valores extremos, enviesando estimativas da média e tornando testes estatísticos pouco confiáveis. Se seus dados são positivos e enviesados à direita, verifique antes de recorrer à normal.
Interpretar a média aritmética de forma inadequada
Em dados lognormais, a média aritmética é puxada bem acima da mediana pela cauda direita. Apresentar a média como “típica” é enganoso. A mediana geralmente é a melhor medida do que é um caso típico. Seja claro sobre qual medida você está reportando e por quê.
Esquecer que os valores devem ser positivos
A distribuição lognormal é indefinida para valores zero ou negativos. Se seu conjunto de dados tem zeros — comum em contagens ou vendas com períodos inativos — a lognormal não se aplica diretamente. Alternativas comuns incluem somar uma constante pequena antes de aplicar log (estatisticamente não é o ideal) ou usar um modelo com inflação de zeros que trate os zeros separadamente.
Aplicar testes estatísticos inadequados
Testes projetados para dados normais (t-testes, intervalos de confiança padrão, ANOVA) não se aplicam diretamente a dados lognormais. Você tem duas opções: fazer log dos dados e aplicar métodos baseados na normal, ou usar métodos não paramétricos que não assumem formato. O teste errado nem sempre dá respostas dramaticamente erradas, mas pode gerar vieses sutis difíceis de detectar.
Conclusão
A distribuição lognormal modela variáveis positivas e enviesadas à direita conectando-as à distribuição normal por meio de uma transformação logarítmica. Ao reconhecer que ln(X) é normal sempre que X é lognormal, o resto se encaixa. Você pode trabalhar no espaço log usando as ferramentas padrão da normal e depois traduzir os resultados de volta para a escala original.
Vimos as principais propriedades da distribuição, relacionando-as a essa transformação, e onde ela aparece na prática. A recomendação é direta: antes de modelar dados positivos e enviesados à direita, verifique a lognormalidade. Plote os dados transformados em log, rode um teste de normalidade neles e veja um gráfico Q-Q. Nosso Introduction to Statistics in Python e o tutorial Probability Distributions in Python são próximos passos ideais para ver essas ideias aplicadas a conjuntos de dados reais.