

Q-Q 图与其他诊断图
如果您熟悉线性模型诊断图,可能知道还有不少方法可用于评估模型拟合。为更好理解 Q-Q 图在展示什么,我们来看看其他一些诊断图。这将帮助我们更清楚地定位 Q-Q 图的作用,以及哪些图可以与之互补。
- 拟合值与残差:该图展示预测值(拟合值)与残差(观测值与预测值之差)之间的关系。
- 残差直方图:展示残差的分布。
- 尺度-位置图:展示残差与拟合值之间的关系。
- 杠杆值与标准化残差:该图突出一个数据点在自变量空间中的“远近”,以及模型对其拟合是好是坏。我们对残差进行标准化,以在一致的尺度上评估其与杠杆值的关系。
- 观测编号与 Cook 距离:该图通过结合杠杆值与残差大小,识别对模型总体影响最大的特定数据点。横轴的观测编号用于标识每个数据点。
- 杠杆值与 Cook 距离:该图比较某点对模型的潜在影响力与其对模型预测的实际总体影响。
我将快速展示如何用 tidyverse 方法创建上述各图。这里的目的不是对“约旦汽车”数据集的每个线性模型诊断都进行解读,而是让您认识这些诊断图,必要时可复用代码,更重要的是,从本文主题出发,帮助您将 Q-Q 图放在其他诊断图的体系中去理解。这样,您就能更好地理解 Q-Q 图展示与未展示的内容、其用途与局限。
fitted_values_vs_residuals <- ggplot(data = car_linear_model, aes(x = .fitted, y = .resid)) +
geom_point(color = '#203147') +
geom_hline(yintercept = 0, linetype = "dashed", color = '#01ef63', size = 1) +
xlab("fitted values") +
ylab("residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Fitted Values vs Residuals")
histogram_of_residuals <- ggplot(data = car_linear_model, aes(x = .resid)) +
geom_histogram(color = '#01ef63') +
xlab("residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Histogram of Residuals")
scale_location <- ggplot(car_linear_model, aes(.fitted, sqrt(abs(.stdresid)))) +
geom_point(color = '#203147', na.rm=TRUE) +
stat_smooth(method="loess", na.rm = TRUE, color = '#01ef63', size = 1, se = FALSE) +
xlab("Fitted Value") +
ylab(expression(sqrt("|Standardized residuals|"))) +
labs(title = "Cars in Jordan") +
labs(subtitle = "Scale-Location")
leverage_vs_standardized_residuals <- ggplot(data = car_linear_model, aes(.hat, .stdresid)) +
geom_point(aes(size = .cooksd), color = '#203147') +
stat_smooth(method="loess", na.rm=TRUE, color = '#01ef63', size = 1) +
xlab("Leverage") +
ylab("Standardized Residuals") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Residuals vs Leverage") +
scale_size_continuous("Cook's Distance", range=c(1,5)) +
theme(legend.title = element_blank()) +
theme(legend.position= "none")
observation_number_vs_cooks_distance <- ggplot(car_linear_model, aes(seq_along(.cooksd), .cooksd)) +
geom_bar(stat="identity", position="identity", color = '#01ef63', size = 1) +
xlab("Obs. Number") +
ylab("Cook's distance") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Cook's distance")
leverage_vs_cooks_distance <- ggplot(car_linear_model, aes(.hat, .cooksd))+geom_point(na.rm=TRUE) +
stat_smooth(method="loess", na.rm=TRUE, color = '#01ef63', size = 1) +
xlab("Leverage hii")+
ylab("Cook's Distance") +
labs(title = "Cars in Jordan") +
labs(subtitle = "Cook's dist vs Leverage hii/(1-hii)") +
geom_abline(slope=seq(0,3,0.5), color = "gray", linetype = "dotdash")
library(patchwork)
fitted_values_vs_residuals + histogram_of_residuals
library(patchwork)
scale_location + leverage_vs_standardized_residuals
library(patchwork)
observation_number_vs_cooks_distance + leverage_vs_cooks_distance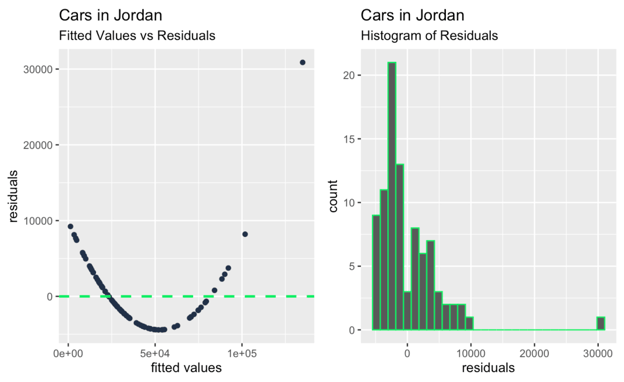
拟合值与残差;残差直方图。作者供图
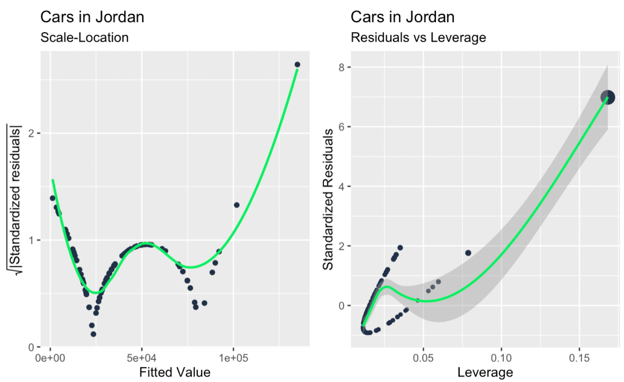
尺度-位置图;杠杆值与标准化残差。作者供图
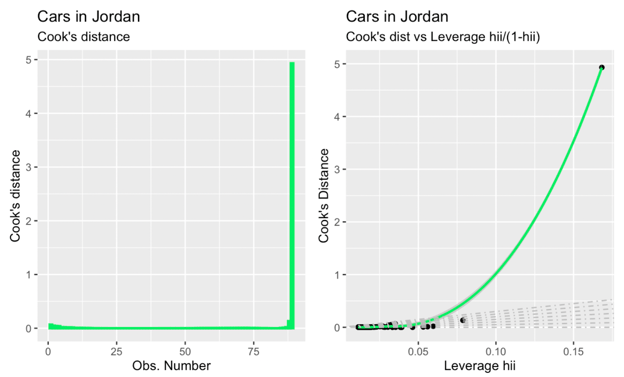
观测编号与 Cook 距离;Cook 距离与杠杆值。作者供图
也许从上面的额外诊断图一眼能看出的关键信息是:存在一两个较大的离群点,对回归线的斜率产生了显著影响,而仅看 Q-Q 图并不那么明显。因此,在我们的示例中,Q-Q 图很好地完成了其职责——检验残差正态性——同时也揭示了它的局限:它并不涉及独立性、同方差性或离群点。
作为补充参考,我在此给出一张高层次的表格,展示每种诊断图对应检验的线性模型假设,并建议 Q-Q 图如何与其他诊断图配合使用。请记住,根据数据不同,不同诊断图可能揭示不同的模式,某些结论也可能需要结合多种图才能看出。例如,Q-Q 图可能确认正态性,而尺度-位置图可能识别出异方差性;只有同时使用两者,您才能同时看到正态性与异方差性。
| 诊断图类型 | 有助于检验 | 与 Q-Q 图的配合方式 |
|---|---|---|
| Q-Q 图 | 残差正态性 | |
| 残差直方图 | 残差正态性 | 提供快速可视化,感知对称性与离散程度。 |
| 拟合值与残差 | 线性性、误差独立 | 揭示模式与非线性,补充 Q-Q 图的正态性检验。 |
| 尺度-位置图 | 同方差性 | 突出残差扩散的一致性,补充 Q-Q 图的正态检验。 |
| 杠杆值与残差图 | 误差独立 | 聚焦高杠杆点,这是 Q-Q 图未涉及的。 |
| 观测编号与 Cook 距离 | 识别高影响点 | 通过定位高影响离群点来补充 Q-Q 图。 |
| 杠杆值与 Cook 距离图 | 识别高杠杆点 | 高亮影响性观测,而 Q-Q 图用于验证正态性。 |
结语
希望您对 Q-Q 图这一评估正态性的有用工具有了新的认识,并更加理解其在评估线性回归残差正态性方面的常见用法。同时也希望您对线性模型诊断这一整体思路与重要性有新的体会。
继续学习线性回归,请参阅我们的Multiple Linear Regression in R: Tutorial With Examples,其中涵盖包含多个自变量的更复杂模型,包括回归中的多重共线性等内容。我也强烈建议您加入我们完整而系统的职业路径 Machine Learning Scientist in Python,全面学习模型构建流程,包括监督学习与无监督学习。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
Q-Q 图常见问题
什么是 Q-Q 图?
Q-Q 图(分位数-分位数图)是一种可视化工具,用于将数据集的分布与某个理论分布(如正态分布)进行比较。
Q-Q 图与正态 Q-Q 图是同一个概念吗?
正态 Q-Q 图是 Q-Q 图的一种形式,用于将一个数据集与具有特定参数的正态分布进行比较,以评估数据集是否服从正态分布。因此,所有正态 Q-Q 图都是 Q-Q 图,但并非所有 Q-Q 图都是正态 Q-Q 图。
线性回归模型广泛用于统计与机器学习中,基于输入特征预测数值,同时也用于理解变量之间的关系。然而,仅仅因为您能在数据上拟合一条直线,并不意味着就该使用它。我们还需要诊断拟合质量,以判断模型是否适合数据,或者是否需要改进。
检验模型的方法有多种,包括采用训练/测试流程评估模型,以及查看诸如调整后的 R²之类的统计量。本文将重点介绍如何创建并解读一种特定的诊断图——Q-Q 图,并展示在 R 语言中生成该图的几种方法。若想系统掌握回归技术,可根据您的熟悉程度,选择学习 Introduction to Regression in R 或 Intermediate Regression in R;如果使用 Python,可选择 Introduction to Regression in Python 或 Intermediate Regression in Python。
什么是 Q-Q 图?
Q-Q(Quantile-Quantile)图用于检查数据集是否遵循某个特定的理论分布。它通过比较观测数据的分位数与该分布的分位数来实现。我之所以说“理论分布”是为了精确,但在实际中,我们制作 Q-Q 图时往往特指正态(高斯)分布,并称之为正态 Q-Q 图。不过,Q-Q 图也可用于将数据与其他分布进行比较,例如指数分布、均匀分布、卡方分布、t 分布、泊松分布等,具体取决于情境。
借助示例更容易理解。这里我创建了 10 个数。要构造一个正态 Q-Q 图,首先将这些数从小到大排序。然后用公式 q = (i– 0.5)/n 计算概率。接着,我可以使用标准正态分布的分位点函数(PPF,对应 R 中的
qnorm()函数)为该秩找到相应的数值。(您可能更熟悉累积分布函数 CDF,它给出小于等于某个 x 的概率。PPF 则相反:它根据给定概率返回相应的 x 值。)最后,为绘制图形,我们将观测值的分位数与理论分位数作图(这也是 Q-Q 图名字里两个 Q 的来历)。参考线通过分别计算观测分布与理论分布的一、三四分位数来得到斜率和截距。
示意性 Q-Q 图。作者供图
为什么使用 Q-Q 图?
Q-Q 图是一种直观检查分布假设的好方法。还有其他检验数据是否服从正态分布的方法,例如 Shapiro-Wilk 检验,但在我看来,没有哪种方式像 Q-Q 图这样直观,把问题讲得这么清楚。
了解某个量的分布在多个方面都很重要。比如,我们可能想知道合适的集中趋势与离散程度度量。此外,在创建线性回归时,我们尤其想知道因变量是否服从正态分布;同时,我们也希望查看模型残差是否近似正态分布,以便对估计更有信心。 基本而言,我认为 Q-Q 图有两大用途:将我们的数据与样本分布比较,以及检验正态性。
如何在 R 中创建 Q-Q 图
下面看看如何在 R 中创建 Q-Q 图。本节我将介绍三种方法:base R、
car包和 tidyverse 方法。您会发现我更偏好 tidyverse,因为它能让图形更美观,也更易与其他包扩展。对每种方法,我都会在简单线性回归的残差上绘制 Q-Q 图——这是 Q-Q 图最常见的用法之一(甚至是最常见的)。当然,您也可以在建立线性回归之前,为变量绘制 Q-Q 图来检查其分布。所需的只是某个变量的分布,以及要用来比较的理论分布。
如果您想跟着练习,可以下载我使用的 Kaggle 数据集:Car Prices Jordan 2023。
在 base R 中创建 Q-Q 图
首先用 base R 创建 Q-Q 图,也就是说不安装额外包,仅使用内置函数。
使用 car 包创建 Q-Q 图
接下来试试用
car包创建 Q-Q 图。就我看来,可视化质量差别不大,但这种 Q-Q 图的优势在于会显示置信包络,它定义了在正态性假设成立时,数据点预计落入的区域。使用 ggplot2 创建 Q-Q 图
现在看看如何用 tidyverse 方法创建 Q-Q 图,以获得更高的灵活性和更佳的美观度。这一次,我会把 Q-Q 图作为面板放在原始散点图旁边。
在 ggplot2 中创建的线性回归与残差 Q-Q 图。作者供图
Q-Q 图能告诉我们什么
在 Q-Q 图中,观测数据的分位数与理论分位数相对应作图。如果数据与理论分布十分接近,点将沿对角直线分布。偏离直线表示与期望分布有差异。点落在直线上方或下方暗示偏度或离群值,而如曲线或 S 形等模式表明存在系统性差异,比如更重或更轻的尾部。
我们主要关注三点:
下面分别用示例展示:
三个 Q-Q 图:一个为直线;一个为曲线;一个呈重尾。作者供图
第一种情况下,Q-Q 线与数据点吻合,说明分布确为正态。第二种情况下出现弯曲,说明数据非正态或存在偏斜。最后一种情况下呈现类似“S”形,说明分布具有重尾或更极端的取值。
线性回归中的 Q-Q 图
线性模型有几项常见假设,包括线性性(变量关系为线性), 误差独立(误差之间不相关), 同方差性(残差方差应保持恒定),以及残差正态性(残差服从正态分布)。Q-Q 图尤其有助于检验第四项假设,即残差正态性。
以下说明不同模式对模型解读与可靠性的影响:
直线对齐
弯曲模式
重尾或轻尾