Pensez aux revenus. Quelques personnes gagnent des millions, la plupart se situent au milieu, et la distribution présente une longue traîne vers la droite. Si vous comparez cela à une courbe en cloche standard, rien ne correspond : la loi normale n’est pas adaptée.
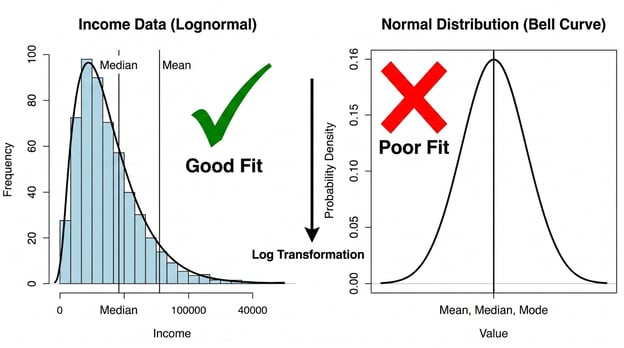
La distribution log-normale est conçue pour des variables strictement positives et asymétriques à droite, dont la dispersion augmente avec la valeur. Le revenu des ménages, les cours boursiers, la taille des fichiers ou encore de nombreuses mesures biologiques se comportent ainsi.
Nous verrons ce qu’est la distribution log-normale, comment elle se compare à la loi normale, ses propriétés et sa formule, quand l’utiliser, et comment la repérer dans les données réelles, en évitant les erreurs courantes.
Qu’est-ce que la distribution log-normale ?
Une variable aléatoire suit une distribution log-normale si son logarithme naturel suit une loi normale.
Si X est log-normale, alors ln(X) est normale. Le nom vient directement de là : log-normale, une distribution dont le log est normal.
Deux conséquences immédiates. D’abord, les valeurs sont toujours positives. Les logarithmes ne sont définis que pour les nombres positifs, donc une variable log-normale ne peut jamais être nulle ni négative. Ensuite, la distribution est asymétrique à droite. Il existe une borne inférieure à zéro, mais aucune borne supérieure, d’où une longue traîne à droite.
La transformation logarithmique est le pont entre les deux distributions. Prenez une variable log-normale, appliquez le log naturel à chaque observation : le résultat suit une loi normale. Ce n’est pas qu’une curiosité mathématique : c’est ce qui rend la log-normale exploitable. Toute la boîte à outils statistique de la loi normale devient disponible après transformation.
Distribution log-normale vs loi normale
La première différence est la forme. La loi normale est symétrique, avec moyenne, médiane et mode confondus au centre. La log-normale est asymétrique, étirée vers la droite, avec une longue traîne. La moyenne, la médiane et le mode diffèrent : nous verrons pourquoi dans la section suivante.
Le domaine des valeurs possibles diffère aussi. Une loi normale s’étend de moins l’infini à plus l’infini. Une log-normale est bornée inférieurement par zéro et s’étend sans limite vers le haut. C’est le bon modèle lorsque votre variable ne peut pas être négative physiquement.
|
Propriété
|
Loi normale
|
Distribution log-normale
|
|
Forme
|
Courbe en cloche symétrique
|
Asymétrique à droite, longue traîne droite
|
|
Symétrie
|
Symétrique
|
Asymétrique
|
|
Valeurs possibles
|
Tous les réels (−∞ à +∞)
|
Strictement positives (0 à +∞)
|
|
Moyenne = médiane = mode ?
|
Oui
|
Non : les trois diffèrent
|
|
Applications typiques
|
Taille, notes d’examen, erreur de mesure
|
Revenus, cours boursiers, tailles de fichiers
|
|
Lien par transformation
|
—
|
Si X est log-normale, ln(X) est normale
|
La dernière ligne est la plus importante en pratique. Le logarithme d’une variable log-normale suit une loi normale. Cette transformation rend la log-normale utile : ce n’est pas qu’une description de données asymétriques, c’est un modèle relié directement au monde normal.
Propriétés de la distribution log-normale
Quelques propriétés clés font la spécificité d’une log-normale.
Toujours positive avec une longue traîne droite
La log-normale ne génère que des valeurs positives. Si ln(X) est normale, alors X = e^(ln(X)) est toujours positif, car l’exponentielle est positive. Il existe un plancher à zéro, mais pas de plafond. Combinée à l’asymétrie à droite, cette contrainte donne sa forme caractéristique : montée abrupte depuis zéro, pic situé à gauche de la moyenne, puis longue traîne décroissante.
Moyenne, médiane et mode sont différents
Les trois mesures de tendance centrale racontent des choses différentes. Le mode (la valeur la plus fréquente) est le plus à gauche. La médiane est plus élevée. La moyenne est encore plus élevée, tirée vers le haut par la traîne droite. Pour les revenus, la moyenne des ménages dépasse nettement la médiane : quelques très hauts revenus font grimper la moyenne sans toucher au milieu de la distribution. C’est pourquoi les économistes privilégient la médiane pour décrire un ménage « typique ». Choisir la mauvaise mesure n’est pas un simple faux pas statistique : c’est trompeur.
Gardez-le en tête pour la formule : μ et σ décrivent la loi normale sous-jacente de ln(X), pas la moyenne et l’écart type de X lui-même. Cette distinction en surprend plus d’un.
La fonction de densité de probabilité (PDF) de la log-normale est :

pour x > 0, où :
- x est la valeur de la variable aléatoire (doit être positive)
- μ (mu) est la moyenne de ln(X). Elle contrôle la position de la distribution : augmenter μ décale le pic vers la droite.
- σ (sigma) est l’écart type de ln(X). Il contrôle la dispersion et le degré d’asymétrie. Un σ plus grand produit une traîne droite plus lourde.
μ et σ ne sont pas la moyenne et l’écart type de X. Ce sont les paramètres de ln(X). La moyenne de X vaut e(μ + σ²/2), d’où sa position à droite de la médiane. Si vous ajustez une log-normale dans Python ou R, les fonctions de bibliothèque gèrent cette conversion, mais il est utile de savoir ce que représentent réellement les paramètres.
Quand utiliser une distribution log-normale ?
Le test pratique : si votre variable est strictement positive et que la croissance est multiplicative (et non additive), la log-normale est souvent un bon choix.
Les processus additifs tendent à produire des lois normales. Par le théorème central limite, des sommes de nombreux petits effets aléatoires convergent vers la normale. Les processus multiplicatifs sont différents : lorsque chaque période multiplie la valeur précédente par un facteur aléatoire (intérêts composés, division bactérienne), le résultat sur de nombreuses périodes est log-normale. C’est pourquoi on la rencontre si souvent en finance et en biologie.
La log-normale convient à des variables telles que :
- Rendements financiers sur de longs horizons : les rendements logarithmiques quotidiens se composent par multiplication
- Sinistres d’assurance : la plupart sont modestes, quelques-uns sont très élevés
- Distributions de revenus : bornées inférieurement par zéro, asymétriques à droite en pratique
- Croissance biologique : taille d’organismes, comptages cellulaires, mesures de concentration
- Temps d’attente : durées de réparation ou de service avec valeurs extrêmes occasionnelles
- Mesures environnementales : concentrations de polluants dans l’eau ou l’air
En cas de doute sur la pertinence de la log-normale, notre cours Feature Engineering for Machine Learning in Python détaille les transformations logarithmiques et comment évaluer leur adéquation à vos données.
Exemples concrets de distribution log-normale
La distribution log-normale apparaît dans de nombreux contextes réels, dont quelques exemples ci-dessous.
Revenus et patrimoine
Les revenus constituent l’exemple classique. La plupart des individus se concentrent dans une plage modérée, sans borne supérieure : une minorité gagne des montants bien supérieurs à la médiane. L’histogramme des revenus bruts est fortement asymétrique à droite ; en prenant le log, on obtient une forme approximativement normale. Le patrimoine suit la même logique, souvent avec une asymétrie encore plus marquée.
Cours boursiers
Les variations quotidiennes des cours sont approximativement normales en termes logarithmiques, ce qui implique que le niveau de prix suit une log-normale dans le temps. Cette hypothèse sous-tend le modèle d’options de Black‑Scholes. Les prix ne peuvent pas être négatifs, ils se composent par multiplication et génèrent cette traîne droite caractéristique.
Tailles de fichiers internet
Les tailles de fichiers s’étendent de quelques kilo-octets à plusieurs gigaoctets, avec une forte asymétrie à droite. La log-normale convient bien : la taille est bornée par zéro et croît de façon multiplicative. L’analyse du trafic web et l’ingénierie réseau s’appuient sur ce modèle.
Mesures biologiques
Les concentrations de substances biologiques (taux hormonaux, polluants dans les tissus, comptages microbiens) tendent à suivre des distributions log-normales. Les processus biologiques impliquent souvent des ratios et des taux de croissance plutôt que des incréments additifs. Les temps de latence dans les études médicales montrent le même schéma.
Dans chacun de ces domaines, la logique est identique : un processus de nature multiplicative, borné à zéro et capable de produire des valeurs extrêmes rares est un candidat naturel pour la modélisation log-normale.
Distribution log-normale en apprentissage automatique et science des données
La distribution log-normale intervient en apprentissage automatique de plusieurs manières, nécessitant chacune une approche spécifique.
Modélisation de variables continues positives
Lorsqu’une variable cible est strictement positive et asymétrique à droite (prix de l’immobilier, revenus, valeur vie client), appliquer une transformation logarithmique avant la modélisation améliore souvent considérablement les résultats. La régression linéaire suppose des résidus normalement distribués ; l’ajuster sur des données log-normales brutes viole cette hypothèse. La solution : loguez la cible, ajustez le modèle, puis exponentiez les prédictions pour revenir à l’échelle d’origine. Attention : l’interprétation des coefficients dans l’espace logarithmique demande de la prudence, car une augmentation unitaire d’un prédicteur correspond désormais à un changement multiplicatif à l’échelle d’origine.
Loguer des caractéristiques asymétriques avant de les injecter dans des modèles sensibles à l’échelle (régression linéaire, logistique, k-means) réduit l’influence des valeurs extrêmes et linéarise les relations. C’est un prétraitement standard pour les caractéristiques continues asymétriques à droite. La transformation gère aussi implicitement les valeurs aberrantes : une valeur 100 fois supérieure à la médiane dans l’espace brut devient environ 4,6 unités au-dessus de la médiane dans l’espace logarithmique.
Modélisation probabiliste et simulation
Certains modèles probabilistes utilisent explicitement la distribution log-normale. En modélisation bayésienne, c’est une loi a priori courante pour les paramètres devant être positifs. En simulation, elle modélise des quantités comme les temps de réparation, les montants de sinistres ou les délais réseau, où la structure multiplicative correspond aux processus réels.
Observer un histogramme ne suffit pas. Voici les approches rigoureuses, par ordre croissant de précision.
Commencez par un histogramme des données brutes. S’il est asymétrique à droite avec une longue traîne et une borne inférieure proche de zéro, c’est suggestif. Tracez ensuite l’histogramme des valeurs log-transformées. S’il semble approximativement symétrique et en cloche, la log-normale est un modèle plausible. Cette comparaison est rapide, mais ne vous arrêtez pas là.
Graphiques Q-Q
Un graphique quantile-quantile (Q-Q plot) compare les quantiles de vos données à ceux d’une distribution théorique. Pour des données log-normales, tracez les quantiles de ln(X) contre ceux d’une loi normale standard. Si les points s’alignent approximativement sur une droite, l’ajustement est bon. Une courbure systématique, surtout dans les queues, suggère que la log-normale n’est pas adaptée. Notre tutoriel sur les Q-Q plots explique comment les interpréter en Python et R.
Tests de qualité d’ajustement
Pour un test formel, appliquez un test de normalité (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) aux données log-transformées. Si ln(X) réussit le test, vous avez une preuve statistique soutenant le modèle log-normal. Avec de très grands jeux de données, ces tests deviennent toutefois si sensibles qu’ils peuvent rejeter la log-normalité pour des écarts négligeables. Couplez toujours les tests formels à une inspection visuelle.
L’utilisation combinée de ces trois approches offre une image bien plus fiable que n’importe quelle méthode isolée.
Erreurs courantes avec les données log-normales
Quelques erreurs fréquentes sont à éviter.
Supposer que les données suivent une loi normale
C’est l’erreur la plus courante. Ajuster une loi normale sur des données log-normales sous-estime la probabilité des valeurs extrêmes, biaise les estimations de la moyenne et rend les tests statistiques peu fiables. Si vos données sont positives et asymétriques à droite, vérifiez avant de choisir la loi normale.
Interpréter incorrectement la moyenne arithmétique
Pour des données log-normales, la moyenne arithmétique est tirée bien au-dessus de la médiane par la traîne droite. Présenter la moyenne comme « typique » est trompeur. La médiane est généralement une meilleure mesure de l’observation typique. Soyez clair sur la mesure que vous rapportez et pourquoi.
Oublier que les valeurs doivent être positives
La distribution log-normale n’est pas définie pour zéro ou les valeurs négatives. Si votre jeu de données contient des zéros (fréquent dans les données de comptage ou de ventes avec des périodes d’inactivité), la log-normale n’est pas directement applicable. Les solutions courantes incluent l’ajout d’une petite constante avant le log (pas idéal statistiquement) ou l’utilisation d’un modèle « zero-inflated » qui traite les zéros séparément.
Appliquer des tests statistiques inappropriés
Les tests conçus pour des données normales (tests t, intervalles de confiance standards, ANOVA) ne s’appliquent pas directement aux données log-normales. Deux options : loguez les données et appliquez des méthodes basées sur la normale, ou utilisez des méthodes non paramétriques sans hypothèse de forme. Le mauvais test ne produira pas toujours des résultats aberrants, mais peut générer des biais subtils difficiles à détecter.
Conclusion
La distribution log-normale modélise des variables positives et asymétriques à droite en les reliant à la loi normale par une transformation logarithmique. Une fois compris que ln(X) est normale si X est log-normale, tout devient logique. Vous pouvez travailler dans l’espace logarithmique avec des outils normaux standards, puis traduire les résultats à l’échelle d’origine.
Nous avons couvert les propriétés clés, leur origine dans cette transformation et leurs applications pratiques. Le conseil pratique est simple : avant de modéliser des données positives et asymétriques à droite, vérifiez la log-normalité. Tracez les données log-transformées, effectuez un test de normalité et examinez un Q-Q plot. Notre cours Introduction to Statistics in Python et notre tutoriel Probability Distributions in Python sont d’excellentes prochaines étapes pour voir ces idées appliquées à des jeux de données réels.





Pensez aux revenus. Quelques personnes gagnent des millions, la plupart se situent au milieu, et la distribution présente une longue traîne vers la droite. Si vous comparez cela à une courbe en cloche standard, rien ne correspond : la loi normale n’est pas adaptée.
La distribution log-normale est conçue pour des variables strictement positives et asymétriques à droite, dont la dispersion augmente avec la valeur. Le revenu des ménages, les cours boursiers, la taille des fichiers ou encore de nombreuses mesures biologiques se comportent ainsi.
Nous verrons ce qu’est la distribution log-normale, comment elle se compare à la loi normale, ses propriétés et sa formule, quand l’utiliser, et comment la repérer dans les données réelles, en évitant les erreurs courantes.
Qu’est-ce que la distribution log-normale ?
Une variable aléatoire suit une distribution log-normale si son logarithme naturel suit une loi normale.
Si X est log-normale, alors ln(X) est normale. Le nom vient directement de là : log-normale, une distribution dont le log est normal.
Deux conséquences immédiates. D’abord, les valeurs sont toujours positives. Les logarithmes ne sont définis que pour les nombres positifs, donc une variable log-normale ne peut jamais être nulle ni négative. Ensuite, la distribution est asymétrique à droite. Il existe une borne inférieure à zéro, mais aucune borne supérieure, d’où une longue traîne à droite.
La transformation logarithmique est le pont entre les deux distributions. Prenez une variable log-normale, appliquez le log naturel à chaque observation : le résultat suit une loi normale. Ce n’est pas qu’une curiosité mathématique : c’est ce qui rend la log-normale exploitable. Toute la boîte à outils statistique de la loi normale devient disponible après transformation.
Distribution log-normale vs loi normale
La première différence est la forme. La loi normale est symétrique, avec moyenne, médiane et mode confondus au centre. La log-normale est asymétrique, étirée vers la droite, avec une longue traîne. La moyenne, la médiane et le mode diffèrent : nous verrons pourquoi dans la section suivante.
Le domaine des valeurs possibles diffère aussi. Une loi normale s’étend de moins l’infini à plus l’infini. Une log-normale est bornée inférieurement par zéro et s’étend sans limite vers le haut. C’est le bon modèle lorsque votre variable ne peut pas être négative physiquement.
Propriété
Loi normale
Distribution log-normale
Forme
Courbe en cloche symétrique
Asymétrique à droite, longue traîne droite
Symétrie
Symétrique
Asymétrique
Valeurs possibles
Tous les réels (−∞ à +∞)
Strictement positives (0 à +∞)
Moyenne = médiane = mode ?
Oui
Non : les trois diffèrent
Applications typiques
Taille, notes d’examen, erreur de mesure
Revenus, cours boursiers, tailles de fichiers
Lien par transformation
—
Si X est log-normale, ln(X) est normale
La dernière ligne est la plus importante en pratique. Le logarithme d’une variable log-normale suit une loi normale. Cette transformation rend la log-normale utile : ce n’est pas qu’une description de données asymétriques, c’est un modèle relié directement au monde normal.
Propriétés de la distribution log-normale
Quelques propriétés clés font la spécificité d’une log-normale.
Toujours positive avec une longue traîne droite
La log-normale ne génère que des valeurs positives. Si ln(X) est normale, alors X = e^(ln(X)) est toujours positif, car l’exponentielle est positive. Il existe un plancher à zéro, mais pas de plafond. Combinée à l’asymétrie à droite, cette contrainte donne sa forme caractéristique : montée abrupte depuis zéro, pic situé à gauche de la moyenne, puis longue traîne décroissante.
Moyenne, médiane et mode sont différents
Les trois mesures de tendance centrale racontent des choses différentes. Le mode (la valeur la plus fréquente) est le plus à gauche. La médiane est plus élevée. La moyenne est encore plus élevée, tirée vers le haut par la traîne droite. Pour les revenus, la moyenne des ménages dépasse nettement la médiane : quelques très hauts revenus font grimper la moyenne sans toucher au milieu de la distribution. C’est pourquoi les économistes privilégient la médiane pour décrire un ménage « typique ». Choisir la mauvaise mesure n’est pas un simple faux pas statistique : c’est trompeur.
Gardez-le en tête pour la formule : μ et σ décrivent la loi normale sous-jacente de ln(X), pas la moyenne et l’écart type de X lui-même. Cette distinction en surprend plus d’un.
La formule de la distribution log-normale
La fonction de densité de probabilité (PDF) de la log-normale est :
pour x > 0, où :
μ et σ ne sont pas la moyenne et l’écart type de X. Ce sont les paramètres de ln(X). La moyenne de X vaut e(μ + σ²/2), d’où sa position à droite de la médiane. Si vous ajustez une log-normale dans Python ou R, les fonctions de bibliothèque gèrent cette conversion, mais il est utile de savoir ce que représentent réellement les paramètres.
Quand utiliser une distribution log-normale ?
Le test pratique : si votre variable est strictement positive et que la croissance est multiplicative (et non additive), la log-normale est souvent un bon choix.
Les processus additifs tendent à produire des lois normales. Par le théorème central limite, des sommes de nombreux petits effets aléatoires convergent vers la normale. Les processus multiplicatifs sont différents : lorsque chaque période multiplie la valeur précédente par un facteur aléatoire (intérêts composés, division bactérienne), le résultat sur de nombreuses périodes est log-normale. C’est pourquoi on la rencontre si souvent en finance et en biologie.
La log-normale convient à des variables telles que :
En cas de doute sur la pertinence de la log-normale, notre cours Feature Engineering for Machine Learning in Python détaille les transformations logarithmiques et comment évaluer leur adéquation à vos données.
Exemples concrets de distribution log-normale
La distribution log-normale apparaît dans de nombreux contextes réels, dont quelques exemples ci-dessous.
Revenus et patrimoine
Les revenus constituent l’exemple classique. La plupart des individus se concentrent dans une plage modérée, sans borne supérieure : une minorité gagne des montants bien supérieurs à la médiane. L’histogramme des revenus bruts est fortement asymétrique à droite ; en prenant le log, on obtient une forme approximativement normale. Le patrimoine suit la même logique, souvent avec une asymétrie encore plus marquée.
Cours boursiers
Les variations quotidiennes des cours sont approximativement normales en termes logarithmiques, ce qui implique que le niveau de prix suit une log-normale dans le temps. Cette hypothèse sous-tend le modèle d’options de Black‑Scholes. Les prix ne peuvent pas être négatifs, ils se composent par multiplication et génèrent cette traîne droite caractéristique.
Tailles de fichiers internet
Les tailles de fichiers s’étendent de quelques kilo-octets à plusieurs gigaoctets, avec une forte asymétrie à droite. La log-normale convient bien : la taille est bornée par zéro et croît de façon multiplicative. L’analyse du trafic web et l’ingénierie réseau s’appuient sur ce modèle.
Mesures biologiques
Les concentrations de substances biologiques (taux hormonaux, polluants dans les tissus, comptages microbiens) tendent à suivre des distributions log-normales. Les processus biologiques impliquent souvent des ratios et des taux de croissance plutôt que des incréments additifs. Les temps de latence dans les études médicales montrent le même schéma.
Dans chacun de ces domaines, la logique est identique : un processus de nature multiplicative, borné à zéro et capable de produire des valeurs extrêmes rares est un candidat naturel pour la modélisation log-normale.
Distribution log-normale en apprentissage automatique et science des données
La distribution log-normale intervient en apprentissage automatique de plusieurs manières, nécessitant chacune une approche spécifique.
Modélisation de variables continues positives
Lorsqu’une variable cible est strictement positive et asymétrique à droite (prix de l’immobilier, revenus, valeur vie client), appliquer une transformation logarithmique avant la modélisation améliore souvent considérablement les résultats. La régression linéaire suppose des résidus normalement distribués ; l’ajuster sur des données log-normales brutes viole cette hypothèse. La solution : loguez la cible, ajustez le modèle, puis exponentiez les prédictions pour revenir à l’échelle d’origine. Attention : l’interprétation des coefficients dans l’espace logarithmique demande de la prudence, car une augmentation unitaire d’un prédicteur correspond désormais à un changement multiplicatif à l’échelle d’origine.
Ingénierie des caractéristiques avec transformations logarithmiques
Loguer des caractéristiques asymétriques avant de les injecter dans des modèles sensibles à l’échelle (régression linéaire, logistique, k-means) réduit l’influence des valeurs extrêmes et linéarise les relations. C’est un prétraitement standard pour les caractéristiques continues asymétriques à droite. La transformation gère aussi implicitement les valeurs aberrantes : une valeur 100 fois supérieure à la médiane dans l’espace brut devient environ 4,6 unités au-dessus de la médiane dans l’espace logarithmique.
Modélisation probabiliste et simulation
Certains modèles probabilistes utilisent explicitement la distribution log-normale. En modélisation bayésienne, c’est une loi a priori courante pour les paramètres devant être positifs. En simulation, elle modélise des quantités comme les temps de réparation, les montants de sinistres ou les délais réseau, où la structure multiplicative correspond aux processus réels.
Comment identifier une distribution log-normale
Observer un histogramme ne suffit pas. Voici les approches rigoureuses, par ordre croissant de précision.
Histogramme et histogramme transformé
Commencez par un histogramme des données brutes. S’il est asymétrique à droite avec une longue traîne et une borne inférieure proche de zéro, c’est suggestif. Tracez ensuite l’histogramme des valeurs log-transformées. S’il semble approximativement symétrique et en cloche, la log-normale est un modèle plausible. Cette comparaison est rapide, mais ne vous arrêtez pas là.
Graphiques Q-Q
Un graphique quantile-quantile (Q-Q plot) compare les quantiles de vos données à ceux d’une distribution théorique. Pour des données log-normales, tracez les quantiles de ln(X) contre ceux d’une loi normale standard. Si les points s’alignent approximativement sur une droite, l’ajustement est bon. Une courbure systématique, surtout dans les queues, suggère que la log-normale n’est pas adaptée. Notre tutoriel sur les Q-Q plots explique comment les interpréter en Python et R.
Tests de qualité d’ajustement
Pour un test formel, appliquez un test de normalité (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) aux données log-transformées. Si ln(X) réussit le test, vous avez une preuve statistique soutenant le modèle log-normal. Avec de très grands jeux de données, ces tests deviennent toutefois si sensibles qu’ils peuvent rejeter la log-normalité pour des écarts négligeables. Couplez toujours les tests formels à une inspection visuelle.
L’utilisation combinée de ces trois approches offre une image bien plus fiable que n’importe quelle méthode isolée.
Erreurs courantes avec les données log-normales
Quelques erreurs fréquentes sont à éviter.
Supposer que les données suivent une loi normale
C’est l’erreur la plus courante. Ajuster une loi normale sur des données log-normales sous-estime la probabilité des valeurs extrêmes, biaise les estimations de la moyenne et rend les tests statistiques peu fiables. Si vos données sont positives et asymétriques à droite, vérifiez avant de choisir la loi normale.
Interpréter incorrectement la moyenne arithmétique
Pour des données log-normales, la moyenne arithmétique est tirée bien au-dessus de la médiane par la traîne droite. Présenter la moyenne comme « typique » est trompeur. La médiane est généralement une meilleure mesure de l’observation typique. Soyez clair sur la mesure que vous rapportez et pourquoi.
Oublier que les valeurs doivent être positives
La distribution log-normale n’est pas définie pour zéro ou les valeurs négatives. Si votre jeu de données contient des zéros (fréquent dans les données de comptage ou de ventes avec des périodes d’inactivité), la log-normale n’est pas directement applicable. Les solutions courantes incluent l’ajout d’une petite constante avant le log (pas idéal statistiquement) ou l’utilisation d’un modèle « zero-inflated » qui traite les zéros séparément.
Appliquer des tests statistiques inappropriés
Les tests conçus pour des données normales (tests t, intervalles de confiance standards, ANOVA) ne s’appliquent pas directement aux données log-normales. Deux options : loguez les données et appliquez des méthodes basées sur la normale, ou utilisez des méthodes non paramétriques sans hypothèse de forme. Le mauvais test ne produira pas toujours des résultats aberrants, mais peut générer des biais subtils difficiles à détecter.
Conclusion
La distribution log-normale modélise des variables positives et asymétriques à droite en les reliant à la loi normale par une transformation logarithmique. Une fois compris que ln(X) est normale si X est log-normale, tout devient logique. Vous pouvez travailler dans l’espace logarithmique avec des outils normaux standards, puis traduire les résultats à l’échelle d’origine.
Nous avons couvert les propriétés clés, leur origine dans cette transformation et leurs applications pratiques. Le conseil pratique est simple : avant de modéliser des données positives et asymétriques à droite, vérifiez la log-normalité. Tracez les données log-transformées, effectuez un test de normalité et examinez un Q-Q plot. Notre cours Introduction to Statistics in Python et notre tutoriel Probability Distributions in Python sont d’excellentes prochaines étapes pour voir ces idées appliquées à des jeux de données réels.