Piensa en los datos de ingresos. Unas pocas personas ganan millones, la mayoría se sitúa en valores intermedios y la distribución tiene una larga cola hacia la derecha. Si lo comparas con una campana normal, no encaja: la distribución normal no es un buen ajuste.
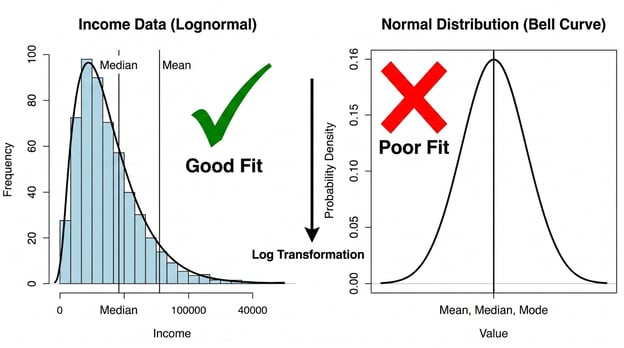
La distribución lognormal está pensada para variables estrictamente positivas y sesgadas a la derecha, donde la dispersión crece con el tamaño del valor. Ingresos de los hogares, precios de acciones, tamaños de archivos y muchas medidas biológicas se comportan así.
Veremos qué es la distribución lognormal, cómo se compara con la normal, sus propiedades clave y su fórmula, cuándo usarla y cómo detectarla en datos reales, incluyendo errores habituales.
¿Qué es la distribución lognormal?
Una variable aleatoria sigue una distribución lognormal si su logaritmo natural está distribuido normalmente.
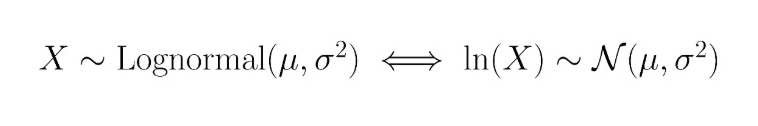
Si X es lognormal, entonces ln(X) es normal. El nombre viene de ahí: log-normal, una distribución cuyo logaritmo es normal.
De aquí se siguen dos cosas. Primero, los valores son siempre positivos. Los logaritmos solo están definidos para números positivos, así que una variable lognormal nunca puede ser cero ni negativa. Segundo, la distribución está sesgada a la derecha. Hay un límite inferior físico en cero pero no hay límite superior, por lo que la cola derecha se extiende mucho más que la izquierda.
La transformación logarítmica es la clave que conecta ambas distribuciones. Toma una variable lognormal, aplica el logaritmo natural a cada observación y obtendrás datos normalmente distribuidos. No es solo una curiosidad matemática: es lo que hace tratable a la lognormal. Todo el aparato estadístico construido para la normal pasa a estar disponible una vez que transformas tus datos.
Distribución lognormal vs. distribución normal
La diferencia más inmediata es la forma. La distribución normal es simétrica, con la media, la mediana y la moda coincidiendo en el centro. La distribución lognormal es asimétrica, sesgada a la derecha, con una cola larga. La media, la mediana y la moda difieren. Veremos por qué en la siguiente sección.
También cambia el rango de valores posibles. Una normal se extiende de menos infinito a más infinito. Una lognormal está acotada inferiormente por cero y hacia arriba no tiene límite. Es el modelo adecuado siempre que tu variable no pueda ser negativa por construcción.
|
Propiedad
|
Distribución normal
|
Distribución lognormal
|
|
Forma
|
Curva de campana simétrica
|
Sesgo a la derecha, cola derecha larga
|
|
Simetría
|
Simétrica
|
Asimétrica
|
|
Valores posibles
|
Todos los reales (−∞ a +∞)
|
Estríctamente positivos (0 a +∞)
|
|
¿Media = mediana = moda?
|
Sí
|
No: las tres difieren
|
|
Aplicaciones típicas
|
Altura, notas de test, error de medida
|
Ingresos, precios de acciones, tamaños de archivos
|
|
Relación por transformación
|
—
|
Si X es lognormal, ln(X) es normal
|
Esa última fila es la más importante en la práctica. Tomar el logaritmo de una variable lognormal produce una normal. Esta transformación es lo que hace útil a la lognormal. No solo describe datos sesgados, es un modelo con un puente directo de vuelta al mundo normal.
Propiedades de la distribución lognormal
Hay un par de propiedades clave de la lognormal que la hacen especial.
Siempre positiva y con cola derecha larga
La distribución lognormal solo produce valores positivos. Si ln(X) es normal, entonces X = e^(ln(X)) siempre es positiva, ya que las exponenciales son siempre positivas. Hay un suelo en cero, pero no techo. Combinado con el sesgo a la derecha, esto da su forma característica: subida pronunciada desde cero, un pico a la izquierda de la media y luego una cola que se atenúa lentamente.
Cada medida de centralidad cuenta algo distinto. La moda (el valor más frecuente) está más a la izquierda. La mediana (el valor central) es mayor. La media (promedio aritmético) es aún mayor, arrastrada por la cola derecha. En ingresos, la media del hogar es sustancialmente superior a la mediana. Unos pocos con rentas muy altas elevan la media sin cambiar el punto medio de la distribución. Por eso en economía se suele informar la mediana para describir a los hogares típicos. Elegir mal la medida no es solo una torpeza estadística: induce a error.
Tenlo presente cuando lleguemos a la fórmula: μ y σ describen la distribución normal subyacente de ln(X), no la media y desviación estándar de X. Esa distinción pilla a muchos por sorpresa.
La fórmula de la distribución lognormal
La función de densidad de probabilidad (PDF) de la lognormal es:
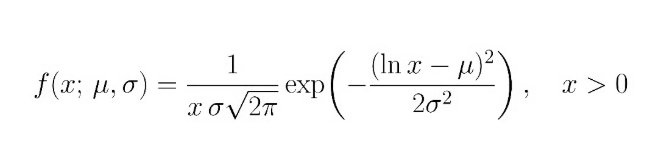
para x > 0, donde:
- x es el valor de la variable aleatoria (debe ser positivo)
- μ (mu) es la media de ln(X). Controla la localización de la distribución: aumentar μ desplaza el pico hacia la derecha.
- σ (sigma) es la desviación estándar de ln(X). Controla la dispersión y el grado de asimetría. Un σ mayor produce una cola derecha más pesada.
μ y σ no son la media y la desviación estándar de X. Son los parámetros de ln(X). La media real de X es e(μ + σ²/2), por eso queda a la derecha de la mediana. Si ajustas una lognormal a datos en Python o R, las librerías hacen esta conversión por ti, pero conviene saber qué representan los parámetros.
¿Cuándo deberías usar una distribución lognormal?
La prueba práctica: si tu variable es estrictamente positiva y el proceso de crecimiento es multiplicativo más que aditivo, la lognormal probablemente encaje bien.
Los procesos aditivos tienden a producir normales. Por el teorema central del límite, sumas de muchos pequeños efectos aleatorios convergen a normal. Los procesos multiplicativos son diferentes. Cuando cada periodo es el valor anterior multiplicado por un factor aleatorio (interés compuesto, duplicación bacteriana), el resultado a lo largo del tiempo es lognormal. Por eso aparece tan a menudo en finanzas y biología.
La lognormal se ajusta a variables como:
- Rentabilidades financieras a largo plazo: los rendimientos logarítmicos diarios se componen de forma multiplicativa
- Siniestros de seguros: la mayoría son pequeños; unos pocos muy grandes
- Distribuciones de ingresos: acotadas por debajo en cero y, en la práctica, sesgadas a la derecha
- Crecimiento biológico: tamaño de organismos, recuentos celulares, mediciones de concentración
- Tiempos de espera: reparaciones y servicios con valores atípicos ocasionales
- Mediciones ambientales: concentraciones de contaminantes en agua o aire
Si no tienes claro si la lognormal es adecuada, nuestro curso Feature Engineering for Machine Learning in Python cubre en detalle las transformaciones logarítmicas, incluido cómo evaluar si una transformación se ajusta a tus datos.
Ejemplos reales de la distribución lognormal
La distribución lognormal aparece en multitud de situaciones reales; a continuación destacamos algunas.
Ingresos y riqueza
Los ingresos son el ejemplo de libro. La mayoría se concentra en un rango moderado, pero no hay límite superior: un pequeño número gana órdenes de magnitud más que la mediana. Si dibujas los ingresos familiares en bruto obtendrás un histograma fuertemente sesgado a la derecha; si tomas el logaritmo, tendrá un aspecto aproximadamente normal. La riqueza muestra el mismo patrón, a menudo con un sesgo aún mayor.
Precios de las acciones
Los cambios diarios de precio son aproximadamente normales en términos logarítmicos, lo que implica que el nivel de precios sigue con el tiempo una distribución lognormal. Esta suposición sustenta el modelo de valoración de opciones de Black–Scholes. Los precios no pueden ser negativos, se componen de forma multiplicativa y generan esa cola derecha característica.
Tamaños de archivos en Internet
Los tamaños de archivo abarcan un rango enorme, de unos kilobytes a muchos gigabytes, y la distribución está muy sesgada a la derecha. La lognormal encaja bien porque el tamaño está acotado por cero y crece de forma multiplicativa. El análisis de tráfico web y la ingeniería de redes dependen de ello.
Mediciones biológicas
Las concentraciones de sustancias biológicas (niveles hormonales, contaminantes en tejidos, recuentos microbianos) tienden a seguir distribuciones lognormales. Muchos procesos biológicos implican razones y tasas de crecimiento más que incrementos aditivos. Los tiempos de latencia en estudios médicos muestran el mismo patrón.
En todos estos ámbitos, la lógica es la misma: un proceso de naturaleza multiplicativa, acotado en cero y capaz de generar valores extremos poco frecuentes es un buen candidato para modelado lognormal.
Distribución lognormal en machine learning y ciencia de datos
La distribución lognormal aparece en machine learning de varias formas, cada una con un tratamiento ligeramente distinto.
Modelado de variables continuas positivas
Cuando la variable objetivo es estrictamente positiva y está sesgada a la derecha —precios de viviendas, ingresos, valor de vida del usuario—, aplicar una transformación logarítmica antes de modelar suele mejorar mucho los resultados. La regresión lineal asume residuos normales; ajustarla a datos lognormales en bruto viola esa suposición. La solución: aplicar log al objetivo, ajustar el modelo y luego reexpresar las predicciones al original mediante la exponencial. Ojo: interpretar coeficientes en el espacio log requiere cuidado, porque un aumento unitario del predictor implica un cambio multiplicativo en la escala original.
Transformar con log características sesgadas antes de usarlas en modelos sensibles a la escala (regresión lineal, logística, k-means) reduce la influencia de valores extremos y linealiza relaciones. Es un preprocesado estándar para continuas sesgadas a la derecha. La transformación también amortigua atípicos: un valor 100 veces la mediana en bruto pasa a estar a unas 4,6 unidades por encima de la mediana en el espacio log.
Modelado probabilístico y simulación
Algunos modelos probabilísticos usan explícitamente la lognormal. En Bayes, es una previa habitual para parámetros que deben ser positivos. En simulación, modela cantidades como tiempos de reparación, importes de siniestros y latencias de red donde la estructura multiplicativa refleja procesos reales. Es común en trabajos aplicados.
Cómo identificar una distribución lognormal
Mirar un histograma no basta. Aquí tienes enfoques que sí funcionan, en orden aproximadamente creciente de rigor.
Empieza con un histograma de los datos en bruto. Si está sesgado a la derecha, con cola larga y un límite inferior cerca de cero, es indicio. Luego dibuja el histograma de los valores transformados con log. Si parece aproximadamente simétrico y con forma de campana, la lognormal es un modelo plausible. Esta comparación rápida de dos gráficos es útil. Pero no te quedes ahí.
Gráficos Q-Q
Un gráfico cuantíl-cuantíl (Q-Q) compara los cuantiles de tus datos con los de una distribución teórica. Para datos lognormales, representa los cuantiles de ln(X) frente a los de una normal estándar. Si los puntos caen aproximadamente en una línea recta, el ajuste es bueno. Curvaturas sistemáticas, sobre todo en las colas, sugieren que la lognormal no encaja del todo. Nuestro tutorial sobre Q-Q plots explica cómo leerlos e interpretarlos en Python y R.
Pruebas de bondad de ajuste
Para una prueba formal, aplica un test de normalidad (Shapiro–Wilk, Kolmogórov–Smirnov, Anderson–Darling) a los datos transformados con log. Si ln(X) pasa, tienes evidencia estadística a favor del modelo lognormal. Con conjuntos muy grandes, estos tests son tan sensibles que pueden rechazar por desviaciones triviales. Acompaña siempre las pruebas formales con inspección visual.
Usar los tres enfoques a la vez da una imagen mucho más fiable que cualquiera por separado.
Errores comunes al trabajar con datos lognormales
Estos son algunos fallos frecuentes que comete mucha gente.
Suponer que los datos son normales
Es el error más común. Ajustar una normal a datos lognormales subestima la probabilidad de valores extremos, sesga la media y puede volver poco fiables las pruebas estadísticas. Si tus datos son positivos y están sesgados a la derecha, compruébalo antes de recurrir a la normal.
En datos lognormales, la media aritmética queda muy por encima de la mediana por culpa de la cola derecha. Presentar la media como "típica" induce a error. La mediana suele ser mejor indicador de lo que es una observación típica. Deja claro qué medida informas y por qué.
Olvidar que los valores deben ser positivos
La lognormal no está definida para ceros o negativos. Si tu conjunto contiene ceros —habitual en datos de conteo o ventas con periodos inactivos—, la lognormal no aplica directamente. Dos apaños comunes son sumar una constante pequeña antes de hacer log (estadísticamente no ideal) o usar un modelo con inflación de ceros que los trate por separado.
Aplicar pruebas estadísticas inapropiadas
Pruebas diseñadas para datos normales (t de Student, intervalos de confianza estándar, ANOVA) no se aplican directamente a datos lognormales. Tienes dos opciones: transformar con log y aplicar métodos basados en la normal, o usar métodos no paramétricos que no asumen forma. La prueba equivocada no siempre dará respuestas catastróficas, pero puede producir sesgos sutiles difíciles de detectar.
Conclusión
La distribución lognormal modela variables positivas y sesgadas a la derecha conectándolas con la normal mediante una transformación logarítmica. Una vez reconoces que ln(X) es normal cuando X es lognormal, todo encaja. Puedes trabajar en el espacio log con las herramientas estándar de la normal y luego volver a la escala original.
Hemos cubierto sus propiedades clave, las hemos vinculado a esa transformación y hemos visto dónde aparece en la práctica. La idea práctica es clara: antes de modelar datos positivos y sesgados a la derecha, comprueba si son lognormales. Representa los datos transformados con log, ejecuta una prueba de normalidad y mira un gráfico Q-Q. Nuestro Introduction to Statistics in Python y el tutorial Probability Distributions in Python son buenos siguientes pasos si quieres ver estas ideas aplicadas a datos reales.





Piensa en los datos de ingresos. Unas pocas personas ganan millones, la mayoría se sitúa en valores intermedios y la distribución tiene una larga cola hacia la derecha. Si lo comparas con una campana normal, no encaja: la distribución normal no es un buen ajuste.
La distribución lognormal está pensada para variables estrictamente positivas y sesgadas a la derecha, donde la dispersión crece con el tamaño del valor. Ingresos de los hogares, precios de acciones, tamaños de archivos y muchas medidas biológicas se comportan así.
Veremos qué es la distribución lognormal, cómo se compara con la normal, sus propiedades clave y su fórmula, cuándo usarla y cómo detectarla en datos reales, incluyendo errores habituales.
¿Qué es la distribución lognormal?
Una variable aleatoria sigue una distribución lognormal si su logaritmo natural está distribuido normalmente.
Si X es lognormal, entonces ln(X) es normal. El nombre viene de ahí: log-normal, una distribución cuyo logaritmo es normal.
De aquí se siguen dos cosas. Primero, los valores son siempre positivos. Los logaritmos solo están definidos para números positivos, así que una variable lognormal nunca puede ser cero ni negativa. Segundo, la distribución está sesgada a la derecha. Hay un límite inferior físico en cero pero no hay límite superior, por lo que la cola derecha se extiende mucho más que la izquierda.
La transformación logarítmica es la clave que conecta ambas distribuciones. Toma una variable lognormal, aplica el logaritmo natural a cada observación y obtendrás datos normalmente distribuidos. No es solo una curiosidad matemática: es lo que hace tratable a la lognormal. Todo el aparato estadístico construido para la normal pasa a estar disponible una vez que transformas tus datos.
Distribución lognormal vs. distribución normal
La diferencia más inmediata es la forma. La distribución normal es simétrica, con la media, la mediana y la moda coincidiendo en el centro. La distribución lognormal es asimétrica, sesgada a la derecha, con una cola larga. La media, la mediana y la moda difieren. Veremos por qué en la siguiente sección.
También cambia el rango de valores posibles. Una normal se extiende de menos infinito a más infinito. Una lognormal está acotada inferiormente por cero y hacia arriba no tiene límite. Es el modelo adecuado siempre que tu variable no pueda ser negativa por construcción.
Propiedad
Distribución normal
Distribución lognormal
Forma
Curva de campana simétrica
Sesgo a la derecha, cola derecha larga
Simetría
Simétrica
Asimétrica
Valores posibles
Todos los reales (−∞ a +∞)
Estríctamente positivos (0 a +∞)
¿Media = mediana = moda?
Sí
No: las tres difieren
Aplicaciones típicas
Altura, notas de test, error de medida
Ingresos, precios de acciones, tamaños de archivos
Relación por transformación
—
Si X es lognormal, ln(X) es normal
Esa última fila es la más importante en la práctica. Tomar el logaritmo de una variable lognormal produce una normal. Esta transformación es lo que hace útil a la lognormal. No solo describe datos sesgados, es un modelo con un puente directo de vuelta al mundo normal.
Propiedades de la distribución lognormal
Hay un par de propiedades clave de la lognormal que la hacen especial.
Siempre positiva y con cola derecha larga
La distribución lognormal solo produce valores positivos. Si ln(X) es normal, entonces X = e^(ln(X)) siempre es positiva, ya que las exponenciales son siempre positivas. Hay un suelo en cero, pero no techo. Combinado con el sesgo a la derecha, esto da su forma característica: subida pronunciada desde cero, un pico a la izquierda de la media y luego una cola que se atenúa lentamente.
La media, la mediana y la moda no coinciden
Cada medida de centralidad cuenta algo distinto. La moda (el valor más frecuente) está más a la izquierda. La mediana (el valor central) es mayor. La media (promedio aritmético) es aún mayor, arrastrada por la cola derecha. En ingresos, la media del hogar es sustancialmente superior a la mediana. Unos pocos con rentas muy altas elevan la media sin cambiar el punto medio de la distribución. Por eso en economía se suele informar la mediana para describir a los hogares típicos. Elegir mal la medida no es solo una torpeza estadística: induce a error.
Tenlo presente cuando lleguemos a la fórmula: μ y σ describen la distribución normal subyacente de ln(X), no la media y desviación estándar de X. Esa distinción pilla a muchos por sorpresa.
La fórmula de la distribución lognormal
La función de densidad de probabilidad (PDF) de la lognormal es:
para x > 0, donde:
μ y σ no son la media y la desviación estándar de X. Son los parámetros de ln(X). La media real de X es e(μ + σ²/2), por eso queda a la derecha de la mediana. Si ajustas una lognormal a datos en Python o R, las librerías hacen esta conversión por ti, pero conviene saber qué representan los parámetros.
¿Cuándo deberías usar una distribución lognormal?
La prueba práctica: si tu variable es estrictamente positiva y el proceso de crecimiento es multiplicativo más que aditivo, la lognormal probablemente encaje bien.
Los procesos aditivos tienden a producir normales. Por el teorema central del límite, sumas de muchos pequeños efectos aleatorios convergen a normal. Los procesos multiplicativos son diferentes. Cuando cada periodo es el valor anterior multiplicado por un factor aleatorio (interés compuesto, duplicación bacteriana), el resultado a lo largo del tiempo es lognormal. Por eso aparece tan a menudo en finanzas y biología.
La lognormal se ajusta a variables como:
Si no tienes claro si la lognormal es adecuada, nuestro curso Feature Engineering for Machine Learning in Python cubre en detalle las transformaciones logarítmicas, incluido cómo evaluar si una transformación se ajusta a tus datos.
Ejemplos reales de la distribución lognormal
La distribución lognormal aparece en multitud de situaciones reales; a continuación destacamos algunas.
Ingresos y riqueza
Los ingresos son el ejemplo de libro. La mayoría se concentra en un rango moderado, pero no hay límite superior: un pequeño número gana órdenes de magnitud más que la mediana. Si dibujas los ingresos familiares en bruto obtendrás un histograma fuertemente sesgado a la derecha; si tomas el logaritmo, tendrá un aspecto aproximadamente normal. La riqueza muestra el mismo patrón, a menudo con un sesgo aún mayor.
Precios de las acciones
Los cambios diarios de precio son aproximadamente normales en términos logarítmicos, lo que implica que el nivel de precios sigue con el tiempo una distribución lognormal. Esta suposición sustenta el modelo de valoración de opciones de Black–Scholes. Los precios no pueden ser negativos, se componen de forma multiplicativa y generan esa cola derecha característica.
Tamaños de archivos en Internet
Los tamaños de archivo abarcan un rango enorme, de unos kilobytes a muchos gigabytes, y la distribución está muy sesgada a la derecha. La lognormal encaja bien porque el tamaño está acotado por cero y crece de forma multiplicativa. El análisis de tráfico web y la ingeniería de redes dependen de ello.
Mediciones biológicas
Las concentraciones de sustancias biológicas (niveles hormonales, contaminantes en tejidos, recuentos microbianos) tienden a seguir distribuciones lognormales. Muchos procesos biológicos implican razones y tasas de crecimiento más que incrementos aditivos. Los tiempos de latencia en estudios médicos muestran el mismo patrón.
En todos estos ámbitos, la lógica es la misma: un proceso de naturaleza multiplicativa, acotado en cero y capaz de generar valores extremos poco frecuentes es un buen candidato para modelado lognormal.
Distribución lognormal en machine learning y ciencia de datos
La distribución lognormal aparece en machine learning de varias formas, cada una con un tratamiento ligeramente distinto.
Modelado de variables continuas positivas
Cuando la variable objetivo es estrictamente positiva y está sesgada a la derecha —precios de viviendas, ingresos, valor de vida del usuario—, aplicar una transformación logarítmica antes de modelar suele mejorar mucho los resultados. La regresión lineal asume residuos normales; ajustarla a datos lognormales en bruto viola esa suposición. La solución: aplicar log al objetivo, ajustar el modelo y luego reexpresar las predicciones al original mediante la exponencial. Ojo: interpretar coeficientes en el espacio log requiere cuidado, porque un aumento unitario del predictor implica un cambio multiplicativo en la escala original.
Ingeniería de características con transformaciones logarítmicas
Transformar con log características sesgadas antes de usarlas en modelos sensibles a la escala (regresión lineal, logística, k-means) reduce la influencia de valores extremos y linealiza relaciones. Es un preprocesado estándar para continuas sesgadas a la derecha. La transformación también amortigua atípicos: un valor 100 veces la mediana en bruto pasa a estar a unas 4,6 unidades por encima de la mediana en el espacio log.
Modelado probabilístico y simulación
Algunos modelos probabilísticos usan explícitamente la lognormal. En Bayes, es una previa habitual para parámetros que deben ser positivos. En simulación, modela cantidades como tiempos de reparación, importes de siniestros y latencias de red donde la estructura multiplicativa refleja procesos reales. Es común en trabajos aplicados.
Cómo identificar una distribución lognormal
Mirar un histograma no basta. Aquí tienes enfoques que sí funcionan, en orden aproximadamente creciente de rigor.
Histograma y histograma log-transformado
Empieza con un histograma de los datos en bruto. Si está sesgado a la derecha, con cola larga y un límite inferior cerca de cero, es indicio. Luego dibuja el histograma de los valores transformados con log. Si parece aproximadamente simétrico y con forma de campana, la lognormal es un modelo plausible. Esta comparación rápida de dos gráficos es útil. Pero no te quedes ahí.
Gráficos Q-Q
Un gráfico cuantíl-cuantíl (Q-Q) compara los cuantiles de tus datos con los de una distribución teórica. Para datos lognormales, representa los cuantiles de ln(X) frente a los de una normal estándar. Si los puntos caen aproximadamente en una línea recta, el ajuste es bueno. Curvaturas sistemáticas, sobre todo en las colas, sugieren que la lognormal no encaja del todo. Nuestro tutorial sobre Q-Q plots explica cómo leerlos e interpretarlos en Python y R.
Pruebas de bondad de ajuste
Para una prueba formal, aplica un test de normalidad (Shapiro–Wilk, Kolmogórov–Smirnov, Anderson–Darling) a los datos transformados con log. Si ln(X) pasa, tienes evidencia estadística a favor del modelo lognormal. Con conjuntos muy grandes, estos tests son tan sensibles que pueden rechazar por desviaciones triviales. Acompaña siempre las pruebas formales con inspección visual.
Usar los tres enfoques a la vez da una imagen mucho más fiable que cualquiera por separado.
Errores comunes al trabajar con datos lognormales
Estos son algunos fallos frecuentes que comete mucha gente.
Suponer que los datos son normales
Es el error más común. Ajustar una normal a datos lognormales subestima la probabilidad de valores extremos, sesga la media y puede volver poco fiables las pruebas estadísticas. Si tus datos son positivos y están sesgados a la derecha, compruébalo antes de recurrir a la normal.
Interpretar mal la media aritmética
En datos lognormales, la media aritmética queda muy por encima de la mediana por culpa de la cola derecha. Presentar la media como "típica" induce a error. La mediana suele ser mejor indicador de lo que es una observación típica. Deja claro qué medida informas y por qué.
Olvidar que los valores deben ser positivos
La lognormal no está definida para ceros o negativos. Si tu conjunto contiene ceros —habitual en datos de conteo o ventas con periodos inactivos—, la lognormal no aplica directamente. Dos apaños comunes son sumar una constante pequeña antes de hacer log (estadísticamente no ideal) o usar un modelo con inflación de ceros que los trate por separado.
Aplicar pruebas estadísticas inapropiadas
Pruebas diseñadas para datos normales (t de Student, intervalos de confianza estándar, ANOVA) no se aplican directamente a datos lognormales. Tienes dos opciones: transformar con log y aplicar métodos basados en la normal, o usar métodos no paramétricos que no asumen forma. La prueba equivocada no siempre dará respuestas catastróficas, pero puede producir sesgos sutiles difíciles de detectar.
Conclusión
La distribución lognormal modela variables positivas y sesgadas a la derecha conectándolas con la normal mediante una transformación logarítmica. Una vez reconoces que ln(X) es normal cuando X es lognormal, todo encaja. Puedes trabajar en el espacio log con las herramientas estándar de la normal y luego volver a la escala original.
Hemos cubierto sus propiedades clave, las hemos vinculado a esa transformación y hemos visto dónde aparece en la práctica. La idea práctica es clara: antes de modelar datos positivos y sesgados a la derecha, comprueba si son lognormales. Representa los datos transformados con log, ejecuta una prueba de normalidad y mira un gráfico Q-Q. Nuestro Introduction to Statistics in Python y el tutorial Probability Distributions in Python son buenos siguientes pasos si quieres ver estas ideas aplicadas a datos reales.