Pikirkan tentang data pendapatan. Sebagian kecil orang berpenghasilan jutaan, sebagian besar berada di kisaran tengah, dan sebarannya memiliki ekor panjang yang memanjang ke kanan. Ketika dipetakan terhadap kurva lonceng standar, tidak ada yang selaras karena distribusi normal bukanlah kecocokan yang baik.
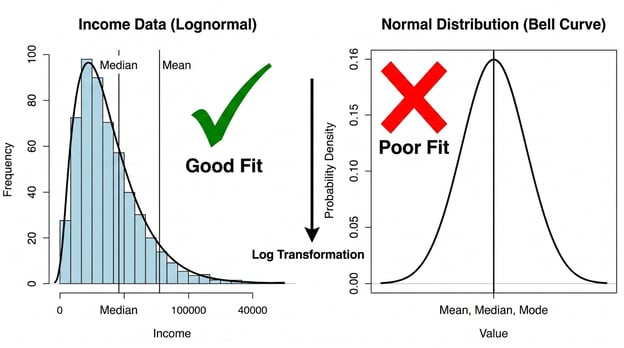
Distribusi lognormal dirancang untuk variabel yang selalu positif dan condong ke kanan, di mana sebarannya membesar seiring meningkatnya nilai. Pendapatan rumah tangga, harga saham, ukuran berkas, dan pengukuran biologis semuanya berperilaku seperti ini.
Kita akan membahas apa itu distribusi lognormal, bagaimana perbandingannya dengan distribusi normal, properti kunci dan rumusnya, kapan menggunakannya, serta cara mengenalinya dalam data nyata, termasuk beberapa kesalahan umum.
Apa Itu Distribusi Lognormal?
Sebuah variabel acak mengikuti distribusi lognormal jika logaritma naturalnya berdistribusi normal.
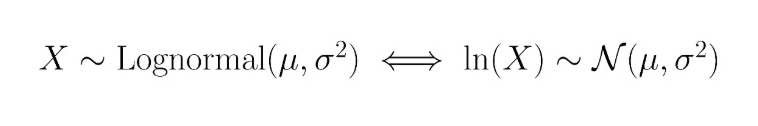
Jika X berdistribusi lognormal, maka ln(X) berdistribusi normal. Namanya berasal langsung dari sini: log-normal, sebuah distribusi yang log-nya normal.
Dua hal langsung mengikuti. Pertama, nilainya selalu positif. Logaritma hanya terdefinisi untuk bilangan positif, jadi variabel lognormal tidak pernah bisa bernilai nol atau negatif. Kedua, distribusinya condong ke kanan. Ada batas bawah fisik di nol tetapi tidak ada batas atas, yang berarti ekor kanan memanjang jauh lebih panjang daripada ekor kiri.
Transformasi logaritma adalah kunci yang menghubungkan kedua distribusi. Ambil variabel yang berdistribusi lognormal, terapkan log natural pada setiap observasi, dan hasilnya adalah data yang berdistribusi normal. Ini lebih dari sekadar keanehan matematis. Inilah yang membuat lognormal mudah ditangani. Seluruh perangkat statistik yang dibangun untuk distribusi normal menjadi tersedia begitu Anda mentransformasikan data Anda.
Distribusi Lognormal vs. Distribusi Normal
Perbedaan paling langsung adalah bentuk. Distribusi normal simetris, dengan mean, median, dan modus semuanya berada di titik tengah yang sama. Distribusi lognormal tidak simetris, condong ke kanan, dengan ekor kanan yang panjang. Mean, median, dan modus semuanya berbeda. Kita akan membahas alasannya di bagian berikutnya.
Rentang nilai yang mungkin juga berbeda. Distribusi normal membentang dari minus tak hingga sampai plus tak hingga. Distribusi lognormal dibatasi di bawah oleh nol dan membentang ke atas tanpa batas. Ini menjadikannya model yang tepat kapan pun variabel Anda secara fisik tidak bisa bernilai negatif.
|
Properti
|
Distribusi normal
|
Distribusi lognormal
|
|
Bentuk
|
Kurva lonceng simetris
|
Condong ke kanan, ekor kanan panjang
|
|
Simetri
|
Simetris
|
Tidak simetris
|
|
Nilai yang mungkin
|
Semua bilangan real (−∞ hingga +∞)
|
Selalu positif (0 hingga +∞)
|
|
Mean = median = modus?
|
Ya
|
Tidak—ketiganya berbeda
|
|
Aplikasi umum
|
Tinggi badan, nilai ujian, galat pengukuran
|
Pendapatan, harga saham, ukuran berkas
|
|
Relasi transformasi
|
—
|
Jika X lognormal, ln(X) normal
|
Baris terakhir itulah yang paling penting dalam praktik. Mengambil logaritma dari variabel yang berdistribusi lognormal menghasilkan distribusi normal. Transformasi inilah yang membuat lognormal berguna. Ini bukan sekadar deskripsi data yang condong, melainkan model dengan jembatan langsung kembali ke dunia normal.
Properti Distribusi Lognormal
Ada beberapa properti kunci dari distribusi lognormal yang membuatnya istimewa.
Selalu positif dengan ekor kanan yang panjang
Distribusi lognormal hanya menghasilkan nilai positif. Jika ln(X) normal, maka X = e^(ln(X)) selalu positif, karena eksponensial selalu positif. Ada lantai di nol, tetapi tidak ada langit-langit. Dikombinasikan dengan kemencengan ke kanan, hal ini memberikan bentuk khas distribusi: kenaikan tajam dari nol, puncak di suatu tempat di kiri mean, lalu ekor yang menipis panjang.
Tiga ukuran pemusatan ini menceritakan kisah yang berbeda. Modus (nilai yang paling sering muncul) berada paling kiri. Median (nilai tengah) lebih tinggi. Mean (rata-rata aritmetika) lebih tinggi lagi, tertarik ke atas oleh ekor kanan. Pada data pendapatan, rata-rata pendapatan rumah tangga secara signifikan lebih tinggi daripada median. Sejumlah kecil berpenghasilan sangat tinggi menggeser rata-rata sambil membiarkan bagian tengah distribusi tak berubah. Inilah mengapa ekonom biasanya melaporkan median pendapatan saat menggambarkan rumah tangga tipikal. Memilih ukuran pemusatan yang salah di sini bukan sekadar statistik yang ceroboh; itu menyesatkan secara aktif.
Ingat ini saat kita sampai pada rumus: μ dan σ menggambarkan distribusi normal dasar dari ln(X), bukan mean dan simpangan baku dari X itu sendiri. Pembedaan ini sering kali mengejutkan banyak orang.
Rumus Distribusi Lognormal
Fungsi kepadatan probabilitas (PDF) dari distribusi lognormal adalah:
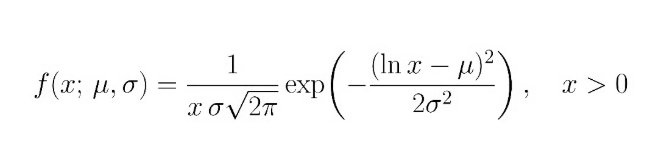
untuk x > 0, dengan:
- x adalah nilai variabel acak (harus positif)
- μ (mu) adalah mean dari ln(X). Ini mengendalikan lokasi distribusi—menaikkan μ menggeser puncak ke kanan.
- σ (sigma) adalah simpangan baku dari ln(X). Ini mengendalikan sebaran dan tingkat kemencengan. σ yang lebih besar menghasilkan ekor kanan yang lebih berat.
μ dan σ bukanlah mean dan simpangan baku dari X itu sendiri. Keduanya adalah parameter dari ln(X). Mean sebenarnya dari X adalah e(μ + σ²/2), itulah sebabnya ia berada di kanan median. Jika Anda menyesuaikan lognormal pada data di Python atau R, fungsi pustaka akan menangani translasi ini untuk Anda, tetapi ada baiknya mengetahui apa yang sebenarnya diwakili parameter-parameter tersebut.
Kapan Sebaiknya Menggunakan Distribusi Lognormal?
Uji praktisnya: jika variabel Anda selalu positif dan proses pertumbuhannya bersifat multiplikatif, bukan aditif, lognormal kemungkinan besar cocok.
Proses aditif cenderung menghasilkan distribusi normal. Berdasarkan teorema limit pusat, jumlah dari banyak efek acak kecil akan konvergen ke normal. Proses multiplikatif berbeda. Ketika nilai setiap periode adalah nilai periode sebelumnya dikalikan faktor acak (bunga majemuk, pelipatgandaan bakteri), hasilnya selama banyak periode adalah lognormal. Inilah mengapa lognormal sering muncul dalam keuangan dan biologi.
Lognormal cocok untuk variabel seperti:
- Imbal hasil keuangan dalam jangka panjang—log return harian terakumulasi secara multiplikatif
- Klaim asuransi—sebagian besar kecil; sebagian sedikit sangat besar
- Distribusi pendapatan—dibatasi di bawah oleh nol, dalam praktiknya condong ke kanan
- Pertumbuhan biologis—ukuran organisme, jumlah sel, pengukuran konsentrasi
- Waktu tunggu—waktu perbaikan dan durasi layanan dengan pencilan sesekali
- Pengukuran lingkungan—konsentrasi polutan di air atau udara
Jika Anda tidak yakin apakah lognormal tepat, kursus Feature Engineering for Machine Learning in Python kami membahas transformasi log secara mendalam, termasuk cara menilai apakah suatu transformasi sesuai untuk data Anda.
Contoh Dunia Nyata dari Distribusi Lognormal
Distribusi lognormal muncul dalam banyak skenario dunia nyata, beberapa di antaranya disorot di bawah ini.
Pendapatan dan kekayaan
Data pendapatan adalah contoh buku teks lognormal. Sebagian besar orang berpenghasilan yang mengelompok pada kisaran moderat, tetapi tidak ada batas atas—sejumlah kecil individu berpenghasilan berkali-kali lipat lebih besar daripada median. Plot pendapatan rumah tangga mentah dan Anda akan mendapatkan histogram yang sangat condong ke kanan; ambil log-nya dan tampilannya kira-kira normal. Data kekayaan menunjukkan pola yang sama, sering kali dengan kemencengan yang lebih jelas.
Harga saham
Perubahan harga saham harian kira-kira berdistribusi normal dalam skala log, yang berarti tingkat harga itu sendiri mengikuti distribusi lognormal dari waktu ke waktu. Asumsi ini mendasari model penetapan harga opsi Black-Scholes. Harga saham tidak bisa turun di bawah nol, terakumulasi secara multiplikatif, dan menghasilkan ekor kanan yang khas.
Ukuran berkas internet
Ukuran berkas membentang sangat lebar, dari beberapa kilobyte hingga banyak gigabyte, dan distribusinya sangat condong ke kanan. Lognormal cocok di sini karena ukuran berkas dibatasi di bawah oleh nol dan tumbuh secara multiplikatif. Analisis lalu lintas web dan rekayasa jaringan mengandalkannya.
Pengukuran biologis
Konsentrasi zat biologis (tingkat hormon, konsentrasi polutan dalam jaringan, jumlah mikroba) cenderung mengikuti distribusi lognormal. Proses biologis sering kali melibatkan rasio dan laju pertumbuhan alih-alih kenaikan aditif. Waktu latensi dalam studi medis menunjukkan pola yang sama.
Di masing-masing domain ini, logikanya sama: proses yang secara alami bersifat multiplikatif, dibatasi di nol, dan mampu menghasilkan nilai ekstrem yang jarang, merupakan kandidat alami untuk pemodelan lognormal.
Distribusi Lognormal dalam Machine Learning dan Data Science
Distribusi lognormal muncul dalam machine learning dalam beberapa cara berbeda, masing-masing memerlukan penanganan yang sedikit berbeda.
Memodelkan variabel kontinu yang positif
Ketika variabel target selalu positif dan condong ke kanan—harga rumah, pendapatan, nilai seumur hidup pengguna—menerapkan transformasi log sebelum pemodelan sering kali sangat meningkatkan hasil. Regresi linear mengasumsikan residual berdistribusi normal; menyesuaikannya pada data lognormal mentah melanggar asumsi itu. Solusinya: log-kan target, sesuaikan model, lalu eksponensialkan kembali prediksi ke skala asli. Satu catatan: menafsirkan koefisien dalam ruang log memerlukan kehati-hatian, karena kenaikan satu unit pada prediktor kini berkaitan dengan perubahan multiplikatif pada skala asli.
Mentransformasi log fitur yang condong sebelum memasukkannya ke model yang peka skala (regresi linear, regresi logistik, k-means) mengurangi pengaruh nilai ekstrem dan membuat hubungan lebih linear. Ini adalah prapemrosesan standar untuk fitur kontinu yang condong ke kanan. Transformasi ini juga menangani pencilan secara implisit: nilai yang 100 kali median dalam ruang mentah menjadi kira-kira 4,6 unit di atas median dalam ruang log.
Pemodelan probabilistik dan simulasi
Beberapa model probabilistik menggunakan distribusi lognormal secara eksplisit. Dalam pemodelan Bayesian, ini adalah prior umum untuk parameter yang harus positif. Dalam simulasi, ia memodelkan besaran seperti waktu perbaikan, besaran klaim asuransi, dan keterlambatan jaringan di mana struktur multiplikatifnya sesuai dengan proses dunia nyata. Hal ini sering muncul dalam pekerjaan terapan.
Cara Mengidentifikasi Distribusi Lognormal
Melihat sekilas histogram saja tidak cukup. Berikut pendekatan yang benar-benar bekerja, kira-kira dalam urutan peningkatan ketelitian.
Mulailah dengan histogram data mentah. Jika condong ke kanan dengan ekor kanan panjang dan batas bawah dekat nol, itu indikatif. Lalu plot histogram dari nilai yang ditransformasi log. Jika histogram itu tampak kira-kira simetris dan berbentuk lonceng, lognormal adalah model yang masuk akal. Perbandingan dua plot ini cepat. Namun jangan berhenti di sini.
Plot Q-Q
Sebuah quantile-quantile (Q-Q) plot membandingkan kuantil data Anda dengan kuantil dari distribusi teoretis. Untuk data lognormal, plot kuantil ln(X) terhadap kuantil normal baku. Titik-titik yang kira-kira jatuh sepanjang garis lurus menandakan kecocokan yang baik. Kelengkungan sistematis, terutama di ekor, menyiratkan bahwa lognormal kurang tepat. Tutorial kami tentang Q-Q plot membahas cara membaca dan menafsirkannya baik di Python maupun R.
Uji goodness-of-fit
Untuk uji formal, terapkan uji kenormalan (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) pada data yang ditransformasi log. Jika ln(X) lolos, Anda memiliki bukti statistik yang mendukung model lognormal. Namun, pada dataset yang sangat besar, uji ini menjadi cukup sensitif untuk menolak ke-lognormal-an karena penyimpangan kecil yang sepele. Selalu pasangkan uji formal dengan inspeksi visual.
Menggunakan ketiga pendekatan secara bersamaan memberi Anda gambaran yang jauh lebih andal daripada satu metode saja.
Kesalahan Umum Saat Bekerja dengan Data Lognormal
Beberapa kesalahan umum yang sering dilakukan praktisi disorot di sini.
Mengasumsikan data berdistribusi normal
Ini adalah kesalahan paling umum. Menyesuaikan distribusi normal pada data lognormal meremehkan probabilitas nilai ekstrem, membiasakan estimasi mean, dan dapat membuat uji statistik tidak andal. Jika data Anda positif dan condong ke kanan, periksalah terlebih dahulu sebelum menggunakan distribusi normal.
Menafsirkan mean aritmetika secara keliru
Untuk data lognormal, mean aritmetika tertarik jauh di atas median oleh ekor kanan. Melaporkan mean sebagai "tipikal" menyesatkan. Median biasanya merupakan ukuran yang lebih baik tentang seperti apa pengamatan tipikal. Jelaskan ukuran mana yang Anda laporkan dan alasannya.
Lupa bahwa nilainya harus positif
Distribusi lognormal tidak terdefinisi untuk nilai nol atau negatif. Jika dataset Anda mengandung nol—umum pada data cacah atau data penjualan dengan periode tidak aktif—lognormal tidak dapat diterapkan secara langsung. Solusi umum termasuk menambahkan konstanta kecil sebelum melakukan log (tidak ideal secara statistik) atau menggunakan model zero-inflated yang menangani nol secara terpisah.
Menerapkan uji statistik yang tidak tepat
Uji yang dirancang untuk data berdistribusi normal (uji t, interval kepercayaan standar, ANOVA) tidak langsung berlaku untuk data lognormal. Anda punya dua pilihan: log-kan data dan terapkan metode berbasis normal, atau gunakan metode nonparametrik yang tidak membuat asumsi bentuk. Uji yang salah tidak selalu menghasilkan jawaban yang sangat keliru, tetapi dapat menghasilkan bias halus yang sulit dideteksi.
Kesimpulan
Distribusi lognormal memodelkan variabel yang positif dan condong ke kanan dengan menghubungkannya ke distribusi normal melalui transformasi logaritma. Setelah Anda menyadari bahwa ln(X) normal kapan pun X lognormal, sisanya mengikuti. Anda dapat bekerja dalam ruang log menggunakan alat normal standar, lalu menerjemahkan hasilnya kembali ke skala asli.
Kita telah membahas properti kunci distribusi ini, menelusurinya kembali ke transformasi tersebut, dan melihat di mana ia muncul dalam praktik. Inti praktisnya sederhana: sebelum memodelkan data yang positif dan condong ke kanan, periksa ke-lognormal-annya. Plot data yang ditransformasi log, jalankan uji kenormalan padanya, dan lihat plot Q-Q. Introduction to Statistics in Python dan tutorial Probability Distributions in Python kami adalah langkah berikutnya yang baik jika Anda ingin melihat gagasan-gagasan ini diterapkan pada dataset nyata.




Pikirkan tentang data pendapatan. Sebagian kecil orang berpenghasilan jutaan, sebagian besar berada di kisaran tengah, dan sebarannya memiliki ekor panjang yang memanjang ke kanan. Ketika dipetakan terhadap kurva lonceng standar, tidak ada yang selaras karena distribusi normal bukanlah kecocokan yang baik.
Distribusi lognormal dirancang untuk variabel yang selalu positif dan condong ke kanan, di mana sebarannya membesar seiring meningkatnya nilai. Pendapatan rumah tangga, harga saham, ukuran berkas, dan pengukuran biologis semuanya berperilaku seperti ini.
Kita akan membahas apa itu distribusi lognormal, bagaimana perbandingannya dengan distribusi normal, properti kunci dan rumusnya, kapan menggunakannya, serta cara mengenalinya dalam data nyata, termasuk beberapa kesalahan umum.
Apa Itu Distribusi Lognormal?
Sebuah variabel acak mengikuti distribusi lognormal jika logaritma naturalnya berdistribusi normal.
Jika X berdistribusi lognormal, maka ln(X) berdistribusi normal. Namanya berasal langsung dari sini: log-normal, sebuah distribusi yang log-nya normal.
Dua hal langsung mengikuti. Pertama, nilainya selalu positif. Logaritma hanya terdefinisi untuk bilangan positif, jadi variabel lognormal tidak pernah bisa bernilai nol atau negatif. Kedua, distribusinya condong ke kanan. Ada batas bawah fisik di nol tetapi tidak ada batas atas, yang berarti ekor kanan memanjang jauh lebih panjang daripada ekor kiri.
Transformasi logaritma adalah kunci yang menghubungkan kedua distribusi. Ambil variabel yang berdistribusi lognormal, terapkan log natural pada setiap observasi, dan hasilnya adalah data yang berdistribusi normal. Ini lebih dari sekadar keanehan matematis. Inilah yang membuat lognormal mudah ditangani. Seluruh perangkat statistik yang dibangun untuk distribusi normal menjadi tersedia begitu Anda mentransformasikan data Anda.
Distribusi Lognormal vs. Distribusi Normal
Perbedaan paling langsung adalah bentuk. Distribusi normal simetris, dengan mean, median, dan modus semuanya berada di titik tengah yang sama. Distribusi lognormal tidak simetris, condong ke kanan, dengan ekor kanan yang panjang. Mean, median, dan modus semuanya berbeda. Kita akan membahas alasannya di bagian berikutnya.
Rentang nilai yang mungkin juga berbeda. Distribusi normal membentang dari minus tak hingga sampai plus tak hingga. Distribusi lognormal dibatasi di bawah oleh nol dan membentang ke atas tanpa batas. Ini menjadikannya model yang tepat kapan pun variabel Anda secara fisik tidak bisa bernilai negatif.
Properti
Distribusi normal
Distribusi lognormal
Bentuk
Kurva lonceng simetris
Condong ke kanan, ekor kanan panjang
Simetri
Simetris
Tidak simetris
Nilai yang mungkin
Semua bilangan real (−∞ hingga +∞)
Selalu positif (0 hingga +∞)
Mean = median = modus?
Ya
Tidak—ketiganya berbeda
Aplikasi umum
Tinggi badan, nilai ujian, galat pengukuran
Pendapatan, harga saham, ukuran berkas
Relasi transformasi
—
Jika X lognormal, ln(X) normal
Baris terakhir itulah yang paling penting dalam praktik. Mengambil logaritma dari variabel yang berdistribusi lognormal menghasilkan distribusi normal. Transformasi inilah yang membuat lognormal berguna. Ini bukan sekadar deskripsi data yang condong, melainkan model dengan jembatan langsung kembali ke dunia normal.
Properti Distribusi Lognormal
Ada beberapa properti kunci dari distribusi lognormal yang membuatnya istimewa.
Selalu positif dengan ekor kanan yang panjang
Distribusi lognormal hanya menghasilkan nilai positif. Jika ln(X) normal, maka X = e^(ln(X)) selalu positif, karena eksponensial selalu positif. Ada lantai di nol, tetapi tidak ada langit-langit. Dikombinasikan dengan kemencengan ke kanan, hal ini memberikan bentuk khas distribusi: kenaikan tajam dari nol, puncak di suatu tempat di kiri mean, lalu ekor yang menipis panjang.
Mean, median, dan modus semuanya berbeda
Tiga ukuran pemusatan ini menceritakan kisah yang berbeda. Modus (nilai yang paling sering muncul) berada paling kiri. Median (nilai tengah) lebih tinggi. Mean (rata-rata aritmetika) lebih tinggi lagi, tertarik ke atas oleh ekor kanan. Pada data pendapatan, rata-rata pendapatan rumah tangga secara signifikan lebih tinggi daripada median. Sejumlah kecil berpenghasilan sangat tinggi menggeser rata-rata sambil membiarkan bagian tengah distribusi tak berubah. Inilah mengapa ekonom biasanya melaporkan median pendapatan saat menggambarkan rumah tangga tipikal. Memilih ukuran pemusatan yang salah di sini bukan sekadar statistik yang ceroboh; itu menyesatkan secara aktif.
Ingat ini saat kita sampai pada rumus: μ dan σ menggambarkan distribusi normal dasar dari ln(X), bukan mean dan simpangan baku dari X itu sendiri. Pembedaan ini sering kali mengejutkan banyak orang.
Rumus Distribusi Lognormal
Fungsi kepadatan probabilitas (PDF) dari distribusi lognormal adalah:
untuk x > 0, dengan:
μ dan σ bukanlah mean dan simpangan baku dari X itu sendiri. Keduanya adalah parameter dari ln(X). Mean sebenarnya dari X adalah e(μ + σ²/2), itulah sebabnya ia berada di kanan median. Jika Anda menyesuaikan lognormal pada data di Python atau R, fungsi pustaka akan menangani translasi ini untuk Anda, tetapi ada baiknya mengetahui apa yang sebenarnya diwakili parameter-parameter tersebut.
Kapan Sebaiknya Menggunakan Distribusi Lognormal?
Uji praktisnya: jika variabel Anda selalu positif dan proses pertumbuhannya bersifat multiplikatif, bukan aditif, lognormal kemungkinan besar cocok.
Proses aditif cenderung menghasilkan distribusi normal. Berdasarkan teorema limit pusat, jumlah dari banyak efek acak kecil akan konvergen ke normal. Proses multiplikatif berbeda. Ketika nilai setiap periode adalah nilai periode sebelumnya dikalikan faktor acak (bunga majemuk, pelipatgandaan bakteri), hasilnya selama banyak periode adalah lognormal. Inilah mengapa lognormal sering muncul dalam keuangan dan biologi.
Lognormal cocok untuk variabel seperti:
Jika Anda tidak yakin apakah lognormal tepat, kursus Feature Engineering for Machine Learning in Python kami membahas transformasi log secara mendalam, termasuk cara menilai apakah suatu transformasi sesuai untuk data Anda.
Contoh Dunia Nyata dari Distribusi Lognormal
Distribusi lognormal muncul dalam banyak skenario dunia nyata, beberapa di antaranya disorot di bawah ini.
Pendapatan dan kekayaan
Data pendapatan adalah contoh buku teks lognormal. Sebagian besar orang berpenghasilan yang mengelompok pada kisaran moderat, tetapi tidak ada batas atas—sejumlah kecil individu berpenghasilan berkali-kali lipat lebih besar daripada median. Plot pendapatan rumah tangga mentah dan Anda akan mendapatkan histogram yang sangat condong ke kanan; ambil log-nya dan tampilannya kira-kira normal. Data kekayaan menunjukkan pola yang sama, sering kali dengan kemencengan yang lebih jelas.
Harga saham
Perubahan harga saham harian kira-kira berdistribusi normal dalam skala log, yang berarti tingkat harga itu sendiri mengikuti distribusi lognormal dari waktu ke waktu. Asumsi ini mendasari model penetapan harga opsi Black-Scholes. Harga saham tidak bisa turun di bawah nol, terakumulasi secara multiplikatif, dan menghasilkan ekor kanan yang khas.
Ukuran berkas internet
Ukuran berkas membentang sangat lebar, dari beberapa kilobyte hingga banyak gigabyte, dan distribusinya sangat condong ke kanan. Lognormal cocok di sini karena ukuran berkas dibatasi di bawah oleh nol dan tumbuh secara multiplikatif. Analisis lalu lintas web dan rekayasa jaringan mengandalkannya.
Pengukuran biologis
Konsentrasi zat biologis (tingkat hormon, konsentrasi polutan dalam jaringan, jumlah mikroba) cenderung mengikuti distribusi lognormal. Proses biologis sering kali melibatkan rasio dan laju pertumbuhan alih-alih kenaikan aditif. Waktu latensi dalam studi medis menunjukkan pola yang sama.
Di masing-masing domain ini, logikanya sama: proses yang secara alami bersifat multiplikatif, dibatasi di nol, dan mampu menghasilkan nilai ekstrem yang jarang, merupakan kandidat alami untuk pemodelan lognormal.
Distribusi Lognormal dalam Machine Learning dan Data Science
Distribusi lognormal muncul dalam machine learning dalam beberapa cara berbeda, masing-masing memerlukan penanganan yang sedikit berbeda.
Memodelkan variabel kontinu yang positif
Ketika variabel target selalu positif dan condong ke kanan—harga rumah, pendapatan, nilai seumur hidup pengguna—menerapkan transformasi log sebelum pemodelan sering kali sangat meningkatkan hasil. Regresi linear mengasumsikan residual berdistribusi normal; menyesuaikannya pada data lognormal mentah melanggar asumsi itu. Solusinya: log-kan target, sesuaikan model, lalu eksponensialkan kembali prediksi ke skala asli. Satu catatan: menafsirkan koefisien dalam ruang log memerlukan kehati-hatian, karena kenaikan satu unit pada prediktor kini berkaitan dengan perubahan multiplikatif pada skala asli.
Rekayasa fitur dengan transformasi log
Mentransformasi log fitur yang condong sebelum memasukkannya ke model yang peka skala (regresi linear, regresi logistik, k-means) mengurangi pengaruh nilai ekstrem dan membuat hubungan lebih linear. Ini adalah prapemrosesan standar untuk fitur kontinu yang condong ke kanan. Transformasi ini juga menangani pencilan secara implisit: nilai yang 100 kali median dalam ruang mentah menjadi kira-kira 4,6 unit di atas median dalam ruang log.
Pemodelan probabilistik dan simulasi
Beberapa model probabilistik menggunakan distribusi lognormal secara eksplisit. Dalam pemodelan Bayesian, ini adalah prior umum untuk parameter yang harus positif. Dalam simulasi, ia memodelkan besaran seperti waktu perbaikan, besaran klaim asuransi, dan keterlambatan jaringan di mana struktur multiplikatifnya sesuai dengan proses dunia nyata. Hal ini sering muncul dalam pekerjaan terapan.
Cara Mengidentifikasi Distribusi Lognormal
Melihat sekilas histogram saja tidak cukup. Berikut pendekatan yang benar-benar bekerja, kira-kira dalam urutan peningkatan ketelitian.
Histogram dan histogram yang ditransformasi log
Mulailah dengan histogram data mentah. Jika condong ke kanan dengan ekor kanan panjang dan batas bawah dekat nol, itu indikatif. Lalu plot histogram dari nilai yang ditransformasi log. Jika histogram itu tampak kira-kira simetris dan berbentuk lonceng, lognormal adalah model yang masuk akal. Perbandingan dua plot ini cepat. Namun jangan berhenti di sini.
Plot Q-Q
Sebuah quantile-quantile (Q-Q) plot membandingkan kuantil data Anda dengan kuantil dari distribusi teoretis. Untuk data lognormal, plot kuantil ln(X) terhadap kuantil normal baku. Titik-titik yang kira-kira jatuh sepanjang garis lurus menandakan kecocokan yang baik. Kelengkungan sistematis, terutama di ekor, menyiratkan bahwa lognormal kurang tepat. Tutorial kami tentang Q-Q plot membahas cara membaca dan menafsirkannya baik di Python maupun R.
Uji goodness-of-fit
Untuk uji formal, terapkan uji kenormalan (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) pada data yang ditransformasi log. Jika ln(X) lolos, Anda memiliki bukti statistik yang mendukung model lognormal. Namun, pada dataset yang sangat besar, uji ini menjadi cukup sensitif untuk menolak ke-lognormal-an karena penyimpangan kecil yang sepele. Selalu pasangkan uji formal dengan inspeksi visual.
Menggunakan ketiga pendekatan secara bersamaan memberi Anda gambaran yang jauh lebih andal daripada satu metode saja.
Kesalahan Umum Saat Bekerja dengan Data Lognormal
Beberapa kesalahan umum yang sering dilakukan praktisi disorot di sini.
Mengasumsikan data berdistribusi normal
Ini adalah kesalahan paling umum. Menyesuaikan distribusi normal pada data lognormal meremehkan probabilitas nilai ekstrem, membiasakan estimasi mean, dan dapat membuat uji statistik tidak andal. Jika data Anda positif dan condong ke kanan, periksalah terlebih dahulu sebelum menggunakan distribusi normal.
Menafsirkan mean aritmetika secara keliru
Untuk data lognormal, mean aritmetika tertarik jauh di atas median oleh ekor kanan. Melaporkan mean sebagai "tipikal" menyesatkan. Median biasanya merupakan ukuran yang lebih baik tentang seperti apa pengamatan tipikal. Jelaskan ukuran mana yang Anda laporkan dan alasannya.
Lupa bahwa nilainya harus positif
Distribusi lognormal tidak terdefinisi untuk nilai nol atau negatif. Jika dataset Anda mengandung nol—umum pada data cacah atau data penjualan dengan periode tidak aktif—lognormal tidak dapat diterapkan secara langsung. Solusi umum termasuk menambahkan konstanta kecil sebelum melakukan log (tidak ideal secara statistik) atau menggunakan model zero-inflated yang menangani nol secara terpisah.
Menerapkan uji statistik yang tidak tepat
Uji yang dirancang untuk data berdistribusi normal (uji t, interval kepercayaan standar, ANOVA) tidak langsung berlaku untuk data lognormal. Anda punya dua pilihan: log-kan data dan terapkan metode berbasis normal, atau gunakan metode nonparametrik yang tidak membuat asumsi bentuk. Uji yang salah tidak selalu menghasilkan jawaban yang sangat keliru, tetapi dapat menghasilkan bias halus yang sulit dideteksi.
Kesimpulan
Distribusi lognormal memodelkan variabel yang positif dan condong ke kanan dengan menghubungkannya ke distribusi normal melalui transformasi logaritma. Setelah Anda menyadari bahwa ln(X) normal kapan pun X lognormal, sisanya mengikuti. Anda dapat bekerja dalam ruang log menggunakan alat normal standar, lalu menerjemahkan hasilnya kembali ke skala asli.
Kita telah membahas properti kunci distribusi ini, menelusurinya kembali ke transformasi tersebut, dan melihat di mana ia muncul dalam praktik. Inti praktisnya sederhana: sebelum memodelkan data yang positif dan condong ke kanan, periksa ke-lognormal-annya. Plot data yang ditransformasi log, jalankan uji kenormalan padanya, dan lihat plot Q-Q. Introduction to Statistics in Python dan tutorial Probability Distributions in Python kami adalah langkah berikutnya yang baik jika Anda ingin melihat gagasan-gagasan ini diterapkan pada dataset nyata.