Denk aan inkomensgegevens. Een paar mensen verdienen miljoenen, de meesten zitten ergens in het midden, en de verdeling heeft een lange staart naar rechts. Zet dit af tegen een standaard klokvorm en niets komt overeen, omdat de normale verdeling hier slecht past.
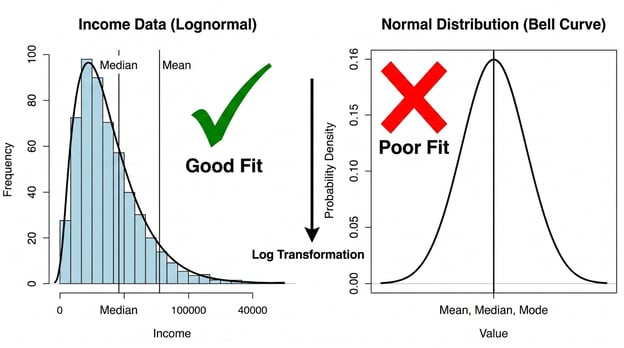
De lognormale verdeling is gemaakt voor variabelen die strikt positief en rechts-scheef zijn, waarbij de spreiding toeneemt met de grootte van de waarde. Huishoudinkomen, aandelenkoersen, bestandsgroottes en biologische metingen gedragen zich allemaal zo.
We behandelen wat de lognormale verdeling is, hoe die zich verhoudt tot de normale verdeling, de belangrijkste eigenschappen en formule, wanneer je die gebruikt en hoe je die in echte data herkent, inclusief een paar veelvoorkomende fouten.
Wat is de lognormale verdeling?
Een toevalsvariabele volgt een lognormale verdeling als het natuurlijke logaritme ervan normaal verdeeld is.
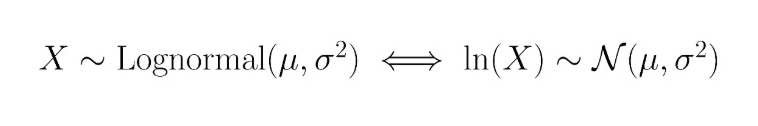
Als X lognormaal verdeeld is, dan is ln(X) normaal. De naam komt hier rechtstreeks vandaan: log-normaal, een verdeling waarvan de log normaal is.
Twee dingen volgen meteen. Ten eerste zijn waarden altijd positief. Logaritmen zijn alleen gedefinieerd voor positieve getallen, dus lognormale variabelen kunnen nooit nul of negatief zijn. Ten tweede is de verdeling rechts-scheef. Er is een fysieke ondergrens bij nul maar geen bovengrens, wat betekent dat de rechterstaart veel verder doorloopt dan de linker.
De logaritmetransformatie is de sleutel die de twee verdelingen verbindt. Neem een lognormaal verdeelde variabele, pas op elke observatie een natuurlijke log toe, en het resultaat is normaal verdeelde data. Dat is meer dan een wiskundige curiositeit. Het maakt de lognormaal hanteerbaar. Alle statistische hulpmiddelen die voor de normale verdeling zijn gebouwd, worden beschikbaar zodra je je data hebt getransformeerd.
Lognormale verdeling vs. normale verdeling
Het meest directe verschil is de vorm. De normale verdeling is symmetrisch, met het gemiddelde, de mediaan en de modus op hetzelfde middelpunt. De lognormale verdeling is asymmetrisch, naar rechts scheef, met een lange rechterstaart. Het gemiddelde, de mediaan en de modus verschillen allemaal. Waarom, dat komt zo.
Ook het bereik van mogelijke waarden verschilt. Een normale verdeling loopt van min oneindig tot plus oneindig. Een lognormale verdeling is van onderen begrensd door nul en loopt onbeperkt omhoog. Dit maakt het het juiste model wanneer je variabele fysiek niet negatief kan zijn.
|
Eigenschap
|
Normale verdeling
|
Lognormale verdeling
|
|
Vorm
|
Symmetrische klokcurve
|
Rechts-scheef, lange rechterstaart
|
|
Symmetrie
|
Symmetrisch
|
Asymmetrisch
|
|
Mogelijke waarden
|
Alle reële getallen (−∞ tot +∞)
|
Strikt positief (0 tot +∞)
|
|
Gemiddelde = mediaan = modus?
|
Ja
|
Nee—alle drie verschillen
|
|
Typische toepassingen
|
Lengte, toetsscores, meetfout
|
Inkomen, aandelenkoersen, bestandsgroottes
|
|
Transformatierelatie
|
—
|
Als X lognormaal is, is ln(X) normaal
|
Die laatste rij is in de praktijk het belangrijkst. Het nemen van het logaritme van een lognormaal verdeelde variabele levert een normale verdeling op. Deze transformatie maakt de lognormaal nuttig. Het is niet alleen een beschrijving van scheve data, maar een model met een directe brug terug naar de normale wereld.
Eigenschappen van de lognormale verdeling
Er zijn een paar belangrijke eigenschappen van een lognormale verdeling die haar bijzonder maken.
Altijd positief met een lange rechterstaart
De lognormale verdeling levert alleen positieve waarden op. Als ln(X) normaal is, dan is X = e^(ln(X)) altijd positief, omdat exponenten altijd positief zijn. Er is een bodem bij nul, maar geen plafond. In combinatie met de rechtsscheefheid geeft dit de verdeling haar kenmerkende vorm: een scherpe stijging vanaf nul, een piek ergens links van het gemiddelde, en dan een lange aflopende staart.
De drie centrummaten vertellen verschillende verhalen. De modus (de meest voorkomende waarde) ligt het verst links. De mediaan (de middelste waarde) ligt hoger. Het gemiddelde (het rekenkundig gemiddelde) ligt nog hoger, omhooggetrokken door de rechterstaart. Bij inkomensdata ligt het gemiddelde huishoudinkomen aanzienlijk hoger dan de mediaan. Een paar zeer hoge verdieners verschuiven het gemiddelde, terwijl het midden van de verdeling onveranderd blijft. Daarom rapporteren economen doorgaans de mediaan als ze typische huishoudens beschrijven. De verkeerde centrummaatstaf kiezen is hier niet alleen slordige statistiek; het misleidt actief.
Onthoud dit bij de formule: μ en σ beschrijven de onderliggende normale verdeling van ln(X), niet het gemiddelde en de standaardafwijking van X zelf. Dat onderscheid verrast veel mensen.
De dichtheidsfunctie (PDF) van de lognormale verdeling is:
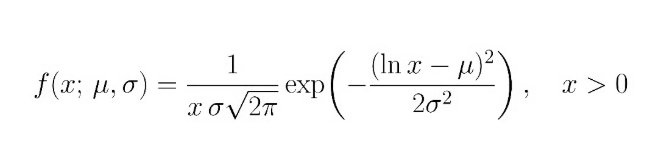
voor x > 0, waar:
- x de waarde is van de toevalsvariabele (moet positief zijn)
- μ (mu) het gemiddelde is van ln(X). Dit bepaalt de ligging van de verdeling—een hogere μ verschuift de piek naar rechts.
- σ (sigma) de standaardafwijking is van ln(X). Dit bepaalt de spreiding en mate van scheefheid. Een grotere σ levert een zwaardere rechterstaart op.
μ en σ zijn niet het gemiddelde en de standaardafwijking van X zelf. Het zijn de parameters van ln(X). Het werkelijke gemiddelde van X is e(μ + σ²/2), wat verklaart waarom het rechts van de mediaan ligt. Als je in Python of R een lognormaal op data fit, handelen bibliotheekfuncties deze vertaling voor je af, maar het is de moeite waard te weten wat de parameters werkelijk voorstellen.
Wanneer gebruik je een lognormale verdeling?
De praktische test: als je variabele strikt positief is en het groeiproces multiplicatief in plaats van additief is, is de lognormaal waarschijnlijk een goede keuze.
Additieve processen produceren vaak normale verdelingen. Volgens de centrale limietstelling convergeren sommen van veel kleine willekeurige invloeden naar normaal. Multiplicatieve processen zijn anders. Als de waarde per periode de vorige waarde is vermenigvuldigd met een willekeurige factor (samengestelde rente, bacteriën die zich verdubbelen), is het resultaat over veel perioden lognormaal. Daarom komt de lognormaal zo vaak voor in financiën en biologie.
De lognormaal past bij variabelen zoals:
- Financiële rendementen over lange periodes—dagelijkse logrendementen worden multiplicatief samengesteld
- Verzekeringsclaims—de meeste zijn klein; enkele zijn zeer groot
- Inkomensverdelingen—van onderen begrensd door nul, in de praktijk rechts-scheef
- Biologische groei—organismegrootte, cel-aantallen, concentratiemetingen
- Wachttijden—reparatietijden en service-duren met incidentele uitschieters
- Milieumetingen—verontreinigingsconcentraties in water of lucht
Als je niet zeker weet of de lognormaal geschikt is, behandelt onze cursus Feature Engineering for Machine Learning in Python logtransformaties uitgebreid, inclusief hoe je beoordeelt of een transformatie bij je data past.
Praktijkvoorbeelden van de lognormale verdeling
De lognormale verdeling komt voor in veel praktijksituaties, waarvan er hieronder een paar worden uitgelicht.
Inkomen en vermogen
Inkomensdata is het schoolvoorbeeld van lognormaal. De meeste mensen verdienen inkomens die clusteren in een gematigd bereik, maar er is geen bovengrens—een klein aantal individuen verdient ordes van grootte meer dan de mediaan. Plot ruwe huishoudinkomens en je krijgt een sterk rechts-scheve histogram; neem de log en het ziet er ruwweg normaal uit. Vermogensdata toont hetzelfde patroon, vaak met een nog uitgesprokener scheefheid.
Aandelenkoersen
Dagelijkse veranderingen in aandelenkoersen zijn in logtermen ongeveer normaal verdeeld, wat betekent dat het prijsniveau zelf over de tijd een lognormale verdeling volgt. Deze aanname ligt ten grondslag aan het Black-Scholes-model voor optieprijzen. Aandelenkoersen kunnen niet onder nul zakken, worden multiplicatief samengesteld en vertonen die kenmerkende rechterstaart.
Bestandsgroottes op internet
Bestandsgroottes beslaan een enorm bereik, van enkele kilobytes tot vele gigabytes, en de verdeling is sterk rechts-scheef. De lognormaal past hier goed, omdat bestandsgrootte van onderen begrensd is door nul en multiplicatief groeit. Webverkeersanalyse en netwerkengineering leunen hierop.
Biologische metingen
Concentraties van biologische stoffen (hormoonspiegels, verontreinigingsconcentraties in weefsel, microbiële aantallen) volgen vaak lognormale verdelingen. Biologische processen draaien vaak om verhoudingen en groeisnelheden in plaats van om additieve stappen. Latentietijden in medische studies laten hetzelfde patroon zien.
In elk van deze domeinen is de logica hetzelfde: een proces dat van nature multiplicatief is, begrensd bij nul en in staat om zeldzame extreme waarden te produceren, is een natuurlijke kandidaat voor lognormaal modelleren.
Lognormale verdeling in machine learning en data science
De lognormale verdeling duikt in machine learning op in een paar verschillende vormen, die elk net iets andere aanpak vragen.
Positieve continue variabelen modelleren
Wanneer een targetvariabele strikt positief en rechts-scheef is—woningprijzen, omzet, customer lifetime value—verbetert een logtransformatie vóór het modelleren de resultaten vaak aanzienlijk. Lineaire regressie gaat uit van normaal verdeelde residuen; een fit op ruwe lognormale data schendt die aanname. De oplossing: neem de log van de target, fit het model en exponentieer de voorspellingen terug naar de oorspronkelijke schaal. Eén kanttekening: het interpreteren van coëfficiënten in log-ruimte vraagt om zorg, omdat een eenheidsverhoging in een predictor nu overeenkomt met een multiplicatieve verandering op de oorspronkelijke schaal.
Rechtsscheve features log-transformeren voordat je ze aan schaalgevoelige modellen voert (lineaire/logistische regressie, k-means) verkleint de invloed van extreme waarden en maakt relaties lineairder. Dit is standaard preprocessing voor rechts-scheve continue features. De transformatie pakt uitschieters impliciet aan: een waarde die 100 keer de mediaan is in ruwe ruimte wordt ongeveer 4,6 eenheden boven de mediaan in logruimte.
Probabilistisch modelleren en simulatie
Sommige probabilistische modellen gebruiken de lognormale verdeling expliciet. In Bayesiaans modelleren is het een veelgebruikte prior voor parameters die positief moeten zijn. In simulaties modelleert ze grootheden zoals reparatietijden, schadebedragen en netwerkvertragingen, waar de multiplicatieve structuur overeenkomt met echte processen. Deze komen regelmatig voor in toegepast werk.
Hoe herken je een lognormale verdeling
Een histogram op het oog beoordelen is niet genoeg. Dit zijn de aanpakken die echt werken, in grofweg oplopende orde van strengheid.
Begin met een histogram van de ruwe data. Als het rechts-scheef is met een lange rechterstaart en een ondergrens nabij nul, is dat veelzeggend. Plot vervolgens een histogram van de log-getransformeerde waarden. Als dat histogram ongeveer symmetrisch en klokvormig is, is de lognormaal een plausibel model. Deze twee-plotsvergelijking is snel. Maar stop hier niet.
Q-Q-plots
Een quantile-quantile (Q-Q)-plot vergelijkt de kwantielen van je data met de kwantielen van een theoretische verdeling. Voor lognormale data plot je de kwantielen van ln(X) tegen de kwantielen van een standaardnormaal. Punten die ongeveer op een rechte lijn vallen duiden op een goede fit. Systematische kromming, vooral in de staarten, suggereert dat de lognormaal niet helemaal klopt. Onze tutorial over Q-Q-plots laat zien hoe je ze leest en interpreteert in zowel Python als R.
Goodness-of-fit-tests
Voor een formele test pas je een normaliteitstest (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) toe op de log-getransformeerde data. Als ln(X) slaagt, heb je statistisch bewijs dat het lognormale model ondersteunt. Bij zeer grote datasets worden deze tests echter zo gevoelig dat ze lognormaliteit afwijzen om triviaal kleine afwijkingen. Combineer formele tests daarom altijd met visuele inspectie.
Alle drie de benaderingen samen geven je een veel betrouwbaarder beeld dan één methode alleen.
Veelgemaakte fouten bij werken met lognormale data
Een paar veelvoorkomende fouten die veel practitioners maken, lichten we hier uit.
Aannemen dat de data normaal verdeeld is
Dit is de meest voorkomende fout. Een normale verdeling fitten op lognormale data onderschat de kans op extreme waarden, vertekent schattingen van het gemiddelde en kan statistische tests onbetrouwbaar maken. Als je data positief en rechts-scheef is, controleer dit dan voordat je naar de normale verdeling grijpt.
Het rekenkundig gemiddelde verkeerd interpreteren
Bij lognormale data wordt het rekenkundig gemiddelde aanzienlijk boven de mediaan getrokken door de rechterstaart. Het gemiddelde als "typisch" rapporteren is misleidend. De mediaan is meestal een betere maat voor hoe een typische observatie eruitziet. Wees duidelijk welke maat je rapporteert en waarom.
Vergeten dat waarden positief moeten zijn
De lognormale verdeling is niet gedefinieerd voor nul of negatieve waarden. Als je dataset nullen bevat—veelvoorkomend in teldata of verkoopdata met inactieve periodes—is de lognormaal niet direct toepasbaar. Gebruikelijke workarounds zijn het toevoegen van een kleine constante vóór het loggen (statistisch niet ideaal) of een zero-inflated model dat de nullen apart behandelt.
Ongepaste statistische tests toepassen
Tests die zijn ontworpen voor normaal verdeelde data (t-toetsen, standaard betrouwbaarheidsintervallen, ANOVA) zijn niet direct van toepassing op lognormale data. Je hebt twee opties: log de data en pas normaal-gebaseerde methoden toe, of gebruik niet-parametrische methoden die geen aannames over de vorm maken. De verkeerde test levert niet altijd dramatisch foute antwoorden op, maar kan subtiel vertekende resultaten geven die lastig te detecteren zijn.
Conclusie
De lognormale verdeling modelleert positieve, rechts-scheve variabelen door ze via een logaritmetransformatie te verbinden met de normale verdeling. Zodra je herkent dat ln(X) normaal is wanneer X lognormaal is, volgt de rest. Je kunt in log-ruimte werken met standaard normale tools en de resultaten daarna terugvertalen naar de oorspronkelijke schaal.
We hebben de belangrijkste eigenschappen van de verdeling behandeld, ze teruggevoerd op die transformatie en bekeken waar ze in de praktijk voorkomt. De praktische les is eenvoudig: controleer op lognormaliteit voordat je positieve, rechts-scheve data modelleert. Plot de log-getransformeerde data, voer er een normaliteitstest op uit en bekijk een Q-Q-plot. Onze Introduction to Statistics in Python-cursus en de Probability Distributions in Python-tutorial zijn goede vervolgstappen als je deze ideeën toegepast op echte datasets wilt zien.




Denk aan inkomensgegevens. Een paar mensen verdienen miljoenen, de meesten zitten ergens in het midden, en de verdeling heeft een lange staart naar rechts. Zet dit af tegen een standaard klokvorm en niets komt overeen, omdat de normale verdeling hier slecht past.
De lognormale verdeling is gemaakt voor variabelen die strikt positief en rechts-scheef zijn, waarbij de spreiding toeneemt met de grootte van de waarde. Huishoudinkomen, aandelenkoersen, bestandsgroottes en biologische metingen gedragen zich allemaal zo.
We behandelen wat de lognormale verdeling is, hoe die zich verhoudt tot de normale verdeling, de belangrijkste eigenschappen en formule, wanneer je die gebruikt en hoe je die in echte data herkent, inclusief een paar veelvoorkomende fouten.
Wat is de lognormale verdeling?
Een toevalsvariabele volgt een lognormale verdeling als het natuurlijke logaritme ervan normaal verdeeld is.
Als X lognormaal verdeeld is, dan is ln(X) normaal. De naam komt hier rechtstreeks vandaan: log-normaal, een verdeling waarvan de log normaal is.
Twee dingen volgen meteen. Ten eerste zijn waarden altijd positief. Logaritmen zijn alleen gedefinieerd voor positieve getallen, dus lognormale variabelen kunnen nooit nul of negatief zijn. Ten tweede is de verdeling rechts-scheef. Er is een fysieke ondergrens bij nul maar geen bovengrens, wat betekent dat de rechterstaart veel verder doorloopt dan de linker.
De logaritmetransformatie is de sleutel die de twee verdelingen verbindt. Neem een lognormaal verdeelde variabele, pas op elke observatie een natuurlijke log toe, en het resultaat is normaal verdeelde data. Dat is meer dan een wiskundige curiositeit. Het maakt de lognormaal hanteerbaar. Alle statistische hulpmiddelen die voor de normale verdeling zijn gebouwd, worden beschikbaar zodra je je data hebt getransformeerd.
Lognormale verdeling vs. normale verdeling
Het meest directe verschil is de vorm. De normale verdeling is symmetrisch, met het gemiddelde, de mediaan en de modus op hetzelfde middelpunt. De lognormale verdeling is asymmetrisch, naar rechts scheef, met een lange rechterstaart. Het gemiddelde, de mediaan en de modus verschillen allemaal. Waarom, dat komt zo.
Ook het bereik van mogelijke waarden verschilt. Een normale verdeling loopt van min oneindig tot plus oneindig. Een lognormale verdeling is van onderen begrensd door nul en loopt onbeperkt omhoog. Dit maakt het het juiste model wanneer je variabele fysiek niet negatief kan zijn.
Eigenschap
Normale verdeling
Lognormale verdeling
Vorm
Symmetrische klokcurve
Rechts-scheef, lange rechterstaart
Symmetrie
Symmetrisch
Asymmetrisch
Mogelijke waarden
Alle reële getallen (−∞ tot +∞)
Strikt positief (0 tot +∞)
Gemiddelde = mediaan = modus?
Ja
Nee—alle drie verschillen
Typische toepassingen
Lengte, toetsscores, meetfout
Inkomen, aandelenkoersen, bestandsgroottes
Transformatierelatie
—
Als X lognormaal is, is ln(X) normaal
Die laatste rij is in de praktijk het belangrijkst. Het nemen van het logaritme van een lognormaal verdeelde variabele levert een normale verdeling op. Deze transformatie maakt de lognormaal nuttig. Het is niet alleen een beschrijving van scheve data, maar een model met een directe brug terug naar de normale wereld.
Eigenschappen van de lognormale verdeling
Er zijn een paar belangrijke eigenschappen van een lognormale verdeling die haar bijzonder maken.
Altijd positief met een lange rechterstaart
De lognormale verdeling levert alleen positieve waarden op. Als ln(X) normaal is, dan is X = e^(ln(X)) altijd positief, omdat exponenten altijd positief zijn. Er is een bodem bij nul, maar geen plafond. In combinatie met de rechtsscheefheid geeft dit de verdeling haar kenmerkende vorm: een scherpe stijging vanaf nul, een piek ergens links van het gemiddelde, en dan een lange aflopende staart.
Gemiddelde, mediaan en modus verschillen allemaal
De drie centrummaten vertellen verschillende verhalen. De modus (de meest voorkomende waarde) ligt het verst links. De mediaan (de middelste waarde) ligt hoger. Het gemiddelde (het rekenkundig gemiddelde) ligt nog hoger, omhooggetrokken door de rechterstaart. Bij inkomensdata ligt het gemiddelde huishoudinkomen aanzienlijk hoger dan de mediaan. Een paar zeer hoge verdieners verschuiven het gemiddelde, terwijl het midden van de verdeling onveranderd blijft. Daarom rapporteren economen doorgaans de mediaan als ze typische huishoudens beschrijven. De verkeerde centrummaatstaf kiezen is hier niet alleen slordige statistiek; het misleidt actief.
Onthoud dit bij de formule: μ en σ beschrijven de onderliggende normale verdeling van ln(X), niet het gemiddelde en de standaardafwijking van X zelf. Dat onderscheid verrast veel mensen.
De formule van de lognormale verdeling
De dichtheidsfunctie (PDF) van de lognormale verdeling is:
voor x > 0, waar:
μ en σ zijn niet het gemiddelde en de standaardafwijking van X zelf. Het zijn de parameters van ln(X). Het werkelijke gemiddelde van X is e(μ + σ²/2), wat verklaart waarom het rechts van de mediaan ligt. Als je in Python of R een lognormaal op data fit, handelen bibliotheekfuncties deze vertaling voor je af, maar het is de moeite waard te weten wat de parameters werkelijk voorstellen.
Wanneer gebruik je een lognormale verdeling?
De praktische test: als je variabele strikt positief is en het groeiproces multiplicatief in plaats van additief is, is de lognormaal waarschijnlijk een goede keuze.
Additieve processen produceren vaak normale verdelingen. Volgens de centrale limietstelling convergeren sommen van veel kleine willekeurige invloeden naar normaal. Multiplicatieve processen zijn anders. Als de waarde per periode de vorige waarde is vermenigvuldigd met een willekeurige factor (samengestelde rente, bacteriën die zich verdubbelen), is het resultaat over veel perioden lognormaal. Daarom komt de lognormaal zo vaak voor in financiën en biologie.
De lognormaal past bij variabelen zoals:
Als je niet zeker weet of de lognormaal geschikt is, behandelt onze cursus Feature Engineering for Machine Learning in Python logtransformaties uitgebreid, inclusief hoe je beoordeelt of een transformatie bij je data past.
Praktijkvoorbeelden van de lognormale verdeling
De lognormale verdeling komt voor in veel praktijksituaties, waarvan er hieronder een paar worden uitgelicht.
Inkomen en vermogen
Inkomensdata is het schoolvoorbeeld van lognormaal. De meeste mensen verdienen inkomens die clusteren in een gematigd bereik, maar er is geen bovengrens—een klein aantal individuen verdient ordes van grootte meer dan de mediaan. Plot ruwe huishoudinkomens en je krijgt een sterk rechts-scheve histogram; neem de log en het ziet er ruwweg normaal uit. Vermogensdata toont hetzelfde patroon, vaak met een nog uitgesprokener scheefheid.
Aandelenkoersen
Dagelijkse veranderingen in aandelenkoersen zijn in logtermen ongeveer normaal verdeeld, wat betekent dat het prijsniveau zelf over de tijd een lognormale verdeling volgt. Deze aanname ligt ten grondslag aan het Black-Scholes-model voor optieprijzen. Aandelenkoersen kunnen niet onder nul zakken, worden multiplicatief samengesteld en vertonen die kenmerkende rechterstaart.
Bestandsgroottes op internet
Bestandsgroottes beslaan een enorm bereik, van enkele kilobytes tot vele gigabytes, en de verdeling is sterk rechts-scheef. De lognormaal past hier goed, omdat bestandsgrootte van onderen begrensd is door nul en multiplicatief groeit. Webverkeersanalyse en netwerkengineering leunen hierop.
Biologische metingen
Concentraties van biologische stoffen (hormoonspiegels, verontreinigingsconcentraties in weefsel, microbiële aantallen) volgen vaak lognormale verdelingen. Biologische processen draaien vaak om verhoudingen en groeisnelheden in plaats van om additieve stappen. Latentietijden in medische studies laten hetzelfde patroon zien.
In elk van deze domeinen is de logica hetzelfde: een proces dat van nature multiplicatief is, begrensd bij nul en in staat om zeldzame extreme waarden te produceren, is een natuurlijke kandidaat voor lognormaal modelleren.
Lognormale verdeling in machine learning en data science
De lognormale verdeling duikt in machine learning op in een paar verschillende vormen, die elk net iets andere aanpak vragen.
Positieve continue variabelen modelleren
Wanneer een targetvariabele strikt positief en rechts-scheef is—woningprijzen, omzet, customer lifetime value—verbetert een logtransformatie vóór het modelleren de resultaten vaak aanzienlijk. Lineaire regressie gaat uit van normaal verdeelde residuen; een fit op ruwe lognormale data schendt die aanname. De oplossing: neem de log van de target, fit het model en exponentieer de voorspellingen terug naar de oorspronkelijke schaal. Eén kanttekening: het interpreteren van coëfficiënten in log-ruimte vraagt om zorg, omdat een eenheidsverhoging in een predictor nu overeenkomt met een multiplicatieve verandering op de oorspronkelijke schaal.
Feature engineering met logtransformaties
Rechtsscheve features log-transformeren voordat je ze aan schaalgevoelige modellen voert (lineaire/logistische regressie, k-means) verkleint de invloed van extreme waarden en maakt relaties lineairder. Dit is standaard preprocessing voor rechts-scheve continue features. De transformatie pakt uitschieters impliciet aan: een waarde die 100 keer de mediaan is in ruwe ruimte wordt ongeveer 4,6 eenheden boven de mediaan in logruimte.
Probabilistisch modelleren en simulatie
Sommige probabilistische modellen gebruiken de lognormale verdeling expliciet. In Bayesiaans modelleren is het een veelgebruikte prior voor parameters die positief moeten zijn. In simulaties modelleert ze grootheden zoals reparatietijden, schadebedragen en netwerkvertragingen, waar de multiplicatieve structuur overeenkomt met echte processen. Deze komen regelmatig voor in toegepast werk.
Hoe herken je een lognormale verdeling
Een histogram op het oog beoordelen is niet genoeg. Dit zijn de aanpakken die echt werken, in grofweg oplopende orde van strengheid.
Histogram en log-getransformeerd histogram
Begin met een histogram van de ruwe data. Als het rechts-scheef is met een lange rechterstaart en een ondergrens nabij nul, is dat veelzeggend. Plot vervolgens een histogram van de log-getransformeerde waarden. Als dat histogram ongeveer symmetrisch en klokvormig is, is de lognormaal een plausibel model. Deze twee-plotsvergelijking is snel. Maar stop hier niet.
Q-Q-plots
Een quantile-quantile (Q-Q)-plot vergelijkt de kwantielen van je data met de kwantielen van een theoretische verdeling. Voor lognormale data plot je de kwantielen van ln(X) tegen de kwantielen van een standaardnormaal. Punten die ongeveer op een rechte lijn vallen duiden op een goede fit. Systematische kromming, vooral in de staarten, suggereert dat de lognormaal niet helemaal klopt. Onze tutorial over Q-Q-plots laat zien hoe je ze leest en interpreteert in zowel Python als R.
Goodness-of-fit-tests
Voor een formele test pas je een normaliteitstest (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) toe op de log-getransformeerde data. Als ln(X) slaagt, heb je statistisch bewijs dat het lognormale model ondersteunt. Bij zeer grote datasets worden deze tests echter zo gevoelig dat ze lognormaliteit afwijzen om triviaal kleine afwijkingen. Combineer formele tests daarom altijd met visuele inspectie.
Alle drie de benaderingen samen geven je een veel betrouwbaarder beeld dan één methode alleen.
Veelgemaakte fouten bij werken met lognormale data
Een paar veelvoorkomende fouten die veel practitioners maken, lichten we hier uit.
Aannemen dat de data normaal verdeeld is
Dit is de meest voorkomende fout. Een normale verdeling fitten op lognormale data onderschat de kans op extreme waarden, vertekent schattingen van het gemiddelde en kan statistische tests onbetrouwbaar maken. Als je data positief en rechts-scheef is, controleer dit dan voordat je naar de normale verdeling grijpt.
Het rekenkundig gemiddelde verkeerd interpreteren
Bij lognormale data wordt het rekenkundig gemiddelde aanzienlijk boven de mediaan getrokken door de rechterstaart. Het gemiddelde als "typisch" rapporteren is misleidend. De mediaan is meestal een betere maat voor hoe een typische observatie eruitziet. Wees duidelijk welke maat je rapporteert en waarom.
Vergeten dat waarden positief moeten zijn
De lognormale verdeling is niet gedefinieerd voor nul of negatieve waarden. Als je dataset nullen bevat—veelvoorkomend in teldata of verkoopdata met inactieve periodes—is de lognormaal niet direct toepasbaar. Gebruikelijke workarounds zijn het toevoegen van een kleine constante vóór het loggen (statistisch niet ideaal) of een zero-inflated model dat de nullen apart behandelt.
Ongepaste statistische tests toepassen
Tests die zijn ontworpen voor normaal verdeelde data (t-toetsen, standaard betrouwbaarheidsintervallen, ANOVA) zijn niet direct van toepassing op lognormale data. Je hebt twee opties: log de data en pas normaal-gebaseerde methoden toe, of gebruik niet-parametrische methoden die geen aannames over de vorm maken. De verkeerde test levert niet altijd dramatisch foute antwoorden op, maar kan subtiel vertekende resultaten geven die lastig te detecteren zijn.
Conclusie
De lognormale verdeling modelleert positieve, rechts-scheve variabelen door ze via een logaritmetransformatie te verbinden met de normale verdeling. Zodra je herkent dat ln(X) normaal is wanneer X lognormaal is, volgt de rest. Je kunt in log-ruimte werken met standaard normale tools en de resultaten daarna terugvertalen naar de oorspronkelijke schaal.
We hebben de belangrijkste eigenschappen van de verdeling behandeld, ze teruggevoerd op die transformatie en bekeken waar ze in de praktijk voorkomt. De praktische les is eenvoudig: controleer op lognormaliteit voordat je positieve, rechts-scheve data modelleert. Plot de log-getransformeerde data, voer er een normaliteitstest op uit en bekijk een Q-Q-plot. Onze Introduction to Statistics in Python-cursus en de Probability Distributions in Python-tutorial zijn goede vervolgstappen als je deze ideeën toegepast op echte datasets wilt zien.