

在线运行和编辑此教程中的代码
运行代码均匀分布函数
或许最简单也最实用的分布之一就是均匀分布。连续型均匀分布的概率分布函数为:
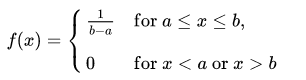
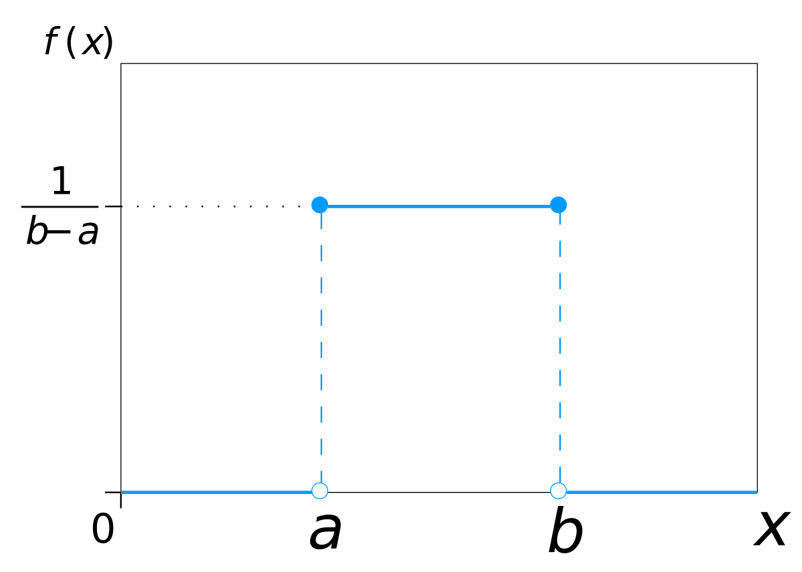
由于任意等宽区间被观察到的概率相同,描述该分布的曲线是一个矩形:在区间上高度为常数,其他地方高度为 0。因为曲线下的面积必须等于 1,区间的长度决定了曲线的高度。下图展示了区间 (a,b) 上的均匀分布。注意由于面积需要为 $1$,高度设为 $1/(b-a)$。
Python 中的均匀分布
您可以借助在区间 (a,b) 上取值的随机数生成器,在 Python 中可视化均匀分布。需要从 scipy.stats 模块导入 uniform 函数。
# import uniform distribution
from scipy.stats import uniform
uniform 函数通过其 loc 与 scale 参数在指定区间内生成连续的均匀随机变量。该分布在 loc 与 loc + scale 之间为常数。size 参数表示随机样本数量。若要保证结果可复现,可传入数值给 random_state 参数。
# random numbers from uniform distribution
n = 10000
start = 10
width = 20
data_uniform = uniform.rvs(size=n, loc = start, scale=width)
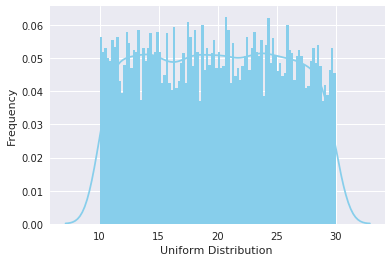
您可以使用 Seaborn 的 distplot 绘制刚创建分布的直方图。distplot 支持多个参数以自定义图形。首先创建一个绘图对象 ax。在这里,您可以指定直方图的 bins 数量、直方图的 color,并通过 kde 开启密度曲线,通过 hist_kws 设置线宽。还可以用 xlabel 与 ylabel 参数设置横纵轴标签。
ax = sns.distplot(data_uniform,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Uniform Distribution ', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Uniform Distribution ')]
正态分布函数
正态分布(又称高斯分布)在数据科学中无处不在。尤其在统计推断等主题中您会频繁遇到它。许多数据科学算法也将其作为假设之一。
正态分布具有由其均值 $μ$ 与标准差 $σ$ 描述的钟形密度曲线。密度曲线关于均值对称,分散程度由标准差决定,表明靠近均值的数据出现更频繁,远离均值的数据出现较少。均值为 $μ$、标准差为 $σ$ 的正态密度曲线在给定点 $x$ 处的概率分布函数为:
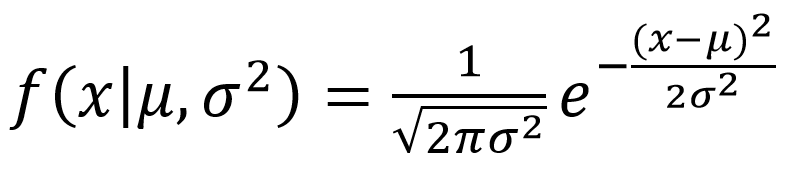
下图展示了该分布的形状:
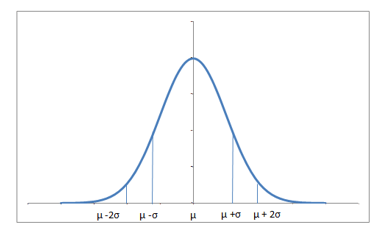
约有 68% 的数据落在均值两侧一个标准差范围内,95% 落在两个标准差范围内。还值得一提的是,均值为 $0$、标准差为 $1$ 的分布称为标准正态分布。
Python 中的正态分布
您可以使用 scipy.stats 模块的 norm.rvs() 方法生成服从正态分布的随机变量。loc 参数对应分布的均值,scale 对应标准差,size 对应随机样本数量。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import norm
# generate random numbers from N(0,1)
data_normal = norm.rvs(size=10000,loc=0,scale=1)
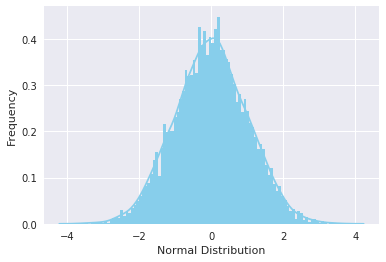
您可以像可视化均匀分布那样,使用 seaborn 的 distplot 来可视化该分布。参数含义与前一例相同。
ax = sns.distplot(data_normal,
bins=100,
kde=True,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Normal Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Normal Distribution')]
Gamma 分布函数
Gamma 分布是一类具有两个参数的连续概率分布。尽管其原始形式使用较少,但许多常用分布(如指数分布、卡方分布、Erlang 分布)都是 Gamma 分布的特例。Gamma 分布可用形状参数 $α = k$ 和逆尺度参数 $β = 1/θ$(也称速率参数)来参数化;符号 $Γ(n)$ 表示伽马函数,定义为 $(n-1)!$:
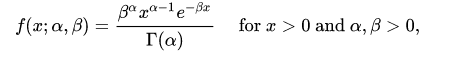
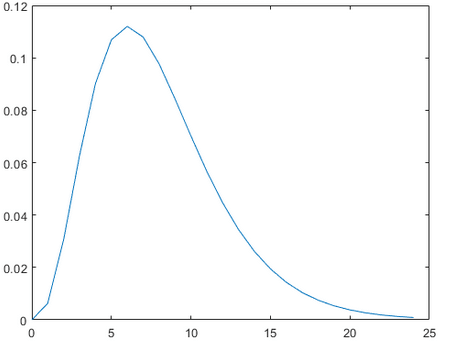
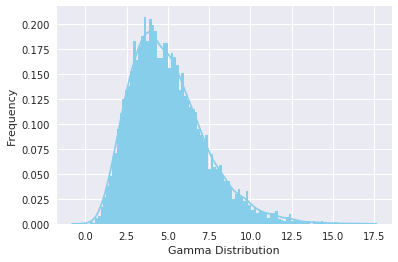
典型的 Gamma 分布形状如下:
Python 中的 Gamma 分布
您可以使用 scipy.stats 模块的 gamma.rvs() 方法生成服从 Gamma 分布的随机变量,该方法以形状参数 $a$ 作为参数。当 $a$ 为整数时,Gamma 分布退化为 Erlang 分布;当 $a=1$ 时为指数分布。通过 loc 参数可平移分布,通过 scale 参数可缩放分布,size 决定样本数量。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import gamma
data_gamma = gamma.rvs(a=5, size=10000)
您可以像在均匀分布部分所示那样,使用 seaborn 的 distplot 来可视化该分布。参数含义与均匀分布部分一致。
ax = sns.distplot(data_gamma,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Gamma Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Gamma Distribution')]
指数分布函数
指数分布描述了泊松过程事件之间的时间间隔,即事件以恒定的平均速率连续且独立地发生。它具有参数 $λ$(称为速率参数),其公式为:
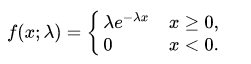
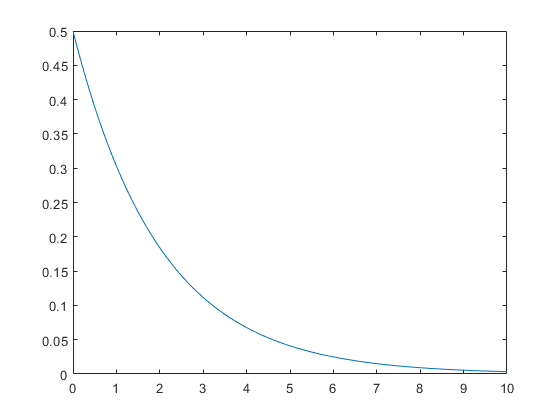
一个递减的指数分布如下所示:
Python 中的指数分布
您可以使用 scipy.stats 模块的 expon.rvs() 方法生成服从指数分布的随机变量。该方法以形状参数 scale 作为参数,即公式中的 1/lambda。通过 loc 参数可平移分布,size 决定样本数量。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import expon
data_expon = expon.rvs(scale=1,loc=0,size=1000)
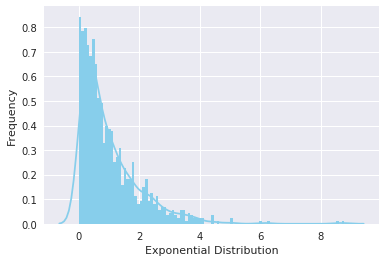
再次使用 seaborn 可视化该分布,将得到如下曲线:
ax = sns.distplot(data_expon,
kde=True,
bins=100,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Exponential Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Exponential Distribution')]
泊松分布
泊松随机变量通常用于建模在某个时间区间内事件发生的次数。例如,某段时间访问网站的用户数量可视为一个泊松过程。泊松分布用事件发生的速率($μ$)来描述。一个事件在区间内可能发生 0、1、2、… 次。区间内事件的平均发生次数记为 $λ$(lambda)。Lambda 是事件速率,也称速率参数。在区间内观察到 $k$ 次事件的概率为:
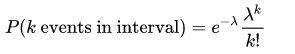
注意,当参数 $λ →∞$ 时,正态分布是泊松分布的极限情形。此外,若随机事件之间的间隔时间服从参数为 $λ$ 的指数分布,则长度为 $t$ 的时间段内事件总数服从参数为 $λt$ 的泊松分布。
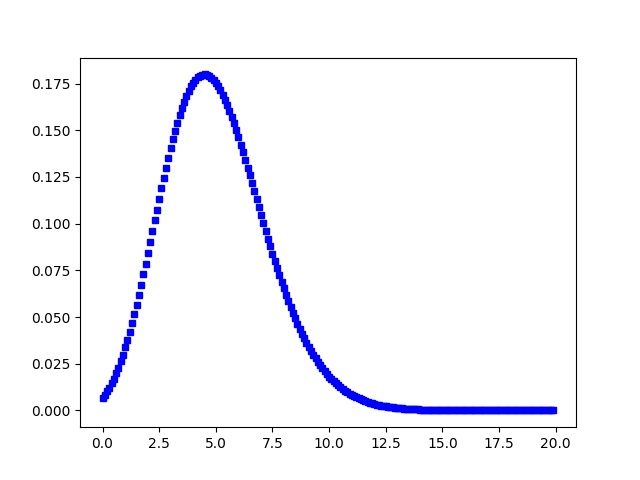
下图展示了典型的泊松分布:
Python 中的泊松分布
您可以使用 scipy.stats 模块的 poisson.rvs() 方法生成服从泊松分布的离散随机变量。该方法以 $μ$ 作为形状参数,即公式中的 $λ$。通过 loc 参数可平移分布,size 决定样本数量。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import poisson
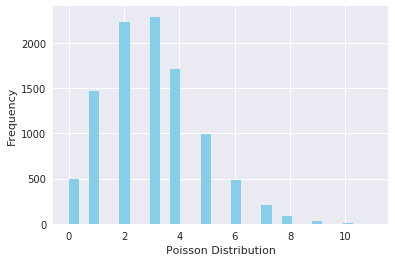
data_poisson = poisson.rvs(mu=3, size=10000)
您可以像可视化均匀分布那样,使用 seaborn 的 distplot 来可视化该分布。参数含义相同。
ax = sns.distplot(data_poisson,
bins=30,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Poisson Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Poisson Distribution')]
二项分布函数
当一次试验只有两种可能结果(如成功或失败、盈利或亏损、胜或负),且每次试验成功与失败的概率相同,则该分布称为二项分布。不过,结果不必等可能,且各次试验彼此独立。二项分布的参数为 $n$ 和 $p$,其中 $n$ 为试验总次数,$p$ 为每次试验成功的概率。其概率分布函数为:
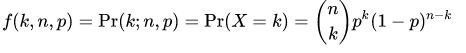
其中:
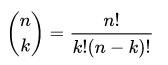
Python 中的二项分布
您可以使用 scipy.stats 模块的 binom.rvs() 方法生成服从二项分布的离散随机变量。该方法以 $n$(试验次数)与 $p$(成功概率)作为形状参数。通过 loc 参数可平移分布,size 决定重复试验的次数。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import binom
data_binom = binom.rvs(n=10,p=0.8,size=10000)
使用 seaborn 的 distplot 可视化该分布,会得到如下直方图:
ax = sns.distplot(data_binom,
kde=False,
color='skyblue',
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Binomial Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Binomial Distribution')]
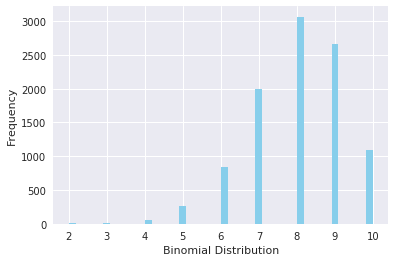
注意,由于成功概率大于 $0.5$,该分布向右偏斜。此外,在以下条件下,泊松分布是二项分布的极限情形:
- 试验次数无限大,即 $n → ∞$。
- 每次试验成功的概率相同且无限小,即 $p →0$。
- $np = λ$ 为有限常数。
在以下条件下,正态分布是二项分布的另一种极限形式:
- 试验次数无限大,$n → ∞$。
- $p$ 与 $q$ 均非无限小。
伯努利分布函数
伯努利分布只有两种可能结果,即 $1$(成功)与 $0$(失败),且只有一次试验,例如一次抛硬币。因此,服从伯努利分布的随机变量 $X$ 以成功概率 $p$ 取值 $1$,以失败概率 $q$ 或 $1-p$ 取值 $0$。成功与失败的概率不必等可能。伯努利分布是二项分布在单次试验($n=1$)情形下的特例。其概率质量函数为:
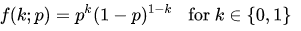
Python 中的伯努利分布
您可以使用 scipy.stats 模块的 bernoulli.rvs() 方法生成服从伯努利分布的离散随机变量。该方法以 $p$(成功概率)作为形状参数。通过 loc 参数可平移分布,size 决定重复试验的次数。若要保证结果可复现,可传入数值给 random_state 参数。
from scipy.stats import bernoulli
data_bern = bernoulli.rvs(size=10000,p=0.6)
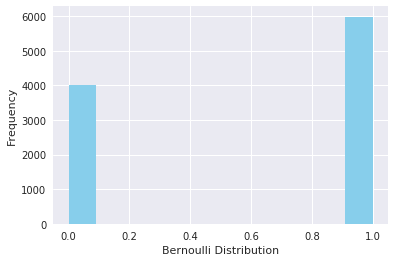
再次对该分布进行可视化,您会看到只有两种可能结果:
ax= sns.distplot(data_bern,
kde=False,
color="skyblue",
hist_kws={"linewidth": 15,'alpha':1})
ax.set(xlabel='Bernoulli Distribution', ylabel='Frequency')
[Text(0,0.5,u'Frequency'), Text(0.5,0,u'Bernoulli Distribution')]
结语
恭喜您读完本教程!在本教程中,您了解了几种常用概率分布,并学习了如何在 Python 中创建并绘制它们。虽然还有许多其他分布有待探索,但这些内容足以帮助您入门。别忘了查看 Python 的 scipy 库,它还提供了许多有趣的统计功能。祝您探索愉快!
如果您想进一步学习 Python 中的概率,请参加 DataCamp 的 Statistical Simulation in Python 课程。
查看我们的 Poker Probability and Statistics with Python 教程。
简介
概率与统计是数据科学的基石。事实上,机器学习与人工智能的底层原理离不开数理统计与线性代数。在数据科学中,您常常会遇到需要阅读包含大量数学内容的研究论文,以便理解某个特定主题。因此,如果您想提升数据科学能力,扎实的数学功底至关重要。本教程将介绍机器学习文献中常用的概率分布。如果您是初学者,这里就是理想的起点。在本教程中,您将:
在开始之前,您需要熟悉一些数学术语,下一节将对此进行介绍。
随机变量
随机变量是其可能取值为随机现象数值结果的变量。随机变量分为两类:离散型和连续型。
离散型随机变量只能取可数个不同的值,因此可以量化。举例来说,您可以将随机变量 $X$ 定义为掷一枚公平骰子时出现的点数。$X$ 可取值为 $[1,2,3,4,5,6]$,因此是离散型随机变量。
离散型随机变量的概率分布是该变量每个可能取值对应的概率列表,有时也称为概率函数或概率质量函数。形式化地,设随机变量 $X$ 可取 $k$ 个不同的值,且 $X = x_{i}$ 的概率为 $P(X = x_{i}) = p_{i}$。则这些概率 $p_{i}$ 必须满足:
1:对每个 $i$,0 < $p_{i}$ < 1
2:$p_{1} + p_{2} + ... + p_{k} = 1$。
常见的离散型概率分布包括伯努利分布、二项分布、泊松分布等。
连续型随机变量可以取无限多个可能值。比如,您可以将随机变量 $X$ 定义为某个班级学生的身高。由于连续型随机变量是在一个区间上定义的,通常用曲线下的面积(或积分)来表示。
连续型随机变量的概率分布称为概率分布函数,其取值是连续的。观察到任一单个值的概率等于 $0$,因为随机变量可能取值的数量是无限的。举例来说,随机变量 $X$ 可以在实数区间上取所有值。则 $X$ 落在结果集合 $A$ 中的概率 $P(A)$ 定义为 $A$ 上方且曲线下方的面积。该曲线表示函数 $p(x)$,并需满足:
1:曲线没有负值(对所有 $x$ 有 $(p(x) > 0$)
2:曲线下的总面积等于 $1$。
满足这些条件的曲线通常称为密度曲线。常见的连续型概率分布包括正态分布、指数分布、Beta 分布等。
还有一种在文献中经常出现、值得了解的分布,称为累计分布函数。所有随机变量(离散与连续)都有累计分布函数。它给出对于每个 $x$,随机变量 $X$ 小于或等于 $x$ 的概率。对于离散型随机变量,累计分布函数通过对概率求和得到。
下一节中,您将探讨一些重要分布,并尝试在 Python 中实现它们。在此之前,先导入将要用到的所有必要库。