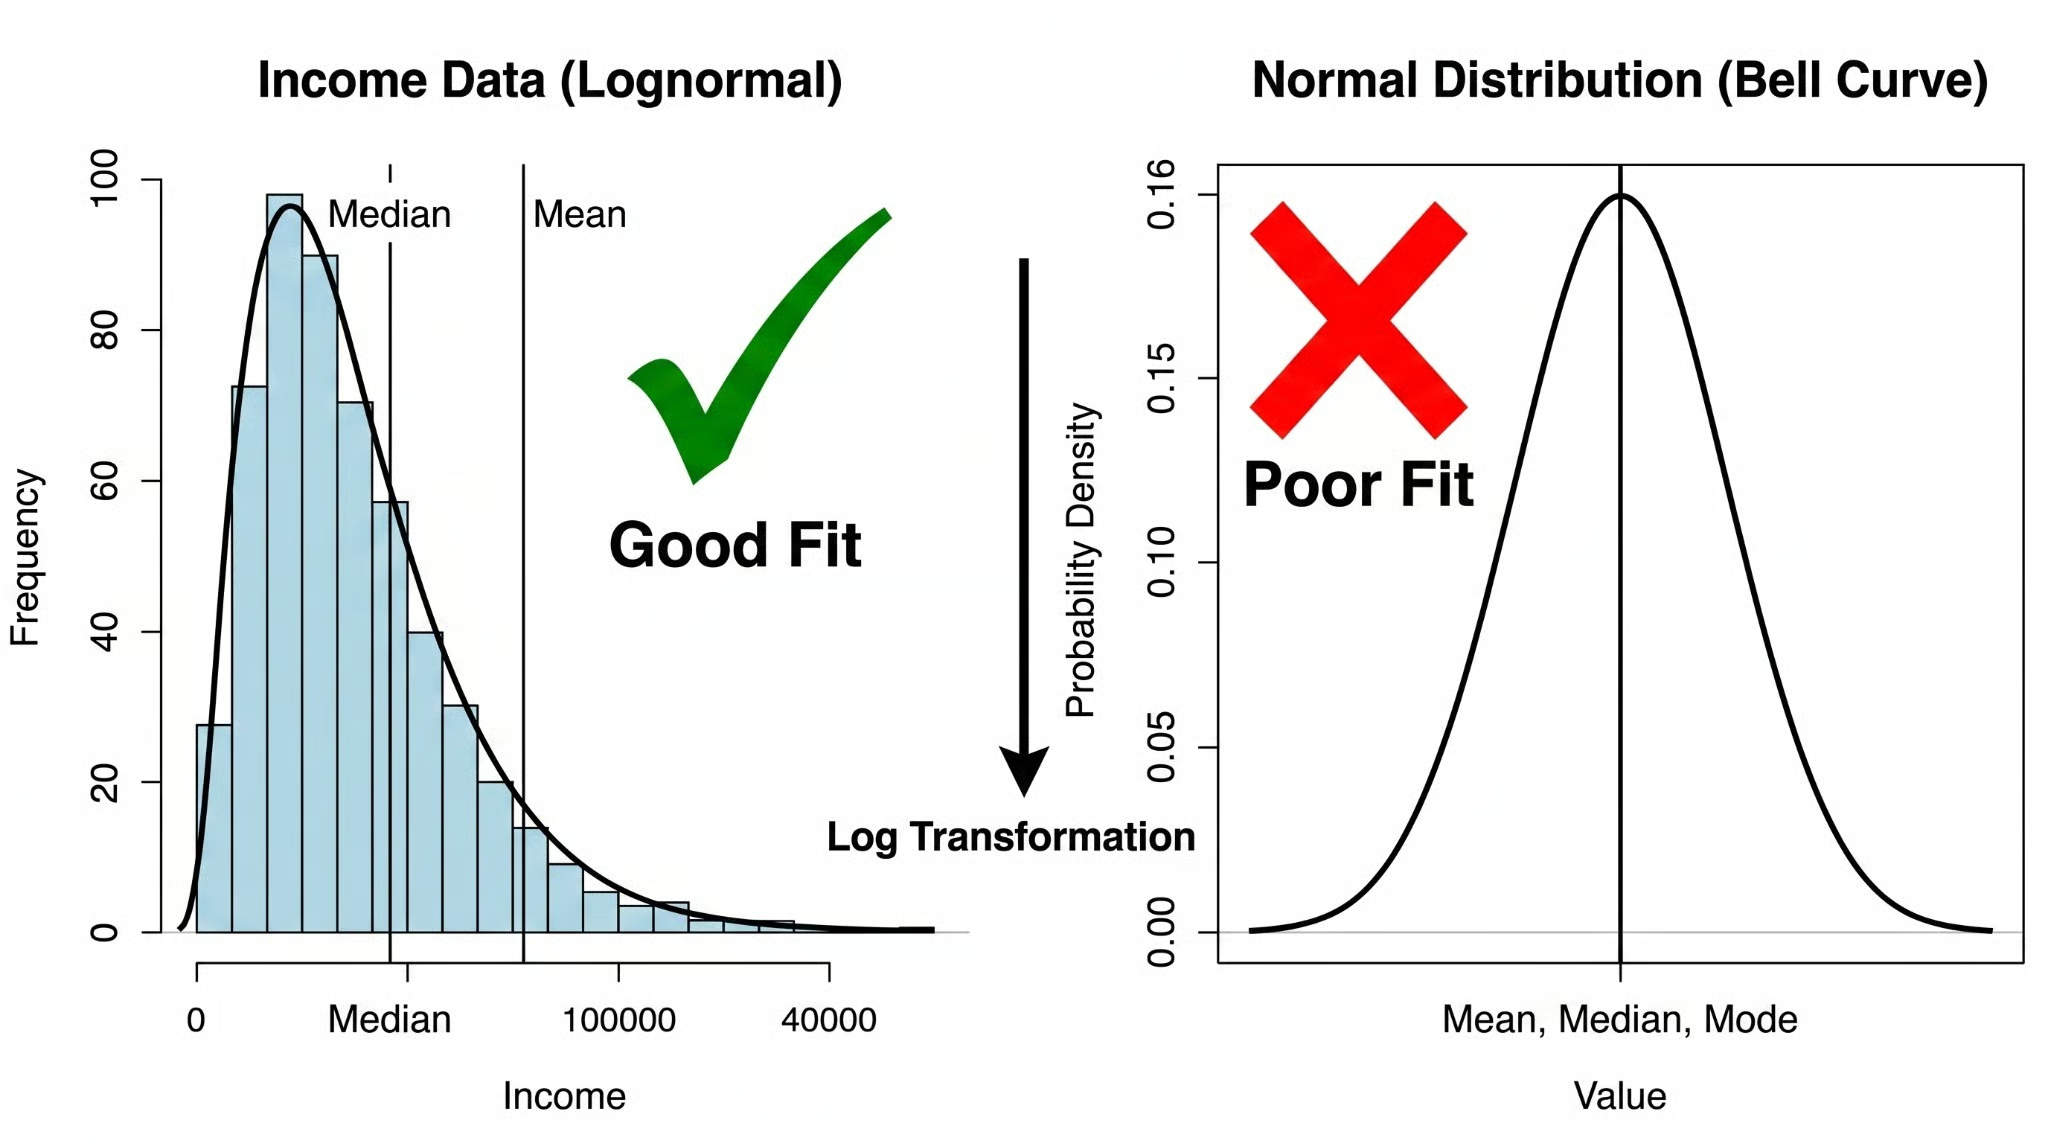
Denk an Einkommensdaten. Einige wenige verdienen Millionen, die meisten liegen irgendwo in der Mitte, und die Verteilung hat einen langen rechten Schwanz. Legst du das auf die Standard-Glockenkurve, passt es nicht zusammen, denn die Normalverteilung eignet sich hier schlecht.
Die Lognormalverteilung ist gemacht für Variablen, die strikt positiv und rechtsschief sind, bei denen die Streuung mit der Höhe des Werts wächst. Haushaltseinkommen, Aktienkurse, Dateigrößen und biologische Messungen verhalten sich genau so.
Wir erklären, was die Lognormalverteilung ist, wie sie sich von der Normalverteilung unterscheidet, ihre wichtigsten Eigenschaften und die Formel, wann du sie einsetzen solltest und wie du sie in echten Daten erkennst – inklusive typischer Fallstricke.
Was ist die Lognormalverteilung?
Eine Zufallsvariable folgt einer Lognormalverteilung, wenn ihr natürlicher Logarithmus normalverteilt ist.
Wenn X lognormalverteilt ist, ist ln(X) normalverteilt. Der Name ist wörtlich: log-normal – eine Verteilung, deren Logarithmus normal ist.
Daraus folgen zwei Dinge sofort. Erstens sind Werte immer positiv. Logarithmen sind nur für positive Zahlen definiert, daher kann eine lognormal verteilte Variable nie null oder negativ sein. Zweitens ist die Verteilung rechtsschief. Es gibt eine untere physikalische Grenze bei null, aber keine obere, weshalb der rechte Schwanz deutlich weiter reicht als der linke.
Die Logarithmen-Transformation ist die Verbindung zwischen beiden Verteilungen. Nimm eine lognormal verteilte Variable, bilde für jede Beobachtung den natürlichen Logarithmus, und das Ergebnis ist normalverteiltes Datenmaterial. Das ist mehr als eine mathematische Kuriosität. Es macht die Lognormalverteilung handhabbar: Alles statistische Handwerkszeug für die Normalverteilung steht dir nach der Transformation zur Verfügung.
Lognormalverteilung vs. Normalverteilung
Der unmittelbarste Unterschied ist die Form. Die Normalverteilung ist symmetrisch; Mittelwert, Median und Modus liegen im selben Zentrum. Die Lognormalverteilung ist asymmetrisch, nach rechts verzerrt, mit langem rechtem Schwanz. Mittelwert, Median und Modus unterscheiden sich – warum, dazu gleich mehr.
Auch der Wertebereich ist anders. Eine Normalverteilung reicht von minus unendlich bis plus unendlich. Eine Lognormalverteilung ist nach unten durch null begrenzt und nach oben unbeschränkt. Das macht sie zum passenden Modell, wann immer deine Variable physisch nicht negativ sein kann.
|
Eigenschaft |
Normalverteilung |
Lognormalverteilung |
|
Form |
Symmetrische Glockenkurve |
Rechtsschief, langer rechter Schwanz |
|
Symmetrie |
Symmetrisch |
Asymmetrisch |
|
Mögliche Werte |
Alle reellen Zahlen (−∞ bis +∞) |
Strikt positiv (0 bis +∞) |
|
Mean = Median = Modus? |
Ja |
Nein — alle drei unterscheiden sich |
|
Typische Anwendungen |
Körpergröße, Testergebnisse, Messfehler |
Einkommen, Aktienkurse, Dateigrößen |
|
Transformationsbezug |
— |
Wenn X lognormal ist, ist ln(X) normal |
Die letzte Zeile ist in der Praxis entscheidend. Der Logarithmus einer lognormal verteilten Variable ergibt eine Normalverteilung. Diese Transformation macht die Lognormalverteilung nützlich: Sie ist nicht nur eine Beschreibung schiefer Daten, sondern ein Modell mit direkter Brücke zurück zur Normalverteilung.
Eigenschaften der Lognormalverteilung
Es gibt ein paar zentrale Eigenschaften, die die Lognormalverteilung auszeichnen.
Immer positiv mit langem rechten Schwanz
Die Lognormalverteilung liefert nur positive Werte. Wenn ln(X) normal ist, ist X = e^(ln(X)) immer positiv, da Exponentialfunktionen stets positiv sind. Es gibt einen Boden bei null, aber keine Decke. Zusammen mit der Rechtsschiefe entsteht die typische Form: ein steiler Anstieg ab null, ein Peak links vom Mittelwert und dann ein lang auslaufender Schwanz.
Mittelwert, Median und Modus sind verschieden
Die drei Lagemaße erzählen Unterschiedliches. Der Modus (der häufigste Wert) liegt am weitesten links. Der Median (der mittlere Wert) ist höher. Der Mittelwert (das arithmetische Mittel) liegt noch weiter rechts, nach oben gezogen durch den rechten Schwanz. Bei Einkommen ist das durchschnittliche Haushaltseinkommen deutlich höher als der Median. Einige sehr hohe Einkommen heben den Durchschnitt an, ohne die Mitte der Verteilung zu verändern. Deshalb berichten Ökonominnen und Ökonomen typischerweise den Median, wenn sie „typische“ Haushalte beschreiben. Hier das falsche Lagemaß zu wählen, ist nicht nur schlampig, es führt in die Irre.
Merke: μ und σ beschreiben die zugrunde liegende Normalverteilung von ln(X), nicht den Mittelwert und die Standardabweichung von X selbst. Diese Unterscheidung überrascht viele.
Die Formel der Lognormalverteilung
Die Wahrscheinlichkeitsdichtefunktion (PDF) der Lognormalverteilung lautet:

für x > 0, wobei gilt:
- x ist der Wert der Zufallsvariable (muss positiv sein)
- μ (mu) ist der Mittelwert von ln(X). Er steuert die Lage der Verteilung — ein höheres μ verschiebt den Gipfel nach rechts.
- σ (sigma) ist die Standardabweichung von ln(X). Sie steuert Streuung und Schiefe. Ein größeres σ erzeugt einen schwereren rechten Schwanz.
μ und σ sind nicht der Mittelwert und die Standardabweichung von X selbst. Es sind die Parameter von ln(X). Der tatsächliche Mittelwert von X ist e(μ + σ²/2) — deshalb liegt er rechts vom Median. Wenn du in Python oder R eine Lognormalverteilung an Daten anpasst, übernehmen Bibliotheksfunktionen diese Umrechnung für dich. Es lohnt sich aber zu wissen, wofür die Parameter stehen.
Wann solltest du eine Lognormalverteilung verwenden?
Der Praxistest: Ist deine Variable strikt positiv und ist der Wachstumsprozess multiplikativ statt additiv, ist die Lognormalverteilung wahrscheinlich eine gute Wahl.
Additive Prozesse führen häufig zur Normalverteilung. Nach dem zentralen Grenzwertsatz konvergieren Summen vieler kleiner Zufallseffekte zur Normalverteilung. Multiplikative Prozesse sind anders. Wenn jeder Periodenwert der vorherige Wert multipliziert mit einem Zufallsfaktor ist (Zinseszins, Bakterienverdopplung), ist das Ergebnis über viele Perioden lognormal. Deshalb taucht die Lognormalverteilung so oft in Finanz- und Biowissenschaften auf.
Die Lognormalverteilung passt zu Variablen wie:
- Finanzrenditen über lange Horizonte — tägliche log-Renditen werden multiplikativ verzinst
- Versicherungsschäden — die meisten sind klein, einige sehr groß
- Einkommensverteilungen — nach unten durch null begrenzt, in der Praxis rechtsschief
- Biologisches Wachstum — Organismengröße, Zellzahlen, Konzentrationsmessungen
- Wartezeiten — Reparaturzeiten und Service-Dauern mit gelegentlichen Ausreißern
- Umweltmessungen — Schadstoffkonzentrationen in Wasser oder Luft
Wenn du unsicher bist, ob die Lognormalverteilung passt: Unser Kurs Feature Engineering for Machine Learning in Python behandelt Log-Transformationen ausführlich, inklusive der Frage, wann eine Transformation zu deinen Daten passt.
Beispiele aus der Praxis für die Lognormalverteilung
Die Lognormalverteilung taucht in vielen realen Szenarien auf, einige davon sind hier hervorgehoben.
Einkommen und Vermögen
Einkommensdaten sind das klassische Beispiel. Die meisten Menschen verdienen in einem moderaten Bereich, aber es gibt keine Obergrenze — eine kleine Gruppe verdient Größenordnungen mehr als der Median. Roh geplottet ergibt sich ein stark rechtsschiefes Histogramm; nach Log-Transformation wirkt es ungefähr normal. Vermögensdaten zeigen dasselbe Muster, oft mit noch stärkerer Schiefe.
Aktienkurse
Tägliche Kursänderungen sind in Log-Begriffen näherungsweise normalverteilt, was bedeutet, dass das Kursniveau über die Zeit lognormal verteilt ist. Diese Annahme liegt dem Black-Scholes-Optionspreismodell zugrunde. Aktienkurse können nicht unter null fallen, sie wachsen multiplikativ und erzeugen den charakteristischen rechten Schwanz.
Internet-Dateigrößen
Dateigrößen reichen von wenigen Kilobyte bis zu vielen Gigabyte und sind stark rechtsschief verteilt. Die Lognormalverteilung passt hier gut, weil die Größe unten durch null begrenzt ist und sich multiplikativ entwickelt. Web-Traffic-Analysen und Netzwerktechnik stützen sich darauf.
Biologische Messungen
Konzentrationen biologischer Substanzen (Hormonspiegel, Schadstoffkonzentrationen im Gewebe, Keimzahlen) folgen tendenziell Lognormalverteilungen. Biologische Prozesse beinhalten oft Verhältnisse und Wachstumsraten statt additiver Zuwächse. Latenzzeiten in medizinischen Studien zeigen dasselbe Muster.
In all diesen Bereichen ist die Logik dieselbe: Ein Prozess, der von Natur aus multiplikativ ist, bei null begrenzt ist und seltene Extremwerte erzeugen kann, ist ein natürlicher Kandidat für die Lognormal-Modellierung.
Lognormalverteilung in Machine Learning und Data Science
Die Lognormalverteilung taucht im Machine Learning auf verschiedene Weise auf, was jeweils eine leicht unterschiedliche Handhabung erfordert.
Modellierung positiver kontinuierlicher Variablen
Wenn eine Zielvariable strikt positiv und rechtsschief ist – Immobilienpreise, Umsatz, Customer Lifetime Value – verbessert eine Log-Transformation vor der Modellierung die Ergebnisse oft erheblich. Lineare Regression setzt normalverteilte Residuen voraus; die Anpassung an rohe lognormal verteilte Daten verletzt diese Annahme. Die Lösung: Logarithmiere das Ziel, fitte das Modell und exponentiere die Vorhersagen zurück auf die ursprüngliche Skala. Ein Vorbehalt: Die Interpretation von Koeffizienten im Log-Raum erfordert Sorgfalt, da ein Einheitsanstieg eines Prädiktors nun einer multiplikativen Änderung auf der ursprünglichen Skala entspricht.
Feature Engineering mit Log-Transformationen
Die Log-Transformation schiefer Features vor der Eingabe in skalenempfindliche Modelle (lineare Regression, logistische Regression, k-Means) reduziert den Einfluss extremer Werte und macht Beziehungen linearer. Dies ist Standard-Preprocessing für rechtsschiefe kontinuierliche Features. Die Transformation behandelt Ausreißer implizit: Ein Wert, der im Rohraum das 100-Fache des Medians beträgt, liegt im Log-Raum nur etwa 4,6 Einheiten über dem Median.
Probabilistische Modellierung und Simulation
Einige probabilistische Modelle nutzen die Lognormalverteilung explizit. In der Bayes-Modellierung ist sie ein häufiger Prior für Parameter, die positiv sein müssen. In der Simulation modelliert sie Größen wie Reparaturzeiten, Schadenshöhen oder Netzwerkverzögerungen, bei denen die multiplikative Struktur reale Prozesse widerspiegelt. Diese tauchen regelmäßig in der angewandten Arbeit auf.
Wie man eine Lognormalverteilung erkennt
Ein Histogramm nur anzuschauen reicht nicht. Hier sind Ansätze, die tatsächlich funktionieren, in aufsteigender Reihenfolge ihrer Strenge.
Histogramm und log-transformiertes Histogramm
Beginne mit einem Histogramm der Rohdaten. Ist es rechtsschief mit langem rechten Schwanz und einer unteren Grenze nahe null, ist das ein Hinweis. Plotte dann ein Histogramm der log-transformierten Werte. Sieht dieses Histogramm annähernd symmetrisch und glockenförmig aus, ist die Lognormalverteilung ein plausibles Modell. Dieser Vergleich zweier Plots ist schnell. Aber bleib nicht dabei stehen.
Q-Q-Plots
Ein Quantil-Quantil-Plot (Q-Q-Plot) vergleicht die Quantile deiner Daten mit denen einer theoretischen Verteilung. Für lognormale Daten plottest du die Quantile von ln(X) gegen die Quantile einer Standardnormalverteilung. Punkte, die annähernd auf einer geraden Linie liegen, deuten auf eine gute Anpassung hin. Systematische Krümmungen, besonders in den Schwänzen, legen nahe, dass die Lognormalverteilung nicht ganz passt. Unser Tutorial zu Q-Q-Plots erklärt, wie man sie in Python und R liest und interpretiert.
Goodness-of-Fit-Tests
Für einen formalen Test wende einen Normalitätstest (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) auf die log-transformierten Daten an. Besteht ln(X) den Test, hast du statistische Belege für das Lognormal-Modell. Bei sehr großen Datensätzen werden diese Tests jedoch so empfindlich, dass sie Lognormalität schon bei trivial kleinen Abweichungen ablehnen. Kombiniere formale Tests immer mit visueller Inspektion.
Die Nutzung aller drei Ansätze zusammen liefert ein viel zuverlässigeres Bild als jede Methode allein.
Häufige Fehler bei der Arbeit mit Lognormal-Daten
Einige häufige Fehler, die viele Praktiker machen, sind hier hervorgehoben.
Annahme, die Daten seien normalverteilt
Dies ist der häufigste Fehler. Die Anpassung einer Normalverteilung an lognormale Daten unterschätzt die Wahrscheinlichkeit extremer Werte, verzerrt Mittelwertschätzungen und kann statistische Tests unzuverlässig machen. Wenn deine Daten positiv und rechtsschief sind, prüfe das, bevor du zur Normalverteilung greifst.
Falsche Interpretation des arithmetischen Mittels
Bei lognormalen Daten wird das arithmetische Mittel durch den rechten Schwanz deutlich über den Median gezogen. Den Mittelwert als „typisch“ zu bezeichnen, ist irreführend. Der Median ist meist das bessere Maß dafür, wie eine typische Beobachtung aussieht. Sei klar darüber, welches Maß du berichtest und warum.
Vergessen, dass Werte positiv sein müssen
Die Lognormalverteilung ist für null oder negative Werte nicht definiert. Wenn dein Datensatz Nullen enthält – häufig bei Zähldaten oder Verkaufsdaten mit inaktiven Perioden –, ist die Lognormalverteilung nicht direkt anwendbar. Gängige Workarounds sind das Addieren einer kleinen Konstante vor dem Logarithmieren (statistisch nicht ideal) oder die Verwendung eines Zero-Inflated-Modells, das Nullen separat behandelt.
Anwendung ungeeigneter statistischer Tests
Tests für normalverteilte Daten (t-Tests, Standard-Konfidenzintervalle, ANOVA) gelten nicht direkt für lognormale Daten. Du hast zwei Optionen: Logarithmiere die Daten und wende normalbasierte Methoden an oder nutze nicht-parametrische Methoden, die keine Annahmen über die Form machen. Der falsche Test liefert nicht immer dramatisch falsche Antworten, aber er kann subtil verzerrte Ergebnisse liefern, die schwer zu erkennen sind.
Fazit
Die Lognormalverteilung modelliert positive, rechtsschiefe Variablen, indem sie diese durch eine Logarithmus-Transformation mit der Normalverteilung verbindet. Sobald du erkennst, dass ln(X) normal ist, wenn X lognormal ist, folgt der Rest. Du kannst im Log-Raum mit Standard-Normal-Tools arbeiten und die Ergebnisse dann auf die ursprüngliche Skala zurückübersetzen.
Wir haben die wichtigsten Eigenschaften der Verteilung behandelt, sie auf diese Transformation zurückgeführt und uns angesehen, wo sie in der Praxis auftaucht. Die praktische Erkenntnis ist einfach: Bevor du positive, rechtsschiefe Daten modellierst, prüfe auf Lognormalität. Plotte die log-transformierten Daten, führe einen Normalitätstest durch und schau dir einen Q-Q-Plot an. Unser Introduction to Statistics in Python Kurs und das Probability Distributions in Python Tutorial sind gute nächste Schritte, wenn du sehen willst, wie diese Ideen auf echte Datensätze angewendet werden.