Pensa ai dati sul reddito. Alcune persone guadagnano milioni, la maggior parte è da qualche parte nel mezzo, e la distribuzione ha una lunga coda verso destra. Se la sovrapponi a una classica curva a campana, non coincide, perché la distribuzione normale si adatta male.
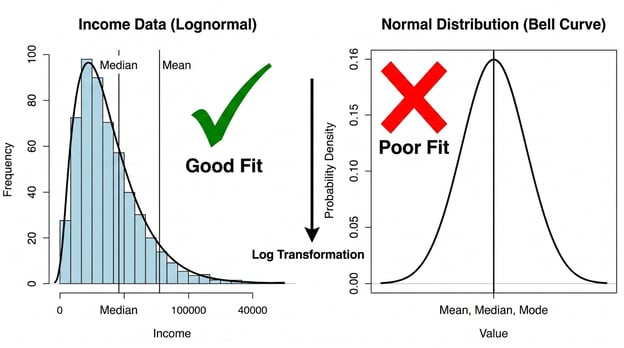
La distribuzione lognormale è fatta per variabili strettamente positive e asimmetriche a destra, in cui la dispersione cresce con la dimensione del valore. Reddito familiare, prezzi azionari, dimensioni dei file e misurazioni biologiche si comportano tutti in questo modo.
Vedremo cos'è la distribuzione lognormale, come si confronta con la distribuzione normale, le sue proprietà chiave e la formula, quando usarla e come riconoscerla nei dati reali, incluse alcune insidie comuni.
Che cos'è la distribuzione lognormale?
Una variabile aleatoria segue una distribuzione lognormale se il suo logaritmo naturale è distribuito normalmente.
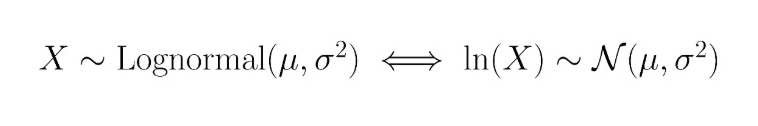
Se X è lognormalmente distribuita, allora ln(X) è normale. Il nome deriva direttamente da questo: log-normale, una distribuzione il cui logaritmo è normale.
Due conseguenze immediate. Primo, i valori sono sempre positivi. I logaritmi sono definiti solo per numeri positivi, quindi le variabili lognormali non possono mai essere zero o negative. Secondo, la distribuzione è asimmetrica a destra. Esiste un limite inferiore fisico a zero ma nessun limite superiore, il che significa che la coda destra si estende molto più della sinistra.
La trasformazione logaritmica è la chiave che collega le due distribuzioni. Prendi una variabile lognormalmente distribuita, applica un logaritmo naturale a ogni osservazione e il risultato sono dati distribuiti normalmente. Non è solo una curiosità matematica. È ciò che rende trattabile la lognormale. Tutta la strumentazione statistica costruita per la distribuzione normale diventa disponibile una volta trasformati i dati.
Distribuzione lognormale vs distribuzione normale
La differenza più immediata è la forma. La distribuzione normale è simmetrica, con media, mediana e moda tutte nello stesso punto centrale. La distribuzione lognormale è asimmetrica, con asimmetria a destra e una lunga coda destra. Media, mediana e moda sono tutte diverse. Vedremo perché nella prossima sezione.
Anche l'intervallo dei valori possibili è diverso. Una distribuzione normale si estende da meno infinito a più infinito. Una lognormale è limitata inferiormente da zero e si estende verso l'alto senza limite. Questo la rende il modello giusto ogni volta che la tua variabile fisicamente non può essere negativa.
|
Proprietà
|
Distribuzione normale
|
Distribuzione lognormale
|
|
Forma
|
Curva a campana simmetrica
|
Asimmetrica a destra, lunga coda destra
|
|
Simmetria
|
Simmetrica
|
Asimmetrica
|
|
Valori possibili
|
Tutti i numeri reali (−∞ a +∞)
|
Strettamente positivi (0 a +∞)
|
|
Media = mediana = moda?
|
Sì
|
No—tutte e tre differiscono
|
|
Applicazioni tipiche
|
Altezza, punteggi dei test, errore di misura
|
Reddito, prezzi azionari, dimensioni dei file
|
|
Relazione di trasformazione
|
—
|
Se X è lognormale, ln(X) è normale
|
L'ultima riga conta di più nella pratica. Prendere il logaritmo di una variabile lognormalmente distribuita produce una distribuzione normale. Questa trasformazione è ciò che rende utile la lognormale. Non è solo una descrizione di dati asimmetrici, è un modello con un ponte diretto verso il mondo normale.
Proprietà della distribuzione lognormale
Ci sono un paio di proprietà chiave di una distribuzione lognormale che la rendono speciale.
Sempre positiva con una lunga coda destra
La distribuzione lognormale produce solo valori positivi. Se ln(X) è normale, allora X = e^(ln(X)) è sempre positiva, poiché le esponenziali sono sempre positive. C'è un pavimento a zero, ma nessun soffitto. Insieme all'asimmetria a destra, questo conferisce alla distribuzione la sua forma caratteristica: una salita ripida da zero, un picco da qualche parte a sinistra della media, poi una lunga coda che degrada lentamente.
Le tre misure di tendenza centrale raccontano storie diverse. La moda (il valore più comune) è la più a sinistra. La mediana (il valore centrale) è più in alto. La media (la media aritmetica) è ancora più in alto, trascinata verso l'alto dalla coda destra. Nei dati sul reddito, il reddito medio familiare è sostanzialmente più alto della mediana. Pochi redditi molto alti spostano la media senza toccare il centro della distribuzione. Ecco perché gli economisti in genere riportano la mediana del reddito quando descrivono le famiglie tipiche. Scegliere la misura sbagliata della tendenza centrale qui non è solo statistica approssimativa; è fuorviante.
Tieni questo a mente quando arriveremo alla formula: μ e σ descrivono la distribuzione normale sottostante di ln(X), non la media e la deviazione standard di X stessa. Questa distinzione coglie di sorpresa molte persone.
La funzione di densità di probabilità (PDF) della distribuzione lognormale è:
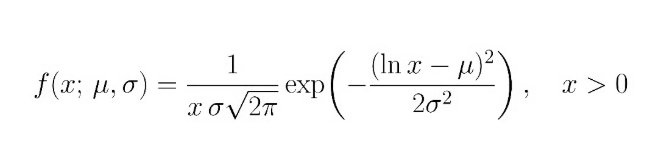
per x > 0, dove:
- x è il valore della variabile aleatoria (deve essere positivo)
- μ (mu) è la media di ln(X). Controlla la posizione della distribuzione—spostare μ verso l'alto muove il picco a destra.
- σ (sigma) è la deviazione standard di ln(X). Controlla la dispersione e il grado di asimmetria. Un σ più grande produce una coda destra più pesante.
μ e σ non sono la media e la deviazione standard di X stessa. Sono i parametri di ln(X). La media effettiva di X è e(μ + σ²/2), motivo per cui si colloca a destra della mediana. Se stai adattando una lognormale ai dati in Python o R, le funzioni delle librerie gestiscono loro questa traduzione, ma vale la pena sapere cosa rappresentano davvero i parametri.
Quando dovresti usare una distribuzione lognormale?
Il test pratico: se la tua variabile è strettamente positiva e il processo di crescita è moltiplicativo piuttosto che additivo, la lognormale è probabilmente un buon adattamento.
I processi additivi tendono a produrre distribuzioni normali. Per il teorema del limite centrale, le somme di molti piccoli effetti casuali convergono alla normale. I processi moltiplicativi sono diversi. Quando il valore di ogni periodo è il valore del periodo precedente moltiplicato per un fattore casuale (interesse composto, raddoppio dei batteri), il risultato su molti periodi è lognormale. Ecco perché la lognormale compare così spesso in finanza e biologia.
La lognormale si adatta a variabili come:
- Rendimenti finanziari su orizzonti lunghi—i rendimenti logaritmici giornalieri si compongono in modo moltiplicativo
- Sinistri assicurativi—la maggior parte è piccola; alcuni sono molto grandi
- Distribuzioni del reddito—limitate inferiormente da zero, asimmetriche a destra in pratica
- Crescita biologica—dimensione degli organismi, conteggi cellulari, misure di concentrazione
- Tempi di attesa—tempi di riparazione e durate del servizio con occasionali valori anomali
- Misure ambientali—concentrazioni di inquinanti in acqua o aria
Se non sei sicuro che la lognormale sia appropriata, il nostro corso Feature Engineering for Machine Learning in Python tratta in profondità le trasformazioni logaritmiche, incluso come valutare se una trasformazione si adatta ai tuoi dati.
Esempi reali della distribuzione lognormale
La distribuzione lognormale compare in molti scenari reali, alcuni dei quali sono evidenziati di seguito.
Reddito e ricchezza
I dati sul reddito sono l'esempio da manuale di lognormale. La maggior parte delle persone guadagna redditi concentrati in un intervallo moderato, ma non c'è un limite superiore—un piccolo numero di individui guadagna ordini di grandezza sopra la mediana. Se rappresenti il reddito familiare grezzo ottieni un istogramma fortemente asimmetrico a destra; prendi il log e appare approssimativamente normale. I dati sulla ricchezza mostrano lo stesso schema, spesso con un'asimmetria più accentuata.
Prezzi azionari
Le variazioni giornaliere dei prezzi azionari sono approssimativamente distribuite normalmente in termini logaritmici, il che significa che il livello dei prezzi segue nel tempo una distribuzione lognormale. Questa assunzione è alla base del modello di valutazione delle opzioni di Black-Scholes. I prezzi delle azioni non possono scendere sotto zero, si compongono in modo moltiplicativo e producono quella caratteristica coda destra.
Dimensioni dei file Internet
Le dimensioni dei file coprono un'enorme gamma, da pochi kilobyte a molti gigabyte, e la distribuzione è fortemente asimmetrica a destra. La lognormale si adatta bene qui perché la dimensione del file è limitata inferiormente da zero e cresce in modo moltiplicativo. L'analisi del traffico web e l'ingegneria di rete si basano su questo.
Misurazioni biologiche
Le concentrazioni di sostanze biologiche (livelli ormonali, concentrazioni di inquinanti nei tessuti, conteggi microbici) tendono a seguire distribuzioni lognormali. I processi biologici coinvolgono spesso rapporti e tassi di crescita piuttosto che incrementi additivi. I tempi di latenza negli studi medici mostrano lo stesso schema.
In ognuno di questi ambiti, la logica è la stessa: un processo di natura moltiplicativa, limitato a zero e in grado di produrre rari valori estremi è un candidato naturale per la modellazione lognormale.
Distribuzione lognormale in machine learning e data science
La distribuzione lognormale compare nel machine learning in alcuni modi distinti, ciascuno dei quali richiede un trattamento leggermente diverso.
Modellare variabili continue positive
Quando una variabile target è strettamente positiva e asimmetrica a destra—prezzi delle case, ricavi, valore di vita dell'utente—applicare una trasformazione log prima della modellazione spesso migliora notevolmente i risultati. La regressione lineare assume residui normalmente distribuiti; adattarla a dati lognormali grezzi viola tale assunzione. La soluzione: fai il log del target, adatta il modello, poi esponenzia le previsioni per tornare alla scala originale. Una avvertenza: interpretare i coefficienti nello spazio logaritmico richiede attenzione, poiché un aumento unitario in un predittore corrisponde ora a una variazione moltiplicativa nella scala originale.
Trasformare con il log le feature asimmetriche prima di passarle a modelli sensibili alla scala (regressione lineare, regressione logistica, k-means) riduce l'influenza dei valori estremi e rende le relazioni più lineari. Questo è un pre-processing standard per feature continue asimmetriche a destra. La trasformazione gestisce anche implicitamente gli outlier: un valore che nello spazio grezzo è 100 volte la mediana diventa circa 4,6 unità sopra la mediana nello spazio logaritmico.
Modellazione probabilistica e simulazione
Alcuni modelli probabilistici usano esplicitamente la distribuzione lognormale. Nella modellazione bayesiana, è una prior comune per parametri che devono essere positivi. Nella simulazione, modella grandezze come tempi di riparazione, importi dei sinistri e ritardi di rete, dove la struttura moltiplicativa rispecchia i processi reali. Questi casi compaiono regolarmente nel lavoro applicato.
Come identificare una distribuzione lognormale
A occhio un istogramma non basta. Ecco gli approcci che funzionano davvero, in ordine approssimativo di rigore crescente.
Inizia con un istogramma dei dati grezzi. Se è asimmetrico a destra con una lunga coda destra e un limite inferiore vicino a zero, è indicativo. Poi traccia un istogramma dei valori trasformati con il log. Se quell'istogramma appare approssimativamente simmetrico e a campana, la lognormale è un modello plausibile. Questo confronto a due grafici è veloce. Ma non fermarti qui.
Q-Q plot
Un grafico quantile-quantile (Q-Q) confronta i quantili dei tuoi dati con i quantili di una distribuzione teorica. Per dati lognormali, traccia i quantili di ln(X) contro i quantili di una normale standard. Punti che cadono approssimativamente lungo una linea retta indicano un buon adattamento. Una curvatura sistematica, specialmente nelle code, suggerisce che la lognormale non è del tutto adatta. Il nostro tutorial sui Q-Q plot spiega come leggerli e interpretarli sia in Python sia in R.
Test di bontà dell'adattamento
Per un test formale, applica un test di normalità (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) ai dati trasformati con il log. Se ln(X) supera il test, hai evidenza statistica a supporto del modello lognormale. Con dataset molto grandi, però, questi test diventano così sensibili da rifiutare la lognormalità per deviazioni banalmente piccole. Affianca sempre ai test formali un'ispezione visiva.
Usare tutti e tre gli approcci insieme offre un quadro molto più affidabile rispetto a qualsiasi metodo preso singolarmente.
Errori comuni nel lavorare con dati lognormali
Qui sono evidenziati alcuni errori comuni che molti professionisti commettono spesso.
Supporre che i dati siano normalmente distribuiti
Questo è l'errore più comune. Adattare una distribuzione normale a dati lognormali sottostima la probabilità di valori estremi, introduce bias nelle stime della media e può rendere inaffidabili i test statistici. Se i tuoi dati sono positivi e asimmetrici a destra, verifica prima di ricorrere alla distribuzione normale.
Per dati lognormali, la media aritmetica è trascinata ben al di sopra della mediana dalla coda destra. Riportare la media come "tipica" è fuorviante. La mediana è di solito la misura migliore di come appare un'osservazione tipica. Sii chiaro su quale misura stai riportando e perché.
Dimenticare che i valori devono essere positivi
La distribuzione lognormale è indefinita per valori zero o negativi. Se il tuo dataset contiene zeri—comune nei dati di conteggio o nelle vendite con periodi inattivi—la lognormale non è direttamente applicabile. Soluzioni comuni includono aggiungere una piccola costante prima di fare il log (non ideale dal punto di vista statistico) o usare un modello a inflazione di zeri che gestisca separatamente gli zeri.
Applicare test statistici inappropriati
Test progettati per dati normalmente distribuiti (t-test, intervalli di confidenza standard, ANOVA) non si applicano direttamente a dati lognormali. Hai due opzioni: fai il log dei dati e applica metodi basati sulla normale, oppure usa metodi non parametrici che non fanno assunzioni sulla forma. Il test sbagliato non produrrà sempre risposte clamorosamente errate, ma può produrre bias sottili difficili da rilevare.
Conclusione
La distribuzione lognormale modella variabili positive e asimmetriche a destra collegandole alla distribuzione normale tramite una trasformazione logaritmica. Una volta riconosciuto che ln(X) è normale ogni volta che X è lognormale, il resto segue. Puoi lavorare nello spazio logaritmico usando gli strumenti standard della normale, quindi riportare i risultati alla scala originale.
Abbiamo coperto le proprietà chiave della distribuzione, ricondotte a quella trasformazione, e visto dove compare in pratica. Il punto pratico è semplice: prima di modellare dati positivi e asimmetrici a destra, verifica la lognormalità. Traccia i dati trasformati con il log, esegui un test di normalità su di essi e guarda un Q-Q plot. Il nostro Introduction to Statistics in Python e il tutorial Probability Distributions in Python sono buoni prossimi passi se vuoi vedere queste idee applicate a dataset reali.






Pensa ai dati sul reddito. Alcune persone guadagnano milioni, la maggior parte è da qualche parte nel mezzo, e la distribuzione ha una lunga coda verso destra. Se la sovrapponi a una classica curva a campana, non coincide, perché la distribuzione normale si adatta male.
La distribuzione lognormale è fatta per variabili strettamente positive e asimmetriche a destra, in cui la dispersione cresce con la dimensione del valore. Reddito familiare, prezzi azionari, dimensioni dei file e misurazioni biologiche si comportano tutti in questo modo.
Vedremo cos'è la distribuzione lognormale, come si confronta con la distribuzione normale, le sue proprietà chiave e la formula, quando usarla e come riconoscerla nei dati reali, incluse alcune insidie comuni.
Che cos'è la distribuzione lognormale?
Una variabile aleatoria segue una distribuzione lognormale se il suo logaritmo naturale è distribuito normalmente.
Se X è lognormalmente distribuita, allora ln(X) è normale. Il nome deriva direttamente da questo: log-normale, una distribuzione il cui logaritmo è normale.
Due conseguenze immediate. Primo, i valori sono sempre positivi. I logaritmi sono definiti solo per numeri positivi, quindi le variabili lognormali non possono mai essere zero o negative. Secondo, la distribuzione è asimmetrica a destra. Esiste un limite inferiore fisico a zero ma nessun limite superiore, il che significa che la coda destra si estende molto più della sinistra.
La trasformazione logaritmica è la chiave che collega le due distribuzioni. Prendi una variabile lognormalmente distribuita, applica un logaritmo naturale a ogni osservazione e il risultato sono dati distribuiti normalmente. Non è solo una curiosità matematica. È ciò che rende trattabile la lognormale. Tutta la strumentazione statistica costruita per la distribuzione normale diventa disponibile una volta trasformati i dati.
Distribuzione lognormale vs distribuzione normale
La differenza più immediata è la forma. La distribuzione normale è simmetrica, con media, mediana e moda tutte nello stesso punto centrale. La distribuzione lognormale è asimmetrica, con asimmetria a destra e una lunga coda destra. Media, mediana e moda sono tutte diverse. Vedremo perché nella prossima sezione.
Anche l'intervallo dei valori possibili è diverso. Una distribuzione normale si estende da meno infinito a più infinito. Una lognormale è limitata inferiormente da zero e si estende verso l'alto senza limite. Questo la rende il modello giusto ogni volta che la tua variabile fisicamente non può essere negativa.
Proprietà
Distribuzione normale
Distribuzione lognormale
Forma
Curva a campana simmetrica
Asimmetrica a destra, lunga coda destra
Simmetria
Simmetrica
Asimmetrica
Valori possibili
Tutti i numeri reali (−∞ a +∞)
Strettamente positivi (0 a +∞)
Media = mediana = moda?
Sì
No—tutte e tre differiscono
Applicazioni tipiche
Altezza, punteggi dei test, errore di misura
Reddito, prezzi azionari, dimensioni dei file
Relazione di trasformazione
—
Se X è lognormale, ln(X) è normale
L'ultima riga conta di più nella pratica. Prendere il logaritmo di una variabile lognormalmente distribuita produce una distribuzione normale. Questa trasformazione è ciò che rende utile la lognormale. Non è solo una descrizione di dati asimmetrici, è un modello con un ponte diretto verso il mondo normale.
Proprietà della distribuzione lognormale
Ci sono un paio di proprietà chiave di una distribuzione lognormale che la rendono speciale.
Sempre positiva con una lunga coda destra
La distribuzione lognormale produce solo valori positivi. Se ln(X) è normale, allora X = e^(ln(X)) è sempre positiva, poiché le esponenziali sono sempre positive. C'è un pavimento a zero, ma nessun soffitto. Insieme all'asimmetria a destra, questo conferisce alla distribuzione la sua forma caratteristica: una salita ripida da zero, un picco da qualche parte a sinistra della media, poi una lunga coda che degrada lentamente.
Media, mediana e moda sono tutte diverse
Le tre misure di tendenza centrale raccontano storie diverse. La moda (il valore più comune) è la più a sinistra. La mediana (il valore centrale) è più in alto. La media (la media aritmetica) è ancora più in alto, trascinata verso l'alto dalla coda destra. Nei dati sul reddito, il reddito medio familiare è sostanzialmente più alto della mediana. Pochi redditi molto alti spostano la media senza toccare il centro della distribuzione. Ecco perché gli economisti in genere riportano la mediana del reddito quando descrivono le famiglie tipiche. Scegliere la misura sbagliata della tendenza centrale qui non è solo statistica approssimativa; è fuorviante.
Tieni questo a mente quando arriveremo alla formula: μ e σ descrivono la distribuzione normale sottostante di ln(X), non la media e la deviazione standard di X stessa. Questa distinzione coglie di sorpresa molte persone.
La formula della distribuzione lognormale
La funzione di densità di probabilità (PDF) della distribuzione lognormale è:
per x > 0, dove:
μ e σ non sono la media e la deviazione standard di X stessa. Sono i parametri di ln(X). La media effettiva di X è e(μ + σ²/2), motivo per cui si colloca a destra della mediana. Se stai adattando una lognormale ai dati in Python o R, le funzioni delle librerie gestiscono loro questa traduzione, ma vale la pena sapere cosa rappresentano davvero i parametri.
Quando dovresti usare una distribuzione lognormale?
Il test pratico: se la tua variabile è strettamente positiva e il processo di crescita è moltiplicativo piuttosto che additivo, la lognormale è probabilmente un buon adattamento.
I processi additivi tendono a produrre distribuzioni normali. Per il teorema del limite centrale, le somme di molti piccoli effetti casuali convergono alla normale. I processi moltiplicativi sono diversi. Quando il valore di ogni periodo è il valore del periodo precedente moltiplicato per un fattore casuale (interesse composto, raddoppio dei batteri), il risultato su molti periodi è lognormale. Ecco perché la lognormale compare così spesso in finanza e biologia.
La lognormale si adatta a variabili come:
Se non sei sicuro che la lognormale sia appropriata, il nostro corso Feature Engineering for Machine Learning in Python tratta in profondità le trasformazioni logaritmiche, incluso come valutare se una trasformazione si adatta ai tuoi dati.
Esempi reali della distribuzione lognormale
La distribuzione lognormale compare in molti scenari reali, alcuni dei quali sono evidenziati di seguito.
Reddito e ricchezza
I dati sul reddito sono l'esempio da manuale di lognormale. La maggior parte delle persone guadagna redditi concentrati in un intervallo moderato, ma non c'è un limite superiore—un piccolo numero di individui guadagna ordini di grandezza sopra la mediana. Se rappresenti il reddito familiare grezzo ottieni un istogramma fortemente asimmetrico a destra; prendi il log e appare approssimativamente normale. I dati sulla ricchezza mostrano lo stesso schema, spesso con un'asimmetria più accentuata.
Prezzi azionari
Le variazioni giornaliere dei prezzi azionari sono approssimativamente distribuite normalmente in termini logaritmici, il che significa che il livello dei prezzi segue nel tempo una distribuzione lognormale. Questa assunzione è alla base del modello di valutazione delle opzioni di Black-Scholes. I prezzi delle azioni non possono scendere sotto zero, si compongono in modo moltiplicativo e producono quella caratteristica coda destra.
Dimensioni dei file Internet
Le dimensioni dei file coprono un'enorme gamma, da pochi kilobyte a molti gigabyte, e la distribuzione è fortemente asimmetrica a destra. La lognormale si adatta bene qui perché la dimensione del file è limitata inferiormente da zero e cresce in modo moltiplicativo. L'analisi del traffico web e l'ingegneria di rete si basano su questo.
Misurazioni biologiche
Le concentrazioni di sostanze biologiche (livelli ormonali, concentrazioni di inquinanti nei tessuti, conteggi microbici) tendono a seguire distribuzioni lognormali. I processi biologici coinvolgono spesso rapporti e tassi di crescita piuttosto che incrementi additivi. I tempi di latenza negli studi medici mostrano lo stesso schema.
In ognuno di questi ambiti, la logica è la stessa: un processo di natura moltiplicativa, limitato a zero e in grado di produrre rari valori estremi è un candidato naturale per la modellazione lognormale.
Distribuzione lognormale in machine learning e data science
La distribuzione lognormale compare nel machine learning in alcuni modi distinti, ciascuno dei quali richiede un trattamento leggermente diverso.
Modellare variabili continue positive
Quando una variabile target è strettamente positiva e asimmetrica a destra—prezzi delle case, ricavi, valore di vita dell'utente—applicare una trasformazione log prima della modellazione spesso migliora notevolmente i risultati. La regressione lineare assume residui normalmente distribuiti; adattarla a dati lognormali grezzi viola tale assunzione. La soluzione: fai il log del target, adatta il modello, poi esponenzia le previsioni per tornare alla scala originale. Una avvertenza: interpretare i coefficienti nello spazio logaritmico richiede attenzione, poiché un aumento unitario in un predittore corrisponde ora a una variazione moltiplicativa nella scala originale.
Feature engineering con trasformazioni logaritmiche
Trasformare con il log le feature asimmetriche prima di passarle a modelli sensibili alla scala (regressione lineare, regressione logistica, k-means) riduce l'influenza dei valori estremi e rende le relazioni più lineari. Questo è un pre-processing standard per feature continue asimmetriche a destra. La trasformazione gestisce anche implicitamente gli outlier: un valore che nello spazio grezzo è 100 volte la mediana diventa circa 4,6 unità sopra la mediana nello spazio logaritmico.
Modellazione probabilistica e simulazione
Alcuni modelli probabilistici usano esplicitamente la distribuzione lognormale. Nella modellazione bayesiana, è una prior comune per parametri che devono essere positivi. Nella simulazione, modella grandezze come tempi di riparazione, importi dei sinistri e ritardi di rete, dove la struttura moltiplicativa rispecchia i processi reali. Questi casi compaiono regolarmente nel lavoro applicato.
Come identificare una distribuzione lognormale
A occhio un istogramma non basta. Ecco gli approcci che funzionano davvero, in ordine approssimativo di rigore crescente.
Istogramma e istogramma trasformato con il log
Inizia con un istogramma dei dati grezzi. Se è asimmetrico a destra con una lunga coda destra e un limite inferiore vicino a zero, è indicativo. Poi traccia un istogramma dei valori trasformati con il log. Se quell'istogramma appare approssimativamente simmetrico e a campana, la lognormale è un modello plausibile. Questo confronto a due grafici è veloce. Ma non fermarti qui.
Q-Q plot
Un grafico quantile-quantile (Q-Q) confronta i quantili dei tuoi dati con i quantili di una distribuzione teorica. Per dati lognormali, traccia i quantili di ln(X) contro i quantili di una normale standard. Punti che cadono approssimativamente lungo una linea retta indicano un buon adattamento. Una curvatura sistematica, specialmente nelle code, suggerisce che la lognormale non è del tutto adatta. Il nostro tutorial sui Q-Q plot spiega come leggerli e interpretarli sia in Python sia in R.
Test di bontà dell'adattamento
Per un test formale, applica un test di normalità (Shapiro-Wilk, Kolmogorov-Smirnov, Anderson-Darling) ai dati trasformati con il log. Se ln(X) supera il test, hai evidenza statistica a supporto del modello lognormale. Con dataset molto grandi, però, questi test diventano così sensibili da rifiutare la lognormalità per deviazioni banalmente piccole. Affianca sempre ai test formali un'ispezione visiva.
Usare tutti e tre gli approcci insieme offre un quadro molto più affidabile rispetto a qualsiasi metodo preso singolarmente.
Errori comuni nel lavorare con dati lognormali
Qui sono evidenziati alcuni errori comuni che molti professionisti commettono spesso.
Supporre che i dati siano normalmente distribuiti
Questo è l'errore più comune. Adattare una distribuzione normale a dati lognormali sottostima la probabilità di valori estremi, introduce bias nelle stime della media e può rendere inaffidabili i test statistici. Se i tuoi dati sono positivi e asimmetrici a destra, verifica prima di ricorrere alla distribuzione normale.
Interpretare in modo errato la media aritmetica
Per dati lognormali, la media aritmetica è trascinata ben al di sopra della mediana dalla coda destra. Riportare la media come "tipica" è fuorviante. La mediana è di solito la misura migliore di come appare un'osservazione tipica. Sii chiaro su quale misura stai riportando e perché.
Dimenticare che i valori devono essere positivi
La distribuzione lognormale è indefinita per valori zero o negativi. Se il tuo dataset contiene zeri—comune nei dati di conteggio o nelle vendite con periodi inattivi—la lognormale non è direttamente applicabile. Soluzioni comuni includono aggiungere una piccola costante prima di fare il log (non ideale dal punto di vista statistico) o usare un modello a inflazione di zeri che gestisca separatamente gli zeri.
Applicare test statistici inappropriati
Test progettati per dati normalmente distribuiti (t-test, intervalli di confidenza standard, ANOVA) non si applicano direttamente a dati lognormali. Hai due opzioni: fai il log dei dati e applica metodi basati sulla normale, oppure usa metodi non parametrici che non fanno assunzioni sulla forma. Il test sbagliato non produrrà sempre risposte clamorosamente errate, ma può produrre bias sottili difficili da rilevare.
Conclusione
La distribuzione lognormale modella variabili positive e asimmetriche a destra collegandole alla distribuzione normale tramite una trasformazione logaritmica. Una volta riconosciuto che ln(X) è normale ogni volta che X è lognormale, il resto segue. Puoi lavorare nello spazio logaritmico usando gli strumenti standard della normale, quindi riportare i risultati alla scala originale.
Abbiamo coperto le proprietà chiave della distribuzione, ricondotte a quella trasformazione, e visto dove compare in pratica. Il punto pratico è semplice: prima di modellare dati positivi e asimmetrici a destra, verifica la lognormalità. Traccia i dati trasformati con il log, esegui un test di normalità su di essi e guarda un Q-Q plot. Il nostro Introduction to Statistics in Python e il tutorial Probability Distributions in Python sono buoni prossimi passi se vuoi vedere queste idee applicate a dataset reali.