
课程
使用 Keras 构建语言建模的循环神经网络(RNN)
4 小时
16.4K
标准循环神经网络在“记忆”方面表现欠佳。随着序列s超出 20-30 个时间步,梯度在反向传播过程中要么趋近于零、要么爆炸,网络便丧失了连接输入中远端部分的能力。Hochreiter 和 Schmidhuber 在其1997 年论文中提出了长短期记忆网络(LSTM)来解决这一问题。
在本指南中,我将先讲解 LSTM 的内部原理,然后转向用 Python 的实战实现。最后几节会将 LSTM 与 Transformer 做比较,帮助您为自己的用例选对架构。
我强烈推荐我们的课程 Introduction to Deep Learning in PyTorch,以获得使用 PyTorch 训练神经网络的实操经验,这些网络正是 LSTM 模型的基础。
LSTM 是 Long Short-Term Memory 的缩写,是一种循环神经网络(RNN),专为处理需要更早上下文信息仍然重要的序列而设计。
LSTM 的核心思想是通过门控机制来调节信息在网络中的流动。与其让所有信号一视同仁地通过,门会学习在何时保留上下文、何时放手。
这种选择性记忆让 LSTM 能够跨越数百个时间步跟踪依赖关系,这在语言建模、语音识别和时间序列预测中非常有用。要理解这种架构为何存在,有助于先看看标准 RNN 出了什么问题。
循环网络通过隐藏状态在时间步之间传递信息。每一步都会用学习到的权重对该状态做乘法、更新它并向前传递。训练需要将误差信号逐步向后传递,每次反向传播都会让信号缩小一点。足够多的步数之后,几乎什么都不剩了。
这就像一张复印件再复印。复印几次看起来还好,复印五十次后几乎难以辨认。RNN 大约在 20-30 个时间步时就会撞到这堵墙,因此难以处理更长的序列。
LSTM 额外引入了一条称为“单元状态”的记忆通道,与标准的隐藏状态并行运行。差异在于结构:单元状态中的信息通过“加法”而非反复“乘法”流动,因此不会以相同方式退化。
为了控制进入和流出这条记忆通道的内容,LSTM 使用门。每个门都是一个小型神经网络,学习输出介于 0 和 1 之间的值,起到过滤器的作用。接近 0 的值会阻断信息,接近 1 的值会放行。网络在训练中学习哪些模式值得在长序列中记住、哪些可以丢弃。
这种门控机制是 LSTM 与普通 RNN 的分野。LSTM 可以在数百个时间步上有选择地保留上下文,而不必强迫所有信息走同一条路径。下一节将详细拆解这些门如何工作,以及它们如何共同更新单元状态。
凡是序列数据重要的地方,都能看到 LSTM 的身影。以下是超出常见 NLP 和预测应用的一些例子:
本节将详细介绍 LSTM 的内部机制。如果您想直接上手实现,可以跳到下一节。理解这些架构细节并非使用 LSTM 的必需,但在调试或调优时很有帮助。
为帮助理解 LSTM 的工作方式,我们来追踪一个具体例子:处理序列 "The clouds are dark..." 以预测下一个词。看到各组件如何作用于真实数据,会更容易理解。
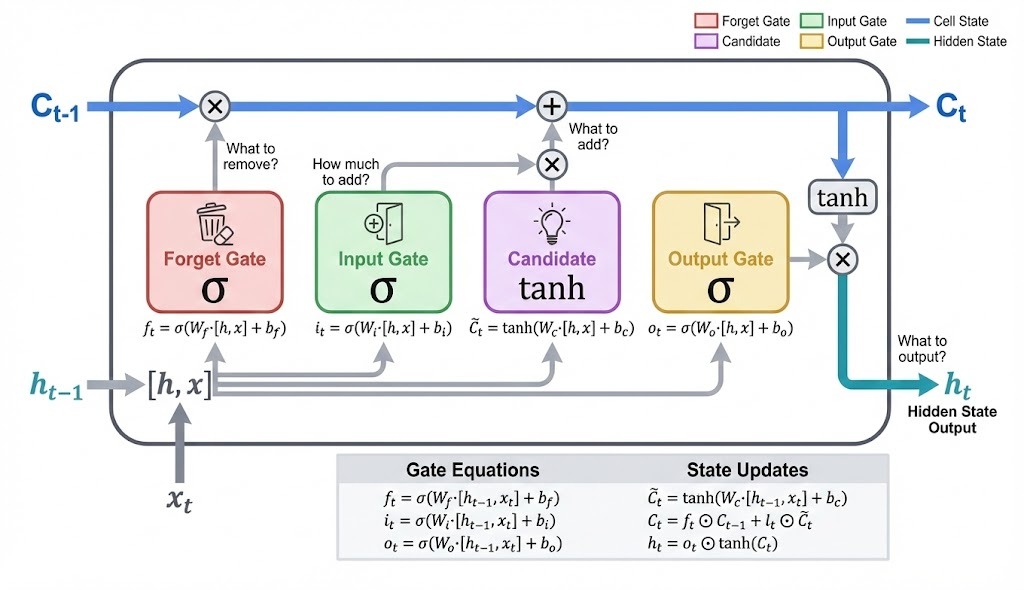
LSTM 在网络中维持两条彼此独立的向量流:单元状态与隐藏状态。
其单元状态充当长期存储。它在各时间步间携带信息,并在每步进行受控修改。处理我们的序列时,单元状态可能在看到 "clouds" 后存下“出现了与天气相关的名词”,并在 "are" 期间保持该上下文,直到 "dark" 强化这一模式。
其隐藏状态是每个时间步的单元输出,它用于预测并输入到下一时间步的计算中。在处理 "dark" 之后,隐藏状态会编码类似“描述天气状况的形容词”之类的信息,供预测层使用。
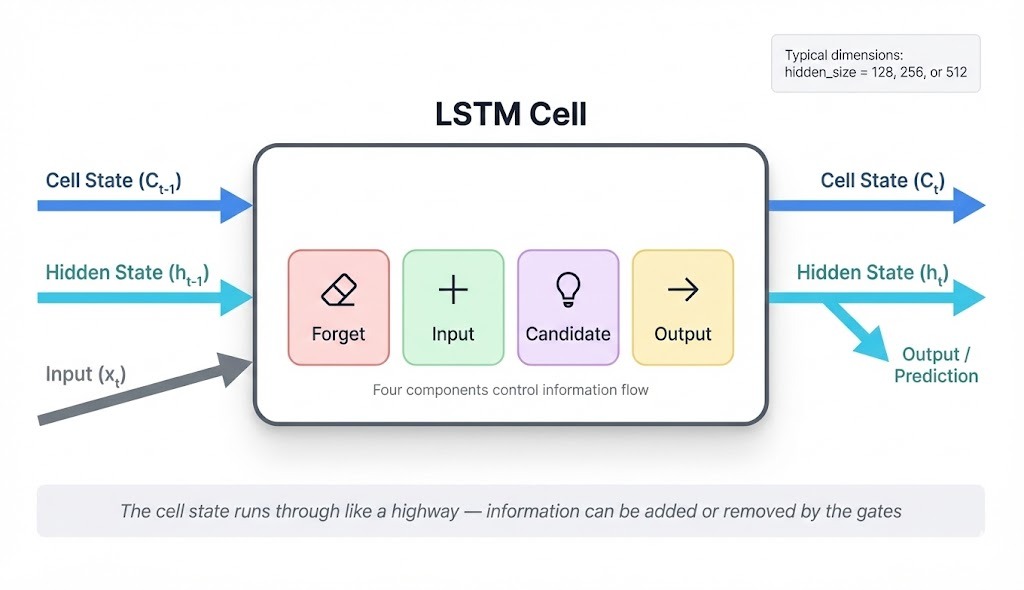
为什么要分两条通道?单一状态需要同时承担长期上下文存储与产生有用输出,这两者目标相冲突:稳定的记忆需要尽量少改动,而有用的输出需要变换。将两者分开,便能各自为其目标优化。
在每个时间步,单元接收三个输入并产生两个输出:
输入:
前一时刻的单元状态(C_{t-1}):网络目前为止记住的内容
前一时刻的隐藏状态(h_{t-1}):上一个时间步的输出
当前输入(x_t):新到达的标记,如 "clouds" 或 "dark"
输出:
更新后的单元状态(C_t):处理该标记后的记忆
新的隐藏状态(h_t):该时间步的输出
四个组件控制单元内部发生的事情。其中三个是输出 0 到 1 之间数值的门、起到过滤器作用。第四个是候选项(candidate),用于提出新的内容。
当 "are" 跟在 "clouds" 之后到来时,各组件分工如下:
遗忘门(f_t):是否要保留 "clouds" 的上下文?天气名词后接系动词通常有用,因此遗忘门输出接近 1 的数值以保留大部分单元状态。
输入门(i_t):"are" 应在多大程度上写入记忆?系动词的预测信号较弱,因此输入门输出较低的数值。
候选项(C̃_t):"are" 能加入哪些新信息?候选项会提出内容,但由输入门将其缩放减弱。
输出门(o_t):隐藏状态该呈现什么?输出门对单元状态进行过滤以产生 h_t。
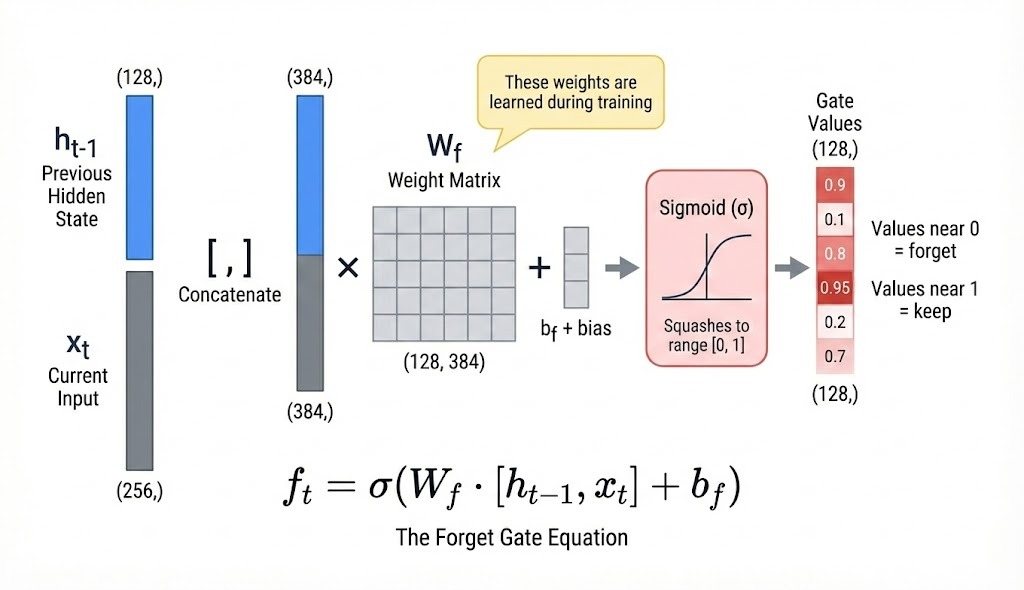
各组件的计算方式相同:
将 h_{t-1} 与 x_t 连接成一个向量
与学习得到的权重矩阵相乘
加上偏置项
应用激活函数
各门使用 sigmoid 激活,将数值压缩到 0-1 范围。候选项使用 tanh,输出-1 到 1 之间的值,因此既能提出对单元状态的增益也能提出减弱。
遗忘门(sigmoid → 0 到 1):
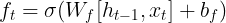
输入门(sigmoid → 0 到 1):
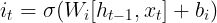
输出门(sigmoid → 0 到 1):
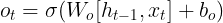
候选项(tanh → -1 到 +1):
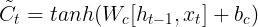
每个组件都有自己的权重矩阵(W_f、W_i、W_c、W_o),从而学习对输入中的不同模式作出反应。
门的输出与向量按位置相乘(逐元素乘法,记作⊙)。每个维度都会被独立过滤。
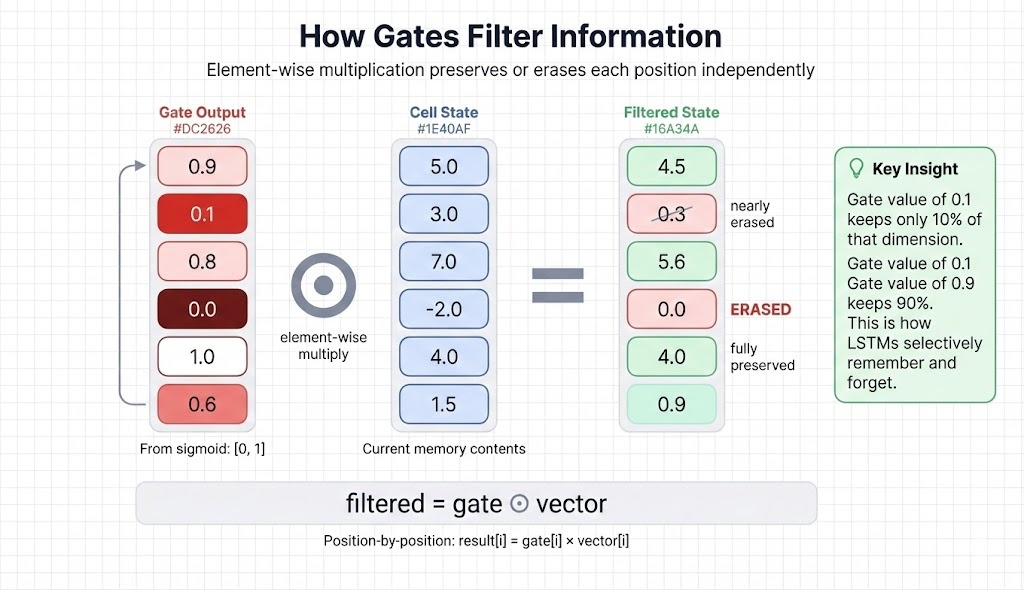
如果门在位置 1 输出 0.9,则该维度保留 90% 的值;如果在位置 4 输出 0.0,则该维度被清除。当在 "clouds are" 之后处理 "dark" 时,遗忘门可能会对存储名词/天气上下文的维度输出较高数值,而对保存早前无关上下文的维度输出较低数值。
这些组件通过三个步骤结合起来,以更新单元状态并产生隐藏状态。
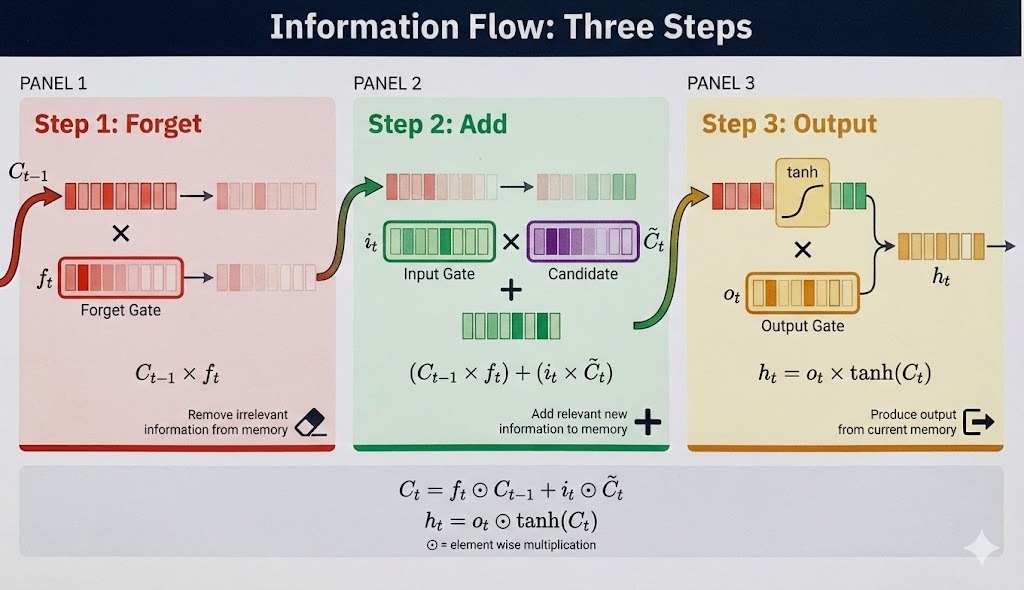
遗忘门对前一时刻的单元状态进行过滤:
处理 "dark" 时,遗忘门会保留来自 "clouds" 的天气上下文,同时清除跟踪冠词 "The" 的维度。
输入门对候选项的提议进行缩放,然后将其加入已过滤的单元状态:
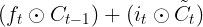
候选项可能提出“修饰天气名词的形容词”,而输入门决定该信息写入记忆的强度。这种“加法式”的更新(而非乘法)有助于训练期间的梯度流动。
单元状态先通过 tanh,然后由输出门过滤,得到隐藏状态:
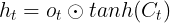
tanh 使数值保持有界。输出门从累积的记忆中选择在该时间步用于预测的部分。
完整流程:
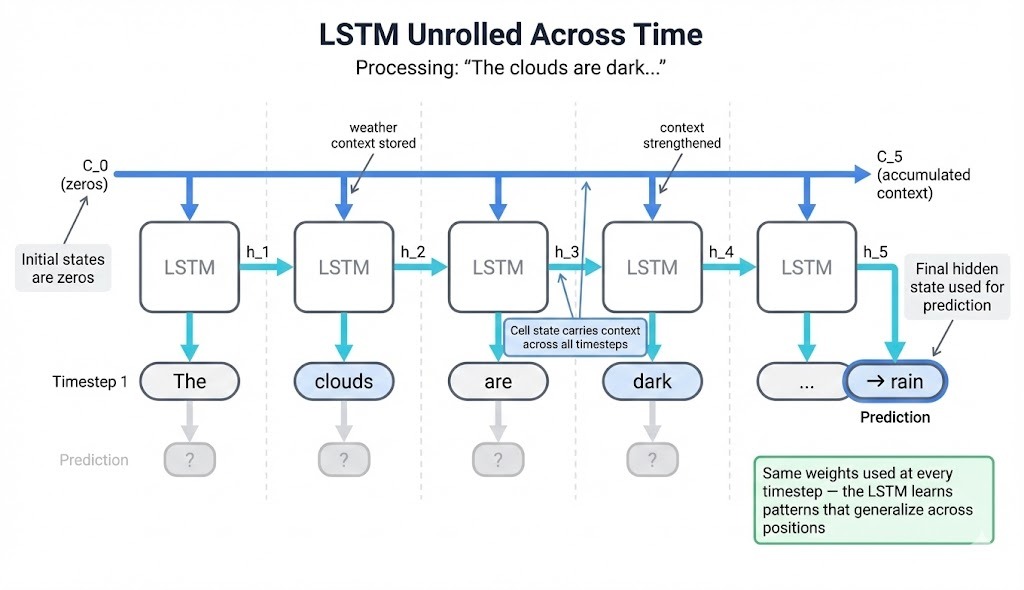
以下是一个具有 4 维单元状态的简化跟踪:
|
Step |
Input |
Cell state (simplified) |
What happens |
|
1 |
"The" |
[0.1, 0.0, 0.2, 0.0] |
最小化存储;冠词的预测信号很弱 |
|
2 |
"clouds" |
[0.1, 0.7, 0.2, 0.3] |
输入门在维度 2、4 打开;存下名词模式 |
|
3 |
"are" |
[0.1, 0.6, 0.2, 0.3] |
遗忘门 ≈ 0.9 保留上下文;系动词贡献不大 |
|
4 |
"dark" |
[0.1, 0.8, 0.5, 0.6] |
该形容词强化了维度 2、3、4 的信号 |
到第 4 个时间步,维度 2-4 已累积出某种模式。隐藏状态 h_4 会送入预测层(不属于 LSTM),输出词表概率。这种累积模式让模型更倾向于诸如 "rain" 或 "sky" 之类的词。
网络并不真正“理解”天气。它学习的是统计相关性:某些输入序列往往会先于某些输出出现。
单元状态的加法结构比标准 RNN 提供了更直接的梯度通路。如果您不熟悉梯度如何在神经网络中传播,请参见反向传播教程,其涵盖基础知识。
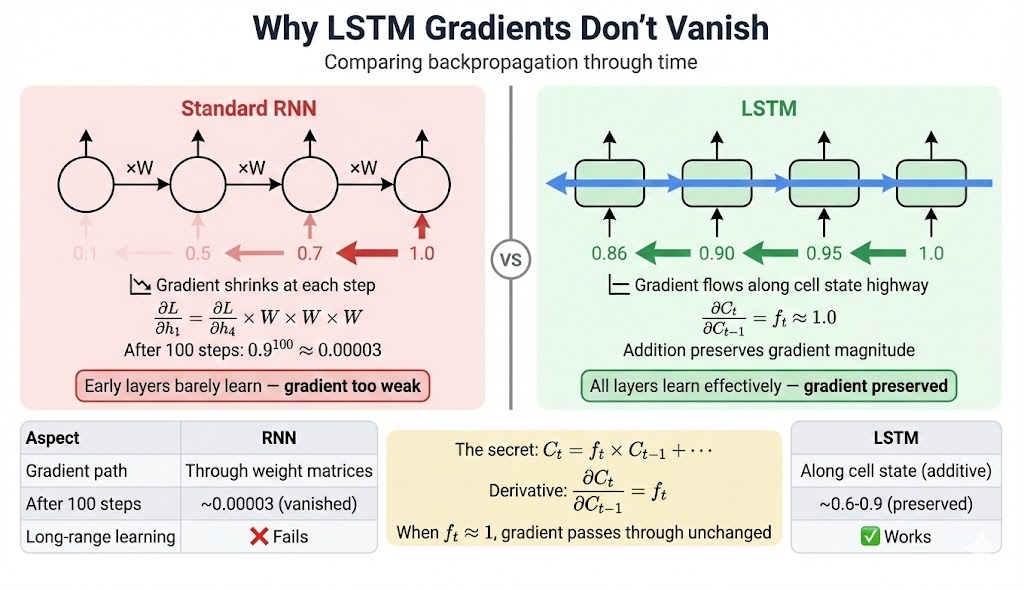
在标准 RNN 中,梯度在每一步都要通过权重矩阵。重复的乘法会复合:若 100 步的权重平均为 0.9,则梯度缩小到 0.9^100 ≈ 0.00003。
LSTM 沿着单元状态提供了一条替代路径。 C_t 对 C_{t-1} 的导数为:
∂C_t/∂C_{t-1} = f_t这就是遗忘门的值,而不是一个权重矩阵。当遗忘门保持接近 1 时,梯度衰减较小。若门的平均值为 0.95,经过 100 步后:0.95^100 ≈ 0.006。仍有衰减,但可用。
|
Aspect |
RNN |
LSTM |
|
Gradient path |
Weight matrices only |
Additional path along the cell state |
|
100-step gradient |
~10^-5 (vanished) |
~10^-2 to 10^-1 (usable) |
|
Practical memory |
~10-20 timesteps |
~50-200 timesteps |
实践提示:常将遗忘门的偏置初始化为 1.0 或更高,使初始输出偏向“全部记住”。这有助于网络在训练早期学习长期模式。
LSTM 是缓解而非消除梯度消失问题。改进来自单元状态的加法更新,它在标准路径之外提供了一条“梯度高速路”。
上一节我们讲了 LSTM 单元内部发生的事:门过滤信息、单元状态保留上下文、隐藏状态产生输出。现在看看 PyTorch 的 nn.LSTM 如何将这一切封装为一个模块,并用它将电影评论分类为正面或负面。
运行代码的小贴士:在 CPU 上训练 50 个 epoch 需要很长时间。请使用 Google Colab 或 Kaggle Notebooks 的 GPU 加速以获得更快结果。完整脚本可在 GitHub Gist 获取。
使用 LSTM 进行文本分类遵循这样一个模式:将词转换为向量,让 LSTM 顺序处理它们,然后用最终输出进行预测。
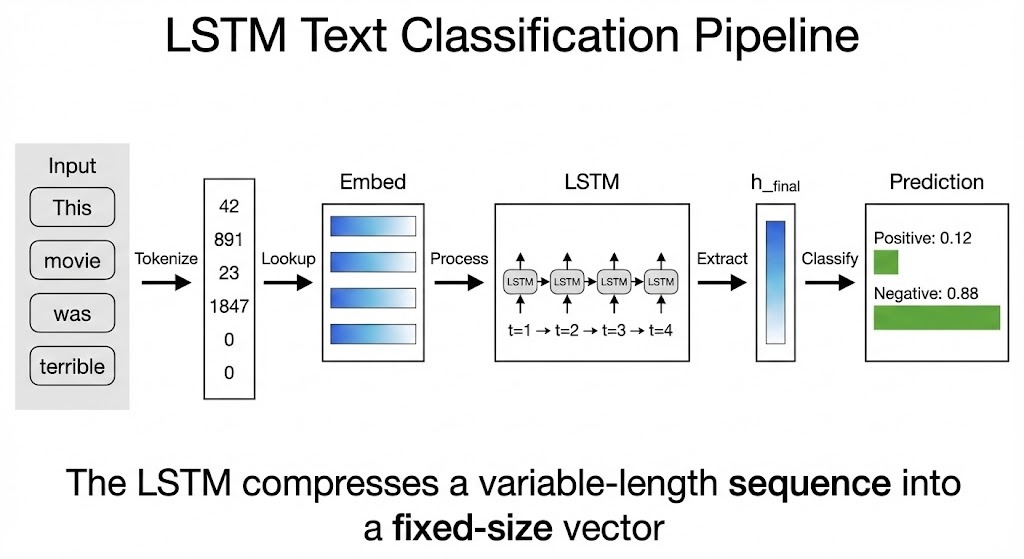
神经网络处理的是连续数值,但词是离散符号。我们不能把 "terrible" 直接送入矩阵乘法。解决方案是嵌入层:一个查表,将每个词映射为可学习的向量。
self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=padding_idx)如果您选择 embedding_dim=32,每个词都会变成一个 32 维向量。训练早期这些向量是随机的。随着模型学习,具有相似情感的词会在该向量空间中渐渐靠近。"Terrible"、"awful" 和 "boring" 可能会彼此接近,而 "excellent" 和 "amazing" 则聚在另一处。
参数 padding_idx 告诉该层将填充标记保持为零向量,这样它们就不会影响模型。
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=num_layers,
	batch_first=True,
	dropout=dropout if num_layers > 1 else 0,
	bidirectional=bidirectional,
)这一行代码创建了上一节介绍的全部门控机制。hidden_size 决定了单元状态与隐藏状态能携带的信息量。数值越大,模型能跟踪的模式越多,但计算开销也越大。
设置 batch_first=True 意味着输入形状为 (batch, sequence_length, embedding_dim)。LSTM 会从左到右逐个位置处理,并在每一步更新其内部状态。
在处理 "This movie was absolutely terrible" 之后,LSTM 已看到每个词。其最终隐藏状态累积了模型从该序列中学到的关键信息。对于情感任务,这可能会编码类似“末尾出现强烈负面形容词,从而否定了先前的中性内容”的信息。
def forward(self, x):
	embedded = self.embedding(x)
	lstm_out, (h_n, c_n) = self.lstm(embedded)
	h_final = h_n[-1]
	return self.fc(h_final)
LSTM 会返回每个时间步的输出(lstm_out)以及最终状态(h_n、c_n)。对于分类,我们只需要 h_n[-1],即最后一个标记后的隐藏状态。随后用线性层将其映射为类别得分。
当 "This movie was terrible" 进入分类器:
每个词获得其嵌入:四个形状为 (32,) 的向量
LSTM 顺序处理它们。"This" 初始化一些单元状态;"movie" 轻微更新;"was" 中性,变化很小;"terrible" 触发遗忘门清除无关上下文,并触发输入门写入强烈的负面信号。
最终隐藏状态捕捉到累积模式。
线性层将其映射为两个分数:正面与负面
模型并不理解语言。它学习的是统计模式:某些词序与某些标签存在相关性。
下面是我们一步步构建的完整 LSTMClassifier 类:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from datasets import load_dataset
from collections import Counter
import numpy as np

torch.manual_seed(42)
np.random.seed(42)


class LSTMClassifier(nn.Module):
    def __init__(
        Self,
        Vocab_size,
        Embedding_dim,
        Hidden_size,
        Output_size,
        num_layers=1,
        dropout=0.0,
        bidirectional=False,
        padding_idx=0,
    ):
        super().__init__()
        self.hidden_size = hidden_size
    	self.num_layers = num_layers
    	self.bidirectional = bidirectional

    	self.embedding = nn.Embedding(
	    vocab_size, embedding_dim, padding_idx=padding_idx
        )
    	self.lstm = nn.LSTM(
            input_size=embedding_dim,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,
            dropout=dropout if num_layers > 1 else 0,
            bidirectional=bidirectional,
    	)

    	fc_input_size = hidden_size * 2 if bidirectional else hidden_size
    	self.fc = nn.Linear(fc_input_size, output_size)

    def forward(self, x):
    	embedded = self.embedding(x)
    	lstm_out, (h_n, c_n) = self.lstm(embedded)

    	if self.bidirectional:
            h_final = torch.cat([h_n[-2], h_n[-1]], dim=1)
    	else:
            h_final = h_n[-1]

    	return self.fc(h_final)
双向选项会运行两个 LSTM:一个自左向右、一个自右向左。它们的最终隐藏状态会被拼接,从而为模型提供双向上下文。当含义依赖后文时(如 "not bad",其中 "not" 只有结合 "bad" 才有意义),这会很有帮助。
LSTM 需要整数序列,而非字符串。预处理将原始文本转换为三个步骤:
def build_vocab(texts, max_vocab_size=10000):
	counter = Counter()
	for text in texts:
    		counter.update(text.lower().split())

	vocab = {"<pad>": 0, "<unk>": 1}
	for word, _ in counter.most_common(max_vocab_size - 2):
    		vocab[word] = len(vocab)
	return vocab
我们将索引 0 保留给填充,索引 1 保留给未知词。限制词表大小可以过滤缺乏足够样本、难以学到有意义嵌入的生僻词。
def tokenize_and_pad(texts, vocab, max_length=200):
	sequences = []
	for text in texts:
    		tokens = text.lower().split()
    		ids = [vocab.get(t, vocab["<unk>"]) for t in tokens[:max_length]]
    		ids = ids + [vocab["<pad>"]] * (max_length - len(ids))
    		sequences.append(ids)
	return torch.tensor(sequences, dtype=torch.long)
截断到 max_length 限制了 LSTM 需要记忆的跨度。更长的序列保留更多上下文,但会增加计算与内存开销。对于电影评论,100-200 个标记通常就能捕捉关键情感信号。
填充确保所有序列长度一致,便于 PyTorch 将它们批处理成单个张量。填充标记在嵌入后变为零向量,对最终状态影响很小。
def load_imdb_data(max_samples=10000, max_length=200, max_vocab=10000):
	dataset = load_dataset("imdb")

	train_data = dataset["train"].shuffle(seed=42)
	test_data = dataset["test"].shuffle(seed=42)

	train_texts = train_data["text"][:max_samples]
	train_labels = train_data["label"][:max_samples]
	test_texts = test_data["text"][: max_samples // 4]
	test_labels = test_data["label"][: max_samples // 4]

	vocab = build_vocab(train_texts, max_vocab)

	X_train = tokenize_and_pad(train_texts, vocab, max_length)
	X_test = tokenize_and_pad(test_texts, vocab, max_length)
	y_train = torch.tensor(train_labels, dtype=torch.long)
	y_test = torch.tensor(test_labels, dtype=torch.long)

	return X_train, y_train, X_test, y_test, vocab
仅用训练数据构建词表可防止信息泄漏。如果某个生僻词只出现在测试评论中,模型应将其视为未知,而不是在训练期间就已学到其嵌入。
训练循环会根据模型预测与真实值的偏差来更新权重。对 LSTM 而言,有个细节尤为重要:梯度裁剪。
def train_model(model, train_loader, test_loader, n_epochs=5, lr=0.001):
	criterion = nn.CrossEntropyLoss()
	optimizer = torch.optim.Adam(model.parameters(), lr=lr)

	for epoch in range(n_epochs):
    		model.train()
    		total_loss, correct, total = 0, 0, 0

    		for batch_texts, batch_labels in train_loader:
        		optimizer.zero_grad()
        		outputs = model(batch_texts)
        		loss = criterion(outputs, batch_labels)
        		loss.backward()
            		torch.nn.utils.clip_grad_norm_(
	model.parameters(),
	max_norm=5.0)
        		optimizer.step()

        		total_loss += loss.item()
        		_, predicted = outputs.max(1)
        		correct += (predicted == batch_labels).sum().item()
total += batch_labels.size(0)前面我们解释了 LSTM 如何通过对单元状态的加法更新来缓解梯度消失。但梯度爆炸仍有风险。当梯度过大时,权重更新会“越界”,使训练不稳定。
clip_grad_norm_ 会限制总梯度范数。如果梯度将超过 max_norm=5.0,它们会被按比例缩小。这样既能保持更新稳定,又不至于完全抹去梯度信号。
    	model.eval()
    	test_correct, test_total = 0, 0
    	with torch.no_grad():
        	for batch_texts, batch_labels in test_loader:
            		outputs = model(batch_texts)
            		_, predicted = outputs.max(1)
            		test_correct += (predicted == batch_labels).sum().item()
            		test_total += batch_labels.size(0)

    	test_acc = test_correct / test_total
    	print(f"Epoch {epoch+1}: Loss={total_loss/len(train_loader):.4f}, "
          	f"Train={correct/total:.3f}, Test={test_acc:.3f}")

    return test_acc
model.eval() 会在评估时禁用 dropout。 torch.no_grad() 会跳过梯度计算,因为我们不更新权重,这能节省内存并加速推理。
X_train, y_train, X_test, y_test, vocab = load_imdb_data(
	max_samples=10000, max_length=100, max_vocab=5000
)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
test_loader = DataLoader(TensorDataset(X_test, y_test), batch_size=64)

model = LSTMClassifier(
	vocab_size=len(vocab),
	embedding_dim=32,
	hidden_size=32,
	output_size=2,
	padding_idx=vocab["<pad>"],
)

final_acc = train_model(model, train_loader, test_loader, n_epochs=50, lr=0.001)
这些取值体现了权衡:
hidden_size=32:足够小,便于快速迭代。生产模型常用 128-512,但随着规模增大,收益递减且训练变慢。
embedding_dim=32:与隐藏规模匹配很常见,但非必须。更大的嵌入能捕捉更细的词区分,但参数更多。
max_length=100:大多数情感信号出现在评论较早位置。更长序列有助于处理更细微的情况,但当 max_length 翻倍时,内存占用大致会增加四倍。
batch_size=64:更大的批量带来更稳定的梯度估计。小批量有助于跳出局部最优。常见范围为 32-128。
lr=0.001:Adam 的默认值适用于大多数 LSTM 任务。若损失震荡,试试 0.0001;若学习停滞,试试 0.01。
n_epochs=50:足以让模型收敛。若测试准确率在平台期或下降而训练准确率仍上升,说明过拟合。
运行该配置会得到类似如下的输出:
...
Epoch 46: Loss=0.4126, Train=0.812, Test=0.789
Epoch 47: Loss=0.4054, Train=0.815, Test=0.791
Epoch 48: Loss=0.3998, Train=0.818, Test=0.788
Epoch 49: Loss=0.3921, Train=0.821, Test=0.793
Epoch 50: Loss=0.3867, Train=0.824, Test=0.795
训练准确率约为 82%,测试准确率约为 80%。模型学会哪些词模式能预测情感。靠近句末的强烈形容词权重更大;"not" 等否定词会翻转极性;某些短语("waste of time"、"highly recommend")成为强信号。这些都不是硬编码,而是从训练数据的相关性中涌现出来的。
仅做最少调参、且模型较小时,80% 的准确率是合理的。训练与测试准确率之间的小差距表明模型泛化良好,没有严重过拟合。添加 dropout、使用如 GloVe 的预训练嵌入或用更多数据训练,能将准确率推到 80% 后段。
前文的基础 LSTM 架构可用,但无需切换模型家族,也有多种技巧可进一步提升准确率。这些方法已在成千上万的生产部署与研究论文中得到验证。
标准 LSTM 自左向右处理序列,仅从过去的标记构建上下文。双向 LSTM(BiLSTM)同时运行两次:一次正向、一次反向。每个时间步的最终表示结合了之前与之后的信息。
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	bidirectional=True,  # Run both directions
	batch_first=True,
)
# Output size doubles: hidden_size * 2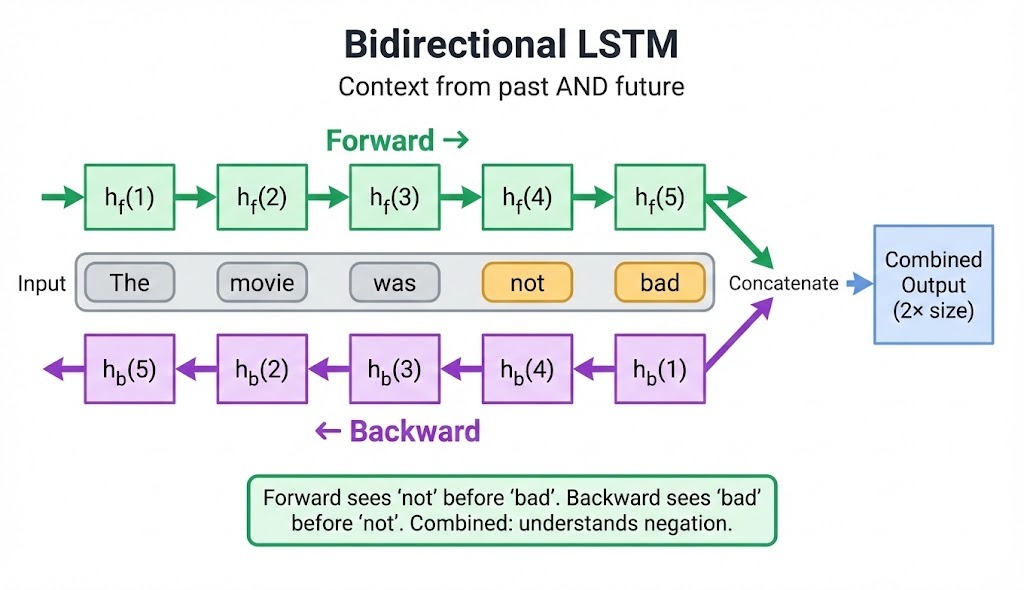
对于情感分析,当否定词出现在其修饰词之后时,这一点很关键:"the movie was not bad" 既需要前向上下文知道有 "bad",也需要后向上下文知道之前有 "not"。
双向 LSTM 在命名实体识别(NER)、情感分类和语音识别等任务上稳定优于单向模型,典型提升为 5-15%。
权衡之处在于:推理时需要完整序列。一次只接收一个标记的流式应用无法使用双向处理。
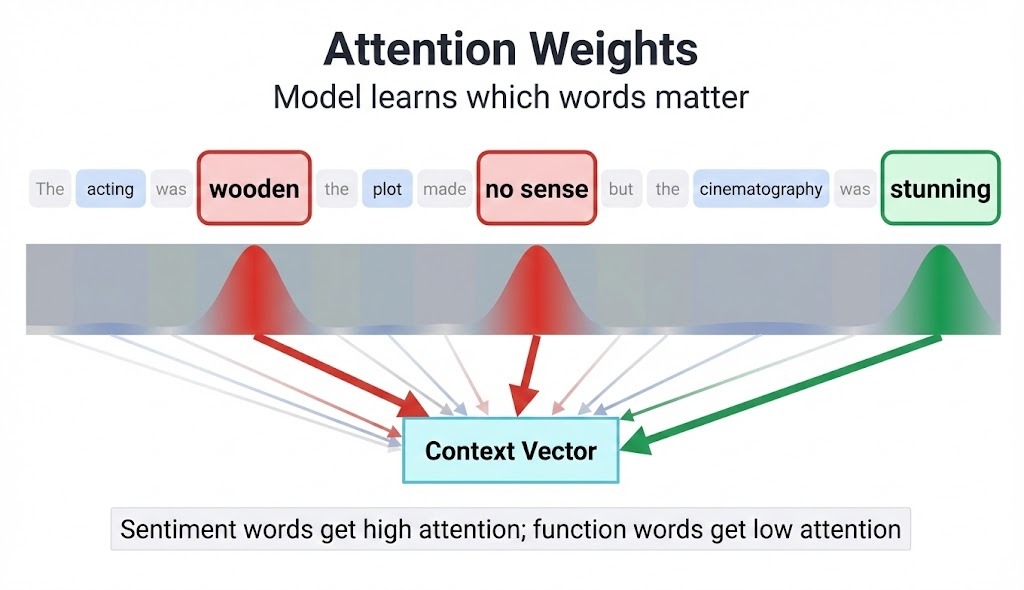
注意力机制让模型为特定预测分配各时间步的重要性权重。它不是把整段序列压缩到最后一个隐藏状态,而是对所有隐藏状态做加权组合。
class AttentionLayer(nn.Module):
	def __init__(self, hidden_size):
    		super().__init__()
    		self.attention = nn.Linear(hidden_size, 1)

	def forward(self, lstm_outputs):
    	# lstm_outputs: (batch, seq_len, hidden_size)
    		scores = self.attention(lstm_outputs)  # (batch, seq_len, 1)
    		weights = torch.softmax(scores, dim=1)
    		context = torch.sum(weights * lstm_outputs, dim=1)
    		return context
在诸如 "The acting was wooden, the plot made no sense, but the cinematography was stunning" 的评论中,注意力会学会聚焦于承载情感的短语,而不是一视同仁地对待所有词。模型会给 "wooden"、"no sense"、"stunning" 更高权重,同时下调 "the" 与 "was"。
注意力带来的额外计算开销很小,且在分类任务上常带来 2-5% 的准确率提升。对于翻译等序列到序列问题,编码器与解码器之间的注意力几乎是获得良好性能的必需。
单层 LSTM 只能捕捉一个抽象层次的模式。堆叠多层可以让网络学习分层特征:第一层可能检测局部短语模式,更高层将其组合为文档级理解。
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=3,  # Stack three layers
	dropout=0.3,   # Dropout between layers (not within)
	batch_first=True,
)
深度指导:
每多一层训练时间大致翻倍。先从浅层起步,只有当验证指标进入平台期时再加深。
LSTM 容易过拟合,尤其是在小数据集上。三种正则化技术能良好配合:
Dropout 会在训练期间随机将部分神经元置零,迫使网络将学习分散到多条路径。将 dropout 应用于层与层之间,不要放在循环连接内部(那会破坏时间学习)。
# PyTorch applies dropout between stacked layers automatically
self.lstm = nn.LSTM(..., num_layers=2, dropout=0.3)

# For single-layer LSTMs, add dropout after
self.dropout = nn.Dropout(0.3)
对多数任务而言,0.2-0.5 的 dropout 率效果良好。更高的数值有助于对抗严重过拟合,但会减慢收敛。
梯度裁剪会在反向传播期间限制梯度大小。虽然 LSTM 缓解了梯度消失,但梯度爆炸仍会发生,尤其是序列很长或网络很深时。
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)典型取值在 1.0 到 5.0 之间。若训练损失突然飙升或出现 NaN,就降低阈值。
早停监控验证损失,并在其不再改善时停止训练。这可防止模型记住训练数据、牺牲泛化能力。
patience = 5
best_val_loss = float('inf')
epochs_without_improvement = 0

for epoch in range(max_epochs):
	train_loss = train_one_epoch(model, train_loader)
	val_loss = evaluate(model, val_loader)

	if val_loss < best_val_loss:
    		best_val_loss = val_loss
    		epochs_without_improvement = 0
    		torch.save(model.state_dict(), 'best_model.pt')
	else:
    		epochs_without_improvement += 1
	if epochs_without_improvement >= patience:
        	break
关于训练循环、评估指标以及 LSTM 常见问题的调试,请参见NLP with PyTorch 指南。
随机初始化嵌入是可行的,但 GloVe 或 Word2Vec 等预训练嵌入能让模型“起步更快”。这些嵌入从数十亿词中学到语义关系:"king" 与 "queen" 会彼此接近,"terrible" 与 "awful" 也会相邻。
import numpy as np

def load_glove_embeddings(glove_path, vocab, embedding_dim):
	embeddings = np.random.randn(len(vocab), embedding_dim) * 0.01

	with open(glove_path, 'r') as f:
    	for line in f:
        	parts = line.split()
        	word = parts[0]
        	if word in vocab:
            		embeddings[vocab[word]] = np.array(parts[1:], dtype=np.float32)

	return torch.tensor(embeddings, dtype=torch.float32)

# Load and freeze or fine-tune
pretrained = load_glove_embeddings('glove.6B.100d.txt', vocab, 100)
model.embedding.weight.data.copy_(pretrained)
model.embedding.weight.requires_grad = True  # Fine-tune during training
当训练数据有限时,预训练嵌入帮助最大。若有数百万样本,随机初始化的嵌入最终也能追上。对大多数 1 万到 10 万样本的实际应用,预训练初始化通常能带来 3-8% 的准确率提升。
这些方法可以叠加。一个生产级文本分类器可能会使用:
每项增加都会提高复杂度和训练时间。先从基线的单层 LSTM 开始,测量性能,然后逐项加入技术,观察在您的特定任务上带来的改进。
从 1990 年代末到 2010 年代中期,LSTM 一直是序列建模的主角。2017 年的 “Attention Is All You Need” 论文改变了这一切。Transformer 现已成为大多数大型语言模型的核心,但 LSTM 并未消失。它们各司其职。
前文讲过 LSTM 如何逐标记处理序列,以及门控机制为何有效。但在大规模下,这种序列依赖就成了瓶颈。您的 GPU 也许有上千个核心,但在隐藏状态链条计算完成前,大多都闲置。一个 500 标记的输入意味着 500 次串行操作。
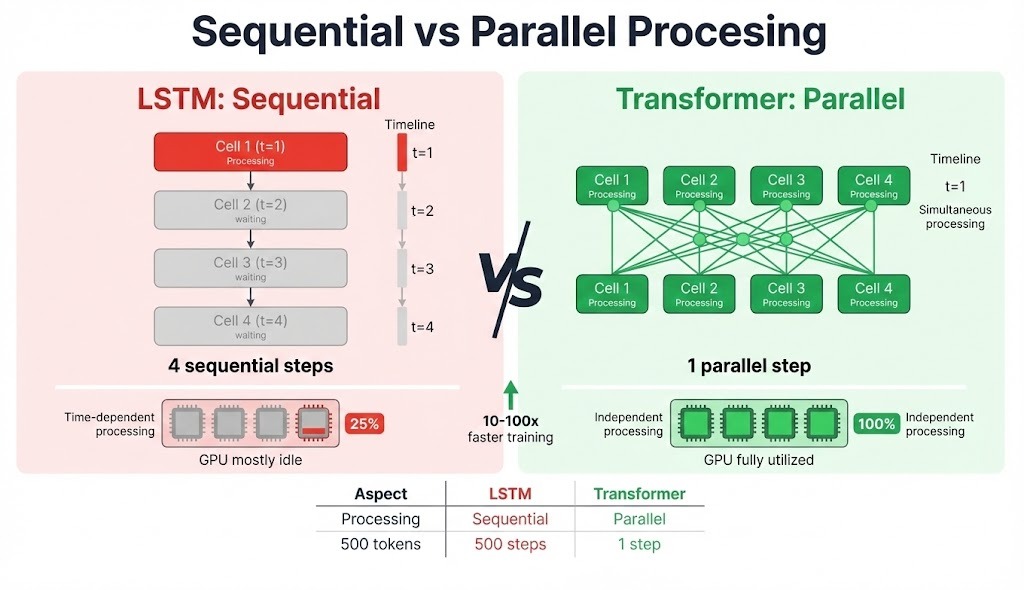
Transformer 没有这种约束。自注意力同时计算所有位置之间的关系,因此同样的 500 标记序列可以并行处理。在现代硬件和大批量下,训练速度可提升 10-100 倍。
序列长度上限也很关键。我们看到 LSTM 比普通 RNN 更能保留梯度,但“更好”不意味着“完美”。性能仍会在大约 200-500 个标记处开始下降,具体取决于任务。
Transformer 直接计算每对位置之间的注意力,因此第 1 个标记与第 1000 个标记的交互同样容易。代价是内存:注意力矩阵的内存随序列长度二次增长。
门的激活值也使解释变得困难。其值介于 0 到 1 且不存在明确边界。Transformer 的注意力权重也并非完美解释,但相较之下,它更清楚地表明了每个输出对应哪些输入标记起了作用。
以下情形适合 Transformer:
以下情形 LSTM 仍然适用:
时间序列预测介于两者之间。最近的基准显示,在单变量且模式一致的数据上,两种架构表现相近。多特征复杂交互时 Transformer 更占优;而当数据稀缺或算力受限时,LSTM 仍然抗打。
混合设计融合了两种方法。有些架构将 LSTM 层与注意力机制堆叠。2024 年发表的 xLSTM 以指数门控与矩阵记忆重访了原始设计,在较小规模下展现出与 Transformer 竞争的结果。
|
Aspect |
LSTM |
Transformer |
|
Processing |
Sequential (token by token) |
Parallel (all positions at once) |
|
Training speed |
Slower (limited parallelization) |
Faster on GPUs |
|
Long-range dependencies |
Degrades beyond 200-500 tokens |
Handles thousands of tokens |
|
Memory scaling |
O(n) with sequence length |
O(n²) for attention matrices |
|
Small data performance |
Good (fewer parameters) |
Prone to overfitting |
|
Edge deployment |
Suitable (lower memory footprint) |
Challenging (large models) |
|
Streaming/real-time |
Native support |
Requires full sequence |
|
Pretrained ecosystem |
Limited |
Extensive (BERT, GPT, etc.) |
抉择通常取决于约束条件。若算力与数据不设限,Transformer 在大多数 NLP 任务上胜出。若目标是一个只有 1 万样本的微控制器,LSTM 依然实用。
LSTM 于 1997 年问世时,解决了一个真实存在的问题。Hochreiter 与 Schmidhuber 引入的门控机制,让网络终于能从超过几十个标记的序列中学习。这一架构在近二十年里推动了机器翻译、语音识别与时间序列预测的发展。
如今 Transformer 处理大多数大规模 NLP 任务,但 LSTM 并未过时。在边缘部署、流式应用以及训练数据有限的场景中,它们仍然合适。
如果您正开启一个新的序列建模项目,不妨先试试一个简单的 LSTM。测量其表现,了解其失败模式,再决定该问题是否真的需要 Transformer。本文介绍的概念(门控、单元状态、梯度流)可直接迁移到对更复杂架构的理解。
若想进行实践,我推荐参加我们的 Recurrent Neural Networks 课程,其中包含更多 LSTM 应用与引导练习。
机器学习课程
课程
课程
课程