
Curso
Redes Neurais Recorrentes (RNNs) para Modelagem de Linguagem com Keras
4 h
16.4K
Redes neurais recorrentes padrão têm dificuldade com memória. À medida que sequênciass crescem além de 20–30 passos de tempo, os gradientes ou encolhem até zero ou explodem durante a backpropagation, e a rede perde a capacidade de conectar partes distantes da entrada. Hochreiter e Schmidhuber enfrentaram esse problema em seu artigo de 1997 apresentando as redes Long Short-Term Memory.
Neste guia, vou percorrer os detalhes internos das LSTMs antes de partir para a implementação prática em Python. As seções finais comparam LSTMs com Transformers para você escolher a arquitetura certa para o seu caso de uso.
Eu recomendo muito nosso curso Introduction to Deep Learning in PyTorch para ganhar experiência prática usando PyTorch para treinar redes neurais, base dos modelos LSTM.
LSTM significa Long Short-Term Memory, um tipo de rede neural recorrente (RNN) projetada para lidar com sequências em que o contexto de muito antes na entrada ainda importa.
A ideia central por trás das LSTMs é um mecanismo de portas que regula o fluxo de informação pela rede. Em vez de deixar todos os sinais passarem igualmente, as portas aprendem quando reter o contexto e quando deixá-lo ir.
Essa memória seletiva permite às LSTMs acompanhar dependências por centenas de passos de tempo, algo útil para modelagem de linguagem, reconhecimento de fala e previsão de séries temporais. Para entender por que essa arquitetura existe, ajuda ver o que quebra nas RNNs padrão.
Redes recorrentes passam informação de um passo de tempo para o seguinte por meio de um estado oculto. Cada passo multiplica esse estado por pesos aprendidos, o atualiza e o passa adiante. Treinar requer enviar sinais de erro para trás por todos esses passos, e cada passagem para trás diminui um pouco o sinal. Depois de passos suficientes, não sobra nada.
É como tirar cópia de uma cópia. Fazer isso algumas vezes fica aceitável. Fazer cinquenta vezes, o texto mal dá para ler. As RNNs batem nesse limite por volta de 20–30 passos, por isso sofrem com sequências longas.
As LSTMs adicionam uma trilha de memória separada, chamada de estado da célula (cell state), que roda em paralelo ao estado oculto padrão. A diferença é estrutural: a informação no estado da célula flui por adição, não por multiplicações repetidas, então não se degrada do mesmo jeito.
Para controlar o que entra e sai dessa memória, LSTMs usam portas. Cada porta é uma pequena rede neural que aprende a produzir valores entre 0 e 1, agindo como filtro. Valor perto de 0 bloqueia informação; valor perto de 1 deixa passar. A rede aprende durante o treinamento quais padrões valem a pena lembrar ao longo de longas sequências e quais podem ser descartados.
Esse mecanismo de portas é o que diferencia LSTMs das RNNs simples. Em vez de forçar toda informação pelo mesmo caminho, LSTMs podem preservar contexto seletivamente por centenas de passos. A próxima seção detalha como essas portas funcionam e como se combinam para atualizar o estado da célula.
LSTMs aparecem sempre que dados sequenciais importam. Alguns exemplos além de NLP e previsão:
Esta seção cobre os internos de LSTM em detalhe. Se quiser ir direto para a implementação, pule para a próxima seção. Os detalhes aqui não são obrigatórios para usar LSTMs, mas ajudam muito ao depurar ou ajustar.
Para entender como LSTMs funcionam, vamos seguir um exemplo concreto: processar a sequência "The clouds are dark..." para prever a próxima palavra. Cada componente faz mais sentido quando vemos o que ele faz com dados reais.
Uma LSTM mantém dois vetores separados que fluem pela rede: o estado da célula e o estado oculto.
O estado da célula atua como armazenamento de longo prazo. Ele carrega informação através de passos, com modificações controladas em cada etapa. No nosso exemplo, o estado da célula pode guardar "substantivo relacionado a clima apareceu" após ver "clouds" e preservar esse contexto por "are", até que "dark" reforce o padrão.
O estado oculto é a saída da célula em cada passo. Ele entra nas previsões e nos cálculos do próximo passo. Depois de processar "dark", o estado oculto codifica algo como "adjetivo descrevendo condições climáticas" que uma camada de previsão pode usar.
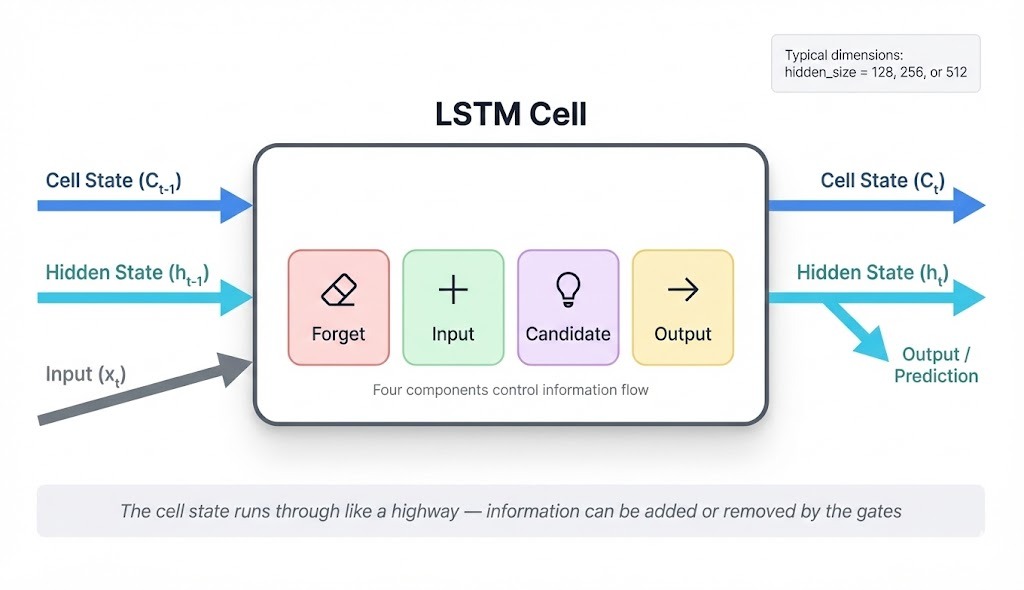
Por que duas trilhas separadas? Um único estado teria de manter contexto de longo prazo e, ao mesmo tempo, produzir saídas úteis. Esses objetivos conflitam: memória estável exige pouca mudança, enquanto saídas úteis exigem transformação. Separá-los permite que cada trilha otimize para seu propósito.
A cada passo, a célula recebe três entradas e produz duas saídas:
Entradas:
Estado da célula anterior (C_{t-1}): o que a rede lembra até agora
Estado oculto anterior (h_{t-1}): a saída do último passo
Entrada atual (x_t): o novo token, como "clouds" ou "dark"
Saídas:
Estado da célula atualizado (C_t): memória após processar este token
Novo estado oculto (h_t): a saída deste passo
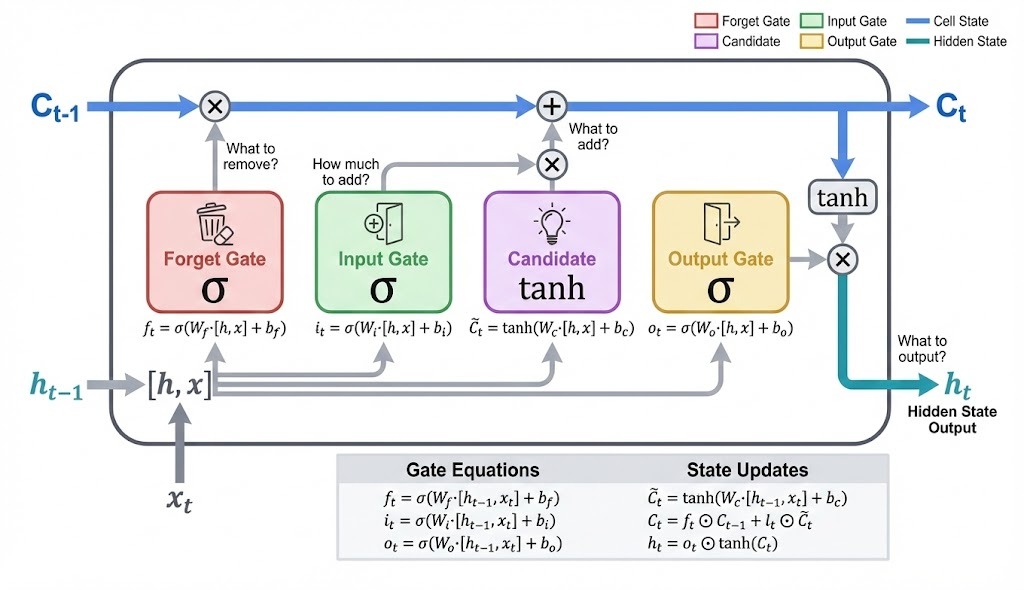
Quatro componentes controlam o que acontece dentro da célula. Três são portas que produzem valores entre 0 e 1, agindo como filtros. O quarto é o candidato, que propõe novo conteúdo.
Quando "are" chega após "clouds", cada componente tem um papel:
Porta de esquecimento (f_t): devemos manter o contexto de "clouds"? Substantivos de clima seguidos por verbos de ligação geralmente importam, então a porta gera valores próximos de 1 para preservar a maior parte do estado da célula.
Porta de entrada (i_t): quanto "are" deve contribuir para a memória? Verbos de ligação carregam menos sinal preditivo, então a porta de entrada gera valores mais baixos.
Candidato (C̃_t): que nova informação "are" poderia adicionar? O candidato propõe conteúdo, mas a porta de entrada o reduz.
Porta de saída (o_t): o que o estado oculto deve mostrar? A porta de saída filtra o estado da célula para produzir h_t.
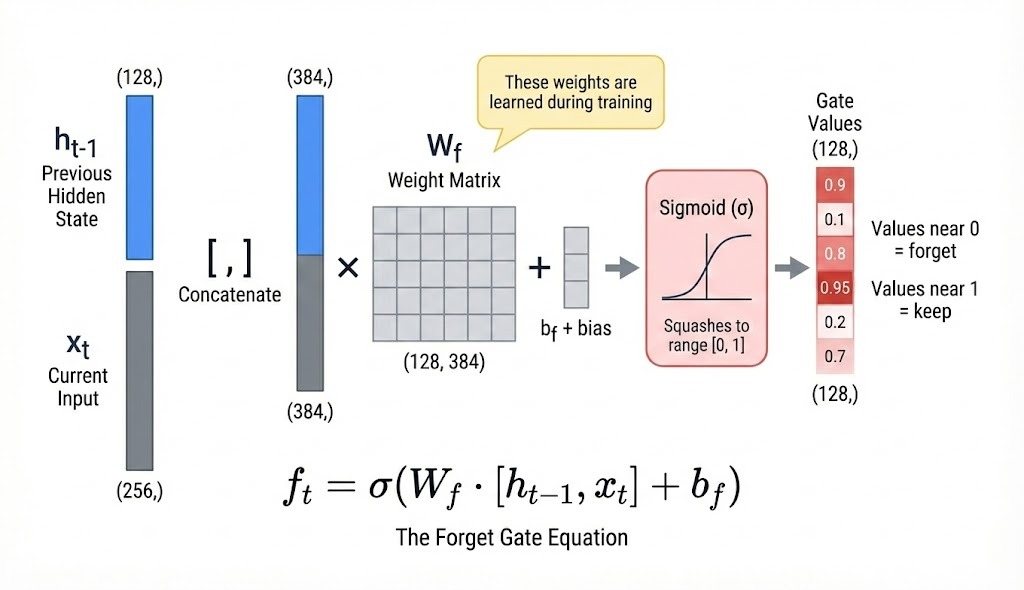
Cada componente calcula sua saída do mesmo modo:
Concatene h_{t-1} e x_t em um vetor
Multiplique por uma matriz de pesos aprendida
Some um termo de viés (bias)
Aplique uma função de ativação
As portas usam ativação sigmoid, que comprime valores para o intervalo 0–1. O candidato usa tanh, produzindo valores entre -1 e 1, assim pode propor aumentos e reduções no estado da célula.
Porta de esquecimento (sigmoid → 0 a 1):
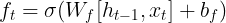
Porta de entrada (sigmoid → 0 a 1):
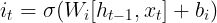
Porta de saída (sigmoid → 0 a 1):
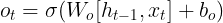
Candidato (tanh → -1 a +1):
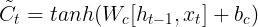
Cada componente tem sua própria matriz de pesos (W_f, W_i, W_c, W_o), então elas aprendem a responder a diferentes padrões na entrada.
As saídas das portas multiplicam vetores posição a posição (multiplicação elemento a elemento, escrita como ⊙). Cada dimensão é filtrada de forma independente.
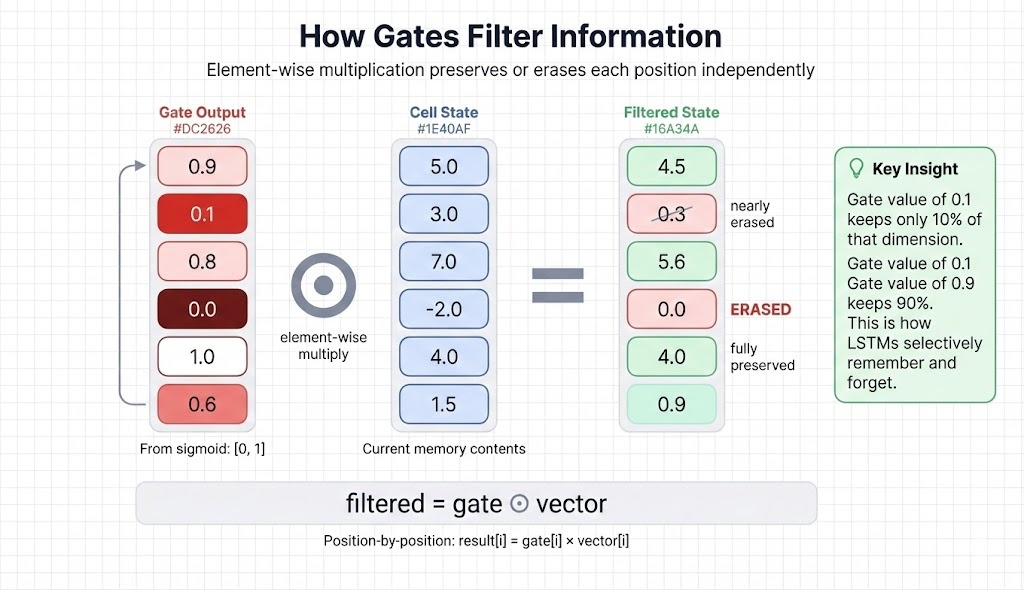
Se uma porta gera 0,9 para a posição 1, aquela dimensão mantém 90% do seu valor. Se gera 0,0 para a posição 4, aquela dimensão é zerada. Ao processar "dark" depois de "clouds are", a porta de esquecimento pode gerar valores altos para dimensões que guardam contexto de substantivo/clima e mais baixos para dimensões com contexto anterior irrelevante.
Os componentes se combinam em três passos para atualizar o estado da célula e produzir o estado oculto.
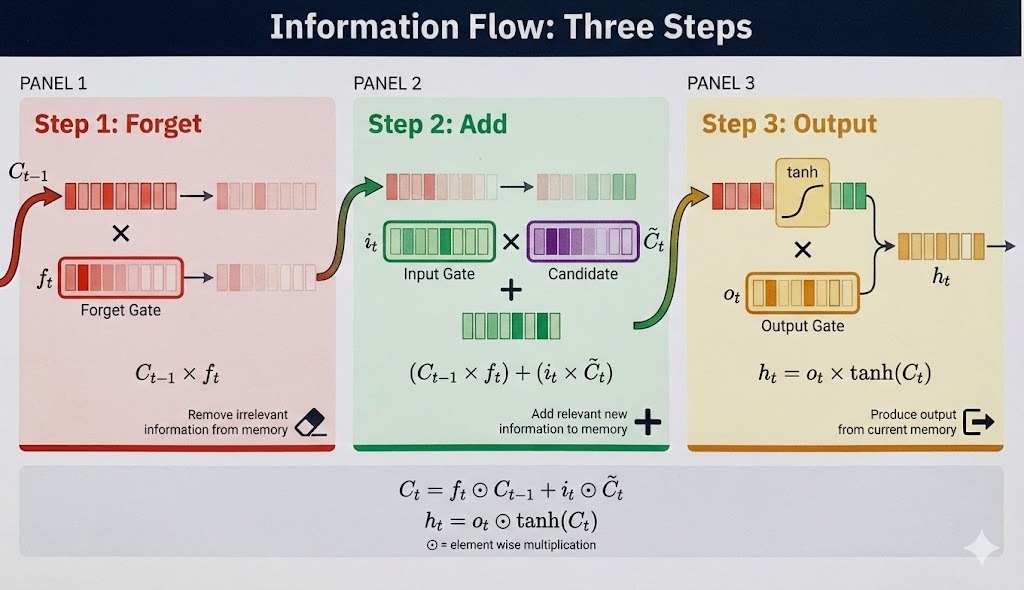
A porta de esquecimento filtra o estado da célula anterior: 
Processando "dark", a porta de esquecimento preserva o contexto de clima de "clouds" enquanto limpa dimensões que rastreavam o artigo "The".
A porta de entrada escala a proposta do candidato e depois a adiciona ao estado da célula filtrado:
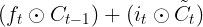
O candidato pode propor "adjetivo modificando substantivo de clima", e a porta de entrada decide quão forte escrever isso na memória. Essa atualização aditiva (não multiplicativa) é o que ajuda os gradientes a fluírem durante o treinamento.
O estado da célula passa por tanh, então a porta de saída filtra o que vira estado oculto:
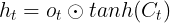
A tanh mantém os valores limitados. A porta de saída seleciona quais aspectos da memória acumulada devem ficar visíveis para as previsões neste passo.
A sequência completa:
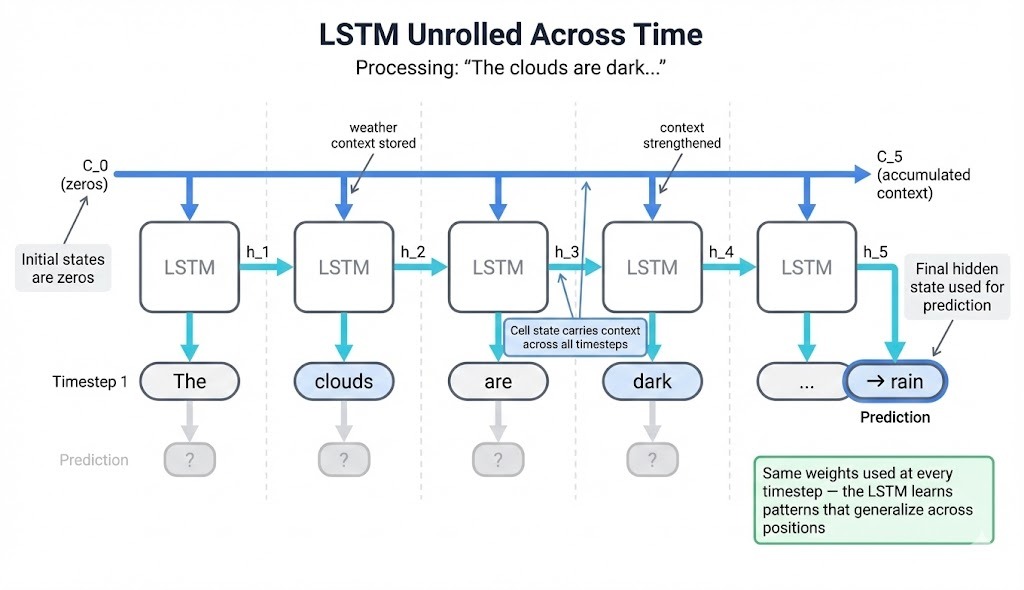
Aqui está um traço simplificado com um estado da célula de 4 dimensões:
|
Passo |
Entrada |
Estado da célula (simplificado) |
O que acontece |
|
1 |
"The" |
[0.1, 0.0, 0.2, 0.0] |
Armazena o mínimo; artigos têm pouco sinal preditivo |
|
2 |
"clouds" |
[0.1, 0.7, 0.2, 0.3] |
Porta de entrada abre nas dimensões 2 e 4; guarda padrão de substantivo |
|
3 |
"are" |
[0.1, 0.6, 0.2, 0.3] |
Porta de esquecimento ≈ 0,9 preserva o contexto; verbo de ligação adiciona pouco |
|
4 |
"dark" |
[0.1, 0.8, 0.5, 0.6] |
O adjetivo fortalece o sinal nas dimensões 2, 3 e 4 |
No passo 4, as dimensões 2–4 acumularam um padrão. O estado oculto h_4 alimenta uma camada de previsão (fora da LSTM), que produz probabilidades no vocabulário. Esse padrão acumulado ajuda o modelo a favorecer palavras como "rain" ou "sky".
A rede não "entende" clima. Ela aprende correlações estatísticas: certas sequências de entrada tendem a preceder certas saídas.
A estrutura aditiva do estado da célula oferece um caminho de gradiente mais direto do que RNNs padrão. Se você não está familiarizado com como os gradientes se propagam por redes neurais, o tutorial de backpropagation apresenta os fundamentos.
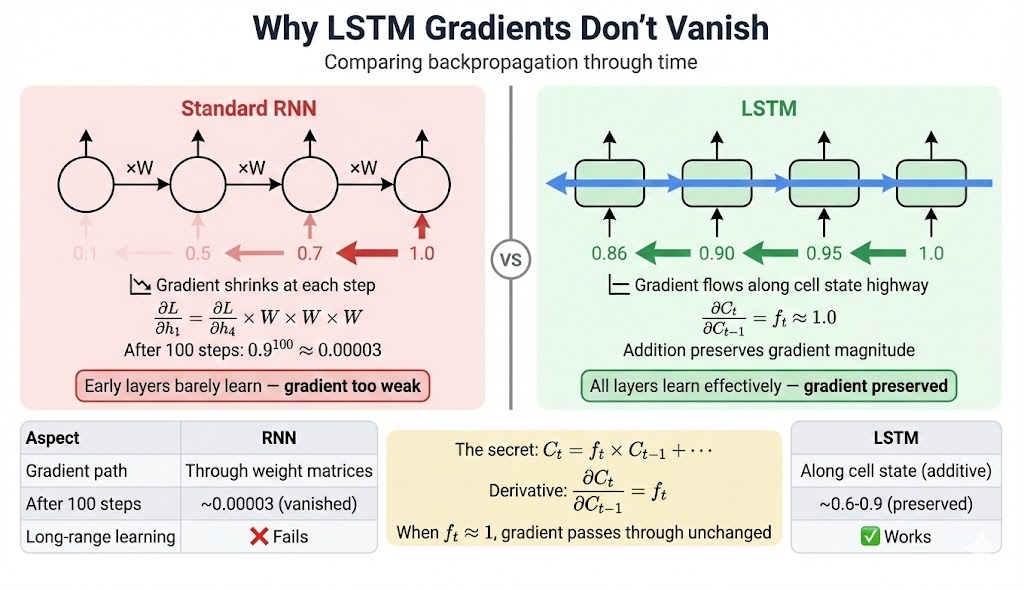
Em RNNs padrão, gradientes fluem por matrizes de pesos a cada passo. A multiplicação repetida se acumula: após 100 passos com pesos médios de 0,9, o gradiente encolhe para 0.9^100 ≈ 0.00003.
LSTMs oferecem um caminho alternativo ao longo do estado da célula. A derivada de C_t em relação a C_{t-1}:
∂C_t/∂C_{t-1} = f_tEsse é o valor da porta de esquecimento, não uma matriz de pesos. Quando as portas de esquecimento ficam perto de 1, os gradientes passam com menos decaimento. Se as portas em média forem 0,95, após 100 passos: 0.95^100 ≈ 0.006. Ainda reduzido, mas utilizável.
|
Aspecto |
RNN |
LSTM |
|
Caminho do gradiente |
Apenas matrizes de pesos |
Caminho adicional pelo estado da célula |
|
Gradiente em 100 passos |
~10^-5 (desaparecido) |
~10^-2 a 10^-1 (utilizável) |
|
Memória prática |
~10–20 passos |
~50–200 passos |
Nota prática: os vieses da porta de esquecimento costumam ser inicializados em 1,0 ou mais, empurrando as saídas iniciais para "lembrar tudo". Isso ajuda a rede a aprender padrões de longo prazo logo no início do treinamento.
LSTMs mitigam o problema do gradiente que desaparece, não o eliminam. A melhoria vem da atualização aditiva do estado da célula, que fornece uma via expressa de gradiente ao lado dos caminhos padrão.
A seção anterior cobriu o que acontece dentro de uma célula LSTM: portas filtrando informação, estado da célula preservando contexto e estado oculto produzindo saídas. Agora veremos como o nn.LSTM do PyTorch encapsula tudo isso em um único módulo e o usa para classificar resenhas de filmes como positivas ou negativas.
Dica para executar o código: treinar por 50 épocas em CPU demora bastante. Use o Google Colab ou Kaggle Notebooks com GPU para acelerar. O script completo está disponível como um GitHub Gist.
Classificação de texto com LSTMs segue um padrão: converter palavras em vetores, deixar a LSTM processá-las sequencialmente e usar a saída final para previsão.
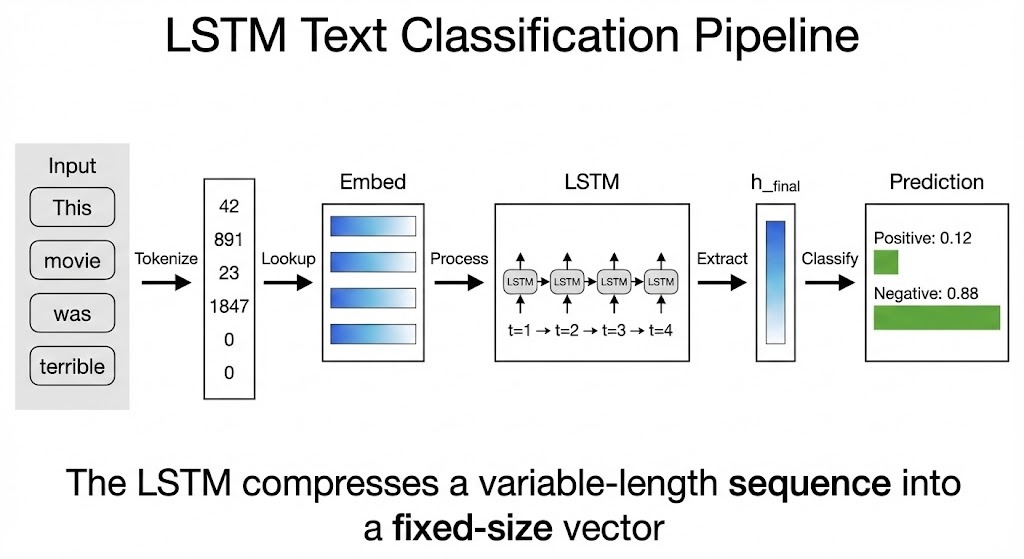
Redes neurais operam com números contínuos, mas palavras são símbolos discretos. Não dá para alimentar "terrible" diretamente em multiplicações de matriz. A solução é uma camada de embedding: uma tabela de consulta em que cada palavra mapeia para um vetor treinável.
self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=padding_idx)Se você escolher embedding_dim=32, cada palavra vira um vetor de 32 dimensões. No começo do treinamento, esses vetores são aleatórios. Conforme o modelo aprende, palavras com sentimento semelhante ficam mais próximas nesse espaço vetorial. "Terrible", "awful" e "boring" podem acabar perto, enquanto "excellent" e "amazing" formam outro agrupamento.
O argumento padding_idx informa à camada para manter os tokens de padding como vetores zero, para não influenciarem o modelo.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=num_layers,
	batch_first=True,
	dropout=dropout if num_layers > 1 else 0,
	bidirectional=bidirectional,
)
Essa única linha cria toda a engenharia de portas da seção anterior. O hidden_size determina quanta informação o estado da célula e o estado oculto conseguem carregar. Valores maiores permitem rastrear mais padrões, mas exigem mais computação.
Definir batch_first=True significa que as entradas têm formato (batch, sequence_length, embedding_dim). A LSTM processa cada posição da esquerda para a direita, atualizando seus estados internos a cada passo.
Depois de processar "This movie was absolutely terrible", a LSTM viu todas as palavras. Seu estado oculto final acumulou o que o modelo aprendeu a extrair daquela sequência. Para sentimento, isso pode codificar algo como "adjetivo fortemente negativo no fim, anulando conteúdo neutro anterior".
def forward(self, x):
	embedded = self.embedding(x)
	lstm_out, (h_n, c_n) = self.lstm(embedded)
	h_final = h_n[-1]
	return self.fc(h_final)
A LSTM retorna saídas por passo (lstm_out) e estados finais (h_n, c_n). Para classificação, precisamos apenas de h_n[-1], o estado oculto após o último token. Uma camada linear mapeia isso para as classes.
Quando "This movie was terrible" entra no classificador:
Cada palavra recebe seu embedding: quatro vetores de forma (32,)
A LSTM os processa em sequência. "This" inicializa algum estado da célula. "Movie" o atualiza levemente. "Was" é neutro e muda pouco. "Terrible" aciona a porta de esquecimento para limpar contexto irrelevante e a porta de entrada para escrever um forte sinal negativo.
O estado oculto final captura o padrão acumulado.
A camada linear mapeia isso para duas pontuações: uma para positivo, outra para negativo
O modelo não entende linguagem. Ele aprende padrões estatísticos: certas sequências de palavras se correlacionam com certos rótulos.
Abaixo, você vê a classe LSTMClassifier inteira que criamos passo a passo:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from datasets import load_dataset
from collections import Counter
import numpy as np

torch.manual_seed(42)
np.random_seed(42)


class LSTMClassifier(nn.Module):
    def __init__(
        Self,
        Vocab_size,
        Embedding_dim,
        Hidden_size,
        Output_size,
        num_layers=1,
        dropout=0.0,
        bidirectional=False,
        padding_idx=0,
    ):
        super().__init__()
        self.hidden_size = hidden_size
    	self.num_layers = num_layers
    	self.bidirectional = bidirectional

    	self.embedding = nn.Embedding(
	    vocab_size, embedding_dim, padding_idx=padding_idx
        )
    	self.lstm = nn.LSTM(
            input_size=embedding_dim,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,
            dropout=dropout if num_layers > 1 else 0,
            bidirectional=bidirectional,
    	)

    	fc_input_size = hidden_size * 2 if bidirectional else hidden_size
    	self.fc = nn.Linear(fc_input_size, output_size)

    def forward(self, x):
    	embedded = self.embedding(x)
    	lstm_out, (h_n, c_n) = self.lstm(embedded)

    	if self.bidirectional:
            h_final = torch.cat([h_n[-2], h_n[-1]], dim=1)
    	else:
            h_final = h_n[-1]

    	return self.fc(h_final)
A opção bidirecional executa duas LSTMs: uma esquerda→direita, outra direita→esquerda. Seus estados ocultos finais são concatenados, dando ao modelo contexto de ambas as direções. Isso ajuda quando o sentido depende do que vem depois, como em "not bad", em que "not" só faz sentido dado "bad".
LSTMs precisam de sequências de inteiros, não strings. O pré-processamento converte o texto bruto em três passos:
def build_vocab(texts, max_vocab_size=10000):
	counter = Counter()
	for text in texts:
    		counter.update(text.lower().split())

	vocab = {"<pad>": 0, "<unk>": 1}
	for word, _ in counter.most_common(max_vocab_size - 2):
    		vocab[word] = len(vocab)
	return vocab
Reservamos o índice 0 para padding e o 1 para palavras desconhecidas. Limitar o tamanho do vocabulário filtra termos raros que não têm exemplos suficientes para aprender embeddings significativos.
def tokenize_and_pad(texts, vocab, max_length=200):
	sequences = []
	for text in texts:
    		tokens = text.lower().split()
    		ids = [vocab.get(t, vocab["<unk>"]) for t in tokens[:max_length]]
    		ids = ids + [vocab["<pad>"]] * (max_length - len(ids))
    		sequences.append(ids)
	return torch.tensor(sequences, dtype=torch.long)
Truncar em max_length limita até onde a LSTM precisa lembrar. Sequências mais longas preservam mais contexto, mas aumentam custo computacional e de memória. Para resenhas, 100–200 tokens costumam capturar os sinais-chave de sentimento.
O padding garante que toda sequência tenha o mesmo comprimento, permitindo ao PyTorch agrupá-las em um único tensor. Os tokens de padding viram vetores zero após o embedding e pouco contribuem para o estado final.
def load_imdb_data(max_samples=10000, max_length=200, max_vocab=10000):
	dataset = load_dataset("imdb")

	train_data = dataset["train"].shuffle(seed=42)
	test_data = dataset["test"].shuffle(seed=42)

	train_texts = train_data["text"][:max_samples]
	train_labels = train_data["label"][:max_samples]
	test_texts = test_data["text"][: max_samples // 4]
	test_labels = test_data["label"][: max_samples // 4]

	vocab = build_vocab(train_texts, max_vocab)

	X_train = tokenize_and_pad(train_texts, vocab, max_length)
	X_test = tokenize_and_pad(test_texts, vocab, max_length)
	y_train = torch.tensor(train_labels, dtype=torch.long)
	y_test = torch.tensor(test_labels, dtype=torch.long)

	return X_train, y_train, X_test, y_test, vocab
Construir o vocabulário apenas com os dados de treino evita vazamento de informação. Se uma palavra rara aparecer só no teste, o modelo deve tratá-la como desconhecida, e não ter aprendido seu embedding durante o treino.
O loop de treinamento atualiza os pesos do modelo conforme o erro das previsões. Para LSTMs, um detalhe importa mais que o usual: clipping de gradiente.
def train_model(model, train_loader, test_loader, n_epochs=5, lr=0.001):
	criterion = nn.CrossEntropyLoss()
	optimizer = torch.optim.Adam(model.parameters(), lr=lr)

	for epoch in range(n_epochs):
    		model.train()
    		total_loss, correct, total = 0, 0, 0

    		for batch_texts, batch_labels in train_loader:
        		optimizer.zero_grad()
        		outputs = model(batch_texts)
        		loss = criterion(outputs, batch_labels)
        		loss.backward()
            		torch.nn.utils.clip_grad_norm_(
	model.parameters(),
	max_norm=5.0)
        		optimizer.step()

        		total_loss += loss.item()
        		_, predicted = outputs.max(1)
        		correct += (predicted == batch_labels).sum().item()
total += batch_labels.size(0)Mais cedo explicamos como LSTMs mitigam gradientes que somem com atualizações aditivas no estado da célula. Mas gradientes explodindo ainda são risco. Quando crescem demais, as atualizações de peso passam do ponto e desestabilizam o treinamento.
clip_grad_norm_ limita a magnitude total do gradiente. Se os gradientes excederem max_norm=5.0, eles são reescalados proporcionalmente. Isso mantém as atualizações estáveis sem eliminar o sinal por completo.
    	model.eval()
    	test_correct, test_total = 0, 0
    	with torch.no_grad():
        	for batch_texts, batch_labels in test_loader:
            		outputs = model(batch_texts)
            		_, predicted = outputs.max(1)
            		test_correct += (predicted == batch_labels).sum().item()
            		test_total += batch_labels.size(0)

    	test_acc = test_correct / test_total
    	print(f"Epoch {epoch+1}: Loss={total_loss/len(train_loader):.4f}, "
          	f"Train={correct/total:.3f}, Test={test_acc:.3f}")

    return test_acc
model.eval() desativa dropout durante avaliação. torch.no_grad() pula o cálculo de gradientes já que não vamos atualizar pesos, economizando memória e acelerando a inferência.
X_train, y_train, X_test, y_test, vocab = load_imdb_data(
	max_samples=10000, max_length=100, max_vocab=5000
)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
test_loader = DataLoader(TensorDataset(X_test, y_test), batch_size=64)

model = LSTMClassifier(
	vocab_size=len(vocab),
	embedding_dim=32,
	hidden_size=32,
	output_size=2,
	padding_idx=vocab["<pad>"],
)

final_acc = train_model(model, train_loader, test_loader, n_epochs=50, lr=0.001)
Esses valores refletem trade-offs:
hidden_size=32: Pequeno o bastante para iterar rápido. Em produção, usa-se 128–512, mas com ganhos decrescentes e treino mais lento.
embedding_dim=32: Combinar com o hidden size é comum, mas não obrigatório. Embeddings maiores capturam distinções mais finas a custo de mais parâmetros.
max_length=100: A maioria dos sinais de sentimento aparece cedo nas resenhas. Sequências mais longas ajudam em casos sutis, mas quadruplicam memória para um max_length duas vezes maior.
batch_size=64: Lotes maiores dão gradientes mais estáveis. Lotes menores podem ajudar a escapar de mínimos locais. 32–128 é típico.
lr=0.001: O padrão do Adam funciona na maioria das tarefas com LSTM. Se a perda oscilar, tente 0,0001. Se travar, tente 0,01.
n_epochs=50: O suficiente para o modelo convergir. Fique de olho se a acurácia de teste estagnar ou cair enquanto a de treino continua subindo, sinalizando overfitting.
Rodando essa configuração, você verá algo como:
...
Epoch 46: Loss=0.4126, Train=0.812, Test=0.789
Epoch 47: Loss=0.4054, Train=0.815, Test=0.791
Epoch 48: Loss=0.3998, Train=0.818, Test=0.788
Epoch 49: Loss=0.3921, Train=0.821, Test=0.793
Epoch 50: Loss=0.3867, Train=0.824, Test=0.795
A acurácia de treino chega a ~82% enquanto a de teste fica perto de 80%. O modelo aprende quais padrões de palavras predizem sentimento. Adjetivos fortes no final pesam mais. Negação como "not" inverte polaridade. Certas frases ("waste of time", "highly recommend") viram sinais fortes. Nada disso é programado; emerge das correlações nos dados de treino.
Com pouco ajuste e um modelo pequeno, 80% de acurácia é razoável. A pequena diferença entre treino e teste mostra boa generalização sem overfitting severo. Adicionar dropout, usar embeddings pré-treinados como GloVe ou treinar com mais dados pode levar a acurácia para a casa dos 80 altos.
A arquitetura LSTM básica funciona, mas várias técnicas podem aumentar a acurácia sem migrar para outra família de modelos. Essas abordagens foram validadas em milhares de implantações e artigos científicos.
LSTMs padrão processam sequências da esquerda para a direita, construindo contexto apenas do passado. LSTMs bidirecionais (BiLSTMs) rodam duas passagens paralelas: uma para frente, outra para trás. A representação final em cada passo combina o que veio antes e o que vem depois.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	bidirectional=True,  # Run both directions
	batch_first=True,
)
# Output size doubles: hidden_size * 2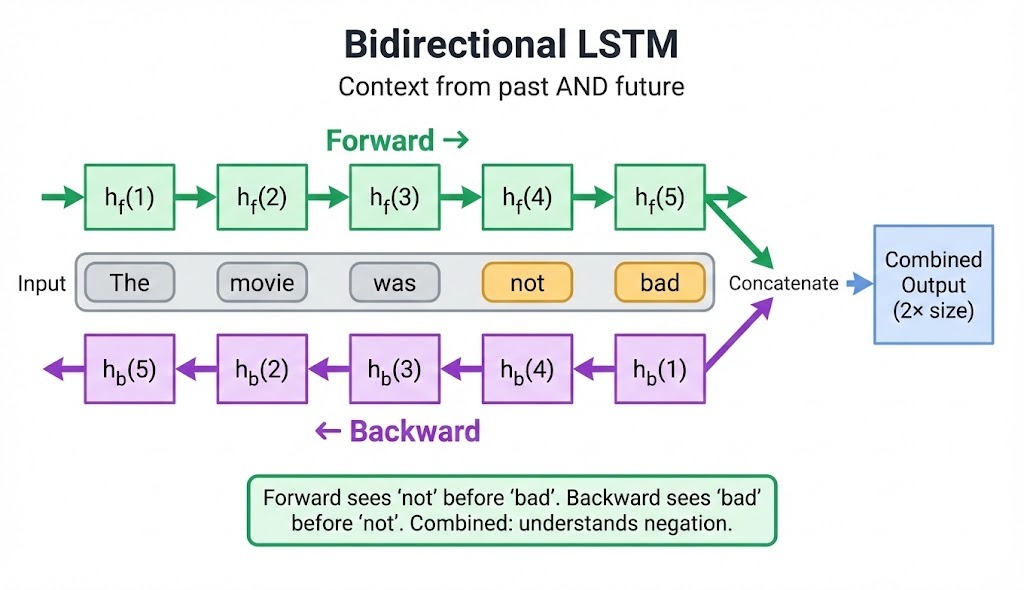
Para análise de sentimento, isso importa quando a negação aparece depois da palavra que modifica: "the movie was not bad" precisa do contexto para frente para saber que "bad" existe, e do contexto para trás para saber que "not" o precede.
BiLSTMs superam consistentemente modelos unidirecionais em reconhecimento de entidades nomeadas (NER), classificação de sentimento e reconhecimento de fala, com ganhos típicos de 5–15%.
O trade-off: você precisa da sequência completa na inferência. Aplicações de streaming que recebem tokens um a um não podem usar processamento bidirecional.
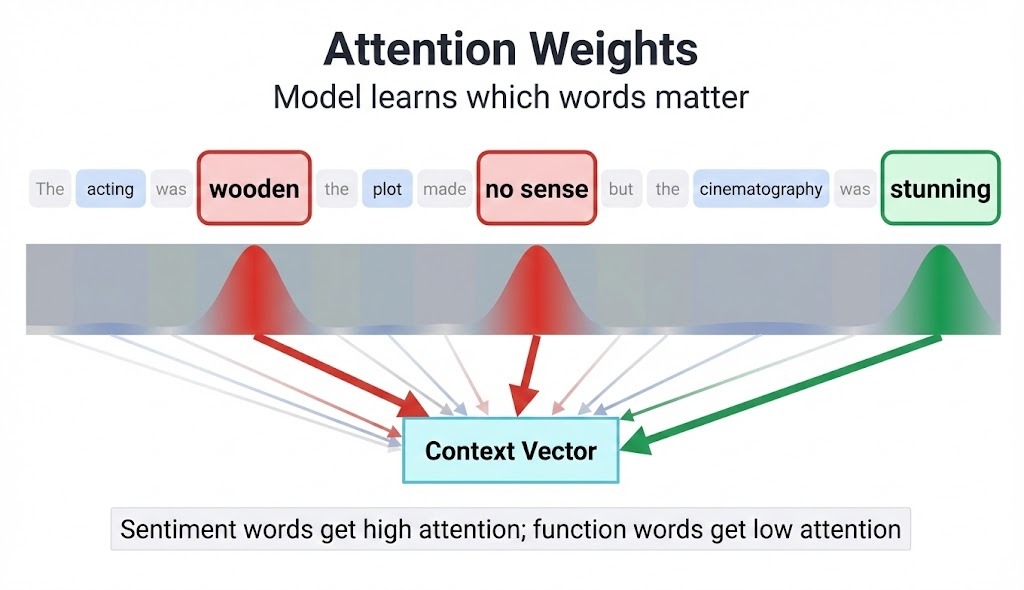
Attention permite ao modelo ponderar quais passos de tempo mais importam para uma previsão. Em vez de comprimir a sequência inteira em um único estado oculto final, atenção calcula uma combinação ponderada de todos os estados ocultos.
class AttentionLayer(nn.Module):
	def __init__(self, hidden_size):
    		super().__init__()
    		self.attention = nn.Linear(hidden_size, 1)

	def forward(self, lstm_outputs):
    	# lstm_outputs: (batch, seq_len, hidden_size)
    		scores = self.attention(lstm_outputs)  # (batch, seq_len, 1)
    		weights = torch.softmax(scores, dim=1)
    		context = torch.sum(weights * lstm_outputs, dim=1)
    		return context
Em uma resenha como "The acting was wooden, the plot made no sense, but the cinematography was stunning", atenção aprende a focar em frases que carregam sentimento, em vez de tratar todas as palavras igualmente. O modelo dá pesos maiores a "wooden", "no sense" e "stunning" e reduz "the" e "was".
Atenção adiciona sobrecarga computacional mínima e costuma render melhorias de 2–5% em tarefas de classificação. Para problemas seqüência‑a‑seqüência como tradução, atenção entre codificador e decodificador é quase obrigatória para bom desempenho.
Uma única camada LSTM captura padrões em um nível de abstração. Empilhar múltiplas camadas permite aprender recursos hierárquicos: a primeira camada detecta padrões locais de frases; camadas superiores combinam isso em entendimento de documento.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=3,  # Stack three layers
	dropout=0.3,   # Dropout between layers (not within)
	batch_first=True,
)
Diretrizes para profundidade:
Cada camada adicional mais que dobra o tempo de treinamento. Comece raso e aumente a profundidade só se as métricas de validação estagnarem.
LSTMs fazem overfitting com facilidade, especialmente em datasets pequenos. Três técnicas de regularização funcionam bem juntas:
Dropout zera neurônios aleatoriamente durante o treino, forçando a rede a distribuir o aprendizado por vários caminhos. Aplique dropout entre camadas LSTM, não dentro das conexões recorrentes (o que pode prejudicar o aprendizado temporal).
# O PyTorch aplica dropout automaticamente entre camadas empilhadas
self.lstm = nn.LSTM(..., num_layers=2, dropout=0.3)

# Para LSTM de uma camada, adicione dropout depois
self.dropout = nn.Dropout(0.3)
Taxas de 0,2–0,5 funcionam na maioria das tarefas. Valores mais altos ajudam com overfitting severo, mas desaceleram a convergência.
Clipping limita as magnitudes dos gradientes durante a backpropagation. Embora LSTMs atenuem gradientes que desaparecem, gradientes explodindo ainda ocorrem, especialmente com sequências longas ou redes profundas.
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)Valores entre 1,0 e 5,0 são comuns. Se a perda de treino disparar ou surgir NaN, reduza o limite.
Early stopping monitora a perda de validação e interrompe o treinamento quando ela para de melhorar. Isso evita que o modelo memorize os dados de treino em detrimento da generalização.
patience = 5
best_val_loss = float('inf')
epochs_without_improvement = 0

for epoch in range(max_epochs):
	train_loss = train_one_epoch(model, train_loader)
	val_loss = evaluate(model, val_loader)

	if val_loss < best_val_loss:
    		best_val_loss = val_loss
    		epochs_without_improvement = 0
    		torch.save(model.state_dict(), 'best_model.pt')
	else:
    		epochs_without_improvement += 1
	if epochs_without_improvement >= patience:
        	break
Para um passo a passo completo de loops de treino, métricas de avaliação e depuração de problemas comuns em LSTMs, consulte o guia de NLP com PyTorch.
Inicialização aleatória funciona, mas embeddings pré-treinados como GloVe ou Word2Vec dão um salto inicial. Eles codificam relações semânticas aprendidas em bilhões de palavras: "king" e "queen" ficam próximos, assim como "terrible" e "awful".
import numpy as np

def load_glove_embeddings(glove_path, vocab, embedding_dim):
	embeddings = np.random.randn(len(vocab), embedding_dim) * 0.01

	with open(glove_path, 'r') as f:
    	for line in f:
        	parts = line.split()
        	word = parts[0]
        	if word in vocab:
            		embeddings[vocab[word]] = np.array(parts[1:], dtype=np.float32)

	return torch.tensor(embeddings, dtype=torch.float32)

# Load and freeze or fine-tune
pretrained = load_glove_embeddings('glove.6B.100d.txt', vocab, 100)
model.embedding.weight.data.copy_(pretrained)
model.embedding.weight.requires_grad = True  # Fine-tune during training
Embeddings pré-treinados ajudam mais quando há poucos dados. Com milhões de exemplos, embeddings aleatórios eventualmente alcançam. Para a maioria dos cenários práticos com 10k–100k amostras, espere ganhos de 3–8% na acurácia com inicialização pré-treinada.
Essas abordagens se somam. Um classificador de texto para produção pode usar:
Cada adição aumenta a complexidade e o tempo de treino. Comece com uma LSTM de uma camada como baseline, meça a performance e adicione técnicas uma a uma para ver o que traz ganho no seu problema.
LSTMs dominaram modelagem de sequência do fim dos anos 1990 até meados dos anos 2010. O artigo "Attention Is All You Need" de 2017 mudou isso. Transformers hoje alimentam a maioria dos grandes modelos de linguagem, mas as LSTMs não desapareceram. Elas atendem a nichos diferentes.
Vimos como LSTMs processam sequências um token por vez e por que o mecanismo de portas funciona. Em escala, essa dependência sequencial vira gargalo. Sua GPU pode ter milhares de núcleos, mas a maioria fica ociosa enquanto a cadeia do estado oculto termina. Uma entrada de 500 tokens implica 500 operações em sequência.
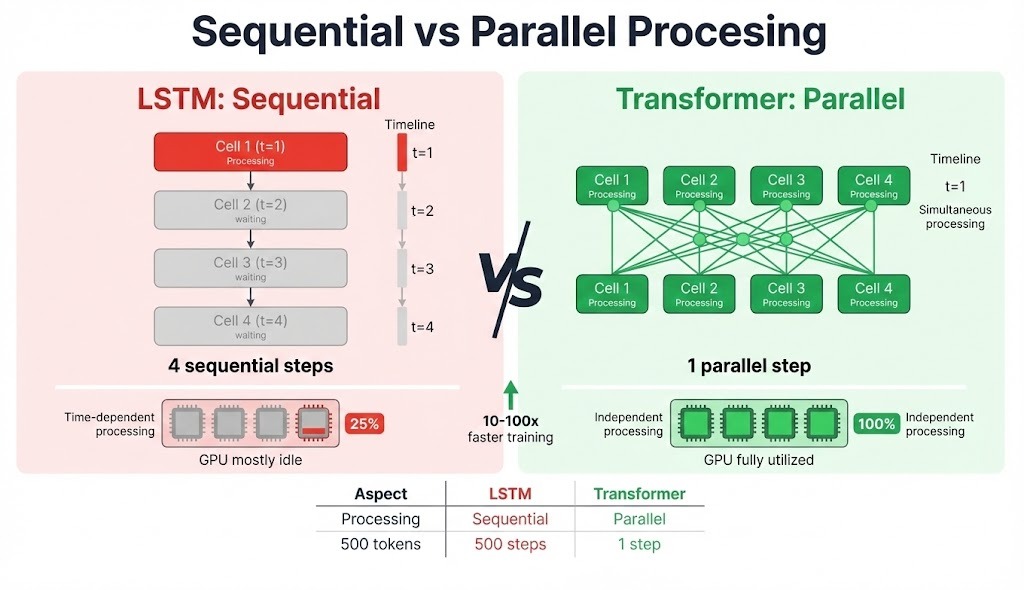
Transformers não têm essa restrição. A autoatenção calcula relações entre todas as posições simultaneamente, então a mesma sequência de 500 tokens é processada em paralelo. Em hardware moderno com lotes grandes, isso se traduz em treinos 10–100x mais rápidos.
O teto de comprimento de sequência também importa. Vimos como LSTMs preservam gradientes melhor que RNNs simples, mas "melhor" não significa "perfeito". O desempenho ainda cai por volta de 200–500 tokens, dependendo da tarefa.
Transformers computam atenção entre todo par de posições diretamente, então o token 1 "olha" para o 1000 com a mesma facilidade. O trade-off é memória: matrizes de atenção crescem quadraticamente com o comprimento.
As ativações das portas também dificultam a interpretação. Os valores variam de 0 a 1 sem fronteiras claras. Pesos de atenção em Transformers não são explicações perfeitas, mas dão um sinal mais claro de quais tokens importaram para cada saída.
Transformers fazem sentido quando:
LSTMs ainda são ideais quando:
Previsão de séries temporais fica no meio do caminho. Benchmarks recentes mostram desempenho similar em dados univariados com padrões consistentes. Transformers levam vantagem quando várias features interagem de forma complexa, mas LSTMs se sustentam quando há poucos dados ou pouco compute.
Arquiteturas híbridas mesclam as duas abordagens. Algumas empilham camadas LSTM com mecanismos de atenção. xLSTM, publicado em 2024, revisita o design original com portas exponenciais e memória matricial, mostrando resultados competitivos com Transformers em escalas menores.
|
Aspecto |
LSTM |
Transformer |
|
Processamento |
Sequencial (token por token) |
Paralelo (todas as posições de uma vez) |
|
Velocidade de treino |
Mais lenta (pouca paralelização) |
Mais rápida em GPUs |
|
Dependências de longo alcance |
Degrada além de 200–500 tokens |
Lida com milhares de tokens |
|
Escalonamento de memória |
O(n) com o comprimento |
O(n²) para matrizes de atenção |
|
Desempenho com poucos dados |
Bom (menos parâmetros) |
Propenso a overfitting |
|
Implantação em edge |
Adequado (menor footprint) |
Desafiador (modelos grandes) |
|
Streaming/tempo real |
Suporte nativo |
Requer sequência completa |
|
Ecossistema pré-treinado |
Limitado |
Extenso (BERT, GPT etc.) |
A decisão geralmente depende das restrições. Compute e dados ilimitados? Transformers vencem na maioria das tarefas de NLP. Um microcontrolador com 10 mil exemplos? LSTMs continuam práticas.
LSTMs resolveram um problema real quando surgiram em 1997. O mecanismo de portas introduzido por Hochreiter e Schmidhuber permitiu que redes finalmente aprendessem com sequências maiores que algumas dezenas de tokens. Essa arquitetura impulsionou tradução automática, reconhecimento de fala e previsão de séries por quase duas décadas.
Hoje, Transformers lidam com a maioria das tarefas de NLP em larga escala, mas LSTMs não ficaram obsoletas. Elas ainda fazem sentido para deployment em edge, aplicações de streaming e situações com dados limitados.
Se você está começando um projeto de modelagem de sequência, teste primeiro uma LSTM simples. Meça o desempenho, entenda onde falha e só então decida se o problema realmente exige um Transformer. Os conceitos deste guia (portas, estado da célula, fluxo de gradiente) transferem direto para arquiteturas mais complexas.
Para praticar na mão na massa, recomendo nosso curso Recurrent Neural Networks, que apresenta outras aplicações de LSTM com exercícios guiados.
Cursos de machine learning
Curso
Curso
Curso
Tutorial
Thushan Ganegedara
15 min
Tutorial
Zoumana Keita
8 min
Tutorial
Zoumana Keita
14 min
Tutorial
Josep Ferrer
11 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
14 min