
Kurs
Rekursive neuronale Netze (RNNs) für die Sprachmodellierung mit Keras
4 Std.
16.4K
Standard-Recurrent-Neural-Networks tun sich mit Erinnerung schwer. Sobald Sequenzens länger als 20–30 Zeitschritte werden, schrumpfen Gradienten während der Backpropagation gegen null oder explodieren, und das Netzwerk verliert die Fähigkeit, weit auseinanderliegende Teile des Inputs zu verknüpfen. Hochreiter und Schmidhuber haben dieses Problem in ihrem Paper von 1997 mit Long Short-Term Memory Networks adressiert.
In diesem Guide gehe ich erst die Interna von LSTMs durch und wechsle dann zur praktischen Implementierung in Python. In den letzten Abschnitten vergleiche ich LSTMs mit Transformern, damit du die passende Architektur für deinen Anwendungsfall wählen kannst.
Ich empfehle dir außerdem unseren Kurs Introduction to Deep Learning in PyTorch, um dir hands-on Erfahrung mit dem Trainieren von neuronalen Netzen in PyTorch zu holen — der Basis für LSTM-Modelle.
LSTM steht für Long Short-Term Memory — ein Typ rekurrenter neuronaler Netze (RNN), der Sequenzen verarbeiten kann, bei denen Kontext aus weit früheren Eingaben noch relevant ist.
Die Kernidee hinter LSTMs ist ein Gating-Mechanismus, der den Informationsfluss im Netzwerk steuert. Anstatt alle Signale gleich zu behandeln, lernen Gates, wann Kontext behalten und wann er verworfen werden sollte.
Diese selektive Erinnerung erlaubt es LSTMs, Abhängigkeiten über Hunderte von Zeitschritten zu verfolgen — nützlich für Sprachmodellierung, Spracherkennung und Zeitreihenprognosen. Um zu verstehen, warum diese Architektur existiert, hilft ein Blick darauf, was bei Standard-RNNs schiefgeht.
Rekurrente Netze geben Informationen über einen versteckten Zustand von einem Zeitschritt zum nächsten weiter. Bei jedem Schritt wird dieser Zustand mit gelernten Gewichten multipliziert, aktualisiert und weitergegeben. Beim Training werden Fehlersignale rückwärts durch all diese Schritte gesendet, und bei jedem Rückpass schrumpft das Signal etwas. Nach genügend Schritten bleibt kaum etwas übrig.
Das ist wie eine Kopie von einer Kopie zu machen. Ein paar Mal geht das gut, nach fünfzig Mal ist der Text kaum noch lesbar. RNNs stoßen ungefähr nach 20–30 Zeitschritten an diese Grenze — daher ihre Schwäche bei längeren Sequenzen.
LSTMs fügen eine separate Gedächtnisspur hinzu — den Zellzustand —, die parallel zum versteckten Zustand läuft. Der Unterschied ist strukturell: Informationen fließen im Zellzustand additiv statt über wiederholte Multiplikation, weshalb sie nicht so stark degradieren.
Um zu steuern, was in dieses Gedächtnis hinein- und herausgeht, nutzen LSTMs Gates. Jedes Gate ist ein kleines neuronales Netz, das Werte zwischen 0 und 1 ausgibt — wie ein Filter. Werte nahe 0 blockieren Informationen, Werte nahe 1 lassen sie durch. Das Netzwerk lernt im Training, welche Muster sich über lange Sequenzen zu merken lohnen und welche entbehrlich sind.
Dieses Gating ist der zentrale Unterschied zu „Vanilla“-RNNs. Statt alle Informationen durch denselben Pfad zu drücken, können LSTMs ausgewählt Kontext über Hunderte Zeitschritte bewahren. Im nächsten Abschnitt siehst du genau, wie diese Gates arbeiten und gemeinsam den Zellzustand aktualisieren.
LSTMs kommen überall dort zum Einsatz, wo Sequenzdaten zählen. Ein paar Beispiele abseits der üblichen NLP- und Forecasting-Anwendungen:
In diesem Abschnitt gehen wir die Interna von LSTMs im Detail durch. Wenn du direkt zur Implementierung springen willst, überspringe ihn. Die Architekturdetails sind nicht zwingend nötig, helfen aber beim Debuggen und Tuning.
Zur Veranschaulichung verfolgen wir ein konkretes Beispiel: die Sequenz „The clouds are dark...“ verarbeiten, um das nächste Wort vorherzusagen. Mit echten Daten wird jeder Baustein greifbarer.
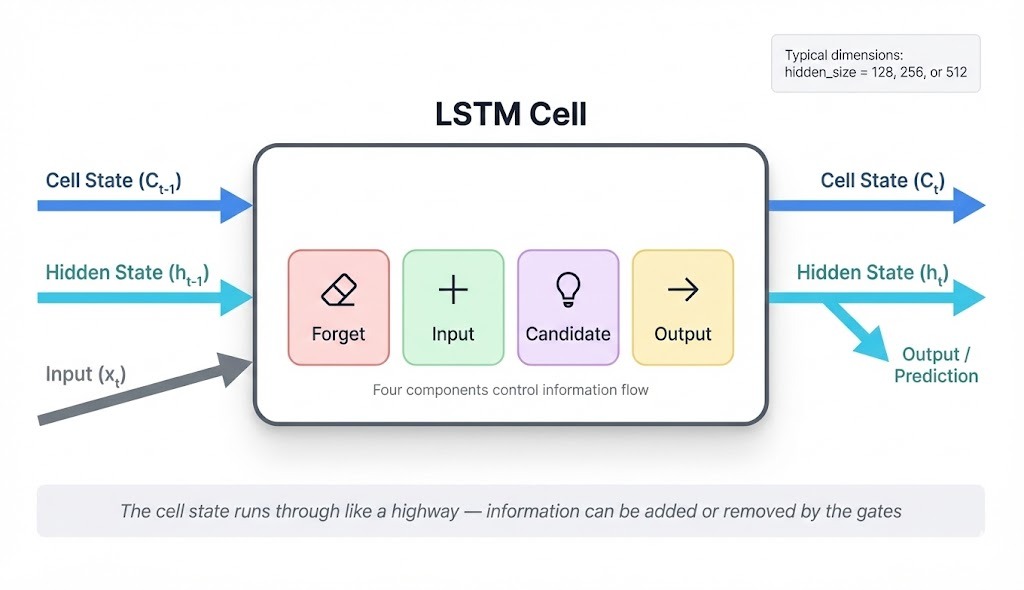
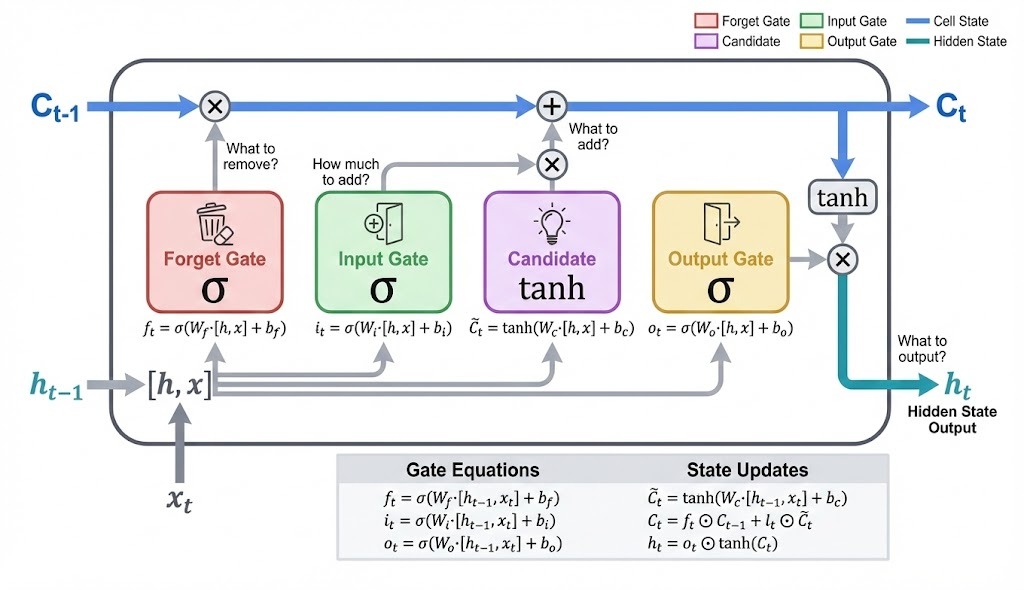
Ein LSTM führt zwei getrennte Vektoren durch das Netzwerk: den Zellzustand und den versteckten Zustand.
Der Zellzustand dient als Langzeitspeicher. Er trägt Informationen über Zeitschritte hinweg und wird bei jedem Schritt kontrolliert angepasst. In unserer Sequenz könnte der Zellzustand nach „clouds“ so etwas wie „Wetterbezogenes Substantiv gesehen“ speichern und diesen Kontext über „are“ hinweg bewahren, bis „dark“ das Muster verstärkt.
Der versteckte Zustand ist die Ausgabe der Zelle pro Zeitschritt. Er fließt in Vorhersagen und in die Berechnungen des nächsten Schritts. Nach „dark“ codiert der versteckte Zustand etwa „Adjektiv, das Wetterbedingungen beschreibt“, was eine Prädiktionsschicht nutzen kann.
Warum zwei getrennte Spuren? Ein einzelner Zustand müsste gleichzeitig Langzeitkontext halten und nützliche Ausgaben erzeugen. Diese Ziele widersprechen sich: Stabiles Gedächtnis braucht geringe Veränderung, nützliche Ausgaben brauchen Transformation. Die Trennung erlaubt es jeder Spur, für ihren Zweck zu optimieren.
Pro Zeitschritt nimmt die Zelle drei Eingaben an und produziert zwei Ausgaben:
Eingaben:
Vorheriger Zellzustand (C_{t-1}): Was das Netzwerk bisher erinnert
Vorheriger versteckter Zustand (h_{t-1}): Die Ausgabe des letzten Schritts
Aktueller Input (x_t): Das neue Token wie „clouds“ oder „dark“
Ausgaben:
Aktualisierter Zellzustand (C_t): Gedächtnis nach Verarbeitung dieses Tokens
Neuer versteckter Zustand (h_t): Die Ausgabe dieses Zeitschritts
Vier Komponenten steuern das Innenleben der Zelle. Drei davon sind Gates, die Werte zwischen 0 und 1 ausgeben und als Filter wirken. Die vierte ist der Kandidat, der neuen Inhalt vorschlägt.
Wenn „are“ nach „clouds“ eintrifft, hat jede Komponente ihre Aufgabe:
Forget-Gate (f_t): Sollen wir den „clouds“-Kontext behalten? Wetter-Substantive gefolgt von Kopulaverben sind meist relevant, daher gibt das Forget-Gate Werte nahe 1 aus, um den Zellzustand weitgehend zu bewahren.
Input-Gate (i_t): Wie stark soll „are“ ins Gedächtnis einfließen? Kopulaverben tragen wenig Vorhersagekraft, daher gibt das Input-Gate kleinere Werte aus.
Kandidat (C̃_t): Welche neuen Infos könnte „are“ beitragen? Der Kandidat schlägt Inhalte vor, die das Input-Gate herunterskaliert.
Output-Gate (o_t): Was soll der versteckte Zustand zeigen? Das Output-Gate filtert den Zellzustand, um h_t zu erzeugen.
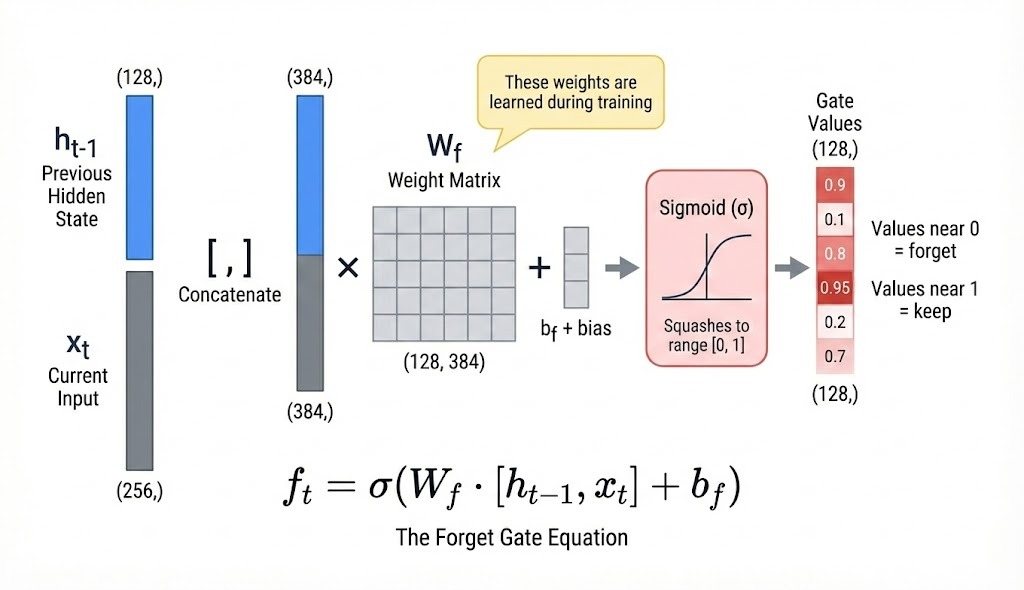
Jede Komponente berechnet ihre Ausgabe gleich:
Konkatenation von h_{t-1} und x_t zu einem Vektor
Multiplikation mit einer gelernten Gewichtsmatrix
Addition eines Bias-Terms
Anwendung einer Aktivierungsfunktion
Gates nutzen Sigmoid als Aktivierung und quetschen Werte in den Bereich 0–1. Der Kandidat nutzt tanh und gibt Werte zwischen −1 und 1 aus — so kann er Erhöhungen und Verringerungen des Zellzustands vorschlagen.
Forget-Gate (Sigmoid → 0 bis 1):
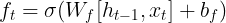
Input-Gate (Sigmoid → 0 bis 1):
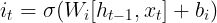
Output-Gate (Sigmoid → 0 bis 1):
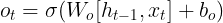
Kandidat (tanh → −1 bis +1):
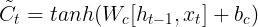
Jede Komponente hat ihre eigene Gewichtsmatrix (W_f, W_i, W_c, W_o) und lernt dadurch, auf unterschiedliche Muster im Input zu reagieren.
Gate-Ausgaben multiplizieren sich positionsweise mit Vektoren (elementweise Multiplikation, geschrieben als ⊙). Jede Dimension wird unabhängig gefiltert.
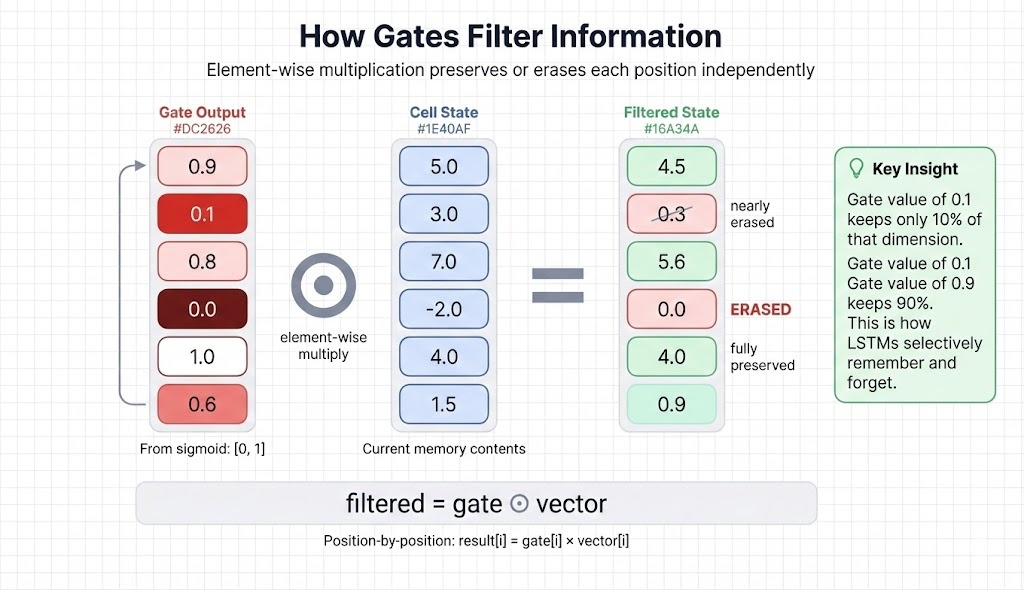
Gibt ein Gate für Position 1 den Wert 0,9 aus, behält diese Dimension 90 % ihres Werts. Gibt es für Position 4 den Wert 0,0 aus, wird diese Dimension gelöscht. Bei „dark“ nach „clouds are“ könnte das Forget-Gate hohe Werte für Dimensionen ausgeben, die Substantiv-/Wetterkontext speichern, und niedrigere für irrelevanten früheren Kontext.
Die Komponenten arbeiten in drei Schritten zusammen, um den Zellzustand zu aktualisieren und den versteckten Zustand zu erzeugen.
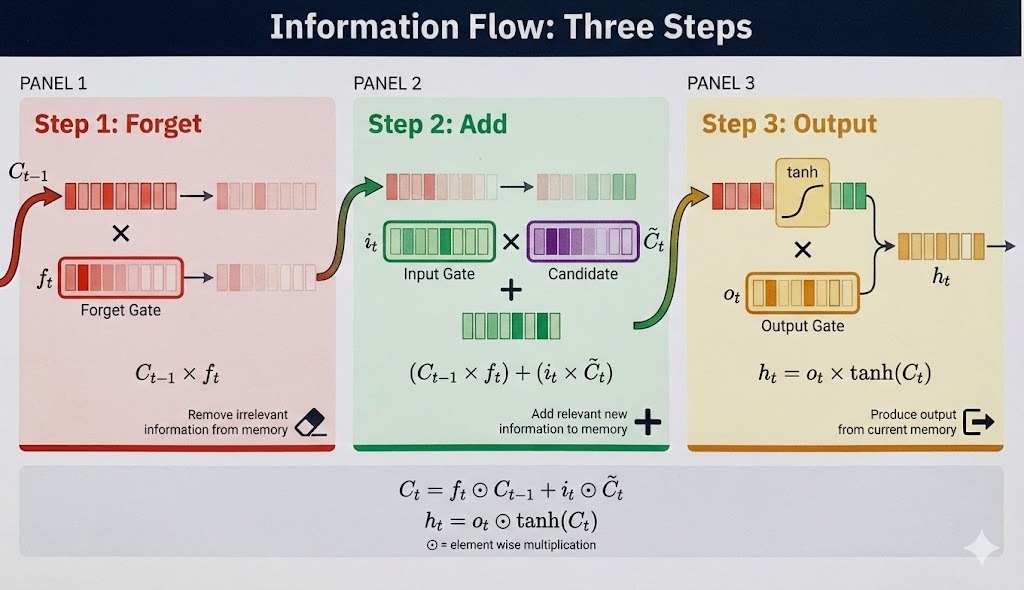
Das Forget-Gate filtert den vorherigen Zellzustand: 
Bei „dark“ bewahrt das Forget-Gate den Wetterkontext aus „clouds“ und löscht Dimensionen, die den Artikel „The“ verfolgt haben.
Das Input-Gate skaliert den Vorschlag des Kandidaten und addiert ihn dann zum gefilterten Zellzustand:
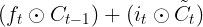
Der Kandidat könnte „Adjektiv modifiziert Wetter-Substantiv“ vorschlagen, und das Input-Gate entscheidet, wie stark das ins Gedächtnis geschrieben wird. Dieses additive Update (statt multiplikativ) erleichtert den Gradientenfluss im Training.
Der Zellzustand läuft durch tanh, anschließend filtert das Output-Gate, was zum versteckten Zustand wird:
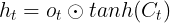
Tanh hält Werte begrenzt. Das Output-Gate wählt, welche Aspekte des angesammelten Gedächtnisses für Vorhersagen in diesem Zeitschritt sichtbar sein sollen.
Der komplette Ablauf:
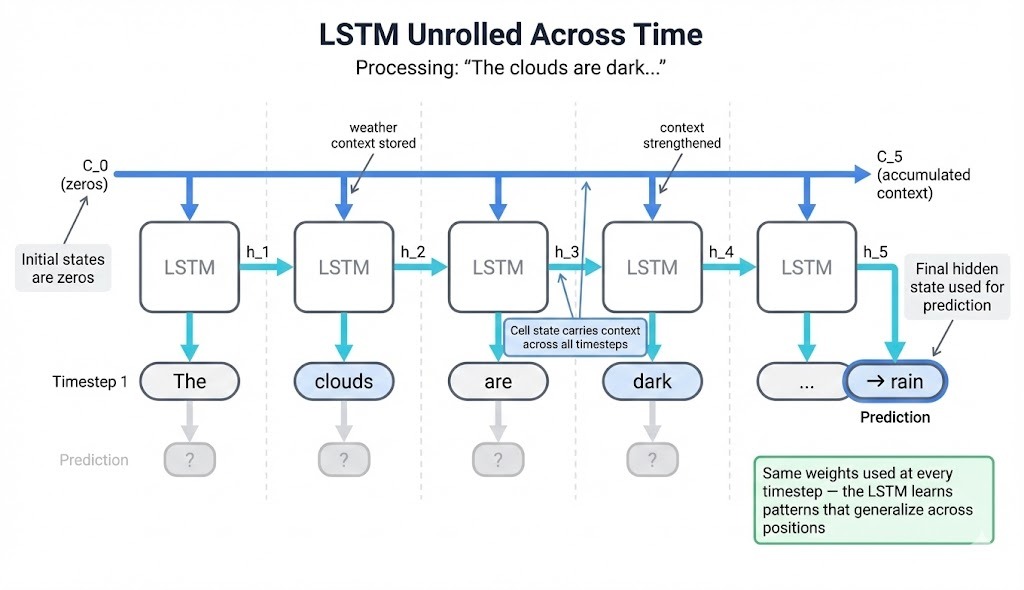
Hier ist eine vereinfachte Trace mit einem 4-dimensionalen Zellzustand:
|
Schritt |
Input |
Zellzustand (vereinfacht) |
Was passiert |
|
1 |
„The“ |
[0.1, 0.0, 0.2, 0.0] |
Minimale Speicherung; Artikel tragen wenig Vorhersagesignal |
|
2 |
„clouds“ |
[0.1, 0.7, 0.2, 0.3] |
Input-Gate öffnet für Dimensionen 2,4; Substantivmuster wird gespeichert |
|
3 |
„are“ |
[0.1, 0.6, 0.2, 0.3] |
Forget-Gate ≈ 0,9 bewahrt Kontext; Kopulaverb trägt wenig bei |
|
4 |
„dark“ |
[0.1, 0.8, 0.5, 0.6] |
Das Adjektiv verstärkt das Signal in den Dimensionen 2,3,4 |
Bis Zeitschritt 4 haben die Dimensionen 2–4 ein Muster angesammelt. Der versteckte Zustand h_4 fließt in eine Prädiktionsschicht (nicht Teil des LSTM), die Wortschatzwahrscheinlichkeiten ausgibt. Dieses Muster hilft dem Modell, Wörter wie „rain“ oder „sky“ zu bevorzugen.
Das Netzwerk „versteht“ kein Wetter. Es lernt statistische Zusammenhänge: Bestimmte Eingabesequenzen gehen typischerweise bestimmten Ausgaben voraus.
Die additive Struktur des Zellzustands bietet einen direkteren Gradientenpfad als Standard-RNNs. Wenn dir der Gradientenfluss in neuronalen Netzen nicht geläufig ist, deckt das Backpropagation-Tutorial die Grundlagen ab.
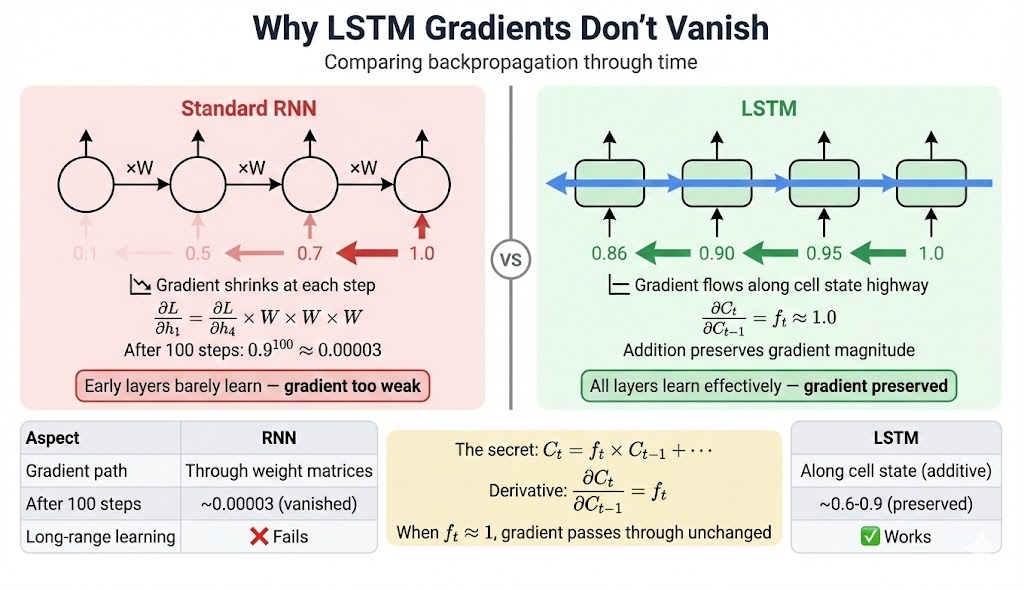
In Standard-RNNs fließen Gradienten bei jedem Schritt durch Gewichtsmatrizen. Wiederholte Multiplikation potenziert den Effekt: Nach 100 Schritten mit Gewichten im Schnitt 0,9 schrumpft der Gradient zu 0.9^100 ≈ 0.00003.
LSTMs bieten eine alternative Route entlang des Zellzustands. Die Ableitung von C_t nach C_{t-1}:
∂C_t/∂C_{t-1} = f_tDas ist der Wert des Forget-Gates, keine Gewichtsmatrix. Bleiben Forget-Gates nahe 1, passieren Gradienten mit weniger Zerfall. Liegen Gates im Schnitt bei 0,95, gilt nach 100 Schritten: 0.95^100 ≈ 0.006. Immer noch reduziert, aber nutzbar.
|
Aspekt |
RNN |
LSTM |
|
Gradientenpfad |
Nur Gewichtsmatrizen |
Zusätzlicher Pfad entlang des Zellzustands |
|
100-Schritt-Gradient |
~10^-5 (verschwunden) |
~10^-2 bis 10^-1 (nutzbar) |
|
Praktisches Gedächtnis |
~10–20 Zeitschritte |
~50–200 Zeitschritte |
Praktischer Hinweis: Forget-Gate-Biases werden oft auf 1,0 oder höher initialisiert, um anfänglich „alles merken“ zu begünstigen. Das hilft, früh im Training Langzeitmuster zu lernen.
LSTMs mildern das Vanishing-Gradient-Problem, eliminieren es aber nicht. Die Verbesserung kommt vom additiven Zellzustands-Update, das eine Gradientenschnellstraße neben den Standardpfaden bietet.
Im vorherigen Abschnitt hast du gesehen, was in einer LSTM-Zelle passiert: Gates filtern Informationen, der Zellzustand bewahrt Kontext, der versteckte Zustand erzeugt Ausgaben. Jetzt schauen wir, wie PyTorchs nn.LSTM all das in ein Modul packt und damit Filmkritiken als positiv oder negativ klassifiziert.
Tipp fürs Ausführen des Codes: 50 Epochen auf der CPU dauern lange. Nutze Google Colab oder Kaggle Notebooks mit GPU-Beschleunigung für schnellere Ergebnisse. Das komplette Skript findest du als GitHub Gist.
Textklassifikation mit LSTMs folgt einem Muster: Wörter in Vektoren umwandeln, vom LSTM sequenziell verarbeiten lassen und die finale Ausgabe für die Vorhersage nutzen.
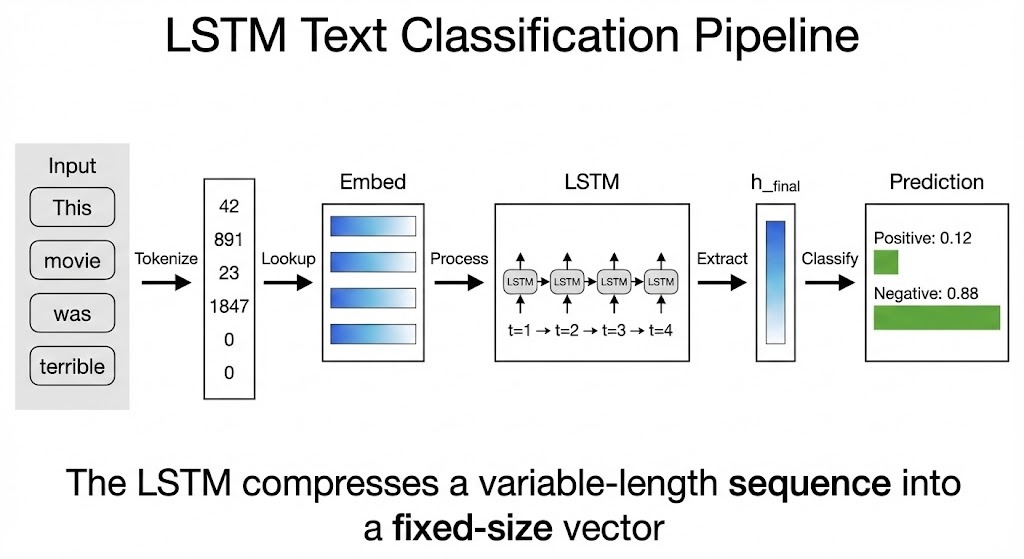
Neuronale Netze arbeiten mit kontinuierlichen Zahlen, Wörter sind diskrete Symbole. Wir können „terrible“ nicht direkt in Matrixmultiplikationen füttern. Die Lösung ist eine Embedding-Schicht: eine Lookup-Tabelle, die jedes Wort auf einen lernbaren Vektor abbildet.
self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=padding_idx)Wenn du embedding_dim=32 wählst, wird jedes Wort zu einem 32-dimensionalen Vektor. Zu Beginn sind diese Vektoren zufällig. Während des Lernens rücken Wörter mit ähnlicher Stimmung in diesem Raum zusammen: „Terrible“, „awful“ und „boring“ landen nahe beieinander, „excellent“ und „amazing“ clustern woanders.
Das Argument padding_idx sorgt dafür, dass Padding-Tokens Nullvektoren bleiben und das Modell nicht beeinflussen.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=num_layers,
	batch_first=True,
	dropout=dropout if num_layers > 1 else 0,
	bidirectional=bidirectional,
)
Diese eine Zeile baut die gesamte Gate-Mechanik aus dem vorherigen Abschnitt. Die hidden_size bestimmt, wie viel Information Zell- und versteckter Zustand tragen können. Größere Werte lassen mehr Muster verfolgen, kosten aber mehr Rechenzeit.
Mit batch_first=True haben Inputs die Form (batch, sequence_length, embedding_dim). Das LSTM verarbeitet jede Position von links nach rechts und aktualisiert seine internen Zustände an jedem Schritt.
Nach „This movie was absolutely terrible“ hat das LSTM jedes Wort gesehen. Sein finaler versteckter Zustand hat extrahiert, was das Modell aus dieser Sequenz gelernt hat. Bei Sentiment könnte das etwa „stark negatives Adjektiv am Ende, neutralen Inhalt zuvor überstimmend“ codieren.
def forward(self, x):
	embedded = self.embedding(x)
	lstm_out, (h_n, c_n) = self.lstm(embedded)
	h_final = h_n[-1]
	return self.fc(h_final)
Das LSTM liefert sowohl Ausgaben pro Zeitschritt (lstm_out) als auch finale Zustände (h_n, c_n). Für Klassifikation reicht h_n[-1] — der versteckte Zustand nach dem letzten Token. Eine lineare Schicht mappt das auf Klassenscores.
Wenn „This movie was terrible“ in den Classifier geht:
Jedes Wort erhält sein Embedding: vier Vektoren der Form (32,)
Das LSTM verarbeitet sie sequenziell. „This“ initialisiert etwas Zellzustand. „Movie“ aktualisiert leicht. „Was“ ist neutral und ändert wenig. „Terrible“ lässt das Forget-Gate irrelevanten Kontext löschen und das Input-Gate ein starkes Negativsignal schreiben.
Der finale versteckte Zustand fasst das Muster zusammen.
Die lineare Schicht mappt auf zwei Scores: positiv und negativ
Das Modell „versteht“ keine Sprache. Es lernt statistische Muster: Bestimmte Wortfolgen korrelieren mit bestimmten Labels.
Unten siehst du die gesamte Klasse LSTMClassifier, die wir gerade Schritt für Schritt aufgebaut haben:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from datasets import load_dataset
from collections import Counter
import numpy as np

torch.manual_seed(42)
np.random.seed(42)


class LSTMClassifier(nn.Module):
    def __init__(
        Self,
        Vocab_size,
        Embedding_dim,
        Hidden_size,
        Output_size,
        num_layers=1,
        dropout=0.0,
        bidirectional=False,
        padding_idx=0,
    ):
        super().__init__()
        self.hidden_size = hidden_size
    	self.num_layers = num_layers
    	self.bidirectional = bidirectional

    	self.embedding = nn.Embedding(
	    vocab_size, embedding_dim, padding_idx=padding_idx
        )
    	self.lstm = nn.LSTM(
            input_size=embedding_dim,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,
            dropout=dropout if num_layers > 1 else 0,
            bidirectional=bidirectional,
    	)

    	fc_input_size = hidden_size * 2 if bidirectional else hidden_size
    	self.fc = nn.Linear(fc_input_size, output_size)

    def forward(self, x):
    	embedded = self.embedding(x)
    	lstm_out, (h_n, c_n) = self.lstm(embedded)

    	if self.bidirectional:
            h_final = torch.cat([h_n[-2], h_n[-1]], dim=1)
    	else:
            h_final = h_n[-1]

    	return self.fc(h_final)
Die bidirektionale Option lässt zwei LSTMs laufen: eins vorwärts, eins rückwärts. Ihre finalen versteckten Zustände werden konkateniert und geben dem Modell Kontext aus beiden Richtungen. Das hilft, wenn Bedeutung vom Nachfolger abhängt — etwa „not bad“, wo „not“ erst mit „bad“ Sinn ergibt.
LSTMs brauchen Integer-Sequenzen, keine Strings. Das Preprocessing konvertiert Rohtext in drei Schritten:
def build_vocab(texts, max_vocab_size=10000):
	counter = Counter()
	for text in texts:
    		counter.update(text.lower().split())

	vocab = {"<pad>": 0, "<unk>": 1}
	for word, _ in counter.most_common(max_vocab_size - 2):
    		vocab[word] = len(vocab)
	return vocab
Index 0 reservieren wir für Padding und 1 für unbekannte Wörter. Die Vokabulargröße zu begrenzen, filtert sehr seltene Wörter heraus, für die zu wenig Beispiele für sinnvolle Embeddings vorhanden sind.
def tokenize_and_pad(texts, vocab, max_length=200):
	sequences = []
	for text in texts:
    		tokens = text.lower().split()
    		ids = [vocab.get(t, vocab["<unk>"]) for t in tokens[:max_length]]
    		ids = ids + [vocab["<pad>"]] * (max_length - len(ids))
    		sequences.append(ids)
	return torch.tensor(sequences, dtype=torch.long)
Das Abschneiden auf max_length begrenzt, wie weit das LSTM zurückblicken muss. Längere Sequenzen bewahren mehr Kontext, erhöhen aber Rechen- und Speicherbedarf. Für Filmreviews reichen meist 100–200 Tokens, um die wichtigsten Sentimentsignale einzufangen.
Padding stellt sicher, dass alle Sequenzen gleich lang sind und PyTorch sie zu einem Tensor batchen kann. Padding-Tokens werden nach dem Embedding zu Nullvektoren und tragen kaum zum finalen Zustand bei.
def load_imdb_data(max_samples=10000, max_length=200, max_vocab=10000):
	dataset = load_dataset("imdb")

	train_data = dataset["train"].shuffle(seed=42)
	test_data = dataset["test"].shuffle(seed=42)

	train_texts = train_data["text"][:max_samples]
	train_labels = train_data["label"][:max_samples]
	test_texts = test_data["text"][: max_samples // 4]
	test_labels = test_data["label"][: max_samples // 4]

	vocab = build_vocab(train_texts, max_vocab)

	X_train = tokenize_and_pad(train_texts, vocab, max_length)
	X_test = tokenize_and_pad(test_texts, vocab, max_length)
	y_train = torch.tensor(train_labels, dtype=torch.long)
	y_test = torch.tensor(test_labels, dtype=torch.long)

	return X_train, y_train, X_test, y_test, vocab
Das Vokabular nur aus den Trainingsdaten zu bauen, verhindert Informationsleckage. Taucht ein seltenes Wort nur in Tests auf, sollte das Modell es als unbekannt behandeln, statt sein Embedding im Training gelernt zu haben.
Die Trainingsschleife aktualisiert die Gewichte basierend darauf, wie weit die Vorhersagen von den korrekten Werten abweichen. Bei LSTMs ist ein Detail besonders wichtig: Gradient Clipping.
def train_model(model, train_loader, test_loader, n_epochs=5, lr=0.001):
	criterion = nn.CrossEntropyLoss()
	optimizer = torch.optim.Adam(model.parameters(), lr=lr)

	for epoch in range(n_epochs):
    		model.train()
    		total_loss, correct, total = 0, 0, 0

    		for batch_texts, batch_labels in train_loader:
        		optimizer.zero_grad()
        		outputs = model(batch_texts)
        		loss = criterion(outputs, batch_labels)
        		loss.backward()
            		torch.nn.utils.clip_grad_norm_(
	model.parameters(),
	max_norm=5.0)
        		optimizer.step()

        		total_loss += loss.item()
        		_, predicted = outputs.max(1)
        		correct += (predicted == batch_labels).sum().item()
total += batch_labels.size(0)Wir haben gesehen, wie LSTMs Vanishing Gradients durch additive Updates am Zellzustand abmildern. Explodierende Gradienten bleiben jedoch ein Risiko. Wenn Gradienten zu groß werden, überschießen Gewichtsupdates und destabilisieren das Training.
clip_grad_norm_ begrenzt die Gesamtnorm der Gradienten. Überschreiten sie max_norm=5.0, werden sie proportional skaliert. So bleiben Updates stabil, ohne das Gradientsignal zu eliminieren.
    	model.eval()
    	test_correct, test_total = 0, 0
    	with torch.no_grad():
        	for batch_texts, batch_labels in test_loader:
            		outputs = model(batch_texts)
            		_, predicted = outputs.max(1)
            		test_correct += (predicted == batch_labels).sum().item()
            		test_total += batch_labels.size(0)

    	test_acc = test_correct / test_total
    	print(f"Epoch {epoch+1}: Loss={total_loss/len(train_loader):.4f}, "
          	f"Train={correct/total:.3f}, Test={test_acc:.3f}")

    return test_acc
model.eval() deaktiviert Dropout während der Evaluation. torch.no_grad() verzichtet auf Gradientenberechnung, spart Speicher und beschleunigt das Inferenzieren.
X_train, y_train, X_test, y_test, vocab = load_imdb_data(
	max_samples=10000, max_length=100, max_vocab=5000
)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
test_loader = DataLoader(TensorDataset(X_test, y_test), batch_size=64)

model = LSTMClassifier(
	vocab_size=len(vocab),
	embedding_dim=32,
	hidden_size=32,
	output_size=2,
	padding_idx=vocab["<pad>"],
)

final_acc = train_model(model, train_loader, test_loader, n_epochs=50, lr=0.001)
Diese Werte spiegeln Trade-offs wider:
hidden_size=32: Klein genug für schnelle Iterationen. Produktionsmodelle nutzen oft 128–512; mit steigender Größe nehmen die Zugewinne ab, die Trainingszeit zu.
embedding_dim=32: Oft gleich der Hidden Size, muss aber nicht. Größere Embeddings erfassen feinere Wortnuancen, kosten mehr Parameter.
max_length=100: Die meisten Sentimentsignale erscheinen früh. Längere Sequenzen helfen in Nuancen, verdoppeln aber Speicher bei verdoppeltem max_length und vervielfachen die Kosten.
batch_size=64: Größere Batches liefern stabilere Gradienten, kleinere helfen beim Entkommen lokaler Minima. 32–128 ist üblich.
lr=0.001: Der Adam-Standard funktioniert für die meisten LSTM-Aufgaben. Oszilliert der Loss, probiere 0,0001. Stockt das Lernen, teste 0,01.
n_epochs=50: Genug, um zu konvergieren. Beobachte, ob die Testgenauigkeit stagniert oder fällt, während die Trainingsgenauigkeit steigt — ein Signal für Overfitting.
Mit dieser Konfiguration entstehen Ausgaben wie:
...
Epoch 46: Loss=0.4126, Train=0.812, Test=0.789
Epoch 47: Loss=0.4054, Train=0.815, Test=0.791
Epoch 48: Loss=0.3998, Train=0.818, Test=0.788
Epoch 49: Loss=0.3921, Train=0.821, Test=0.793
Epoch 50: Loss=0.3867, Train=0.824, Test=0.795
Die Trainingsgenauigkeit erreicht ca. 82 %, die Testgenauigkeit pendelt sich um 80 % ein. Das Modell lernt, welche Wortmuster Sentiment vorhersagen. Starke Adjektive am Ende wiegen schwer, Negationen wie „not“ drehen Polarität, bestimmte Phrasen („waste of time“, „highly recommend“) werden zu starken Signalen. Nichts davon ist hart codiert — es entsteht aus Korrelationen in den Trainingsdaten.
Mit minimalem Tuning und kleinem Modell sind 80 % realistisch. Die kleine Lücke zwischen Trainings- und Testgenauigkeit zeigt gute Generalisierung ohne starkes Overfitting. Mit Dropout, vortrainierten Embeddings wie GloVe oder mehr Daten kommst du in die hohen 80er.
Die Basisarchitektur aus den vorherigen Abschnitten funktioniert, aber mehrere Techniken heben die Genauigkeit, ohne die Modellfamilie zu wechseln. Diese Ansätze wurden in tausenden Produktivsystemen und Papers validiert.
Standard-LSTMs verarbeiten von links nach rechts und bauen Kontext nur aus der Vergangenheit auf. Bidirektionale LSTMs (BiLSTMs) laufen doppelt: vorwärts und rückwärts. Die finale Repräsentation pro Zeitschritt kombiniert Vorher und Nachher.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	bidirectional=True,  # Run both directions
	batch_first=True,
)
# Output size doubles: hidden_size * 2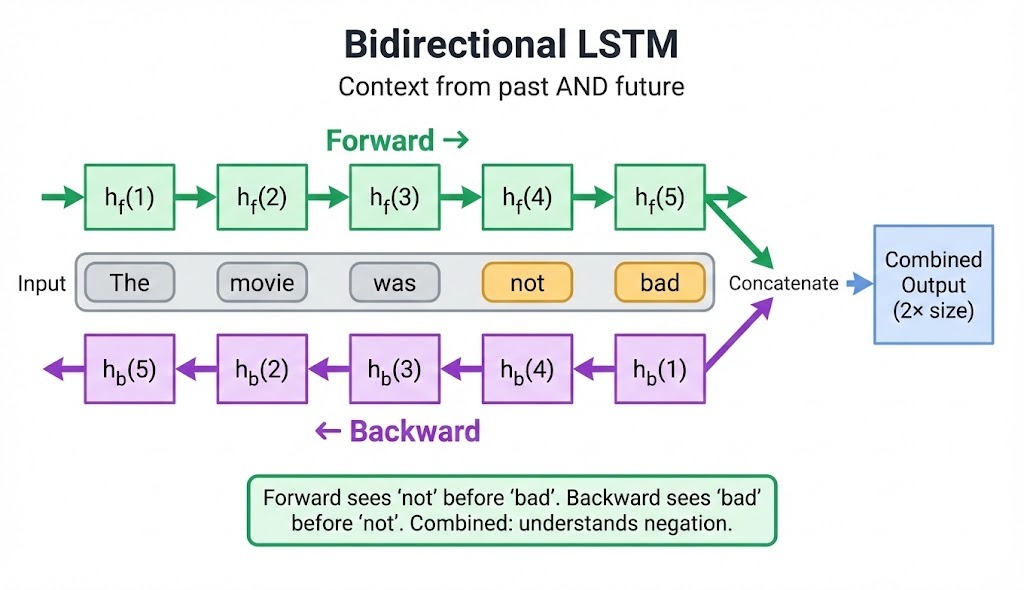
Bei Sentimentanalyse ist das wichtig, wenn eine Negation nach dem Wort erscheint, das sie modifiziert: „the movie was not bad“ braucht Vorwärtskontext, um „bad“ zu kennen, und Rückwärtskontext, um „not“ davor zu sehen.
BiLSTMs schlagen unidirektionale Modelle bei Named Entity Recognition (NER), Sentiment-Klassifikation und Spracherkennung konsistent — oft mit 5–15 % Zugewinn.
Der Trade-off: Zur Inferenz brauchst du die gesamte Sequenz. Streaming-Anwendungen mit Token-zu-Token-Input können nicht bidirektional arbeiten.
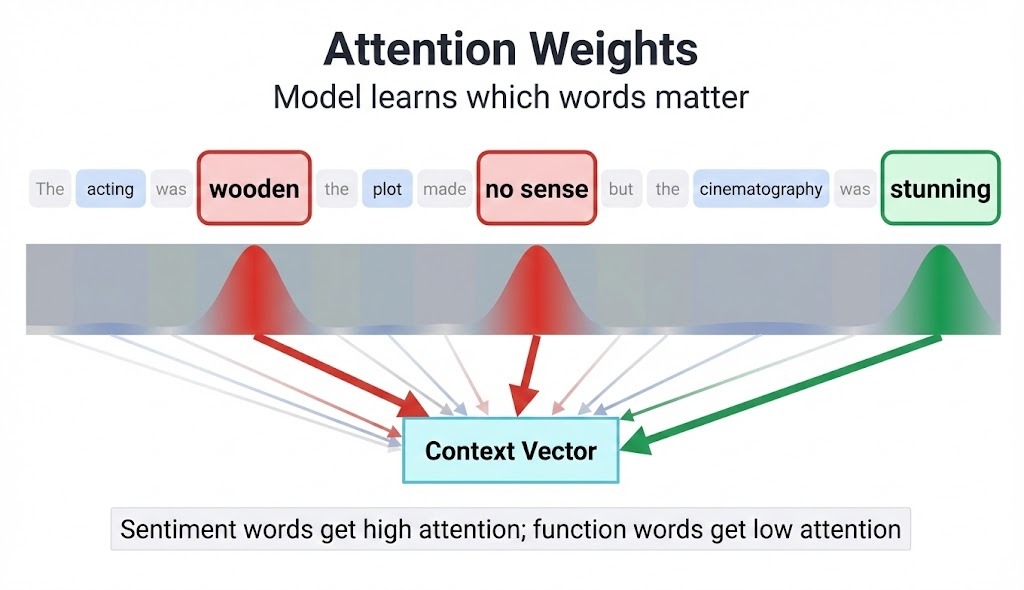
Attention erlaubt dem Modell zu gewichten, welche Zeitschritte für eine Vorhersage am meisten zählen. Statt die gesamte Sequenz in einen einzigen finalen versteckten Zustand zu pressen, berechnet Attention eine gewichtete Kombination aller versteckten Zustände.
class AttentionLayer(nn.Module):
	def __init__(self, hidden_size):
    		super().__init__()
    		self.attention = nn.Linear(hidden_size, 1)

	def forward(self, lstm_outputs):
    	# lstm_outputs: (batch, seq_len, hidden_size)
    		scores = self.attention(lstm_outputs)  # (batch, seq_len, 1)
    		weights = torch.softmax(scores, dim=1)
    		context = torch.sum(weights * lstm_outputs, dim=1)
    		return context
In einer Review wie „The acting was wooden, the plot made no sense, but the cinematography was stunning“ lernt Attention, sich auf stimmungsrelevante Phrasen zu fokussieren statt alle Wörter gleich zu behandeln. Das Modell gewichtet „wooden“, „no sense“ und „stunning“ höher und „the“ sowie „was“ niedriger.
Attention kostet wenig zusätzliche Rechenzeit und bringt bei Klassifikationsaufgaben oft 2–5 % Genauigkeitsgewinn. Bei Sequence-to-Sequence-Problemen wie Übersetzung ist Attention zwischen Encoder und Decoder quasi Pflicht für gute Ergebnisse.
Eine einzelne LSTM-Schicht erfasst Muster auf einer Abstraktionsebene. Mehrere gestapelte Schichten lassen das Netzwerk hierarchische Features lernen: Die erste Schicht erkennt lokale Phrasenmuster, höhere Schichten kombinieren sie zu Dokumentverständnis.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=3,  # Stack three layers
	dropout=0.3,   # Dropout between layers (not within)
	batch_first=True,
)
Leitlinien für die Tiefe:
Jede weitere Schicht verdoppelt grob die Trainingszeit. Starte flach und erhöhe die Tiefe erst, wenn die Validierungsmetriken plateauern.
LSTMs überfitten leicht, besonders bei kleinen Datensätzen. Drei Techniken funktionieren gut im Zusammenspiel:
Dropout setzt während des Trainings zufällig Neuronen auf Null und zwingt das Netzwerk, Wissen über mehrere Pfade zu verteilen. Wende Dropout zwischen LSTM-Schichten an, nicht innerhalb der rekurrenten Verbindungen (das stört das Zeitlehren).
# PyTorch setzt Dropout automatisch zwischen gestapelten Schichten ein
self.lstm = nn.LSTM(..., num_layers=2, dropout=0.3)

# Bei einlagigen LSTMs Dropout danach hinzufügen
self.dropout = nn.Dropout(0.3)
Dropout-Raten von 0,2–0,5 funktionieren meist gut. Höhere Werte helfen bei starkem Overfitting, verlangsamen aber die Konvergenz.
Gradient Clipping begrenzt die Größe der Gradienten während der Backpropagation. Auch wenn LSTMs Vanishing Gradients dämpfen, treten explodierende Gradienten weiterhin auf — besonders bei langen Sequenzen oder tiefen Netzen.
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)Typische Werte liegen zwischen 1,0 und 5,0. Wenn der Trainingsloss sprunghaft steigt oder NaN-Werte auftreten, setze den Schwellenwert niedriger.
Early Stopping überwacht den Validierungsloss und stoppt das Training, wenn er sich nicht mehr verbessert. So verhindert man, dass das Modell Trainingsdaten auswendig lernt und schlechter generalisiert.
patience = 5
best_val_loss = float('inf')
epochs_without_improvement = 0

for epoch in range(max_epochs):
	train_loss = train_one_epoch(model, train_loader)
	val_loss = evaluate(model, val_loader)

	if val_loss < best_val_loss:
    		best_val_loss = val_loss
    		epochs_without_improvement = 0
    		torch.save(model.state_dict(), 'best_model.pt')
	else:
    		epochs_without_improvement += 1
	if epochs_without_improvement >= patience:
        	break
Für einen kompletten Walkthrough zu Trainingsschleifen, Evaluationsmetriken und Debugging häufiger LSTM-Probleme schau dir den NLP mit PyTorch Guide an.
Zufällige Initialisierung funktioniert, aber vortrainierte Embeddings wie GloVe oder Word2Vec geben dem Modell einen Vorsprung. Sie kodieren semantische Beziehungen aus Milliarden Wörtern: „king“ und „queen“ liegen nahe beieinander, ebenso „terrible“ und „awful“.
import numpy as np

def load_glove_embeddings(glove_path, vocab, embedding_dim):
	embeddings = np.random.randn(len(vocab), embedding_dim) * 0.01

	with open(glove_path, 'r') as f:
    	for line in f:
        	parts = line.split()
        	word = parts[0]
        	if word in vocab:
            		embeddings[vocab[word]] = np.array(parts[1:], dtype=np.float32)

	return torch.tensor(embeddings, dtype=torch.float32)

# Load and freeze or fine-tune
pretrained = load_glove_embeddings('glove.6B.100d.txt', vocab, 100)
model.embedding.weight.data.copy_(pretrained)
model.embedding.weight.requires_grad = True  # Fine-tune during training
Vortrainierte Embeddings helfen besonders, wenn Trainingsdaten knapp sind. Mit Millionen Beispielen holen zufällige Embeddings irgendwann auf. In vielen Praxisfällen mit 10k–100k Samples bringen vortrainierte Initialisierungen 3–8 % Genauigkeitsgewinn.
Diese Ansätze lassen sich stapeln. Ein produktionsreifer Textklassifizierer könnte nutzen:
Jede Ergänzung erhöht Komplexität und Trainingszeit. Starte mit einem einfachen, einlagigen LSTM, miss die Performance und füge anschließend Techniken einzeln hinzu, um zu sehen, was für deine Aufgabe wirklich etwas bringt.
LSTMs dominierten das Sequenzmodellieren von den späten 1990ern bis in die Mitte der 2010er. Das Paper „Attention Is All You Need“ von 2017 hat das geändert. Transformer treiben heute die meisten Large Language Models — LSTMs sind aber nicht verschwunden. Sie bedienen andere Nischen.
Vorher hast du gesehen, wie LSTMs Sequenzen tokenweise verarbeiten und warum das Gating wirkt. Im großen Maßstab wird diese Sequenzialität zum Flaschenhals. Deine GPU hat tausende Kerne, doch die meisten sind untätig, während die Kette versteckter Zustände abgearbeitet wird. Ein Input mit 500 Tokens bedeutet 500 Schritte hintereinander.
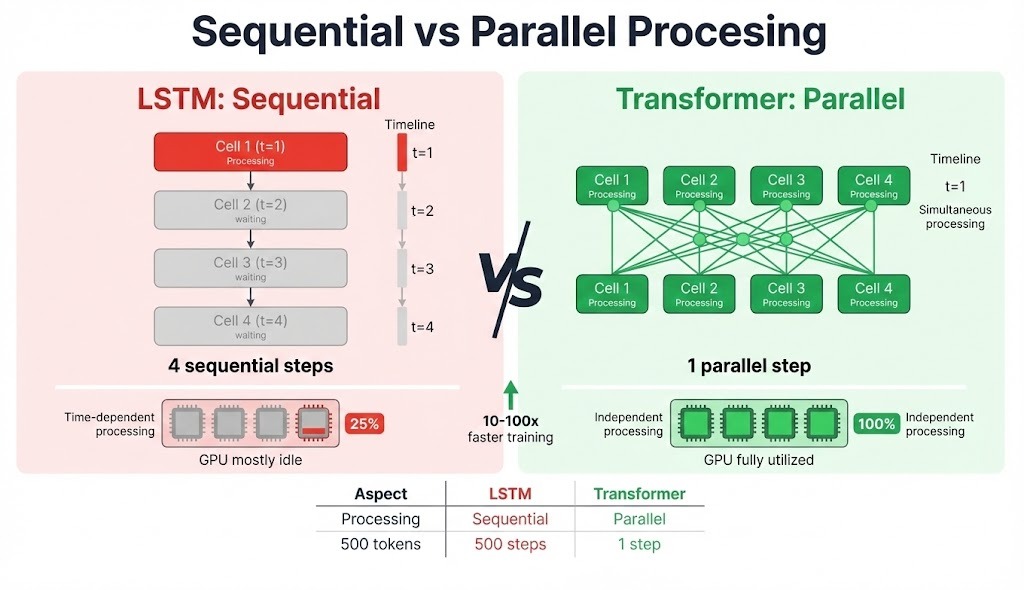
Transformer haben diese Einschränkung nicht. Self-Attention berechnet Beziehungen zwischen allen Positionen gleichzeitig — dieselbe 500-Token-Sequenz wird parallel verarbeitet. Auf moderner Hardware mit großen Batches bedeutet das 10–100× schnellere Trainings.
Auch die Längengrenze zählt. Wir haben gesehen, dass LSTMs Gradienten besser bewahren als Vanilla-RNNs — „besser“ heißt aber nicht „perfekt“. Die Leistung fällt irgendwo zwischen 200–500 Tokens ab, je nach Aufgabe.
Transformer berechnen Aufmerksamkeit direkt zwischen jedem Positionspaar — Token 1 beachtet Token 1000 genauso leicht. Der Trade-off ist Speicher: Aufmerksamkeitsmatrizen wachsen quadratisch mit der Sequenzlänge.
Gate-Aktivierungen erschweren zudem die Interpretation. Werte liegen zwischen 0 und 1 ohne klare Grenzen. Attention-Gewichte sind auch keine perfekten Erklärungen, geben aber ein klareres Signal, welche Tokens für welche Ausgabe wichtig waren.
Transformer sind sinnvoll, wenn:
LSTMs passen weiterhin, wenn:
Zeitreihenprognosen liegen irgendwo dazwischen. Aktuelle Benchmarks zeigen: Beide Architekturen performen auf univariaten Daten mit konsistenten Mustern ähnlich. Transformer ziehen davon, wenn viele Features komplex interagieren, während LSTMs punkten, wenn Daten knapp oder Rechenressourcen eng sind.
Hybride Designs verbinden beide Ansätze. Einige Architekturen stapeln LSTM-Schichten mit Attention-Mechanismen. xLSTM, veröffentlicht 2024, greift das Originaldesign mit exponentiellem Gating und Matrixspeicher neu auf und zeigt in kleineren Skalierungen wettbewerbsfähige Ergebnisse zu Transformern.
|
Aspekt |
LSTM |
Transformer |
|
Verarbeitung |
Sequenziell (Token für Token) |
Parallel (alle Positionen auf einmal) |
|
Trainingsgeschwindigkeit |
Langsamer (kaum parallelisierbar) |
Schneller auf GPUs |
|
Langfristige Abhängigkeiten |
Nimmt ab jenseits 200–500 Tokens |
Bewältigt tausende Tokens |
|
Speicherskalierung |
O(n) mit Sequenzlänge |
O(n²) für Attention-Matrizen |
|
Performance bei wenig Daten |
Gut (weniger Parameter) |
Überfittet leicht |
|
Einsatz am Edge |
Geeignet (kleiner Footprint) |
Herausfordernd (große Modelle) |
|
Streaming/Echtzeit |
Nativ unterstützt |
Braucht die vollständige Sequenz |
|
Ökosystem vortrainierter Modelle |
Begrenzt |
Umfassend (BERT, GPT, etc.) |
Am Ende entscheidet der Rahmen. Unbegrenzte Rechenleistung und Daten? Bei den meisten NLP-Aufgaben gewinnen Transformer. Ein Mikrocontroller mit 10K Trainingsbeispielen? LSTMs bleiben praktisch.
LSTMs lösten 1997 ein echtes Problem. Der von Hochreiter und Schmidhuber eingeführte Gating-Mechanismus ermöglichte es Netzen erstmals, aus Sequenzen von mehr als ein paar Dutzend Tokens zu lernen. Diese Architektur trieb Machine Translation, Spracherkennung und Zeitreihenprognosen fast zwei Jahrzehnte lang an.
Heute übernehmen Transformer die meisten großskaligen NLP-Aufgaben, doch LSTMs sind nicht obsolet. Sie sind weiterhin sinnvoll für Edge-Deployment, Streaming-Anwendungen und Szenarien mit wenig Trainingsdaten.
Wenn du ein neues Sequenzprojekt startest, probiere zuerst ein einfaches LSTM. Miss seine Performance, verstehe seine Schwächen und entscheide dann, ob es wirklich ein Transformer sein muss. Die Konzepte aus diesem Guide (Gating, Zellzustand, Gradientenfluss) helfen dir direkt beim Verständnis komplexerer Architekturen.
Für Praxisübungen empfehle ich unseren Kurs Recurrent Neural Networks, der weitere LSTM-Anwendungen mit geführten Übungen durchgeht.
Machine Learning Courses
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Allan Ouko
11 Min.