Sigmoid 函数是数据科学和机器学习中的重要概念,为逻辑回归和神经网络等算法提供动力。它有助于将复杂的数值数据转换为更易解释的概率。更准确地说,它将一个实值输入(通常来自线性模型的输出)映射为 0 到 1 之间类似概率的输出。
因此,sigmoid 对于预测二元结果(是/否或真/假决策)以及在分类机器学习模型中进行更有根据的预测至关重要。接下来的教程中,我将解释其数学性质、应用以及一些局限性。
什么是 Sigmoid 函数?
从本质上讲,sigmoid 函数是一条数学公式,它将任意实数映射到0 到 1之间的取值,因此非常适合产生概率型输出。其公式如下:
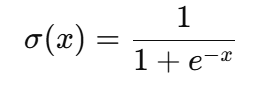
其中:
- x 是函数的输入。
- e 是自然对数的底(约为 2.718)。
Sigmoid 函数在数据科学中主要有两种常见用法:
- 二元分类:Sigmoid 将模型输出转换为概率分数,可用于预测贷款违约、检测欺诈或识别垃圾邮件等任务。
- 激活函数:在神经网络中,sigmoid 引入非线性,使模型能够学习数据中的复杂模式。
Sigmoid 函数的数学性质
Sigmoid 函数具备多种数学性质,使其在诸多应用中广受欢迎。
关键性质
- 取值范围:Sigmoid 的输出始终位于 0 到 1 之间,因此非常适合在二元分类等任务中估计概率。
- 单调性:该函数是单调递增的,即随着输入值的增加,输出值也随之增加而不会减少。这种一致性有助于建模变量之间的关系。
- 可微性:Sigmoid 在全域可微,即可在任一点计算其导数。此性质对反向传播等优化技术至关重要,反向传播用于训练神经网络。
- 非线性:Sigmoid 引入非线性,使模型能够学习更复杂的模式和决策边界。这在简单线性关系不足以解决问题的任务中尤为重要。
Sigmoid 函数的可视化
Sigmoid 函数最鲜明的特征是其S 形曲线。该曲线展示了如何将输入值压缩到 0 到 1 的范围内。
下面是一个简单的可视化:
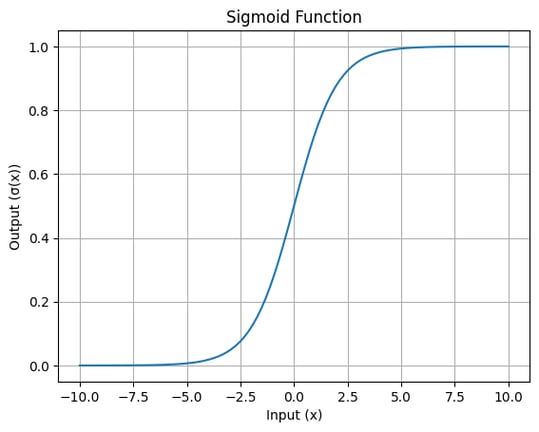
Sigmoid 函数的 S 形曲线:作者制图
Sigmoid 在逻辑回归中的作用
在逻辑回归中,sigmoid 函数用于将输入特征的线性组合转换为概率分数:
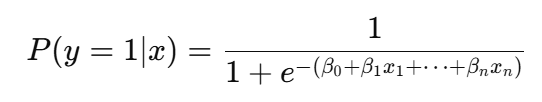
更具体地说,sigmoid 用于建模二元结果,即帮助预测某对象是否属于两类之一,例如 "yes" 或 "no"、“default” 或 “no-default”、"spam" 或 "not spam"。
该函数接受输入特征线性组合的结果,并将其转换为 0 到 1 之间的概率值。这个概率表示输入属于某个特定类别的可能性。
例如,如果线性方程的输出为 2,sigmoid 会将其转换为一个概率(如 0.88),表示该输入属于正类的概率为 88%。假设阈值设为 0.5 以确定分类,那么当概率高于 0.5 时,模型预测为正类;否则预测为负类。
为何需要进行这种转换?这是因为线性模型的原始输出并不能直接解释为概率。通过使用 sigmoid,逻辑回归不仅能够给出分类结果,还能提供清晰的概率解释,这在风险预测、流失分类或欺诈检测等应用中尤为有用。这种概率化的解释使决策者能够根据任务的具体需求设置自定义阈值。
在神经网络中的应用
Sigmoid 函数在神经网络中作为激活函数发挥关键作用。
激活函数的作用
作为激活函数,sigmoid 的主要作用是将上一层输入的加权和转换为 0 到 1 之间的输出值。该转换用于为模型引入非线性,使深度神经网络中的隐藏层能够学习复杂关系,并解决无法用直线分割的问题,例如图像识别或自然语言处理。
梯度消失问题
然而,sigmoid 也存在局限性,其中最主要的是梯度消失问题。对于非常大或非常小的输入值,函数输出会饱和于接近 1 或 0,其梯度几乎为零。这会导致致密神经网络的学习过程变慢,因为训练时权重更新过于缓慢。
替代激活函数
为解决这一问题,常采用 ReLU(修正线性单元)和 Tanh 等其他激活函数。ReLU 计算更简单,并在正输入时避免梯度消失。Tanh 与 sigmoid 一样呈 S 形,但输出范围为 -1 到 1,因而以零为中心,在某些场景下更高效。这些替代方案在深层网络中已大体取代 sigmoid,除非是在二元分类等任务的输出层。
关键考量与局限
尽管 sigmoid 函数有诸多优势,但在某些情境下也会遇到影响性能的挑战。
饱和问题
当输入值过大(正向)或过小(负向)时,sigmoid 会发生饱和。饱和意味着输出非常接近 0 或 1,梯度(变化率)几乎为零。
这会带来问题:当梯度接近零时,模型在训练过程中难以学习。结果就是基于梯度的优化方法(如反向传播)中的参数更新被明显放缓。
非零中心输出
另一个局限是 sigmoid 的输出位于 0 到 1 之间,并且不是以零为中心。这意味着所有输出均为正值,可能会偏移神经网络中的输入分布,从而降低优化速度。相较之下,Tanh 的输出范围是 -1 到 1,有助于使激活的均值更接近零,从而加快收敛。
计算开销
Sigmoid 依赖指数运算,相比 ReLU(修正线性单元)等更简单的激活函数,其计算成本更高。例如,sigmoid 的公式为:
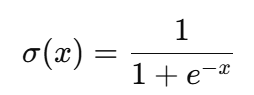
其中,指数计算比 ReLU 中仅包含比较与线性运算的开销更大,ReLU 表达式如下:
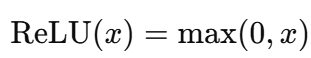
对于现代神经网络,尤其是层数和神经元众多的网络,反复进行指数运算的成本会累积,此时通常会采用替代方案。
结论
Sigmoid 函数是数据科学中的重要工具,尤其适用于逻辑回归以及神经网络中的激活函数。它有助于将输入转换为概率,并为模型引入非线性,使其能够处理复杂模式。然而,它也存在诸如饱和、缺乏零中心输出以及计算成本较高等挑战,可能影响其在深层网络中的效率。
尽管现代技术提供了替代方案,但 sigmoid 在塑造数据科学方法论方面的重要性不容小觑。如果您想更深入地了解其工作原理并查看其实际应用,欢迎探索我们关于神经网络和逻辑回归的互动课程与教程。我们的Introduction to Deep Learning in Python是一个不错的选择。


Sigmoid 函数是数据科学和机器学习中的重要概念,为逻辑回归和神经网络等算法提供动力。它有助于将复杂的数值数据转换为更易解释的概率。更准确地说,它将一个实值输入(通常来自线性模型的输出)映射为 0 到 1 之间类似概率的输出。
因此,sigmoid 对于预测二元结果(是/否或真/假决策)以及在分类机器学习模型中进行更有根据的预测至关重要。接下来的教程中,我将解释其数学性质、应用以及一些局限性。
什么是 Sigmoid 函数?
从本质上讲,sigmoid 函数是一条数学公式,它将任意实数映射到0 到 1之间的取值,因此非常适合产生概率型输出。其公式如下:
其中:
Sigmoid 函数在数据科学中主要有两种常见用法:
Sigmoid 函数的数学性质
Sigmoid 函数具备多种数学性质,使其在诸多应用中广受欢迎。
关键性质
Sigmoid 函数的可视化
Sigmoid 函数最鲜明的特征是其S 形曲线。该曲线展示了如何将输入值压缩到 0 到 1 的范围内。
下面是一个简单的可视化:
Sigmoid 函数的 S 形曲线:作者制图
Sigmoid 在逻辑回归中的作用
在逻辑回归中,sigmoid 函数用于将输入特征的线性组合转换为概率分数:
更具体地说,sigmoid 用于建模二元结果,即帮助预测某对象是否属于两类之一,例如 "yes" 或 "no"、“default” 或 “no-default”、"spam" 或 "not spam"。
该函数接受输入特征线性组合的结果,并将其转换为 0 到 1 之间的概率值。这个概率表示输入属于某个特定类别的可能性。
例如,如果线性方程的输出为 2,sigmoid 会将其转换为一个概率(如 0.88),表示该输入属于正类的概率为 88%。假设阈值设为 0.5 以确定分类,那么当概率高于 0.5 时,模型预测为正类;否则预测为负类。
为何需要进行这种转换?这是因为线性模型的原始输出并不能直接解释为概率。通过使用 sigmoid,逻辑回归不仅能够给出分类结果,还能提供清晰的概率解释,这在风险预测、流失分类或欺诈检测等应用中尤为有用。这种概率化的解释使决策者能够根据任务的具体需求设置自定义阈值。
在神经网络中的应用
Sigmoid 函数在神经网络中作为激活函数发挥关键作用。
激活函数的作用
作为激活函数,sigmoid 的主要作用是将上一层输入的加权和转换为 0 到 1 之间的输出值。该转换用于为模型引入非线性,使深度神经网络中的隐藏层能够学习复杂关系,并解决无法用直线分割的问题,例如图像识别或自然语言处理。
梯度消失问题
然而,sigmoid 也存在局限性,其中最主要的是梯度消失问题。对于非常大或非常小的输入值,函数输出会饱和于接近 1 或 0,其梯度几乎为零。这会导致致密神经网络的学习过程变慢,因为训练时权重更新过于缓慢。
替代激活函数
为解决这一问题,常采用 ReLU(修正线性单元)和 Tanh 等其他激活函数。ReLU 计算更简单,并在正输入时避免梯度消失。Tanh 与 sigmoid 一样呈 S 形,但输出范围为 -1 到 1,因而以零为中心,在某些场景下更高效。这些替代方案在深层网络中已大体取代 sigmoid,除非是在二元分类等任务的输出层。
关键考量与局限
尽管 sigmoid 函数有诸多优势,但在某些情境下也会遇到影响性能的挑战。
饱和问题
当输入值过大(正向)或过小(负向)时,sigmoid 会发生饱和。饱和意味着输出非常接近 0 或 1,梯度(变化率)几乎为零。
这会带来问题:当梯度接近零时,模型在训练过程中难以学习。结果就是基于梯度的优化方法(如反向传播)中的参数更新被明显放缓。
非零中心输出
另一个局限是 sigmoid 的输出位于 0 到 1 之间,并且不是以零为中心。这意味着所有输出均为正值,可能会偏移神经网络中的输入分布,从而降低优化速度。相较之下,Tanh 的输出范围是 -1 到 1,有助于使激活的均值更接近零,从而加快收敛。
计算开销
Sigmoid 依赖指数运算,相比 ReLU(修正线性单元)等更简单的激活函数,其计算成本更高。例如,sigmoid 的公式为:
其中,指数计算比 ReLU 中仅包含比较与线性运算的开销更大,ReLU 表达式如下:
对于现代神经网络,尤其是层数和神经元众多的网络,反复进行指数运算的成本会累积,此时通常会采用替代方案。
结论
Sigmoid 函数是数据科学中的重要工具,尤其适用于逻辑回归以及神经网络中的激活函数。它有助于将输入转换为概率,并为模型引入非线性,使其能够处理复杂模式。然而,它也存在诸如饱和、缺乏零中心输出以及计算成本较高等挑战,可能影响其在深层网络中的效率。
尽管现代技术提供了替代方案,但 sigmoid 在塑造数据科学方法论方面的重要性不容小觑。如果您想更深入地了解其工作原理并查看其实际应用,欢迎探索我们关于神经网络和逻辑回归的互动课程与教程。我们的Introduction to Deep Learning in Python是一个不错的选择。