词语之间的关系
每个向量就像一个独特的标识符,不仅封装了词语的含义,还反映了它与其他词语的关系。定义相似的词语在这个数值空间中往往彼此接近,就像地图上相邻的点一样。这种接近性揭示了词语之间的语义连接。
下面的三维散点图可视化了词语向量嵌入的概念。空间中的每个点代表一个词,其位置由其向量嵌入决定。聚集在一起的蓝色点表示动物相关的词(“Cat”“Dog”“Pet”“Animal”),红色点表示交通工具相关的词(“Car”“Vehicle”)。点之间的距离表示语义相似度——含义相关的词在该向量空间中位置更接近。
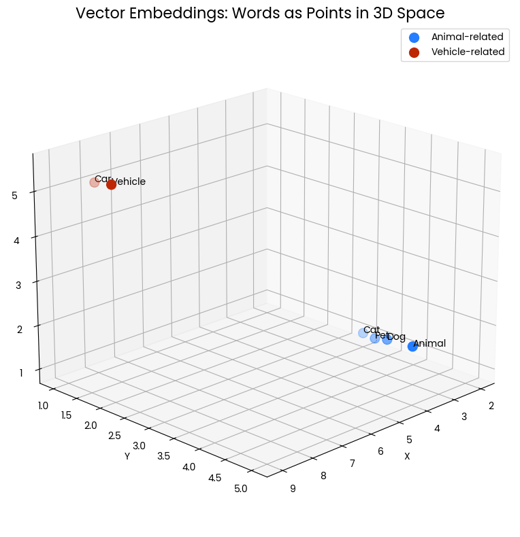
图 1:三维空间中的两个词语簇。距离表示语义相似度。
例如,“Cat”和“Dog”彼此接近,反映了它们作为常见宠物的共同特征。同样,“Car”和“Vehicle”也很接近,表明它们含义相关。然而,动物簇与交通工具簇相距较远,说明这两组概念在语义上彼此区分。
这种空间化的表示帮助我们直观理解向量嵌入如何捕捉并呈现词语之间的关系。它将语言的含义转化为可度量、可数学分析的几何关系。
向量嵌入如何捕捉含义
向量嵌入在自然语言处理(NLP)中尤为常见,重点在于表示单个词。这些数值表示并非随机指定——而是从海量文本数据中学习得到的。下面来看它是如何工作的。
使用 Word2Vec 的自然语言处理
将向量分配给词语的 NLP 技术之一是 Word2Vec。它是一种机器学习模型,通过大型语料中的上下文来学习词语之间的关联。您可以将其视为一种语言模型,尝试根据周围词语来预测目标词。
通过这种方式,它隐式地学习词语之间的关系,捕捉语义和句法信息。随后,这些学习到的关系被编码为数值向量,可用于各种 NLP 任务。最终,那些经常一起出现或处于相似上下文中的词,其向量会在嵌入空间中更为接近。
Word2Vec 使用两种主要架构来捕捉词语关系:连续词袋模型(CBOW)与 Skip-gram。
|
架构 |
过程 |
计算效率 |
捕捉到的关系 |
对高频词的敏感性 |
|
CBOW |
根据周围上下文词预测目标词 |
训练更快 |
更擅长捕捉句法关系(语法规则) |
对高频词更敏感 |
|
Skip-gram |
根据目标词预测周围上下文词 |
训练较慢 |
更擅长捕捉语义关系(文本含义) |
对高频词不那么敏感 |
Skip-gram 的训练可能比 CBOW 更慢,但其生成式方法通常被认为能产生更准确的嵌入,尤其适用于罕见词。
来看一个例子:设想一个庞大的文本语料。Word2Vec 从分析词语在特定窗口内的共现开始。比如句子“The king and queen ruled the kingdom.”中,“king”和“queen”在一个很小的窗口内同时出现。Word2Vec 会捕捉这种共现信息。
经过无数句子的统计,算法会建立一个统计模型。它学习到“king”和“queen”等词经常出现在相似的上下文中,并将这种信息编码为数值向量。结果,“king”和“queen”的向量在嵌入空间中的位置会比“apple”(很少出现在相同语境中)的向量更为接近。
在向量空间中的这种接近性反映了“king”和“queen”的语义相似,展示了 Word2Vec 在捕捉语言关系方面的强大能力。
为什么向量嵌入如此强大
既然我们已经了解了什么是向量嵌入以及它们如何捕捉含义,接下来更进一步,看看它们能支持哪些任务。
正如前文所述,向量嵌入擅长量化语义相似性。通过测量词向量之间的距离,我们可以判断词语在含义上的接近程度。
这种能力可用于查找同义词和反义词。定义相近的词向量会聚集在一起,而反义词在许多维度上可能相似,但在描述其差异的关键维度上相距甚远。
这种“魔法”还可解决复杂的语言类比。向量嵌入允许我们对词向量进行算术运算,从而揭示隐藏的关系。例如,“king 之于 queen,如 man 之于 woman”的类比,可以通过用“king”的向量减去“man”的向量,再加上“woman”的向量来求解。所得向量应与“queen”的向量高度接近,体现了向量嵌入在捕捉语言模式方面的威力。
句子嵌入
嵌入的适用范围不仅限于单个词。句子嵌入能够捕捉整句的整体含义。通过将句子表示为稠密向量,我们可以衡量不同文本之间的语义相似度。
就像词嵌入是高维空间中的点一样,句子嵌入也同为向量。但为了反映句子层面的更高复杂度,它们通常具有更高的维度。我们可以对这些向量进行数学运算来衡量语义相似,从而实现更复杂的任务,如信息检索、文本分类和情感分析。
一种直接的方法是对句中所有词的词嵌入取平均。尽管简单,但常常是不错的基线。为捕捉更复杂的语义与句法信息,会采用更先进的技术,如循环神经网络(RNN)和基于 Transformer 的模型:
|
架构 |
处理方式 |
上下文理解 |
计算效率 |
|
RNNs |
序列式 |
侧重局部上下文 |
对长序列效率较低 |
|
基于 Transformer 的模型 |
并行式 |
可捕捉长程依赖 |
高效,对长序列同样适用 |
虽然 RNN 曾长期占据主导地位,但 Transformer 在许多 NLP 任务(包括句子嵌入生成)上的性能与效率已实现超越。
不过,在需要严格序列处理的特定应用中,RNN 依然有其用武之地。此外,还有许多预训练的句子嵌入模型可用,可即插即用地支持诸如文本摘要、基于知识的问答或命名实体识别(NER)等任务。
超越文本
向量嵌入并不限于文本。以下应用展示了嵌入在多个领域的广泛影响:
- 图像可被转化为数值表示,从而实现图像搜索、目标识别与图像生成。
- 商品嵌入可在电商场景中实现个性化推荐,基于用户偏好与购买历史寻找相似商品。
- 音频数据可转化为嵌入,推动音乐发现与语音识别的革新。
- 时序列数据(如股价或传感器读数)可被转化为嵌入,以发掘隐藏模式并进行准确预测。
- 图数据(如社交网络或知识库)可表示为向量,以分析复杂关系并提取有价值的洞见。
- 文档可被转化为嵌入,为高效的搜索引擎与智能文档组织提供动力。
- 代码片段可被表示为嵌入,支持先进的代码搜索与推荐系统。
向量嵌入的实际应用
既然我们已经了解了向量嵌入的工作原理及其可处理的数据类型,接下来来看具体用例。让我们从最知名的例子之一开始:大型语言模型(LLM)。
诸如ChatGPT、Claud 或 Google Gemini等 LLM 在很大程度上依赖向量嵌入这一基础组件。这些模型学习将词语、短语乃至整句表示为高维空间中的稠密向量。本质上,向量嵌入为语言模型提供了对词语及其关系的语义理解,构成其强大能力的骨干。
文本的数值化表示使 LLM 能够理解并生成类人文本,从而完成翻译、摘要与问答等任务。这为内容创作、客户服务、教育与科研等众多领域打开了广阔应用空间。
超越 LLM
向量嵌入还能为传统搜索引擎提供替代路径,后者通常依赖关键词匹配。通过将搜索查询与网页同时表示为嵌入,可以帮助搜索引擎理解查询与候选页面背后的语义含义,突破仅限精确关键词匹配的局限,从而定位更相关的页面并提供更准确、信息量更高的结果。
向量嵌入的另一优势在于识别异常数据点或异常模式。算法可以计算以向量表示的数据点之间的距离,并将那些显著偏离常态的点标记出来。这一技术广泛应用于欺诈检测、网络安全与工业过程监控。
向量嵌入还在弥合语言鸿沟方面发挥关键作用。与我们关于“king”和“queen”的示例类似,跨语言也能捕捉表示词语间语义与句法关系的向量。因此,可以根据向量相似度在目标语言中找到对应该词或短语,帮助诸如 DeepL等机器翻译系统生成更准确、流畅的译文。
最后,向量嵌入在构建高效推荐系统方面同样至关重要。通过将用户与物品表示为嵌入,推荐系统可以基于向量距离识别相似的用户或物品,从而为商品、电影、音乐及其他内容提供个性化推荐。例如,喜欢某部电影的用户,往往也会喜欢嵌入相似的其他电影。
结语
可以看到,向量嵌入已成为一项非常强大的工具。它们将复杂数据转化为机器学习算法易于理解的格式,从而在多个领域释放出巨大潜力。
本文的要点如下:
- 向量嵌入充当数据的数字“指纹”,将词语、图像甚至声音翻译为数值表示。
- 这些表示能够捕捉数据点之间的语义关系,使得查找相似项或挖掘隐藏模式成为可能。
- 像 Word2Vec 这样的技术利用海量文本数据来学习词语关联,并将这些关系编码为向量。
- 这些向量不仅驱动 LLM,也让搜索结果更准确、翻译更自然,并支持欺诈检测算法。
- 扎实理解向量嵌入,有助于进一步探索自然语言处理(NLP)、计算机视觉与推荐系统等领域。
您可以通过以下资源继续学习向量嵌入:
想象一下,试图教一台计算机分辨苹果和橙子。对我们来说这很容易,但对一台只会理解数字的机器而言,却是个复杂的挑战。
这正是向量嵌入发挥作用的地方。这些数学“魔法”将词语、图像及其他数据转化为计算机易于理解和操作的数值表示。
向量嵌入通过将信息世界映射到数值空间,开启了无限可能。
什么是向量嵌入?
向量嵌入是词语或其他数据片段的数字“指纹”。它不是用字母或图像,而是用按特定结构排列的数字来表示,这种结构称为向量,类似于一个有序的数值列表。
可以将每个向量想象成多维空间中的一个点,其所在位置携带了关于所代表词语或数据的关键信息。
您也许还记得数学课上向量是具有方向和大小的箭头。虽然向量嵌入共享这一基本概念,它们却在拥有无数维度的空间中运行。
这种极高的维度对于捕捉人类语言的复杂细微差别至关重要,例如语气、上下文和语法特征。想象一个向量不仅能区分“happy”和“sad”,还能刻画“ecstatic”“content”或“melancholic”等细微变化。
向量嵌入是一种将复杂数据转换为适合机器学习算法格式的有价值技术。通过将高维、类别型数据转换为低维、连续的表示,嵌入在保留底层数据模式的同时,提升模型性能与计算效率。
为便于直观理解如何定义一个多维向量空间,下面这张表展示了八个示例维度及其取值范围:
特征
描述
范围
具体性
衡量一个词是多么具体或抽象
0 到 1
情感价
与该词相关的正负倾向
-1 到 1
频率
该词在大型语料库中出现的频率
0 到 1
长度
词语的字符数
0 到 1
词性
用独热编码表示名词、动词、形容词、其他
4x [0,1]
正式程度
与该词相关的正式程度
0 到 1
特异性
词语的具体或泛化程度
0 到 1
感官关联
该词与感官体验的关联程度
0 到 1
例如,“cat”的向量可能是:[0.9, 0.2, 0.7, 0.3, 1, 0, 0, 0, 0.4, 0.8, 0.9],而“freedom”可能是:[0.1, 0.8, 0.6, 0.7, 1, 0, 0, 0, 0.7, 0.3, 0.2]。