
Corso
Reti Neurali Ricorrenti (RNN) per il Language Modeling con Keras
4 ore
16.4K
Le reti neurali ricorrenti standard faticano con la memoria. Quando le sequenzes superano i 20-30 timestep, i gradienti tendono a ridursi verso zero o a esplodere durante la backpropagation, e la rete perde la capacità di collegare parti lontane dell'input. Hochreiter e Schmidhuber hanno affrontato questo problema nel paper del 1997 introducendo le Long Short-Term Memory networks.
In questa guida, passerò in rassegna gli aspetti interni delle LSTM prima di arrivare all'implementazione pratica in Python. Nelle sezioni finali confronteremo LSTM e Transformer così da aiutarti a scegliere l'architettura giusta per il tuo caso d’uso.
Ti consiglio vivamente il nostro corso Introduction to Deep Learning in PyTorch per fare esperienza pratica nell'uso di PyTorch per l'addestramento di reti neurali, che sono la base dei modelli LSTM.
LSTM sta per Long Short-Term Memory, un tipo di rete neurale ricorrente (RNN) progettata per gestire sequenze in cui il contesto lontano nell'input è ancora rilevante.
L’idea alla base delle LSTM è un meccanismo di gating che regola il flusso di informazioni nella rete. Invece di lasciare passare indistintamente tutti i segnali, le porte imparano quando trattenere il contesto e quando lasciarlo andare.
Questa memoria selettiva permette alle LSTM di seguire dipendenze su centinaia di timestep, utili per language modeling, riconoscimento vocale e previsione di serie temporali. Per capire perché esiste questa architettura, aiuta vedere cosa si rompe nelle RNN standard.
Le reti ricorrenti trasmettono informazioni da un timestep al successivo attraverso uno stato nascosto. A ogni passo, questo stato viene moltiplicato per pesi appresi, aggiornato e passato avanti. L'addestramento richiede di inviare segnali di errore all’indietro lungo tutti quei passi, e ogni passaggio all’indietro riduce un po’ il segnale. Dopo abbastanza passi, non rimane più nulla.
È come fare una fotocopia di una fotocopia. Dopo poche volte, la copia è ancora leggibile. Dopo cinquanta, a malapena si distingue il testo. Le RNN si scontrano con questo limite intorno ai 20-30 timestep, ed è per questo che faticano con sequenze più lunghe.
Le LSTM aggiungono un percorso di memoria separato, chiamato stato di cella, che scorre in parallelo allo stato nascosto standard. La differenza è strutturale: l’informazione nello stato di cella fluisce tramite addizione invece che per moltiplicazioni ripetute, quindi non si degrada nello stesso modo.
Per controllare cosa entra ed esce da questa memoria, le LSTM usano delle porte. Ogni porta è una piccola rete neurale che impara a produrre valori tra 0 e 1, agendo da filtro. Un valore vicino a 0 blocca l’informazione; un valore vicino a 1 la lascia passare. Durante l’addestramento, la rete impara quali pattern vale la pena ricordare lungo sequenze lunghe e quali si possono scartare.
Questo meccanismo di gating è ciò che distingue le LSTM dalle RNN “vanilla”. Invece di forzare tutte le informazioni nello stesso percorso, le LSTM possono preservare selettivamente il contesto su centinaia di timestep. La prossima sezione spiega nel dettaglio come funzionano queste porte e come si combinano per aggiornare lo stato di cella.
Le LSTM compaiono ovunque i dati sequenziali contino. Alcuni esempi oltre alle solite applicazioni NLP e di forecasting:
Questa sezione tratta nel dettaglio gli aspetti interni delle LSTM. Se vuoi passare subito all’implementazione, salta alla sezione successiva. I dettagli architetturali qui non sono indispensabili per usare le LSTM, ma aiutano nel debug o nella messa a punto.
Per capire come funzionano le LSTM, seguiamo un esempio concreto: elaborare la sequenza "The clouds are dark..." per prevedere la parola successiva. Ogni componente ha più senso quando vedi cosa fa a dati reali.
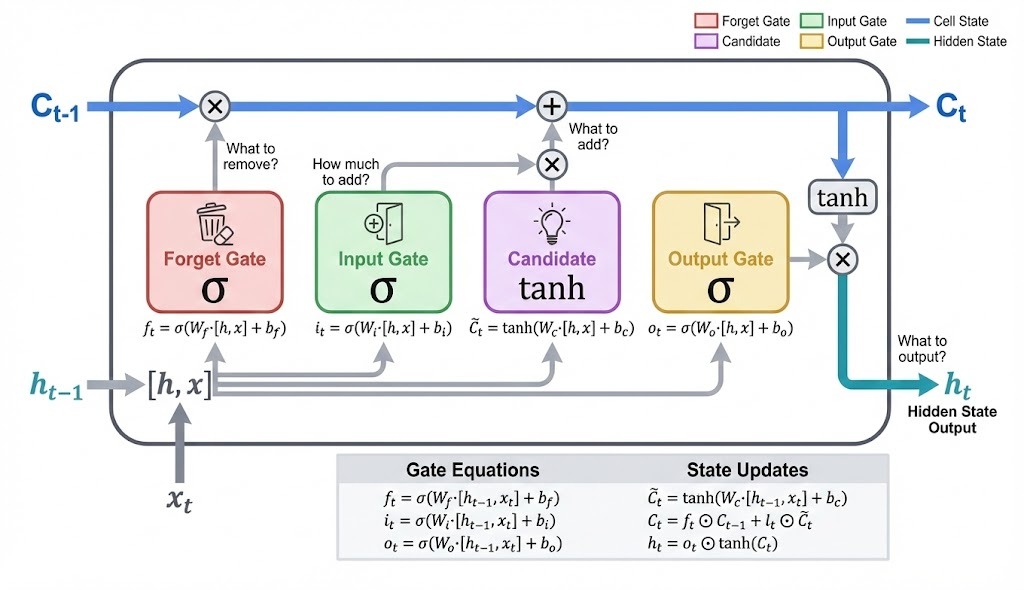
Una LSTM mantiene due vettori separati che scorrono nella rete: lo stato di cella e lo stato nascosto.
Lo stato di cella funge da memoria a lungo termine. Porta informazioni tra i timestep con modifiche controllate a ogni passo. Elaborando la nostra sequenza, lo stato di cella potrebbe memorizzare "comparso un sostantivo legato al meteo" dopo aver visto "clouds" e preservare quel contesto attraverso "are", finché "dark" rinforza il pattern.
Lo stato nascosto è l'output della cella a ogni timestep. Alimenta le previsioni e i calcoli del timestep successivo. Dopo aver elaborato "dark", lo stato nascosto codifica qualcosa come "aggettivo che descrive condizioni meteo" che uno strato di previsione può usare.
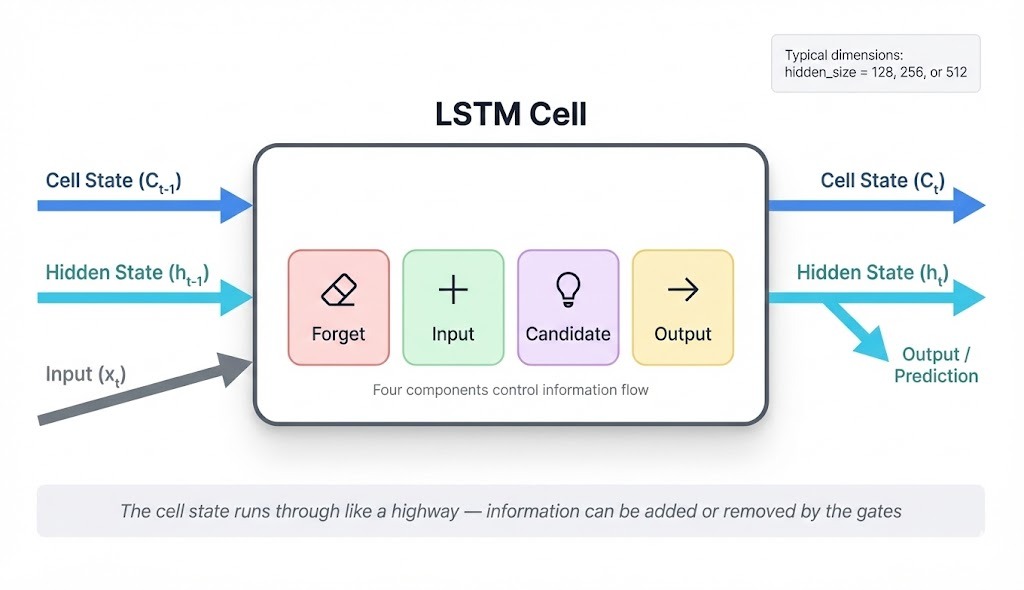
Perché due percorsi separati? Un unico stato dovrebbe al tempo stesso mantenere contesto a lungo termine e produrre output utili. Questi obiettivi confliggono: una memoria stabile richiede cambi minimi, mentre output utili richiedono trasformazioni. Separarli permette a ciascun percorso di ottimizzare il proprio scopo.
A ogni timestep, la cella riceve tre input e produce due output:
Input:
Precedente stato di cella (C_{t-1}): ciò che la rete ricorda finora
Precedente stato nascosto (h_{t-1}): l'output dell'ultimo timestep
Input corrente (x_t): il nuovo token, come "clouds" o "dark"
Output:
Stato di cella aggiornato (C_t): la memoria dopo aver elaborato questo token
Nuovo stato nascosto (h_t): l'output di questo timestep
Quattro componenti controllano cosa accade dentro la cella. Tre sono porte che producono valori tra 0 e 1, agendo da filtri. La quarta è il candidato, che propone nuovo contenuto.
Quando "are" arriva dopo "clouds", ogni componente ha un compito:
Porta di dimenticanza (f_t): Dovremmo mantenere il contesto di "clouds"? I sostantivi meteo seguiti da verbi copulativi di solito contano, quindi la porta di dimenticanza produce valori vicini a 1 per preservare gran parte dello stato di cella.
Porta di input (i_t): Quanto dovrebbe contribuire "are" alla memoria? I verbi copulativi portano meno segnale predittivo, quindi la porta di input produce valori più bassi.
Candidato (C̃_t): Quale nuova informazione potrebbe aggiungere "are"? Il candidato propone contenuto, ma la porta di input lo ridimensiona.
Porta di output (o_t): Cosa dovrebbe mostrare lo stato nascosto? La porta di output filtra lo stato di cella per produrre h_t.
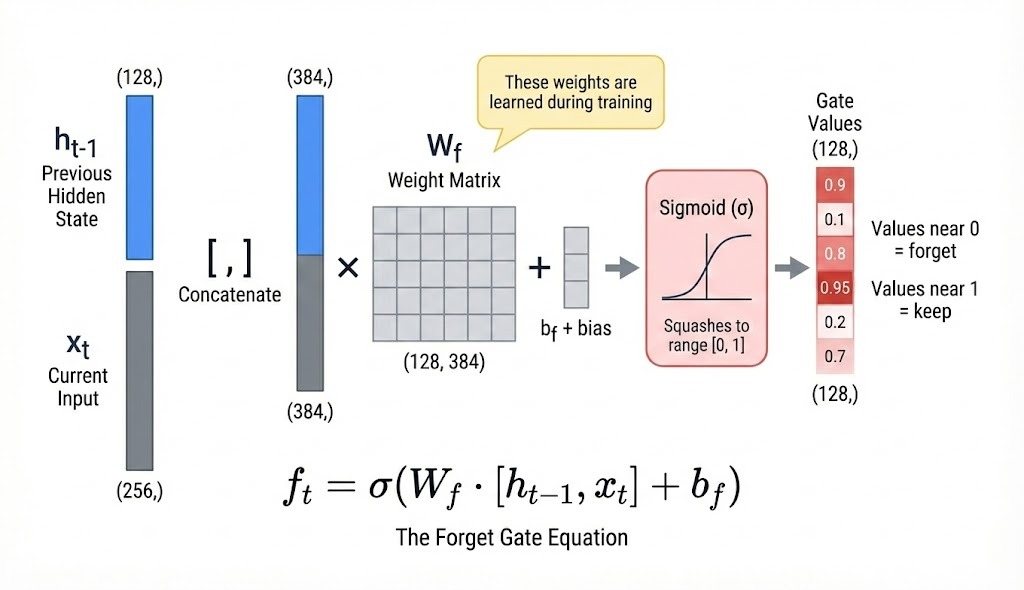
Ogni componente calcola il proprio output allo stesso modo:
Concatena h_{t-1} e x_t in un unico vettore
Moltiplica per una matrice di pesi appresa
Aggiungi un termine di bias
Applica una funzione di attivazione
Le porte usano l’attivazione sigmoid, che comprime i valori nell’intervallo 0-1. Il candidato usa la tanh, producendo valori tra -1 e 1, così può proporre sia incrementi che decrementi allo stato di cella.
Porta di dimenticanza (sigmoid → da 0 a 1):
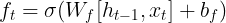
Porta di input (sigmoid → da 0 a 1):
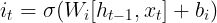
Porta di output (sigmoid → da 0 a 1):
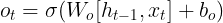
Candidato (tanh → da -1 a +1):
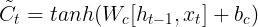
Ogni componente ha la propria matrice di pesi (W_f, W_i, W_c, W_o), quindi imparano a rispondere a pattern diversi nell’input.
Gli output delle porte si moltiplicano con i vettori posizione per posizione (moltiplicazione elemento per elemento, scritta come ⊙). Ogni dimensione viene filtrata indipendentemente.
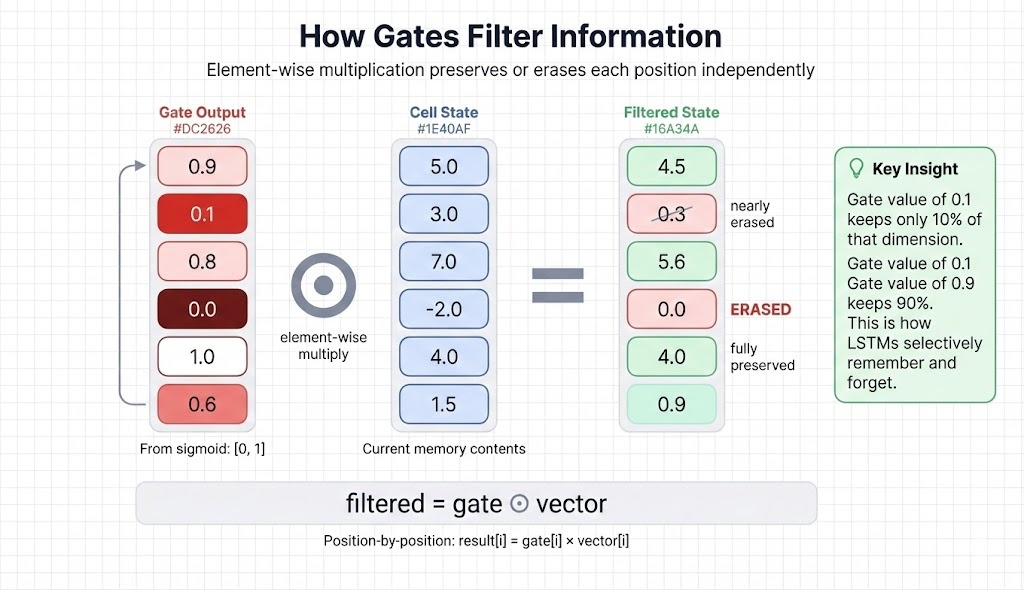
Se una porta produce 0,9 per la posizione 1, quella dimensione mantiene il 90% del suo valore. Se produce 0,0 per la posizione 4, quella dimensione viene cancellata. Elaborando "dark" dopo "clouds are", la porta di dimenticanza potrebbe produrre valori alti per le dimensioni che memorizzano il contesto nome/meteo e più bassi per le dimensioni che contengono contesto precedente irrilevante.
I componenti si combinano in tre passaggi per aggiornare lo stato di cella e produrre lo stato nascosto.
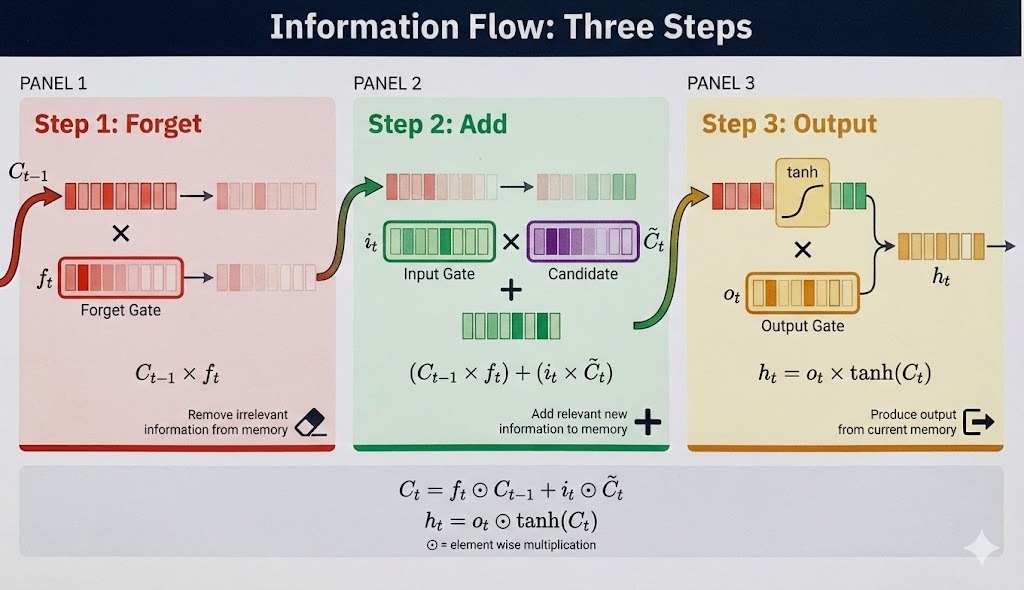
La porta di dimenticanza filtra il precedente stato di cella: 
Elaborando "dark", la porta di dimenticanza preserva il contesto meteo da "clouds" mentre pulisce le dimensioni che tracciavano l’articolo "The".
La porta di input scala la proposta del candidato, poi la aggiunge allo stato di cella filtrato:
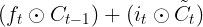
Il candidato potrebbe proporre "aggettivo che modifica un sostantivo meteo", e la porta di input decide quanto scriverlo in memoria. Questo aggiornamento additivo (non moltiplicativo) è ciò che aiuta il flusso dei gradienti durante l’addestramento.
Lo stato di cella passa attraverso la tanh, poi la porta di output filtra ciò che diventa lo stato nascosto:
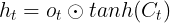
La tanh mantiene i valori limitati. La porta di output seleziona quali aspetti della memoria accumulata devono essere visibili per le previsioni in questo timestep.
La sequenza completa:
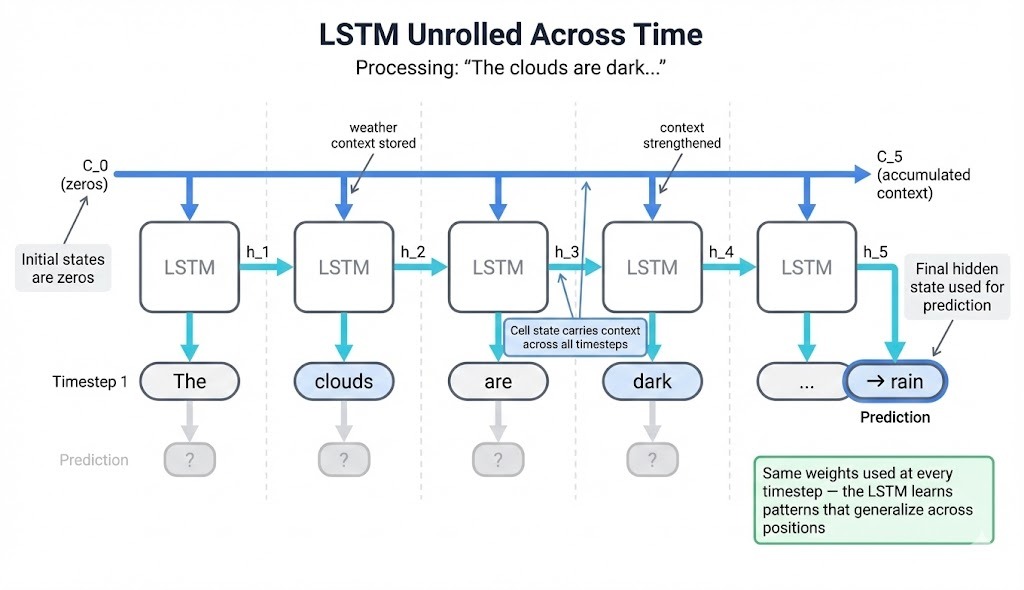
Ecco un tracciamento semplificato con uno stato di cella di 4 dimensioni:
|
Step |
Input |
Stato di cella (semplificato) |
Cosa succede |
|
1 |
"The" |
[0.1, 0.0, 0.2, 0.0] |
Memorizzazione minima; gli articoli portano poco segnale predittivo |
|
2 |
"clouds" |
[0.1, 0.7, 0.2, 0.3] |
La porta di input si apre per le dimensioni 2,4; memorizza il pattern del sostantivo |
|
3 |
"are" |
[0.1, 0.6, 0.2, 0.3] |
La porta di dimenticanza ≈ 0.9 preserva il contesto; il verbo copulativo aggiunge poco |
|
4 |
"dark" |
[0.1, 0.8, 0.5, 0.6] |
L’aggettivo rafforza il segnale nelle dimensioni 2,3,4 |
Al timestep 4, le dimensioni 2-4 hanno accumulato un pattern. Lo stato nascosto h_4 alimenta uno strato di previsione (non parte della LSTM), che produce probabilità sul vocabolario. Quel pattern accumulato aiuta il modello a preferire parole come "rain" o "sky".
La rete non “capisce” il meteo. Impara correlazioni statistiche: certe sequenze di input tendono a precedere certi output.
La struttura additiva dello stato di cella fornisce un percorso del gradiente più diretto rispetto alle RNN standard. Se non ti è familiare come i gradienti si propagano nelle reti neurali, il tutorial sulla backpropagation copre le basi.
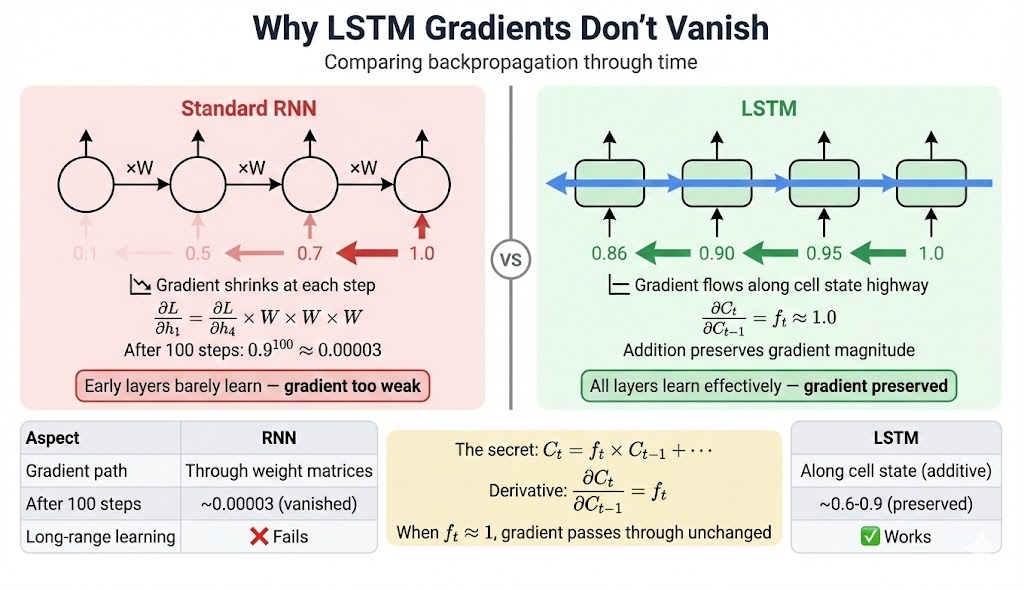
Nelle RNN standard, i gradienti scorrono attraverso matrici di pesi a ogni passo. La moltiplicazione ripetuta si accumula: dopo 100 passi con pesi medi di 0,9, il gradiente si riduce a 0.9^100 ≈ 0.00003.
Le LSTM offrono un percorso alternativo lungo lo stato di cella. La derivata di C_t rispetto a C_{t-1}:
∂C_t/∂C_{t-1} = f_tQuesto è il valore della porta di dimenticanza, non una matrice di pesi. Quando le porte di dimenticanza restano vicine a 1, i gradienti passano con meno decadimento. Se le porte in media valgono 0,95, dopo 100 passi: 0.95^100 ≈ 0.006. Ancora ridotto, ma utilizzabile.
|
Aspetto |
RNN |
LSTM |
|
Percorso del gradiente |
Solo matrici di pesi |
Percorso aggiuntivo lungo lo stato di cella |
|
Gradiente a 100 passi |
~10^-5 (svanito) |
~10^-2 a 10^-1 (utilizzabile) |
|
Memoria pratica |
~10-20 timestep |
~50-200 timestep |
Nota pratica: I bias delle porte di dimenticanza sono spesso inizializzati a 1,0 o più, spingendo gli output iniziali verso "ricorda tutto". Questo aiuta la rete a imparare pattern a lungo termine già nelle prime fasi dell’addestramento.
Le LSTM mitigano il problema del gradiente che svanisce, non lo eliminano. Il miglioramento deriva dall’aggiornamento additivo dello stato di cella, che fornisce un’autostrada per il gradiente accanto ai percorsi standard.
La sezione precedente ha trattato ciò che accade dentro una cella LSTM: porte che filtrano l’informazione, stato di cella che preserva il contesto e stato nascosto che produce output. Ora vedremo come nn.LSTM di PyTorch racchiude tutto questo in un singolo modulo e lo usa per classificare recensioni di film come positive o negative.
Suggerimento per eseguire il codice: Addestrare per 50 epoche su CPU richiede molto tempo. Usa Google Colab o Kaggle Notebooks con accelerazione GPU per risultati più rapidi. Lo script completo è disponibile come GitHub Gist.
La classificazione di testo con LSTM segue uno schema: convertire le parole in vettori, lasciare che la LSTM le processi in sequenza, quindi usare l’output finale per la previsione.
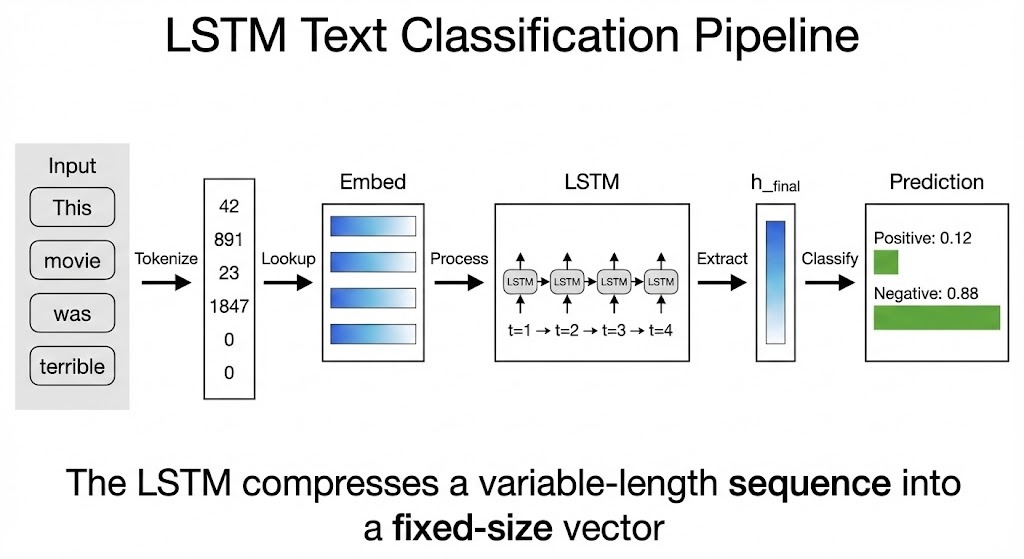
Le reti neurali operano su numeri continui, ma le parole sono simboli discreti. Non possiamo inserire "terrible" direttamente nelle moltiplicazioni di matrici. La soluzione è uno strato di embedding: una tabella di lookup in cui ogni parola mappa a un vettore apprendibile.
self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=padding_idx)Se scegli embedding_dim=32, ogni parola diventa un vettore a 32 dimensioni. Nelle prime fasi di addestramento, questi vettori sono casuali. Man mano che il modello impara, le parole con sentiment simile si avvicinano in questo spazio vettoriale. "Terrible", "awful" e "boring" potrebbero finire vicine, mentre "excellent" e "amazing" si raggruppano altrove.
L’argomento padding_idx indica allo strato di mantenere i token di padding come vettori zero, così da non influenzare il modello.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=num_layers,
	batch_first=True,
	dropout=dropout if num_layers > 1 else 0,
	bidirectional=bidirectional,
)
Questa singola riga crea tutto il macchinario di porte visto nella sezione precedente. Il hidden_size determina quanta informazione possono trasportare stato di cella e stato nascosto. Valori maggiori permettono al modello di tracciare più pattern ma richiedono più calcolo.
Impostare batch_first=True significa che gli input hanno forma (batch, sequence_length, embedding_dim). La LSTM elabora ogni posizione da sinistra a destra, aggiornando i propri stati interni a ogni passo.
Dopo aver elaborato "This movie was absolutely terrible", la LSTM ha visto ogni parola. Il suo stato nascosto finale ha accumulato ciò che il modello ha imparato a estrarre da quella sequenza. Per il sentiment, questo potrebbe codificare qualcosa come "aggettivo fortemente negativo alla fine, che smentisce contenuti neutri precedenti".
def forward(self, x):
	embedded = self.embedding(x)
	lstm_out, (h_n, c_n) = self.lstm(embedded)
	h_final = h_n[-1]
	return self.fc(h_final)
La LSTM restituisce sia output per timestep (lstm_out) sia stati finali (h_n, c_n). Per la classificazione, ci serve solo h_n[-1], lo stato nascosto dopo l’ultimo token. Uno strato lineare mappa poi questo ai punteggi di classe.
Quando "This movie was terrible" entra nel classificatore:
Ogni parola ottiene il suo embedding: quattro vettori di forma (32,)
La LSTM li elabora in sequenza. "This" inizializza qualche stato di cella. "Movie" lo aggiorna leggermente. "Was" è neutro e cambia poco. "Terrible" induce la porta di dimenticanza a cancellare contesto irrilevante e la porta di input a scrivere un forte segnale negativo.
Lo stato nascosto finale cattura il pattern accumulato.
Lo strato lineare mappa questo a due punteggi: uno per positivo, uno per negativo
Il modello non capisce il linguaggio. Impara pattern statistici: certe sequenze di parole correlano con certe etichette.
Qui sotto trovi l’intera classe LSTMClassifier che abbiamo appena creato passo dopo passo:
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from datasets import load_dataset
from collections import Counter
import numpy as np

torch.manual_seed(42)
np.random_seed(42)


class LSTMClassifier(nn.Module):
    def __init__(
        Self,
        Vocab_size,
        Embedding_dim,
        Hidden_size,
        Output_size,
        num_layers=1,
        dropout=0.0,
        bidirectional=False,
        padding_idx=0,
    ):
        super().__init__()
        self.hidden_size = hidden_size
    	self.num_layers = num_layers
    	self.bidirectional = bidirectional

    	self.embedding = nn.Embedding(
	    vocab_size, embedding_dim, padding_idx=padding_idx
        )
    	self.lstm = nn.LSTM(
            input_size=embedding_dim,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,
            dropout=dropout if num_layers > 1 else 0,
            bidirectional=bidirectional,
    	)

    	fc_input_size = hidden_size * 2 if bidirectional else hidden_size
    	self.fc = nn.Linear(fc_input_size, output_size)

    def forward(self, x):
    	embedded = self.embedding(x)
    	lstm_out, (h_n, c_n) = self.lstm(embedded)

    	if self.bidirectional:
            h_final = torch.cat([h_n[-2], h_n[-1]], dim=1)
    	else:
            h_final = h_n[-1]

    	return self.fc(h_final)
L’opzione bidirezionale esegue due LSTM: una da sinistra a destra, una da destra a sinistra. I loro stati nascosti finali vengono concatenati, offrendo al modello contesto da entrambe le direzioni. Questo aiuta quando il significato dipende da ciò che segue, come "not bad", dove "not" ha senso solo dato "bad".
Le LSTM richiedono sequenze di interi, non stringhe. Il preprocessing converte il testo grezzo in tre passaggi:
def build_vocab(texts, max_vocab_size=10000):
	counter = Counter()
	for text in texts:
    		counter.update(text.lower().split())

	vocab = {"<pad>": 0, "<unk>": 1}
	for word, _ in counter.most_common(max_vocab_size - 2):
    		vocab[word] = len(vocab)
	return vocab
Riserviamo l’indice 0 al padding e l’indice 1 alle parole sconosciute. Limitare la dimensione del vocabolario filtra parole rare che non hanno abbastanza esempi per apprendere embedding significativi.
def tokenize_and_pad(texts, vocab, max_length=200):
	sequences = []
	for text in texts:
    		tokens = text.lower().split()
    		ids = [vocab.get(t, vocab["<unk>"]) for t in tokens[:max_length]]
    		ids = ids + [vocab["<pad>"]] * (max_length - len(ids))
    		sequences.append(ids)
	return torch.tensor(sequences, dtype=torch.long)
Troncare a max_length limita quanto indietro la LSTM deve ricordare. Sequenze più lunghe preservano più contesto ma aumentano costi computazionali e di memoria. Per le recensioni di film, 100-200 token di solito catturano i segnali chiave di sentiment.
Il padding garantisce che ogni sequenza abbia la stessa lunghezza, permettendo a PyTorch di batcharle in un singolo tensore. I token di padding diventano vettori zero dopo l’embedding e contribuiscono poco allo stato finale.
def load_imdb_data(max_samples=10000, max_length=200, max_vocab=10000):
	dataset = load_dataset("imdb")

	train_data = dataset["train"].shuffle(seed=42)
	test_data = dataset["test"].shuffle(seed=42)

	train_texts = train_data["text"][:max_samples]
	train_labels = train_data["label"][:max_samples]
	test_texts = test_data["text"][: max_samples // 4]
	test_labels = test_data["label"][: max_samples // 4]

	vocab = build_vocab(train_texts, max_vocab)

	X_train = tokenize_and_pad(train_texts, vocab, max_length)
	X_test = tokenize_and_pad(test_texts, vocab, max_length)
	y_train = torch.tensor(train_labels, dtype=torch.long)
	y_test = torch.tensor(test_labels, dtype=torch.long)

	return X_train, y_train, X_test, y_test, vocab
Costruire il vocabolario solo dai dati di training previene leakage di informazione. Se una parola rara appare solo nelle recensioni di test, il modello dovrebbe trattarla come sconosciuta invece di averne appreso l’embedding in addestramento.
Il loop di training aggiorna i pesi del modello in base a quanto le sue previsioni si discostano dai valori corretti. Per le LSTM, un dettaglio conta più del solito: il clipping del gradiente.
def train_model(model, train_loader, test_loader, n_epochs=5, lr=0.001):
	criterion = nn.CrossEntropyLoss()
	optimizer = torch.optim.Adam(model.parameters(), lr=lr)

	for epoch in range(n_epochs):
    		model.train()
    		total_loss, correct, total = 0, 0, 0

    		for batch_texts, batch_labels in train_loader:
        		optimizer.zero_grad()
        		outputs = model(batch_texts)
        		loss = criterion(outputs, batch_labels)
        		loss.backward()
            		torch.nn.utils.clip_grad_norm_(
	model.parameters(),
	max_norm=5.0)
        		optimizer.step()

        		total_loss += loss.item()
        		_, predicted = outputs.max(1)
        		correct += (predicted == batch_labels).sum().item()
total += batch_labels.size(0)In precedenza abbiamo spiegato come le LSTM mitigano i gradienti che svaniscono tramite aggiornamenti additivi allo stato di cella. Ma i gradienti che esplodono restano un rischio. Quando i gradienti crescono troppo, gli aggiornamenti dei pesi superano il bersaglio e destabilizzano l’addestramento.
clip_grad_norm_ limita la magnitudine totale del gradiente. Se i gradienti superano max_norm=5.0, vengono ridimensionati proporzionalmente. Questo mantiene stabili gli aggiornamenti senza eliminare del tutto il segnale del gradiente.
    	model.eval()
    	test_correct, test_total = 0, 0
    	with torch.no_grad():
        	for batch_texts, batch_labels in test_loader:
            		outputs = model(batch_texts)
            		_, predicted = outputs.max(1)
            		test_correct += (predicted == batch_labels).sum().item()
            		test_total += batch_labels.size(0)

    	test_acc = test_correct / test_total
    	print(f"Epoch {epoch+1}: Loss={total_loss/len(train_loader):.4f}, "
          	f"Train={correct/total:.3f}, Test={test_acc:.3f}")

    return test_acc
model.eval() disabilita il dropout durante la valutazione. torch.no_grad() salta il calcolo dei gradienti dato che non stiamo aggiornando i pesi, risparmiando memoria e velocizzando l’inferenza.
X_train, y_train, X_test, y_test, vocab = load_imdb_data(
	max_samples=10000, max_length=100, max_vocab=5000
)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
test_loader = DataLoader(TensorDataset(X_test, y_test), batch_size=64)

model = LSTMClassifier(
	vocab_size=len(vocab),
	embedding_dim=32,
	hidden_size=32,
	output_size=2,
	padding_idx=vocab["<pad>"],
)

final_acc = train_model(model, train_loader, test_loader, n_epochs=50, lr=0.001)
Questi valori riflettono compromessi:
hidden_size=32: Abbastanza piccolo per iterazioni rapide. I modelli in produzione usano spesso 128-512, ma all’aumentare della dimensione i guadagni diminuiscono e l’addestramento rallenta.
embedding_dim=32: Abbinarlo all’hidden size è comune ma non obbligatorio. Embedding più grandi catturano distinzioni più fini tra parole al costo di più parametri.
max_length=100: La maggior parte dei segnali di sentiment appare all’inizio delle recensioni. Sequenze più lunghe aiutano nei casi sfumati, ma quadruplicano l’uso di memoria raddoppiando il max_length.
batch_size=64: Batch più grandi danno stime del gradiente più stabili. Batch più piccoli possono aiutare a uscire da minimi locali. Tipico 32-128.
lr=0.001: Il default di Adam funziona per la maggior parte dei compiti con LSTM. Se la loss oscilla, prova 0.0001. Se l’apprendimento si blocca, prova 0.01.
n_epochs=50: Sufficiente perché il modello converga. Osserva quando l’accuratezza sul test si appiattisce o cala mentre quella di training continua a crescere: segnala overfitting.
Eseguendo questa configurazione si ottiene un output del tipo:
...
Epoch 46: Loss=0.4126, Train=0.812, Test=0.789
Epoch 47: Loss=0.4054, Train=0.815, Test=0.791
Epoch 48: Loss=0.3998, Train=0.818, Test=0.788
Epoch 49: Loss=0.3921, Train=0.821, Test=0.793
Epoch 50: Loss=0.3867, Train=0.824, Test=0.795
L’accuratezza in training raggiunge circa l’82% mentre quella sul test si stabilizza intorno all’80%. Il modello impara quali pattern di parole predicono il sentiment. Aggettivi forti verso la fine pesano di più. Negazioni come "not" ribaltano la polarità. Alcune frasi ("waste of time", "highly recommend") diventano segnali forti. Nulla di ciò è codificato a mano; emerge dalle correlazioni nei dati di addestramento.
Con una messa a punto minima e un modello piccolo, l’80% di accuratezza è ragionevole. Il piccolo divario tra training e test mostra che il modello generalizza bene senza overfitting grave. Aggiungere dropout, usare embedding pretrained come GloVe o addestrare su più dati può spingere l’accuratezza verso l’alta 80.
L’architettura LSTM di base delle sezioni precedenti funziona, ma diverse tecniche possono aumentare l’accuratezza senza passare a una famiglia di modelli diversa. Questi approcci sono stati convalidati in migliaia di deployment in produzione e paper di ricerca.
Le LSTM standard elaborano le sequenze da sinistra a destra, costruendo contesto solo dai token passati. Le LSTM bidirezionali (BiLSTM) eseguono due passaggi paralleli: uno in avanti e uno all’indietro. La rappresentazione finale a ogni timestep combina ciò che è venuto prima e ciò che viene dopo.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	bidirectional=True,  # Run both directions
	batch_first=True,
)
# Output size doubles: hidden_size * 2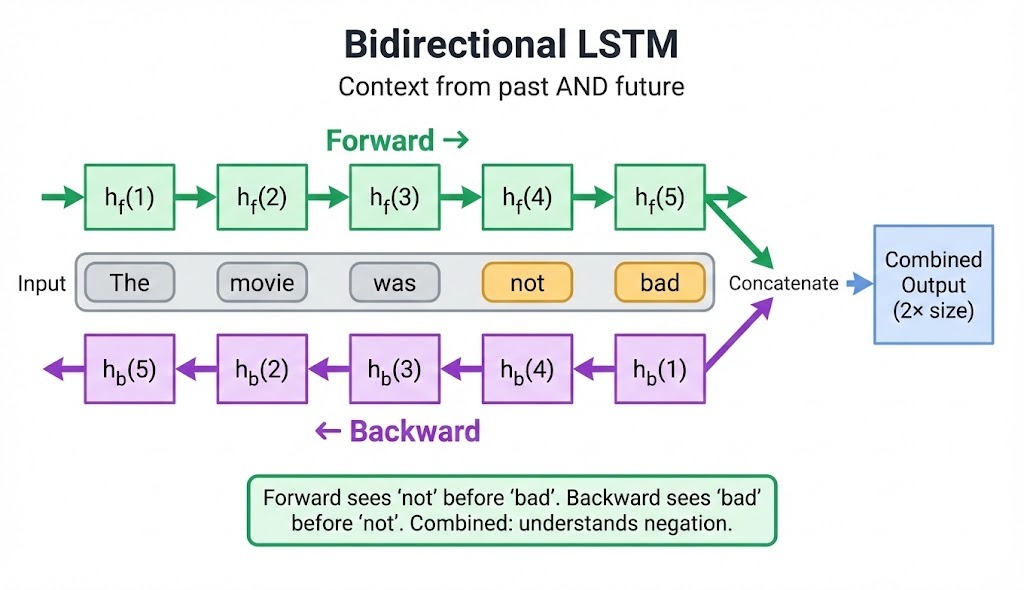
Per la sentiment analysis, questo conta quando la negazione appare dopo la parola che modifica: "the movie was not bad" necessita del contesto in avanti per sapere che esiste "bad", e del contesto all’indietro per sapere che "not" lo precede.
Le BiLSTM superano costantemente i modelli unidirezionali in named entity recognition (NER), classificazione del sentiment e riconoscimento vocale, con guadagni tipici del 5-15%.
Il compromesso: serve l’intera sequenza in fase di inferenza. Le applicazioni in streaming che ricevono i token uno alla volta non possono usare l’elaborazione bidirezionale.
L’attenzione permette al modello di pesare quali timestep contano di più per una data previsione. Invece di comprimere un’intera sequenza in un singolo stato nascosto finale, l’attenzione calcola una combinazione pesata di tutti gli stati nascosti.
class AttentionLayer(nn.Module):
	def __init__(self, hidden_size):
    		super().__init__()
    		self.attention = nn.Linear(hidden_size, 1)

	def forward(self, lstm_outputs):
    	# lstm_outputs: (batch, seq_len, hidden_size)
    		scores = self.attention(lstm_outputs)  # (batch, seq_len, 1)
    		weights = torch.softmax(scores, dim=1)
    		context = torch.sum(weights * lstm_outputs, dim=1)
    		return context
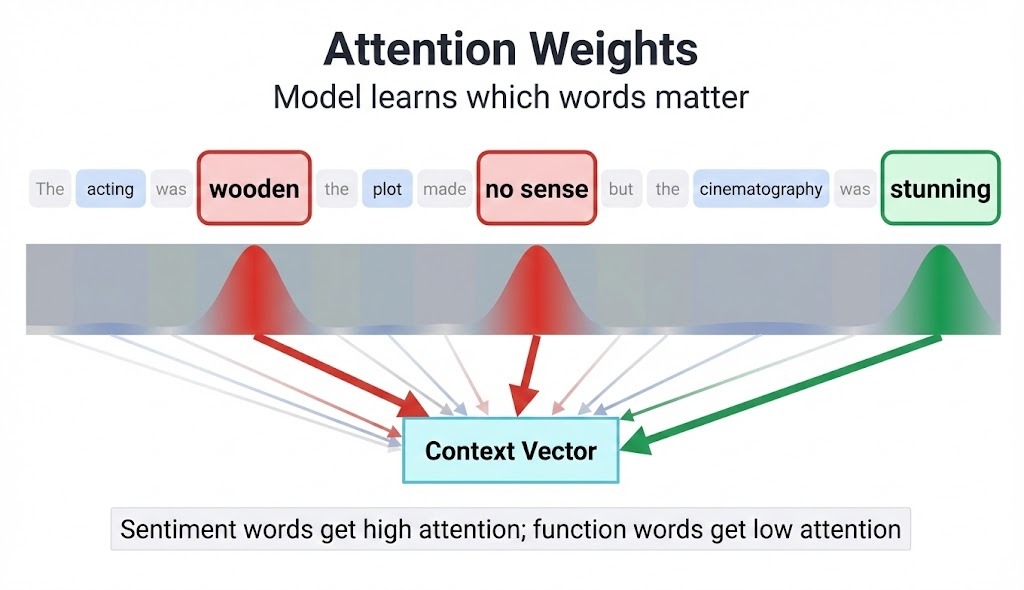
In una recensione come "The acting was wooden, the plot made no sense, but the cinematography was stunning", l’attenzione impara a concentrarsi sulle frasi che veicolano il sentiment anziché trattare tutte le parole allo stesso modo. Il modello assegna pesi più alti a "wooden", "no sense" e "stunning" riducendo il peso di "the" e "was".
L’attenzione aggiunge un sovraccarico computazionale minimo e spesso porta a miglioramenti del 2-5% nell’accuratezza sui task di classificazione. Per i problemi sequence-to-sequence come la traduzione, l’attenzione tra encoder e decoder è quasi obbligatoria per buone prestazioni.
Un singolo strato LSTM cattura pattern a un livello di astrazione. Impilare più strati permette alla rete di imparare caratteristiche gerarchiche: il primo strato può rilevare pattern di frasi locali, mentre gli strati superiori li combinano in una comprensione a livello di documento.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=3,  # Stack three layers
	dropout=0.3,   # Dropout between layers (not within)
	batch_first=True,
)
Linee guida per la profondità:
Ogni strato aggiuntivo raddoppia circa il tempo di training. Parti da poco profondo e aggiungi profondità solo se le metriche di validazione si appiattiscono.
Le LSTM vanno facilmente in overfitting, soprattutto su dataset piccoli. Tre tecniche di regolarizzazione funzionano bene insieme:
Il dropout azzera in modo casuale neuroni durante l’addestramento, costringendo la rete a distribuire l’apprendimento su più percorsi. Applica il dropout tra gli strati LSTM, non all’interno delle connessioni ricorrenti (che possono disturbare l’apprendimento temporale).
# PyTorch applica dropout tra strati impilati automaticamente
self.lstm = nn.LSTM(..., num_layers=2, dropout=0.3)

# Per LSTM a singolo strato, aggiungi dropout dopo
self.dropout = nn.Dropout(0.3)
Tassi di dropout tra 0,2 e 0,5 funzionano per la maggior parte dei task. Valori più alti aiutano con overfitting severo ma rallentano la convergenza.
Il clipping del gradiente limita le magnitudini dei gradienti durante la backpropagation. Sebbene le LSTM mitighino i gradienti che svaniscono, quelli che esplodono possono ancora verificarsi, soprattutto con sequenze lunghe o reti profonde.
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)Valori tra 1,0 e 5,0 sono tipici. Se la training loss schizza o produce valori NaN, abbassa la soglia.
L’early stopping monitora la loss di validazione e interrompe l’addestramento quando smette di migliorare. Previene che il modello memorizzi i dati di training a scapito della generalizzazione.
patience = 5
best_val_loss = float('inf')
epochs_without_improvement = 0

for epoch in range(max_epochs):
	train_loss = train_one_epoch(model, train_loader)
	val_loss = evaluate(model, val_loader)

	if val_loss < best_val_loss:
    		best_val_loss = val_loss
    		epochs_without_improvement = 0
    		torch.save(model.state_dict(), 'best_model.pt')
	else:
    		epochs_without_improvement += 1
	if epochs_without_improvement >= patience:
        	break
Per una guida completa su loop di training, metriche di valutazione e debug dei problemi comuni nelle LSTM, vedi la guida NLP con PyTorch.
L’inizializzazione casuale degli embedding funziona, ma embedding pretrained come GloVe o Word2Vec danno al modello un vantaggio iniziale. Questi embedding codificano relazioni semantiche apprese da miliardi di parole: "king" e "queen" finiscono vicini, così come "terrible" e "awful".
import numpy as np

def load_glove_embeddings(glove_path, vocab, embedding_dim):
	embeddings = np.random.randn(len(vocab), embedding_dim) * 0.01

	with open(glove_path, 'r') as f:
    	for line in f:
        	parts = line.split()
        	word = parts[0]
        	if word in vocab:
            		embeddings[vocab[word]] = np.array(parts[1:], dtype=np.float32)

	return torch.tensor(embeddings, dtype=torch.float32)

# Load and freeze or fine-tune
pretrained = load_glove_embeddings('glove.6B.100d.txt', vocab, 100)
model.embedding.weight.data.copy_(pretrained)
model.embedding.weight.requires_grad = True  # Fine-tune during training
Gli embedding pretrained aiutano soprattutto quando i dati di training sono limitati. Con milioni di esempi, embedding inizializzati casualmente alla fine recuperano. Per la maggior parte delle applicazioni pratiche con 10k-100k campioni, aspettati guadagni di accuratezza del 3-8% dall’inizializzazione pretrained.
Questi approcci si combinano. Un classificatore di testo di livello produttivo potrebbe usare:
Ogni aggiunta aumenta complessità e tempo di training. Parti da una LSTM a singolo strato come baseline, misura le prestazioni, poi aggiungi le tecniche una alla volta per vedere cosa porta benefici sul tuo task specifico.
Le LSTM hanno dominato la modellazione di sequenze dalla fine degli anni ’90 alla metà degli anni 2010. Il paper del 2017 "Attention Is All You Need" ha cambiato le cose. I Transformer oggi alimentano la maggior parte dei grandi modelli linguistici, ma le LSTM non sono scomparse. Coprono nicchie diverse.
Le sezioni precedenti hanno mostrato come le LSTM elaborano le sequenze un token alla volta e perché quel meccanismo di gating funziona. Su larga scala, questa dipendenza sequenziale diventa un collo di bottiglia. La tua GPU può avere migliaia di core, ma la maggior parte resta inattiva mentre la catena degli stati nascosti termina. Un input da 500 token significa 500 operazioni in fila.
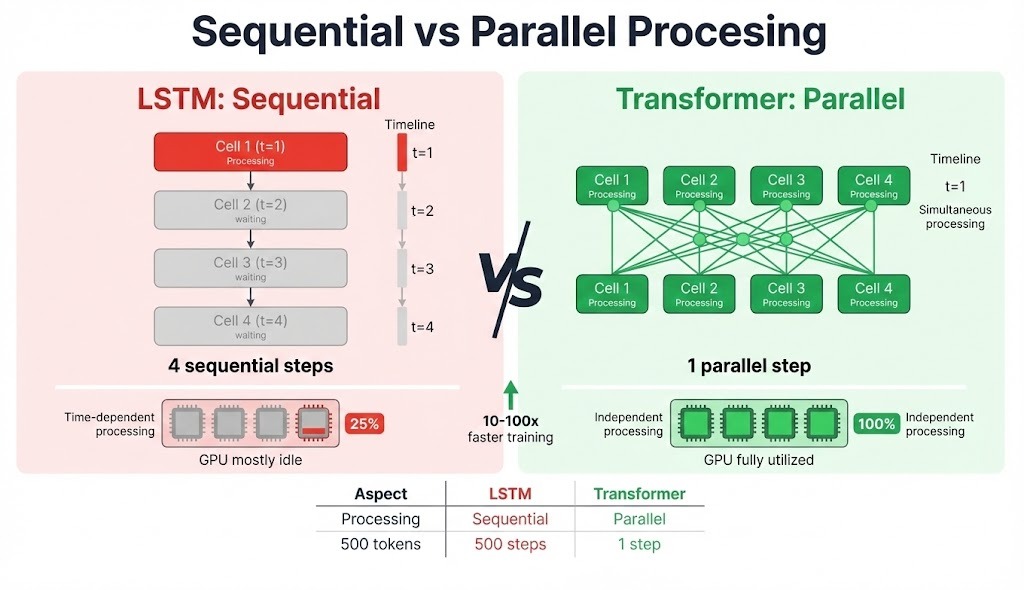
I Transformer non hanno questo vincolo. La self-attention calcola le relazioni tra tutte le posizioni simultaneamente, quindi la stessa sequenza da 500 token viene elaborata in parallelo. Su hardware moderno con batch grandi, ciò si traduce in accelerazioni di training di 10-100x.
Conta anche il tetto sulla lunghezza della sequenza. Abbiamo visto come le LSTM preservano i gradienti meglio delle RNN vanilla, ma "meglio" non significa "perfetto". Le prestazioni calano comunque intorno ai 200-500 token, a seconda del task.
I Transformer calcolano l’attenzione tra ogni coppia di posizioni direttamente, quindi il token 1 presta attenzione al token 1000 con la stessa facilità. Il compromesso è la memoria: le matrici di attenzione crescono quadraticamente con la lunghezza della sequenza.
Le attivazioni delle porte rendono difficile anche l’interpretazione. I valori vanno da 0 a 1 senza confini netti. I pesi di attenzione nei Transformer non sono spiegazioni perfette, ma danno un segnale più chiaro su quali token di input sono contati per ciascun output.
I Transformer hanno senso quando:
Le LSTM sono ancora adatte quando:
Il forecasting di serie temporali si colloca a metà strada. Benchmark recenti mostrano che entrambe le architetture performano in modo simile su dati univariati, con pattern consistenti. I Transformer prevalgono quando più feature interagiscono in modo complesso, ma le LSTM tengono quando i dati sono scarsi o il compute è limitato.
Progetti ibridi fondono i due approcci. Alcune architetture impilano strati LSTM con meccanismi di attenzione. xLSTM, pubblicato nel 2024, rivede il design originale con gating esponenziale e memoria a matrice, mostrando risultati competitivi con i Transformer su piccola scala.
|
Aspetto |
LSTM |
Transformer |
|
Elaborazione |
Sequenziale (token per token) |
Parallela (tutte le posizioni insieme) |
|
Velocità di training |
Più lenta (parallelizzazione limitata) |
Più veloce su GPU |
|
Dipendenze a lungo raggio |
Degradano oltre 200-500 token |
Gestisce migliaia di token |
|
Scalabilità della memoria |
O(n) con la lunghezza della sequenza |
O(n²) per le matrici di attenzione |
|
Prestazioni con pochi dati |
Buone (meno parametri) |
Incline all’overfitting |
|
Deployment su edge |
Adatto (impronta di memoria minore) |
Sfida (modelli grandi) |
|
Streaming/real-time |
Supporto nativo |
Richiede sequenza completa |
|
Ecosistema pretrained |
Limitato |
Esteso (BERT, GPT, ecc.) |
La decisione di solito dipende dai vincoli. Compute e dati illimitati? I Transformer vincono sulla maggior parte dei task NLP. Un microcontrollore con 10K esempi di training? Le LSTM restano pratiche.
Le LSTM hanno risolto un problema reale quando sono arrivate nel 1997. Il meccanismo di gating introdotto da Hochreiter e Schmidhuber ha permesso alle reti di imparare finalmente da sequenze più lunghe di poche decine di token. Quell’architettura ha alimentato traduzione automatica, riconoscimento vocale e forecasting di serie temporali per quasi due decenni.
Oggi i Transformer gestiscono la maggior parte dei task NLP su larga scala, ma le LSTM non sono diventate obsolete. Hanno ancora senso per il deployment su edge, applicazioni in streaming e situazioni con dati di training limitati.
Se stai iniziando un nuovo progetto di modellazione di sequenze, prova prima una semplice LSTM. Misura le sue prestazioni, capisci dove fallisce, poi decidi se il problema richiede davvero un Transformer. I concetti di questa guida (gating, stato di cella, flusso del gradiente) si trasferiscono direttamente alla comprensione di architetture più complesse.
Per fare pratica, ti consiglio il nostro corso Recurrent Neural Networks, che illustra ulteriori applicazioni LSTM con esercizi guidati.
Corsi di Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



