
Cours
Réseaux de neurones récurrents (RNN) pour la modélisation du langage avec Keras
4 h
16.4K
Les réseaux de neurones récurrents standards ont du mal avec la mémoire. Quand les séquencess dépassent 20 à 30 pas de temps, les gradients rétrécissent vers zéro ou explosent lors de la rétropropagation, et le réseau perd sa capacité à relier des parties éloignées de l’entrée. Hochreiter et Schmidhuber ont attaqué ce problème dans leur article de 1997 en introduisant les réseaux Long Short-Term Memory.
Dans ce guide, nous allons détailler l’intérieur des LSTM avant de passer à une implémentation pratique en Python. Les dernières sections comparent les LSTM aux Transformers afin que vous puissiez choisir l’architecture adaptée à votre cas d’usage.
Nous vous recommandons vivement notre cours Introduction to Deep Learning in PyTorch pour vous exercer concrètement à l’utilisation de PyTorch pour entraîner des réseaux de neurones, qui constituent la base des modèles LSTM.
LSTM signifie Long Short-Term Memory, un type de réseau de neurones récurrent (RNN) conçu pour traiter des séquences où le contexte lointain dans l’entrée reste pertinent.
L’idée clé derrière les LSTM est un mécanisme de portes qui régule le flux d’information dans le réseau. Plutôt que de laisser tous les signaux passer de la même manière, les portes apprennent quand conserver le contexte et quand le relâcher.
Cette mémoire sélective permet aux LSTM de suivre des dépendances sur des centaines de pas de temps, ce qui s’est avéré utile pour la modélisation de langue, la reconnaissance vocale et la prévision de séries temporelles. Pour comprendre pourquoi cette architecture existe, il est utile de voir ce qui casse dans les RNN standards.
Les réseaux récurrents font passer l’information d’un pas de temps au suivant via un état caché. À chaque pas, cet état est multiplié par des poids appris, mis à jour, puis transmis. L’entraînement nécessite de renvoyer les signaux d’erreur à travers toutes ces étapes, et chaque passage en arrière réduit un peu le signal. Après assez d’étapes, il ne reste presque rien.
C’est comme faire une photocopie d’une photocopie. Quelques fois, la copie reste lisible. Cinquante fois, vous ne distinguez plus le texte. Les RNN atteignent ce mur autour de 20 à 30 pas de temps, d’où leurs difficultés avec les longues séquences.
Les LSTM ajoutent une piste de mémoire distincte, appelée état de cellule, qui fonctionne en parallèle de l’état caché standard. La différence est structurelle : l’information dans l’état de cellule circule via des additions plutôt que des multiplications répétées, elle ne se dégrade donc pas de la même manière.
Pour contrôler ce qui entre et sort de cette mémoire, les LSTM utilisent des portes. Chaque porte est un petit réseau de neurones qui apprend à produire des valeurs entre 0 et 1, agissant comme un filtre. Une valeur proche de 0 bloque l’information ; une valeur proche de 1 la laisse passer. Le réseau apprend pendant l’entraînement quels motifs valent la peine d’être mémorisés sur de longues séquences et lesquels peuvent être éliminés.
Ce mécanisme de portes distingue les LSTM des RNN classiques. Au lieu de forcer toute l’information à suivre le même chemin, les LSTM peuvent préserver sélectivement le contexte sur des centaines de pas de temps. La prochaine section détaille précisément le fonctionnement de ces portes et la manière dont elles se combinent pour mettre à jour l’état de cellule.
On retrouve les LSTM partout où les données séquentielles comptent. Quelques exemples au-delà des applications NLP et de prévision habituelles :
Cette section couvre en détail l’intérieur d’un LSTM. Si vous préférez passer directement à l’implémentation, allez à la section suivante. Les détails d’architecture ne sont pas indispensables pour utiliser des LSTM, mais ils aident au débogage et au réglage.
Pour comprendre le fonctionnement, suivons un exemple concret : traiter la séquence « The clouds are dark... » pour prédire le mot suivant. Chaque composant est plus clair lorsqu’on voit son effet sur des données réelles.
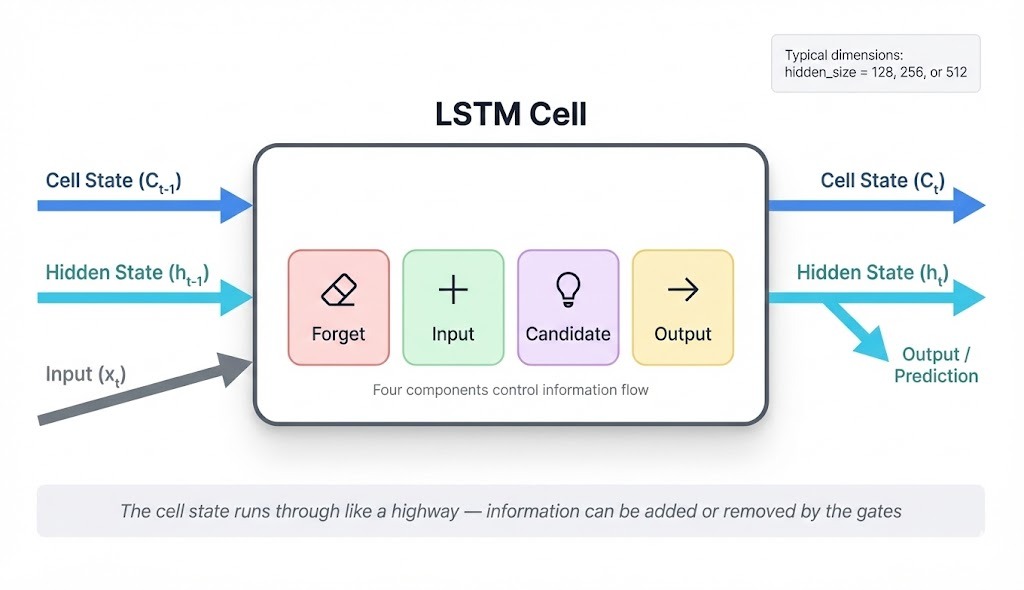
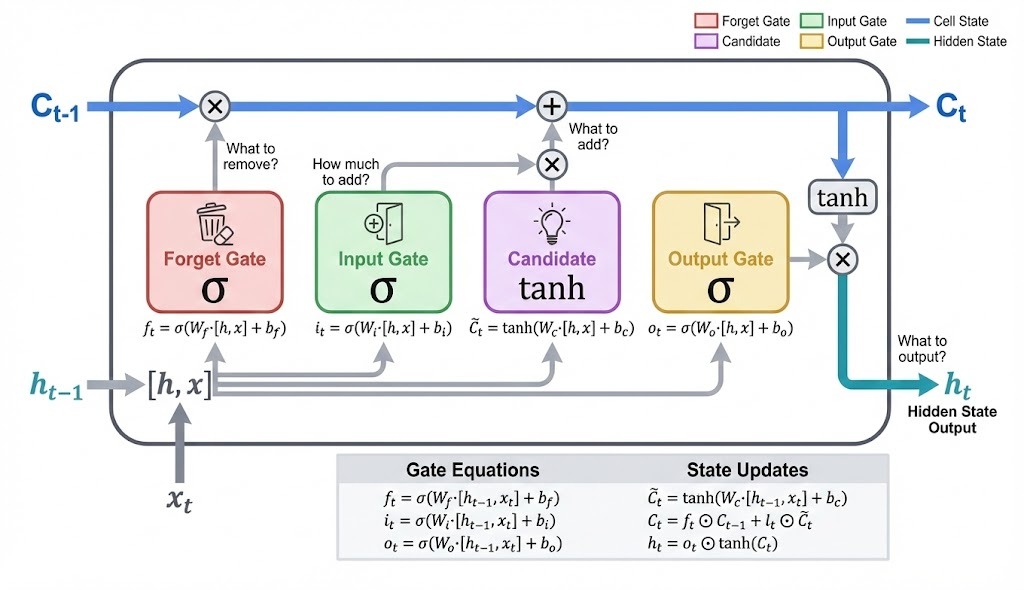
Un LSTM maintient deux vecteurs distincts qui circulent dans le réseau : l’état de cellule et l’état caché.
L’état de cellule sert de stockage à long terme. Il transporte l’information d’un pas de temps à l’autre, avec des modifications contrôlées à chaque étape. Dans notre séquence, il pourrait stocker « un nom lié à la météo est apparu » après « clouds » et préserver ce contexte à travers « are », jusqu’à ce que « dark » renforce le motif.
L’état caché est la sortie de la cellule à chaque pas de temps. Il alimente les prédictions et les calculs du pas suivant. Après « dark », l’état caché encode quelque chose comme « adjectif décrivant des conditions météo » utilisable par une couche de prédiction.
Pourquoi deux pistes séparées ? Un seul état devrait simultanément conserver un contexte de long terme et produire des sorties utiles. Ces objectifs sont en tension : une mémoire stable nécessite peu de changements, alors que des sorties utiles exigent des transformations. Les séparer permet à chaque piste d’optimiser son rôle.
À chaque pas de temps, la cellule prend trois entrées et produit deux sorties :
Entrées :
État de cellule précédent (C_{t-1}) : ce que le réseau a retenu jusqu’ici
État caché précédent (h_{t-1}) : la sortie du dernier pas de temps
Entrée courante (x_t) : le nouveau jeton, comme « clouds » ou « dark »
Sorties :
Nouvel état de cellule (C_t) : la mémoire après traitement de ce jeton
Nouvel état caché (h_t) : la sortie de ce pas de temps
Quatre composants contrôlent ce qui se passe dans la cellule. Trois sont des portes qui produisent des valeurs entre 0 et 1, agissant comme des filtres. Le quatrième est le candidat, qui propose du contenu nouveau.
Quand « are » arrive après « clouds », chaque composant a un rôle :
Porte d’oubli (f_t) : doit-on garder le contexte « clouds » ? Les noms liés à la météo suivis d’un verbe copule sont souvent importants ; la porte d’oubli produit donc des valeurs proches de 1 pour préserver la majeure partie de l’état de cellule.
Porte d’entrée (i_t) : quelle place « are » doit-il prendre en mémoire ? Les verbes copules portent moins de signal prédictif ; la porte d’entrée renvoie des valeurs plus faibles.
Candidat (C̃_t) : quelle nouvelle information « are » pourrait-il apporter ? Le candidat propose du contenu, mais la porte d’entrée l’atténue.
Porte de sortie (o_t) : que doit refléter l’état caché ? La porte de sortie filtre l’état de cellule pour produire h_t.
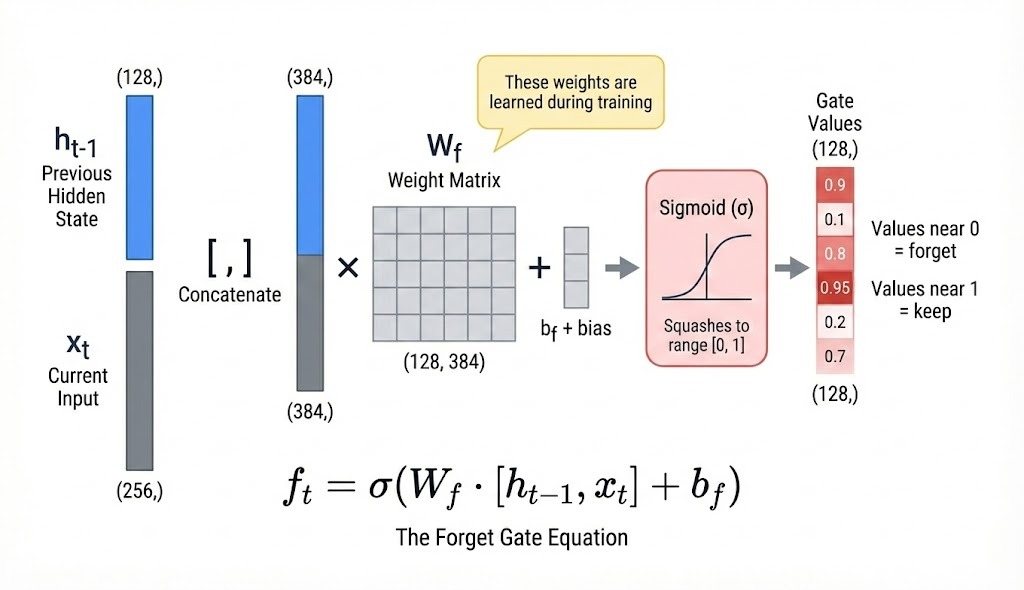
Chaque composant calcule sa sortie de la même manière :
Concaténez h_{t-1} et x_t en un seul vecteur
Multipliez par une matrice de poids apprise
Ajoutez un biais
Appliquez une fonction d’activation
Les portes utilisent l’activation sigmoïde, qui comprime les valeurs dans l’intervalle 0-1. Le candidat utilise tanh, qui renvoie des valeurs entre -1 et 1, afin de proposer des hausses comme des baisses de l’état de cellule.
Porte d’oubli (sigmoïde → 0 à 1) :
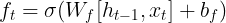
Porte d’entrée (sigmoïde → 0 à 1) :
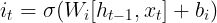
Porte de sortie (sigmoïde → 0 à 1) :
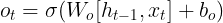
Candidat (tanh → -1 à +1) :
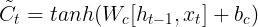
Chaque composant possède sa propre matrice de poids (W_f, W_i, W_c, W_o), afin d’apprendre à répondre à différents motifs d’entrée.
Les sorties des portes se multiplient élément par élément avec les vecteurs (multiplication positionnelle, notée ⊙). Chaque dimension est filtrée indépendamment.
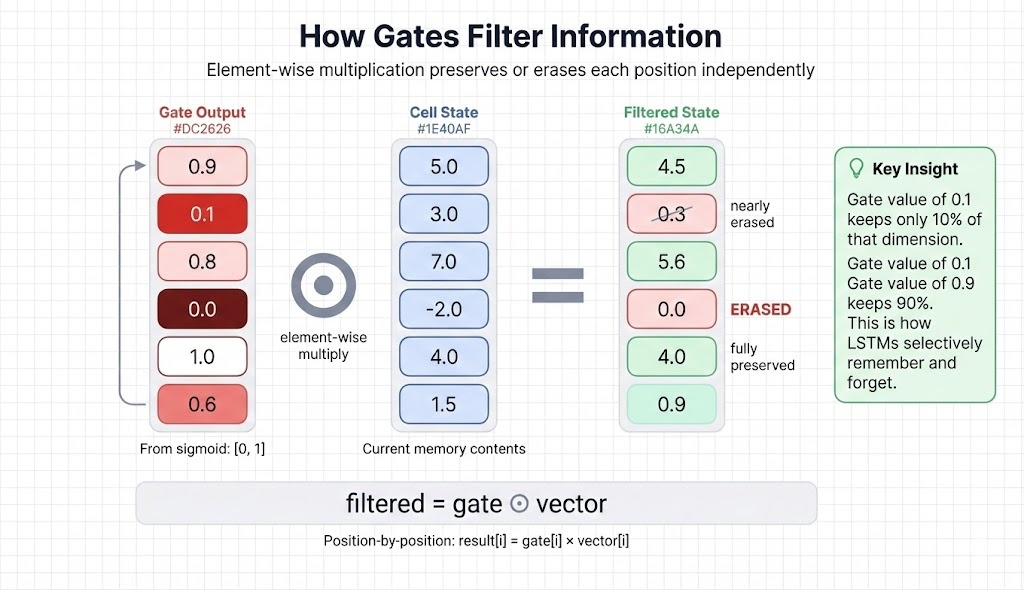
Si une porte renvoie 0,9 pour la position 1, cette dimension conserve 90 % de sa valeur. Si elle renvoie 0,0 pour la position 4, cette dimension est effacée. En traitant « dark » après « clouds are », la porte d’oubli peut produire des valeurs élevées pour les dimensions qui stockent le contexte nom/météo et des valeurs plus faibles pour des dimensions portant un contexte antérieur non pertinent.
Les composants se combinent en trois étapes pour mettre à jour l’état de cellule et produire l’état caché.
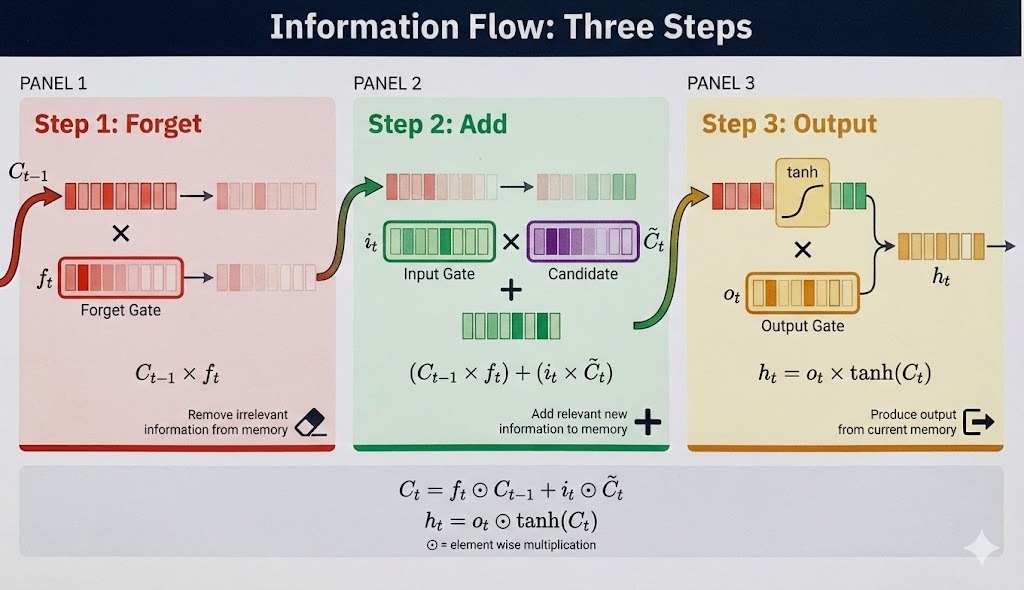
La porte d’oubli filtre l’état de cellule précédent : 
En traitant « dark », la porte d’oubli préserve le contexte météo de « clouds » tout en effaçant des dimensions qui suivaient l’article « The ».
La porte d’entrée met à l’échelle la proposition du candidat, puis l’ajoute à l’état de cellule filtré :
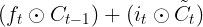
Le candidat peut proposer « adjectif modifiant un nom lié à la météo » et la porte d’entrée décide de la force d’écriture en mémoire. Cette mise à jour additive (et non multiplicative) facilite le flux de gradient pendant l’entraînement.
L’état de cellule passe par tanh, puis la porte de sortie filtre ce qui devient l’état caché :
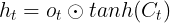
La tanh maintient des valeurs bornées. La porte de sortie sélectionne les aspects de la mémoire accumulée à rendre visibles pour les prédictions à ce pas de temps.
La séquence complète :
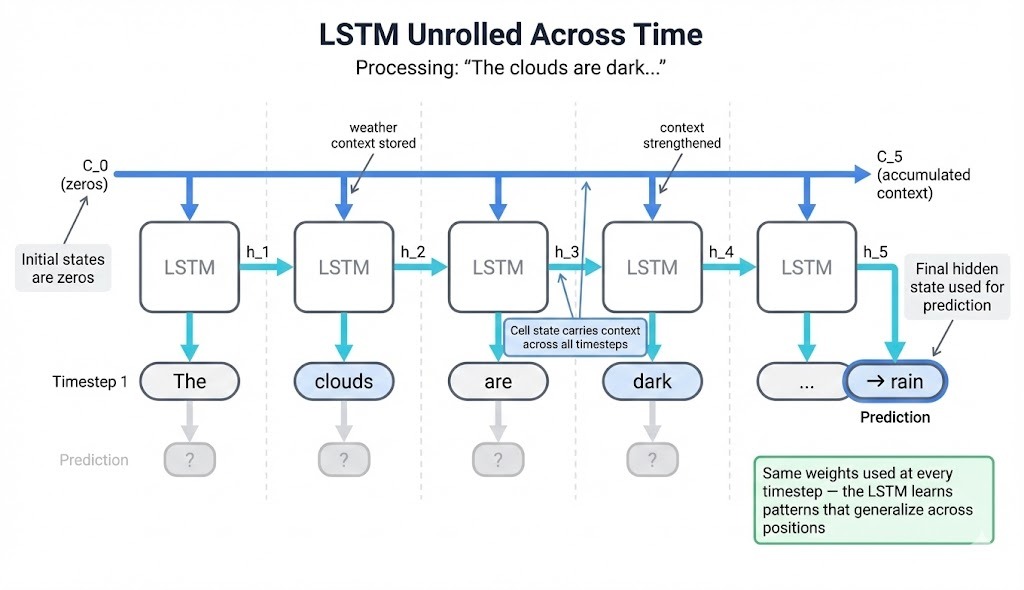
Voici une trace simplifiée avec un état de cellule de 4 dimensions :
|
Étape |
Entrée |
État de cellule (simplifié) |
Ce qui se passe |
|
1 |
"The" |
[0.1, 0.0, 0.2, 0.0] |
Stockage minimal ; les articles portent peu de signal prédictif |
|
2 |
"clouds" |
[0.1, 0.7, 0.2, 0.3] |
La porte d’entrée s’ouvre pour les dimensions 2 et 4 ; stockage du motif « nom » |
|
3 |
"are" |
[0.1, 0.6, 0.2, 0.3] |
Porte d’oubli ≈ 0,9 préserve le contexte ; le verbe copule ajoute peu |
|
4 |
"dark" |
[0.1, 0.8, 0.5, 0.6] |
L’adjectif renforce le signal dans les dimensions 2, 3 et 4 |
Au quatrième pas de temps, les dimensions 2 à 4 ont accumulé un motif. L’état caché h_4 alimente une couche de prédiction (hors LSTM) qui produit des probabilités sur le vocabulaire. Ce motif accumulé aide le modèle à privilégier des mots comme « rain » ou « sky ».
Le réseau ne « comprend » pas la météo. Il apprend des corrélations statistiques : certaines séquences d’entrée précèdent souvent certaines sorties.
La structure additive de l’état de cellule fournit une voie de gradient plus directe que les RNN standards. Si vous n’êtes pas familier avec la propagation des gradients dans les réseaux de neurones, le tutoriel sur la rétropropagation couvre les fondamentaux.
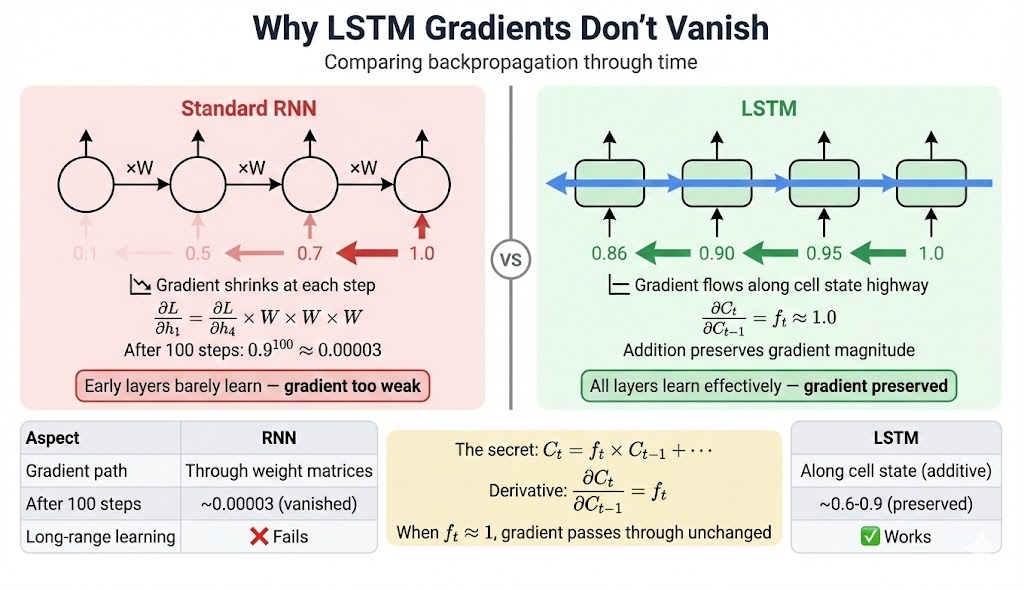
Dans les RNN standards, les gradients traversent des matrices de poids à chaque pas. Les multiplications répétées s’accumulent : après 100 pas avec des poids moyens à 0,9, le gradient rétrécit à 0.9^100 ≈ 0.00003.
Les LSTM offrent une voie alternative le long de l’état de cellule. La dérivée de C_t par rapport à C_{t-1} :
∂C_t/∂C_{t-1} = f_tC’est la valeur de la porte d’oubli, pas une matrice de poids. Quand les portes d’oubli restent proches de 1, les gradients passent avec moins d’atténuation. Si les portes tournent en moyenne à 0,95, après 100 pas : 0.95^100 ≈ 0.006. Toujours réduit, mais exploitable.
|
Aspect |
RNN |
LSTM |
|
Voie du gradient |
Matrices de poids uniquement |
Voie supplémentaire via l’état de cellule |
|
Gradient à 100 pas |
~10^-5 (évanoui) |
~10^-2 à 10^-1 (utilisable) |
|
Mémoire pratique |
~10-20 pas de temps |
~50-200 pas de temps |
Remarque pratique : les biais des portes d’oubli sont souvent initialisés à 1,0 ou plus, poussant les sorties initiales vers « tout mémoriser ». Cela aide le réseau à apprendre des motifs de long terme tôt dans l’entraînement.
Les LSTM atténuent le problème du gradient qui s’évanouit, sans l’éliminer. Le gain vient de la mise à jour additive de l’état de cellule, qui offre une autoroute de gradient en parallèle des voies standard.
La section précédente a couvert ce qui se passe dans une cellule LSTM : des portes qui filtrent, un état de cellule qui préserve le contexte, et un état caché qui produit des sorties. Voyons maintenant comment nn.LSTM de PyTorch encapsule tout cela dans un module unique pour classer des critiques de films en positives ou négatives.
Astuce pour exécuter le code : entraîner 50 époques sur CPU est long. Utilisez Google Colab ou Kaggle Notebooks avec accélération GPU pour aller plus vite. Le script complet est disponible en GitHub Gist.
La classification de texte avec des LSTM suit un schéma : convertir les mots en vecteurs, laisser le LSTM les traiter séquentiellement, puis utiliser la sortie finale pour prédire.
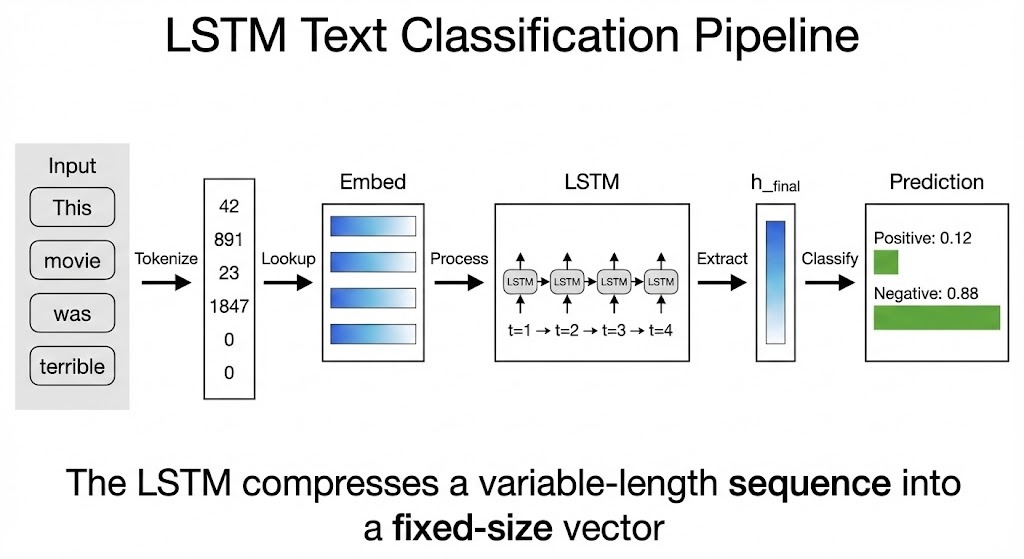
Les réseaux de neurones opèrent sur des nombres continus, alors que les mots sont des symboles discrets. On ne peut pas envoyer « terrible » directement dans une multiplication matricielle. La solution est une couche d’embedding : une table de correspondance où chaque mot est associé à un vecteur apprenable.
self.embedding = nn.Embedding(vocab_size, embedding_dim, padding_idx=padding_idx)Si vous choisissez embedding_dim=32, chaque mot devient un vecteur à 32 dimensions. Au début de l’entraînement, ces vecteurs sont aléatoires. À mesure que le modèle apprend, les mots de sentiment similaire se rapprochent dans cet espace. « Terrible », « awful » et « boring » finissent proches, tandis que « excellent » et « amazing » forment un autre groupe.
L’argument padding_idx indique à la couche de garder les jetons de padding à des vecteurs nuls, pour qu’ils n’influencent pas le modèle.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=num_layers,
	batch_first=True,
	dropout=dropout if num_layers > 1 else 0,
	bidirectional=bidirectional,
)
Cette seule ligne crée toute la machinerie de portes décrite plus haut. Le hidden_size détermine la quantité d’information que l’état de cellule et l’état caché peuvent porter. Plus il est grand, plus le modèle peut suivre de motifs, au prix d’un calcul accru.
Paramétrer batch_first=True signifie que les entrées ont la forme (batch, sequence_length, embedding_dim). Le LSTM parcourt chaque position de gauche à droite en mettant à jour ses états internes à chaque pas.
Après avoir traité « This movie was absolutely terrible », le LSTM a vu chaque mot. Son état caché final a accumulé ce que le modèle a appris à extraire de la séquence. Pour le sentiment, cela peut encoder quelque chose comme « adjectif fortement négatif en fin de phrase, annulant un contenu neutre précédent ».
def forward(self, x):
	embedded = self.embedding(x)
	lstm_out, (h_n, c_n) = self.lstm(embedded)
	h_final = h_n[-1]
	return self.fc(h_final)
Le LSTM renvoie des sorties par pas de temps (lstm_out) et des états finaux (h_n, c_n). Pour une classification, seul h_n[-1] est nécessaire : l’état caché après le dernier jeton. Une couche linéaire le projette ensuite en scores de classes.
Quand « This movie was terrible » entre dans le classificateur :
Chaque mot reçoit son embedding : quatre vecteurs de forme (32,)
Le LSTM les traite séquentiellement. « This » initialise un état de cellule. « Movie » le met légèrement à jour. « Was » est neutre et change peu. « Terrible » déclenche la porte d’oubli pour effacer le contexte hors sujet et la porte d’entrée pour écrire un signal fortement négatif.
L’état caché final capture le motif accumulé.
La couche linéaire le mappe en deux scores : positif et négatif
Le modèle ne comprend pas la langue ; il apprend des motifs statistiques : certaines séquences de mots corrèlent avec certaines étiquettes.
Ci-dessous, la classe LSTMClassifier complète que nous venons de construire pas à pas :
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from datasets import load_dataset
from collections import Counter
import numpy as np

torch.manual_seed(42)
np.random.seed(42)


class LSTMClassifier(nn.Module):
    def __init__(
        Self,
        Vocab_size,
        Embedding_dim,
        Hidden_size,
        Output_size,
        num_layers=1,
        dropout=0.0,
        bidirectional=False,
        padding_idx=0,
    ):
        super().__init__()
        self.hidden_size = hidden_size
    	self.num_layers = num_layers
    	self.bidirectional = bidirectional

    	self.embedding = nn.Embedding(
	    vocab_size, embedding_dim, padding_idx=padding_idx
        )
    	self.lstm = nn.LSTM(
            input_size=embedding_dim,
            hidden_size=hidden_size,
            num_layers=num_layers,
            batch_first=True,
            dropout=dropout if num_layers > 1 else 0,
            bidirectional=bidirectional,
    	)

    	fc_input_size = hidden_size * 2 if bidirectional else hidden_size
    	self.fc = nn.Linear(fc_input_size, output_size)

    def forward(self, x):
    	embedded = self.embedding(x)
    	lstm_out, (h_n, c_n) = self.lstm(embedded)

    	if self.bidirectional:
            h_final = torch.cat([h_n[-2], h_n[-1]], dim=1)
    	else:
            h_final = h_n[-1]

    	return self.fc(h_final)
L’option bidirectionnelle exécute deux LSTM : un de gauche à droite, un de droite à gauche. Leurs états cachés finaux sont concaténés, offrant au modèle du contexte dans les deux sens. C’est utile lorsque le sens dépend de ce qui suit, comme « not bad », où « not » ne prend sens qu’avec « bad ».
Les LSTM attendent des séquences d’entiers, pas des chaînes. Le prétraitement convertit le texte brut en trois étapes :
def build_vocab(texts, max_vocab_size=10000):
	counter = Counter()
	for text in texts:
    		counter.update(text.lower().split())

	vocab = {"<pad>": 0, "<unk>": 1}
	for word, _ in counter.most_common(max_vocab_size - 2):
    		vocab[word] = len(vocab)
	return vocab
Nous réservons l’indice 0 pour le padding et l’indice 1 pour les mots inconnus. Limiter la taille du vocabulaire filtre les mots rares qui manquent d’exemples pour apprendre des embeddings pertinents.
def tokenize_and_pad(texts, vocab, max_length=200):
	sequences = []
	for text in texts:
    		tokens = text.lower().split()
    		ids = [vocab.get(t, vocab["<unk>"]) for t in tokens[:max_length]]
    		ids = ids + [vocab["<pad>"]] * (max_length - len(ids))
    		sequences.append(ids)
	return torch.tensor(sequences, dtype=torch.long)
Tronquer à max_length limite la profondeur de mémoire requise. Des séquences plus longues préservent plus de contexte mais augmentent fortement le calcul et la mémoire. Pour des critiques de films, 100 à 200 jetons capturent généralement l’essentiel du signal de sentiment.
Le padding garantit une longueur identique pour toutes les séquences, permettant à PyTorch de les regrouper en un tenseur unique. Après embedding, les jetons de padding deviennent des vecteurs nuls et influencent peu l’état final.
def load_imdb_data(max_samples=10000, max_length=200, max_vocab=10000):
	dataset = load_dataset("imdb")

	train_data = dataset["train"].shuffle(seed=42)
	test_data = dataset["test"].shuffle(seed=42)

	train_texts = train_data["text"][:max_samples]
	train_labels = train_data["label"][:max_samples]
	test_texts = test_data["text"][: max_samples // 4]
	test_labels = test_data["label"][: max_samples // 4]

	vocab = build_vocab(train_texts, max_vocab)

	X_train = tokenize_and_pad(train_texts, vocab, max_length)
	X_test = tokenize_and_pad(test_texts, vocab, max_length)
	y_train = torch.tensor(train_labels, dtype=torch.long)
	y_test = torch.tensor(test_labels, dtype=torch.long)

	return X_train, y_train, X_test, y_test, vocab
Construire le vocabulaire uniquement à partir des données d’entraînement évite les fuites d’information. Si un mot rare n’apparaît qu’en test, le modèle doit le traiter comme inconnu plutôt que d’avoir appris son embedding pendant l’entraînement.
La boucle d’entraînement met à jour les poids selon l’écart entre prédictions et vérité. Pour les LSTM, un détail compte plus qu’à l’accoutumée : le clipping des gradients.
def train_model(model, train_loader, test_loader, n_epochs=5, lr=0.001):
	criterion = nn.CrossEntropyLoss()
	optimizer = torch.optim.Adam(model.parameters(), lr=lr)

	for epoch in range(n_epochs):
    		model.train()
    		total_loss, correct, total = 0, 0, 0

    		for batch_texts, batch_labels in train_loader:
        		optimizer.zero_grad()
        		outputs = model(batch_texts)
        		loss = criterion(outputs, batch_labels)
        		loss.backward()
            		torch.nn.utils.clip_grad_norm_(
	model.parameters(),
	max_norm=5.0)
        		optimizer.step()

        		total_loss += loss.item()
        		_, predicted = outputs.max(1)
        		correct += (predicted == batch_labels).sum().item()
total += batch_labels.size(0)Plus haut, nous avons expliqué comment les LSTM atténuent l’évanouissement des gradients via des mises à jour additives de l’état de cellule. Mais les gradients explosifs restent un risque. Lorsqu’ils deviennent trop grands, les mises à jour de poids dépassent la cible et déstabilisent l’entraînement.
clip_grad_norm_ borne la norme totale du gradient. Si les gradients dépassent max_norm=5.0, ils sont réduits proportionnellement. Cela stabilise les mises à jour sans annuler complètement le signal de gradient.
    	model.eval()
    	test_correct, test_total = 0, 0
    	with torch.no_grad():
        	for batch_texts, batch_labels in test_loader:
            		outputs = model(batch_texts)
            		_, predicted = outputs.max(1)
            		test_correct += (predicted == batch_labels).sum().item()
            		test_total += batch_labels.size(0)

    	test_acc = test_correct / test_total
    	print(f"Epoch {epoch+1}: Loss={total_loss/len(train_loader):.4f}, "
          	f"Train={correct/total:.3f}, Test={test_acc:.3f}")

    return test_acc
model.eval() désactive le dropout en évaluation. torch.no_grad() évite de calculer les gradients puisque nous ne mettons pas à jour les poids, ce qui économise de la mémoire et accélère l’inférence.
X_train, y_train, X_test, y_test, vocab = load_imdb_data(
	max_samples=10000, max_length=100, max_vocab=5000
)

train_loader = DataLoader(TensorDataset(X_train, y_train), batch_size=64, shuffle=True)
test_loader = DataLoader(TensorDataset(X_test, y_test), batch_size=64)

model = LSTMClassifier(
	vocab_size=len(vocab),
	embedding_dim=32,
	hidden_size=32,
	output_size=2,
	padding_idx=vocab["<pad>"],
)

final_acc = train_model(model, train_loader, test_loader, n_epochs=50, lr=0.001)
Ces valeurs reflètent des arbitrages :
hidden_size=32 : assez petit pour itérer vite. En production, on voit souvent 128-512, mais les gains diminuent avec la taille tandis que l’entraînement ralentit.
embedding_dim=32 : l’aligner à la taille cachée est courant mais non requis. Des embeddings plus grands capturent des nuances au prix de paramètres supplémentaires.
max_length=100 : la plupart des signaux de sentiment apparaissent tôt. Des séquences plus longues aident les cas nuancés, mais quadruplent l’usage mémoire quand on double max_length.
batch_size=64 : des lots plus grands donnent des gradients plus stables. Des lots plus petits peuvent aider à sortir de minima locaux. 32-128 est typique.
lr=0.001 : la valeur par défaut d’Adam fonctionne pour la plupart des tâches LSTM. Si la perte oscille, essayez 0,0001. Si l’apprentissage stagne, tentez 0,01.
n_epochs=50 : suffisant pour converger. Surveillez un plateau (ou une baisse) de l’accuracy test alors que l’accuracy train grimpe : signe de surapprentissage.
Avec cette configuration, vous obtiendrez des sorties du type :
...
Epoch 46: Loss=0.4126, Train=0.812, Test=0.789
Epoch 47: Loss=0.4054, Train=0.815, Test=0.791
Epoch 48: Loss=0.3998, Train=0.818, Test=0.788
Epoch 49: Loss=0.3921, Train=0.821, Test=0.793
Epoch 50: Loss=0.3867, Train=0.824, Test=0.795
L’accuracy d’entraînement atteint ~82 % tandis que l’accuracy test se stabilise autour de 80 %. Le modèle apprend quels motifs de mots prédisent le sentiment. Les adjectifs forts en fin de phrase pèsent lourd. Les négations comme « not » inversent la polarité. Certaines expressions (« waste of time », « highly recommend ») deviennent de forts signaux. Rien n’est codé en dur ; tout émerge des corrélations dans les données.
Avec peu de réglages et un petit modèle, 80 % est raisonnable. Le faible écart entre train et test montre une bonne généralisation sans surapprentissage marqué. Ajouter du dropout, utiliser des embeddings préentraînés comme GloVe, ou entraîner sur plus de données peut pousser l’accuracy vers 85-90 %.
L’architecture LSTM de base fonctionne, mais plusieurs techniques permettent de gagner en précision sans changer de famille de modèles. Ces approches ont été validées dans des milliers de déploiements et d’articles.
Les LSTM standards lisent de gauche à droite, ne s’appuyant que sur le passé. Les LSTM bidirectionnels (BiLSTM) effectuent deux passes : une avant, une arrière. La représentation finale à chaque pas combine ce qui précède et ce qui suit.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	bidirectional=True,  # Run both directions
	batch_first=True,
)
# Output size doubles: hidden_size * 2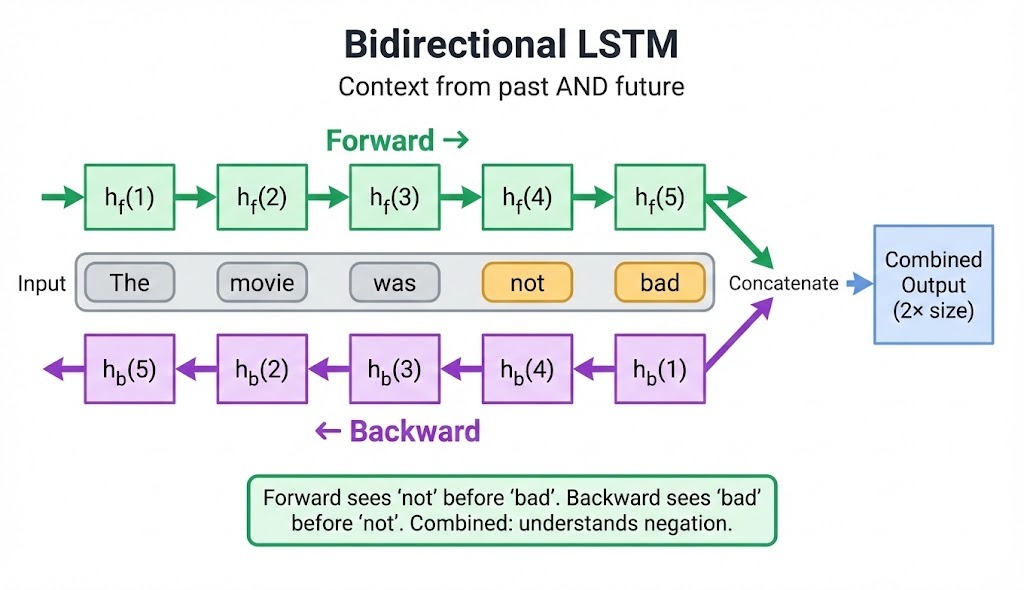
Pour l’analyse de sentiment, c’est utile quand la négation apparaît après le mot modifié : « the movie was not bad » requiert le contexte avant pour savoir que « bad » existe, et le contexte après pour savoir que « not » le précède.
Les BiLSTM surclassent consistamment les modèles unidirectionnels pour la reconnaissance d’entités nommées (NER), la classification de sentiment et la reconnaissance vocale, avec des gains typiques de 5 à 15 %.
Le compromis : il faut disposer de la séquence complète à l’inférence. Les applications en streaming qui reçoivent un jeton après l’autre ne peuvent pas utiliser le bidirectionnel.
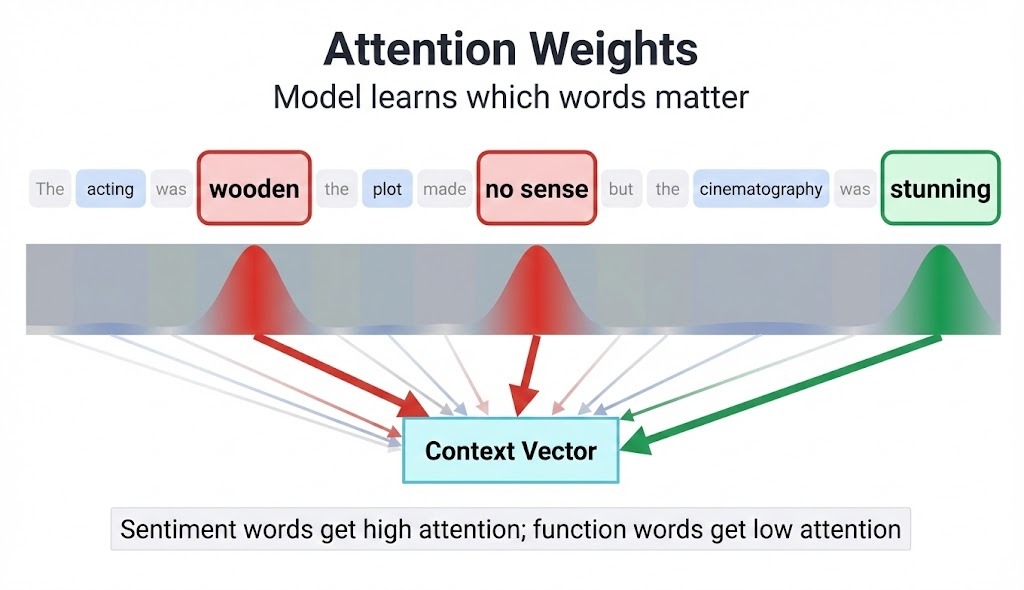
L’attention permet au modèle de pondérer les pas de temps les plus importants pour une prédiction donnée. Plutôt que de compresser toute la séquence dans un unique état caché final, l’attention calcule une combinaison pondérée de tous les états cachés.
class AttentionLayer(nn.Module):
	def __init__(self, hidden_size):
    		super().__init__()
    		self.attention = nn.Linear(hidden_size, 1)

	def forward(self, lstm_outputs):
    	# lstm_outputs: (batch, seq_len, hidden_size)
    		scores = self.attention(lstm_outputs)  # (batch, seq_len, 1)
    		weights = torch.softmax(scores, dim=1)
    		context = torch.sum(weights * lstm_outputs, dim=1)
    		return context
Dans une critique comme « The acting was wooden, the plot made no sense, but the cinematography was stunning », l’attention apprend à se concentrer sur les segments porteurs de sentiment plutôt que de traiter tous les mots à égalité. Le modèle attribue des poids plus élevés à « wooden », « no sense » et « stunning », et atténue « the » et « was ».
L’attention ajoute peu de surcoût de calcul et apporte souvent 2 à 5 % d’amélioration sur les tâches de classification. Pour les tâches séquence-à-séquence comme la traduction, l’attention entre encodeur et décodeur est quasiment indispensable.
Une couche LSTM capture des motifs à un niveau d’abstraction. En empiler plusieurs permet d’apprendre des caractéristiques hiérarchiques : la première couche détecte des motifs locaux, les couches supérieures les combinent en compréhension de document.
self.lstm = nn.LSTM(
	input_size=embedding_dim,
	hidden_size=hidden_size,
	num_layers=3,  # Stack three layers
	dropout=0.3,   # Dropout between layers (not within)
	batch_first=True,
)
Recommandations sur la profondeur :
Chaque couche supplémentaire double à peu près le temps d’entraînement. Commencez peu profond, et n’ajoutez de la profondeur que si les métriques de validation plafonnent.
Les LSTM surajustent facilement, surtout avec peu de données. Trois techniques de régularisation fonctionnent bien ensemble :
Le dropout met zéro aléatoirement des neurones pendant l’entraînement, forçant le réseau à répartir l’apprentissage sur plusieurs voies. Appliquez le dropout entre les couches LSTM, pas à l’intérieur des connexions récurrentes (ce qui peut perturber l’apprentissage temporel).
# PyTorch applique automatiquement du dropout entre couches empilées
self.lstm = nn.LSTM(..., num_layers=2, dropout=0.3)

# Pour un LSTM monocouche, ajoutez du dropout après
self.dropout = nn.Dropout(0.3)
Des taux de 0,2 à 0,5 fonctionnent dans la plupart des cas. Plus haut aide en cas de fort surapprentissage mais ralentit la convergence.
Le clipping borne la magnitude des gradients lors de la rétropropagation. Même si les LSTM atténuent l’évanouissement, les explosions de gradients surviennent encore, surtout avec de longues séquences ou des réseaux profonds.
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)Des valeurs entre 1,0 et 5,0 sont typiques. Si la perte d’entraînement explose ou devient NaN, baissez le seuil.
L’arrêt anticipé surveille la perte de validation et stoppe l’entraînement lorsqu’elle n’améliore plus. Il évite au modèle de mémoriser les données d’entraînement au détriment de la généralisation.
patience = 5
best_val_loss = float('inf')
epochs_without_improvement = 0

for epoch in range(max_epochs):
	train_loss = train_one_epoch(model, train_loader)
	val_loss = evaluate(model, val_loader)

	if val_loss < best_val_loss:
    		best_val_loss = val_loss
    		epochs_without_improvement = 0
    		torch.save(model.state_dict(), 'best_model.pt')
	else:
    		epochs_without_improvement += 1
	if epochs_without_improvement >= patience:
        	break
Pour un tutoriel complet sur les boucles d’entraînement, les métriques d’évaluation et le débogage des LSTM, consultez le guide NLP avec PyTorch.
L’initialisation aléatoire fonctionne, mais des embeddings préentraînés comme GloVe ou Word2Vec donnent de l’avance au modèle. Ces vecteurs encodent des relations sémantiques apprises sur des milliards de mots : « king » et « queen » sont proches, tout comme « terrible » et « awful ».
import numpy as np

def load_glove_embeddings(glove_path, vocab, embedding_dim):
	embeddings = np.random.randn(len(vocab), embedding_dim) * 0.01

	with open(glove_path, 'r') as f:
    	for line in f:
        	parts = line.split()
        	word = parts[0]
        	if word in vocab:
            		embeddings[vocab[word]] = np.array(parts[1:], dtype=np.float32)

	return torch.tensor(embeddings, dtype=torch.float32)

# Load and freeze or fine-tune
pretrained = load_glove_embeddings('glove.6B.100d.txt', vocab, 100)
model.embedding.weight.data.copy_(pretrained)
model.embedding.weight.requires_grad = True  # Fine-tune during training
Les embeddings préentraînés aident surtout quand les données d’entraînement sont limitées. Avec des millions d’exemples, des embeddings aléatoires finissent par rattraper. Pour la plupart des cas pratiques avec 10 000 à 100 000 échantillons, attendez-vous à 3 à 8 % de gains d’accuracy grâce à cette initialisation.
Ces approches sont cumulatives. Un classificateur de texte de production pourrait utiliser :
Chaque ajout accroît la complexité et le temps d’entraînement. Commencez par un LSTM monocouche de base, mesurez, puis ajoutez les techniques une par une pour voir ce qui apporte un gain sur votre tâche.
Les LSTM ont dominé la modélisation séquentielle de la fin des années 1990 au milieu des années 2010. L’article « Attention Is All You Need » (2017) a changé la donne. Les Transformers alimentent aujourd’hui la plupart des grands modèles de langue, mais les LSTM n’ont pas disparu. Ils occupent d’autres niches.
Nous avons vu comment les LSTM traitent les séquences un jeton à la fois et pourquoi ce mécanisme de portes fonctionne. À l’échelle, cette dépendance séquentielle devient un goulot d’étranglement. Votre GPU peut avoir des milliers de cœurs, mais la plupart restent inactifs pendant que la chaîne d’états cachés se termine. Une entrée de 500 jetons implique 500 opérations en série.
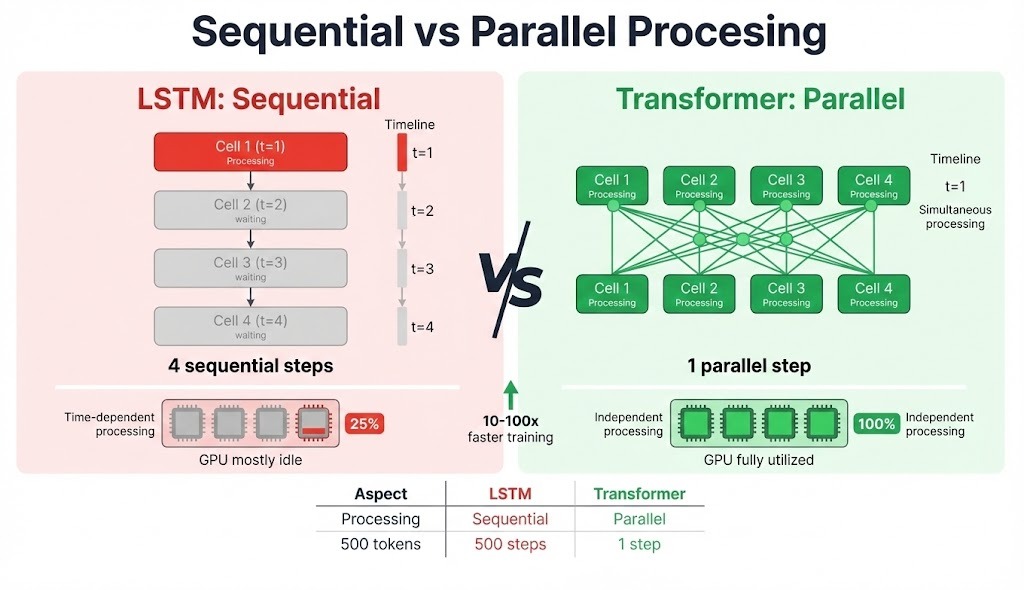
Les Transformers n’ont pas cette contrainte. L’auto-attention calcule les relations entre toutes les positions simultanément ; la même séquence de 500 jetons est donc traitée en parallèle. Sur du matériel moderne avec de grands batches, cela se traduit par des accélérations de 10 à 100×.
La longueur de séquence maximale compte aussi. Nous avons vu que les LSTM préservent mieux les gradients que les RNN classiques, mais « mieux » ne signifie pas « parfait ». Les performances chutent toujours vers 200 à 500 jetons selon la tâche.
Les Transformers calculent l’attention entre chaque paire de positions directement, donc le jeton 1 peut « regarder » le jeton 1000 sans difficulté. Le compromis est la mémoire : les matrices d’attention croissent quadratiquement avec la longueur de séquence.
Les activations des portes rendent aussi l’interprétation difficile. Les valeurs vont de 0 à 1 sans frontière nette. Les poids d’attention des Transformers ne sont pas des explications parfaites non plus, mais ils donnent un signal plus clair sur les jetons qui comptent pour chaque sortie.
Les Transformers s’imposent lorsque :
Les LSTM restent adaptés lorsque :
La prévision de séries temporelles se situe entre les deux. Des benchmarks récents montrent des performances similaires sur des données univariées et régulières. Les Transformers prennent l’avantage quand de multiples variables interagissent de façon complexe, mais les LSTM tiennent la route quand les données sont rares ou le calcul contraint.
Des architectures hybrides combinent les deux approches. Certaines empilent des couches LSTM avec des mécanismes d’attention. xLSTM, publié en 2024, revisite le design originel avec des portes exponentielles et une mémoire matricielle, et obtient des résultats compétitifs avec les Transformers à plus petite échelle.
|
Aspect |
LSTM |
Transformer |
|
Traitement |
Séquentiel (jeton par jeton) |
Parallèle (toutes positions à la fois) |
|
Vitesse d’entraînement |
Plus lente (peu parallélisable) |
Plus rapide sur GPU |
|
Dépendances longues |
Se dégrade au-delà de 200-500 jetons |
Gère des milliers de jetons |
|
Scalabilité mémoire |
O(n) avec la longueur de séquence |
O(n²) pour les matrices d’attention |
|
Peu de données |
Bon (moins de paramètres) |
Sujets au surapprentissage |
|
Déploiement edge |
Adapté (empreinte mémoire réduite) |
Difficile (modèles volumineux) |
|
Streaming/temps réel |
Support natif |
Besoin de la séquence complète |
|
Écosystème préentraîné |
Limité |
Étendu (BERT, GPT, etc.) |
La décision se résume souvent aux contraintes. Calcul et données illimités ? Les Transformers gagnent sur la plupart des tâches NLP. Un microcontrôleur avec 10 000 exemples d’entraînement ? Les LSTM restent pratiques.
Les LSTM ont résolu un vrai problème en 1997. Le mécanisme de portes introduit par Hochreiter et Schmidhuber a permis aux réseaux d’apprendre sur des séquences plus longues que quelques dizaines de jetons. Cette architecture a propulsé la traduction automatique, la reconnaissance vocale et la prévision de séries pendant près de deux décennies.
Les Transformers gèrent désormais la plupart des tâches NLP à grande échelle, mais les LSTM ne sont pas obsolètes. Ils gardent du sens pour l’edge, le streaming et les contextes où les données d’entraînement sont limitées.
Si vous lancez un nouveau projet de modélisation séquentielle, essayez d’abord un LSTM simple. Mesurez ses performances, comprenez ses limites, puis décidez si le problème nécessite vraiment un Transformer. Les concepts de ce guide (portes, état de cellule, flux de gradient) se transfèrent directement vers des architectures plus complexes.
Pour pratiquer, nous vous recommandons notre cours Recurrent Neural Networks, qui propose d’autres applications LSTM avec des exercices guidés.
Cours de machine learning
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
Kurtis Pykes
15 min
Tutoriel
Josef Waples
8 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
Mark Pedigo
10 min
Tutoriel


