反向传播是现代神经网络训练中不可或缺的一环,使这些复杂的算法能够从训练数据集中学习并随时间不断改进。
理解并掌握反向传播算法对于从事神经网络与深度学习领域的任何人都至关重要。本教程将深入探索反向传播。
我们将先解释什么是反向传播及其工作原理,并讨论其优劣势,然后再进入一个将其应用于常用数据集的实践环节。
什么是反向传播?
反向传播算法诞生于20世纪70年代,用于根据上一轮迭代或epoch得到的误差率来微调神经网络的权重,这是训练人工神经网络的标准方法。
您可以把它看作一种反馈机制:在每一轮训练(“epoch”)之后,网络会回顾自己在任务上的表现。它计算自身输出与正确答案之间的差异(即误差),然后调整内部参数(“权重”)以在下一次减小该误差。该方法对于调优神经网络的准确率至关重要,是学习改善预测或决策能力的基础策略。
反向传播如何工作?
既然已经了解了反向传播的概念,下面来看看它如何运作。下图展示了反向传播算法应用于一个神经网络的示意,其中包含:
- 两个输入 X1 和 X2
- 两个隐藏层 N1X 和 N2X,其中 X 取值为 1、2 和 3
- 一个输出层
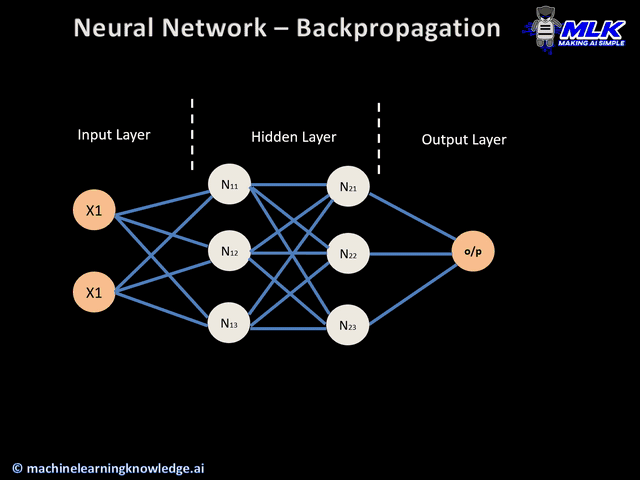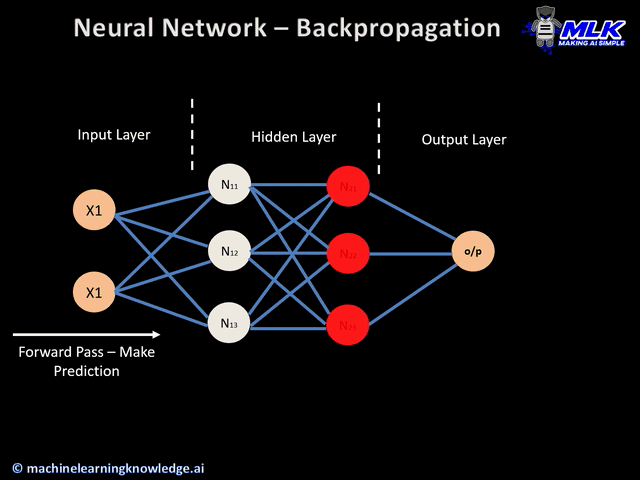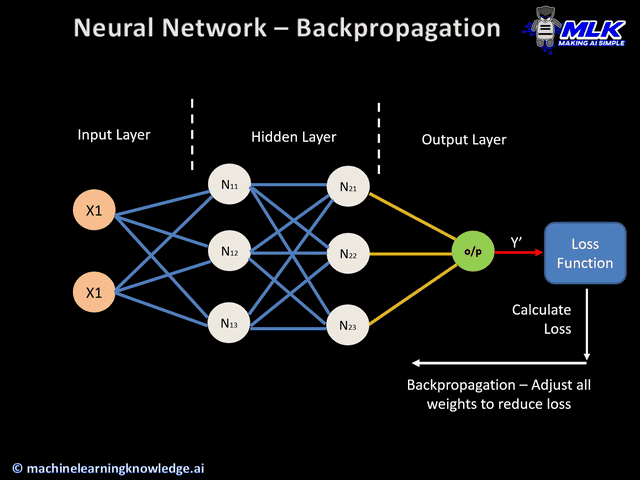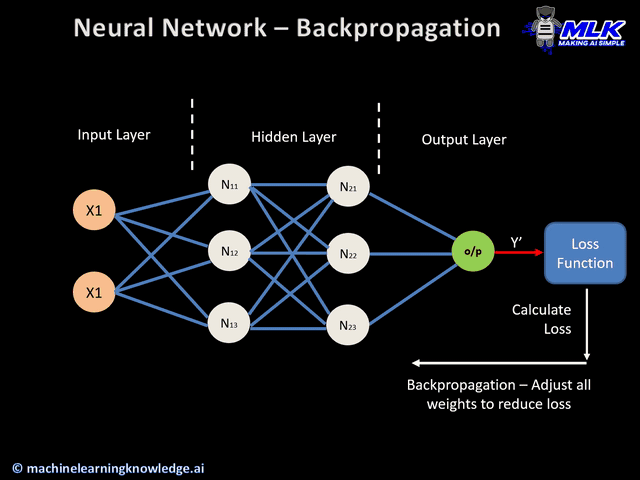
反向传播示意图(来源:machinelearningknowledge)
反向传播算法总体包含四个主要步骤:
- 前向传播
- 误差计算
- 反向传播
- 权重更新
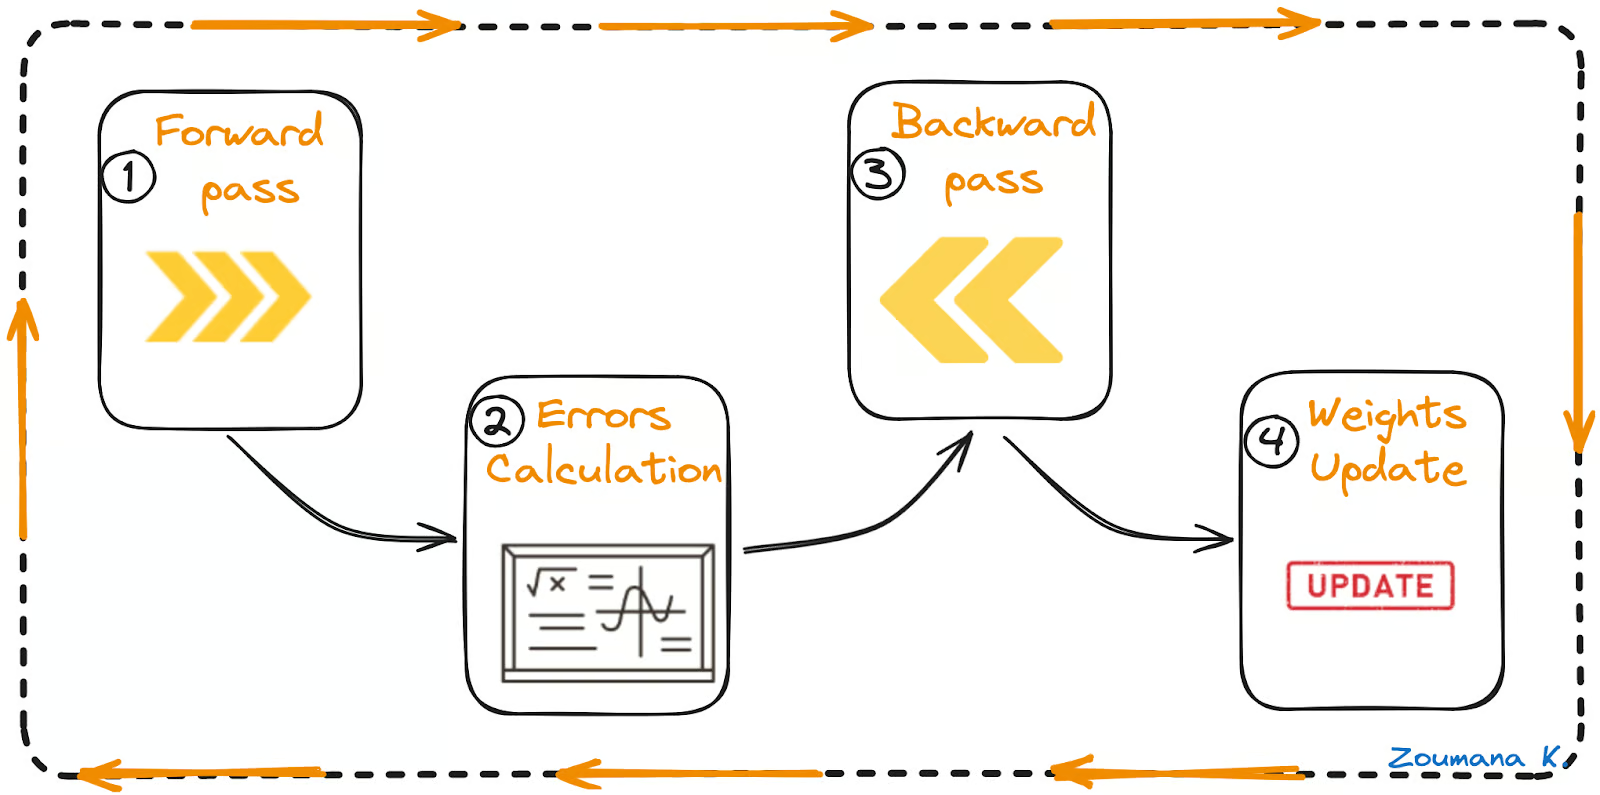
前向传播、误差计算、反向传播与权重更新
让我们基于上述动图来理解每个步骤。
前向传播
这是反向传播流程的第一步,如下所示:
- 将数据(输入 X1 和 X2)馈入输入层
- 随后,每个输入与其对应的权重相乘,结果传递到隐藏层的神经元 N1X 和 N2X。
- 这些神经元对接收到的加权输入应用激活函数,结果再传递到下一层。
误差计算
- 该过程持续进行,直到输出层生成最终输出(o/p)。
- 将网络输出与真实值(期望输出)进行比较,计算差值,得到误差。
反向传播
这是实际的反向传播步骤,必须在完成上述前向传播与误差计算后才能进行。其工作方式如下:
- 利用先前得到的误差值来计算损失函数的梯度。
- 从输出层开始,将误差梯度向后传播至隐藏层。
- 随着误差梯度向后传播,依据各自对误差的贡献来更新权重(由连接节点的连线表示)。这涉及对每个权重求误差的偏导,表示权重变化对误差的影响程度。
- 学习率决定权重更新的幅度。学习率越小,权重更新幅度越小,反之亦然。
权重更新
- 权重沿梯度的反方向更新,这也就是“梯度下降”的由来。其目的是在下一次前向传播时降低误差。
- 前向传播、误差计算、反向传播与权重更新这一过程会在多个 epoch 上反复进行,直到网络表现达到满意水平或不再显著提升。
反向传播的优势
反向传播是神经网络训练的基础技术,因其实现直观、编程简单,且可跨多种网络架构应用而广受青睐。
我们的用 R 构建神经网络(NN)模型教程是学习神经网络的绝佳起点,教授如何在 R 中创建神经网络模型。
对于 Python 程序员,循环神经网络(RNN)教程提供了关于这一最受欢迎的深度学习模型 RNN 的完整指南,并通过构建万事达股票价格预测器进行实操练习。
现在,让我们展开说明前文提到的每项益处:
- 易于实现:可通过 Pytorch、Keras 等多种深度学习库使用,便于在不同应用中落地。
- 编程简洁:框架抽象降低了编码复杂度,减少对繁琐数学推导的依赖。
- 灵活性强:可适配多样架构,适用于广泛的 AI 挑战。
局限与挑战
尽管反向传播算法取得了巨大成功,但它并非毫无局限,这些局限可能影响神经网络训练过程的效率与效果。下面来看看其中一些限制:
- 数据质量:数据质量差(包括噪声、不完整或偏差)会导致模型不准确,因为反向传播完全按照提供的数据进行学习。
- 训练时长:反向传播通常需要较长的训练时间,对于大型网络而言可能不太实际。
- 矩阵计算复杂度:反向传播中的矩阵运算会随网络规模增长而扩大计算需求,可能超出可用资源。
实现反向传播
了解了这些关于反向传播算法的要点后,是时候在真实场景中一试身手了:我们将实现一个神经网络来识别 MNIST 数据集中的手写数字。
本节涵盖从数据可视化到模型训练与评估的全部步骤。完整源码见此 DataLab 工作簿;您可轻松创建自己的副本,在浏览器中运行代码,无需在本地安装任何软件。
关于数据集
MNIST 数据集在图像识别领域广泛使用。它由 70000 张 0 到 9 的手写数字灰度图构成,每张图片为 28x28 像素。
该数据集可通过 Keras.datasets 模块的 mnist 函数获取,导入 mnist 库后按如下方式加载:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
探索性数据分析
在构建任何机器学习或深度学习模型之前,探索性数据分析是关键步骤,因为它能帮助更好地理解手头数据的特性,从而指导模型类型的选择。
主要任务包括:
- 确定训练集与测试集中的数据总量。
- 随机可视化训练集中部分数字。
- 可视化训练集标签的分布。
整个数据集包含 70000 张图像。典型的划分方式如下,但并无固定规则:
- 70% 或 80% 作为训练集
- 30% 或 20% 作为测试集
有时也会用 90% 训练、10% 测试的划分。
在我们的场景中,训练集与测试集已分别加载,因此无需再分割。先来看下它们的规模。
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")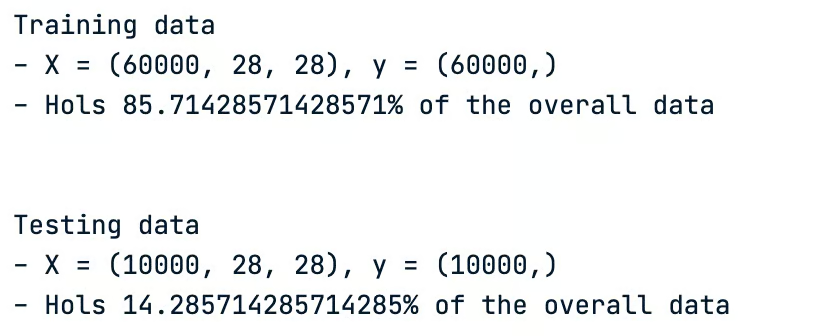
训练集与测试集的特征
- 训练集包含 60000 张图像,占原始数据集的 85.71%。
- 测试集包含剩余的 10000 张图像,占原始数据集的 14.28%。
现在来随机可视化一些数字。这通过辅助函数 plot_images 实现,该函数接收两个主要参数:
- 要绘制的图像数量,
- 用于可视化的数据集
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
我们希望可视化训练数据中的九张图像,对应的代码片段如下:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
成功执行上述代码后,会生成以下九个数字。
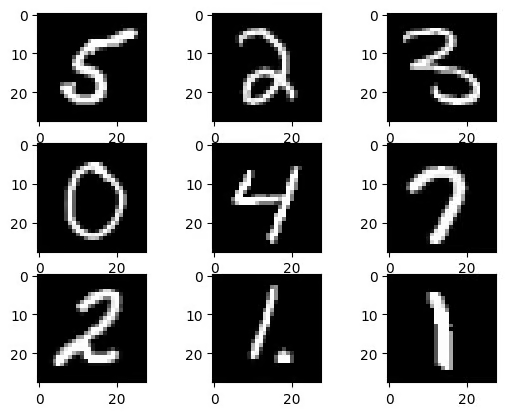
训练集中随机抽取的九张图像
第二次运行相同函数后,将显示以下数字。可见结果不同,这是由于辅助函数的随机性所致。
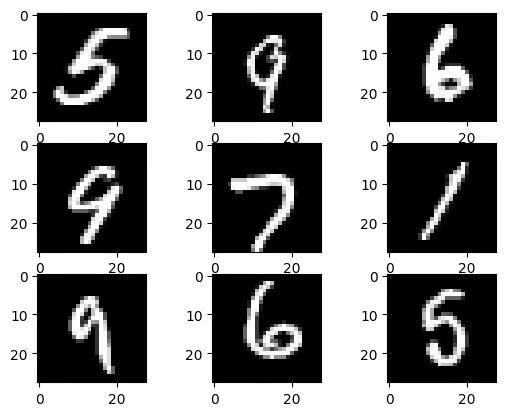
第二次运行函数后训练集中随机抽取的九张图像
数据分析的最后一项任务是使用辅助函数 plot_labels_distribution 可视化训练集标签的分布。
- X 轴为所有可能的数字
- Y 轴为对应数字的总数
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
向该函数提供训练集的标签即可应用:
plot_labels_distribution(train_labels)如下图所示,十个数字在整个数据集中几乎均匀分布,这是个好消息,意味着无需进一步平衡标签分布。
数据预处理
现实世界的数据通常需要一些预处理,以便适用于模型训练。我们对训练集与测试集图像应用三项主要预处理:
- 图像归一化:将所有像素值从 0–255 转换到 0–1 区间,有助于在训练过程中更快收敛。
- 重塑图像:将每张 28×28 的方阵图像拉平成 784 维向量,以便作为神经网络的输入。
- 标签编码:将标签转换为独热编码向量,避免数值大小带来的层级问题,防止模型对较大数字产生偏置。
整体预处理逻辑实现在下面的辅助函数 preprocess_data 中:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
通过以下代码片段将该函数应用于数据集:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
现在,来看一下两个数据集当前的像素最大值与最小值:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
如下所示,归一化已成功完成。
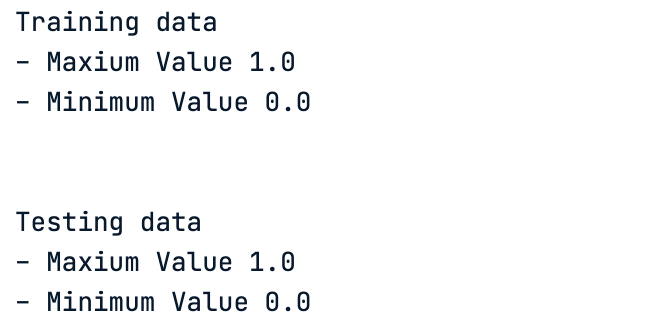
归一化后的像素最小值与最大值
同样地,最终标签也成为由 0 和 1 构成的矩阵,即这些标签的独热编码值。
# One hot encoding of the test data labels
test_images
结果如下:
测试集标签的独热编码
# One hot encoding of the train data labels
train_labels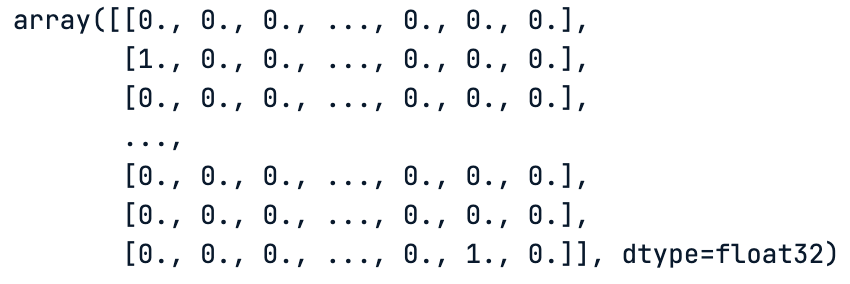
训练集标签的独热编码
网络结构
由于我们要进行图像分类任务,卷积神经网络更适用于此类场景。在编写代码之前,定义模型架构非常重要,本节即为此目的。
若想进一步了解卷积神经网络,请参阅我们的卷积神经网络(CNN)入门教程。这是一份完整指南,帮助理解 CNN、其在图像分析中的影响,以及用于对抗过拟合、提升 CNN 与深度学习应用鲁棒性的一些关键策略。
本用例的架构结合了多种层类型,以实现高效的图像分类。模型的关键组件如下:
- 卷积层:以 3×3 的小卷积核和 32 个滤波器开始处理图像。
- 最大池化层:在卷积层之后加入最大池化层以降低特征图尺寸。
- 展平:将池化层输出展平为单个向量,以便进行分类。
- 全连接层:在展平输出与最终层之间加入一个含 100 个节点的全连接层,用于解释提取到的特征。
- 输出层:使用含 10 个节点的输出层,对应 10 个图像类别。每个节点计算图像属于相应类别的概率。
- Softmax 激活:在输出层使用 softmax 激活函数进行多分类。
- ReLU 激活函数:在所有层使用 ReLU(修正线性单元)激活进行非线性处理。
- 优化器:采用学习率 0.001、动量 0.95 的随机梯度下降优化器,在训练期间调整模型。
- 损失函数:使用适合多分类任务的类别交叉熵损失函数。
- 准确率指标:考虑到类别分布均衡,本例关注分类准确率指标。
以上信息实现在辅助函数 define_network_architecture 中。在此之前,需先导入必要的库:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
以下是辅助函数的实现。
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
源码实现固然不错,但若能有图形化网络结构更佳。我们使用 keras.utils.vis_utils 模块中的 plot_model 函数来实现可视化。
首先,通过辅助函数生成网络。
network = define_network_architecture()然后显示图形表示。我们先将结果保存为 PNG 文件再展示,便于与他人分享。
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
结果如下所示。
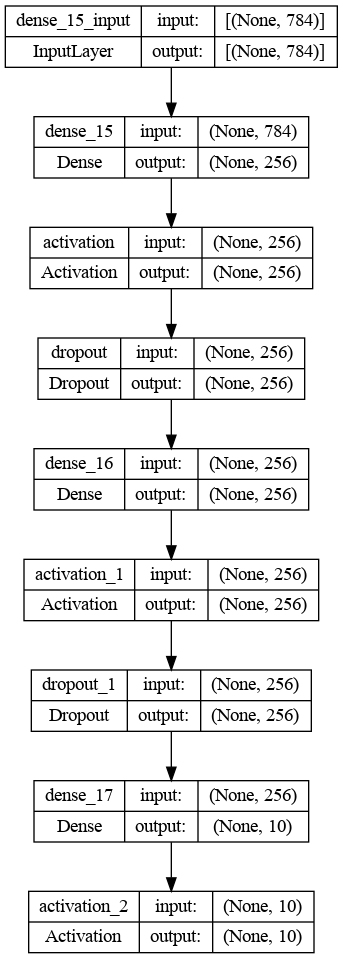
卷积神经网络的图形化架构
计算 delta
在进入模型训练流程之前,先来理解如何基于网络架构计算 delta 误差分布。
delta 误差分布是损失函数对每个节点激活值的导数,表示每个节点的激活对最终误差的贡献程度。
上述架构包含三个主要层:
- 输入层含 784 个单元,对应一张 28×28 的输入图像
- 隐藏层含 512 个单元,使用 ReLU 激活
- 输出层含 10 个单元,使用 softmax 激活函数,对应 10 个独特标签
现在,分别计算各层的 delta 误差。
输出层
设 softmax 层的输出为大写 O(O),真实标签为 Y。使用交叉熵损失 δ output,则 delta 误差为:
δ output = O - Y
该公式源于 softmax 输出变化对交叉熵损失变化的基本推导。
隐藏层
对于隐藏层,delta 误差记为 δ hidden,它取决于后续层(即输出层)的误差以及 ReLU 激活函数的导数。
ReLU 的导数对正输入为 1,对负输入为 0,如下所示。
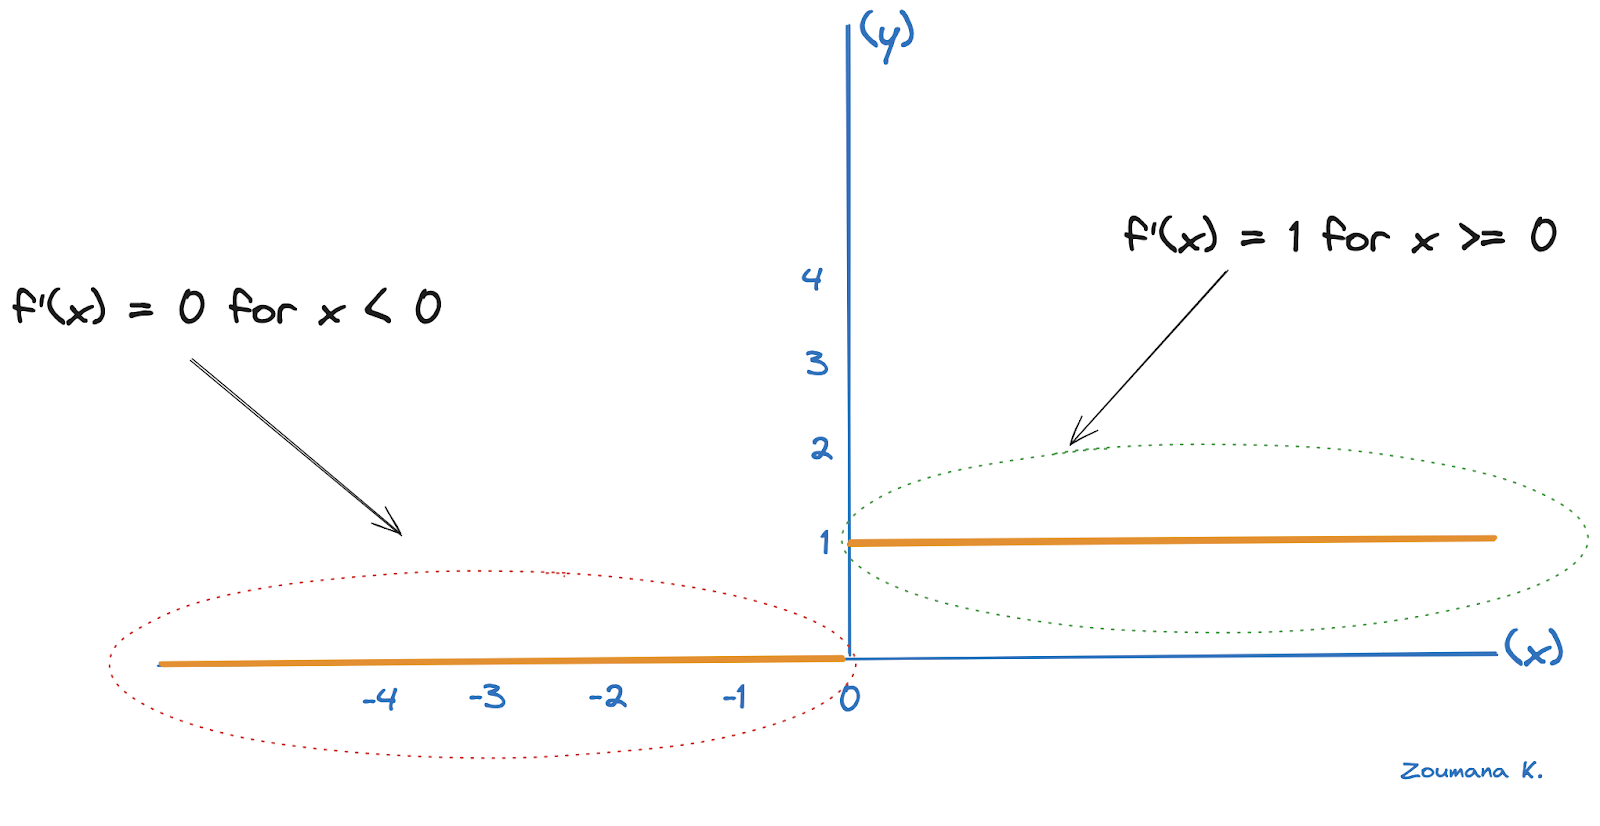
ReLU 导数示意
设 Zhidden 为隐藏层中 ReLU 的输入,Woutput 为隐藏层到输出层的连接权重。此时隐藏层的 delta 误差为:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- “.”表示矩阵乘法
- 符号 ⊙ 表示按元素相乘
- ReLU’(Zhidden) 表示在 Zhidden 处的 ReLU 导数
输入层
类似地,若有更多隐藏层,该过程会继续向后推进,每一层的 delta 误差取决于后续层的 delta 误差以及其自身激活函数的导数。
更一般地,对于网络中任意一层 k(除输出层外),delta 误差的计算公式为:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 为下一层权重矩阵的转置
- f’ 是第 k 层激活函数的导数
- Zk 是第 k 层激活函数的输入
网络编译
理解了误差计算后,让我们编译网络,以便为训练过程优化其结构。
在编译过程中,需要做出若干关键选择:
- 优化算法的选择:即选择用于梯度下降优化的算法,可选项包括随机梯度下降(SGD)、Adagrad、RMSprop 等,本文使用 RMSprop。
- 损失函数的选择:损失函数(也称成本函数)用于量化网络表现,其选择应与分类或回归问题的性质相匹配。由于问题为多分类,因此使用类别交叉熵。
- 性能指标的选择:性能指标主要用于评估模型在测试集上的效果,本文使用准确率。
对应的代码如下:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
网络训练
训练模型时最大的难题之一是过拟合,必须在训练过程中对模型进行监控以确保更好的泛化能力,其中一种方法是早停(early stopping)。
完整逻辑如下所示:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
模型以 256 的批量大小训练 15 个 epoch,并使用 20% 的训练数据作为验证集。
训练完成后,下面绘制训练与验证表现的历史曲线。
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()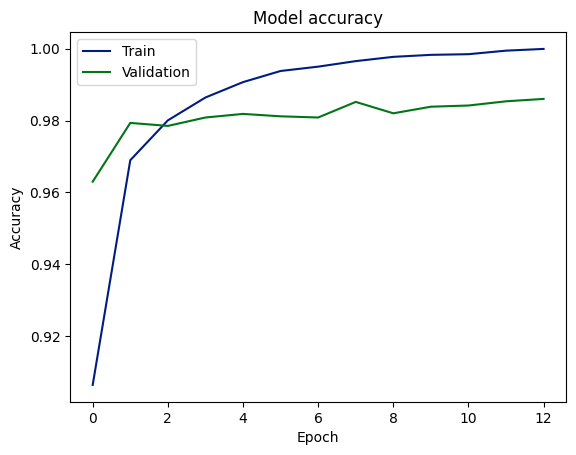
训练与验证集的准确率
在测试数据上的评估
现在我们可以使用模型的 evaluate 函数在测试数据上评估其性能。
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))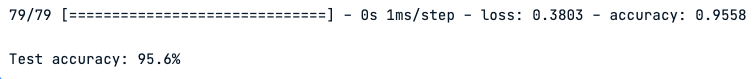
模型在测试数据上的表现
图表显示,模型在预测方面达到了较高准确率,在验证集与测试集上均约为 98%,这表明模型能够较好地从训练数据泛化到未见数据。不过,训练准确率与验证准确率之间的差距可能是过拟合的信号,尽管验证与测试准确率的一致性在一定程度上缓解了这一担忧。
建议
尽管模型具有较高的准确率与泛化能力,仍有提升空间。以下是一些可执行的改进步骤。
- 正则化:引入正则化方法以降低过拟合。
- 早停:在训练中使用早停以防止过拟合。
- 误差分析:分析错误预测以定位并纠正潜在问题。
- 多样性测试:在多样化数据集上测试模型以验证其鲁棒性。
- 更广的指标:在数据不平衡时使用精确率、召回率与 F1 分数进行更全面的评估。
结语
总之,本文全面探讨了机器学习领域的一项核心技术——反向传播。我们从反向传播的明确定义入手,阐述了其在推动人工智能发展中的关键作用。
接着,我们深入解析了反向传播的工作机制及其优势(如提升学习效率),同时也正视其面临的局限与挑战。
随后,我们给出了有关搭建神经网络的详细指导,强调了前向传播的重要性。
在收尾部分,我们探讨了计算 delta 与更新网络权重的步骤,这些都是优化学习过程的关键。
总体而言,本文可作为希望理解并有效在神经网络中实现反向传播的读者的有价值参考。
想要进一步夯实您的深度学习技能吗?我们的使用 PyTorch 的深度学习课程可助您更加自信地深入神经网络,拓展相关知识。
