Geri yayılım, modern sinir ağı eğitiminin temel bir parçasıdır; bu sayede bu gelişmiş algoritmalar eğitim veri kümelerinden öğrenir ve zamanla kendilerini geliştirir.
Geri yayılım algoritmasını anlamak ve buna hâkim olmak, sinir ağları ve derin öğrenme alanındaki herkes için kritik öneme sahiptir. Bu eğitim, geri yayılıma derinlemesine bir bakış sunar.
Öncelikle geri yayılımın ne olduğunu ve nasıl çalıştığını, artıları ve sınırlamalarıyla birlikte açıklar; ardından yaygın olarak kullanılan bir veri kümesine uygulamaya yönelik pratik bir deneyime geçer.
Geri yayılım nedir?
1970’lerde tanıtılan geri yayılım algoritması, bir sinir ağının ağırlıklarını, bir önceki yineleme veya epokta elde edilen hata oranına göre ince ayar yapma yöntemidir ve yapay sinir ağlarını eğitmenin standart bir yöntemidir.
Bunu, her bir eğitim turundan veya “epok”tan sonra ağın görevlerdeki performansını gözden geçirdiği bir geri bildirim sistemi olarak düşünebilirsiniz. Çıktısı ile doğru yanıt arasındaki farkı, yani hatayı hesaplar. Ardından, bir sonraki seferde bu hatayı azaltmak için iç parametrelerini veya “ağırlıklarını” ayarlar. Bu yöntem, sinir ağının doğruluğunu ayarlamak için gereklidir ve daha iyi tahminler veya kararlar vermeyi öğrenmede temel bir stratejidir.
Geri Yayılım Nasıl Çalışır?
Artık geri yayılımın ne olduğunu bildiğinize göre, nasıl çalıştığına dalalım. Aşağıda, geri yayılım algoritmasının şu yapıdaki bir sinir ağına uygulanışına dair bir görsel yer alıyor:
- İki girdi X1 ve X2
- X’in 1, 2 ve 3 değerlerini aldığı iki gizli katman N1X ve N2X
- Bir çıktı katmanı
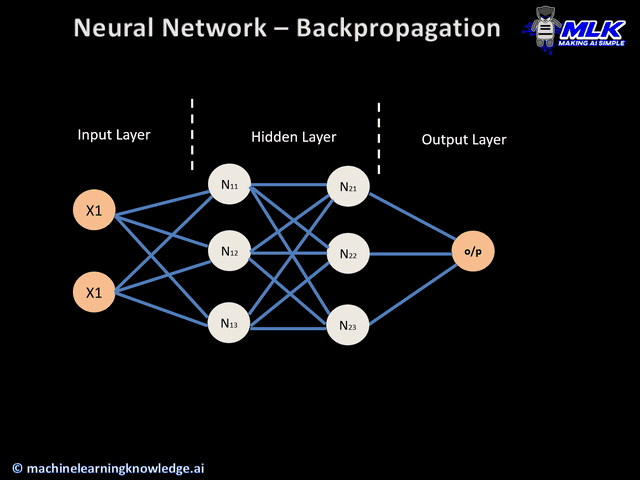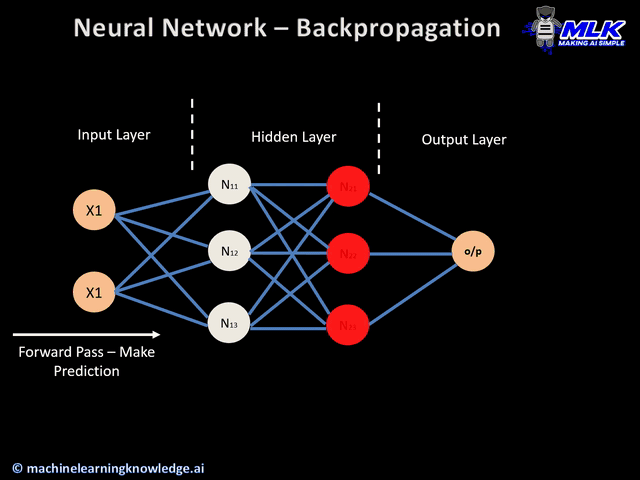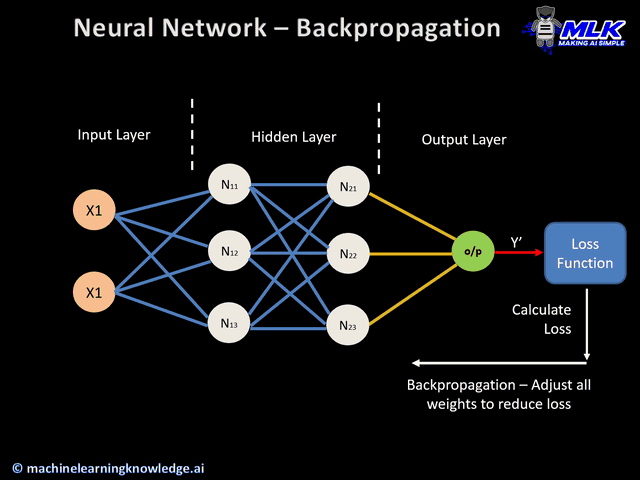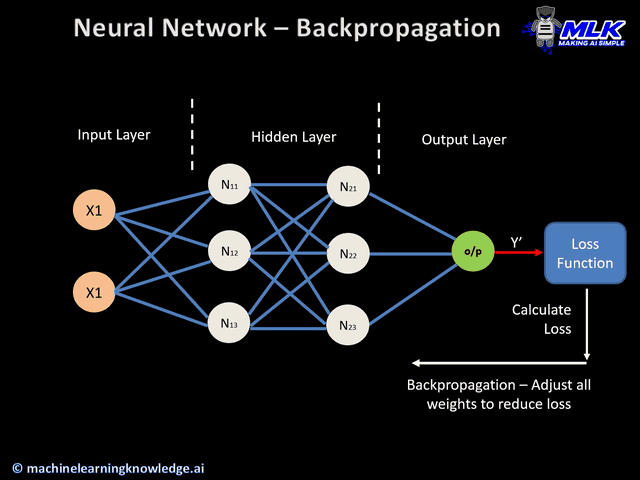
Geri yayılım görselleştirmesi (kaynak: machinelearningknowledge)
Geri yayılım algoritmasında toplam dört ana adım vardır:
- İleri geçiş
- Hata hesaplama
- Geri geçiş
- Ağırlıkların güncellenmesi
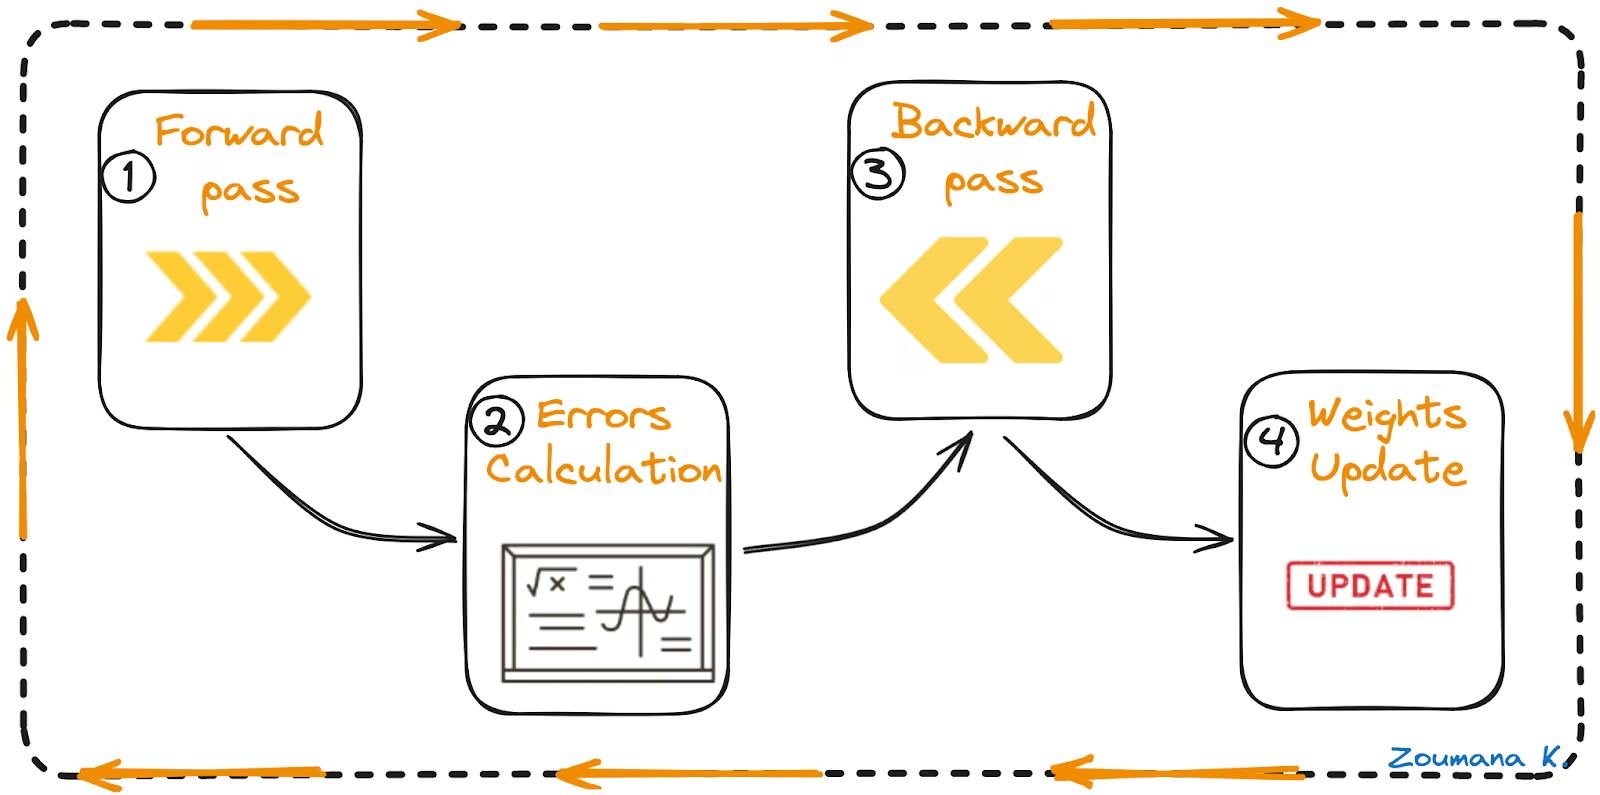
İleri geçiş, hata hesaplama, geri geçiş ve ağırlık güncelleme
Yukarıdaki animasyondan bu adımların her birini anlayalım.
İleri geçiş
Bu, geri yayılım sürecinin ilk adımıdır ve aşağıda gösterilmiştir:
- Veri (girdiler X1 ve X2) giriş katmanına beslenir.
- Ardından her girdi, karşılık gelen ağırlıkla çarpılır ve sonuçlar gizli katmanların N1X ve N2X nöronlarına iletilir.
- Bu nöronlar, aldıkları ağırlıklı girdilere bir aktivasyon fonksiyonu uygular ve sonuç bir sonraki katmana aktarılır.
Hata hesaplama
- Süreç, çıktı katmanı nihai çıktıyı (o/p) üretene kadar devam eder.
- Ağın çıktısı, gerçek değerlerle (istenen çıktı) karşılaştırılır ve aradaki fark hesaplanır; bu da bir hata değerine yol açar.
Geri geçiş
Bu, gerçek geri yayılım adımıdır ve yukarıdaki ileri geçiş ve hata hesaplama adımları olmadan gerçekleştirilemez. Şöyle çalışır:
- Önceden elde edilen hata değeri, kayıp fonksiyonunun gradyanını hesaplamak için kullanılır.
- Hata gradyanı, çıktı katmanından başlayarak gizli katmanlara doğru ağ boyunca geri doğru yayılır.
- Hata gradyanı geri yayılırken, düğümleri birbirine bağlayan çizgilerle temsil edilen ağırlıklar, hataya katkılarına göre güncellenir. Bu, her bir ağırlığa göre hatanın türevini almayı içerir; bu türev, ağırlıktaki bir değişikliğin hatayı ne kadar değiştireceğini gösterir.
- Öğrenme oranı, ağırlık güncellemelerinin büyüklüğünü belirler. Daha küçük bir öğrenme oranı, ağırlıkların daha küçük bir miktarla güncelleneceği anlamına gelir; tersi de geçerlidir.
Ağırlıkların güncellenmesi
- Ağırlıklar, gradyanın ters yönünde güncellenir; bu da “gradyan inişi” adının kaynağıdır. Amaç, bir sonraki ileri geçişte hatayı azaltmaktır.
- İleri geçiş, hata hesaplama, geri geçiş ve ağırlık güncelleme süreci, ağın performansı tatmin edici bir seviyeye ulaşana veya anlamlı bir iyileşme durana kadar birden çok epok boyunca devam eder.
Geri Yayılımın Avantajları
Geri yayılım, sinir ağı eğitiminde temel bir tekniktir; doğrudan uygulanabilirliği, programlama basitliği ve çoklu ağ mimarileri genelinde çok yönlü kullanımı sayesinde geniş çapta takdir görmüştür.
R ile Sinir Ağı (NN) Modelleri Oluşturma eğitimimiz, sinir ağları hakkında bilgi edinmek isteyen herkes için harika bir başlangıç noktasıdır. R’de bir sinir ağı modelinin nasıl oluşturulacağını öğretir.
Python programcıları için Yinelemeli Sinir Ağı (RNN) Eğitimi, en popüler derin öğrenme modeli RNN hakkında, MasterCard hisse fiyatı tahmin edicisi oluşturarak uygulamalı kapsamlı bir rehber sunar.
Şimdi, yukarıda belirtilen faydaların her birini açalım:
- Uygulama kolaylığı: Pytorch ve Keras gibi çok sayıda derin öğrenme kütüphanesi aracılığıyla erişilebilir olup farklı uygulamalarda kullanımını kolaylaştırır.
- Programlama basitliği: Çerçeve soyutlamasıyla kodlama basitleşir, karmaşık matematik ihtiyacını azaltır.
- Esneklik: Çeşitli mimarilere uyarlanabilir; geniş bir yapay zeka sorun yelpazesi için uygundur.
Sınırlamalar ve Zorluklar
Geri yayılım algoritmasının başarısına rağmen, sınırlamaları yok değildir; bu da bir sinir ağının eğitim sürecinin verimliliğini ve etkinliğini etkileyebilir. Bu kısıtların bazılarını inceleyelim:
- Veri kalitesi: gürültü, eksiklik veya önyargı dahil zayıf veri kalitesi, geri yayılım kendisine verilenleri tam olarak öğrendiğinden, hatalı modellere yol açabilir.
- Eğitim süresi: geri yayılım genellikle geniş eğitim süresi gerektirir; bu da büyük ağlarla çalışırken pratik olmayabilir.
- Matris tabanlı karmaşıklık: geri yayılımdaki matris işlemleri ağ boyutuyla ölçeklenir; bu da hesaplama talebini artırır ve mevcut kaynakları aşabilir.
Geri Yayılımın Uygulanması
Geri yayılım algoritmasına dair tüm bu içgörülerle, şimdi gerçek bir senaryoda uygulamasına dalma zamanı: MNIST veri kümesindeki el yazısı rakamları tanımak için bir sinir ağının uygulanması.
Bu bölüm, veri görselleştirmeden model eğitimine ve değerlendirmeye kadar tüm adımları kapsar. Tüm kaynak kodu bu DataLab çalışma kitabında mevcuttur; tarayıcıda kodu çalıştırmak için kolayca kendi kopyanızı oluşturabilirsiniz; bilgisayarınıza herhangi bir şey kurmanıza gerek yoktur.
Veri kümesi hakkında
MNIST veri kümesi, görüntü tanıma alanında yaygın olarak kullanılır. 0’dan 9’a el yazısı rakamların 70000 gri tonlamalı görüntüsünden oluşur ve her görüntü 28x28 piksel ölçülerindedir.
Veri kümesi, Keras.datasets modülündeki mnist fonksiyonunda mevcuttur ve mnist kitaplığı içe aktarıldıktan sonra aşağıdaki şekilde yüklenir:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Keşifsel veri analizi
Keşifsel veri analizi, eldeki verilerin doğasını daha iyi anlamaya yardımcı olduğu için herhangi bir makine öğrenmesi veya derin öğrenme modeli oluşturmadan önceki ana adımdır; dolayısıyla hangi tür modelin seçileceğine yol gösterir.
Başlıca görevler şunları içerir:
- Eğitim ve test veri kümelerindeki toplam veri sayısının belirlenmesi.
- Eğitim veri kümesinden bazı rakamların rastgele görselleştirilmesi.
- Eğitim veri kümesindeki etiketlerin dağılımının görselleştirilmesi.
Genel veri kümesi 70000 görüntüden oluşur. Orijinal veri kümesinin tipik bölünmesi aşağıda verilmiştir; bunun için belirli bir kural yoktur:
- Eğitim veri kümesi için %70 veya %80
- Test veri kümesi için %30 veya %20
Hatta bazı bölünmeler %90 eğitim ve %10 test şeklinde olabilir.
Bizim senaryomuzda eğitim ve test veri kümelerinin her ikisi de yüklendi; bu nedenle bölmeye gerek yok. Bu veri kümelerinin boyutlarını gözlemleyelim.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")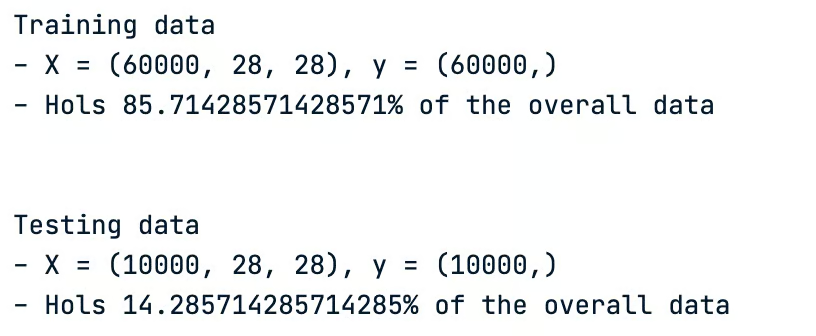
Hem eğitim hem de test veri kümelerinin özellikleri
- Eğitim veri kümesi 60000 görüntüye sahiptir ve orijinal veri kümesinin %85,71’ine karşılık gelir.
- Test veri kümesi ise kalan 10000 görüntüye, dolayısıyla orijinal veri kümesinin %14,28’ine sahiptir.
Şimdi bazı rastgele rakamları görselleştirelim. Bu, iki ana parametre alan plot_images yardımcı işleviyle gerçekleştirilir:
- Çizilecek görüntü sayısı ve
- Görselleştirme için dikkate alınacak veri kümesi
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Eğitim verilerinden dokuz görüntüyü görselleştirmek istiyoruz; bu da aşağıdaki kod parçasına karşılık gelir:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Yukarıdaki kodun başarılı şekilde yürütülmesi, aşağıdaki dokuz rakamı üretir.
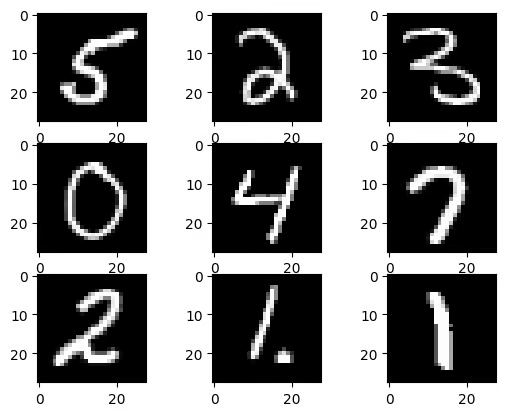
Eğitim veri kümesinden dokuz rastgele görüntü
Aynı işlev ikinci kez çalıştırıldıktan sonra aşağıdaki rakamlar görüntülenir ve aynı olmadıklarını fark ederiz; bu, yardımcı işlevin rastgele doğasından kaynaklanır.
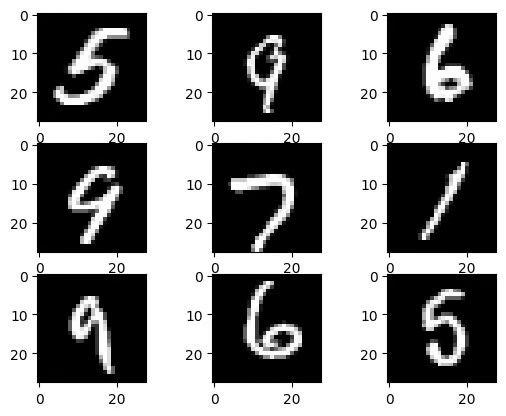
İşlevin ikinci çalıştırmasından sonra eğitim veri kümesinden dokuz rastgele görüntü
Veri analizi için son görev, plot_labels_distribution yardımcı işlevini kullanarak eğitim veri kümesindeki etiketlerin dağılımını görselleştirmektir.
- X ekseninde tüm olası rakamlar bulunur.
- Y ekseninde ise bu rakamların toplam sayısı bulunur.
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
İşlev, etiketleri aşağıdaki gibi verilerek eğitim veri kümesine uygulanır:
plot_labels_distribution(train_labels)Sonuç aşağıdadır ve on rakamın tümünün veri kümesi genelinde neredeyse eşit dağıldığını görüyoruz; bu iyi bir haberdir, etiketlerin dağılımını dengelemek için ek bir işleme gerek olmadığı anlamına gelir.
Veri ön işleme
Gerçek dünya verileri, modellerin eğitimi için uygun hale getirilmesi amacıyla genellikle bazı ön işlemler gerektirir. Hem eğitim hem de test görüntülerine uygulanan üç ana ön işleme görevi vardır:
- Görüntü normalizasyonu: tüm piksel değerlerinin 0-255 aralığından 0-1 aralığına dönüştürülmesinden oluşur. Bu, eğitim sürecinde daha hızlı yakınsama için önemlidir.
- Görüntülerin yeniden şekillendirilmesi: her görüntü için 28’e 28’lik kare bir matris yerine, her birini 784 elemanlı vektörlere düzleştiririz; böylece sinir ağı girişleri için uygun hale gelir.
- Etiket kodlama: etiketleri tek-sıcak (one-hot) olarak kodlanmış vektörlere dönüştürün. Bu, sayısal hiyerarşiyle ilgili yaşayabileceğimiz sorunları önleyecektir. Bu sayede model, daha büyük rakamlara karşı yanlı olmayacaktır.
Genel ön işleme mantığı aşağıdaki preprocess_data yardımcı işlevinde uygulanmıştır:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
İşlev, aşağıdaki kod parçacıkları kullanılarak veri kümelerine uygulanır:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Şimdi her iki veri kümesinin güncel maksimum ve minimum piksel değerlerini gözlemleyelim:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Kodun sonucu aşağıda verilmiştir ve normalizasyonun başarıyla gerçekleştirildiğini görüyoruz.
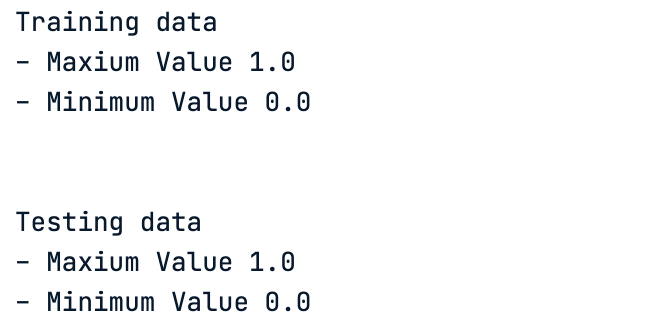
Normalizasyondan sonra minimum ve maksimum piksel değerleri
Benzer şekilde, etiketler için de artık bu etiketlerin tek-sıcak olarak kodlanmış değerlerine karşılık gelen birlerden ve sıfırlardan oluşan bir matrisimiz var.
# One hot encoding of the test data labels
test_images
Sonuç aşağıdadır:
Test veri etikelerinin tek-sıcak kodlaması
# One hot encoding of the train data labels
train_labels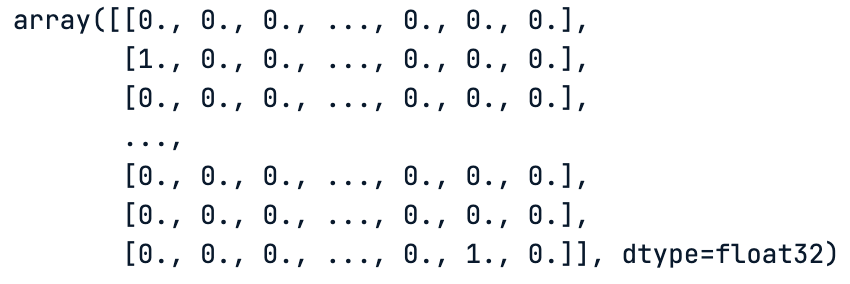
Eğitim veri etikelerinin tek-sıcak kodlaması
Ağın yapısı
Bir görüntü sınıflandırma görevi kullandığımızdan, bu tür bir senaryo için evrişimsel sinir ağı daha uygundur. Herhangi bir şeyi kodlamadan önce modelin mimarisini tanımlamak önemlidir; bu bölümün amacı budur.
Evrişimsel sinir ağları hakkında daha fazla bilgi edinmek için Evrişimsel Sinir Ağlarına (CNN’ler) Giriş eğitimimiz harika bir başlangıç kaynağıdır. CNN’leri, görüntü analizine etkilerini ve sağlam CNN ile derin öğrenme uygulamaları için aşırı uyumla mücadeleye yönelik bazı temel stratejileri anlamaya yönelik eksiksiz bir rehberdir.
Bu kullanım durumu için mimari, etkili bir görüntü sınıflandırması için farklı katman türlerini birleştirir. Modelin ana bileşenleri aşağıdadır:
- Evrişim Katmanı: Görüntüleri işlemek için küçük bir 3x3 filtre boyutu ve 32 filtre kullanan bir katmanla başlayın.
- Maksimum Havuzlama Katmanı: Evrişim katmanından sonra, öznitelik haritalarının boyutunu küçültmek için bir maksimum havuzlama katmanı ekleyin.
- Düzleştirme: Sınıflandırma sürecine hazırlamak için havuzlama katmanının çıktısını tek bir vektöre düzleştirin.
- Yoğun Katman: Çıktı katmanından önce, düzleştirilmiş çıktı ile nihai katman arasında 100 düğümlü bir yoğun katman ekleyin; bu katman, çıkarılan öznitelikleri yorumlar.
- Çıktı Katmanı: 10 görüntü kategorisine karşılık gelen 10 düğümlü bir çıktı katmanı kullanın. Her düğüm, bir görüntünün bu kategorilerden birine ait olma olasılığını hesaplar.
- Softmax Aktivasyonu: Çıktı katmanında, çok sınıflı sınıflandırma için softmax aktivasyon fonksiyonunu uygulayın.
- ReLU Aktivasyon Fonksiyonu: Tüm katmanlarda doğrusal olmayan işlem için ReLU (Düzleştirilmiş Doğrultucu Birim) aktivasyon fonksiyonunu kullanın.
- Eniyileştirici: Eğitimi sırasında modeli ayarlamak için 0,001 öğrenme oranı ve 0,95 momentum ile stokastik gradyan inişi eniyileştiricisi kullanın.
- Kayıp Fonksiyonu: Çok sınıflı sınıflandırma görevleri için ideal olan kategorik çapraz entropi kayıp fonksiyonunu kullanın.
- Doğruluk Ölçütü: Sınıfların dengeli dağılımını göz önünde bulundurarak sınıflandırma doğruluğu ölçütüne odaklanın.
Tüm bu bilgiler, define_network_architecture yardımcı işlevinde uygulanmıştır. Ancak ondan önce gerekli tüm kitaplıkları içe aktarmamız gerekir:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
İşte yardımcı işlevin uygulaması.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Kaynak kodu uygulaması iyi, ancak ağın grafiksel bir görselleştirmesine sahip olmak daha da iyidir; bu da keras.utils.vis_utils modülündeki plot_model işlevi kullanılarak gerçekleştirilir.
Önce yardımcı işlevden ağı oluşturun.
network = define_network_architecture()Ardından grafik gösterimi görüntüleyin. Sonucu önce bir PNG dosyasına kaydedip sonra gösteriyoruz; bu, başkalarıyla paylaşmayı kolaylaştırır.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Sonuç aşağıda gösterilmiştir.
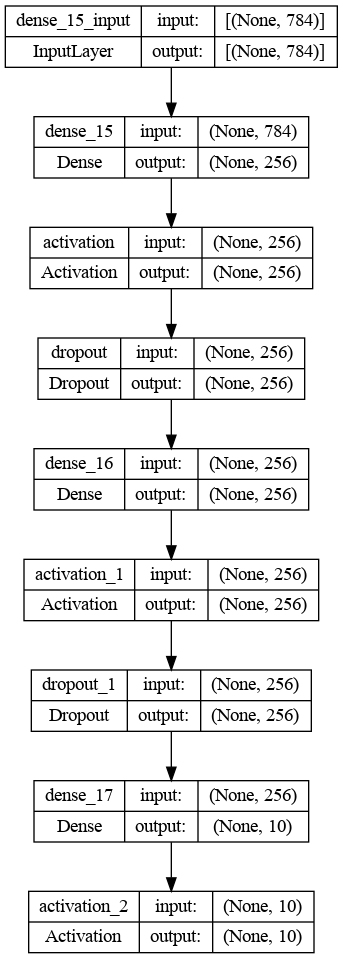
Evrişimsel sinir ağının grafiksel mimarisi
Delta’nın hesaplanması
Modelin eğitim sürecine dalmadan önce, ağın mimarisi kullanılarak delta hata dağılımının nasıl hesaplandığını anlayalım.
Delta hata dağılımı, her düğümün aktivasyon fonksiyonuna göre kayıp fonksiyonunun türevidir ve her düğümün aktivasyonunun nihai hataya ne ölçüde katkıda bulunduğunu gösterir.
Yukarıdaki mimari üç ana katmandan oluşur:
- 28x28 giriş görüntüsüne karşılık gelen 784 birimli giriş katmanı
- ReLU aktivasyonlu 512 birimli gizli katman
- Softmax aktivasyon fonksiyonuna sahip, benzersiz etiket sayısına karşılık gelen 10 birimli çıktı katmanı
Şimdi her katman için delta hata hesaplamasını daha ileri götürelim.
Çıktı katmanı
Softmax katmanının çıktısını büyük O (O) ve gerçek etiketleri Y olarak ele alalım. Çapraz entropi kaybı δ output kullanıldığında, delta hata şöyle olur:
δ output = O - Y
Bu formül, softmax çıktısı değiştiğinde çapraz entropi kaybının nasıl değiştiğine dair temel hesaplamadan gelir.
Gizli katman
Gizli katman için delta hata, δ hidden olur ve çıktı katmanına karşılık gelen bir sonraki katmanın hatasına ve ReLU aktivasyon fonksiyonunun türevine bağlıdır.
ReLU’nun türevi, pozitif girdiler için 1, negatifler için 0’dır; aşağıda gösterildiği gibi.
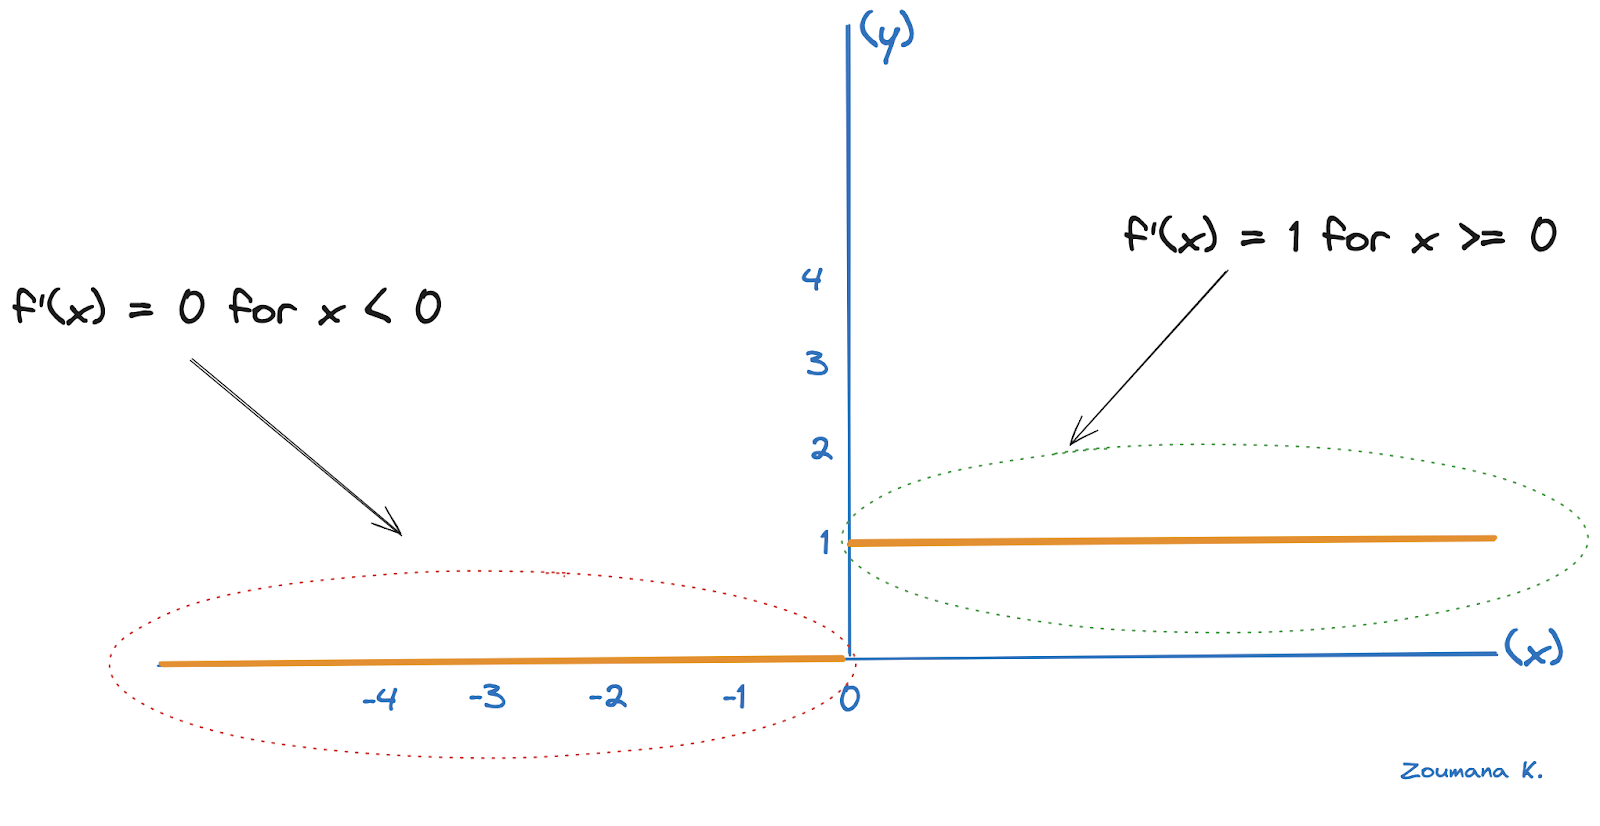
ReLU’nun türevinin görselleştirilmesi
Zhidden’ı gizli katmandaki ReLU fonksiyonuna giriş ve Woutput’u gizli katmanı çıktı katmanına bağlayan ağırlıklar olarak ele alalım. Bu durumda gizli katmanın delta hatası şöyle olur:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- “.” nokta işareti matris çarpımını belirtir
- ⊙ işareti, eleman düzeyinde çarpmaya karşılık gelir
- ReLU’(Zhidden), Zhidden’da ReLU’nun türevine karşılık gelir
Giriş katmanı
Benzer şekilde, daha fazla gizli katmanımız olsaydı, süreç, her katmanın delta hatasının bir sonraki katmanın delta hatasına ve kendi aktivasyon fonksiyonunun türevine bağlı olduğu şekilde geriye doğru devam ederdi.
Daha genel bir senaryoda, ağdaki herhangi bir k katmanı (çıktı katmanı hariç) için delta hata hesaplama formülü şöyledir:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1, bir sonraki katmanın ağırlıklar matrisinin transpozuna karşılık gelir
- f’, k katmanı için aktivasyon fonksiyonunun türevidir ve
- Zk, k katmanındaki aktivasyon fonksiyonuna giriştir
Ağın derlenmesi
Hata hesaplamasını bu şekilde anladıktan sonra, eğitim süreci için yapısını eniyilemek üzere ağı derleyelim.
Derleme sırasında birkaç kritik seçim yapmamız gerekir:
- Eniyileme Algoritması Seçimi: gradyan inişi eniyilemesi için bir algoritma seçmeyi içerir. Stokastik Gradyan İnişi (SGD), Adagrad ve bu yazıda kullanılan RMSprop gibi birçok seçenek vardır.
- Kayıp Fonksiyonunun Seçimi: Kayıp fonksiyonu, diğer adıyla maliyet fonksiyonu, eğitimin temel parçasıdır. Ağın ne kadar iyi performans gösterdiğini niceler ve seçimi, problemin sınıflandırma mı yoksa regresyon mu olduğuyla uyumlu olmalıdır. Problemin çok sınıflı doğası nedeniyle odak, kategorik çapraz entropidedir.
- Performans Ölçütünün Seçimi: Kayıp fonksiyonuna benzer olsa da, performans ölçütü esas olarak modelin test veri kümesindeki etkinliğini değerlendirmek için kullanılır ve biz doğruluğu kullanıyoruz.
Yukarıdaki üç seçim için kod aşağıda verilmiştir:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Ağın eğitimi
Bir modeli eğitmenin en büyük sorunlarından biri aşırı uyumdur; bu nedenle, daha iyi genelleme sağladığından emin olmak için eğitim süreci boyunca modeli izlemek kritik önemdedir; bunu yapmanın yollarından biri erken durdurma kavramıdır.
Tüm mantık aşağıda gösterilmiştir:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Model, 256’lık bir yığın boyutuyla 15 epok boyunca eğitilir ve eğitim verilerinin %20’si modelin doğrulanması için kullanılır.
Model eğitildikten sonra, eğitim ve doğrulama performans geçmişi aşağıda çizilmiştir.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()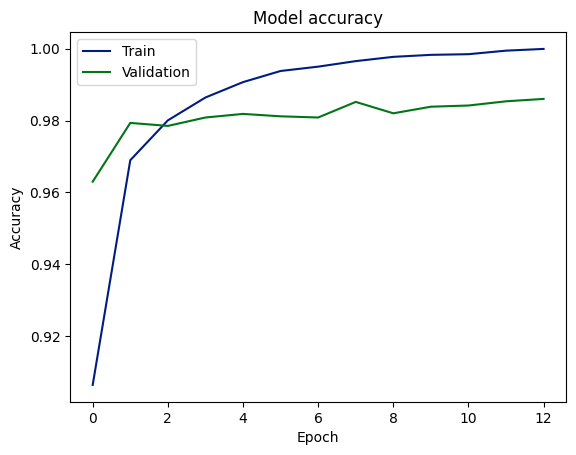
Eğitim ve doğrulama doğruluk puanları
Test verisi üzerinde değerlendirme
Artık model performansını, modelin evaluate işlevini kullanarak test verisi üzerinde değerlendirebiliriz.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))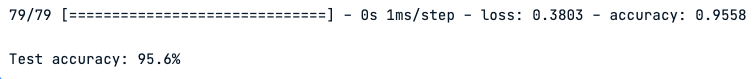
Test verisi üzerindeki model performansı
Grafik, modelin sonuçları yüksek doğrulukla tahmin etmeyi öğrendiğini, hem doğrulama hem de test veri kümelerinde yaklaşık %98’e ulaştığını gösteriyor. Bu, eğitimden görülmemiş verilere iyi genelleme yapıldığını düşündürür. Ancak eğitim ve doğrulama doğruluğu arasındaki fark, aşırı uyumun bir işareti olabilir; yine de doğrulama ve test doğruluğu arasındaki tutarlılık bu endişeyi hafifletebilir.
Öneri
Model yüksek doğruluk ve genelleme yetenekleri gösterse de hâlâ iyileştirme alanı vardır; performansı daha da artırmak için aşağıda bazı uygulanabilir adımlar yer alır.
- Düzenlileştirme: Aşırı uyumu azaltmak için düzenlileştirme yöntemlerini entegre edin.
- Erken Durdurma: Aşırı uyumu önlemek için eğitim sırasında erken durdurmayı kullanın.
- Hata Analizi: Yanlış tahminleri analiz ederek altta yatan sorunları belirleyip düzeltin.
- Çeşitlilik Testi: Sağlamlığını doğrulamak için modeli farklı veri kümeleri üzerinde test edin.
- Daha Geniş Ölçütler: Özellikle veri dengesizse kapsamlı bir performans değerlendirmesi için kesinlik, duyarlılık ve F1 skorunu kullanın.
Sonuç
Özetle, bu makale, makine öğrenmesi alanındaki temel bir teknik olan geri yayılıma kapsamlı bir bakış sunmuştur. Geri yayılımın ne olduğuna dair net bir tanımla başladık ve yapay zekânın gelişimindeki kritik rolünü özetledik.
Ardından, geri yayılımın işleyişine ve geliştirilmiş öğrenme verimliliği gibi bazı avantajlarına dalarken, karşılaştığı sınırlamaları ve zorlukları da kabul ettik.
Sonrasında, ileri yayılımın önemini vurgulayarak sinir ağlarının kurulumu ve inşasına ilişkin ayrıntılı rehberlik sağladık.
Son bölümlerde ise, öğrenme sürecini iyileştirmek için gerekli olan deltaların hesaplanması ve ağ ağırlıklarının güncellenmesi adımlarını inceledik.
Genel olarak, bu makale, sinir ağlarında geri yayılımı anlamak ve etkili bir şekilde uygulamak isteyen herkes için değerli bir kaynak niteliğindedir.
Derin öğrenme becerilerinizi güçlendirmeye hevesli misiniz? PyTorch ile Derin Öğrenme kursumuz, sinir ağlarına daha derinlemesine dalma ve bilginizi ilerletme konusunda güven kazanmanıza yardımcı olacaktır.




