El backpropagation es una pieza clave del entrenamiento moderno de redes neuronales: permite que estos algoritmos aprendan a partir de conjuntos de datos y mejoren con el tiempo.
Comprender y dominar el algoritmo de backpropagation es esencial para cualquiera que trabaje con redes neuronales y deep learning. Este tutorial ofrece una exploración en profundidad de este método.
Empieza explicando qué es el backpropagation y cómo funciona, junto con sus ventajas y limitaciones, y luego pasa a una experiencia práctica aplicándolo a un conjunto de datos muy utilizado.
¿Qué es el backpropagation?
Introducido en la década de 1970, el algoritmo de backpropagation ajusta los pesos de una red neuronal en función del error obtenido en la iteración o época anterior; es el método estándar para entrenar redes neuronales artificiales.
Puedes verlo como un sistema de retroalimentación donde, tras cada ronda de entrenamiento o "época", la red revisa su rendimiento en las tareas. Calcula la diferencia entre su salida y la respuesta correcta (el error) y después ajusta sus parámetros internos, o "pesos", para reducir ese error la próxima vez. Este método es esencial para afinar la precisión de la red y es la base para que aprenda a hacer mejores predicciones o tomar mejores decisiones.
¿Cómo funciona el backpropagation?
Ahora que ya sabes qué es el backpropagation, veamos cómo funciona. A continuación tienes una ilustración del algoritmo aplicado a una red neuronal con:
- Dos entradas X1 y X2
- Dos capas ocultas N1X y N2X, donde X toma los valores 1, 2 y 3
- Una capa de salida
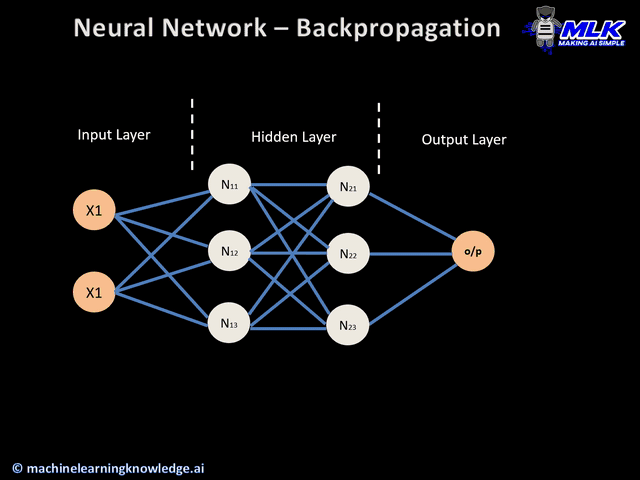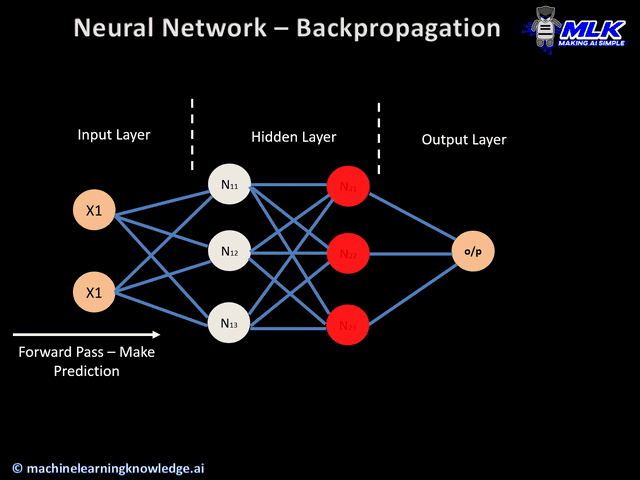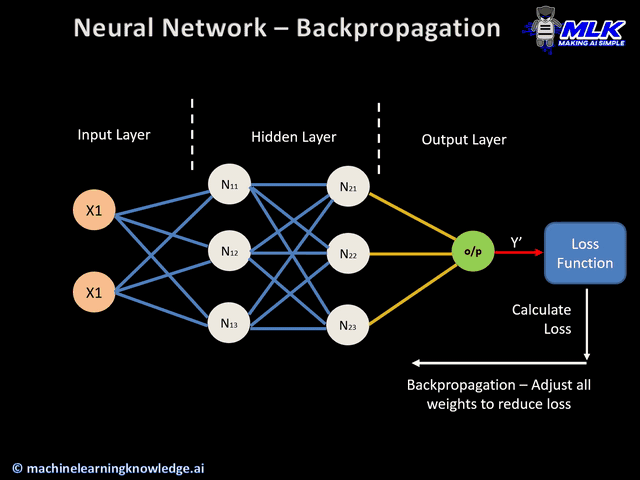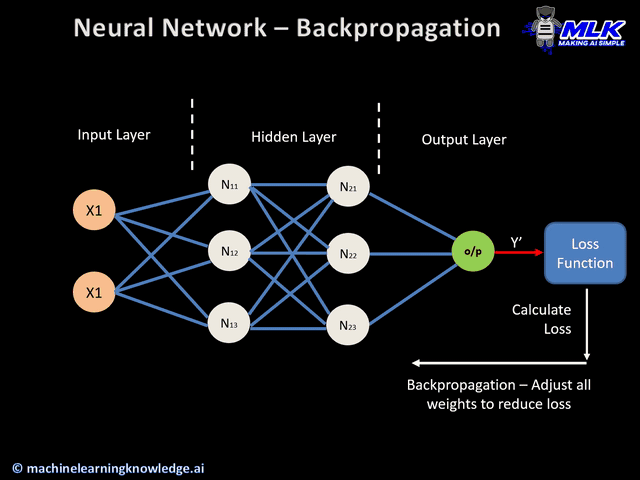
Ilustración de backpropagation (fuente: machinelearningknowledge)
En términos generales, el algoritmo consta de cuatro pasos principales:
- Paso hacia delante (forward pass)
- Cálculo del error
- Paso hacia atrás (backward pass)
- Actualización de pesos
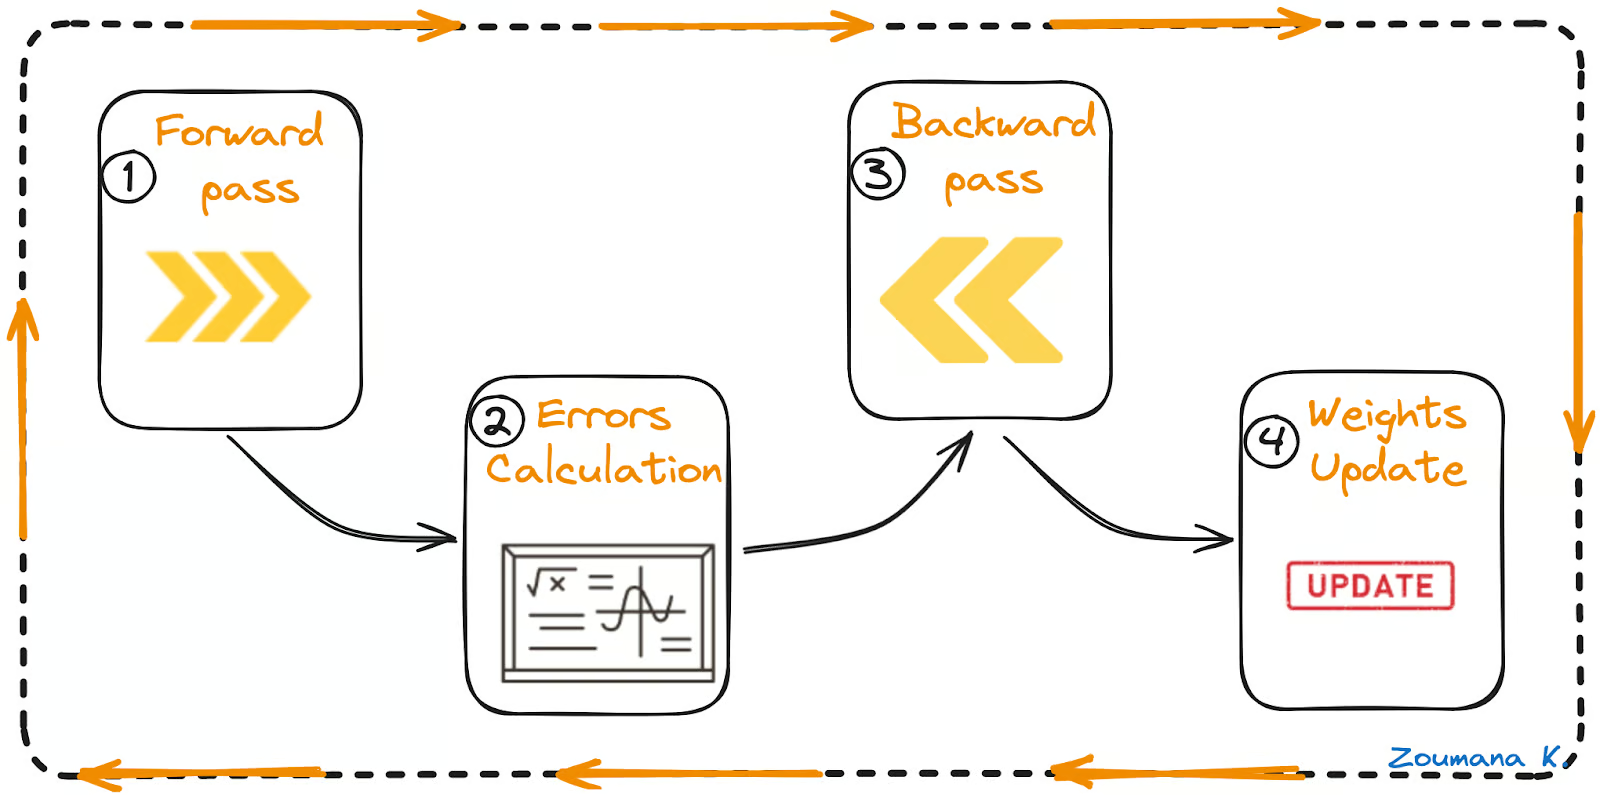
Forward pass, cálculo del error, backward pass y actualización de pesos
Veamos cada uno de estos pasos a partir de la animación anterior.
Forward pass
Es el primer paso del proceso de backpropagation y se ilustra así:
- Los datos (entradas X1 y X2) se introducen en la capa de entrada.
- Cada entrada se multiplica por su peso correspondiente y los resultados se pasan a las neuronas N1X y N2X de las capas ocultas.
- Esas neuronas aplican una función de activación a las entradas ponderadas que reciben y el resultado pasa a la siguiente capa.
Cálculo del error
- El proceso continúa hasta que la capa de salida genera la salida final (o/p).
- La salida de la red se compara con la verdad de terreno (salida deseada) y se calcula la diferencia, obteniendo así un valor de error.
Backward pass
Este es el paso de backpropagation propiamente dicho y no puede realizarse sin los pasos previos de forward y cálculo del error. Así funciona:
- El valor de error obtenido se usa para calcular el gradiente de la función de pérdida.
- El gradiente del error se propaga hacia atrás por la red, desde la capa de salida hacia las capas ocultas.
- A medida que el gradiente se propaga hacia atrás, los pesos (las líneas que conectan los nodos) se actualizan según su contribución al error. Esto implica tomar la derivada del error con respecto a cada peso, lo que indica cuánto cambiaría el error si modificamos ese peso.
- La tasa de aprendizaje determina el tamaño de las actualizaciones. Una tasa más pequeña implica cambios de peso más pequeños, y viceversa.
Actualización de pesos
- Los pesos se actualizan en la dirección opuesta al gradiente; de ahí el nombre "descenso por gradiente". El objetivo es reducir el error en el siguiente forward pass.
- Este ciclo de forward pass, cálculo del error, backward pass y actualización de pesos se repite durante múltiples épocas hasta que el rendimiento de la red alcanza un nivel satisfactorio o deja de mejorar de forma significativa.
Ventajas del backpropagation
El backpropagation es una técnica fundamental en el entrenamiento de redes neuronales, muy valorada por su implementación directa, su sencillez de programación y su versatilidad en múltiples arquitecturas.
Nuestro tutorial Building Neural Network (NN) Models in R es un gran punto de partida para quien quiera aprender sobre redes neuronales. Enseña a crear un modelo de red neuronal en R.
Para quienes programan en Python, el tutorial Recurrent Neural Network Tutorial (RNN) ofrece una guía completa sobre el popular modelo de deep learning RNN, con práctica construyendo un predictor del precio de la acción de MasterCard.
Ahora, desarrollemos cada una de las ventajas mencionadas:
- Facilidad de implementación: accesible a través de múltiples librerías de deep learning como Pytorch y Keras, lo que facilita su uso en aplicaciones muy diversas.
- Simplicidad de programación: código simplificado gracias a la abstracción de los frameworks, reduciendo la necesidad de matemáticas complejas.
- Flexibilidad: se adapta a arquitecturas variadas y es adecuada para un amplio abanico de retos de IA.
Limitaciones y desafíos
A pesar del éxito del algoritmo de backpropagation, no está exento de limitaciones que pueden afectar a la eficiencia y la eficacia del entrenamiento de una red neuronal. Veamos algunas de ellas:
- Calidad de los datos: datos de mala calidad (ruido, incompletitud o sesgo) pueden generar modelos inexactos, ya que el backpropagation aprende exactamente de lo que se le da.
- Duración del entrenamiento: a menudo requiere tiempos de entrenamiento extensos, lo que puede ser poco práctico con redes grandes.
- Complejidad basada en matrices: las operaciones matriciales escalan con el tamaño de la red, lo que aumenta la demanda computacional y puede superar los recursos disponibles.
Implementación de backpropagation
Con todo lo visto, pasamos a su aplicación en un escenario real: implementaremos una red neuronal para reconocer dígitos escritos a mano del conjunto de datos MNIST.
Esta sección cubre todos los pasos, desde la visualización de datos hasta el entrenamiento y la evaluación del modelo. El código completo está disponible en este workbook de DataLab; puedes crear tu propia copia y ejecutar el código en el navegador, sin instalar nada en tu ordenador.
Sobre el conjunto de datos
El conjunto de datos MNIST es muy utilizado en reconocimiento de imágenes. Consta de 70 000 imágenes en escala de grises de dígitos del 0 al 9, y cada imagen mide 28x28 píxeles.
Está disponible en la función mnist del módulo Keras.datasets y se carga así tras importar la librería mnist:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Análisis exploratorio de datos
El análisis exploratorio de datos es un paso clave antes de construir cualquier modelo de machine learning o deep learning, porque ayuda a entender mejor la naturaleza de los datos y orienta en la elección del tipo de modelo.
Las tareas principales incluyen:
- Identificar el número total de datos en los conjuntos de entrenamiento y de prueba.
- Visualizar aleatoriamente algunos dígitos del conjunto de entrenamiento.
- Visualizar la distribución de las etiquetas del conjunto de entrenamiento.
El conjunto completo tiene 70 000 imágenes. Una partición típica del conjunto original suele ser como sigue (no hay una regla fija):
- 70% u 80% para entrenamiento
- 30% o 20% para prueba
A veces incluso 90% para entrenamiento y 10% para prueba.
En nuestro caso, ambos conjuntos ya vienen cargados, así que no hay que partirlos. Veamos su tamaño.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")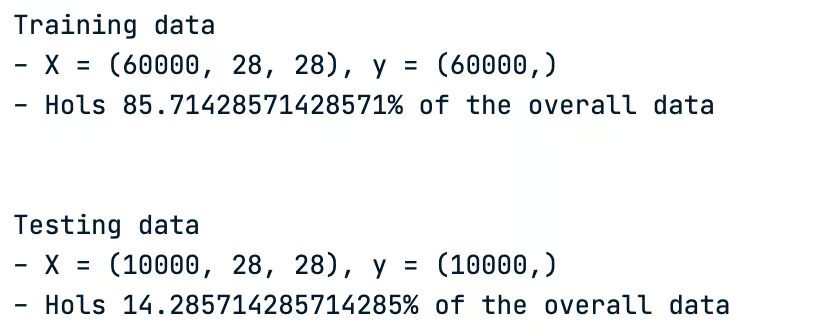
Características de los conjuntos de entrenamiento y prueba
- El conjunto de entrenamiento tiene 60 000 imágenes y corresponde al 85,71% del conjunto original.
- El conjunto de prueba tiene las 10 000 imágenes restantes (14,28% del total).
Ahora, visualicemos algunos dígitos aleatorios. Lo haremos con la función auxiliar plot_images, que recibe dos parámetros principales:
- El número de imágenes a representar, y
- El conjunto de datos a usar para la visualización
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Queremos ver nueve imágenes del conjunto de entrenamiento, lo que se consigue con este fragmento:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Al ejecutar el código anterior se generan los nueve dígitos siguientes.
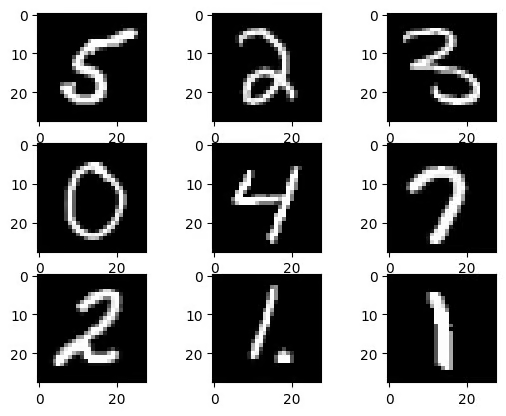
Nueve imágenes aleatorias del conjunto de entrenamiento
Si ejecutas la misma función por segunda vez, verás dígitos distintos debido a la naturaleza aleatoria de la función auxiliar.
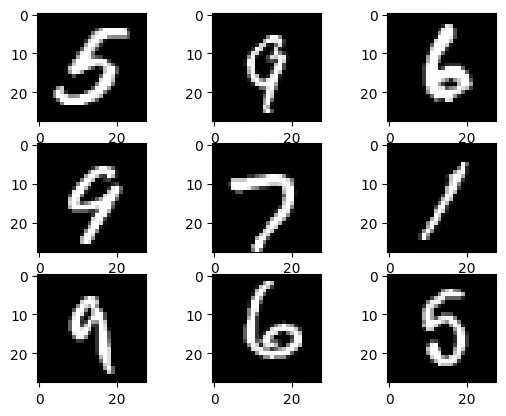
Nueve imágenes aleatorias del conjunto de entrenamiento tras una segunda ejecución
La última tarea del análisis es visualizar la distribución de las etiquetas del conjunto de entrenamiento con la función auxiliar plot_labels_distribution.
- En el eje X aparecen todos los dígitos posibles.
- En el eje Y, el número total de ocurrencias de cada dígito.
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
Aplicamos la función al conjunto de entrenamiento pasando sus etiquetas así:
plot_labels_distribution(train_labels)El resultado muestra que los diez dígitos están casi uniformemente distribuidos en todo el conjunto, una buena señal: no hace falta equilibrar las etiquetas.
Preprocesamiento de datos
Los datos del mundo real suelen requerir preprocesamiento para que sean aptos para el entrenamiento. Aplicaremos tres tareas principales tanto a las imágenes de entrenamiento como a las de prueba:
- Normalización: convertir todos los valores de píxeles de 0-255 a 0-1 para acelerar la convergencia durante el entrenamiento.
- Reformateo: en lugar de una matriz 28x28 por imagen, aplanamos cada una a vectores de 784 elementos para ajustarla a las entradas de la red.
- Codificación de etiquetas: convertir las etiquetas a vectores one-hot. Evita problemas de jerarquía numérica que podrían sesgar el modelo hacia dígitos mayores.
La lógica de preprocesamiento se implementa en la función auxiliar preprocess_data:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
Aplicamos la función a los conjuntos con estos fragmentos:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Ahora, comprobemos los valores máximos y mínimos de píxel en ambos conjuntos:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
El resultado confirma que la normalización se ha realizado correctamente.
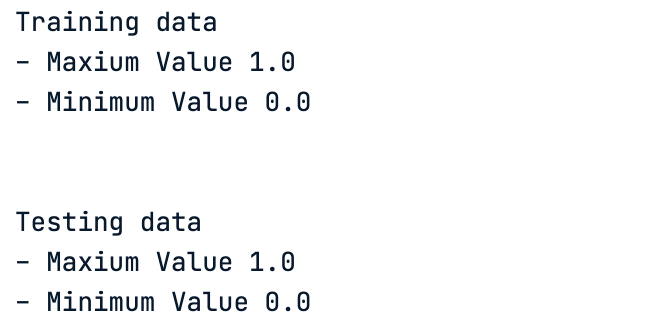
Valores mínimos y máximos de píxel tras la normalización
De forma análoga a las etiquetas, obtenemos finalmente una matriz de unos y ceros que corresponde a los valores one-hot codificados.
# One hot encoding of the test data labels
test_images
Resultado:
One-hot encoding de las etiquetas de prueba
# One hot encoding of the train data labels
train_labels
One-hot encoding de las etiquetas de entrenamiento
Estructura de la red
Como se trata de una tarea de clasificación de imágenes, una red neuronal convolucional se adapta especialmente bien. Antes de programar nada, conviene definir la arquitectura del modelo; de eso trata esta sección.
Si quieres saber más sobre redes neuronales convolucionales, nuestro tutorial An Introduction to Convolutional Neural Networks (CNNs) es un gran recurso inicial. Ofrece una guía completa para entender las CNN, su impacto en el análisis de imágenes y estrategias clave para combatir el sobreajuste.
La arquitectura para este caso combina distintos tipos de capas para una clasificación eficaz. Componentes clave del modelo:
- Capa convolucional: comienza con un filtro de 3x3 y 32 filtros para procesar las imágenes.
- Capa de max pooling: después de la convolución, incluye una capa de max pooling para reducir el tamaño de los mapas de características.
- Flatten: aplana la salida de la capa de pooling a un vector único, preparándola para la clasificación.
- Capa densa: añade una capa densa con 100 nodos entre la salida aplanada y la capa final para interpretar las características extraídas.
- Capa de salida: usa una capa de salida con 10 nodos, correspondientes a las 10 categorías. Cada nodo calcula la probabilidad de pertenencia a una de ellas.
- Activación softmax: en la capa de salida, aplica softmax para la clasificación multiclase.
- Función de activación ReLU: utiliza ReLU (Rectified Linear Unit) en todas las capas para introducir no linealidad.
- Optimizador: emplea descenso por gradiente estocástico con tasa de aprendizaje 0,001 y momentum 0,95 para ajustar el modelo durante el entrenamiento.
- Función de pérdida: usa entropía cruzada categórica, ideal para clasificación multiclase.
- Métrica de precisión: céntrate en la precisión de clasificación, dado que las clases están equilibradas.
Todo esto se implementa en la función auxiliar define_network_architecture. Antes, importa las librerías necesarias:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Implementación de la función auxiliar:
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
El código está bien, pero aún mejor si contamos con una visualización gráfica de la red, algo que conseguimos con la función plot_model del módulo keras.utils.vis_utils.
Primero, genera la red con la función auxiliar.
network = define_network_architecture()Luego muestra la representación gráfica. Primero guardamos el resultado en un PNG antes de visualizarlo; así es más fácil compartirlo.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
El resultado se muestra a continuación.
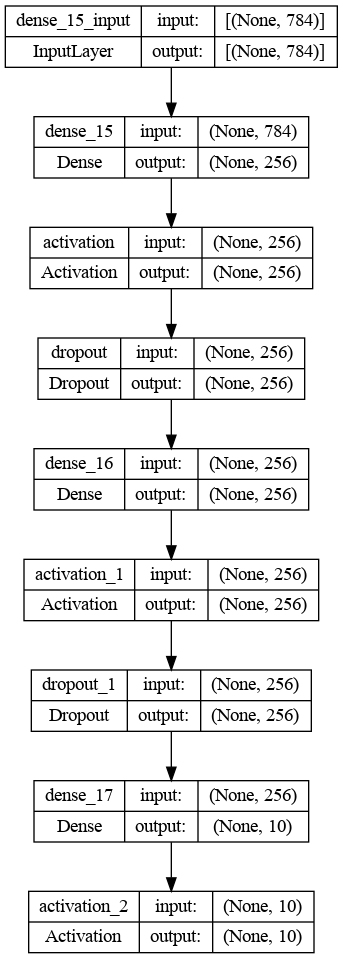
Arquitectura gráfica de la red neuronal convolucional
Cálculo del delta
Antes de pasar al entrenamiento del modelo, entendamos cómo se calcula la distribución del error delta usando la arquitectura de la red.
La distribución del error delta es la derivada de la función de pérdida respecto a la activación de cada nodo e indica cuánto ha contribuido la activación de cada nodo al error final.
La arquitectura anterior consta de tres capas principales:
- Capa de entrada con 784 unidades (una imagen 28x28)
- Capa oculta con 512 unidades y activación ReLU
- Capa de salida con 10 unidades (número de etiquetas únicas) y activación softmax
Ahora, avancemos con el cálculo del error delta en cada capa.
Capa de salida
Consideremos la salida de la capa softmax como O y las etiquetas verdaderas como Y. Usando la pérdida de entropía cruzada, el error delta es:
δ output = O - Y
Esta fórmula surge del cálculo de cómo cambia la entropía cruzada cuando cambia la salida del softmax.
Capa oculta
Para la capa oculta, el error delta δ hidden depende del error de la capa siguiente (la de salida) y de la derivada de la función ReLU.
La derivada de ReLU es 1 para entradas positivas y 0 para negativas, como se muestra a continuación.
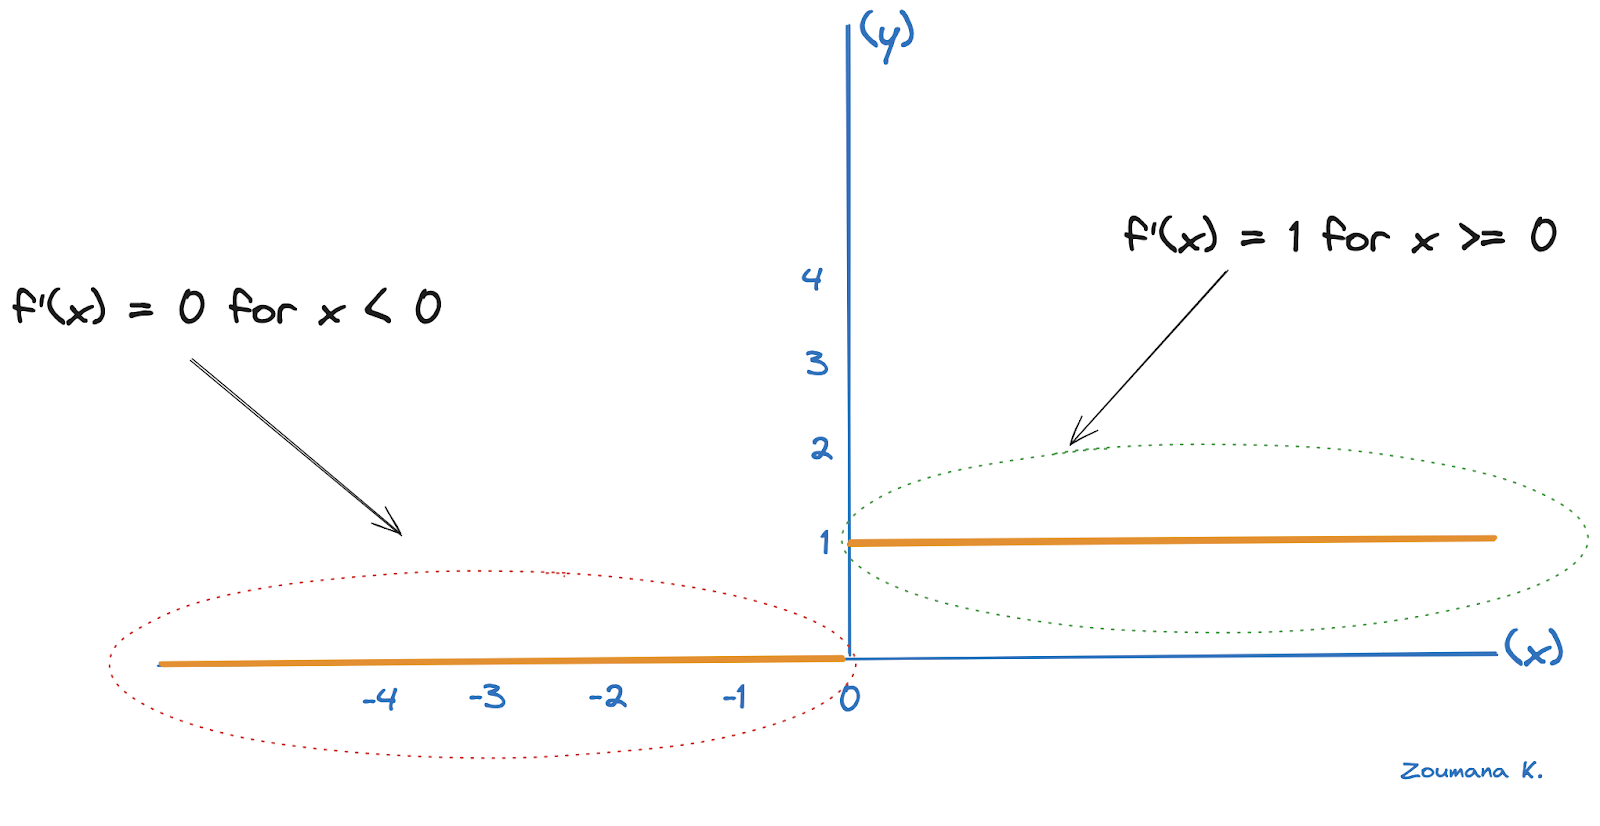
Ilustración de la derivada de ReLU
Sea Zhidden la entrada a ReLU en la capa oculta y Woutput los pesos que conectan la capa oculta con la de salida. Entonces:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- El punto "." denota multiplicación matricial.
- El símbolo ⊙ indica multiplicación elemento a elemento.
- ReLU’(Zhidden) es la derivada de ReLU en Zhidden.
Capa de entrada
De forma similar, si hubiera más capas ocultas, el proceso continuaría hacia atrás: el delta de cada capa depende del delta de la siguiente y de la derivada de su función de activación.
En general, para cualquier capa k de la red (excepto la de salida), la fórmula del delta es:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 es la traspuesta de la matriz de pesos de la capa siguiente.
- f’ es la derivada de la función de activación de la capa k.
- Zk es la entrada a la función de activación en la capa k.
Compilación de la red
Con este entendimiento del cálculo del error, compilamos la red para optimizar su estructura de cara al entrenamiento.
Durante la compilación hay que tomar varias decisiones críticas:
- Algoritmo de optimización: elegir un algoritmo de descenso por gradiente. Hay varias opciones, como Stochastic Gradient Descent (SGD), Adagrad y RMSprop, que es el que se usa en este artículo.
- Función de pérdida: también llamada función de coste, cuantifica el rendimiento de la red. Debe alinearse con la naturaleza del problema (clasificación o regresión). Aquí usamos entropía cruzada categórica por tratarse de multiclase.
- Métrica de rendimiento: aunque similar a la pérdida, se usa principalmente para evaluar la eficacia del modelo en el conjunto de prueba. Usaremos la precisión.
El código para estas tres elecciones es el siguiente:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Entrenamiento de la red
Uno de los mayores problemas al entrenar un modelo es el sobreajuste, por lo que es crucial monitorizarlo durante el entrenamiento para asegurar una buena generalización; una forma de hacerlo es con early stopping.
La lógica completa se muestra a continuación:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
El modelo se entrena durante 15 épocas con un tamaño de lote de 256, y el 20% de los datos de entrenamiento se usa para validación.
Tras el entrenamiento, representamos la evolución de las métricas de entrenamiento y validación.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()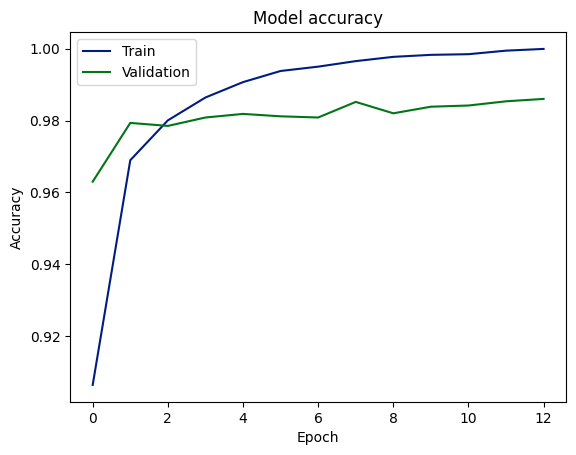
Precisión en entrenamiento y validación
Evaluación en los datos de prueba
Ahora podemos evaluar el rendimiento del modelo en el conjunto de prueba con la función evaluate del modelo.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))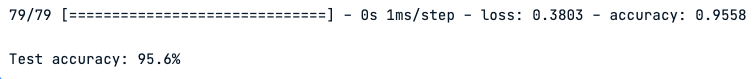
Rendimiento del modelo en el conjunto de prueba
El gráfico indica que el modelo ha aprendido a predecir con alta precisión, en torno al 98% tanto en validación como en prueba. Esto sugiere una buena generalización de los datos de entrenamiento a datos no vistos. Sin embargo, la diferencia entre precisión de entrenamiento y validación podría apuntar a cierto sobreajuste, aunque la consistencia entre validación y prueba mitiga esta preocupación.
Recomendaciones
Aunque el modelo muestra alta precisión y buena generalización, aún se puede mejorar. Algunas acciones recomendadas:
- Regularización: integra métodos de regularización para reducir el sobreajuste.
- Early stopping: utilízalo durante el entrenamiento para evitar sobreajuste.
- Análisis de errores: estudia las predicciones erróneas para detectar y corregir problemas de fondo.
- Pruebas con diversidad: evalúa el modelo en conjuntos variados para confirmar su robustez.
- Métricas adicionales: usa precisión, recall y F1 para una evaluación más completa, especialmente si los datos están desbalanceados.
Conclusión
En resumen, este artículo ha ofrecido una visión completa del backpropagation, una técnica esencial en machine learning. Empezamos con una definición clara y destacamos su papel crítico en el avance de la inteligencia artificial.
Después, profundizamos en su funcionamiento y en algunas de sus ventajas, como la mejora de la eficiencia del aprendizaje, sin obviar las limitaciones y desafíos que presenta.
A continuación, proporcionamos una guía detallada para configurar y construir redes neuronales, haciendo hincapié en la importancia de la propagación hacia delante.
Por último, exploramos los pasos de cálculo de deltas y actualización de pesos, fundamentales para perfeccionar el proceso de aprendizaje.
En conjunto, este artículo es un recurso útil para cualquiera que quiera entender e implementar con solvencia el backpropagation en redes neuronales.
¿Quieres reforzar tus habilidades en deep learning? Nuestro curso Deep Learning with PyTorch te ayudará a ganar confianza para profundizar en redes neuronales y seguir avanzando.