बैकप्रोपेगेशन में महारत: न्यूरल नेटवर्क्स के लिए एक व्यापक मार्गदर्शिका
छवि वर्गीकरण उपयोग-परिदृश्य के लिए मॉडल को प्रशिक्षित और मूल्यांकन करने की व्यावहारिक गाइड के साथ न्यूरल नेटवर्क्स में बैकप्रोपेगेशन के मूल तत्वों में गहराई से उतरें।
बैकप्रोपेगेशन आधुनिक न्यूरल नेटवर्क प्रशिक्षण का एक अनिवार्य हिस्सा है, जो इन उन्नत एल्गोरिदम को प्रशिक्षण डाटासेट से सीखने और समय के साथ बेहतर बनने में सक्षम बनाता है।
न्यूरल नेटवर्क और डीप लर्निंग के क्षेत्र में किसी के लिए भी बैकप्रोपेगेशन एल्गोरिदम को समझना और उस पर अधिकार पाना अत्यंत महत्वपूर्ण है। यह ट्यूटोरियल बैकप्रोपेगेशन की गहन पड़ताल प्रस्तुत करता है।
यह पहले बताता है कि बैकप्रोपेगेशन क्या है और यह कैसे काम करता है, साथ ही इसके लाभ और सीमाएँ, और फिर इसे व्यापक रूप से प्रयुक्त डाटासेट पर लागू करने के व्यावहारिक अनुभव में ले जाता है।
बैकप्रोपेगेशन क्या है?
1970 के दशक में प्रस्तुत, बैकप्रोपेगेशन एल्गोरिदम पिछली पुनरावृत्ति या युग (epoch) में प्राप्त त्रुटि दर के अनुरूप न्यूरल नेटवर्क के वेट्स को फाइन-ट्यून करने की विधि है, और यह कृत्रिम न्यूरल नेटवर्क्स को प्रशिक्षित करने की मानक विधि है।
आप इसे एक फीडबैक सिस्टम की तरह समझ सकते हैं, जहाँ प्रत्येक प्रशिक्षण चरण या 'epoch' के बाद नेटवर्क अपने कार्य-प्रदर्शन की समीक्षा करता है। यह अपने आउटपुट और सही उत्तर के बीच के अंतर की गणना करता है, जिसे त्रुटि कहा जाता है। फिर यह अपनी आंतरिक पैरामीटर्स यानी 'वेट्स' को समायोजित करता है ताकि अगली बार यह त्रुटि कम हो सके। यह तरीका नेटवर्क की शुद्धता को ट्यून करने के लिए आवश्यक है और बेहतर भविष्यवाणी या निर्णय लेने के लिए एक बुनियादी रणनीति है।
बैकप्रोपेगेशन कैसे काम करता है?
अब जब आपको पता है कि बैकप्रोपेगेशन क्या है, तो आइए देखें कि यह काम कैसे करता है। नीचे दिए गए चित्र में बैकप्रोपेगेशन एल्गोरिदम को जिस न्यूरल नेटवर्क पर लागू किया गया है, उसमें हैं:
दो इनपुट X1 और X2
दो हिडन लेयर N1X और N2X, जहाँ X के मान 1, 2 और 3 हैं
एक आउटपुट लेयर
बैकप्रोपेगेशन का चित्रण (स्रोत: machinelearningknowledge)
बैकप्रोपेगेशन एल्गोरिदम के कुल मिलाकर चार मुख्य चरण होते हैं:
फॉरवर्ड पास
त्रुटि की गणना
बैकवर्ड पास
वेट्स अपडेट
फॉरवर्ड पास, त्रुटि गणना, बैकवर्ड पास, और वेट्स अपडेट
आइए ऊपर दी गई एनीमेशन से इन प्रत्येक चरणों को समझें।
फॉरवर्ड पास
यह बैकप्रोपेगेशन प्रक्रिया का पहला चरण है, और इसे नीचे दर्शाया गया है:
डेटा (इनपुट X1 और X2) को इनपुट लेयर में भेजा जाता है
फिर, प्रत्येक इनपुट को उसके संबंधित वेट से गुणा किया जाता है, और परिणाम हिडन लेयर्स के न्यूरॉन्स N1X और N2X तक भेजे जाते हैं।
ये न्यूरॉन्स प्राप्त वेटेड इनपुट्स पर एक एक्टिवेशन फंक्शन लागू करते हैं, और परिणाम अगली लेयर को भेज दिया जाता है।
त्रुटि की गणना
प्रक्रिया तब तक जारी रहती है जब तक आउटपुट लेयर अंतिम आउटपुट (o/p) उत्पन्न नहीं कर देती।
नेटवर्क के आउटपुट की तुलना ग्राउंड ट्रुथ (वांछित आउटपुट) से की जाती है, और अंतर की गणना कर एक त्रुटि मान प्राप्त किया जाता है।
बैकवर्ड पास
यह वास्तविक बैकप्रोपेगेशन चरण है, और इसे ऊपर दिए गए फॉरवर्ड और त्रुटि-गणना चरणों के बिना नहीं किया जा सकता। यह इस प्रकार काम करता है:
पहले प्राप्त त्रुटि मान का उपयोग लॉस फंक्शन के ग्रेडिएंट की गणना के लिए किया जाता है।
त्रुटि का ग्रेडिएंट नेटवर्क में आउटपुट लेयर से हिडन लेयर्स की ओर पीछे की दिशा में प्रवाहित किया जाता है।
जैसे-जैसे त्रुटि ग्रेडिएंट पीछे की ओर फैलता है, वेट्स (जो नोड्स को जोड़ने वाली रेखाओं द्वारा दर्शाए जाते हैं) को त्रुटि में उनके योगदान के अनुसार अपडेट किया जाता है। इसमें प्रत्येक वेट के संबंध में त्रुटि का अवकलन लेना शामिल है, जो यह दर्शाता है कि वेट में बदलाव से त्रुटि कितनी बदलेगी।
लर्निंग रेट वेट अपडेट्स के आकार को निर्धारित करता है। छोटा लर्निंग रेट होने पर वेट्स में छोटे बदलाव होते हैं, और इसके विपरीत।
वेट्स अपडेट
वेट्स को ग्रेडिएंट की विपरीत दिशा में अपडेट किया जाता है, जिसे ही “ग्रेडिएंट डिसेंट” नाम मिला है। इसका उद्देश्य अगले फॉरवर्ड पास में त्रुटि को कम करना है।
फॉरवर्ड पास, त्रुटि गणना, बैकवर्ड पास और वेट्स अपडेट की यह प्रक्रिया कई epochs तक चलती है, जब तक कि नेटवर्क का प्रदर्शन संतोषजनक स्तर तक न पहुँच जाए या महत्वपूर्ण रूप से सुधारना बंद न कर दे।
बैकप्रोपेगेशन के लाभ
बैकप्रोपेगेशन न्यूरल नेटवर्क प्रशिक्षण में एक आधारभूत तकनीक है, जो अपने सीधे-सादे इम्प्लीमेंटेशन, प्रोग्रामिंग की सहजता और अनेक नेटवर्क आर्किटेक्चर में बहुउद्देश्यीय उपयोगिता के लिए व्यापक रूप से सराही जाती है।
हमारा R में न्यूरल नेटवर्क (NN) मॉडल बनाना ट्यूटोरियल किसी भी व्यक्ति के लिए एक शानदार शुरुआती बिंदु है जो न्यूरल नेटवर्क के बारे में सीखना चाहता है। यह R में एक न्यूरल नेटवर्क मॉडल बनाना सिखाता है।
Python प्रोग्रामर्स के लिए, रीकरेंट न्यूरल नेटवर्क (RNN) ट्यूटोरियल सबसे लोकप्रिय डीप लर्निंग मॉडल RNN पर एक व्यापक गाइड प्रदान करता है, जिसमें MasterCard स्टॉक प्राइस प्रेडिक्टर बनाकर हैंड्स-ऑन अनुभव शामिल है।
अब, आइए पहले बताए गए प्रत्येक लाभ पर थोड़ा विस्तार करें:
लागू करने में सहज: Pytorch और Keras जैसी कई डीप लर्निंग लाइब्रेरीज़ के माध्यम से सुलभ, जो विविध अनुप्रयोगों में इसके उपयोग को सरल बनाती हैं।
प्रोग्रामिंग की सरलता: फ्रेमवर्क एब्स्ट्रैक्शन के साथ सरल कोडिंग, जिससे जटिल गणित की आवश्यकता कम हो जाती है।
लचीलापन: विविध आर्किटेक्चर में अनुकूलनीय, जो एआई की व्यापक चुनौतियों के लिए उपयुक्त है।
सीमाएँ और चुनौतियाँ
बैकप्रोपेगेशन एल्गोरिदम की सफलता के बावजूद, इसमें कुछ सीमाएँ हैं, जो न्यूरल नेटवर्क के प्रशिक्षण प्रक्रिया की दक्षता और प्रभावशीलता को प्रभावित कर सकती हैं। आइए कुछ बाधाओं का अन्वेषण करें:
डेटा की गुणवत्ता: खराब डेटा गुणवत्ता—जैसे शोर, अपूर्णता, या पक्षपात—गलत मॉडलों की ओर ले जा सकती है, क्योंकि बैकप्रोपेगेशन वही सीखता है जो उसे दिया जाता है।
प्रशिक्षण की अवधि: बैकप्रोपेगेशन को अक्सर लंबे प्रशिक्षण समय की आवश्यकता होती है, जो बड़े नेटवर्क के साथ अव्यावहारिक हो सकता है।
मैट्रिक्स-आधारित जटिलता: बैकप्रोपेगेशन में मैट्रिक्स ऑपरेशंस नेटवर्क के आकार के साथ स्केल करते हैं, जिससे संगणनात्मक मांग बढ़ती है और उपलब्ध संसाधनों से आगे निकल सकती है।
बैकप्रोपेगेशन का इम्प्लीमेंटेशन
बैकप्रोपेगेशन एल्गोरिदम के बारे में इन सभी अंतर्दृष्टियों के साथ, अब वास्तविक दुनिया के परिदृश्य में इसके अनुप्रयोग में उतरने का समय है—MNIST डाटासेट से हस्तलिखित अंकों को पहचानने के लिए एक न्यूरल नेटवर्क का इम्प्लीमेंटेशन।
यह भाग डेटा विज़ुअलाइज़ेशन से लेकर मॉडल प्रशिक्षण और मूल्यांकन तक सभी चरणों को कवर करता है। संपूर्ण सोर्स कोड इस DataLab वर्कबुक में उपलब्ध है; आप अपने ब्राउज़र में कोड चलाने के लिए आसानी से इसकी एक प्रति बना सकते हैं, बिना अपने कंप्यूटर पर कुछ भी इंस्टॉल किए।
डाटासेट के बारे में
MNIST डाटासेट छवि पहचान के क्षेत्र में व्यापक रूप से उपयोग किया जाता है। इसमें 0 से 9 तक के हस्तलिखित अंकों की 70000 ग्रेस्केल छवियाँ हैं, और प्रत्येक छवि 28x28 पिक्सेल की है।
यह डाटासेट Keras.datasets मॉड्यूल की mnist फ़ंक्शन में उपलब्ध है, और mnist लाइब्रेरी इम्पोर्ट करने के बाद इसे इस प्रकार लोड किया जाता है:
from keras.datasets import mnist
(train_images, train_labels),(test_images, test_labels)= mnist.load_data()संचालित द्वारा
एक्सप्लोरेटरी डेटा एनालिसिस
किसी भी मशीन लर्निंग या डीप लर्निंग मॉडल के निर्माण से पहले एक्सप्लोरेटरी डेटा एनालिसिस एक प्रमुख चरण है, क्योंकि यह हमारे पास उपलब्ध डेटा की प्रकृति को बेहतर ढंग से समझने में मदद करता है, और इसी के अनुसार प्रयुक्त मॉडल के प्रकार के चयन का मार्गदर्शन करता है।
मुख्य कार्यों में शामिल हैं:
प्रशिक्षण और परीक्षण डाटासेट दोनों में डेटा की कुल संख्या की पहचान करना।
प्रशिक्षण डाटासेट से कुछ अंकों का रैंडम विज़ुअलाइज़ेशन।
प्रशिक्षण डाटासेट के लेबल्स के वितरण का विज़ुअलाइज़ेशन।
कुल डाटासेट 70000 छवियों का है। मूल डाटासेट का सामान्य विभाजन निम्न प्रकार दिया जाता है, और इसके लिए कोई निश्चित thumb नियम नहीं है:
प्रशिक्षण डाटासेट के लिए 70% या 80%
परीक्षण डाटासेट के लिए 30% या 20%
कुछ विभाजन 90% प्रशिक्षण और 10% परीक्षण भी हो सकते हैं।
हमारे परिदृश्य में, प्रशिक्षण और परीक्षण डाटासेट दोनों लोड किए गए हैं, इसलिए विभाजन की आवश्यकता नहीं है। आइए इन डाटासेट्स के आकार का निरीक्षण करें।
print("Training data")print(f"- X = {train_images.shape}, y = {train_labels.shape}")print(f"- Hols {train_images.shape[0]/70000*100}% of the overall data")print("\n")print("Testing data")print(f"- X = {test_images.shape}, y = {test_labels.shape}")print(f"- Hols {test_images.shape[0]/70000*100}% of the overall data")संचालित द्वारा
प्रशिक्षण और परीक्षण डाटासेट्स की विशेषताएँ
प्रशिक्षण डाटासेट में 60000 छवियाँ हैं और यह मूल डाटासेट का 85.71% है।
दूसरी ओर, परीक्षण डाटासेट में शेष 10000 छवियाँ हैं, यानी मूल डाटासेट का 14.28%।
अब, कुछ रैंडम अंकों का विज़ुअलाइज़ेशन करते हैं। यह plot_images सहायक फ़ंक्शन से किया जाता है, जो दो मुख्य पैरामीटर्स लेता है:
प्लॉट की जाने वाली छवियों की संख्या, और
वह डाटासेट जिसे विज़ुअलाइज़ेशन के लिए लिया जाना है
defplot_images(nb_images_to_plot, train_data):# Generate a list of random indices from the training data
random_indices = random.sample(range(len(train_data)), nb_images_to_plot)# Plot each image using the random indicesfor i, idx inenumerate(random_indices):
plt.subplot(330+1+ i)
plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))
plt.show()संचालित द्वारा
हम प्रशिक्षण डेटा से नौ छवियाँ देखना चाहते हैं, जिसके लिए निम्नलिखित कोड स्निपेट है:
nb_images_to_plot =9
plot_images(nb_images_to_plot, train_images)संचालित द्वारा
ऊपर दिए गए कोड के सफल निष्पादन से निम्नलिखित नौ अंक उत्पन्न होते हैं।
प्रशिक्षण डाटासेट से नौ रैंडम छवियाँ
उसी फ़ंक्शन को दूसरी बार चलाने के बाद निम्नलिखित अंक प्रदर्शित होते हैं, और हम देखते हैं कि वे वही नहीं हैं; यह सहायक फ़ंक्शन की रैंडम प्रकृति के कारण है।
फ़ंक्शन को दूसरी बार चलाने के बाद प्रशिक्षण डाटासेट से नौ रैंडम छवियाँ
डेटा विश्लेषण का अंतिम कार्य प्रशिक्षण डाटासेट के लेबल्स के वितरण का विज़ुअलाइज़ेशन करना है, जो plot_labels_distribution सहायक फ़ंक्शन से किया जाता है।
X-अक्ष पर हमारे पास सभी संभावित अंक हैं
Y-अक्ष पर ऐसे अंकों की कुल संख्या है
import numpy as np
defplot_labels_distribution(data_labels):
counts = np.bincount(data_labels)
plt.style.use('seaborn-dark-palette')
fig, ax = plt.subplots(figsize=(10,5))
ax.bar(range(10), counts, width=0.8, align='center')
ax.set(xticks=range(10), xlim=[-1,10], title='Training data distribution')
plt.show()संचालित द्वारा
यह फ़ंक्शन प्रशिक्षण डाटासेट पर इसके लेबल्स देकर इस प्रकार लागू किया जाता है:
नीचे परिणाम दिया गया है, और हम देखते हैं कि सभी दस अंक पूरे डाटासेट में लगभग समान रूप से वितरित हैं, जो अच्छी बात है—इसका मतलब है कि लेबल्स के वितरण को संतुलित करने के लिए किसी अतिरिक्त कार्रवाई की आवश्यकता नहीं है।
डेटा प्रीप्रोसेसिंग
वास्तविक दुनिया के डेटा को आमतौर पर मॉडल प्रशिक्षण के लिए उपयुक्त बनाने हेतु कुछ प्रीप्रोसेसिंग की आवश्यकता होती है। प्रशिक्षण और परीक्षण दोनों छवियों पर तीन मुख्य प्रीप्रोसेसिंग कार्य लागू किए जाते हैं:
इमेज नॉर्मलाइज़ेशन: इसमें सभी पिक्सेल मानों को 0-255 से 0-1 में बदलना शामिल है। यह प्रशिक्षण के दौरान तेज़ कन्वर्जेंस के लिए प्रासंगिक है।
इमेज रीशेपिंग: प्रत्येक छवि के लिए 28x28 के स्क्वेर्ड मैट्रिक्स के बजाय, हम प्रत्येक को 784-एलिमेंट वेक्टर में फ्लैट कर देते हैं ताकि यह न्यूरल नेटवर्क इनपुट्स के लिए उपयुक्त हो जाए।
लेबल एनकोडिंग: लेबल्स को वन-हॉट एनकोडेड वेक्टर्स में बदलें। यह संख्यात्मक पदानुक्रम से उत्पन्न होने वाली समस्याओं से बचाएगा। इस तरह, मॉडल बड़े अंकों की ओर पक्षपाती नहीं होगा।
कुल प्रीप्रोसेसिंग लॉजिक नीचे दिए गए preprocess_data सहायक फ़ंक्शन में इम्प्लीमेंट किया गया है:
from keras.utils import to_categorical
defpreprocess_data(data, label,
vector_size,
grayscale_size):# Normalize to range 0-1
preprocessed_images = data.reshape((data.shape[0],
vector_size)).astype('float32')/ grayscale_size
# One-hot encode the labels
encoded_labels = to_categorical(label)return preprocessed_images, encoded_labelsसंचालित द्वारा
यह फ़ंक्शन निम्नलिखित कोड स्निपेट्स के साथ डाटासेट्स पर लागू किया जाता है:
# Flattening variable
vector_size =28*28
grayscale_size =255
train_size = train_images.shape[0]
test_size = test_images.shape[0]# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
train_labels,
vector_size,
grayscale_size)# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
test_labels,
vector_size,
grayscale_size)संचालित द्वारा
अब, दोनों डाटासेट्स के वर्तमान अधिकतम और न्यूनतम पिक्सेल मानों का अवलोकन करें:
print("Training data")print(f"- Maxium Value {train_images.max()} ")print(f"- Minimum Value {train_images.min()} ")print("\n")print("Testing data")print(f"- Maxium Value {test_images.max()} ")print(f"- Minimum Value {test_images.min()} ")संचालित द्वारा
कोड का परिणाम नीचे दिया गया है, और हम देखते हैं कि नॉर्मलाइज़ेशन सफलतापूर्वक किया गया था।
नॉर्मलाइज़ेशन के बाद न्यूनतम और अधिकतम पिक्सेल मान
इसी तरह, लेबल्स के लिए हमारे पास अंततः 0 और 1 की मैट्रिक्स है, जो उन लेबल्स के वन-हॉट एनकोडेड मानों के अनुरूप है।
# One hot encoding of the test data labels
test_imagesसंचालित द्वारा
परिणाम नीचे:
टेस्ट डेटा लेबल्स का वन-हॉट एनकोडिंग
# One hot encoding of the train data labels
train_labelsसंचालित द्वारा
ट्रेन डेटा लेबल्स का वन-हॉट एनकोडिंग
नेटवर्क की संरचना
चूँकि हम एक इमेज क्लासिफिकेशन कार्य का उपयोग कर रहे हैं, एक कन्वोल्यूशनल न्यूरल नेटवर्क ऐसे परिदृश्य के लिए अधिक उपयुक्त होता है। कुछ भी कोड करने से पहले, मॉडल की आर्किटेक्चर को परिभाषित करना महत्वपूर्ण है—और यही इस अनुभाग का उद्देश्य है।
कन्वोल्यूशनल न्यूरल नेटवर्क्स के बारे में अधिक जानने के लिए, हमारा कन्वोल्यूशनल न्यूरल नेटवर्क्स (CNNs) का परिचय ट्यूटोरियल एक शानदार शुरुआती संसाधन है। यह CNNs को समझने, इमेज एनालिसिस पर उनके प्रभाव, और मजबूत CNN बनाम डीप लर्निंग अनुप्रयोगों के लिए ओवरफिटिंग से निपटने की कुछ प्रमुख रणनीतियों पर एक संपूर्ण गाइड है।
इस उपयोग-प्रकरण के लिए आर्किटेक्चर प्रभावी इमेज क्लासिफिकेशन के लिए विभिन्न प्रकार की लेयर्स को संयोजित करता है। नीचे मॉडल के प्रमुख घटक दिए गए हैं:
कन्वोल्यूशनल लेयर: 3x3 के छोटे फ़िल्टर आकार और 32 फ़िल्टर्स का उपयोग कर छवियों को प्रोसेस करने वाली लेयर से शुरुआत करें।
मैक्स पूलिंग लेयर: कन्वोल्यूशनल लेयर के बाद, फीचर मैप्स के आकार को कम करने के लिए एक मैक्स पूलिंग लेयर शामिल करें।
फ्लैटनिंग: पूलिंग लेयर के आउटपुट को एक सिंगल वेक्टर में फ्लैट करें, ताकि यह क्लासिफिकेशन प्रक्रिया के लिए तैयार हो जाए।
डेंस लेयर: निकाले गए फीचर्स की व्याख्या करने के लिए फ्लैट आउटपुट और अंतिम लेयर के बीच 100 नोड्स वाली एक डेंस लेयर जोड़ें।
आउटपुट लेयर: 10 नोड्स वाली आउटपुट लेयर का उपयोग करें, जो 10 छवि श्रेणियों के अनुरूप है। प्रत्येक नोड इस बात की प्रायिकता निकालता है कि कोई छवि इन श्रेणियों में से किससे संबंधित है।
सॉफ्टमैक्स एक्टिवेशन: आउटपुट लेयर में, मल्टी-क्लास क्लासिफिकेशन के लिए सॉफ्टमैक्स एक्टिवेशन फंक्शन लागू करें।
ReLU एक्टिवेशन फंक्शन: सभी लेयर्स में नॉन-लीनियर प्रोसेसिंग के लिए ReLU (Rectified Linear Unit) एक्टिवेशन फंक्शन का उपयोग करें।
ऑप्टिमाइज़र: प्रशिक्षण के दौरान मॉडल को समायोजित करने के लिए 0.001 लर्निंग रेट और 0.95 मोमेंटम वाले स्टोकेस्टिक ग्रेडिएंट डिसेंट ऑप्टिमाइज़र का उपयोग करें।
लॉस फंक्शन: मल्टी-क्लास क्लासिफिकेशन कार्यों के लिए आदर्श, कैटेगोरिकल क्रॉस-एंट्रॉपी लॉस फंक्शन का उपयोग करें।
एक्युरेसी मेट्रिक: कक्षाओं के संतुलित वितरण को देखते हुए क्लासिफिकेशन एक्युरेसी मेट्रिक पर ध्यान दें।
यह सारी जानकारी define_network_architecture सहायक फ़ंक्शन में इम्प्लीमेंट की गई है। लेकिन उससे पहले, हमें सभी आवश्यक लाइब्रेरीज़ इम्पोर्ट करनी होंगी:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization संचालित द्वारा
यहाँ सहायक फ़ंक्शन का इम्प्लीमेंटेशन है।
hidden_units =256
nb_unique_labels =10
vector_size =784# Assuming a 28x28 input image for exampledefdefine_network_architecture():
network = models.Sequential()
network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))# Input layer
network.add(Dense(512, activation='relu'))# Hidden layer
network.add(Dense(nb_unique_labels, activation='softmax'))return networkसंचालित द्वारा
सोर्स कोड का इम्प्लीमेंटेशन अच्छा है, लेकिन यदि हम नेटवर्क का ग्राफिकल विज़ुअलाइज़ेशन भी देख सकें तो और बेहतर होगा, जिसे keras.utils.vis_utils मॉड्यूल के plot_model फ़ंक्शन से हासिल किया जाता है।
इसके बाद, ग्राफिकल प्रतिनिधित्व प्रदर्शित करें। हम पहले परिणाम को एक PNG फ़ाइल में सेव करते हैं और फिर दिखाते हैं; इससे दूसरों के साथ साझा करना आसान हो जाता है।
import keras.utils.vis_utils
from importlib importreloadreload(keras.utils.vis_utils)from keras.utils.vis_utils import plot_model
import matplotlib.image as mpimg
plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)
img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()संचालित द्वारा
परिणाम नीचे दिखाया गया है।
कन्वोल्यूशनल न्यूरल नेटवर्क की ग्राफिकल आर्किटेक्चर
डेल्टा की गणना
मॉडल के प्रशिक्षण की प्रक्रिया में जाने से पहले, आइए समझें कि नेटवर्क की आर्किटेक्चर का उपयोग करते हुए डेल्टा त्रुटि वितरण कैसे गणना किया जाता है।
डेल्टा त्रुटि वितरण प्रत्येक नोड के एक्टिवेशन फंक्शन के संबंध में लॉस फंक्शन का अवकलज है, और यह संकेत देता है कि अंतिम त्रुटि में प्रत्येक नोड के एक्टिवेशन का कितना योगदान था।
ऊपर दी गई आर्किटेक्चर तीन मुख्य लेयर्स से मिलकर बनी है:
इनपुट लेयर, जिसमें 784 यूनिट्स हैं, जो 28x28 इनपुट इमेज के अनुरूप हैं
512 यूनिट्स वाली हिडन लेयर, जिसमें ReLU एक्टिवेशन है
10 यूनिट्स वाली आउटपुट लेयर, जो सॉफ्टमैक्स एक्टिवेशन फंक्शन के साथ अद्वितीय लेबल्स की संख्या के अनुरूप है
अब, प्रत्येक लेयर के लिए डेल्टा त्रुटि की गणना को आगे बढ़ाते हैं।
आउटपुट लेयर
आइए सॉफ्टमैक्स लेयर के आउटपुट को बड़ा O (O) और सही लेबल्स को Y मानें। क्रॉस-एंट्रॉपी लॉस δoutput का उपयोग करते हुए, डेल्टा त्रुटि बनती है:
δoutput = O - Y
यह सूत्र इस मूल गणना से आता है कि जब सॉफ्टमैक्स आउटपुट बदलता है तो क्रॉस-एंट्रॉपी लॉस कैसे बदलता है।
हिडन लेयर
हिडन लेयर के लिए, डेल्टा त्रुटि δhidden बनती है और यह अगली लेयर (आउटपुट लेयर) की त्रुटि तथा ReLU एक्टिवेशन के अवकलज पर निर्भर करती है।
ReLU का अवकलज धनात्मक इनपुट्स के लिए 1 और ऋणात्मक के लिए 0 होता है, जैसा कि नीचे दिखाया गया है।
ReLU के अवकलज का चित्रण
मान लें Zhidden हिडन लेयर में ReLU फंक्शन का इनपुट है और Woutput हिडन लेयर को आउटपुट लेयर से जोड़ने वाले वेट्स हैं। इस स्थिति में हिडन लेयर के लिए डेल्टा त्रुटि होगी:
δhidden = (δoutput.Woutput) ⊙ ReLU’(Zhidden)
बिंदु चिह्न “.” मैट्रिक्स गुणा को दर्शाता है
चिह्न ⊙ एलिमेंट-वाइज़ गुणा का प्रतिनिधित्व करता है
ReLU’(Zhidden)Zhidden पर ReLU के अवकलज के अनुरूप है
इनपुट लेयर
इसी तरह, यदि हमारे पास और हिडन लेयर्स होतीं, तो प्रक्रिया पीछे की ओर जारी रहती, जहाँ प्रत्येक लेयर की डेल्टा त्रुटि अगली लेयर की डेल्टा त्रुटि और उसके एक्टिवेशन फंक्शन के अवकलज पर निर्भर करती।
एक अधिक सामान्य परिदृश्य में, नेटवर्क की किसी भी दी गई लेयर k (आउटपुट लेयर को छोड़कर) के लिए, डेल्टा त्रुटि गणना का सूत्र है:
δk = (δk+1 . WTk+1) ⊙ f’(Zk)
WTk+1 अगली लेयर के वेट मैट्रिक्स के ट्रांसपोज़ के अनुरूप है
f’ लेयर k के एक्टिवेशन फंक्शन का अवकलज है, और
Zk लेयर k में एक्टिवेशन फंक्शन का इनपुट है
नेटवर्क का संकलन (कम्पाइलेशन)
त्रुटि गणना की इस समझ के साथ, प्रशिक्षण प्रक्रिया के लिए इसकी संरचना को अनुकूलित करने हेतु नेटवर्क को कम्पाइल करते हैं।
कम्पाइलेशन के दौरान, हमें कई महत्वपूर्ण चुनाव करने होते हैं:
ऑप्टिमाइज़ेशन एल्गोरिदम का चुनाव: इसमें ग्रेडिएंट डिसेंट ऑप्टिमाइज़ेशन के लिए एक एल्गोरिदम का चयन शामिल है। कई विकल्प हैं, जैसे Stochastic Gradient Descent (SGD), Adagrad, और RMSprop, जिसका इस लेख में उपयोग किया गया है।
लॉस फंक्शन का चयन: लॉस फंक्शन, जिसे कॉस्ट फंक्शन भी कहा जाता है, प्रशिक्षण का एक आवश्यक भाग है। यह बताता है कि नेटवर्क कितना अच्छा प्रदर्शन कर रहा है, और लॉस फंक्शन का चुनाव समस्या की क्लासिफिकेशन/रिग्रेशन प्रकृति के अनुरूप होना चाहिए। इस समस्या की मल्टी-क्लास प्रकृति के कारण कैटेगोरिकल क्रॉस-एंट्रॉपी पर ध्यान केंद्रित किया गया है।
परफॉरमेंस मेट्रिक का चुनाव: यद्यपि यह लॉस फंक्शन के समान लगता है, परफॉरमेंस मेट्रिक का मुख्य उपयोग टेस्ट डाटासेट पर मॉडल की प्रभावशीलता का मूल्यांकन करना है, और यहाँ हम एक्युरेसी का उपयोग कर रहे हैं।
उपरोक्त तीनों चुनावों के लिए कोड नीचे दिया गया है:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])संचालित द्वारा
नेटवर्क का प्रशिक्षण
मॉडल के प्रशिक्षण में सबसे बड़ी समस्याओं में से एक ओवरफिटिंग है, और यह सुनिश्चित करने के लिए प्रशिक्षण के दौरान मॉडल की निगरानी करना महत्वपूर्ण है कि उसकी जनरलाइज़ेशन क्षमता बेहतर हो—और ऐसा करने का एक तरीका है अर्ली स्टॉपिंग का सिद्धांत।
पूर्ण लॉजिक नीचे दर्शाया गया है:
# Fit the model
batch_size =256
n_epochs =15
val_split =0.2
patience_value =5# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
epochs=n_epochs, batch_size=batch_size)संचालित द्वारा
मॉडल को 256 के बैच साइज़ के साथ 15 epochs के लिए प्रशिक्षित किया गया है, और प्रशिक्षण डेटा का 20% मॉडल के मान्यकरण (validation) के लिए उपयोग किया गया है।
मॉडल को प्रशिक्षित करने के बाद, प्रशिक्षण और मान्यकरण प्रदर्शन का इतिहास नीचे प्लॉट किया गया है।
अब, हम मॉडल के प्रदर्शन का मूल्यांकन टेस्ट डेटा पर मॉडल की evaluate फ़ंक्शन का उपयोग करके कर सकते हैं।
loss, acc = network.evaluate(test_images,
test_labels, batch_size=batch_size)print("\nTest accuracy: %.1f%%"%(100.0* acc))संचालित द्वारा
टेस्ट डेटा पर मॉडल का प्रदर्शन
ग्राफ़ बताता है कि मॉडल ने उच्च एक्युरेसी के साथ परिणामों की भविष्यवाणी करना सीख लिया है, और वैलिडेशन तथा टेस्ट दोनों डाटासेट्स पर लगभग 98% हासिल किया है। यह प्रशिक्षण से अनदेखे डेटा पर अच्छी जनरलाइज़ेशन का संकेत देता है। हालांकि, प्रशिक्षण और वैलिडेशन एक्युरेसी के बीच का अंतर ओवरफिटिंग का संकेत हो सकता है, यद्यपि वैलिडेशन और टेस्ट एक्युरेसी की एकरूपता इस चिंता को कम कर सकती है।
सिफारिश
यद्यपि मॉडल उच्च एक्युरेसी और जनरलाइज़ेशन क्षमता दिखाता है, सुधार की गुंजाइश बनी हुई है। प्रदर्शन को और बेहतर करने के लिए नीचे कुछ क्रियाशील कदम दिए गए हैं।
रेगुलराइज़ेशन: ओवरफिटिंग को कम करने के लिए रेगुलराइज़ेशन विधियाँ एकीकृत करें।
अर्ली स्टॉपिंग: ओवरफिटिंग से बचने के लिए प्रशिक्षण के दौरान अर्ली स्टॉपिंग का उपयोग करें।
त्रुटि विश्लेषण: गलत भविष्यवाणियों का विश्लेषण कर अंतर्निहित समस्याओं की पहचान करें और उन्हें सुधारें।
विविधता परीक्षण: मॉडल की मजबूती की पुष्टि करने के लिए इसे विविध डाटासेट्स पर जाँचें।
विस्तृत मेट्रिक्स: विशेषकर यदि डेटा असंतुलित हो, तो संपूर्ण मूल्यांकन के लिए प्रिसिजन, रिकॉल और F1-स्कोर का उपयोग करें।
निष्कर्ष
संक्षेप में, इस लेख ने मशीन लर्निंग के क्षेत्र की एक अनिवार्य तकनीक—बैकप्रोपेगेशन—का व्यापक अन्वेषण प्रस्तुत किया है। हमने बैकप्रोपेगेशन की स्पष्ट परिभाषा से शुरुआत की और कृत्रिम बुद्धिमत्ता की उन्नति में इसकी महत्वपूर्ण भूमिका रेखांकित की।
इसके बाद, हमने बैकप्रोपेगेशन के कामकाज में गहराई से उतरते हुए इसके कुछ लाभों, जैसे सीखने की दक्षता में सुधार, के साथ-साथ इसकी सीमाओं और चुनौतियों को भी स्वीकार किया।
फिर, हमने न्यूरल नेटवर्क्स को सेट अप और निर्माण करने पर विस्तृत मार्गदर्शन दिया, जिसमें फॉरवर्ड प्रोपेगेशन के महत्व पर जोर दिया गया।
अंतिम भागों में, हमने डेल्टाज की गणना और नेटवर्क वेट्स को अपडेट करने के चरणों का अन्वेषण किया, जो सीखने की प्रक्रिया को परिष्कृत करने के लिए आवश्यक हैं।
कुल मिलाकर, यह लेख उन सभी के लिए एक मूल्यवान संसाधन के रूप में कार्य करता है जो न्यूरल नेटवर्क्स में बैकप्रोपेगेशन को समझना और प्रभावी ढंग से लागू करना चाहते हैं।
क्या आप डीप लर्निंग में अपनी कौशल को मजबूत करने के इच्छुक हैं? हमारा Deep Learning with PyTorch कोर्स आपको न्यूरल नेटवर्क्स में और गहराई से जाने और अपने ज्ञान को आगे बढ़ाने का आत्मविश्वास देगा।
बहु-प्रतिभाशाली डेटा साइंटिस्ट जो अपना ज्ञान साझा करने और समुदाय को वापस देने में आनंद लेते हैं, ज़ूमाना YouTube पर कंटेंट क्रिएटर हैं और Medium पर शीर्ष तकनीकी लेखक हैं। उन्हें बोलने, कोडिंग करने और पढ़ाने में खुशी मिलती है। ज़ूमाना के पास दो मास्टर डिग्री हैं—पहली पेरिस, फ्रांस से कंप्यूटर साइंस में, मशीन लर्निंग पर केंद्रित, और दूसरी अमेरिका के टेक्सास टेक यूनिवर्सिटी से डेटा साइंस में। उनका करियर फ्रांस में Groupe OPEN में सॉफ्टवेयर डेवलपर के रूप में शुरू हुआ, जिसके बाद वे IBM में मशीन लर्निंग कंसल्टेंट बने, जहाँ उन्होंने बीमा कंपनियों के लिए एंड-टू-एंड एआई समाधान विकसित किए। ज़ूमाना ने Axionable, पेरिस और मॉन्ट्रियल स्थित पहली Sustainable AI स्टार्टअप, से जुड़कर डेटा साइंटिस्ट के रूप में काम किया और फ्रांस, मॉन्ट्रियल, सिंगापुर और स्विट्ज़रलैंड के क्लाइंट्स के लिए मुख्यतः NLP उपयोग मामलों पर आधारित एआई प्रोडक्ट्स लागू किए। इसके अतिरिक्त, अपने समय का 5% उन्होंने अनुसंधान और विकास को समर्पित किया। वर्तमान में, वे IFC - The World Bank Group में सीनियर डेटा साइंटिस्ट के रूप में कार्यरत हैं।


बैकप्रोपेगेशन आधुनिक न्यूरल नेटवर्क प्रशिक्षण का एक अनिवार्य हिस्सा है, जो इन उन्नत एल्गोरिदम को प्रशिक्षण डाटासेट से सीखने और समय के साथ बेहतर बनने में सक्षम बनाता है।
न्यूरल नेटवर्क और डीप लर्निंग के क्षेत्र में किसी के लिए भी बैकप्रोपेगेशन एल्गोरिदम को समझना और उस पर अधिकार पाना अत्यंत महत्वपूर्ण है। यह ट्यूटोरियल बैकप्रोपेगेशन की गहन पड़ताल प्रस्तुत करता है।
यह पहले बताता है कि बैकप्रोपेगेशन क्या है और यह कैसे काम करता है, साथ ही इसके लाभ और सीमाएँ, और फिर इसे व्यापक रूप से प्रयुक्त डाटासेट पर लागू करने के व्यावहारिक अनुभव में ले जाता है।
बैकप्रोपेगेशन क्या है?
1970 के दशक में प्रस्तुत, बैकप्रोपेगेशन एल्गोरिदम पिछली पुनरावृत्ति या युग (epoch) में प्राप्त त्रुटि दर के अनुरूप न्यूरल नेटवर्क के वेट्स को फाइन-ट्यून करने की विधि है, और यह कृत्रिम न्यूरल नेटवर्क्स को प्रशिक्षित करने की मानक विधि है।
आप इसे एक फीडबैक सिस्टम की तरह समझ सकते हैं, जहाँ प्रत्येक प्रशिक्षण चरण या 'epoch' के बाद नेटवर्क अपने कार्य-प्रदर्शन की समीक्षा करता है। यह अपने आउटपुट और सही उत्तर के बीच के अंतर की गणना करता है, जिसे त्रुटि कहा जाता है। फिर यह अपनी आंतरिक पैरामीटर्स यानी 'वेट्स' को समायोजित करता है ताकि अगली बार यह त्रुटि कम हो सके। यह तरीका नेटवर्क की शुद्धता को ट्यून करने के लिए आवश्यक है और बेहतर भविष्यवाणी या निर्णय लेने के लिए एक बुनियादी रणनीति है।
बैकप्रोपेगेशन कैसे काम करता है?
अब जब आपको पता है कि बैकप्रोपेगेशन क्या है, तो आइए देखें कि यह काम कैसे करता है। नीचे दिए गए चित्र में बैकप्रोपेगेशन एल्गोरिदम को जिस न्यूरल नेटवर्क पर लागू किया गया है, उसमें हैं:
बैकप्रोपेगेशन का चित्रण (स्रोत: machinelearningknowledge)
बैकप्रोपेगेशन एल्गोरिदम के कुल मिलाकर चार मुख्य चरण होते हैं:
फॉरवर्ड पास, त्रुटि गणना, बैकवर्ड पास, और वेट्स अपडेट
आइए ऊपर दी गई एनीमेशन से इन प्रत्येक चरणों को समझें।
फॉरवर्ड पास
यह बैकप्रोपेगेशन प्रक्रिया का पहला चरण है, और इसे नीचे दर्शाया गया है:
त्रुटि की गणना
बैकवर्ड पास
यह वास्तविक बैकप्रोपेगेशन चरण है, और इसे ऊपर दिए गए फॉरवर्ड और त्रुटि-गणना चरणों के बिना नहीं किया जा सकता। यह इस प्रकार काम करता है:
वेट्स अपडेट
बैकप्रोपेगेशन के लाभ
बैकप्रोपेगेशन न्यूरल नेटवर्क प्रशिक्षण में एक आधारभूत तकनीक है, जो अपने सीधे-सादे इम्प्लीमेंटेशन, प्रोग्रामिंग की सहजता और अनेक नेटवर्क आर्किटेक्चर में बहुउद्देश्यीय उपयोगिता के लिए व्यापक रूप से सराही जाती है।
हमारा R में न्यूरल नेटवर्क (NN) मॉडल बनाना ट्यूटोरियल किसी भी व्यक्ति के लिए एक शानदार शुरुआती बिंदु है जो न्यूरल नेटवर्क के बारे में सीखना चाहता है। यह R में एक न्यूरल नेटवर्क मॉडल बनाना सिखाता है।
Python प्रोग्रामर्स के लिए, रीकरेंट न्यूरल नेटवर्क (RNN) ट्यूटोरियल सबसे लोकप्रिय डीप लर्निंग मॉडल RNN पर एक व्यापक गाइड प्रदान करता है, जिसमें MasterCard स्टॉक प्राइस प्रेडिक्टर बनाकर हैंड्स-ऑन अनुभव शामिल है।
अब, आइए पहले बताए गए प्रत्येक लाभ पर थोड़ा विस्तार करें:
सीमाएँ और चुनौतियाँ
बैकप्रोपेगेशन एल्गोरिदम की सफलता के बावजूद, इसमें कुछ सीमाएँ हैं, जो न्यूरल नेटवर्क के प्रशिक्षण प्रक्रिया की दक्षता और प्रभावशीलता को प्रभावित कर सकती हैं। आइए कुछ बाधाओं का अन्वेषण करें:
बैकप्रोपेगेशन का इम्प्लीमेंटेशन
बैकप्रोपेगेशन एल्गोरिदम के बारे में इन सभी अंतर्दृष्टियों के साथ, अब वास्तविक दुनिया के परिदृश्य में इसके अनुप्रयोग में उतरने का समय है—MNIST डाटासेट से हस्तलिखित अंकों को पहचानने के लिए एक न्यूरल नेटवर्क का इम्प्लीमेंटेशन।
यह भाग डेटा विज़ुअलाइज़ेशन से लेकर मॉडल प्रशिक्षण और मूल्यांकन तक सभी चरणों को कवर करता है। संपूर्ण सोर्स कोड इस DataLab वर्कबुक में उपलब्ध है; आप अपने ब्राउज़र में कोड चलाने के लिए आसानी से इसकी एक प्रति बना सकते हैं, बिना अपने कंप्यूटर पर कुछ भी इंस्टॉल किए।
डाटासेट के बारे में
MNIST डाटासेट छवि पहचान के क्षेत्र में व्यापक रूप से उपयोग किया जाता है। इसमें 0 से 9 तक के हस्तलिखित अंकों की 70000 ग्रेस्केल छवियाँ हैं, और प्रत्येक छवि 28x28 पिक्सेल की है।
यह डाटासेट Keras.datasets मॉड्यूल की mnist फ़ंक्शन में उपलब्ध है, और mnist लाइब्रेरी इम्पोर्ट करने के बाद इसे इस प्रकार लोड किया जाता है:
एक्सप्लोरेटरी डेटा एनालिसिस
किसी भी मशीन लर्निंग या डीप लर्निंग मॉडल के निर्माण से पहले एक्सप्लोरेटरी डेटा एनालिसिस एक प्रमुख चरण है, क्योंकि यह हमारे पास उपलब्ध डेटा की प्रकृति को बेहतर ढंग से समझने में मदद करता है, और इसी के अनुसार प्रयुक्त मॉडल के प्रकार के चयन का मार्गदर्शन करता है।
मुख्य कार्यों में शामिल हैं:
कुल डाटासेट 70000 छवियों का है। मूल डाटासेट का सामान्य विभाजन निम्न प्रकार दिया जाता है, और इसके लिए कोई निश्चित thumb नियम नहीं है:
कुछ विभाजन 90% प्रशिक्षण और 10% परीक्षण भी हो सकते हैं।
हमारे परिदृश्य में, प्रशिक्षण और परीक्षण डाटासेट दोनों लोड किए गए हैं, इसलिए विभाजन की आवश्यकता नहीं है। आइए इन डाटासेट्स के आकार का निरीक्षण करें।
प्रशिक्षण और परीक्षण डाटासेट्स की विशेषताएँ
अब, कुछ रैंडम अंकों का विज़ुअलाइज़ेशन करते हैं। यह plot_images सहायक फ़ंक्शन से किया जाता है, जो दो मुख्य पैरामीटर्स लेता है:
हम प्रशिक्षण डेटा से नौ छवियाँ देखना चाहते हैं, जिसके लिए निम्नलिखित कोड स्निपेट है:
ऊपर दिए गए कोड के सफल निष्पादन से निम्नलिखित नौ अंक उत्पन्न होते हैं।
प्रशिक्षण डाटासेट से नौ रैंडम छवियाँ
उसी फ़ंक्शन को दूसरी बार चलाने के बाद निम्नलिखित अंक प्रदर्शित होते हैं, और हम देखते हैं कि वे वही नहीं हैं; यह सहायक फ़ंक्शन की रैंडम प्रकृति के कारण है।
फ़ंक्शन को दूसरी बार चलाने के बाद प्रशिक्षण डाटासेट से नौ रैंडम छवियाँ
डेटा विश्लेषण का अंतिम कार्य प्रशिक्षण डाटासेट के लेबल्स के वितरण का विज़ुअलाइज़ेशन करना है, जो plot_labels_distribution सहायक फ़ंक्शन से किया जाता है।
यह फ़ंक्शन प्रशिक्षण डाटासेट पर इसके लेबल्स देकर इस प्रकार लागू किया जाता है:
नीचे परिणाम दिया गया है, और हम देखते हैं कि सभी दस अंक पूरे डाटासेट में लगभग समान रूप से वितरित हैं, जो अच्छी बात है—इसका मतलब है कि लेबल्स के वितरण को संतुलित करने के लिए किसी अतिरिक्त कार्रवाई की आवश्यकता नहीं है।
डेटा प्रीप्रोसेसिंग
वास्तविक दुनिया के डेटा को आमतौर पर मॉडल प्रशिक्षण के लिए उपयुक्त बनाने हेतु कुछ प्रीप्रोसेसिंग की आवश्यकता होती है। प्रशिक्षण और परीक्षण दोनों छवियों पर तीन मुख्य प्रीप्रोसेसिंग कार्य लागू किए जाते हैं:
कुल प्रीप्रोसेसिंग लॉजिक नीचे दिए गए
preprocess_dataसहायक फ़ंक्शन में इम्प्लीमेंट किया गया है:यह फ़ंक्शन निम्नलिखित कोड स्निपेट्स के साथ डाटासेट्स पर लागू किया जाता है:
अब, दोनों डाटासेट्स के वर्तमान अधिकतम और न्यूनतम पिक्सेल मानों का अवलोकन करें:
कोड का परिणाम नीचे दिया गया है, और हम देखते हैं कि नॉर्मलाइज़ेशन सफलतापूर्वक किया गया था।
नॉर्मलाइज़ेशन के बाद न्यूनतम और अधिकतम पिक्सेल मान
इसी तरह, लेबल्स के लिए हमारे पास अंततः 0 और 1 की मैट्रिक्स है, जो उन लेबल्स के वन-हॉट एनकोडेड मानों के अनुरूप है।
परिणाम नीचे:
टेस्ट डेटा लेबल्स का वन-हॉट एनकोडिंग
ट्रेन डेटा लेबल्स का वन-हॉट एनकोडिंग
नेटवर्क की संरचना
चूँकि हम एक इमेज क्लासिफिकेशन कार्य का उपयोग कर रहे हैं, एक कन्वोल्यूशनल न्यूरल नेटवर्क ऐसे परिदृश्य के लिए अधिक उपयुक्त होता है। कुछ भी कोड करने से पहले, मॉडल की आर्किटेक्चर को परिभाषित करना महत्वपूर्ण है—और यही इस अनुभाग का उद्देश्य है।
कन्वोल्यूशनल न्यूरल नेटवर्क्स के बारे में अधिक जानने के लिए, हमारा कन्वोल्यूशनल न्यूरल नेटवर्क्स (CNNs) का परिचय ट्यूटोरियल एक शानदार शुरुआती संसाधन है। यह CNNs को समझने, इमेज एनालिसिस पर उनके प्रभाव, और मजबूत CNN बनाम डीप लर्निंग अनुप्रयोगों के लिए ओवरफिटिंग से निपटने की कुछ प्रमुख रणनीतियों पर एक संपूर्ण गाइड है।
इस उपयोग-प्रकरण के लिए आर्किटेक्चर प्रभावी इमेज क्लासिफिकेशन के लिए विभिन्न प्रकार की लेयर्स को संयोजित करता है। नीचे मॉडल के प्रमुख घटक दिए गए हैं:
यह सारी जानकारी define_network_architecture सहायक फ़ंक्शन में इम्प्लीमेंट की गई है। लेकिन उससे पहले, हमें सभी आवश्यक लाइब्रेरीज़ इम्पोर्ट करनी होंगी:
यहाँ सहायक फ़ंक्शन का इम्प्लीमेंटेशन है।
सोर्स कोड का इम्प्लीमेंटेशन अच्छा है, लेकिन यदि हम नेटवर्क का ग्राफिकल विज़ुअलाइज़ेशन भी देख सकें तो और बेहतर होगा, जिसे
keras.utils.vis_utilsमॉड्यूल केplot_modelफ़ंक्शन से हासिल किया जाता है।पहले, सहायक फ़ंक्शन से नेटवर्क जनरेट करें।
इसके बाद, ग्राफिकल प्रतिनिधित्व प्रदर्शित करें। हम पहले परिणाम को एक PNG फ़ाइल में सेव करते हैं और फिर दिखाते हैं; इससे दूसरों के साथ साझा करना आसान हो जाता है।
परिणाम नीचे दिखाया गया है।
कन्वोल्यूशनल न्यूरल नेटवर्क की ग्राफिकल आर्किटेक्चर
डेल्टा की गणना
मॉडल के प्रशिक्षण की प्रक्रिया में जाने से पहले, आइए समझें कि नेटवर्क की आर्किटेक्चर का उपयोग करते हुए डेल्टा त्रुटि वितरण कैसे गणना किया जाता है।
डेल्टा त्रुटि वितरण प्रत्येक नोड के एक्टिवेशन फंक्शन के संबंध में लॉस फंक्शन का अवकलज है, और यह संकेत देता है कि अंतिम त्रुटि में प्रत्येक नोड के एक्टिवेशन का कितना योगदान था।
ऊपर दी गई आर्किटेक्चर तीन मुख्य लेयर्स से मिलकर बनी है:
अब, प्रत्येक लेयर के लिए डेल्टा त्रुटि की गणना को आगे बढ़ाते हैं।
आउटपुट लेयर
आइए सॉफ्टमैक्स लेयर के आउटपुट को बड़ा O (O) और सही लेबल्स को Y मानें। क्रॉस-एंट्रॉपी लॉस δ output का उपयोग करते हुए, डेल्टा त्रुटि बनती है:
δ output = O - Y
यह सूत्र इस मूल गणना से आता है कि जब सॉफ्टमैक्स आउटपुट बदलता है तो क्रॉस-एंट्रॉपी लॉस कैसे बदलता है।
हिडन लेयर
हिडन लेयर के लिए, डेल्टा त्रुटि δ hidden बनती है और यह अगली लेयर (आउटपुट लेयर) की त्रुटि तथा ReLU एक्टिवेशन के अवकलज पर निर्भर करती है।
ReLU का अवकलज धनात्मक इनपुट्स के लिए 1 और ऋणात्मक के लिए 0 होता है, जैसा कि नीचे दिखाया गया है।
ReLU के अवकलज का चित्रण
मान लें Zhidden हिडन लेयर में ReLU फंक्शन का इनपुट है और Woutput हिडन लेयर को आउटपुट लेयर से जोड़ने वाले वेट्स हैं। इस स्थिति में हिडन लेयर के लिए डेल्टा त्रुटि होगी:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
इनपुट लेयर
इसी तरह, यदि हमारे पास और हिडन लेयर्स होतीं, तो प्रक्रिया पीछे की ओर जारी रहती, जहाँ प्रत्येक लेयर की डेल्टा त्रुटि अगली लेयर की डेल्टा त्रुटि और उसके एक्टिवेशन फंक्शन के अवकलज पर निर्भर करती।
एक अधिक सामान्य परिदृश्य में, नेटवर्क की किसी भी दी गई लेयर k (आउटपुट लेयर को छोड़कर) के लिए, डेल्टा त्रुटि गणना का सूत्र है:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
नेटवर्क का संकलन (कम्पाइलेशन)
त्रुटि गणना की इस समझ के साथ, प्रशिक्षण प्रक्रिया के लिए इसकी संरचना को अनुकूलित करने हेतु नेटवर्क को कम्पाइल करते हैं।
कम्पाइलेशन के दौरान, हमें कई महत्वपूर्ण चुनाव करने होते हैं:
उपरोक्त तीनों चुनावों के लिए कोड नीचे दिया गया है:
नेटवर्क का प्रशिक्षण
मॉडल के प्रशिक्षण में सबसे बड़ी समस्याओं में से एक ओवरफिटिंग है, और यह सुनिश्चित करने के लिए प्रशिक्षण के दौरान मॉडल की निगरानी करना महत्वपूर्ण है कि उसकी जनरलाइज़ेशन क्षमता बेहतर हो—और ऐसा करने का एक तरीका है अर्ली स्टॉपिंग का सिद्धांत।
पूर्ण लॉजिक नीचे दर्शाया गया है:
मॉडल को 256 के बैच साइज़ के साथ 15 epochs के लिए प्रशिक्षित किया गया है, और प्रशिक्षण डेटा का 20% मॉडल के मान्यकरण (validation) के लिए उपयोग किया गया है।
मॉडल को प्रशिक्षित करने के बाद, प्रशिक्षण और मान्यकरण प्रदर्शन का इतिहास नीचे प्लॉट किया गया है।
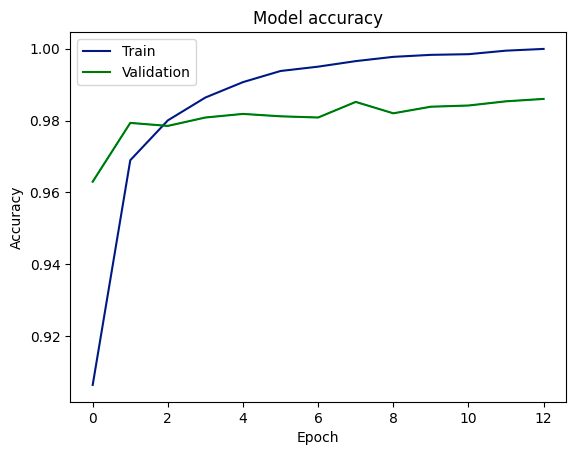
प्रशिक्षण और मान्यकरण एक्युरेसी स्कोर
टेस्ट डेटा पर मूल्यांकन
अब, हम मॉडल के प्रदर्शन का मूल्यांकन टेस्ट डेटा पर मॉडल की evaluate फ़ंक्शन का उपयोग करके कर सकते हैं।
टेस्ट डेटा पर मॉडल का प्रदर्शन
ग्राफ़ बताता है कि मॉडल ने उच्च एक्युरेसी के साथ परिणामों की भविष्यवाणी करना सीख लिया है, और वैलिडेशन तथा टेस्ट दोनों डाटासेट्स पर लगभग 98% हासिल किया है। यह प्रशिक्षण से अनदेखे डेटा पर अच्छी जनरलाइज़ेशन का संकेत देता है। हालांकि, प्रशिक्षण और वैलिडेशन एक्युरेसी के बीच का अंतर ओवरफिटिंग का संकेत हो सकता है, यद्यपि वैलिडेशन और टेस्ट एक्युरेसी की एकरूपता इस चिंता को कम कर सकती है।
सिफारिश
यद्यपि मॉडल उच्च एक्युरेसी और जनरलाइज़ेशन क्षमता दिखाता है, सुधार की गुंजाइश बनी हुई है। प्रदर्शन को और बेहतर करने के लिए नीचे कुछ क्रियाशील कदम दिए गए हैं।
निष्कर्ष
संक्षेप में, इस लेख ने मशीन लर्निंग के क्षेत्र की एक अनिवार्य तकनीक—बैकप्रोपेगेशन—का व्यापक अन्वेषण प्रस्तुत किया है। हमने बैकप्रोपेगेशन की स्पष्ट परिभाषा से शुरुआत की और कृत्रिम बुद्धिमत्ता की उन्नति में इसकी महत्वपूर्ण भूमिका रेखांकित की।
इसके बाद, हमने बैकप्रोपेगेशन के कामकाज में गहराई से उतरते हुए इसके कुछ लाभों, जैसे सीखने की दक्षता में सुधार, के साथ-साथ इसकी सीमाओं और चुनौतियों को भी स्वीकार किया।
फिर, हमने न्यूरल नेटवर्क्स को सेट अप और निर्माण करने पर विस्तृत मार्गदर्शन दिया, जिसमें फॉरवर्ड प्रोपेगेशन के महत्व पर जोर दिया गया।
अंतिम भागों में, हमने डेल्टाज की गणना और नेटवर्क वेट्स को अपडेट करने के चरणों का अन्वेषण किया, जो सीखने की प्रक्रिया को परिष्कृत करने के लिए आवश्यक हैं।
कुल मिलाकर, यह लेख उन सभी के लिए एक मूल्यवान संसाधन के रूप में कार्य करता है जो न्यूरल नेटवर्क्स में बैकप्रोपेगेशन को समझना और प्रभावी ढंग से लागू करना चाहते हैं।
क्या आप डीप लर्निंग में अपनी कौशल को मजबूत करने के इच्छुक हैं? हमारा Deep Learning with PyTorch कोर्स आपको न्यूरल नेटवर्क्स में और गहराई से जाने और अपने ज्ञान को आगे बढ़ाने का आत्मविश्वास देगा।