Backpropagation is een essentieel onderdeel van het trainen van moderne neurale netwerken. Het stelt deze geavanceerde algoritmen in staat te leren van trainingsdatasets en zich in de loop van de tijd te verbeteren.
Inzicht in en beheersing van het backpropagation-algoritme is cruciaal voor iedereen in het vakgebied van neurale netwerken en deep learning. Deze tutorial biedt een diepgaande verkenning van backpropagation.
We beginnen met uit te leggen wat backpropagation is en hoe het werkt, inclusief de voordelen en beperkingen, en duiken daarna in een praktische toepassing op een veelgebruikt dataset.
Wat is backpropagation?
Geïntroduceerd in de jaren zeventig is het backpropagation-algoritme de methode om de gewichten van een neuraal netwerk te verfijnen op basis van het foutenpercentage in de vorige iteratie of epoch. Het is een standaardmethode voor het trainen van kunstmatige neurale netwerken.
Je kunt het zien als een feedbacksysteem waarbij het netwerk na elke trainingsronde of ‘epoch’ zijn prestaties op taken evalueert. Het berekent het verschil tussen de eigen output en het juiste antwoord, de zogenaamde fout. Vervolgens past het zijn interne parameters, ofwel ‘gewichten’, aan om deze fout de volgende keer te verkleinen. Deze methode is essentieel om de nauwkeurigheid van het neurale netwerk af te stellen en vormt de basis voor het leren betere voorspellingen of beslissingen te maken.
Hoe werkt backpropagation?
Nu je weet wat backpropagation is, gaan we in op hoe het werkt. Hieronder zie je een illustratie van het backpropagation-algoritme toegepast op een neuraal netwerk met:
- Twee inputs X1 en X2
- Twee verborgen lagen N1X en N2X, waarbij X de waarden 1, 2 en 3 aanneemt
- Één outputlaag
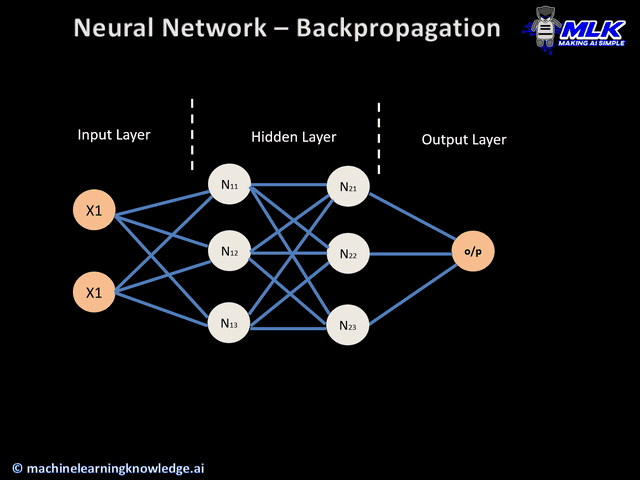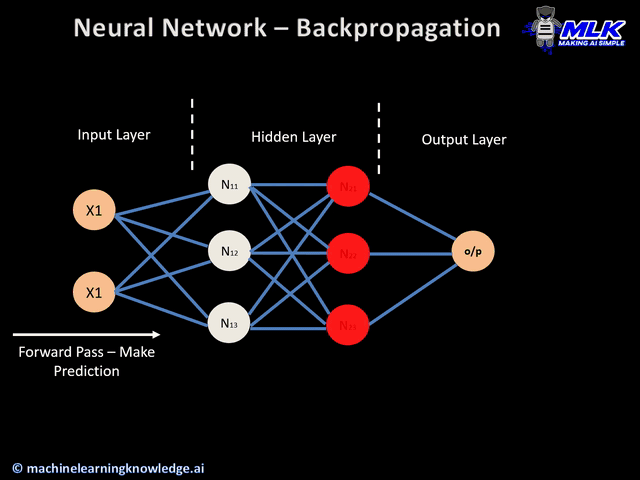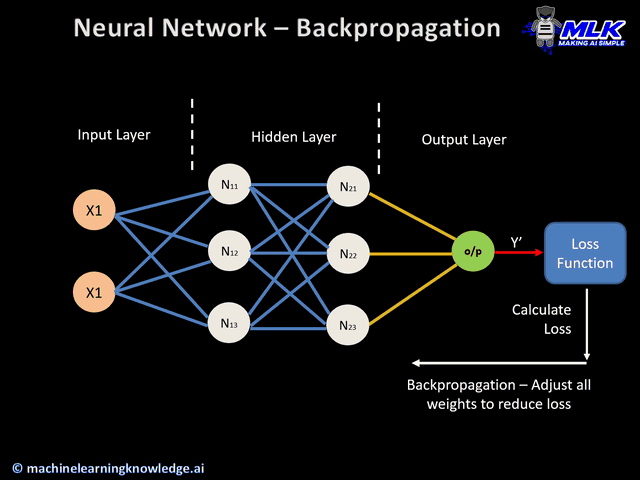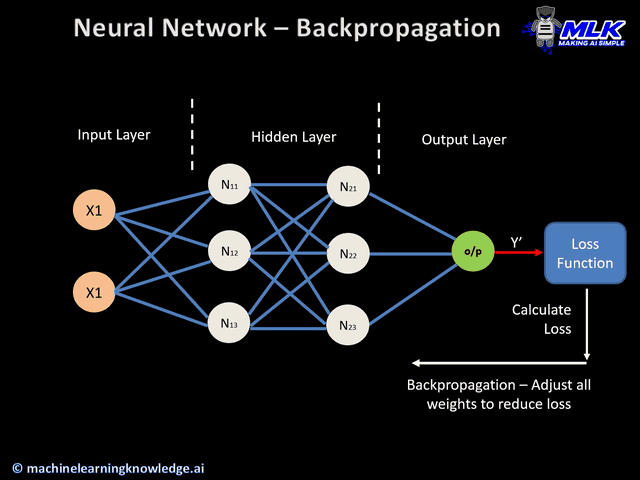
Backpropagation-illustratie (bron: machinelearningknowledge)
Het backpropagation-algoritme kent in grote lijnen vier hoofd stappen:
- Forward pass
- Fouten berekenen
- Backward pass
- Gewichten bijwerken
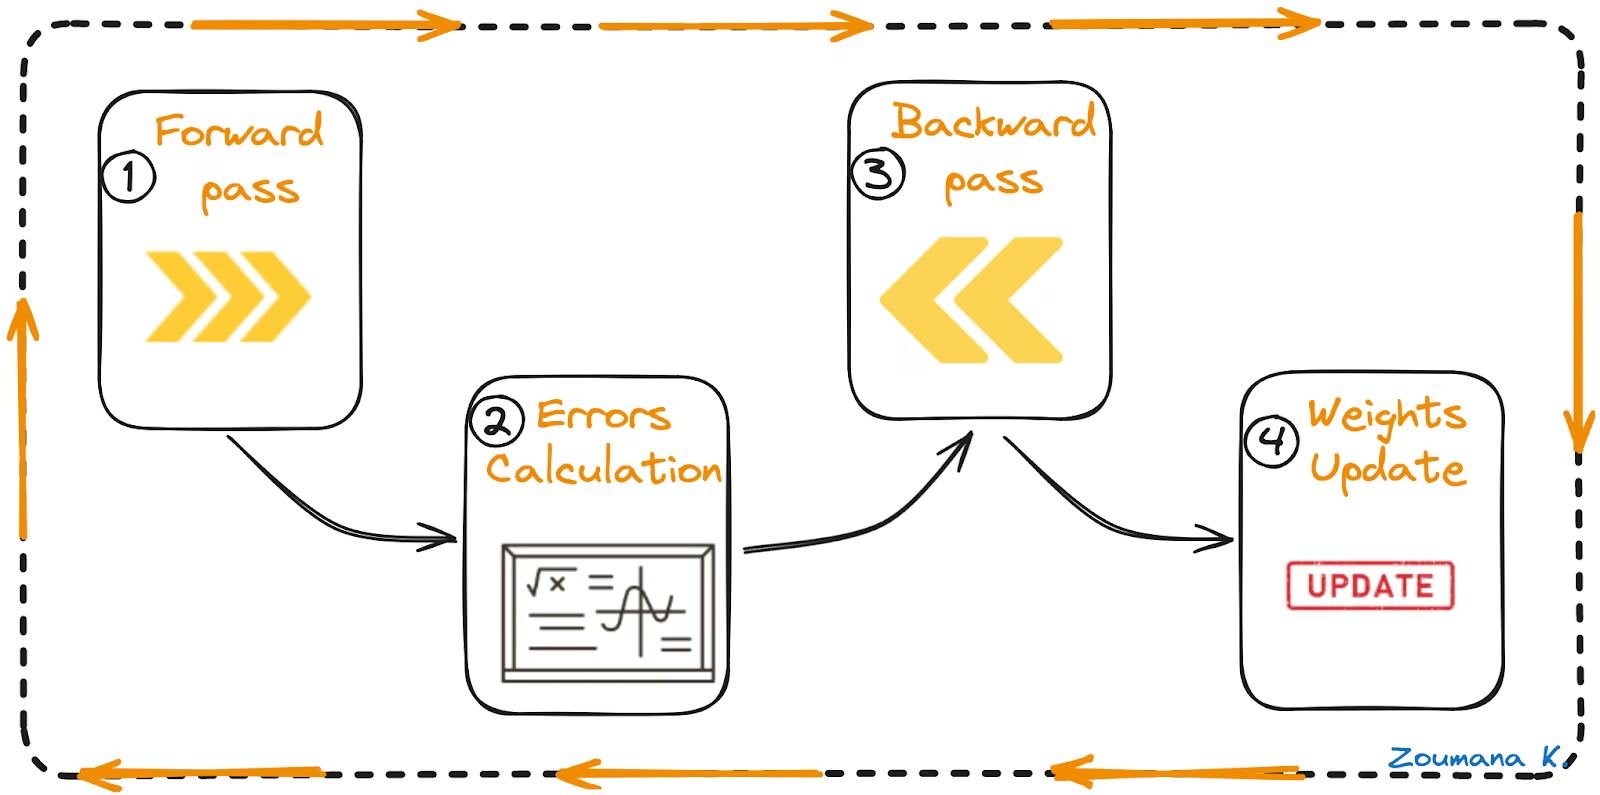
Forward pass, fouten berekenen, backward pass en gewichten bijwerken
Laten we elk van deze stappen uit de animatie hierboven begrijpen.
Forward pass
Dit is de eerste stap van het backpropagation-proces en wordt hieronder geïllustreerd:
- De data (inputs X1 en X2) wordt naar de inputlaag gevoerd.
- Vervolgens wordt elke input vermenigvuldigd met het bijbehorende gewicht en worden de resultaten doorgegeven aan de neuronen N1X en N2X van de verborgen lagen.
- Die neuronen passen een activatiefunctie toe op de gewogen inputs die ze ontvangen, en het resultaat gaat door naar de volgende laag.
Fouten berekenen
- Het proces gaat door totdat de outputlaag de uiteindelijke output (o/p) genereert.
- De output van het netwerk wordt vervolgens vergeleken met de ground truth (gewenste output) en het verschil wordt berekend, wat resulteert in een foutwaarde.
Backward pass
Dit is de eigenlijke backpropagation-stap en kan niet worden uitgevoerd zonder de bovenstaande stappen van forward en foutberekening. Zo werkt het:
- De eerder verkregen foutwaarde wordt gebruikt om de gradiënt van de verliesfunctie te berekenen.
- De foutgradiënt wordt teruggepropageerd door het netwerk, beginnend bij de outputlaag naar de verborgen lagen.
- Terwijl de foutgradiënt terugloopt, worden de gewichten (weergegeven door de lijnen die de knooppunten verbinden) bijgewerkt op basis van hun bijdrage aan de fout. Dit omvat het nemen van de afgeleide van de fout naar elk gewicht, wat aangeeft hoeveel een wijziging in het gewicht de fout zou veranderen.
- De leersnelheid bepaalt de grootte van de gewichtsupdates. Een lagere leersnelheid betekent dat de gewichten met een kleinere stap worden bijgewerkt, en omgekeerd.
Gewichten bijwerken
- De gewichten worden bijgewerkt in de tegenovergestelde richting van de gradiënt, wat leidt tot de naam “gradient descent”. Het doel is de fout in de volgende forward pass te verkleinen.
- Dit proces van forward pass, fouten berekenen, backward pass en gewichten bijwerken gaat meerdere epochs door totdat de netwerkprestaties een bevredigend niveau bereiken of niet meer significant verbeteren.
Voordelen van backpropagation
Backpropagation is een basistechniek in het trainen van neurale netwerken, gewaardeerd om de rechttoe-rechtaan implementatie, de eenvoud in programmeren en de brede toepasbaarheid op meerdere netwerkarchitecturen.
Onze tutorial Neural Network (NN)-modellen bouwen in R is een goed startpunt voor iedereen die meer wil leren over neurale netwerken. Je leert er hoe je een neuraal netwerkmodel in R maakt.
Voor Python-programmeurs biedt de tutorial Recurrent Neural Network Tutorial (RNN) een uitgebreide gids over het populaire deep learning-model RNN, met praktijkervaring door een MasterCard-aandelenprijspredictor te bouwen.
Laten we nu elk van de eerder genoemde voordelen toelichten:
- Eenvoudige implementatie: toegankelijk via meerdere deep-learningbibliotheken zoals Pytorch en Keras, wat het gebruik in uiteenlopende toepassingen vergemakkelijkt.
- Eenvoudig programmeren: vereenvoudigde code dankzij framework-abstractie, waardoor minder complexe wiskunde nodig is.
- Flexibiliteit: aanpasbaar aan diverse architecturen, geschikt voor een breed spectrum aan AI-uitdagingen.
Beperkingen en uitdagingen
Ondanks het succes van het backpropagation-algoritme is het niet zonder beperkingen, die de efficiëntie en effectiviteit van het trainingsproces van een neuraal netwerk kunnen beïnvloeden. Laten we enkele van die beperkingen bekijken:
- Datakwaliteit: slechte datakwaliteit, waaronder ruis, onvolledigheid of bias, kan leiden tot onnauwkeurige modellen, omdat backpropagation precies leert wat het wordt aangeboden.
- Trainingsduur: backpropagation vereist vaak veel trainingstijd, wat onpraktisch kan zijn bij grote netwerken.
- Matrixcomplexiteit: de matrixbewerkingen in backpropagation schalen mee met de netwerkgrootte, wat de rekenlast vergroot en mogelijk de beschikbare resources te boven gaat.
Backpropagation implementeren
Met al deze inzichten over het backpropagation-algoritme is het tijd om de toepassing in een realistische situatie te verkennen: we implementeren een neuraal netwerk om handgeschreven cijfers uit de MNIST-dataset te herkennen.
Deze sectie behandelt alle stappen, van datavisualisatie tot modeltraining en -evaluatie. De volledige broncode is beschikbaar in deze DataLab-werkmap; je kunt eenvoudig een eigen kopie maken om de code in de browser te draaien, zonder iets op je computer te installeren.
Over de dataset
De MNIST-dataset wordt veel gebruikt op het gebied van beeldherkenning. Hij bestaat uit 70.000 grijswaardebeelden van handgeschreven cijfers van 0 tot en met 9, en elk beeld is 28x28 pixels.
De dataset is beschikbaar via de functie mnist uit de module Keras.datasets en wordt als volgt geladen nadat je de mnist-bibliotheek hebt geïmporteerd:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Verkennende data-analyse
Verkennende data-analyse is een belangrijke stap vóór het bouwen van een machine-learning- of deep-learningmodel, omdat het helpt de aard van de data beter te begrijpen en zo de keuze van het type model te sturen.
De belangrijkste taken zijn onder meer:
- Het totale aantal data in zowel de trainings- als de testdataset bepalen.
- Willekeurige visualisatie van enkele cijfers uit de trainingsdataset.
- De verdeling van de labels uit de trainingsdataset visualiseren.
De volledige dataset bestaat uit 70.000 beelden. De gebruikelijke opsplitsing van de oorspronkelijke dataset is als volgt, al is er geen vaste vuistregel:
- 70% of 80% voor de trainingsdataset
- 30% of 20% voor de testdataset
Sommige splitsingen gaan zelfs naar 90% voor training en 10% voor testen.
In ons scenario worden de trainings- en testdatasets beide geladen, dus opsplitsen is niet nodig. Laten we de omvang van die datasets bekijken.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")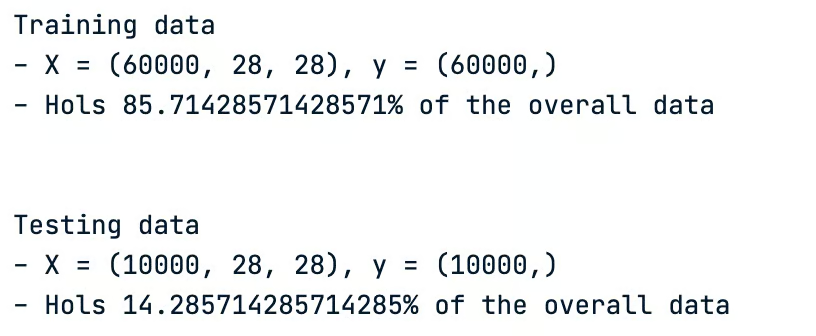
Kenmerken van zowel de trainings- als testdatasets
- De trainingsdataset heeft 60.000 beelden en komt overeen met 85,71% van de oorspronkelijke dataset.
- De testdataset bevat de resterende 10.000 beelden, dus 14,28% van de oorspronkelijke dataset.
Laten we nu enkele willekeurige cijfers visualiseren. Dat doen we met de hulpfunctie plot_images, die twee hoofdparameters heeft:
- Het aantal te plotten beelden, en
- De dataset die voor de visualisatie wordt gebruikt
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
We willen negen beelden uit de trainingsdata visualiseren. Dat komt overeen met de volgende code:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Het succesvol uitvoeren van de bovenstaande code levert de volgende negen cijfers op.
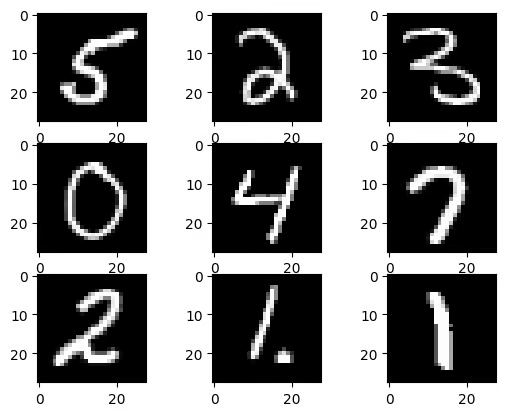
Negen willekeurige beelden uit de trainingsdataset
De volgende cijfers worden weergegeven na het dezelfde functie een tweede keer draaien, en we merken dat ze niet hetzelfde zijn; dit komt door het willekeurige karakter van de hulpfunctie.
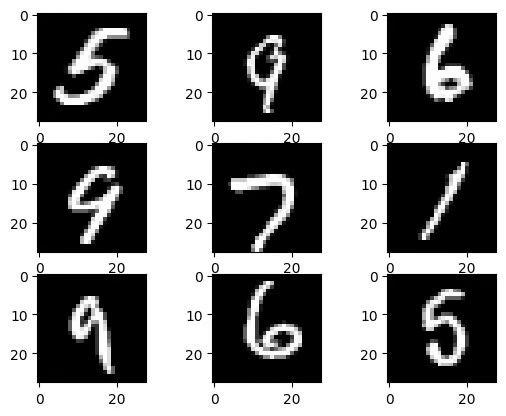
Negen willekeurige beelden uit de trainingsdataset na een tweede run van de functie
De laatste taak voor de data-analyse is het visualiseren van de verdeling van de labels uit de trainingsdataset met behulp van de hulpfunctie plot_labels_distribution.
- Op de X-as staan alle mogelijke cijfers
- Op de Y-as staat het totale aantal van die cijfers
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
De functie wordt toegepast op de trainingsdataset door de labels als volgt door te geven:
plot_labels_distribution(train_labels)Hieronder staat het resultaat. We zien dat alle tien cijfers bijna gelijkmatig over de hele dataset zijn verdeeld. Dat is goed nieuws: we hoeven geen extra stappen te nemen om de labelverdeling in balans te brengen.
Datapreprocessing
Echte data vereisen meestal enige preprocessing om ze geschikt te maken voor het trainen van modellen. Er zijn drie belangrijke preprocessing-taken die op zowel de trainings- als testbeelden worden toegepast:
- Beeldnormalisatie: hierbij worden alle pixelwaarden van 0–255 omgezet naar 0–1. Dit zorgt voor snellere convergentie tijdens het trainingsproces.
- Vorm aanpassen: in plaats van voor elk beeld een vierkante matrix van 28 bij 28 te hebben, flatten we elk beeld naar een vector van 784 elementen om het geschikt te maken als input voor het neurale netwerk.
- Label-encoding: zet de labels om naar one-hot encoding. Dit voorkomt problemen met numerieke hiërarchie, waardoor het model anders bevooroordeeld raakt richting grotere cijfers.
De totale preprocessinglogica is geïmplementeerd in de hulpfunctie preprocess_data hieronder:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
De functie wordt op de datasets toegepast met deze codefragmenten:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Laten we nu de huidige maximale en minimale pixelwaarden van beide datasets bekijken:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Het resultaat van de code staat hieronder. We zien dat de normalisatie succesvol is uitgevoerd.
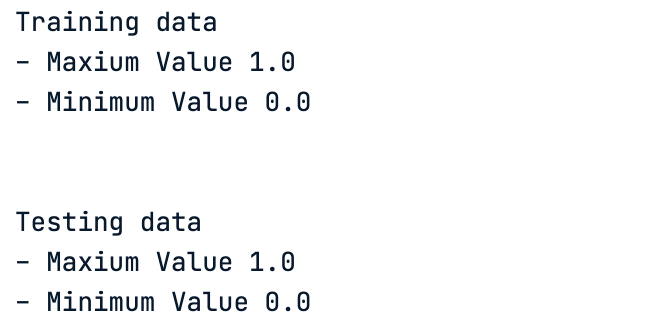
Minimale en maximale pixelwaarden na normalisatie
Net als bij de labels hebben we uiteindelijk een matrix van enen en nullen, die overeenkomen met de one-hot encoded waarden van die labels.
# One hot encoding of the test data labels
test_images
Resultaat hieronder:
One-hot encoding van de testdatalabels
# One hot encoding of the train data labels
train_labels
One-hot encoding van de trainingsdatalabels
Structuur van het netwerk
Omdat we een beeldclassificatietaak uitvoeren, is een convolutioneel neuraal netwerk geschikter voor dit scenario. Voordat we iets coderen, is het belangrijk de architectuur van het model te definiëren; daar draait deze sectie om.
Wil je meer leren over convolutionele neurale netwerken? Onze tutorial Een introductie tot Convolutional Neural Networks (CNN’s) is een uitstekend startpunt. Het is een complete gids om CNN’s te begrijpen, hun impact op beeldanalyse en enkele sleutelstrategieën tegen overfitting voor robuuste CNN- versus deep learning-toepassingen.
De architectuur voor deze usecase combineert verschillende typen lagen voor effectieve beeldclassificatie. Hieronder staan de belangrijkste componenten van het model:
- Convolutielaag: begin met een laag met een klein 3x3-filter en 32 filters om de beelden te verwerken.
- Max-poolinglaag: neem na de convolutielaag een max-poolinglaag op om de grootte van de featuremaps te verkleinen.
- Flatten: flatten de output van de poolinglaag tot één vector ter voorbereiding op het classificatieproces.
- Dense-laag: voeg een dense laag met 100 nodes toe tussen de geflatteerde output en de uiteindelijke laag om de geëxtraheerde features te interpreteren.
- Outputlaag: gebruik een outputlaag met 10 nodes, overeenkomend met de 10 beeldcategorieën. Elke node berekent de kans dat een beeld tot een van deze categorieën behoort.
- Softmax-activatie: pas in de outputlaag een softmax-activatiefunctie toe voor multiclass-classificatie.
- ReLU-activatiefunctie: gebruik de ReLU (Rectified Linear Unit)-activatiefunctie in alle lagen voor niet-lineaire verwerking.
- Optimizer: gebruik een stochastic gradient descent-optimizer met een leersnelheid van 0,001 en een momentum van 0,95 om het model tijdens het trainen aan te passen.
- Verliesfunctie: gebruik de categorische cross-entropy-verliesfunctie, ideaal voor multiclass-classificatietaken.
- Nauwkeurigheidsmetric: focus op de classificatienauwkeurigheid, gezien de gebalanceerde verdeling van de klassen.
Al deze informatie is geïmplementeerd in de hulpfunctie define_network_architecture. Maar daarvoor moeten we alle benodigde bibliotheken importeren:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Hier is de implementatie van de hulpfunctie.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
De broncode is prima, maar het is nog beter als we een grafische visualisatie van het netwerk hebben. Dat kan met de functie plot_model uit de module keras.utils.vis_utils.
Genereer eerst het netwerk met de hulpfunctie.
network = define_network_architecture()Toon daarna de grafische weergave. We slaan het resultaat eerst op als een PNG-bestand voordat we het tonen; zo kun je het makkelijker met anderen delen.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Het resultaat zie je hieronder.
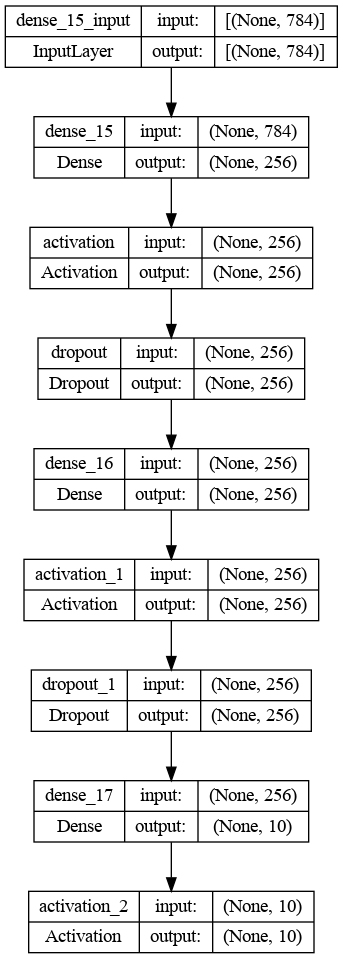
Grafische architectuur van het convolutionele neurale netwerk
De delta berekenen
Voordat we in het trainingsproces van het model duiken, bekijken we hoe de deltafoutverdeling wordt berekend met behulp van de netwerkarchitectuur.
De deltafoutverdeling is de afgeleide van de verliesfunctie ten opzichte van de activatie van elke node en geeft aan hoeveel de activatie van elke node heeft bijgedragen aan de uiteindelijke fout.
De bovenstaande architectuur bestaat uit drie hoofdlagen:
- Inputlaag van 784 eenheden, overeenkomend met een 28x28 inputbeeld
- Verborgen laag van 512 eenheden met de ReLU-activatie
- Outputlaag met 10 eenheden, overeenkomend met het aantal unieke labels, met softmax-activatiefunctie
Laten we nu verdergaan met de deltafoutberekening voor elke laag.
Outputlaag
Noem de output van de softmaxlaag O (O) en de ware labels Y. Met de cross-entropy-verliesfunctie wordt de deltafout δ output:
δ output = O - Y
Deze formule komt voort uit de basisberekening van hoe de cross-entropy verandert wanneer de softmaxoutput verandert.
Verborgen laag
Voor de verborgen laag wordt de deltafout δ hidden en hangt die af van de fout van de volgende laag (de outputlaag) en de afgeleide van de ReLU-activatiefunctie.
De afgeleide van ReLU is 1 voor positieve inputs en 0 voor negatieve, zoals hieronder te zien is.
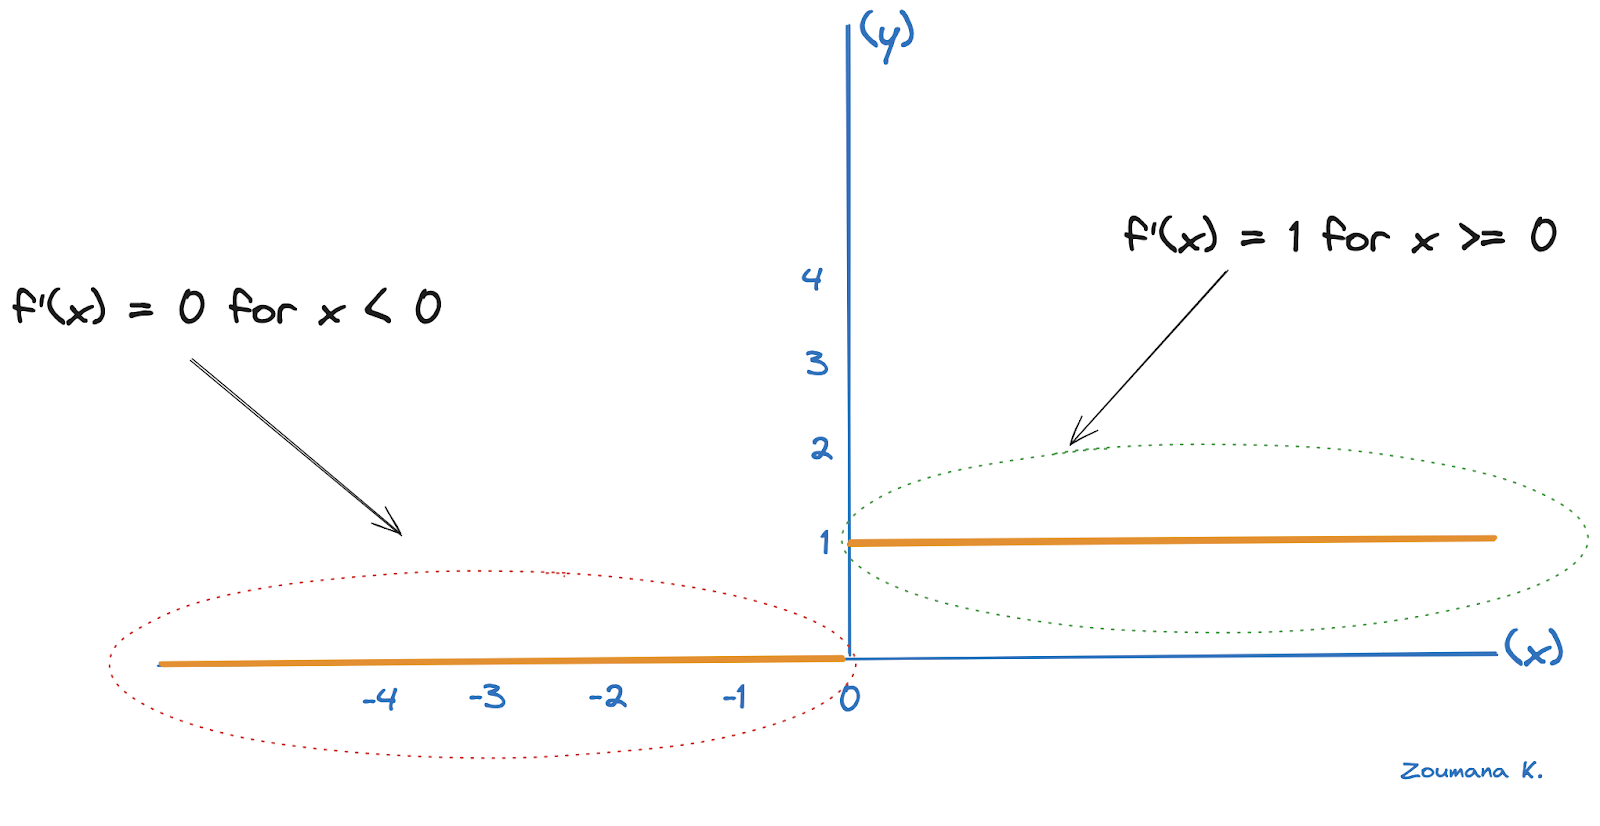
Illustratie van de afgeleide van ReLU
Noem Zhidden de input van de ReLU-functie in de verborgen laag en Woutput de gewichten die de verborgen laag met de outputlaag verbinden. De deltafout voor de verborgen laag wordt in dit geval:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- De punt “.” duidt op matrixvermenigvuldiging
- Het teken ⊙ staat voor elementgewijze vermenigvuldiging
- ReLU’(Zhidden) komt overeen met de afgeleide van ReLU bij Zhidden
Inputlaag
Als we meer verborgen lagen hadden, zou het proces achterwaarts doorgaan, waarbij de deltafout van elke laag afhangt van de deltafout van de volgende laag en de afgeleide van de eigen activatiefunctie.
Algemener geldt voor een willekeurige laag k in het netwerk (behalve de outputlaag) de formule voor deltafoutberekening:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 is de getransponeerde van de gewichtenmatrix van de volgende laag
- f’ is de afgeleide van de activatiefunctie voor laag k
- Zk is de input van de activatiefunctie in laag k
Compileren van het netwerk
Met dit begrip van de foutberekening gaan we het netwerk compileren om de structuur te optimaliseren voor het trainingsproces.
Tijdens het compileren moeten we enkele cruciale keuzes maken:
- Keuze van optimalisatie-algoritme: dit houdt in dat we een algoritme kiezen voor gradiëntafdalingsoptimalisatie. Er zijn meerdere opties, zoals Stochastic Gradient Descent (SGD), Adagrad en RMSprop, dat in dit artikel wordt gebruikt.
- Selectie van een verliesfunctie: de verlies- of kostfunctie is essentieel tijdens het trainen. Ze kwantificeert hoe goed het netwerk presteert, en de keuze moet aansluiten bij de aard van het classificatie- of regressieprobleem. We focussen op categorische cross-entropy vanwege het multiclass-karakter van het probleem.
- Keuze van een prestatiemetric: lijkt op een verliesfunctie, maar wordt vooral gebruikt om de effectiviteit van het model op de testdataset te evalueren; wij gebruiken nauwkeurigheid.
De code voor bovenstaande drie keuzes staat hieronder:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Het netwerk trainen
Een van de grootste problemen bij het trainen van een model is overfitting. Het is cruciaal het model tijdens het trainen te monitoren om te zorgen voor goede generalisatie; een manier om dat te doen is early stopping.
De volledige logica wordt hieronder geïllustreerd:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Het model wordt 15 epochs getraind met een batchgrootte van 256, en 20% van de trainingsdata wordt gebruikt voor validatie van het model.
Na het trainen worden de prestaties op training en validatie hieronder geplot.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()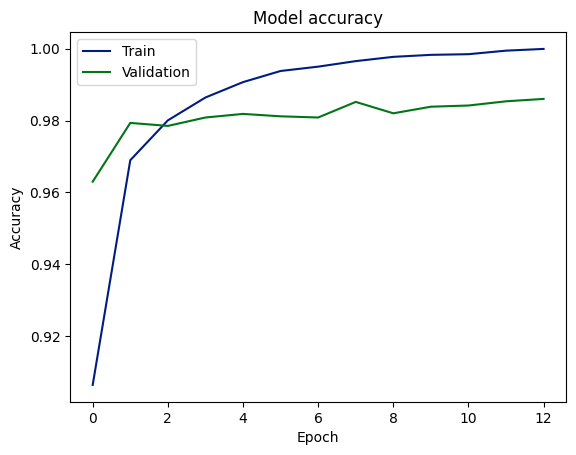
Nauwkeurigheidsscores voor training en validatie
Evaluatie op testdata
Nu kunnen we de modelprestaties op de testdata evalueren met de functie evaluate van het model.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))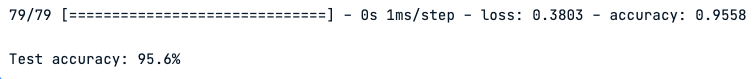
Modelprestaties op testdata
De grafiek laat zien dat het model met hoge nauwkeurigheid leert voorspellen, met ongeveer 98% op zowel validatie- als testdatasets. Dit duidt op goede generalisatie van training naar onzichtbare data. De kloof tussen training- en validatienauwkeurigheid kan echter een teken van overfitting zijn, al kan de consistentie tussen validatie- en testnauwkeurigheid die zorg verminderen.
Aanbeveling
Ook al vertoont het model hoge nauwkeurigheid en generalisatievermogen, er is nog ruimte voor verbetering. Hieronder staan enkele acties om de prestaties verder te verhogen.
- Regularisatie: integreer regularisatiemethoden om overfitting te verminderen.
- Early stopping: gebruik early stopping tijdens het trainen om overfitting te voorkomen.
- Foutanalyse: analyseer misclassificaties om onderliggende problemen te identificeren en te verhelpen.
- Diversiteitstesten: test het model op uiteenlopende datasets om de robuustheid te bevestigen.
- Breder palet aan metrics: gebruik precision, recall en F1-score voor een volledige prestatie-evaluatie, vooral bij ongebalanceerde data.
Conclusie
Samengevat bood dit artikel een uitgebreide verkenning van backpropagation, een essentiële techniek binnen machine learning. We begonnen met een heldere definitie van wat backpropagation is en beschreven de cruciale rol in de vooruitgang van kunstmatige intelligentie.
Vervolgens doken we in de werking van backpropagation en enkele voordelen, zoals efficiënter leren, terwijl we ook de beperkingen en uitdagingen erkenden.
Daarna gaven we gedetailleerde richtlijnen voor het opzetten en bouwen van neurale netwerken, met nadruk op het belang van forward propagatie.
In de afsluitende secties bespraken we de stappen voor het berekenen van delta’s en het bijwerken van netwerkgewichten, die essentieel zijn om het leerproces te verfijnen.
Al met al is dit artikel een waardevolle bron voor iedereen die backpropagation in neurale netwerken wil begrijpen en effectief wil toepassen.
Wil je je deep-learningvaardigheden versterken? Onze cursus Deep Learning met PyTorch helpt je om met vertrouwen dieper in neurale netwerken te duiken en je kennis verder uit te bouwen.


