La backpropagation è una parte essenziale dell’addestramento moderno delle reti neurali, che consente a questi sofisticati algoritmi di apprendere dai dataset di training e migliorare nel tempo.
Capire e padroneggiare l’algoritmo di backpropagation è fondamentale per chiunque lavori nel campo delle reti neurali e del deep learning. Questo tutorial offre un’esplorazione approfondita della backpropagation.
Si parte spiegando cos’è la backpropagation e come funziona, insieme ai suoi vantaggi e ai suoi limiti, per poi passare a un’esperienza pratica applicandola a un dataset ampiamente utilizzato.
Che cos’è la backpropagation?
Introdotto negli anni ’70, l’algoritmo di backpropagation è il metodo per ottimizzare i pesi di una rete neurale rispetto al tasso di errore ottenuto nell’iterazione o epoca precedente, ed è un metodo standard per addestrare le reti neurali artificiali.
Puoi pensarla come un sistema di feedback in cui, dopo ogni ciclo di training o "epoca", la rete rivede le proprie prestazioni sui compiti. Calcola la differenza tra il suo output e la risposta corretta, nota come errore. Poi regola i suoi parametri interni, o "pesi", per ridurre questo errore la volta successiva. Questo metodo è essenziale per affinare l’accuratezza della rete neurale ed è una strategia di base per imparare a fare previsioni o decisioni migliori
Come funziona la backpropagation?
Ora che sai cos’è la backpropagation, vediamo come funziona. Di seguito trovi un’illustrazione dell’algoritmo di backpropagation applicato a una rete neurale con:
- Due input X1 e X2
- Due livelli nascosti N1X e N2X, dove X assume i valori 1, 2 e 3
- Un livello di output
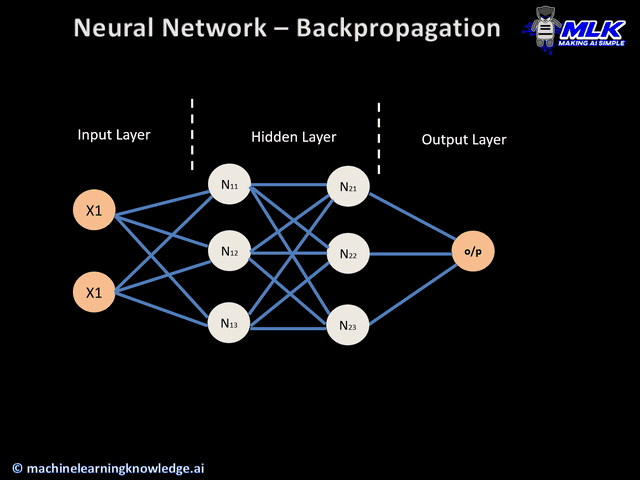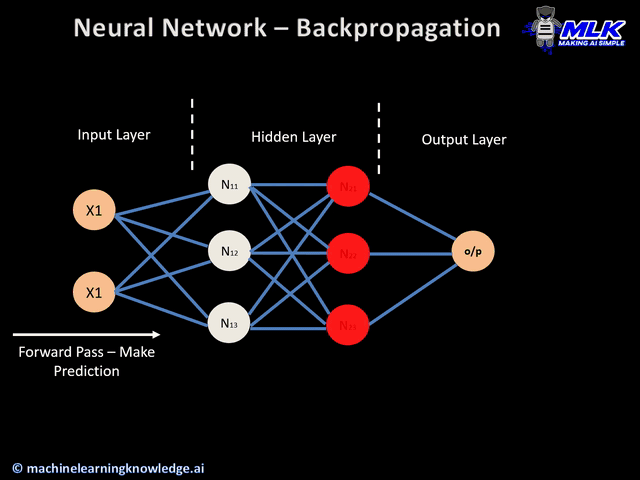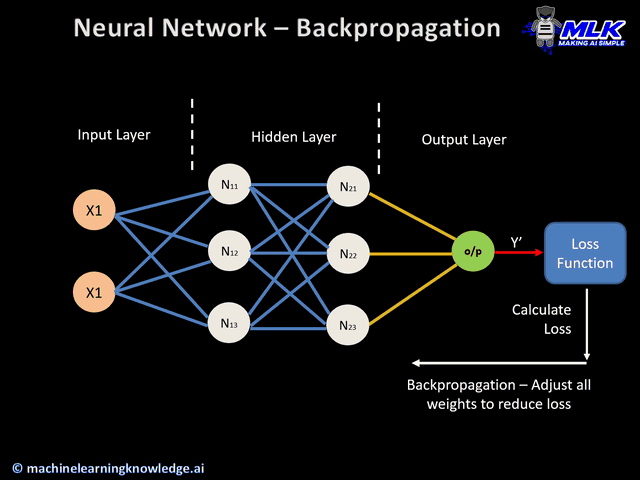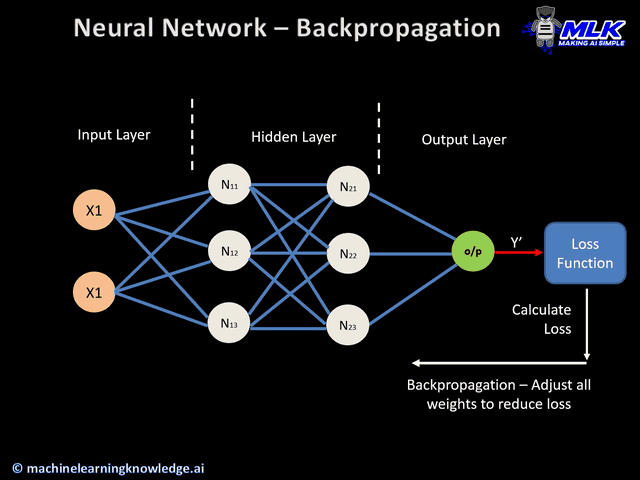
Illustrazione della backpropagation (fonte: machinelearningknowledge)
Nel complesso, l’algoritmo di backpropagation prevede quattro passaggi principali:
- Passaggio in avanti (forward pass)
- Calcolo degli errori
- Passaggio all’indietro (backward pass)
- Aggiornamento dei pesi
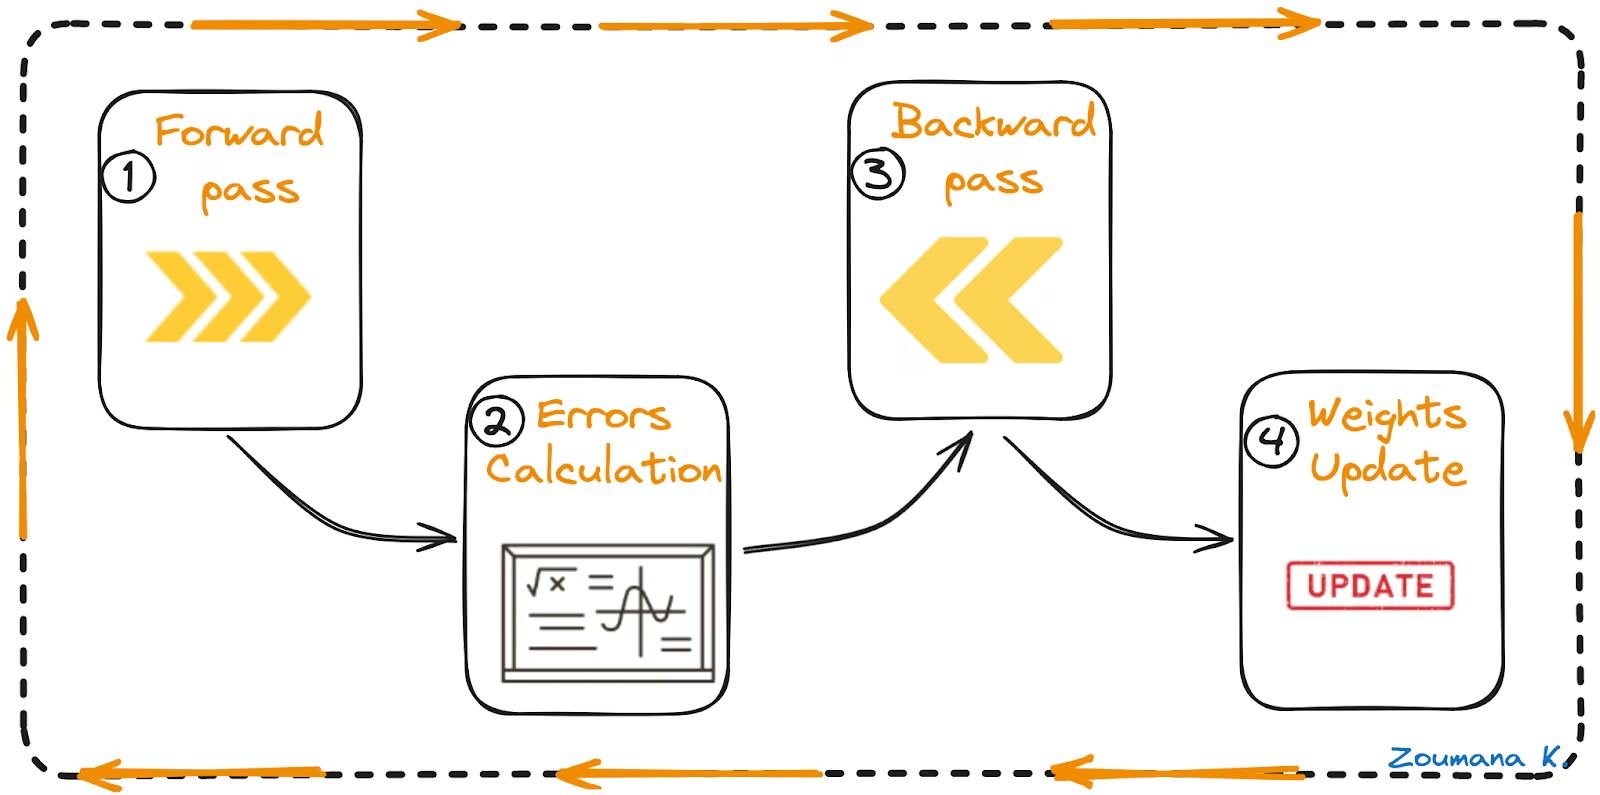
Forward pass, calcolo dell’errore, backward pass e aggiornamento dei pesi
Capiremo ciascuno di questi passaggi partendo dall’animazione sopra.
Forward pass
Questo è il primo passaggio del processo di backpropagation, ed è illustrato di seguito:
- I dati (input X1 e X2) vengono forniti al livello di input
- Poi, ogni input viene moltiplicato per il peso corrispondente e i risultati sono passati ai neuroni N1X e N2X dei livelli nascosti.
- Quei neuroni applicano una funzione di attivazione agli input pesati ricevuti e il risultato passa al livello successivo.
Calcolo degli errori
- Il processo continua fino a quando il livello di output genera l’output finale (o/p).
- L’output della rete viene quindi confrontato con il ground truth (output desiderato) e si calcola la differenza, ottenendo un valore di errore.
Backward pass
Questo è il vero passaggio di backpropagation e non può essere eseguito senza i passaggi precedenti di forward e calcolo dell’errore. Ecco come funziona:
- Il valore di errore ottenuto in precedenza viene utilizzato per calcolare il gradiente della funzione di perdita.
- Il gradiente dell’errore viene propagato all’indietro attraverso la rete, partendo dal livello di output fino ai livelli nascosti.
- Man mano che il gradiente dell’errore si propaga all’indietro, i pesi (rappresentati dalle linee che collegano i nodi) vengono aggiornati in base al loro contributo all’errore. Ciò comporta il calcolo della derivata dell’errore rispetto a ciascun peso, che indica di quanto cambierebbe l’errore a seguito di una variazione del peso.
- Il learning rate determina l’ampiezza degli aggiornamenti dei pesi. Un learning rate minore significa che i pesi vengono aggiornati di una quantità più piccola, e viceversa.
Aggiornamento dei pesi
- I pesi vengono aggiornati nella direzione opposta al gradiente, da cui il nome "discesa del gradiente". L’obiettivo è ridurre l’errore nel successivo forward pass.
- Questo processo di forward pass, calcolo dell’errore, backward pass e aggiornamento dei pesi continua per più epoche finché le prestazioni della rete non raggiungono un livello soddisfacente o smettono di migliorare in modo significativo.
Vantaggi della backpropagation
La backpropagation è una tecnica fondamentale nell’addestramento delle reti neurali, apprezzata per la sua implementazione lineare, la semplicità di programmazione e l’ampia applicabilità a diverse architetture di rete.
Il nostro tutorial Costruire modelli di reti neurali (NN) in R è un ottimo punto di partenza per chi è interessato a imparare sulle reti neurali. Insegna come creare un modello di rete neurale in R.
Per i programmatori Python, il tutorial Recurrent Neural Network (RNN) fornisce una guida completa sul popolare modello di deep learning RNN con un’esperienza pratica costruendo un predittore del prezzo delle azioni MasterCard.
Ora approfondiamo ciascuno dei benefici citati in precedenza:
- Facilità di implementazione: accessibile tramite numerose librerie di deep learning come Pytorch e Keras, facilitandone l’uso in applicazioni diverse.
- Semplicità di programmazione: codice semplificato grazie all’astrazione dei framework, riducendo la necessità di matematica complessa.
- Flessibilità: adattabile a diverse architetture, adatta a un ampio spettro di sfide di IA.
Limitazioni e sfide
Nonostante il successo dell’algoritmo di backpropagation, non è privo di limitazioni, che possono influenzare l’efficienza e l’efficacia del processo di training di una rete neurale. Esploriamo alcuni di questi vincoli:
- Qualità dei dati: dati di scarsa qualità, inclusi rumore, incompletezza o bias, possono portare a modelli imprecisi, poiché la backpropagation apprende esattamente da ciò che riceve.
- Durata dell’addestramento: la backpropagation spesso richiede tempi di training estesi, che possono essere poco pratici con reti di grandi dimensioni.
- Complessità basata su matrici: le operazioni matriciali nella backpropagation scalano con la dimensione della rete, aumentando la richiesta computazionale e potenzialmente superando le risorse disponibili.
Implementare la backpropagation
Con tutte queste informazioni sull’algoritmo di backpropagation, è il momento di vederne l’applicazione in uno scenario reale implementando una rete neurale per riconoscere cifre scritte a mano dal dataset MNIST.
Questa sezione copre tutti i passaggi, dalla visualizzazione dei dati al training e alla valutazione del modello. Il codice sorgente completo è disponibile in questo workbook DataLab; puoi facilmente crearne una copia per eseguire il codice nel browser, senza installare nulla sul tuo computer.
Informazioni sul dataset
Il dataset MNIST è ampiamente utilizzato nel campo del riconoscimento di immagini. È composto da 70000 immagini in scala di grigi di cifre scritte a mano da 0 a 9, e ogni immagine misura 28x28 pixel.
Il dataset è disponibile nella funzione mnist del modulo Keras.datasets e viene caricato come segue dopo l’import della libreria mnist:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Analisi esplorativa dei dati
L’analisi esplorativa dei dati è un passaggio fondamentale prima di costruire qualsiasi modello di machine learning o deep learning perché aiuta a comprendere meglio la natura dei dati a disposizione e quindi guida nella scelta del tipo di modello da utilizzare.
Le attività principali includono:
- Identificare il numero totale di dati sia nel dataset di training che in quello di test.
- Visualizzazione casuale di alcune cifre dal dataset di training.
- Visualizzare la distribuzione delle etichette nel dataset di training.
Il dataset complessivo è composto da 70000 immagini. La suddivisione tipica del dataset originale è la seguente, e non esiste una regola fissa:
- 70% o 80% per il dataset di training
- 30% o 20% per il dataset di test
Alcune suddivisioni possono arrivare anche al 90% per il training e al 10% per il test.
Nel nostro scenario, i dataset di training e test sono già caricati, quindi non è necessario effettuare split. Osserviamo la dimensione di questi dataset.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")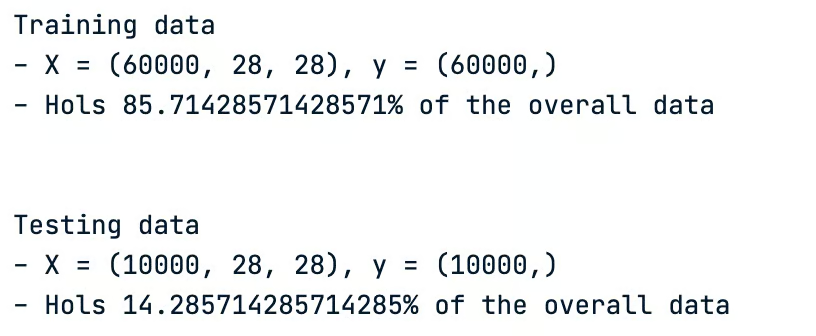
Caratteristiche dei dataset di training e di test
- Il dataset di training ha 60000 immagini e corrisponde all’85,71% del dataset originale.
- Il dataset di test, invece, contiene le restanti 10000 immagini, quindi il 14,28% del dataset originale.
Ora visualizziamo alcune cifre casuali. Questo si ottiene con la funzione di supporto plot_images, che accetta due parametri principali:
- Il numero di immagini da tracciare, e
- Il dataset da considerare per la visualizzazione
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Vogliamo visualizzare nove immagini dai dati di training, il che corrisponde al seguente snippet di codice:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
L’esecuzione corretta del codice sopra genera le seguenti nove cifre.
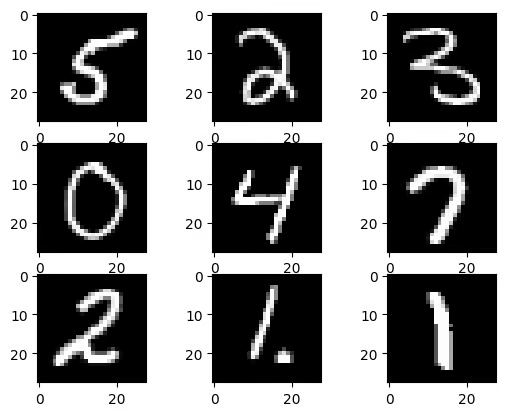
Nove immagini casuali dal dataset di training
Le seguenti cifre sono visualizzate dopo aver eseguito la stessa funzione per la seconda volta, e notiamo che non sono le stesse; ciò è dovuto alla natura casuale della funzione di supporto.
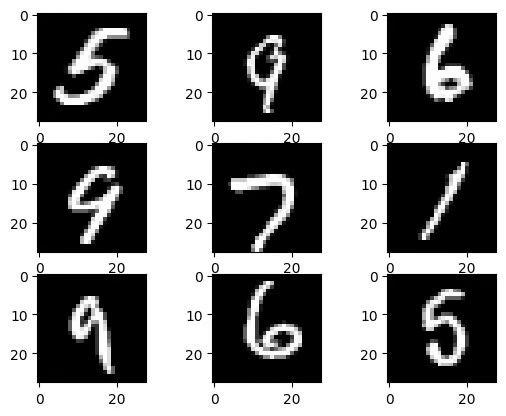
Nove immagini casuali dal dataset di training dopo una seconda esecuzione della funzione
L’ultimo compito per l’analisi dei dati è visualizzare la distribuzione delle etichette del dataset di training utilizzando la funzione di supporto plot_labels_distribution.
- Sull’asse X abbiamo tutte le cifre possibili
- Sull’asse Y abbiamo il numero totale di tali cifre
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
La funzione viene applicata al dataset di training fornendo le sue etichette come segue:
plot_labels_distribution(train_labels)Di seguito il risultato: notiamo che tutte e dieci le cifre sono distribuite in modo quasi uniforme sull’intero dataset, il che è una buona notizia, perché significa che non sono necessarie ulteriori azioni per bilanciare la distribuzione delle etichette.
Preprocessing dei dati
I dati del mondo reale richiedono solitamente un certo preprocessing per renderli adatti all’addestramento dei modelli. Ci sono tre principali attività di preprocessing applicate sia alle immagini di training che a quelle di test:
- Normalizzazione delle immagini: consiste nel convertire tutti i valori dei pixel da 0-255 a 0-1. Questo favorisce una convergenza più rapida durante il training
- Reshape delle immagini: invece di avere, per ogni immagine, una matrice quadrata 28 per 28, appiattiamo ciascuna in vettori da 784 elementi per renderla adatta agli input della rete neurale.
- Codifica delle etichette: convertire le etichette in vettori one-hot. Questo eviterà i problemi legati alla gerarchia numerica. In questo modo, il modello non verrà influenzato a favore delle cifre più grandi.
La logica complessiva del preprocessing è implementata nella funzione di supporto preprocess_data qui sotto:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
La funzione viene applicata ai dataset utilizzando questi snippet di codice:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Ora osserviamo i valori massimi e minimi correnti dei pixel di entrambi i dataset:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Il risultato del codice è riportato di seguito e notiamo che la normalizzazione è stata eseguita correttamente.
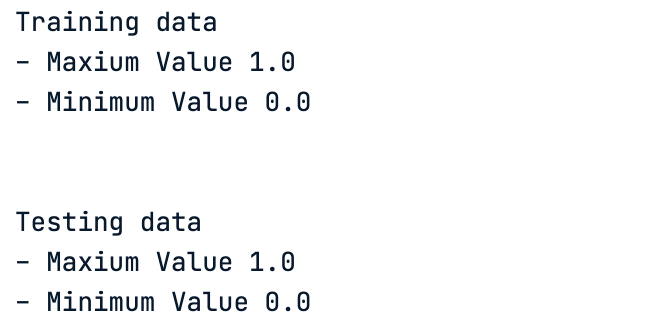
Valori minimi e massimi dei pixel dopo la normalizzazione
Analogamente alle etichette, otteniamo infine una matrice di zeri e uni, che corrispondono ai valori one-hot codificati di tali etichette.
# One hot encoding of the test data labels
test_images
Risultato di seguito:
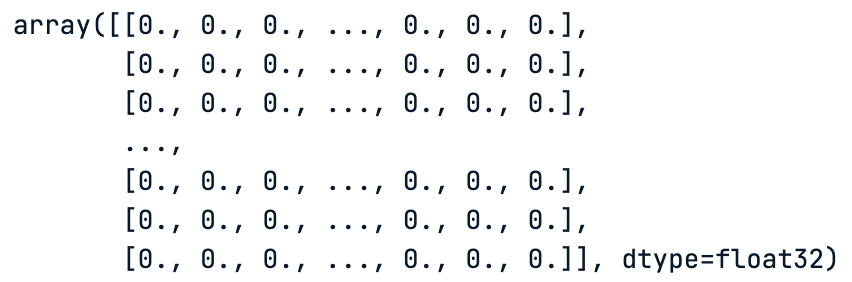
One hot encoding delle etichette dei dati di test
# One hot encoding of the train data labels
train_labels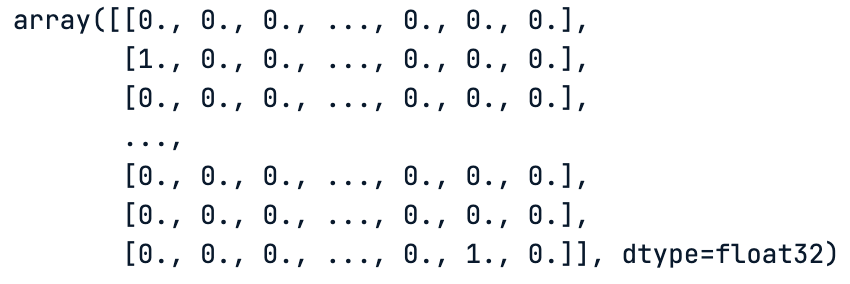
One hot encoding delle etichette dei dati di training
Struttura della rete
Poiché stiamo affrontando un compito di classificazione di immagini, una convolutional neural network è più adatta a questo scenario. Prima di scrivere codice, è importante definire l’architettura del modello: è proprio l’obiettivo di questa sezione.
Per saperne di più sulle convolutional neural network, il nostro tutorial Introduzione alle Convolutional Neural Network (CNN) è un’ottima risorsa di partenza. È una guida completa per capire le CNN, il loro impatto sull’analisi delle immagini e alcune strategie chiave per contrastare l’overfitting nelle applicazioni robuste di CNN e deep learning.
L’architettura per questo caso d’uso combina diversi tipi di layer per una classificazione efficace delle immagini. Ecco i componenti chiave del modello:
- Livello convoluzionale: inizia con un layer che utilizza filtri 3x3 e 32 filtri per elaborare le immagini.
- Max pooling: dopo il layer convoluzionale, includi un layer di max pooling per ridurre la dimensione delle mappe di feature.
- Flattening: appiattisci l’output del layer di pooling in un unico vettore, preparandolo al processo di classificazione.
- Layer denso: aggiungi un layer denso con 100 nodi tra l’output appiattito e il layer finale per interpretare le feature estratte.
- Layer di output: usa un layer di output con 10 nodi, corrispondenti alle 10 categorie di immagini. Ogni nodo calcola la probabilità che un’immagine appartenga a una di queste categorie.
- Attivazione Softmax: nel layer di output, applica una funzione di attivazione softmax per la classificazione multiclasse.
- Funzione di attivazione ReLU: utilizza la ReLU (Rectified Linear Unit) in tutti i layer per l’elaborazione non lineare.
- Ottimizzatore: impiega un ottimizzatore a discesa del gradiente stocastica con learning rate 0,001 e momentum 0,95 per regolare il modello durante l’addestramento.
- Funzione di perdita: usa la categorical cross-entropy, ideale per compiti di classificazione multiclasse.
- Metrica di accuratezza: concentrati sulla metrica di accuratezza della classificazione, dato l’equilibrio nella distribuzione delle classi.
Tutte queste informazioni sono implementate nella funzione di supporto define_network_architecture. Ma prima, dobbiamo importare tutte le librerie necessarie:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Ecco l’implementazione della funzione di supporto.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Il codice sorgente è valido, ma è ancora meglio avere una visualizzazione grafica della rete, ottenuta usando la funzione plot_model dal modulo keras.utils.vis_utils.
Per prima cosa, genera la rete dalla funzione di supporto.
network = define_network_architecture()Quindi, mostra la rappresentazione grafica. Prima salviamo il risultato in un file PNG e poi lo visualizziamo; questo facilita la condivisione con altri.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Il risultato è mostrato di seguito.
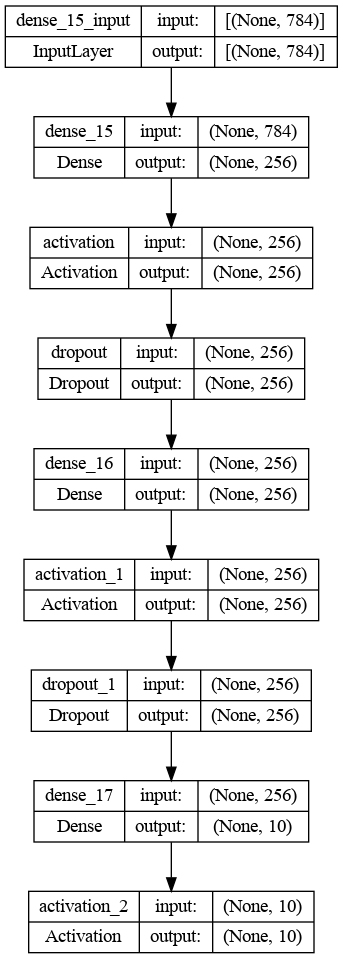
Architettura grafica della convolutional neural network
Calcolo della delta
Prima di addentrarci nel processo di training del modello, vediamo come viene calcolata la distribuzione dell’errore delta usando l’architettura della rete.
La distribuzione dell’errore delta è la derivata della funzione di perdita rispetto alla funzione di attivazione di ciascun nodo e indica quanto l’attivazione di ogni nodo ha contribuito all’errore finale.
L’architettura sopra è composta da tre layer principali:
- Layer di input di 784 unità corrispondenti a un’immagine di input 28x28
- Layer nascosto di 512 unità con attivazione ReLU
- Layer di output con 10 unità, che corrispondono al numero di etichette uniche, con funzione di attivazione softmax
Ora procediamo con il calcolo dell’errore delta per ciascun layer.
Layer di output
Consideriamo l’output del layer softmax come grande O (O) e le etichette vere come Y. Utilizzando la loss di entropia incrociata δ output, l’errore delta diventa:
δ output = O - Y
Questa formula deriva dal calcolo base di come cambia la loss di entropia incrociata al variare dell’output della softmax.
Layer nascosto
Per il layer nascosto, l’errore delta diventa δ hidden e dipende dall’errore del layer successivo, che corrisponde al layer di output, e dalla derivata della funzione di attivazione ReLU.
La derivata della ReLU è 1 per input positivi e 0 per quelli negativi, come mostrato sotto.
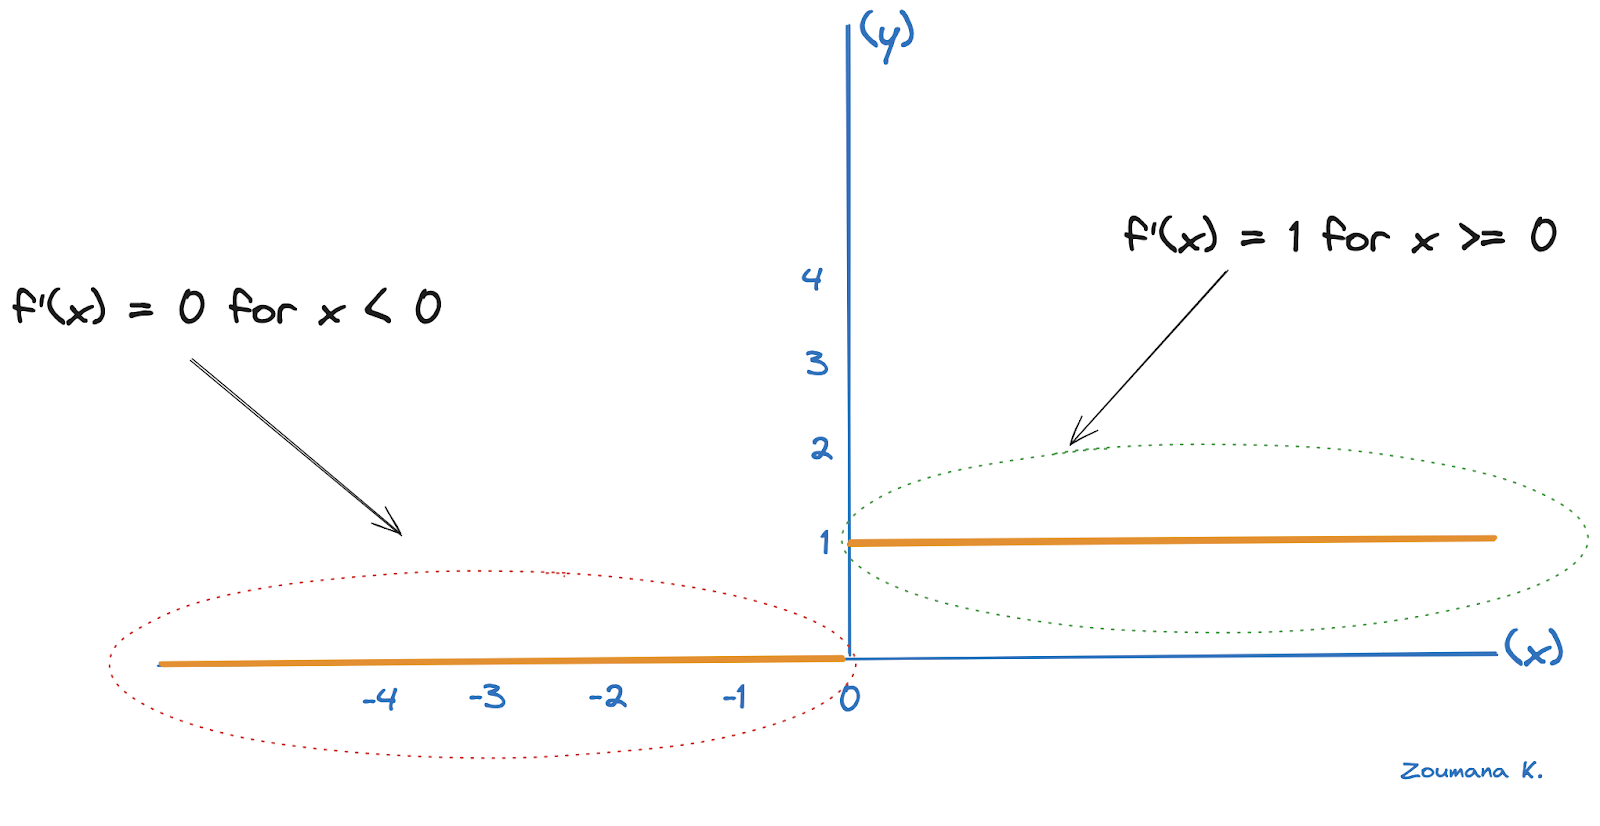
Illustrazione della derivata della ReLU
Consideriamo Zhidden come l’input alla funzione ReLU nel layer nascosto e Woutput come i pesi che collegano il layer nascosto a quello di output. In questo caso, l’errore delta per il layer nascosto diventa:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- Il punto "+"." indica la moltiplicazione di matrici
- Il simbolo ⊙ corrisponde alla moltiplicazione elemento per elemento
- ReLU’(Zhidden) corrisponde alla derivata della ReLU in Zhidden
Layer di input
Allo stesso modo, se avessimo più layer nascosti, il processo continuerebbe all’indietro con l’errore delta di ciascun layer che dipende dall’errore delta del layer successivo e dalla derivata della sua funzione di attivazione.
In uno scenario più generale, per un qualunque layer k nella rete (tranne il layer di output), la formula per il calcolo dell’errore delta è:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 corrisponde alla trasposta della matrice dei pesi del layer successivo
- f’ è la derivata della funzione di attivazione per il layer k e
- Zk è l’input alla funzione di attivazione nel layer k
Compilazione della rete
Con questa comprensione del calcolo dell’errore, compiliamo la rete per ottimizzarne la struttura in vista del training.
Durante la compilazione, dobbiamo effettuare alcune scelte critiche:
- Scelta dell’algoritmo di ottimizzazione: si tratta di selezionare un algoritmo per l’ottimizzazione tramite discesa del gradiente. Esistono diverse opzioni, come Stochastic Gradient Descent (SGD), Adagrad e RMSprop, utilizzato in questo articolo.
- Scelta della funzione di perdita: la funzione di perdita, nota anche come funzione di costo, è parte essenziale del training. Quantifica le prestazioni della rete e la scelta deve essere in linea con la natura del problema di classificazione o regressione. Qui ci concentriamo sulla categorical cross entropy per la natura multiclasse del problema.
- Scelta di una metrica di performance: pur simile a una funzione di perdita, una metrica di performance è usata principalmente per valutare l’efficacia del modello sul dataset di test; utilizziamo l’accuratezza
Il codice per le tre scelte sopra è riportato di seguito:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Training della rete
Uno dei problemi più grandi durante l’addestramento di un modello è l’overfitting; è fondamentale monitorare il modello durante il training per garantirne una migliore generalizzazione, e un modo per farlo è il concetto di early stopping.
La logica completa è illustrata di seguito:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Il modello viene addestrato per 15 epoche usando un batch size di 256 e il 20% dei dati di training viene utilizzato per la validazione del modello.
Dopo l’addestramento del modello, la cronologia delle prestazioni di training e validazione è tracciata di seguito.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()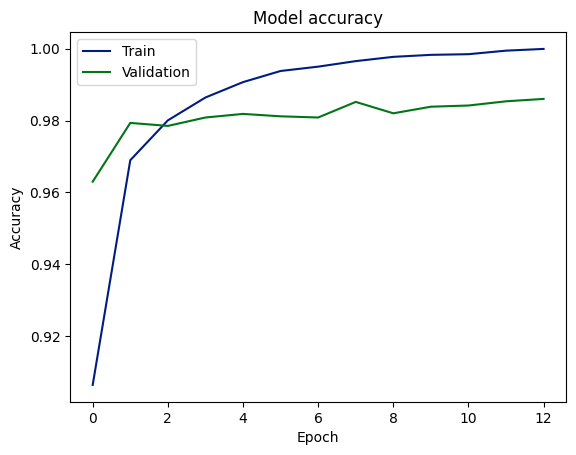
Punteggi di accuratezza in training e validazione
Valutazione sui dati di test
Ora possiamo valutare le prestazioni del modello sui dati di test usando la funzione evaluate del modello.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))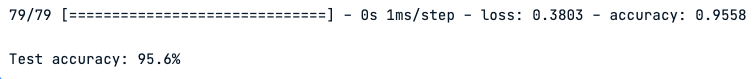
Prestazioni del modello sui dati di test
Il grafico indica che il modello ha imparato a prevedere con alta accuratezza, raggiungendo circa il 98% sia sui set di validazione che di test. Ciò suggerisce una buona generalizzazione dai dati di training a quelli non visti. Tuttavia, il divario tra accuratezza di training e di validazione potrebbe essere un segnale di overfitting, anche se la coerenza tra accuratezza di validazione e di test potrebbe attenuare questa preoccupazione.
Raccomandazioni
Anche se il modello mostra alta accuratezza e capacità di generalizzazione, c’è ancora margine di miglioramento. Ecco alcune azioni concrete per migliorare ulteriormente le prestazioni.
- Regolarizzazione: integra metodi di regolarizzazione per ridurre l’overfitting.
- Early stopping: utilizza l’early stopping durante il training per prevenire l’overfitting.
- Analisi degli errori: analizza le previsioni errate per individuare e correggere le cause sottostanti.
- Test di diversità: prova il modello su dataset vari per confermarne la robustezza.
- Metriche più ampie: usa precision, recall e F1-score per una valutazione completa delle prestazioni, soprattutto se i dati sono sbilanciati.
Conclusione
In sintesi, questo articolo ha fornito un’esplorazione completa della backpropagation, una tecnica essenziale nel campo del machine learning. Siamo partiti da una chiara definizione di cos’è la backpropagation e ne abbiamo delineato il ruolo fondamentale nell’avanzamento dell’intelligenza artificiale.
Successivamente, abbiamo approfondito il funzionamento della backpropagation insieme ad alcuni dei suoi vantaggi, come l’efficienza dell’apprendimento, riconoscendo al contempo le limitazioni e le sfide.
Poi abbiamo fornito indicazioni dettagliate sulla configurazione e la costruzione delle reti neurali, sottolineando l’importanza della propagazione in avanti.
Nelle sezioni conclusive, abbiamo esplorato i passaggi di calcolo delle delta e di aggiornamento dei pesi della rete, essenziali per affinare il processo di apprendimento.
Nel complesso, questo articolo è una risorsa preziosa per chiunque voglia comprendere e implementare efficacemente la backpropagation nelle reti neurali.
Vuoi rafforzare le tue competenze di deep learning? Il nostro corso Deep Learning con PyTorch ti aiuterà ad acquisire la sicurezza necessaria per approfondire le reti neurali e far progredire ulteriormente le tue conoscenze.




