Backpropagation là một phần thiết yếu trong quá trình huấn luyện mạng nơ-ron hiện đại, cho phép các thuật toán tinh vi này học từ tập dữ liệu huấn luyện và cải thiện theo thời gian.
Việc hiểu và làm chủ thuật toán backpropagation rất quan trọng với bất kỳ ai trong lĩnh vực mạng nơ-ron và học sâu. Hướng dẫn này cung cấp một khám phá chuyên sâu về backpropagation.
Bài viết bắt đầu bằng việc giải thích backpropagation là gì và cách nó hoạt động, cùng với các ưu điểm và hạn chế, trước khi đi vào trải nghiệm thực tế khi áp dụng nó cho một tập dữ liệu được sử dụng rộng rãi.
Backpropagation là gì?
Được giới thiệu từ những năm 1970, thuật toán backpropagation là phương pháp tinh chỉnh trọng số của mạng nơ-ron dựa trên tỷ lệ lỗi thu được ở vòng lặp hoặc epoch trước đó, và đây là phương pháp tiêu chuẩn để huấn luyện mạng nơ-ron nhân tạo.
Bạn có thể hình dung đây như một hệ thống phản hồi, trong đó sau mỗi vòng huấn luyện hay "epoch", mạng sẽ xem lại hiệu suất của mình trên các tác vụ. Nó tính toán chênh lệch giữa đầu ra của mình và đáp án đúng, được gọi là lỗi. Sau đó, nó điều chỉnh các tham số nội bộ hay "trọng số" để giảm lỗi này cho lần sau. Phương pháp này rất quan trọng để tinh chỉnh độ chính xác của mạng nơ-ron và là chiến lược nền tảng giúp học cách đưa ra dự đoán hoặc quyết định tốt hơn.
Backpropagation hoạt động như thế nào?
Giờ bạn đã biết backpropagation là gì, hãy đi sâu vào cách nó vận hành. Dưới đây là minh họa thuật toán backpropagation áp dụng cho một mạng nơ-ron gồm:
- Hai đầu vào X1 và X2
- Hai lớp ẩn N1X và N2X, trong đó X nhận các giá trị 1, 2 và 3
- Một lớp đầu ra
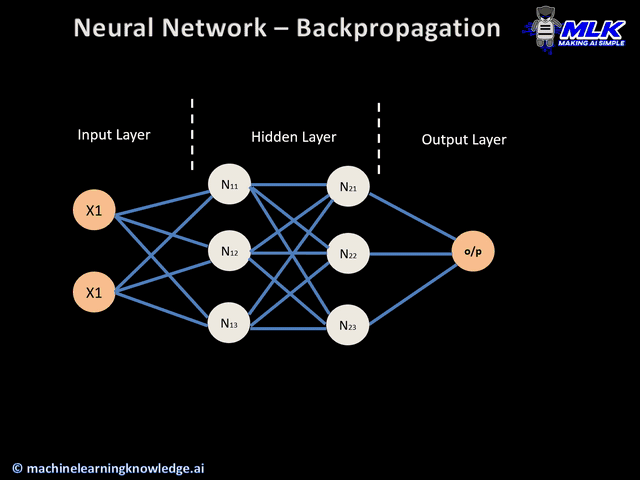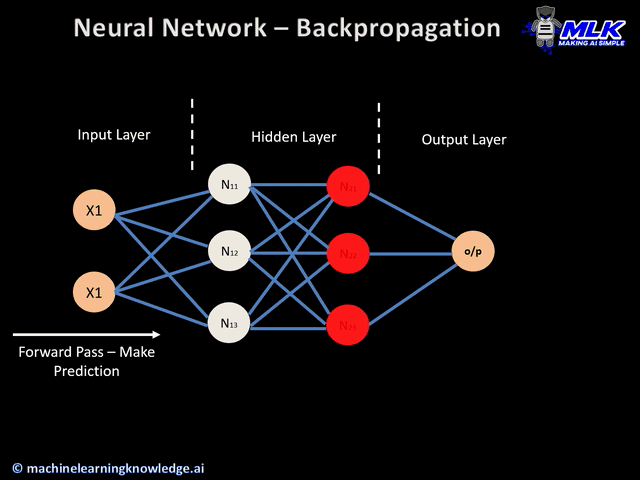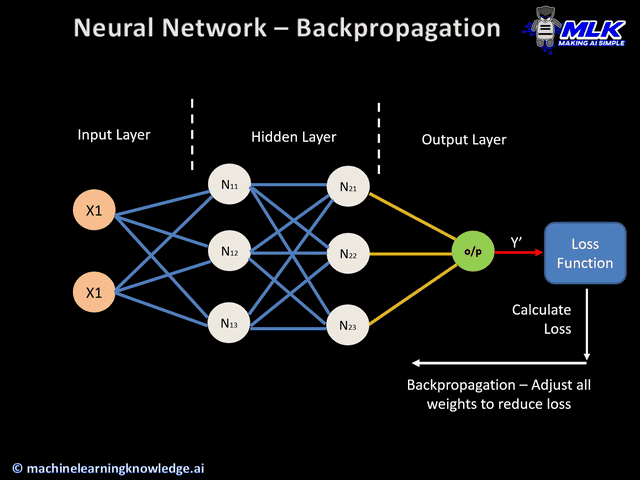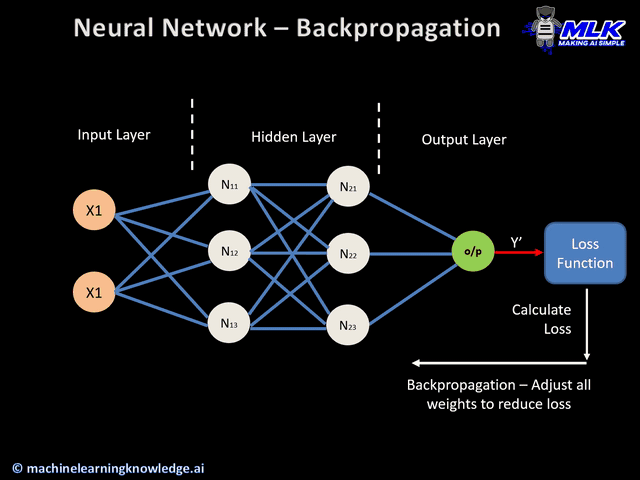
Minh họa backpropagation (nguồn: machinelearningknowledge)
Tổng thể có bốn bước chính trong thuật toán backpropagation:
- Lan truyền xuôi (forward pass)
- Tính toán lỗi
- Lan truyền ngược (backward pass)
- Cập nhật trọng số
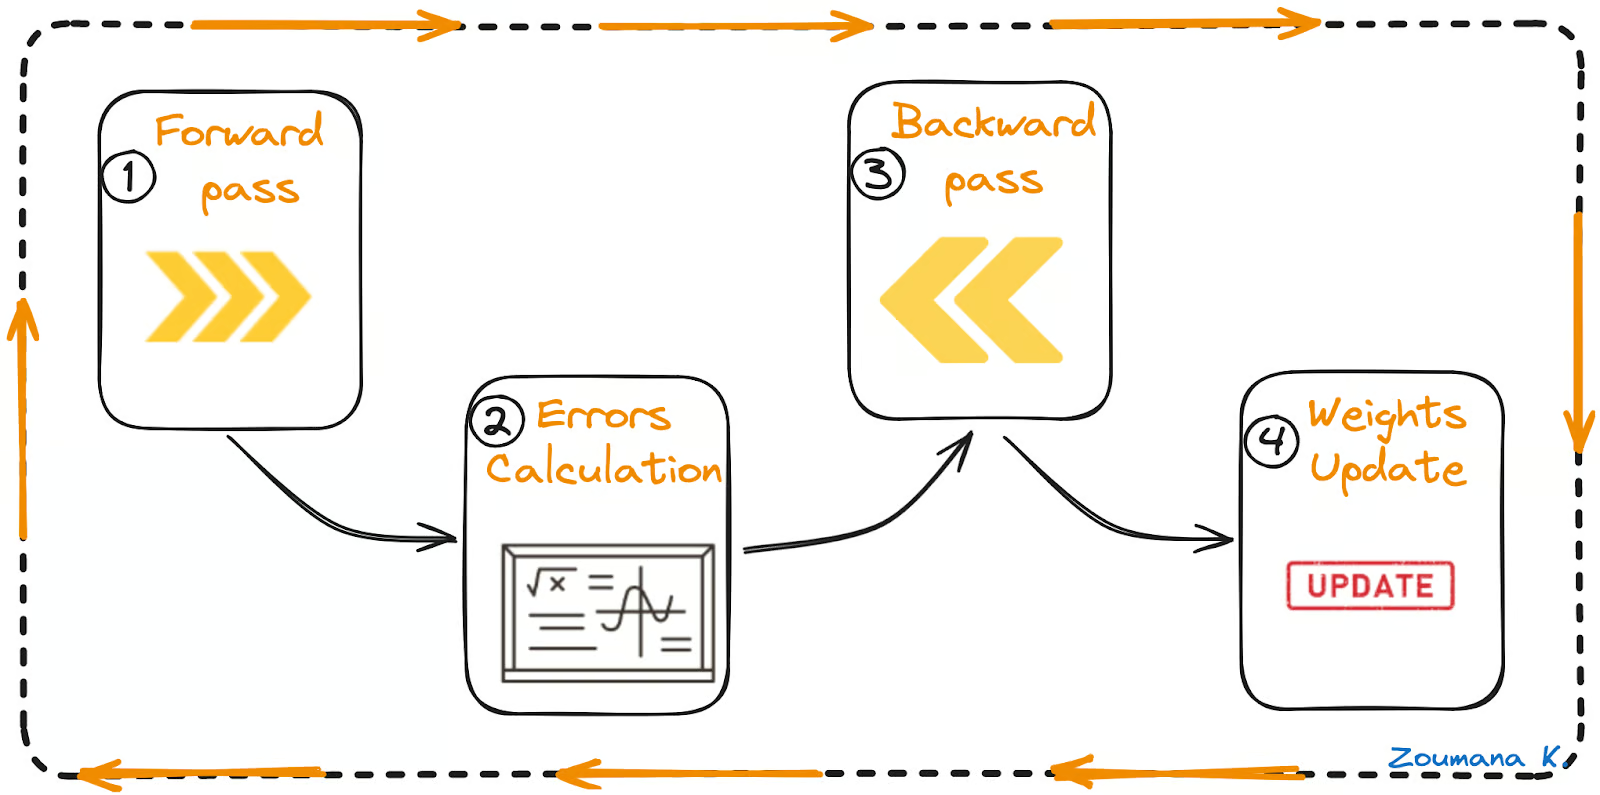
Lan truyền xuôi, tính toán lỗi, lan truyền ngược và cập nhật trọng số
Hãy cùng hiểu từng bước dựa trên hoạt hình ở trên.
Lan truyền xuôi
Đây là bước đầu tiên của quá trình backpropagation và được minh họa như sau:
- Dữ liệu (đầu vào X1 và X2) được đưa vào lớp đầu vào
- Sau đó, mỗi đầu vào được nhân với trọng số tương ứng và kết quả được truyền đến các nơ-ron N1X và N2X của các lớp ẩn.
- Các nơ-ron đó áp dụng hàm kích hoạt cho các đầu vào đã được trọng số, và kết quả được truyền sang lớp tiếp theo.
Tính toán lỗi
- Quá trình tiếp tục cho đến khi lớp đầu ra tạo ra kết quả cuối cùng (o/p).
- Đầu ra của mạng sau đó được so sánh với nhãn đúng (đầu ra mong muốn), và chênh lệch được tính ra thành một giá trị lỗi.
Lan truyền ngược
Đây là bước backpropagation thực sự và không thể thực hiện nếu thiếu hai bước lan truyền xuôi và tính lỗi ở trên. Cách thức như sau:
- Giá trị lỗi thu được trước đó được dùng để tính gradient của hàm mất mát.
- Gradient lỗi được lan truyền ngược qua mạng, bắt đầu từ lớp đầu ra về các lớp ẩn.
- Khi gradient lỗi lan truyền ngược, các trọng số (biểu diễn bằng các đường nối các nút) được cập nhật theo mức độ đóng góp của chúng vào lỗi. Việc này bao gồm lấy đạo hàm của lỗi theo từng trọng số, cho biết thay đổi trọng số sẽ làm lỗi thay đổi bao nhiêu.
- Tốc độ học (learning rate) quyết định độ lớn của bước cập nhật trọng số. Learning rate nhỏ hơn nghĩa là trọng số được cập nhật với biên độ nhỏ hơn, và ngược lại.
Cập nhật trọng số
- Các trọng số được cập nhật theo hướng ngược với gradient, dẫn đến tên gọi "hạ dốc (gradient descent)". Mục tiêu là giảm lỗi ở lần lan truyền xuôi tiếp theo.
- Quy trình lan truyền xuôi, tính lỗi, lan truyền ngược và cập nhật trọng số lặp lại qua nhiều epoch cho đến khi hiệu suất mạng đạt mức chấp nhận được hoặc không còn cải thiện đáng kể.
Ưu điểm của Backpropagation
Backpropagation là kỹ thuật nền tảng trong huấn luyện mạng nơ-ron, được đánh giá cao nhờ triển khai trực tiếp, lập trình đơn giản và khả năng áp dụng linh hoạt trên nhiều kiến trúc mạng.
Hướng dẫn Xây dựng mô hình Mạng nơ-ron (NN) trong R của chúng tôi là điểm khởi đầu tuyệt vời cho bất kỳ ai quan tâm đến mạng nơ-ron. Bài viết dạy cách tạo một mô hình mạng nơ-ron trong R.
Đối với lập trình viên Python, hướng dẫn Mạng nơ-ron Hồi quy (RNN) cung cấp chỉ dẫn toàn diện về mô hình học sâu phổ biến RNN, với trải nghiệm thực hành xây dựng bộ dự đoán giá cổ phiếu MasterCard.
Giờ hãy đi sâu hơn vào từng lợi ích đã nêu:
- Dễ triển khai: có thể tiếp cận qua nhiều thư viện học sâu như Pytorch và Keras, giúp dễ sử dụng trong các ứng dụng đa dạng.
- Đơn giản khi lập trình: mã lệnh được đơn giản hóa nhờ trừu tượng hóa của framework, giảm nhu cầu toán học phức tạp.
- Linh hoạt: thích nghi với nhiều kiến trúc, phù hợp với phổ rộng các bài toán AI.
Hạn chế và thách thức
Dù thuật toán backpropagation rất thành công, nó vẫn có những hạn chế có thể ảnh hưởng đến hiệu quả và hiệu suất của quá trình huấn luyện mạng nơ-ron. Hãy cùng điểm qua một số ràng buộc đó:
- Chất lượng dữ liệu: dữ liệu kém chất lượng, gồm nhiễu, thiếu hụt hoặc thiên lệch, có thể dẫn tới mô hình thiếu chính xác, vì backpropagation học đúng theo những gì được cung cấp.
- Thời gian huấn luyện: backpropagation thường cần thời gian huấn luyện dài, có thể không thực tế với các mạng lớn.
- Độ phức tạp ma trận: các phép toán ma trận trong backpropagation tăng theo kích thước mạng, làm tăng nhu cầu tính toán và có thể vượt quá tài nguyên sẵn có.
Triển khai Backpropagation
Với những hiểu biết trên về thuật toán backpropagation, đã đến lúc đi vào ứng dụng thực tế bằng cách triển khai một mạng nơ-ron nhận dạng chữ số viết tay từ tập dữ liệu MNIST.
Phần này bao quát mọi bước, từ trực quan hóa dữ liệu đến huấn luyện và đánh giá mô hình. Mã nguồn đầy đủ có trong workbook DataLab này; bạn có thể dễ dàng tạo bản sao để chạy mã ngay trên trình duyệt mà không cần cài đặt gì trên máy tính.
Về tập dữ liệu
Tập dữ liệu MNIST được sử dụng rộng rãi trong lĩnh vực nhận dạng ảnh. Nó gồm 70000 ảnh thang độ xám của các chữ số viết tay từ 0 đến 9, mỗi ảnh có kích thước 28x28 pixel.
Tập dữ liệu có sẵn qua hàm mnist trong mô-đun Keras.datasets, và được nạp như sau sau khi import thư viện mnist:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Phân tích dữ liệu khám phá
Phân tích dữ liệu khám phá là bước quan trọng trước khi xây dựng bất kỳ mô hình máy học hay học sâu nào vì nó giúp hiểu rõ hơn bản chất dữ liệu đang có, từ đó định hướng lựa chọn kiểu mô hình phù hợp.
Các nhiệm vụ chính gồm:
- Xác định tổng số dữ liệu trong cả tập huấn luyện và tập kiểm tra.
- Trực quan hóa ngẫu nhiên một số chữ số từ tập huấn luyện.
- Trực quan hóa phân bố nhãn trong tập huấn luyện.
Tổng thể tập dữ liệu gồm 70000 ảnh. Tỷ lệ chia tách điển hình của tập gốc như sau, và không có quy tắc cứng nhắc:
- 70% hoặc 80% cho tập huấn luyện
- 30% hoặc 20% cho tập kiểm tra
Một số cách chia còn dùng 90% cho huấn luyện và 10% cho kiểm tra.
Trong kịch bản của chúng ta, cả tập huấn luyện và kiểm tra đều đã được nạp, nên không cần tự chia tách. Hãy quan sát kích thước các tập này.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")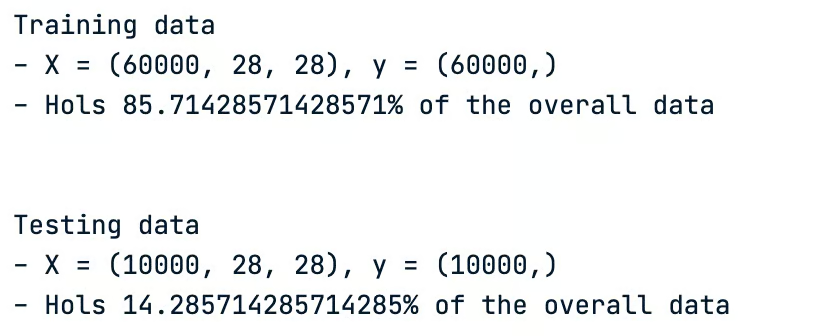
Đặc điểm của tập huấn luyện và tập kiểm tra
- Tập huấn luyện có 60000 ảnh, chiếm 85,71% tập gốc.
- Tập kiểm tra có 10000 ảnh còn lại, tức 14,28% tập gốc.
Giờ hãy trực quan hóa một vài chữ số ngẫu nhiên. Việc này được thực hiện bằng hàm trợ giúp plot_images, nhận hai tham số chính:
- Số lượng ảnh cần vẽ, và
- Tập dữ liệu được dùng để trực quan hóa
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Chúng ta muốn hiển thị chín ảnh từ dữ liệu huấn luyện, tương ứng với đoạn mã sau:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Chạy thành công đoạn mã trên sẽ tạo ra chín chữ số sau.
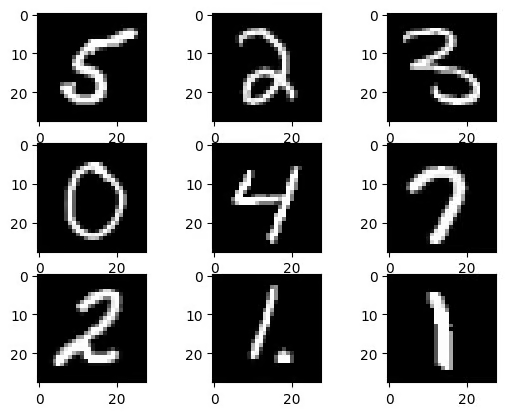
Chín ảnh ngẫu nhiên từ tập huấn luyện
Các chữ số sau đây được hiển thị sau khi chạy lại cùng hàm lần thứ hai, và ta thấy chúng không giống trước; điều này là do tính ngẫu nhiên của hàm trợ giúp.
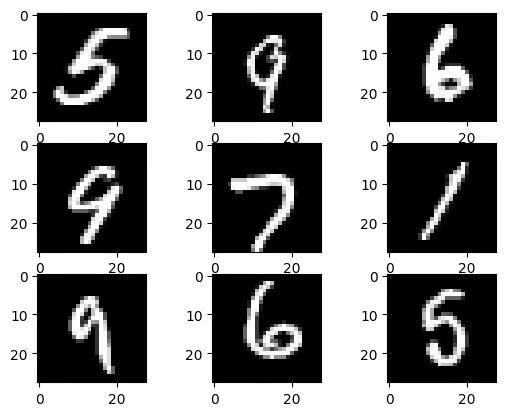
Chín ảnh ngẫu nhiên từ tập huấn luyện sau lần chạy thứ hai
Nhiệm vụ cuối cùng trong phân tích dữ liệu là trực quan hóa phân bố nhãn từ tập huấn luyện bằng hàm trợ giúp plot_labels_distribution.
- Trục X là tất cả các chữ số có thể
- Trục Y là tổng số lượng từng chữ số
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
Hàm được áp dụng cho tập huấn luyện bằng cách truyền vào các nhãn như sau:
plot_labels_distribution(train_labels)Kết quả bên dưới cho thấy cả mười chữ số gần như được phân bố đồng đều trong toàn bộ tập dữ liệu, đây là tín hiệu tốt, nghĩa là không cần thêm thao tác để cân bằng phân bố nhãn.
Tiền xử lý dữ liệu
Dữ liệu thực tế thường cần một số bước tiền xử lý để phù hợp cho việc huấn luyện mô hình. Có ba tác vụ tiền xử lý chính áp dụng cho cả ảnh huấn luyện và kiểm tra:
- Chuẩn hóa ảnh: chuyển tất cả giá trị pixel từ 0-255 về 0-1. Điều này giúp quá trình huấn luyện hội tụ nhanh hơn
- Đổi dạng ảnh: thay vì ma trận vuông 28x28 cho mỗi ảnh, ta làm phẳng thành các vector 784 phần tử để phù hợp với đầu vào của mạng nơ-ron.
- Mã hóa nhãn: chuyển nhãn sang vector one-hot. Cách này tránh các vấn đề do thứ bậc số học, khiến mô hình có thể thiên lệch về các chữ số lớn hơn.
Toàn bộ logic tiền xử lý được hiện thực trong hàm trợ giúp preprocess_data dưới đây:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
Hàm được áp dụng cho các tập dữ liệu bằng các đoạn mã sau:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Giờ hãy quan sát giá trị pixel lớn nhất và nhỏ nhất hiện tại của cả hai tập:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Kết quả dưới đây cho thấy việc chuẩn hóa đã được thực hiện thành công.
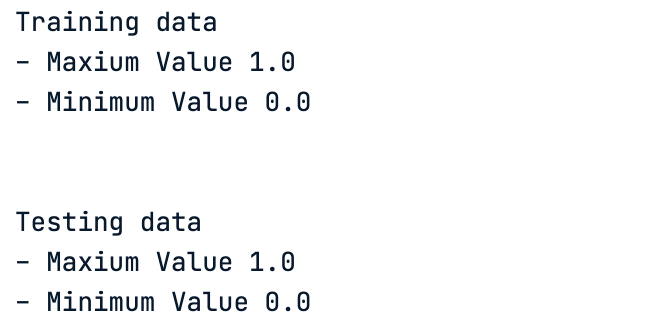
Giá trị pixel nhỏ nhất và lớn nhất sau chuẩn hóa
Tương tự với nhãn, cuối cùng ta có ma trận gồm các số 0 và 1, tương ứng với giá trị one-hot của các nhãn.
# One hot encoding of the test data labels
test_images
Kết quả bên dưới:
Mã hóa one-hot cho nhãn của dữ liệu kiểm tra
# One hot encoding of the train data labels
train_labels
Mã hóa one-hot cho nhãn của dữ liệu huấn luyện
Cấu trúc của mạng
Vì chúng ta đang làm bài toán phân loại ảnh, mạng nơ-ron tích chập là phù hợp hơn cho kịch bản này. Trước khi viết mã, việc xác định kiến trúc mô hình là rất quan trọng, và đó là trọng tâm của phần này.
Để tìm hiểu thêm về mạng nơ-ron tích chập, hướng dẫn Giới thiệu về Convolutional Neural Networks (CNNs) của chúng tôi là tài liệu khởi đầu tuyệt vời. Đây là hướng dẫn đầy đủ để hiểu CNN, tác động của chúng lên phân tích ảnh, và một số chiến lược chính để chống overfitting cho các ứng dụng CNN và học sâu vững chắc.
Kiến trúc cho trường hợp này kết hợp nhiều loại lớp để phân loại ảnh hiệu quả. Dưới đây là các thành phần chính của mô hình:
- Lớp tích chập: Bắt đầu với một lớp dùng bộ lọc 3x3 nhỏ và 32 bộ lọc để xử lý ảnh.
- Lớp gộp cực đại: Sau lớp tích chập, thêm lớp gộp cực đại nhằm giảm kích thước bản đồ đặc trưng.
- Làm phẳng: Làm phẳng đầu ra của lớp gộp thành một vector đơn, chuẩn bị cho quá trình phân loại.
- Lớp dày đặc: Thêm một lớp dày đặc 100 nút giữa đầu ra đã làm phẳng và lớp cuối để diễn giải các đặc trưng đã trích xuất.
- Lớp đầu ra: Dùng lớp đầu ra có 10 nút tương ứng 10 hạng mục ảnh. Mỗi nút tính xác suất ảnh thuộc về một trong các hạng mục này.
- Kích hoạt Softmax: Ở lớp đầu ra, áp dụng hàm kích hoạt softmax cho bài toán phân loại đa lớp.
- Hàm kích hoạt ReLU: Sử dụng ReLU (Rectified Linear Unit) ở tất cả các lớp để xử lý phi tuyến.
- Trình tối ưu hóa: Dùng bộ tối ưu hóa hạ dốc ngẫu nhiên với learning rate 0,001 và momentum 0,95 để điều chỉnh mô hình trong quá trình huấn luyện.
- Hàm mất mát: Dùng hàm mất mát cross-entropy phân loại, phù hợp với bài toán đa lớp.
- Chỉ số độ chính xác: Tập trung vào độ chính xác phân loại, xét tới phân bố lớp cân bằng.
Tất cả thông tin này được hiện thực trong hàm trợ giúp define_network_architecture. Nhưng trước đó, ta cần import các thư viện cần thiết:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Dưới đây là hiện thực của hàm trợ giúp.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Mã nguồn ở trên là tốt, nhưng sẽ tuyệt hơn nếu có sơ đồ trực quan của mạng; điều này được thực hiện bằng hàm plot_model từ mô-đun keras.utils.vis_utils.
Trước tiên, tạo mạng từ hàm trợ giúp.
network = define_network_architecture()Sau đó hiển thị đại diện đồ họa. Trước hết ta lưu kết quả thành tệp PNG rồi mới hiển thị; cách này giúp chia sẻ với người khác thuận tiện hơn.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Kết quả được hiển thị bên dưới.
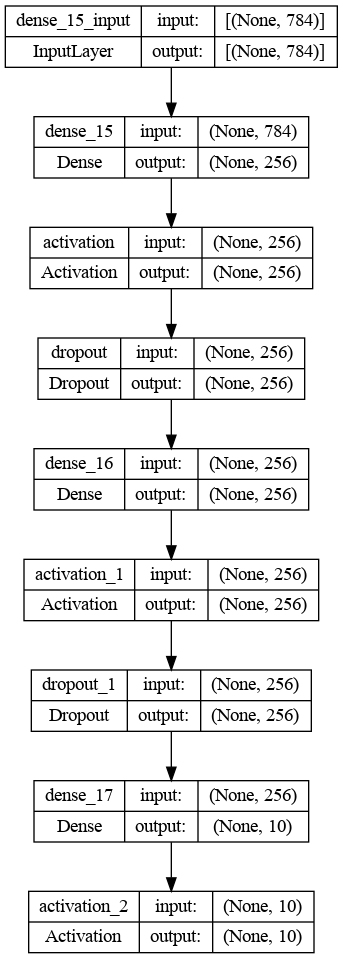
Kiến trúc đồ họa của mạng nơ-ron tích chập
Tính delta
Trước khi đi vào huấn luyện mô hình, hãy hiểu cách tính phân bố lỗi delta dựa trên kiến trúc mạng.
Phân bố lỗi delta là đạo hàm của hàm mất mát theo hàm kích hoạt của mỗi nút, cho biết mức đóng góp của kích hoạt từng nút vào lỗi cuối cùng.
Kiến trúc trên gồm ba lớp chính:
- Lớp đầu vào có 784 đơn vị tương ứng ảnh đầu vào 28x28
- Lớp ẩn có 512 đơn vị với kích hoạt ReLU
- Lớp đầu ra có 10 đơn vị, tương ứng số lượng nhãn duy nhất, với hàm kích hoạt softmax
Giờ hãy đi xa hơn với việc tính lỗi delta cho từng lớp.
Lớp đầu ra
Giả sử đầu ra của lớp softmax là chữ O (O) và nhãn thật là Y. Khi dùng mất mát cross-entropy δ output , lỗi delta là:
δ output = O - Y
Công thức này xuất phát từ tính toán cơ bản về cách mất mát cross-entropy thay đổi khi đầu ra softmax thay đổi.
Lớp ẩn
Với lớp ẩn, lỗi delta là δ hidden và phụ thuộc vào lỗi của lớp liền sau (tức lớp đầu ra) và đạo hàm của hàm kích hoạt ReLU.
Đạo hàm của ReLU bằng 1 với đầu vào dương, và bằng 0 với đầu vào âm, như hình dưới.
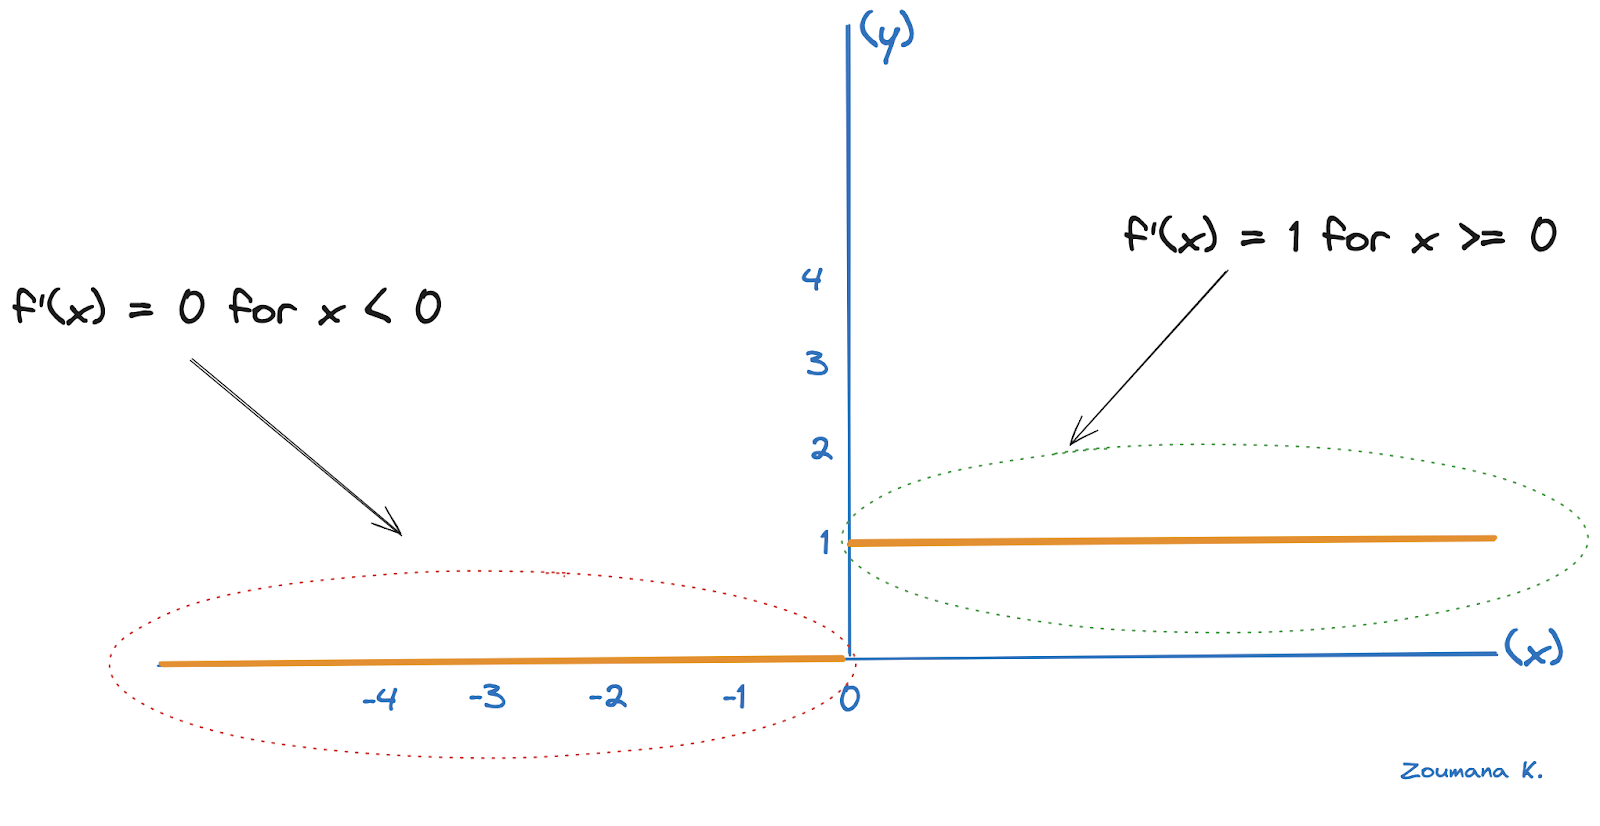
Minh họa đạo hàm của ReLU
Giả sử Zhidden là đầu vào của hàm ReLU ở lớp ẩn và Woutput là trọng số nối lớp ẩn với lớp đầu ra. Lỗi delta cho lớp ẩn khi đó là:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- Dấu chấm “.” là phép nhân ma trận
- Ký hiệu ⊙ là phép nhân theo phần tử
- ReLU’(Zhidden) là đạo hàm của ReLU tại Zhidden
Lớp đầu vào
Tương tự, nếu có nhiều lớp ẩn hơn, quá trình sẽ tiếp tục lan truyền ngược, với lỗi delta của mỗi lớp phụ thuộc vào lỗi delta của lớp liền sau và đạo hàm của hàm kích hoạt của lớp đó.
Tổng quát hơn, với bất kỳ lớp k nào trong mạng (trừ lớp đầu ra), công thức tính lỗi delta là:
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 là ma trận chuyển vị của trọng số ở lớp tiếp theo
- f’ là đạo hàm của hàm kích hoạt ở lớp k
- Zk là đầu vào của hàm kích hoạt tại lớp k
Biên dịch (compile) mạng
Với hiểu biết về cách tính lỗi, hãy biên dịch mạng để tối ưu cấu trúc cho quá trình huấn luyện.
Trong khi biên dịch, ta cần một số lựa chọn quan trọng:
- Chọn thuật toán tối ưu: liên quan đến việc chọn thuật toán cho hạ dốc. Có nhiều lựa chọn như Stochastic Gradient Descent (SGD), Adagrad và RMSprop, được dùng trong bài này.
- Chọn hàm mất mát: Hàm mất mát (còn gọi là cost function) là phần thiết yếu của quá trình huấn luyện. Nó định lượng mức độ mạng hoạt động tốt, và lựa chọn hàm mất mát phải phù hợp với bản chất bài toán phân loại hay hồi quy. Ở đây tập trung vào cross-entropy phân loại do bài toán đa lớp.
- Chọn chỉ số đánh giá: Dù tương tự hàm mất mát, chỉ số đánh giá chủ yếu dùng để đo hiệu quả mô hình trên tập kiểm tra; chúng ta dùng accuracy.
Mã cho ba lựa chọn trên như sau:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Huấn luyện mạng
Một trong những vấn đề lớn khi huấn luyện mô hình là overfitting, và điều quan trọng là theo dõi mô hình trong quá trình huấn luyện để đảm bảo khả năng khái quát tốt hơn; một cách là dùng khái niệm dừng sớm (early stopping).
Logic đầy đủ được minh họa dưới đây:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Mô hình được huấn luyện trong 15 epoch với batch size 256, và 20% dữ liệu huấn luyện được dùng để xác thực mô hình.
Sau khi huấn luyện, lịch sử hiệu suất huấn luyện và xác thực được vẽ như dưới đây.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()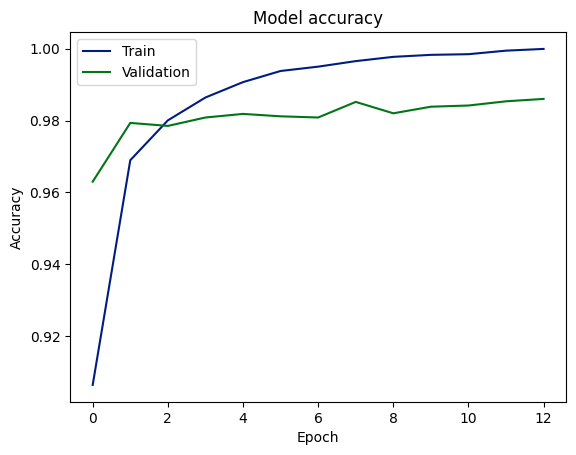
Điểm độ chính xác huấn luyện và xác thực
Đánh giá trên dữ liệu kiểm tra
Bây giờ, chúng ta có thể đánh giá hiệu suất mô hình trên dữ liệu kiểm tra bằng hàm evaluate của mô hình.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))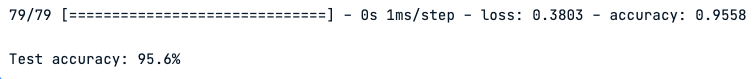
Hiệu suất mô hình trên dữ liệu kiểm tra
Biểu đồ cho thấy mô hình đã học dự đoán với độ chính xác cao, đạt khoảng 98% trên cả tập xác thực và kiểm tra. Điều này gợi ý khả năng khái quát tốt từ dữ liệu huấn luyện sang dữ liệu chưa thấy. Tuy nhiên, khoảng cách giữa độ chính xác huấn luyện và xác thực có thể là dấu hiệu của overfitting, dù sự nhất quán giữa xác thực và kiểm tra phần nào giảm bớt lo ngại này.
Khuyến nghị
Dù mô hình cho thấy độ chính xác cao và khả năng khái quát tốt, vẫn còn khoảng trống để cải thiện; dưới đây là một số bước có thể hành động nhằm nâng cao hiệu suất hơn nữa.
- Regularization: Tích hợp các phương pháp regularization để giảm overfitting.
- Dừng sớm: Sử dụng early stopping trong quá trình huấn luyện để ngăn overfitting.
- Phân tích lỗi: Phân tích các dự đoán sai để xác định và khắc phục vấn đề gốc rễ.
- Kiểm thử đa dạng: Kiểm thử mô hình trên các tập dữ liệu đa dạng để xác nhận độ vững.
- Chỉ số rộng hơn: Dùng precision, recall và F1-score để đánh giá toàn diện, đặc biệt khi dữ liệu mất cân bằng.
Kết luận
Tóm lại, bài viết này đã cung cấp một cái nhìn toàn diện về backpropagation, kỹ thuật thiết yếu trong lĩnh vực học máy. Chúng ta bắt đầu bằng định nghĩa rõ ràng về backpropagation và nhấn mạnh vai trò quan trọng của nó trong sự tiến bộ của trí tuệ nhân tạo.
Tiếp theo, chúng ta đi sâu vào cách thức hoạt động của backpropagation cùng một số ưu điểm như nâng cao hiệu quả học, đồng thời thừa nhận các hạn chế và thách thức.
Sau đó, bài viết hướng dẫn chi tiết cách thiết lập và xây dựng mạng nơ-ron, nhấn mạnh tầm quan trọng của lan truyền xuôi.
Ở các phần cuối, chúng ta xem xét các bước tính delta và cập nhật trọng số mạng, vốn là chìa khóa để tinh chỉnh quá trình học.
Nhìn chung, bài viết là nguồn tham khảo hữu ích cho bất kỳ ai muốn hiểu và triển khai hiệu quả backpropagation trong mạng nơ-ron.
Bạn muốn củng cố kỹ năng học sâu? Khóa học Deep Learning với PyTorch của chúng tôi sẽ giúp bạn tự tin đi sâu hơn vào mạng nơ-ron và mở rộng kiến thức.
