La rétropropagation est un élément essentiel de l’entraînement des réseaux de neurones modernes, qui permet à ces algorithmes sophistiqués d’apprendre à partir d’ensembles de données d’entraînement et de s’améliorer au fil du temps.
Comprendre et maîtriser l’algorithme de rétropropagation est crucial pour toute personne travaillant sur les réseaux de neurones et le deep learning. Ce tutoriel propose une exploration approfondie de la rétropropagation.
Nous commençons par expliquer ce qu’est la rétropropagation et son fonctionnement, ainsi que ses avantages et ses limites, avant de passer à une mise en pratique sur un jeu de données largement utilisé.
Qu’est-ce que la rétropropagation ?
Introduit dans les années 1970, l’algorithme de rétropropagation sert à ajuster finement les poids d’un réseau de neurones en fonction du taux d’erreur obtenu à l’itération (ou époque) précédente. C’est la méthode standard pour entraîner des réseaux de neurones artificiels.
On peut l’assimiler à un système de retour d’information : après chaque cycle d’entraînement (ou « époque »), le réseau évalue ses performances. Il calcule l’écart entre sa prédiction et la bonne réponse (l’erreur), puis ajuste ses paramètres internes, ou « poids », pour réduire cette erreur lors du passage suivant. Cette méthode est indispensable pour améliorer la précision du réseau et constitue un pilier de l’apprentissage pour produire de meilleures prédictions ou décisions.
Comment fonctionne la rétropropagation ?
Maintenant que vous savez ce qu’est la rétropropagation, voyons son fonctionnement. Ci-dessous, une illustration de l’algorithme appliqué à un réseau de neurones comportant :
- Deux entrées X1 et X2
- Deux couches cachées N1X et N2X, où X prend les valeurs 1, 2 et 3
- Une couche de sortie
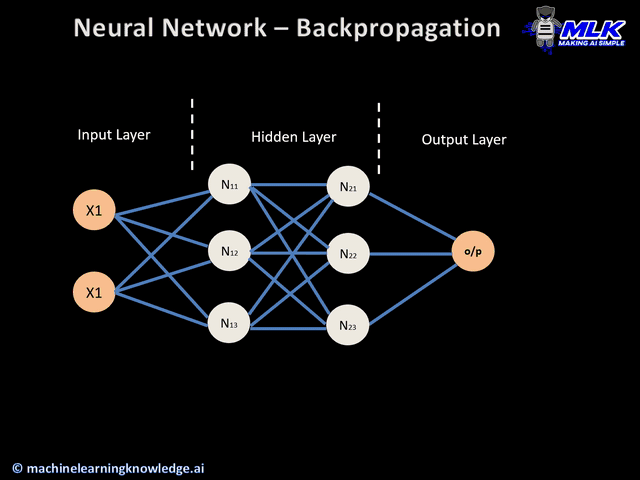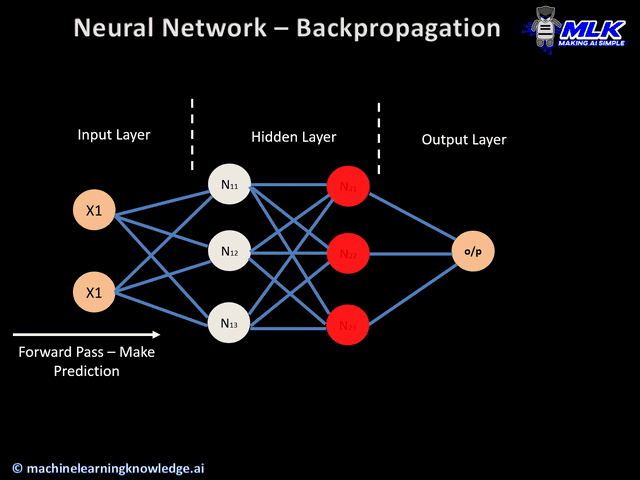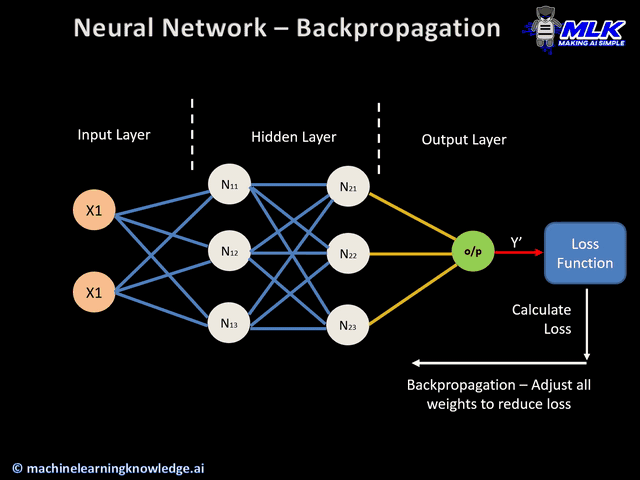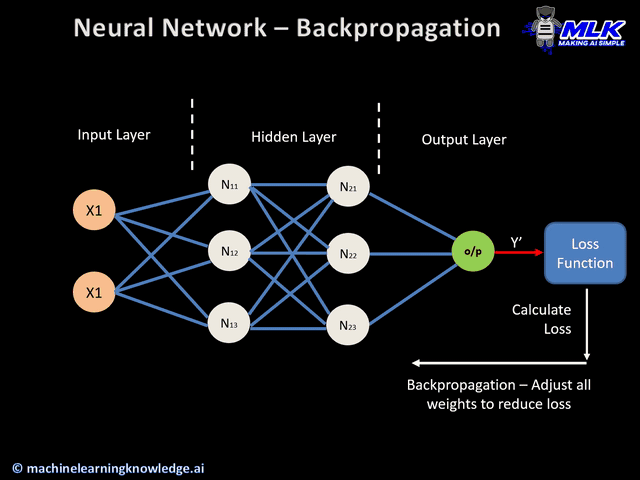
Illustration de la rétropropagation (source : machinelearningknowledge)
L’algorithme de rétropropagation se déroule en quatre grandes étapes :
- Propagation avant (forward pass)
- Calcul de l’erreur
- Propagation arrière (backward pass)
- Mise à jour des poids
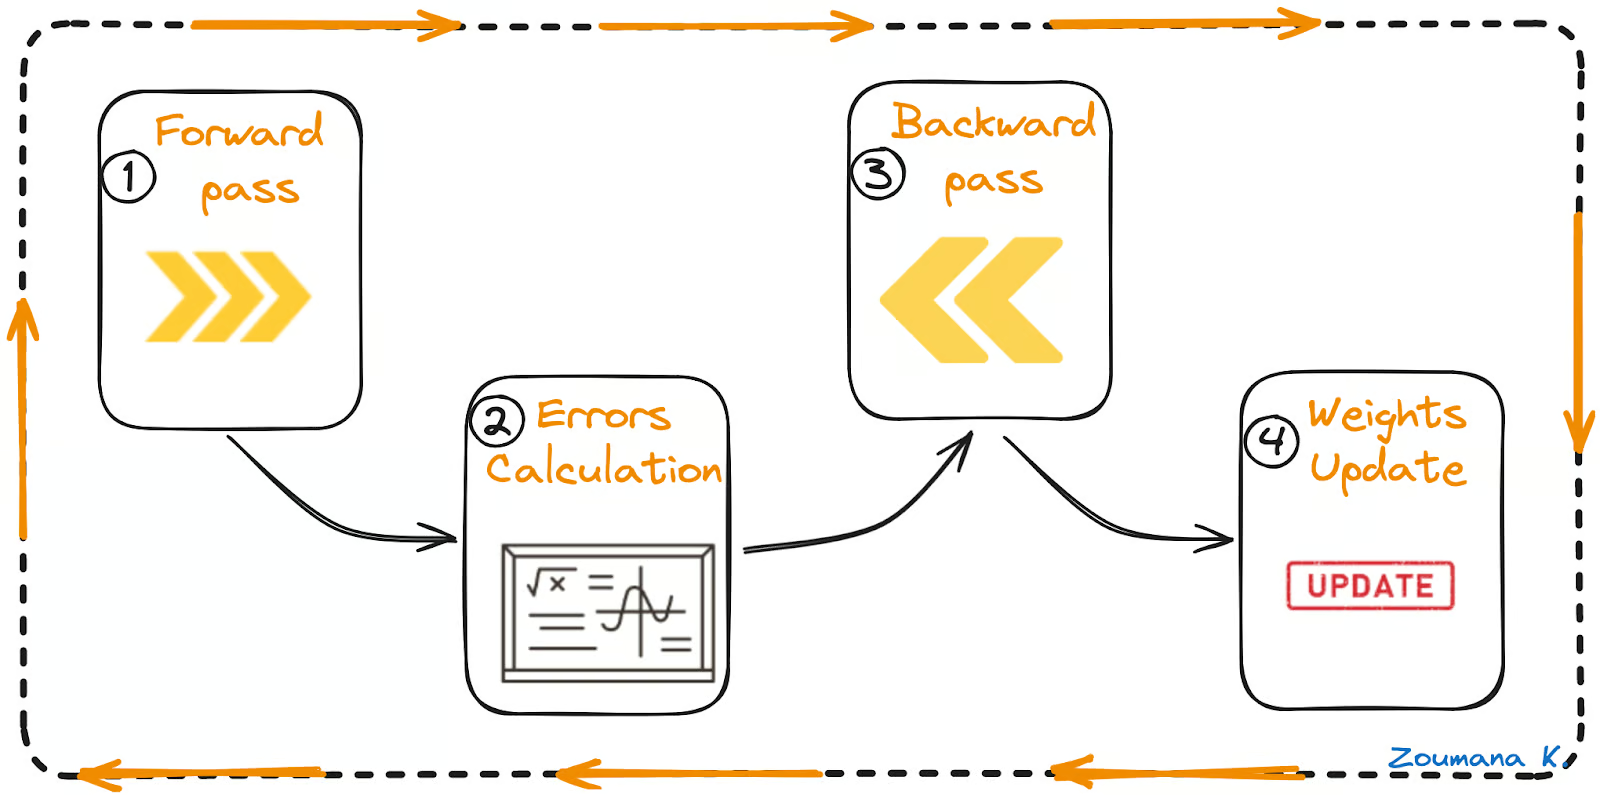
Propagation avant, calcul de l’erreur, propagation arrière et mise à jour des poids
Voyons chacune de ces étapes à partir de l’animation ci-dessus.
Propagation avant
C’est la première étape du processus de rétropropagation, illustrée ci-dessous :
- Les données (entrées X1 et X2) sont fournies à la couche d’entrée.
- Chaque entrée est multipliée par son poids correspondant, et les résultats sont transmis aux neurones N1X et N2X des couches cachées.
- Ces neurones appliquent une fonction d’activation aux entrées pondérées reçues, puis transmettent le résultat à la couche suivante.
Calcul de l’erreur
- Le processus se poursuit jusqu’à la production de la sortie finale par la couche de sortie.
- La sortie du réseau est ensuite comparée à la vérité terrain (sortie attendue) et la différence est calculée pour obtenir une valeur d’erreur.
Propagation arrière
Il s’agit de l’étape de rétropropagation à proprement parler, qui ne peut être effectuée sans la propagation avant et le calcul de l’erreur. Voici comment cela fonctionne :
- La valeur d’erreur obtenue précédemment sert à calculer le gradient de la fonction de perte.
- Le gradient de l’erreur est propagé en arrière dans le réseau, de la couche de sortie vers les couches cachées.
- Au fil de cette propagation, les poids (représentés par les lignes reliant les nœuds) sont mis à jour selon leur contribution à l’erreur. Cela implique de calculer la dérivée de l’erreur par rapport à chaque poids, indiquant l’impact d’une variation du poids sur l’erreur.
- Le taux d’apprentissage détermine l’amplitude des mises à jour des poids. Un taux plus faible entraîne des mises à jour plus petites, et inversement.
Mise à jour des poids
- Les poids sont mis à jour dans la direction opposée au gradient, d’où le nom de « descente de gradient ». L’objectif est de réduire l’erreur lors de la prochaine propagation avant.
- Ce cycle propagation avant, calcul de l’erreur, propagation arrière et mise à jour des poids se répète pendant plusieurs époques, jusqu’à ce que les performances du réseau deviennent satisfaisantes ou cessent de s’améliorer significativement.
Avantages de la rétropropagation
La rétropropagation est une technique fondatrice de l’entraînement des réseaux de neurones, reconnue pour sa mise en œuvre directe, sa simplicité de programmation et sa polyvalence sur de nombreuses architectures.
Notre tutoriel Building Neural Network (NN) Models in R est un excellent point de départ pour toute personne souhaitant découvrir les réseaux de neurones. Il explique comment créer un modèle de réseau de neurones en R.
Pour les programmeurs Python, le tutoriel Recurrent Neural Network Tutorial (RNN) propose un guide complet sur le modèle de deep learning RNN, avec une mise en pratique via un prédicteur du cours de l’action MasterCard.
Développons maintenant chacun des bénéfices mentionnés :
- Facilité d’implémentation : accessible via de nombreuses bibliothèques de deep learning comme Pytorch et Keras, ce qui facilite son utilisation dans des applications variées.
- Simplicité de programmation : le niveau d’abstraction des frameworks simplifie le code et limite le recours à des mathématiques complexes.
- Flexibilité : s’adapte à des architectures diverses, convenant à un large éventail de défis en IA.
Limites et défis
Malgré son succès, l’algorithme de rétropropagation présente des limites susceptibles d’affecter l’efficacité et l’efficience de l’entraînement d’un réseau de neurones. Examinons-en quelques-unes :
- Qualité des données : une qualité médiocre (bruit, incomplétude, biais) conduit à des modèles inexacts, car la rétropropagation apprend exactement ce qu’on lui fournit.
- Durée d’entraînement : la rétropropagation exige souvent des temps d’entraînement importants, peu pratiques pour des réseaux de grande taille.
- Complexité matricielle : les opérations matricielles croissent avec la taille du réseau, ce qui augmente la demande de calcul et peut dépasser les ressources disponibles.
Mise en œuvre de la rétropropagation
Fort de ces éléments, passons à une application concrète : implémenter un réseau de neurones pour reconnaître des chiffres manuscrits avec le jeu de données MNIST.
Cette section couvre toutes les étapes, de la visualisation des données à l’entraînement et l’évaluation du modèle. Le code source complet est disponible dans ce carnet DataLab ; vous pouvez facilement en créer une copie et exécuter le code dans votre navigateur, sans rien installer sur votre ordinateur.
À propos du jeu de données
Le jeu de données MNIST est largement utilisé en reconnaissance d’images. Il comprend 70 000 images en niveaux de gris de chiffres manuscrits de 0 à 9, chaque image mesurant 28×28 pixels.
Le jeu de données est accessible via la fonction mnist du module Keras.datasets et se charge comme suit après import de la bibliothèque mnist :
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Analyse exploratoire des données
L’analyse exploratoire est une étape clé avant toute modélisation en machine learning ou deep learning : elle permet de mieux comprendre la nature des données et oriente le choix du type de modèle.
Les principales tâches incluent :
- Identifier le volume de données dans les ensembles d’entraînement et de test.
- Visualiser aléatoirement quelques chiffres issus de l’ensemble d’entraînement.
- Visualiser la distribution des étiquettes (labels) de l’ensemble d’entraînement.
Le jeu de données global contient 70 000 images. Le découpage classique se présente ainsi, sans règle universelle :
- 70 % ou 80 % pour l’entraînement
- 30 % ou 20 % pour le test
Certains découpages vont même jusqu’à 90 % pour l’entraînement et 10 % pour le test.
Dans notre cas, les ensembles d’entraînement et de test sont déjà fournis ; aucun split n’est donc nécessaire. Observons leur taille.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")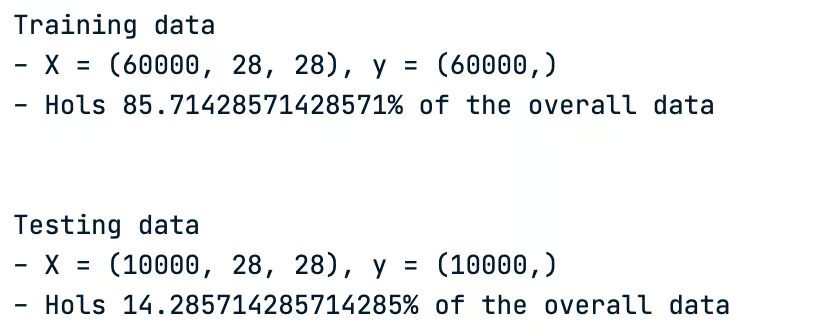
Caractéristiques des jeux d’entraînement et de test
- L’ensemble d’entraînement comporte 60 000 images, soit 85,71 % du jeu initial.
- Le jeu de test compte les 10 000 images restantes, soit 14,28 % du jeu initial.
Visualisons maintenant quelques chiffres aléatoires. Pour cela, on utilise la fonction utilitaire plot_images, qui prend deux paramètres principaux :
- Le nombre d’images à afficher, et
- Le jeu de données sur lequel réaliser la visualisation
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Nous souhaitons afficher neuf images issues des données d’entraînement ; le code correspondant est le suivant :
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
L’exécution réussie du code ci-dessus génère les neuf chiffres suivants.
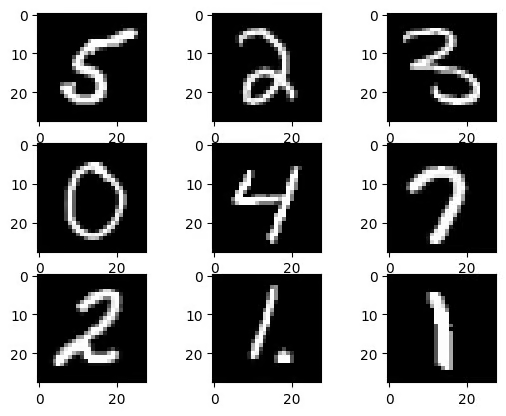
Neuf images aléatoires issues de l’ensemble d’entraînement
En réexécutant la même fonction, on obtient les affichages ci-dessous ; ils diffèrent en raison du caractère aléatoire de la fonction utilitaire.
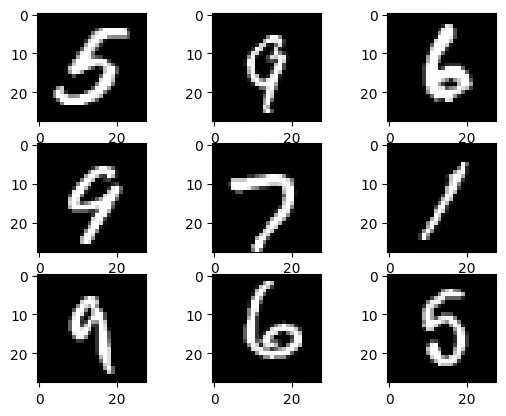
Neuf images aléatoires après un second appel de la fonction
La dernière tâche de l’analyse consiste à visualiser la distribution des étiquettes de l’ensemble d’entraînement avec la fonction utilitaire plot_labels_distribution.
- En abscisse (X), on retrouve les chiffres possibles.
- En ordonnée (Y), on affiche le nombre d’occurrences de chaque chiffre.
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
On applique la fonction à l’ensemble d’entraînement en lui passant ses labels comme suit :
plot_labels_distribution(train_labels)Voici le résultat : les dix chiffres sont répartis de manière quasi uniforme sur l’ensemble du jeu de données, ce qui est une bonne nouvelle. Aucune action supplémentaire n’est nécessaire pour rééquilibrer la distribution des étiquettes.
Prétraitement des données
Les données réelles nécessitent généralement un prétraitement pour être adaptées à l’entraînement. Trois opérations principales sont appliquées aux images d’entraînement et de test :
- Normalisation : convertir les valeurs de pixels de 0–255 en 0–1, ce qui favorise une convergence plus rapide à l’entraînement.
- Remise en forme : au lieu d’une matrice 28×28 par image, on aplatit chaque image en un vecteur de 784 éléments pour l’adapter aux entrées du réseau.
- Encodage des labels : convertir les étiquettes en vecteurs one‑hot afin d’éviter les effets de hiérarchie numérique qui biaiseraient le modèle vers les plus grands chiffres.
La logique de prétraitement est implémentée dans la fonction utilitaire preprocess_data ci‑dessous :
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
On applique ensuite la fonction aux jeux de données :
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Observons maintenant les valeurs minimales et maximales de pixels dans les deux jeux :
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Le résultat ci-dessous confirme que la normalisation a bien été effectuée.
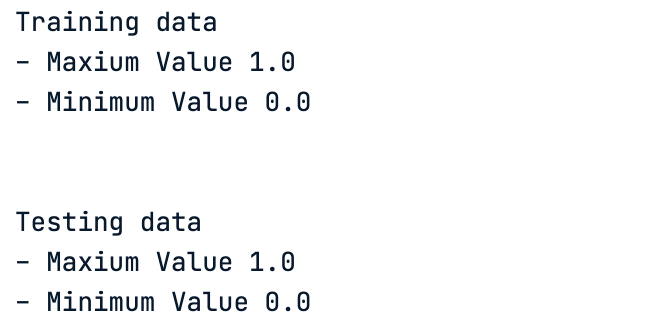
Valeurs minimale et maximale des pixels après normalisation
Comme pour les labels, nous obtenons finalement une matrice de zéros et de uns correspondant aux valeurs one‑hot encodées.
# One hot encoding of the test data labels
test_images
Résultat :
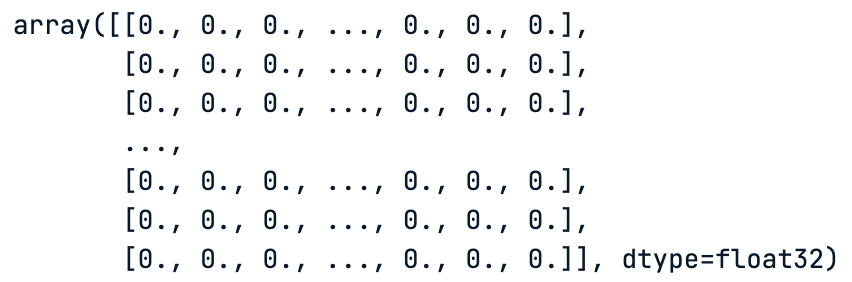
One‑hot encoding des labels de test
# One hot encoding of the train data labels
train_labels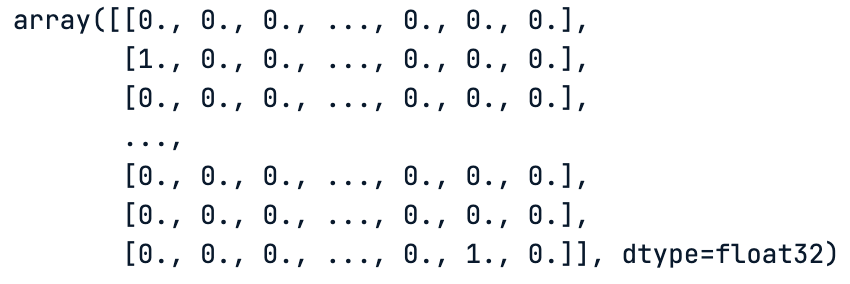
One‑hot encoding des labels d’entraînement
Structure du réseau
Pour une tâche de classification d’images, un réseau de neurones convolutifs est particulièrement adapté. Avant de coder, il est important de définir l’architecture du modèle : c’est l’objet de cette section.
Pour en savoir plus sur les réseaux de neurones convolutifs, notre tutoriel An Introduction to Convolutional Neural Networks (CNNs) est une excellente ressource d’initiation. Il présente les CNN, leur impact sur l’analyse d’images et des stratégies clés pour lutter contre le surapprentissage.
L’architecture retenue pour ce cas d’usage combine différents types de couches pour une classification efficace. Composants clés :
- Couche de convolution : commencez par une couche avec des filtres 3×3 et 32 filtres pour traiter les images.
- Couche de max‑pooling : après la convolution, ajoutez une couche de max‑pooling pour réduire la taille des cartes de caractéristiques.
- Aplatissement : aplatissez la sortie du pooling en un vecteur unique, en vue de la classification.
- Couche dense : insérez une couche dense de 100 nœuds entre la sortie aplatie et la couche finale pour interpréter les caractéristiques extraites.
- Couche de sortie : utilisez 10 nœuds, correspondant aux 10 catégories d’images. Chaque nœud calcule la probabilité d’appartenance à une catégorie.
- Activation softmax : appliquez softmax en sortie pour la classification multi‑classe.
- Fonction d’activation ReLU : utilisez ReLU (Rectified Linear Unit) dans toutes les couches pour introduire la non‑linéarité.
- Optimiseur : employez la descente de gradient stochastique avec un taux d’apprentissage de 0,001 et un momentum de 0,95 pour ajuster le modèle pendant l’entraînement.
- Fonction de perte : utilisez l’entropie croisée catégorielle, adaptée aux tâches multi‑classe.
- Métrique d’exactitude : privilégiez l’accuracy, compte tenu de la distribution équilibrée des classes.
Toutes ces informations sont implémentées dans la fonction utilitaire define_network_architecture. Avant cela, importons les bibliothèques nécessaires :
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Voici l’implémentation de la fonction utilitaire.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Le code source est pertinent, mais une visualisation graphique du réseau est encore plus parlante. On l’obtient avec la fonction plot_model du module keras.utils.vis_utils.
Générons d’abord le réseau via la fonction utilitaire.
network = define_network_architecture()Puis affichons la représentation graphique. Nous enregistrons d’abord le résultat en PNG avant de l’afficher ; cela facilite le partage.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Voici le résultat.
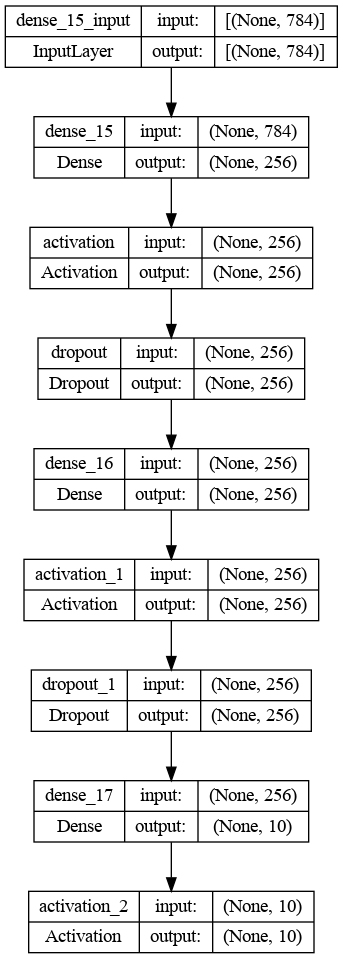
Architecture graphique du réseau de neurones convolutif
Calcul du delta
Avant d’entraîner le modèle, voyons comment est calculée la distribution de l’erreur delta à partir de l’architecture du réseau.
La distribution de l’erreur delta correspond à la dérivée de la fonction de perte par rapport à l’activation de chaque nœud ; elle indique la contribution de chaque activation à l’erreur finale.
L’architecture ci-dessus comporte trois couches principales :
- Une couche d’entrée de 784 unités (image d’entrée 28×28)
- Une couche cachée de 512 unités avec activation ReLU
- Une couche de sortie de 10 unités (autant que de labels uniques) avec activation softmax
Poursuivons avec le calcul du delta pour chaque couche.
Couche de sortie
Notons la sortie de la couche softmax par une grande O (O) et les étiquettes réelles par Y. En utilisant la perte d’entropie croisée, le delta δ output vaut :
δ output = O - Y
Cette formule découle du calcul de la variation de l’entropie croisée lorsque la sortie softmax varie.
Couche cachée
Pour la couche cachée, le delta δ hidden dépend de l’erreur de la couche suivante (la sortie) et de la dérivée de la fonction d’activation ReLU.
La dérivée de ReLU vaut 1 pour les entrées positives et 0 pour les négatives, comme ci-dessous.
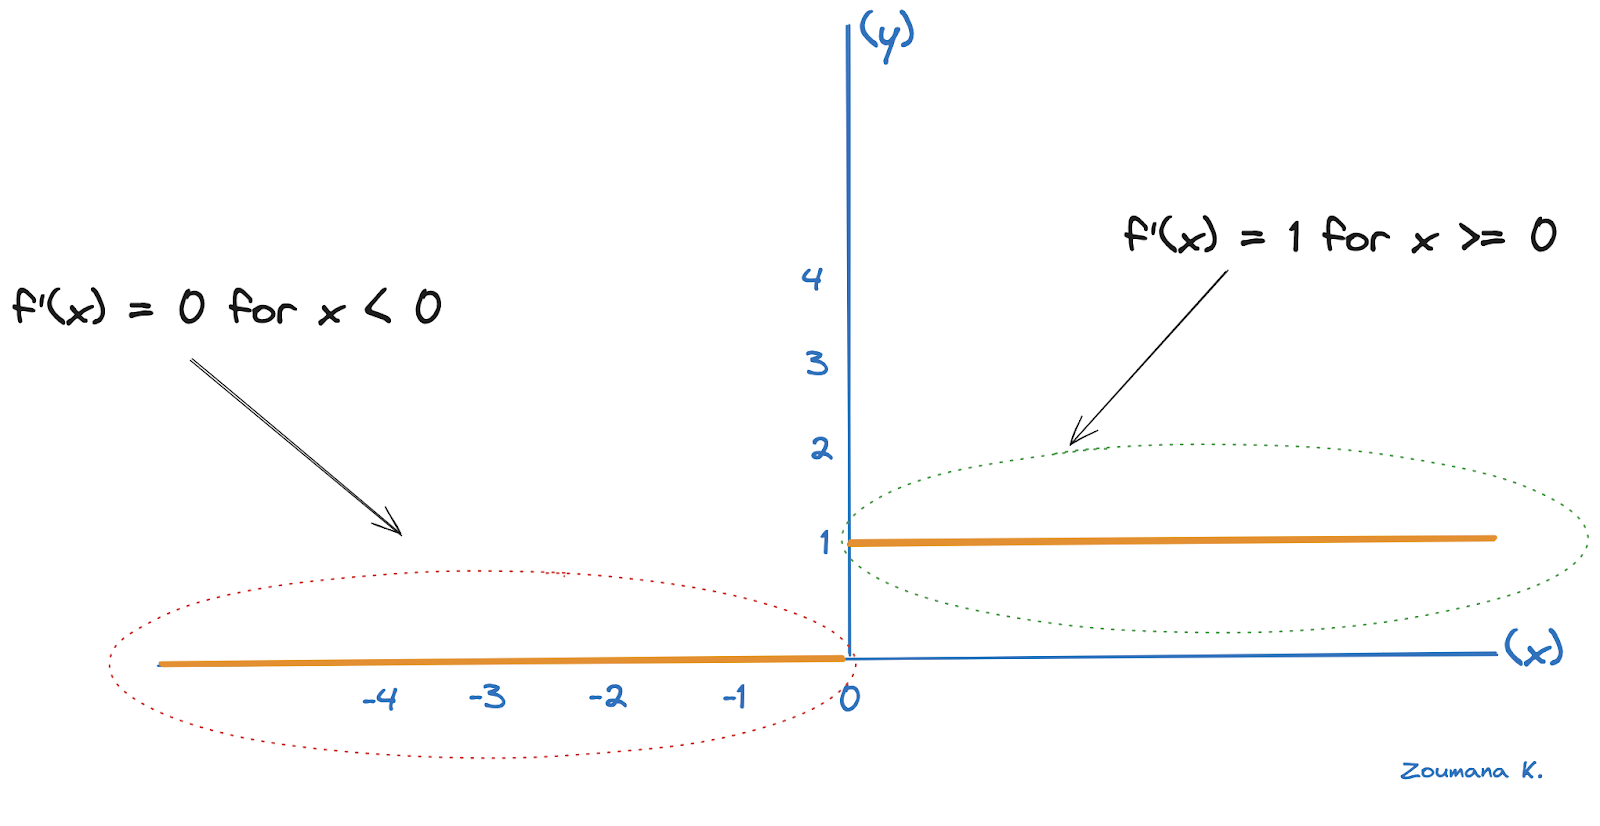
Illustration de la dérivée de ReLU
Notons Zhidden l’entrée de la ReLU dans la couche cachée et Woutput les poids reliant la couche cachée à la couche de sortie. Le delta pour la couche cachée s’écrit alors :
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- Le point « . » désigne la multiplication matricielle.
- Le symbole ⊙ correspond au produit élément par élément.
- ReLU’(Zhidden) est la dérivée de ReLU évaluée en Zhidden.
Couche d’entrée
De même, s’il y avait d’autres couches cachées, le processus continuerait vers l’amont, chaque delta dépendant du delta de la couche suivante et de la dérivée de sa fonction d’activation.
De façon générale, pour une couche k (hors couche de sortie), la formule du delta est :
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 est la transposée de la matrice de poids de la couche suivante.
- f’ est la dérivée de la fonction d’activation de la couche k.
- Zk est l’entrée de la fonction d’activation à la couche k.
Compilation du réseau
Avec cette compréhension du calcul d’erreur, compilons le réseau pour l’optimiser en vue de l’entraînement.
La compilation implique plusieurs choix clés :
- Choix de l’algorithme d’optimisation : sélection d’un algorithme de descente de gradient. Plusieurs options existent (Stochastic Gradient Descent, Adagrad, RMSprop utilisé ici).
- Sélection de la fonction de perte : la fonction de coût mesure la performance du réseau. Elle doit correspondre à la nature du problème (classification ou régression). Ici, l’entropie croisée catégorielle s’impose pour une classification multi‑classe.
- Choix d’une métrique : proche de la perte mais destinée à évaluer l’efficacité du modèle, notamment sur le jeu de test. Nous utilisons l’accuracy.
Le code correspondant :
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Entraînement du réseau
L’un des principaux écueils à l’entraînement est le surapprentissage. Il est crucial de suivre le modèle pendant l’apprentissage pour garantir sa capacité de généralisation ; l’arrêt anticipé (early stopping) est une approche efficace.
La logique complète est illustrée ci-dessous :
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Le modèle est entraîné pendant 15 époques, avec une taille de lot de 256 ; 20 % des données d’entraînement servent à la validation.
Après l’entraînement, on trace l’historique des performances en apprentissage et en validation.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()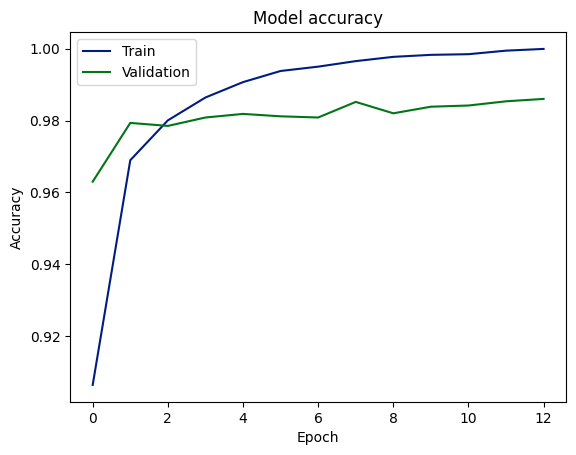
Scores d’exactitude en entraînement et en validation
Évaluation sur les données de test
Nous pouvons maintenant évaluer les performances sur le jeu de test avec la méthode evaluate du modèle.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))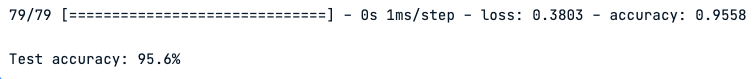
Performances du modèle sur les données de test
Le graphique indique que le modèle prédit avec une grande précision, autour de 98 % sur les ensembles de validation et de test. Cela suggère une bonne généralisation des apprentissages. Toutefois, l’écart entre l’exactitude d’entraînement et de validation peut signaler un surapprentissage, même si la cohérence entre validation et test vient tempérer cette inquiétude.
Recommandations
Même si le modèle affiche une forte précision et une bonne généralisation, des améliorations sont possibles. Voici quelques actions concrètes pour aller plus loin :
- Régularisation : intégrer des techniques de régularisation pour réduire le surapprentissage.
- Arrêt anticipé : utiliser l’early stopping pendant l’entraînement.
- Analyse d’erreurs : étudier les erreurs de prédiction pour identifier et corriger les causes sous-jacentes.
- Tests de diversité : évaluer le modèle sur des jeux variés pour confirmer sa robustesse.
- Métriques élargies : compléter l’accuracy par la précision, le rappel et le F1‑score, surtout en cas de déséquilibre des classes.
Conclusion
En résumé, cet article a proposé une exploration complète de la rétropropagation, une technique essentielle du machine learning. Nous avons commencé par définir la rétropropagation et rappeler son rôle clé dans les avancées de l’intelligence artificielle.
Nous avons ensuite détaillé son fonctionnement et ses avantages, comme l’amélioration de l’efficacité d’apprentissage, tout en reconnaissant ses limites et défis.
Nous avons fourni des indications précises pour configurer et construire des réseaux de neurones, en soulignant l’importance de la propagation avant.
Enfin, nous avons parcouru le calcul des deltas et la mise à jour des poids, étapes cruciales pour affiner l’apprentissage.
Au total, cet article constitue une ressource utile pour quiconque souhaite comprendre et mettre en œuvre efficacement la rétropropagation dans des réseaux de neurones.
Envie de renforcer vos compétences en deep learning ? Notre cours Deep Learning with PyTorch vous aidera à gagner en confiance pour approfondir les réseaux de neurones et progresser davantage.
