Backpropagation ist ein zentraler Bestandteil des modernen Trainings neuronaler Netze. Sie ermöglicht es diesen ausgeklügelten Algorithmen, aus Trainingsdaten zu lernen und sich mit der Zeit zu verbessern.
Wer mit neuronalen Netzen und Deep Learning arbeitet, muss den Backpropagation-Algorithmus verstehen und sicher beherrschen. Dieses Tutorial bietet dir einen tiefen Einblick in Backpropagation.
Wir starten mit einer Erklärung, was Backpropagation ist, wie sie funktioniert und wo ihre Stärken und Grenzen liegen. Anschließend setzen wir sie praktisch auf einem weit verbreiteten Datensatz ein.
Was ist Backpropagation?
Der Backpropagation-Algorithmus wurde in den 1970er-Jahren eingeführt. Er dient dazu, die Gewichte eines neuronalen Netzes anhand der Fehlerrate aus der vorherigen Iteration bzw. Epoche feinzujustieren und ist das Standardverfahren zum Trainieren künstlicher neuronaler Netze.
Du kannst dir das wie ein Feedback-System vorstellen: Nach jeder Trainingsrunde ("Epoch") prüft das Netz seine Leistung. Es berechnet die Abweichung zwischen seiner Vorhersage und der richtigen Antwort – den Fehler. Danach passt es seine internen Parameter, die sogenannten Gewichte, so an, dass dieser Fehler beim nächsten Mal kleiner wird. Diese Methode ist essenziell, um die Genauigkeit des Netzes zu steigern, und bildet die Grundlage dafür, bessere Vorhersagen oder Entscheidungen zu treffen.
Wie funktioniert Backpropagation?
Nachdem du nun weißt, was Backpropagation ist, schauen wir uns an, wie sie abläuft. Unten siehst du eine Illustration des Backpropagation-Algorithmus auf einem neuronalen Netz mit:
- Zwei Eingaben X1 und X2
- Zwei verdeckten Schichten N1X und N2X, wobei X die Werte 1, 2 und 3 annimmt
- Einer Ausgabeschicht
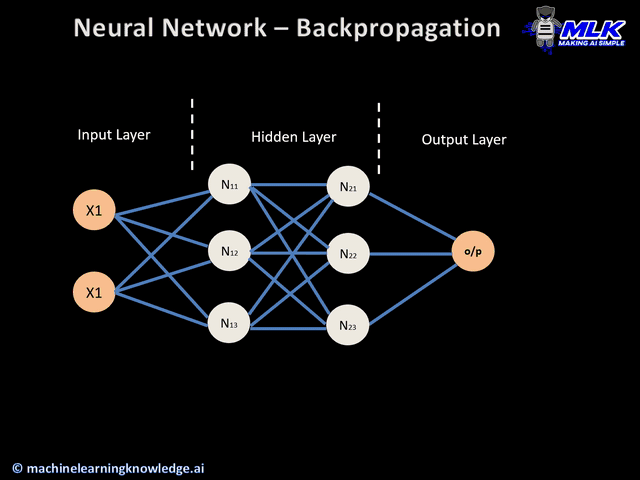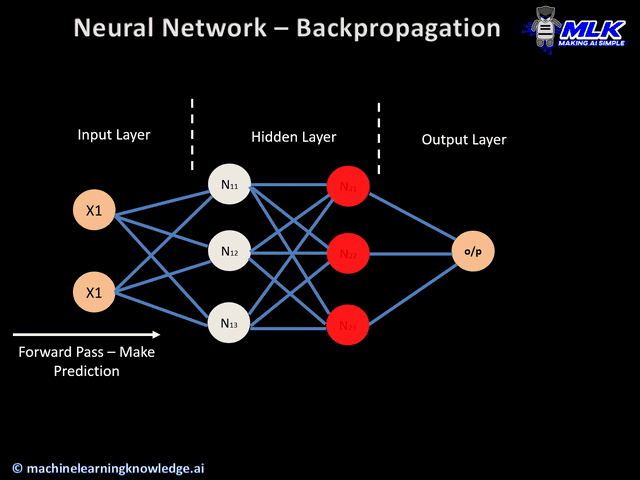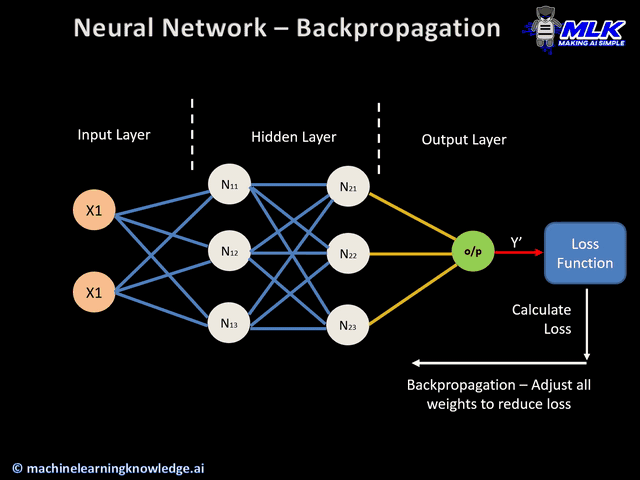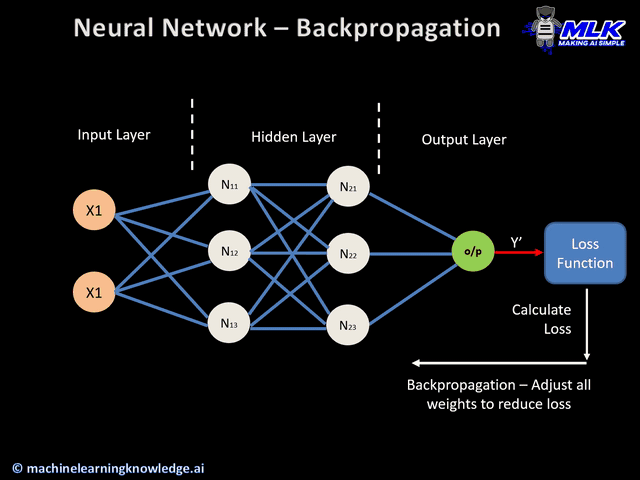
Backpropagation-Illustration (Quelle: machinelearningknowledge)
Insgesamt umfasst der Backpropagation-Algorithmus vier Hauptschritte:
- Vorwärtsdurchlauf
- Fehlerberechnung
- Rückwärtsdurchlauf
- Gewichtsaktualisierung
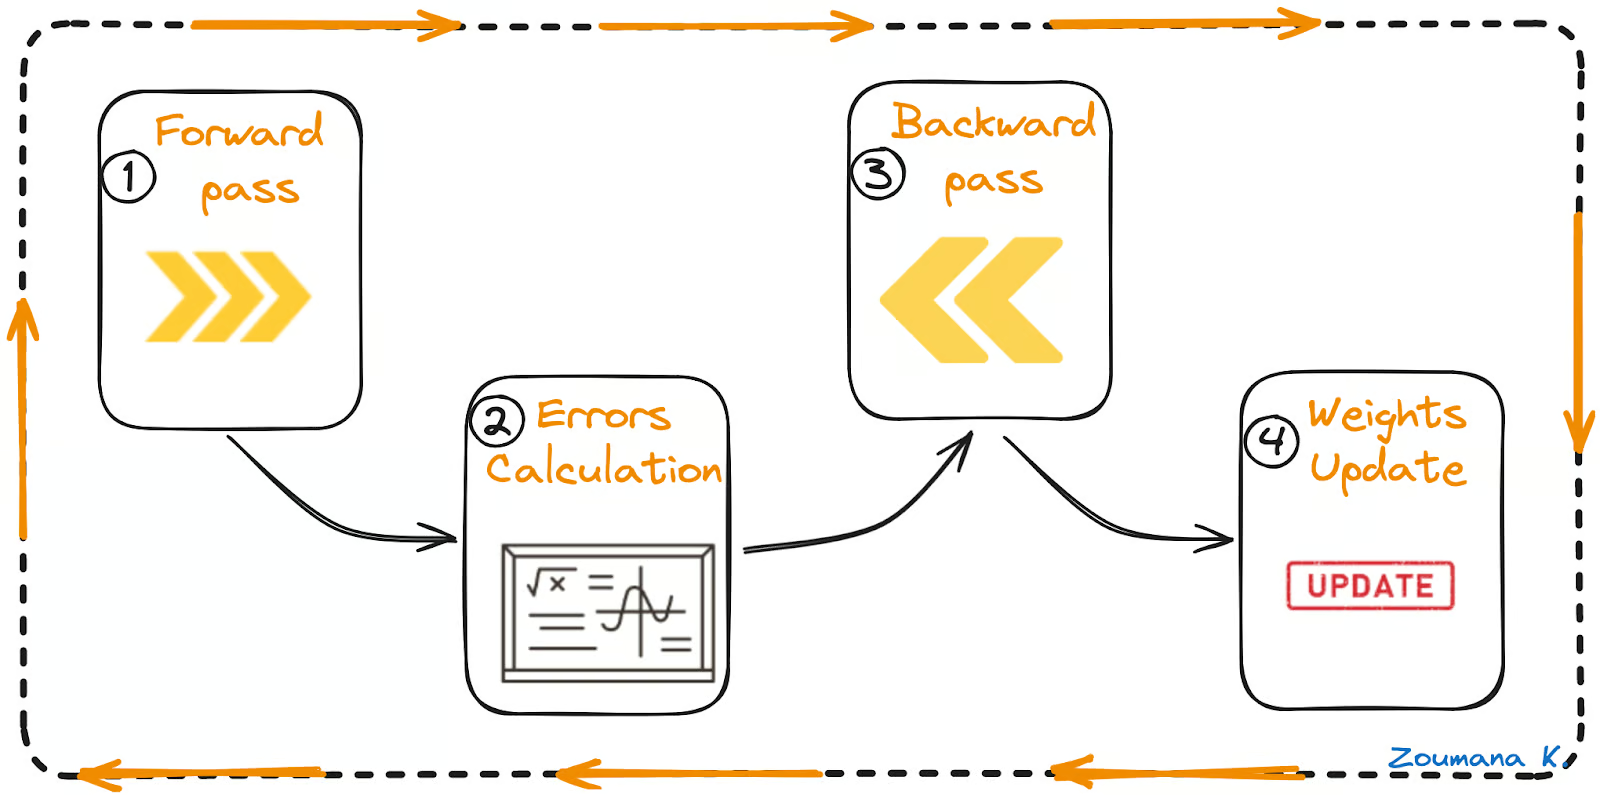
Vorwärtsdurchlauf, Fehlerberechnung, Rückwärtsdurchlauf und Gewichtsaktualisierung
Schauen wir uns diese Schritte anhand der obigen Animation an.
Vorwärtsdurchlauf
Das ist der erste Schritt im Backpropagation-Prozess, unten veranschaulicht:
- Die Daten (Eingaben X1 und X2) gelangen in die Eingabeschicht.
- Dann wird jede Eingabe mit ihrem jeweiligen Gewicht multipliziert und das Ergebnis an die Neuronen N1X und N2X in den verdeckten Schichten weitergegeben.
- Diese Neuronen wenden auf die gewichteten Eingaben eine Aktivierungsfunktion an und geben das Ergebnis an die nächste Schicht weiter.
Fehlerberechnung
- Der Prozess läuft weiter, bis die Ausgabeschicht die finale Ausgabe (o/p) erzeugt.
- Die Ausgabe des Netzes wird mit der Ground Truth (Soll-Ausgabe) verglichen. Die Differenz ergibt den Fehlerwert.
Rückwärtsdurchlauf
Hier findet die eigentliche Backpropagation statt. Sie ist ohne den vorangegangenen Vorwärtsdurchlauf und die Fehlerberechnung nicht möglich. So funktioniert sie:
- Der zuvor ermittelte Fehlerwert dient zur Berechnung des Gradienten der Verlustfunktion.
- Der Fehlergradient wird vom Ausgang zurück durch das Netz propagiert – von der Ausgabeschicht zu den verdeckten Schichten.
- Während sich der Fehlergradient zurückbewegt, werden die Gewichte (die Linien zwischen den Knoten) entsprechend ihrem Beitrag zum Fehler angepasst. Dazu wird die Ableitung des Fehlers nach jedem Gewicht berechnet. Sie zeigt, wie stark sich der Fehler ändert, wenn sich ein Gewicht ändert.
- Die Lernrate bestimmt die Größe der Gewichtsänderungen. Eine kleinere Lernrate bedeutet kleinere Updates – und umgekehrt.
Gewichtsaktualisierung
- Die Gewichte werden in Richtung des negativen Gradienten angepasst – daher der Name „Gradientenabstieg“. Ziel ist es, den Fehler im nächsten Vorwärtsdurchlauf zu verringern.
- Dieser Zyklus aus Vorwärtsdurchlauf, Fehlerberechnung, Rückwärtsdurchlauf und Gewichtsaktualisierung wiederholt sich über viele Epochen, bis die Leistung des Netzes zufriedenstellend ist oder sich nicht mehr signifikant verbessert.
Vorteile von Backpropagation
Backpropagation ist eine grundlegende Technik im Training neuronaler Netze. Sie überzeugt durch einfache Implementierung, programmatische Einfachheit und vielseitige Einsetzbarkeit in unterschiedlichen Netzwerkarchitekturen.
Unser Tutorial Building Neural Network (NN) Models in R ist ein guter Einstieg für alle, die mehr über neuronale Netze lernen möchten. Es zeigt, wie du ein NN-Modell in R erstellst.
Für Python-Programmierer bietet das Tutorial Recurrent Neural Network Tutorial (RNN) eine umfassende Einführung in das beliebte Deep-Learning-Modell RNN – inklusive Praxisprojekt zum Vorhersagen des MasterCard-Aktienkurses.
Im Folgenden gehen wir auf die genannten Vorteile genauer ein:
- Einfache Umsetzung: Über zahlreiche Deep-Learning-Bibliotheken wie PyTorch und Keras verfügbar – ideal für vielfältige Anwendungen.
- Einfaches Programmieren: Frameworks kapseln viel Komplexität, sodass weniger aufwendige Mathematik nötig ist.
- Flexibilität: Für viele Architekturen adaptierbar und damit für ein breites Spektrum an KI-Aufgaben geeignet.
Einschränkungen und Herausforderungen
Trotz ihrer Erfolge hat Backpropagation auch Grenzen, die Effizienz und Wirksamkeit des Trainings eines neuronalen Netzes beeinflussen können. Hier sind einige zentrale Punkte:
- Datenqualität: Schlechte Qualität – etwa Rauschen, Unvollständigkeit oder Verzerrungen – führt zu ungenauen Modellen, denn Backpropagation lernt exakt aus dem, was vorliegt.
- Trainingsdauer: Backpropagation braucht oft viel Trainingszeit – bei großen Netzen in der Praxis problematisch.
- Matrix-Komplexität: Matrixoperationen skalieren mit der Netzgröße, was den Rechenaufwand erhöht und Ressourcen schnell ausreizen kann.
Backpropagation implementieren
Mit diesem Verständnis setzen wir Backpropagation jetzt in einem realen Szenario ein: Wir bauen ein neuronales Netz, das handgeschriebene Ziffern aus dem MNIST-Datensatz erkennt.
Dieser Abschnitt deckt alle Schritte ab – von der Datenvisualisierung über das Training bis zur Evaluation. Den vollständigen Code findest du in diesem DataLab-Workbook. Du kannst dir unkompliziert eine eigene Kopie anlegen und den Code direkt im Browser ausführen – ganz ohne Installation.
Zum Datensatz
Der MNIST-Datensatz ist ein Klassiker in der Bildverarbeitung. Er umfasst 70.000 Graustufenbilder handgeschriebener Ziffern von 0 bis 9, jeweils mit 28x28 Pixeln.
Der Datensatz ist über die Funktion mnist aus dem Modul Keras.datasets verfügbar und wird nach dem Import wie folgt geladen:
from keras.datasets import mnist
(train_images, train_labels), (test_images, test_labels) = mnist.load_data()
Explorative Datenanalyse
Vor dem Aufbau eines Machine-Learning- oder Deep-Learning-Modells ist eine explorative Datenanalyse zentral. Sie hilft, die Daten besser zu verstehen und die Wahl des passenden Modells zu leiten.
Die wichtigsten Aufgaben sind:
- Ermitteln der Gesamtanzahl an Datenpunkten in Trainings- und Testdatensatz.
- Zufällige Visualisierung einiger Ziffern aus dem Trainingsdatensatz.
- Visualisierung der Labelverteilung im Trainingsdatensatz.
Insgesamt umfasst der Datensatz 70.000 Bilder. Typische Aufteilungen des Originaldatensatzes sind unter anderem:
- 70% oder 80% für das Training
- 30% oder 20% für das Testen
Manchmal werden auch 90% für Training und 10% für Testen verwendet.
In unserem Fall sind Trainings- und Testdaten bereits getrennt geladen, ein zusätzliches Splitten ist also nicht nötig. Schauen wir uns die Größen an.
print("Training data")
print(f"- X = {train_images.shape}, y = {train_labels.shape}")
print(f"- Hols {train_images.shape[0]/70000* 100}% of the overall data")

print("\n")

print("Testing data")
print(f"- X = {test_images.shape}, y = {test_labels.shape}")
print(f"- Hols {test_images.shape[0]/70000* 100}% of the overall data")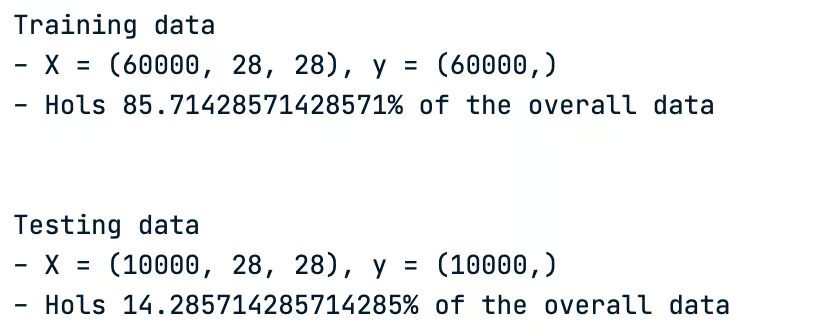
Eigenschaften von Trainings- und Testdatensatz
- Der Trainingsdatensatz enthält 60.000 Bilder und entspricht 85,71% des ursprünglichen Datensatzes.
- Der Testdatensatz umfasst die verbleibenden 10.000 Bilder, also 14,28% des ursprünglichen Datensatzes.
Als Nächstes visualisieren wir einige zufällige Ziffern. Dafür nutzen wir die Hilfsfunktion plot_images, die zwei Hauptparameter erwartet:
- Die Anzahl der zu zeichnenden Bilder und
- Den Datensatz, aus dem visualisiert werden soll
def plot_images(nb_images_to_plot, train_data):

	# Generate a list of random indices from the training data
	random_indices = random.sample(range(len(train_data)), nb_images_to_plot)

	# Plot each image using the random indices
	for i, idx in enumerate(random_indices):
    	plt.subplot(330 + 1 + i)
    	plt.imshow(train_data[idx], cmap=plt.get_cmap('gray'))

	plt.show()
Wir möchten neun Bilder aus den Trainingsdaten anzeigen. Das erledigt folgender Code:
nb_images_to_plot = 9
plot_images(nb_images_to_plot, train_images)
Die erfolgreiche Ausführung erzeugt die folgenden neun Ziffern.
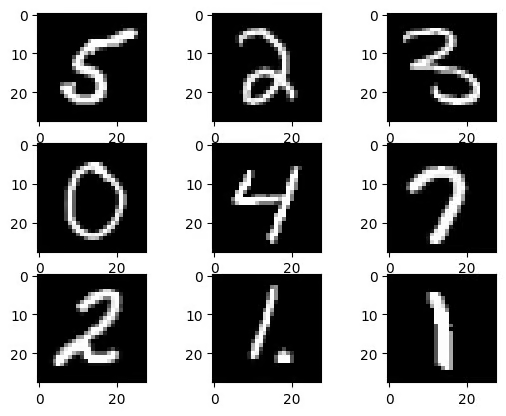
Neun zufällige Bilder aus dem Trainingsdatensatz
Beim zweiten Aufruf der Funktion werden andere Ziffern angezeigt – bedingt durch die zufällige Auswahl in der Hilfsfunktion.
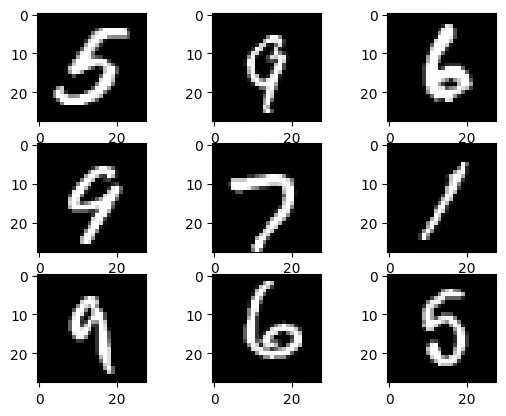
Neun zufällige Bilder aus dem Trainingsdatensatz nach erneutem Aufruf
Abschließend visualisieren wir die Labelverteilung im Trainingsdatensatz mit der Hilfsfunktion plot_labels_distribution.
- Auf der X-Achse stehen alle möglichen Ziffern.
- Auf der Y-Achse die jeweilige Anzahl dieser Ziffern.
import numpy as np

def plot_labels_distribution(data_labels):

	counts = np.bincount(data_labels)

	plt.style.use('seaborn-dark-palette')

	fig, ax = plt.subplots(figsize=(10,5))
	ax.bar(range(10), counts, width=0.8, align='center')
	ax.set(xticks=range(10), xlim=[-1, 10], title='Training data distribution')

	plt.show()
Die Funktion wird auf den Trainingsdatensatz angewandt, indem wir seine Labels übergeben:
plot_labels_distribution(train_labels)Das Ergebnis zeigt: Alle zehn Ziffern sind über den gesamten Datensatz nahezu gleich verteilt. Gut so – eine nachträgliche Balancierung der Label ist nicht nötig.
Datenvorverarbeitung
Echtdaten benötigen in der Regel Vorverarbeitung, um sie fürs Training aufzubereiten. Wir wenden drei Schritte auf Trainings- und Testbilder an:
- Bildnormalisierung: Umwandlung aller Pixelwerte von 0–255 auf 0–1. Das beschleunigt die Konvergenz beim Training.
- Reshaping: Anstatt einer 28x28-Matrix pro Bild wird jedes Bild zu einem Vektor mit 784 Elementen abgeflacht – passend für die Eingaben des Netzes.
- Label-Encoding: Umwandlung der Labels in One-Hot-Vektoren. So vermeiden wir Probleme durch numerische Ordnungseffekte, die das Modell sonst zu größeren Ziffern hin verzerren könnten.
Die gesamte Logik steckt in der Hilfsfunktion preprocess_data:
from keras.utils import to_categorical

def preprocess_data(data, label,
                	vector_size,
                	grayscale_size):

	# Normalize to range 0-1
	preprocessed_images = data.reshape((data.shape[0],
                             	vector_size)).astype('float32') / grayscale_size

	# One-hot encode the labels
	encoded_labels = to_categorical(label)

	return preprocessed_images, encoded_labels
So wenden wir die Funktion auf die Datensätze an:
# Flattening variable
vector_size = 28 * 28

grayscale_size = 255
train_size = train_images.shape[0]
test_size = test_images.shape[0]

# Preprocessing of the training data
train_images, train_labels = preprocess_data(train_images,
                                         	train_labels,
                                         	vector_size,
                                         	grayscale_size)

# Preprocessing of the testing data
test_images, test_labels = preprocess_data(test_images,
                                       	test_labels,
                                       	vector_size,
                                       	grayscale_size)
Jetzt prüfen wir die minimalen und maximalen Pixelwerte beider Datensätze:
print("Training data")
print(f"- Maxium Value {train_images.max()} ")
print(f"- Minimum Value {train_images.min()} ")

print("\n")

print("Testing data")
print(f"- Maxium Value {test_images.max()} ")
print(f"- Minimum Value {test_images.min()} ")
Das Ergebnis unten zeigt: Die Normalisierung hat wie vorgesehen funktioniert.
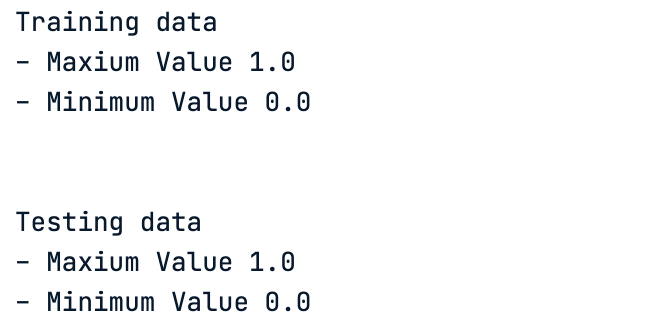
Minimale und maximale Pixelwerte nach der Normalisierung
Analog zu den Labels erhalten wir schließlich Matrizen aus Nullen und Einsen – die One-Hot-kodierten Werte dieser Labels.
# One hot encoding of the test data labels
test_images
Ergebnis:
One-Hot-Encoding der Testdaten-Labels
# One hot encoding of the train data labels
train_labels
One-Hot-Encoding der Trainingsdaten-Labels
Aufbau des Netzes
Für eine Bildklassifikationsaufgabe sind Convolutional Neural Networks besonders geeignet. Bevor wir mit dem Code starten, definieren wir die Architektur – darum geht es in diesem Abschnitt.
Mehr zu Convolutional Neural Networks erfährst du im Tutorial An Introduction to Convolutional Neural Networks (CNNs). Es erklärt CNNs, ihren Einfluss auf die Bildanalyse und Strategien gegen Overfitting für robuste CNN- und Deep-Learning-Anwendungen.
Die Architektur in diesem Use Case kombiniert verschiedene Schichten für eine effektive Bildklassifikation. Die wichtigsten Bausteine sind:
- Convolutional Layer: Starte mit einem Layer mit kleinem 3x3-Filter und 32 Filtern zur Verarbeitung der Bilder.
- Max-Pooling-Layer: Reduziert nach der Convolution die Größe der Feature-Maps.
- Flattening: Wandelt die Ausgabe des Pooling-Layers in einen Vektor um – Vorbereitung für die Klassifikation.
- Dense Layer: Eine dichte Schicht mit 100 Knoten zwischen Flatten und der Ausgabeschicht, um die extrahierten Merkmale zu interpretieren.
- Ausgabeschicht: 10 Knoten – einer pro Kategorie. Jeder Knoten liefert die Wahrscheinlichkeit, dass ein Bild zu dieser Kategorie gehört.
- Softmax-Aktivierung: In der Ausgabeschicht für die Mehrklassenklassifikation.
- ReLU-Aktivierungsfunktion: In allen versteckten Schichten für nichtlineare Abbildungen.
- Optimizer: Stochastischer Gradientenabstieg mit Lernrate 0,001 und Momentum 0,95 zur Anpassung während des Trainings.
- Verlustfunktion: Kategorische Kreuzentropie – ideal für Mehrklassenklassifikation.
- Metrik Genauigkeit: Fokus auf die Klassifikationsgenauigkeit, da die Klassen ausgewogen verteilt sind.
All das setzen wir in der Hilfsfunktion define_network_architecture um. Zunächst importieren wir die benötigten Bibliotheken:
from keras import models
from keras import layers
from tensorflow.keras.optimizers import SGD
from tensorflow.keras.layers import Conv2D
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import MaxPooling2D
from tensorflow.keras.layers import Dense
from tensorflow.keras.layers import Flatten
from tensorflow.keras.layers import BatchNormalization
Hier die Implementierung der Hilfsfunktion.
hidden_units = 256
nb_unique_labels = 10
vector_size = 784  # Assuming a 28x28 input image for example

def define_network_architecture():

	network = models.Sequential()
	network.add(Dense(vector_size, activation='relu', input_shape=(vector_size,)))  # Input layer
	network.add(Dense(512, activation='relu'))                       	# Hidden layer
	network.add(Dense(nb_unique_labels, activation='softmax'))

	return network
Der Code ist gut – noch besser wird es mit einer grafischen Darstellung der Architektur. Das geht mit plot_model aus keras.utils.vis_utils.
Zuerst erzeugen wir das Netz über die Hilfsfunktion.
network = define_network_architecture()Dann visualisieren wir es. Wir speichern die Grafik als PNG und zeigen sie anschließend an – so lässt sie sich leichter teilen.
import keras.utils.vis_utils
from importlib import reload
reload(keras.utils.vis_utils)
from keras.utils.vis_utils import plot_model

import matplotlib.image as mpimg

plot_model(network, to_file='network_architecture.png', show_shapes=True, show_layer_names=True)

img = mpimg.imread('network_architecture.png')
plt.imshow(img)
plt.axis('off')
plt.show()
Das Ergebnis siehst du unten.
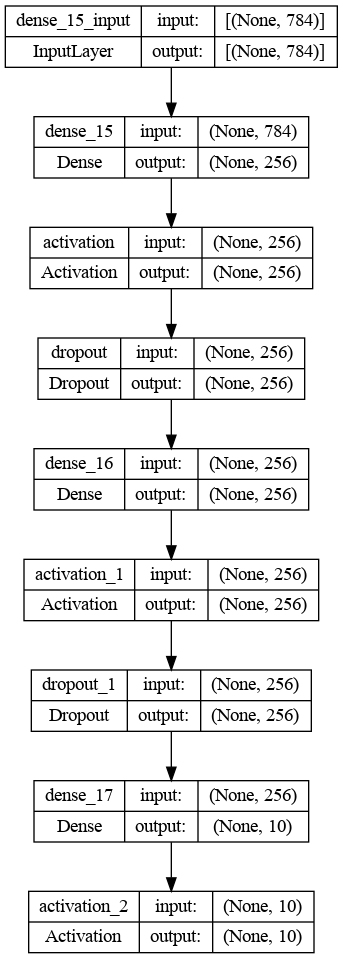
Grafische Architektur des Convolutional Neural Network
Delta berechnen
Bevor wir das Modell trainieren, klären wir, wie die Delta-Fehlerverteilung anhand der Netzwerkarchitektur berechnet wird.
Die Delta-Fehlerverteilung ist die Ableitung der Verlustfunktion bezüglich der Aktivierung jedes Knotens. Sie zeigt, wie stark die Aktivierung eines Knotens zum Gesamtfehler beigetragen hat.
Die obige Architektur umfasst drei Hauptschichten:
- Eingabeschicht mit 784 Einheiten für ein 28x28-Eingabebild
- Verdeckte Schicht mit 512 Einheiten und ReLU-Aktivierung
- Ausgabeschicht mit 10 Einheiten (eine pro Label) und Softmax-Aktivierung
Nun zur Delta-Berechnung pro Schicht.
Ausgabeschicht
Bezeichne die Ausgabe der Softmax-Schicht mit großem O (O) und die wahren Labels mit Y. Mit der Kreuzentropie als Verlust ergibt sich der Delta-Fehler:
δ output = O - Y
Diese Formel folgt direkt daraus, wie sich die Kreuzentropie ändert, wenn sich die Softmax-Ausgabe ändert.
Verdeckte Schicht
Für die verdeckte Schicht hängt der Delta-Fehler δ hidden vom Fehler der nachfolgenden Schicht (Ausgabeschicht) und der Ableitung der ReLU-Aktivierung ab.
Die Ableitung von ReLU ist 1 für positive Eingaben und 0 für negative – siehe unten.
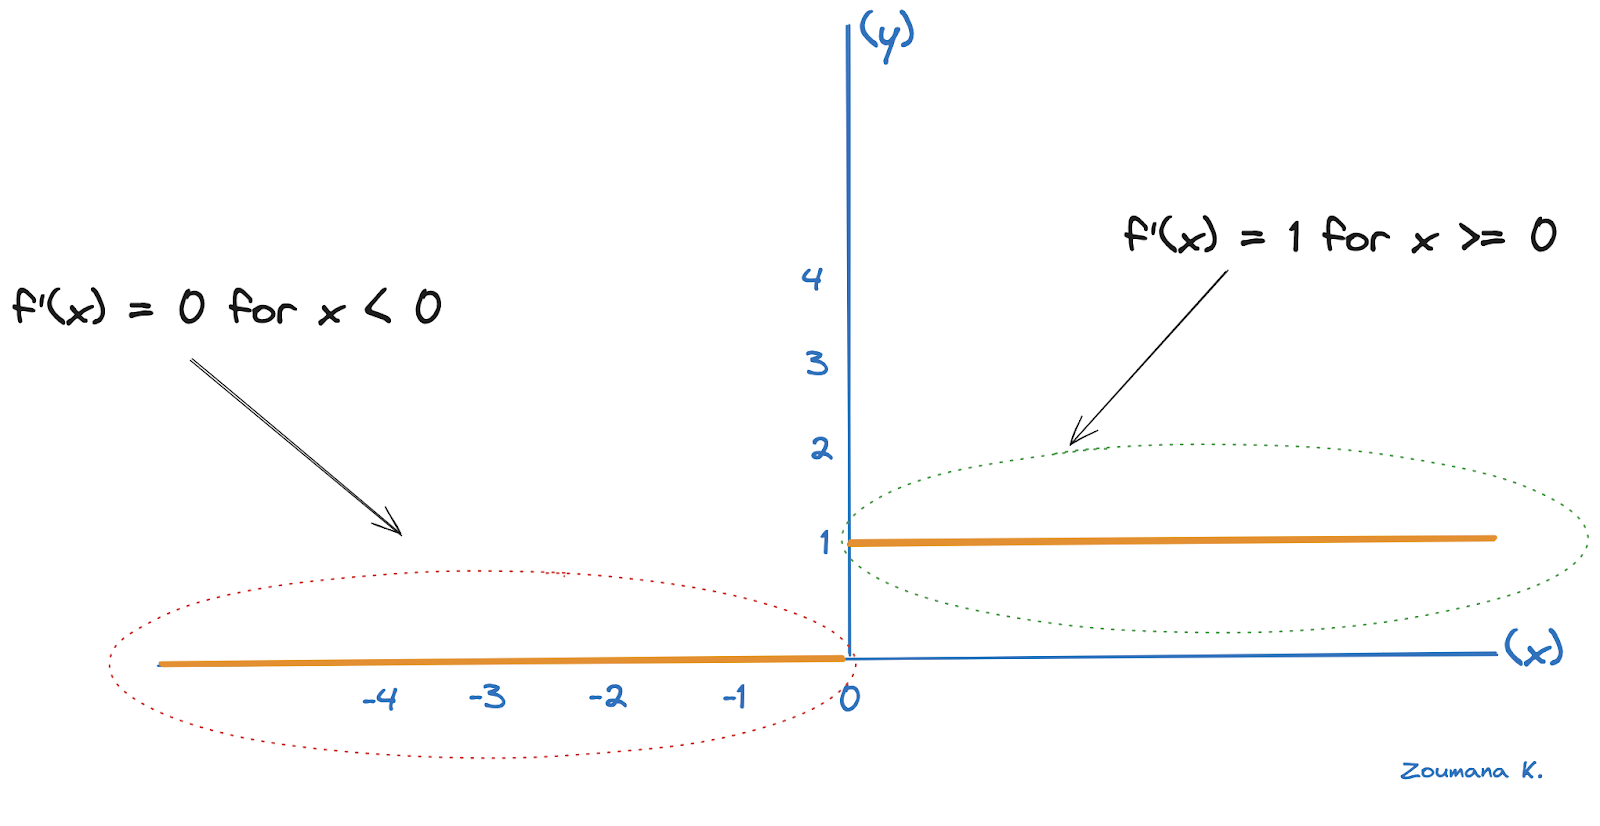
Ableitung der ReLU-Funktion
Sei Zhidden der Eingang der ReLU in der verdeckten Schicht und Woutput die Gewichte zwischen verdeckter und Ausgabeschicht. Dann gilt für den Delta-Fehler der verdeckten Schicht:
δ hidden = (δ output . Woutput) ⊙ ReLU’(Zhidden)
- Der Punkt „." bezeichnet die Matrixmultiplikation.
- Das Zeichen ⊙ steht für elementweise Multiplikation.
- ReLU’(Zhidden) ist die Ableitung der ReLU an der Stelle Zhidden.
Eingabeschicht
Bei weiteren verdeckten Schichten setzt sich der Prozess entsprechend fort: Jede Schicht erhält ihr Delta aus dem der nächsten Schicht und der Ableitung ihrer Aktivierungsfunktion.
Allgemein gilt für eine beliebige Schicht k (außer der Ausgabeschicht):
δ k = (δ k+1 . WTk+1) ⊙ f’(Zk)
- WTk+1 ist die transponierte Gewichtsmatrix der Folgeschicht,
- f’ die Ableitung der Aktivierungsfunktion der Schicht k und
- Zk der Eingang der Aktivierungsfunktion in Schicht k.
Kompilierung des Netzes
Mit diesem Verständnis der Fehlerberechnung kompilieren wir das Netz, um es optimal fürs Training vorzubereiten.
Bei der Kompilierung triffst du mehrere zentrale Entscheidungen:
- Optimierungsalgorithmus: Auswahl eines Verfahrens für den Gradientenabstieg – etwa Stochastic Gradient Descent (SGD), Adagrad oder RMSprop (hier verwendet).
- Verlustfunktion: Sie misst, wie gut das Netz performt, und sollte zum Problem (Klassifikation/Regression) passen. Für unser Mehrklassenproblem nutzen wir die kategoriale Kreuzentropie.
- Leistungsmetrik: Eine Metrik zur Bewertung auf dem Testdatensatz – wir verwenden die Genauigkeit.
Der zugehörige Code:
network.compile(optimizer='rmsprop',
            	loss='categorical_crossentropy',
            	metrics=['accuracy'])
Training des Netzes
Eine der größten Herausforderungen beim Training ist Overfitting. Es ist wichtig, das Modell während des Trainings zu überwachen – etwa mit Early Stopping –, um die Generalisierung zu verbessern.
Die komplette Logik siehst du hier:
# Fit the model
batch_size = 256
n_epochs = 15
val_split = 0.2
patience_value = 5

# Fit the model with the callback
history = network.fit(train_images, train_labels, validation_split=val_split,
        	epochs=n_epochs, batch_size=batch_size)
Das Modell wird über 15 Epochen mit einer Batch-Größe von 256 trainiert. 20% der Trainingsdaten dienen als Validierung.
Nach dem Training visualisieren wir den Verlauf von Trainings- und Validierungsleistung.
plt.plot(history.history['accuracy'])
plt.plot(history.history['val_accuracy'])
plt.title('Model accuracy')
plt.ylabel('Accuracy')
plt.xlabel('Epoch')
plt.legend(['Train', 'Validation'], loc='upper left')
plt.show()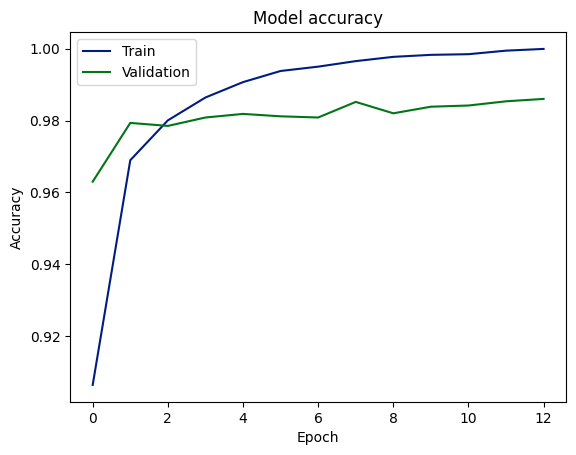
Genauigkeit im Training und in der Validierung
Evaluation auf Testdaten
Jetzt bewerten wir die Modellleistung auf den Testdaten mit der evaluate-Funktion.
loss, acc = network.evaluate(test_images,
                         	test_labels, batch_size=batch_size)

print("\nTest accuracy: %.1f%%" % (100.0 * acc))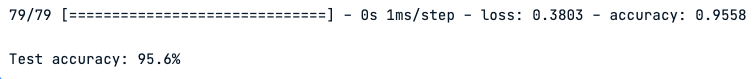
Modellleistung auf Testdaten
Die Grafik zeigt, dass das Modell mit hoher Genauigkeit vorhersagt – rund 98% auf Validierungs- und Testdaten. Das spricht für gute Generalisierung. Die Lücke zwischen Trainings- und Validierungsgenauigkeit kann auf Overfitting hindeuten, die Übereinstimmung von Validierungs- und Testergebnis relativiert das jedoch.
Empfehlungen
Trotz hoher Genauigkeit und guter Generalisierung gibt es noch Potenzial. Diese Maßnahmen können die Leistung weiter verbessern:
- Regularisierung: Setze Regularisierungsmethoden ein, um Overfitting zu reduzieren.
- Early Stopping: Brich das Training ab, sobald sich die Validierungsleistung nicht mehr verbessert.
- Fehleranalyse: Untersuche Fehlklassifikationen, um systematische Ursachen zu finden und zu beheben.
- Vielfaltstests: Teste das Modell auf vielfältigen Datensätzen, um die Robustheit zu prüfen.
- Erweiterte Metriken: Nutze Precision, Recall und F1-Score für eine umfassendere Bewertung – besonders bei unausgewogenen Daten.
Fazit
Dieses Tutorial hat Backpropagation – eine Schlüsseltechnik im Machine Learning – umfassend beleuchtet. Wir haben definiert, was Backpropagation ist, und ihre zentrale Rolle für die Weiterentwicklung der KI herausgestellt.
Anschließend sind wir in die Funktionsweise eingestiegen, haben Vorteile wie effizienteres Lernen erläutert und zugleich Grenzen und Herausforderungen benannt.
Darauf folgte eine detaillierte Anleitung zum Aufsetzen und Trainieren neuronaler Netze – mit Fokus auf den Vorwärtsdurchlauf.
Zum Abschluss haben wir die Schritte zur Delta-Berechnung und Gewichtsaktualisierung betrachtet – essenziell, um den Lernprozess zu verfeinern.
In Summe ist dieser Beitrag eine wertvolle Ressource für alle, die Backpropagation in neuronalen Netzen verstehen und wirksam einsetzen möchten.
Du willst deine Deep-Learning-Kompetenzen ausbauen? Unser Kurs Deep Learning with PyTorch gibt dir das nötige Rüstzeug, um tiefer in neuronale Netze einzusteigen und dein Wissen weiterzuentwickeln.
