
Last chance! 50% off DataCamp Premium
Sale ends in
Dengan kemajuan terbaru pada model visi komputer berbasis deep learning, aplikasi deteksi objek kini lebih mudah dikembangkan daripada sebelumnya. Selain peningkatan kinerja yang signifikan, teknik-teknik ini juga memanfaatkan kumpulan data gambar yang masif untuk mengurangi kebutuhan akan dataset yang besar. Di samping itu, dengan pendekatan terkini yang berfokus pada pipeline end-to-end penuh, kinerja juga meningkat pesat sehingga memungkinkan kasus penggunaan secara real-time.
Mirip dengan blogpost yang saya tulis tentang berbagai arsitektur klasifikasi gambar, saya akan membahas dua arsitektur deteksi objek. Saya akan membahas SSD dan Faster RCNN, yang saat ini keduanya tersedia di Tensorflow Detection API.
Pertama saya akan membahas beberapa konsep kunci dalam deteksi objek, kemudian diikuti dengan ilustrasi bagaimana konsep tersebut diimplementasikan dalam SSD dan Faster RCNN.
Orang sering keliru antara skenario klasifikasi gambar dan deteksi objek. Secara umum, jika Anda ingin mengklasifikasikan sebuah gambar ke dalam kategori tertentu, Anda menggunakan klasifikasi gambar. Sebaliknya, jika Anda bertujuan mengidentifikasi lokasi objek dalam gambar, dan misalnya, menghitung jumlah kemunculan suatu objek, Anda dapat menggunakan deteksi objek.
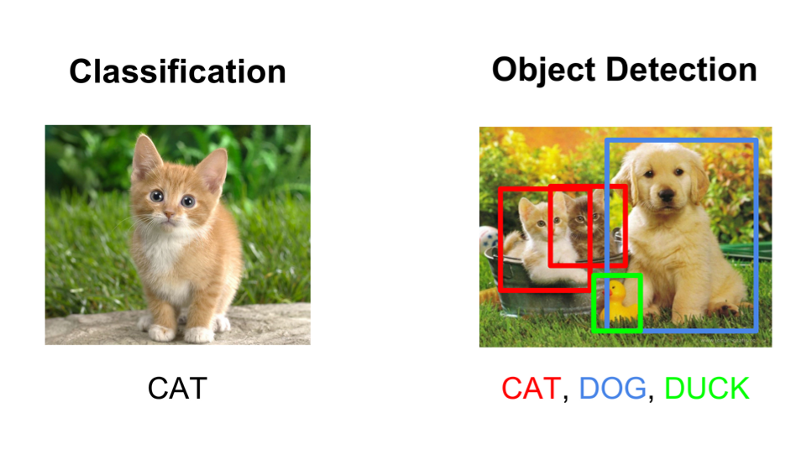
Namun, ada sedikit tumpang tindih antara kedua skenario ini. Jika Anda ingin mengklasifikasikan sebuah gambar ke dalam kategori tertentu, bisa saja objek atau karakteristik yang diperlukan untuk melakukan pengkategorian terlalu kecil dibandingkan dengan keseluruhan gambar. Dalam kasus tersebut, Anda akan mendapatkan kinerja lebih baik dengan deteksi objek ketimbang klasifikasi gambar, meskipun Anda tidak tertarik pada lokasi persis atau jumlah objeknya.
Bayangkan Anda perlu memeriksa papan sirkuit dan mengklasifikasikannya sebagai cacat atau baik. Walau pada dasarnya ini masalah klasifikasi, cacatnya mungkin terlalu kecil untuk terlihat oleh model klasifikasi gambar. Membangun dataset deteksi objek akan memakan waktu lebih lama, tetapi kemungkinan besar menghasilkan model yang lebih baik.
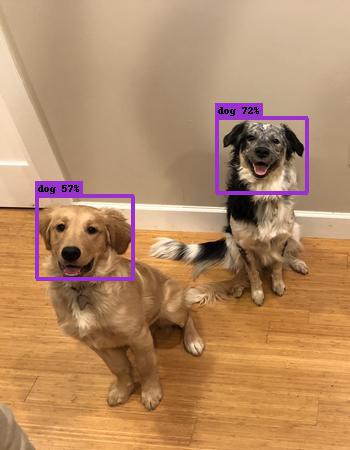
Dengan model klasifikasi gambar, Anda menghasilkan fitur gambar (melalui metode tradisional atau deep learning) dari keseluruhan gambar. Fitur-fitur ini merupakan agregat dari gambar. Dengan deteksi objek, Anda melakukannya pada tingkat yang lebih rinci, granular, dan per wilayah dari gambar. Pada yang pertama Anda mungkin kehilangan jejak sinyal klasifikasi, sedangkan pada yang kedua sinyalnya dapat dipertahankan dengan cara yang lebih sesuai untuk kasus penggunaan.
Untuk melatih model kustom, Anda memerlukan data berlabel. Data berlabel dalam konteks deteksi objek adalah gambar dengan koordinat bounding box dan label yang sesuai. Yaitu, koordinat (x,y) kiri bawah dan kanan atas + kelas.
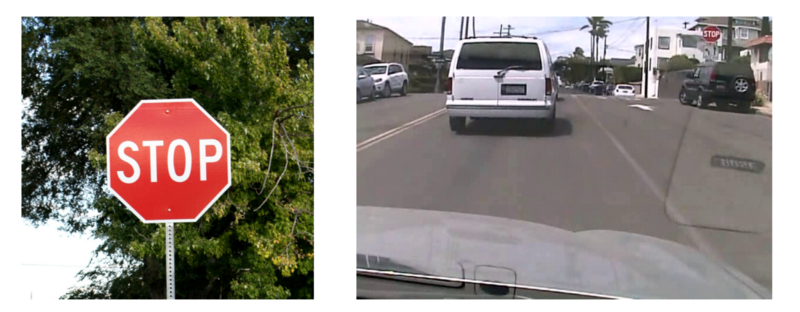
Pertanyaan yang selalu muncul adalah: untuk melakukan deteksi objek pada masalah X, berapa banyak gambar yang saya butuhkan? Alih-alih itu, lebih penting untuk benar-benar memahami dalam skenario apa model akan digunakan. Sangat krusial tersedia sejumlah besar (misalnya, > 100 dan berpotensi >1000) gambar yang representatif per kelas. Representatif di sini berarti harus sesuai dengan rentang skenario tempat model akan digunakan. Jika Anda membangun model deteksi rambu lalu lintas yang akan berjalan di mobil, Anda harus menggunakan gambar yang diambil dalam kondisi cuaca, pencahayaan, dan kamera yang berbeda dalam konteksnya masing-masing. Model deteksi objek bukanlah sihir dan sebenarnya cukup polos. Jika model tidak memiliki cukup data untuk mempelajari pola umum, model tidak akan berkinerja baik di produksi.
Biasanya, ada tiga langkah dalam kerangka deteksi objek.
Ada beberapa pendekatan berbeda untuk menghasilkan usulan wilayah. Awalnya, algoritme ‘selective search’ digunakan untuk menghasilkan usulan objek. Lillie Weng memberikan penjelasan menyeluruh tentang algoritme ini di postingan blognya. Singkatnya, selective search adalah pendekatan berbasis pengelompokan yang berupaya mengelompokkan piksel dan menghasilkan usulan berdasarkan klaster yang terbentuk.
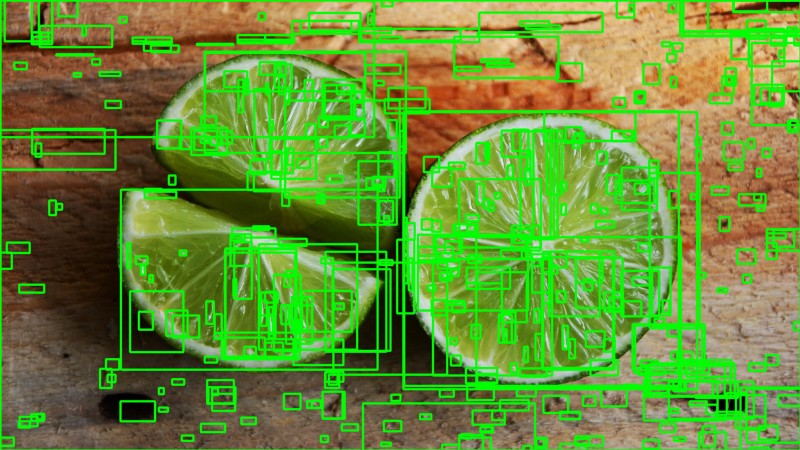
Pendekatan lain menggunakan fitur visual yang lebih kompleks yang diekstrak dari gambar untuk menghasilkan wilayah (misalnya, berdasarkan fitur dari model deep learning) atau mengadopsi pendekatan brute-force untuk menghasilkan wilayah. Pendekatan brute-force ini mirip dengan jendela geser yang diterapkan pada gambar, pada berbagai rasio dan skala. Wilayah-wilayah ini dihasilkan secara otomatis, tanpa mempertimbangkan fitur gambar.
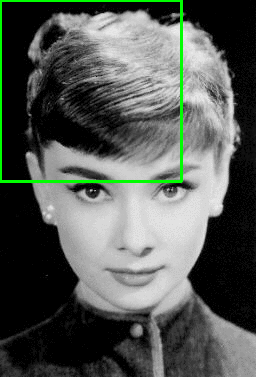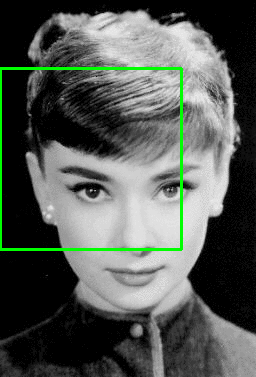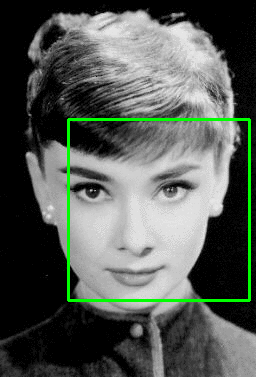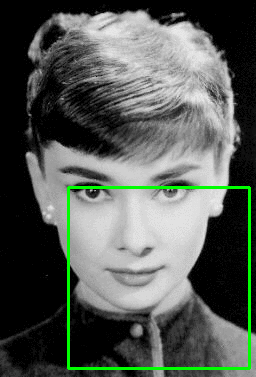
Trade-off penting dalam pembuatan usulan wilayah adalah jumlah wilayah vs kompleksitas komputasi. Semakin banyak wilayah yang Anda hasilkan, semakin besar peluang Anda menemukan objek. Di sisi lain, jika Anda menghasilkan semua usulan secara ekshaustif, misalnya, pendeteksi objek tidak akan bisa berjalan secara real-time. Dalam beberapa kasus, memungkinkan untuk menggunakan informasi spesifik masalah guna mengurangi jumlah ROI. Misalnya, pejalan kaki biasanya memiliki rasio sekitar 1,5, jadi tidak berguna menghasilkan ROI dengan rasio 0,25.
Tujuan ekstraksi fitur adalah mereduksi gambar berukuran variabel menjadi sekumpulan fitur visual berukuran tetap. Model klasifikasi gambar biasanya dibangun menggunakan metode ekstraksi fitur visual yang kuat. Baik berbasis pendekatan visi komputer tradisional, seperti misalnya pendekatan berbasis filter, metode histogram, dan sebagainya, maupun metode deep learning, semuanya memiliki tujuan yang sama: mengekstrak fitur dari gambar masukan yang representatif untuk tugas yang dihadapi dan menggunakan fitur-fitur tersebut untuk menentukan kelas gambar. Dalam kerangka deteksi objek, orang biasanya menggunakan model klasifikasi gambar pralatih untuk mengekstrak fitur visual, karena model-model tersebut cenderung cukup terumumkan. Misalnya, model yang dilatih pada dataset MS CoCo mampu mengekstrak fitur yang cukup generik. Namun, untuk meningkatkan model, disarankan bereksperimen dengan berbagai pendekatan. Postingan blog saya tentang transfer learning memberikan pembedaan yang jelas antara berbagai jenis transfer learning beserta kelebihan dan kekurangannya.
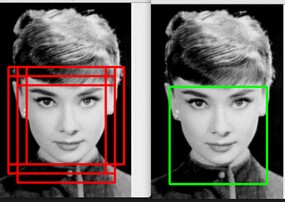
Gagasan umum non-maximum suppression adalah mengurangi jumlah deteksi dalam satu frame menjadi jumlah objek yang sebenarnya ada. Jika objek dalam frame cukup besar dan lebih dari 2000 usulan objek telah dihasilkan, sangat mungkin beberapa di antaranya memiliki tumpang tindih signifikan satu sama lain dan dengan objeknya. Tonton video ini di Coursera untuk mempelajari lebih lanjut tentang NMS. Teknik NMS umumnya standar di berbagai kerangka deteksi, tetapi ini adalah langkah penting yang mungkin memerlukan pengaturan hiperparameter berdasarkan skenario.
Metrik evaluasi yang paling umum digunakan dalam tugas pengenalan objek adalah ‘mAP’, singkatan dari ‘mean average precision’. Nilainya berkisar 0 hingga 100 dan nilai yang lebih tinggi biasanya lebih baik, tetapi nilainya berbeda dari metrik akurasi pada klasifikasi.
Setiap bounding box akan memiliki skor terkait (kemungkinan kotak tersebut mengandung objek). Berdasarkan prediksi, kurva precision-recall (kurva PR) dihitung untuk tiap kelas dengan memvariasikan ambang skor. Average precision (AP) adalah area di bawah kurva PR. Pertama AP dihitung untuk tiap kelas, lalu dirata-ratakan di seluruh kelas. Hasil akhirnya adalah mAP.
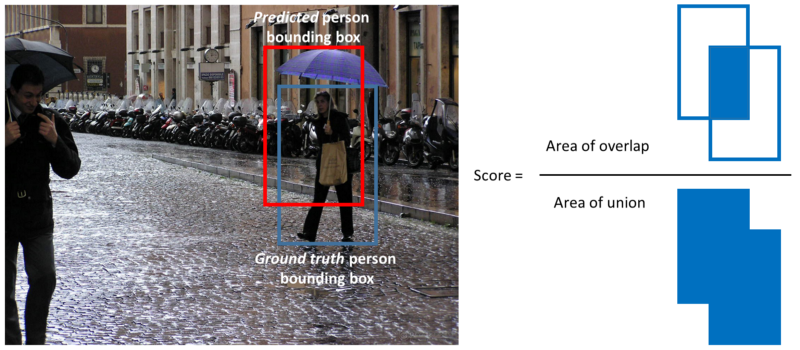
Perhatikan bahwa suatu deteksi adalah true positive jika memiliki ‘intersection over union’ (IoU atau tumpang tindih) dengan kotak ground-truth yang lebih besar daripada ambang tertentu (biasanya 0,5). Alih-alih menggunakan mAP saja, kita biasanya menggunakan mAP@0.5 atau mAP@0.25 untuk merujuk pada IoU yang digunakan.
Tensorflow Detection API menggabungkan banyak gagasan yang disebutkan sebelumnya dalam satu paket, memungkinkan Anda dengan cepat melakukan iterasi berbagai konfigurasi menggunakan backend Tensorflow. Dengan API ini, Anda mendefinisikan model deteksi objek menggunakan file konfigurasi, dan Tensorflow Detection API bertanggung jawab menyusun semua elemen yang diperlukan.
Untuk memahami lebih baik komponen apa saja yang didukung, lihat ‘folder protos’ yang berisi definisi fungsi. Secara khusus, protos train, eval, ssd, faster_rcnn, dan preprocessing penting saat melakukan fine-tuning model.
Arsitektur SSD dipublikasikan pada 2016 oleh peneliti dari Google. Arsitektur ini menyajikan model deteksi objek menggunakan satu jaringan saraf dalam yang menggabungkan usulan wilayah dan ekstraksi fitur.
Sekumpulan kotak default pada berbagai rasio aspek dan skala digunakan dan diterapkan pada feature map. Karena feature map ini dihitung dengan melewatkan gambar melalui jaringan klasifikasi gambar, ekstraksi fitur untuk bounding box dapat diambil dalam satu langkah. Skor dihasilkan untuk setiap kategori objek dalam setiap bounding box default. Untuk lebih menyesuaikan dengan kotak ground truth, offset penyesuaian dihitung untuk tiap kotak.
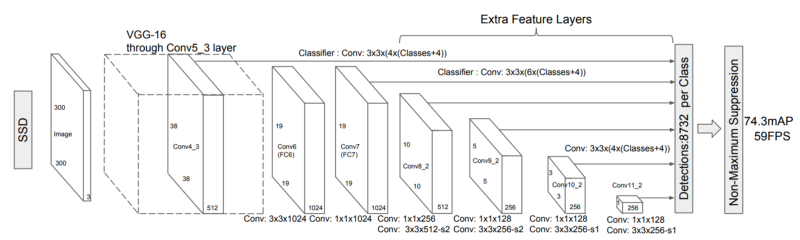
Feature map berbeda dalam jaringan konvolusional berkorespondensi dengan receptive field yang berbeda dan digunakan untuk secara alami menangani objek pada berbagai skala. Karena semua komputasi terenkapsulasi dalam satu jaringan, kecepatan komputasi yang cukup tinggi dapat dicapai (misalnya, untuk masukan 300 × 300 mencapai 59 FPS).
Untuk penggunaan, kita akan meninjau berbagai file konfigurasi contoh untuk SSD. Beberapa parameter penting saat memanfaatkan arsitektur SSD dan kita akan membahasnya satu per satu.
Pertama, jaringan klasifikasi yang berbeda memiliki kekuatan dan kelemahan yang berbeda (lihat posting blog ini untuk ikhtisar). Jaringan Inceptionv3 misalnya dilatih untuk mendeteksi objek dengan baik pada berbagai skala, sedangkan arsitektur ResNet mencapai akurasi keseluruhan yang sangat tinggi. Mobilenet di sisi lain adalah jaringan yang dilatih untuk meminimalkan sumber daya komputasi yang diperlukan. Kinerja jaringan ekstraksi fitur pada ImageNet, jumlah parameter, dan dataset asal tempat ia dilatih merupakan proksi yang baik untuk trade-off kinerja/kecepatan. Feature extractor didefinisikan dalam bagian ‘feature_extractor’.
Kedua, sekumpulan parameter yang jelas adalah pengaturan untuk kotak default dan rasio aspek. Bergantung pada jenis masalah, ada baiknya menganalisis berbagai rasio aspek dan skala bounding box dari data berlabel. Menyetel rasio aspek dan skala akan memastikan jaringan tidak melakukan perhitungan yang tidak perlu. Anda dapat menyetel ini di bagian ‘ssd_anchor_generator’. Perhatikan bahwa menambahkan lebih banyak skala dan rasio aspek akan meningkatkan kinerja, tetapi biasanya dengan hasil yang semakin kecil.
Ketiga, saat melatih model penting untuk menetapkan ukuran gambar dan opsi augmentasi data pada bagian ‘data_augmentation_options’ dan ‘image_resizer’. Ukuran gambar yang lebih besar akan berkinerja lebih baik karena objek kecil sering sulit dideteksi, tetapi akan berbiaya komputasi signifikan. Augmentasi data sangat penting dalam konteks SSD guna mampu mendeteksi objek pada berbagai skala (bahkan pada skala yang mungkin tidak ada dalam data pelatihan).
Terakhir, menyetel ‘train_config’, menetapkan laju pembelajaran dan ukuran batch penting untuk mengurangi overfitting, dan akan sangat bergantung pada ukuran dataset yang Anda miliki.
Faster R-CNN dikembangkan oleh peneliti di Microsoft. Model ini berbasis R-CNN yang menggunakan pendekatan multi-fase untuk deteksi objek. R-CNN menggunakan Selective Search untuk menentukan usulan wilayah, melewatkannya melalui jaringan klasifikasi dan kemudian menggunakan SVM untuk mengklasifikasikan berbagai wilayah.
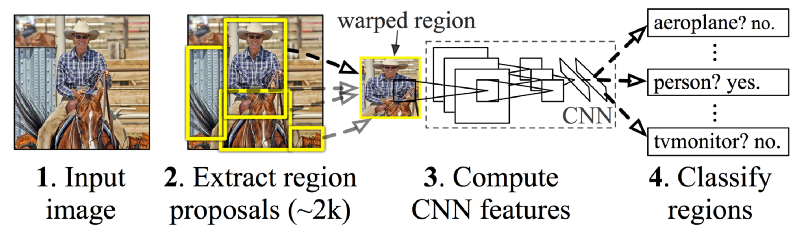
Faster R-CNN, mirip dengan SSD, adalah pendekatan end-to-end. Alih-alih menggunakan bounding box default, Faster R-CNN memiliki Region Proposal Network (RPN) untuk menghasilkan sekumpulan wilayah tetap. RPN menggunakan fitur konvolusional dari jaringan klasifikasi gambar, sehingga hampir tanpa biaya tambahan untuk usulan wilayah. RPN diimplementasikan sebagai jaringan sepenuhnya konvolusional yang memprediksi batas objek dan skor objectness pada setiap posisi.
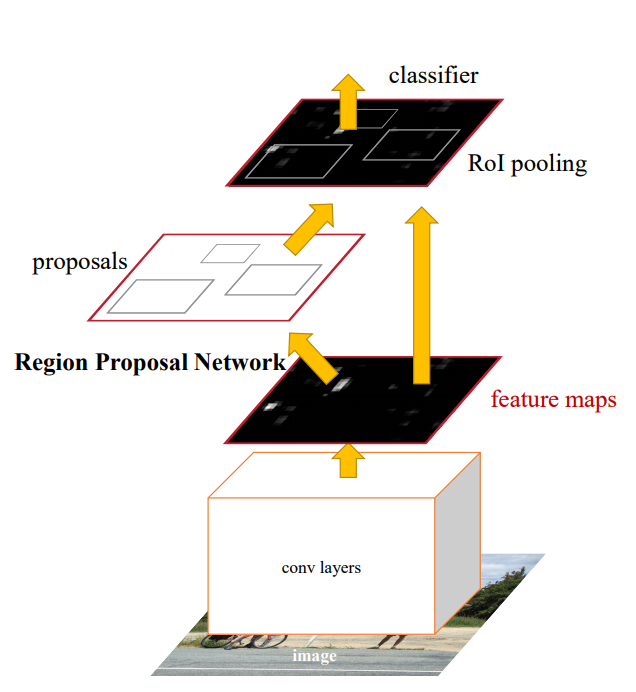
Perhatikan bahwa RPN memiliki pengaturan serupa dengan jaringan SSD (yakni tidak memprediksi bounding box dari nol). Jaringan RPN bekerja dengan jendela geser melintasi feature map. Pada setiap lokasi jendela geser atau anchor, sekumpulan usulan dihitung dengan berbagai skala dan rasio aspek. Mirip dengan SSD, keluaran RPN adalah bounding box yang ‘disesuaikan’ berdasarkan anchor.
Berbagai komponen digabungkan dalam satu kesatuan dan dilatih secara end-to-end atau dalam beberapa fase (untuk meningkatkan stabilitas). Interpretasi lain dari RPN adalah bahwa ia membimbing ‘perhatian’ jaringan ke wilayah-wilayah menarik.
Sebagian besar detail penggunaan Faster R-CNN mirip dengan SSD. Dari sisi mAP mentah, Faster R-CNN umumnya mengungguli SSD, tetapi membutuhkan daya komputasi yang jauh lebih besar.
Bagian penting untuk detektor Fast-RCNN adalah ‘first_stage_anchor_generator’ yang mendefinisikan anchor yang dihasilkan oleh RPN. Stride pada bagian ini mendefinisikan langkah jendela geser. Perhatikan terutama saat mencoba mendeteksi objek kecil (jika stride terlalu besar, Anda bisa melewatkannya).
Meskipun penulis makalah Faster-RCNN tidak menggunakan augmentasi data yang ekstensif, tetap disarankan menggunakannya saat bekerja dengan dataset kecil.
Masih ada beberapa arsitektur deteksi objek lainnya yang belum saya bahas. Terutama untuk aplikasi real-time, Yolov2 sering disebut sebagai arsitektur penting (cukup mirip dengan SSD). Saya akan memperbarui postingan ini kapan pun arsitektur tersebut ditambahkan ke Tensorflow Detection API.
Jika Anda memiliki pertanyaan, dengan senang hati saya membacanya di kolom komentar. Ikuti saya di Medium atau Twitter jika Anda ingin menerima pembaruan tentang postingan blog saya!
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



