
Last chance! 50% off DataCamp Premium
Sale ends in
Con i recenti progressi nei modelli di deep learning per la computer vision, le applicazioni di rilevamento oggetti sono più facili da sviluppare che mai. Oltre ai notevoli miglioramenti in termini di prestazioni, queste tecniche sfruttano anche enormi dataset di immagini per ridurre il bisogno di grandi quantità di dati. Inoltre, con gli approcci attuali focalizzati su pipeline end-to-end complete, le prestazioni sono migliorate significativamente, abilitando casi d’uso in tempo reale.
Analogamente al post che ho scritto sulle diverse architetture di classificazione di immagini, passerò in rassegna due architetture per il rilevamento oggetti. Parlerò di SSD e Faster R-CNN, entrambe attualmente disponibili nella TensorFlow Detection API.
Per prima cosa esaminerò alcuni concetti chiave nel rilevamento oggetti, per poi illustrare come vengono implementati in SSD e Faster R-CNN.
Spesso si confondono gli scenari di classificazione di immagini e rilevamento oggetti. In generale, se vuoi classificare un’immagine in una certa categoria, usi la classificazione. Se invece vuoi identificare la posizione degli oggetti in un’immagine e, ad esempio, contare il numero di istanze di un oggetto, puoi usare il rilevamento.
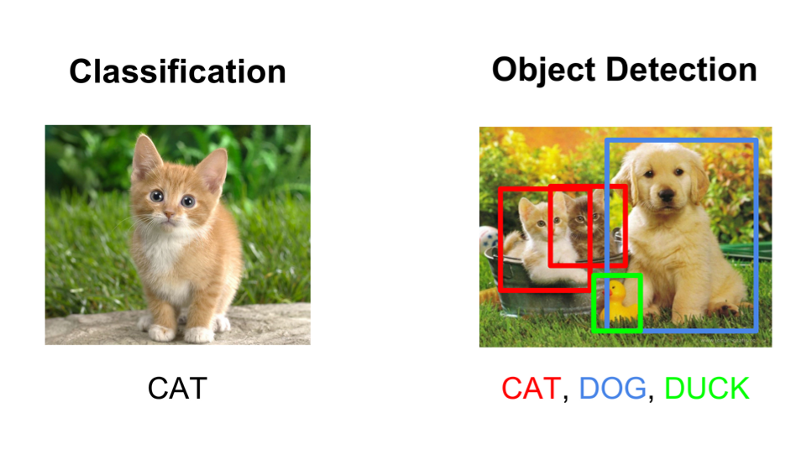
C’è comunque una certa sovrapposizione tra i due scenari. Se vuoi classificare un’immagine in una certa categoria, può capitare che l’oggetto o le caratteristiche necessarie alla categorizzazione siano troppo piccole rispetto all’intera immagine. In tal caso, potresti ottenere prestazioni migliori con il rilevamento oggetti anziché la classificazione, anche se non ti interessano la posizione esatta o il conteggio degli oggetti.
Immagina di dover controllare schede elettroniche e classificarle come difettose o corrette. Anche se si tratta essenzialmente di un problema di classificazione, i difetti potrebbero essere troppo piccoli per essere notati con un modello di classificazione. Costruire un dataset per il rilevamento oggetti richiederà più tempo, ma con ogni probabilità porterà a un modello migliore.
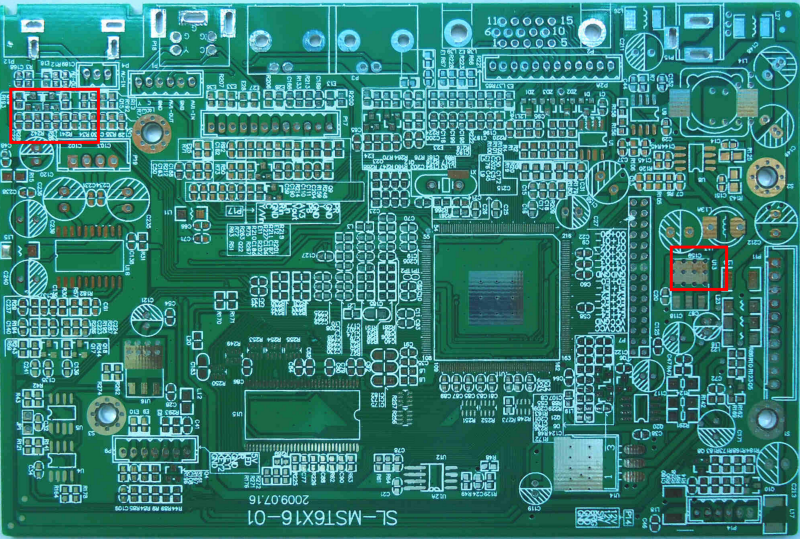
Con un modello di classificazione, generi caratteristiche dell’immagine (con metodi tradizionali o di deep learning) sull’immagine intera. Queste caratteristiche sono aggregati dell’immagine. Con il rilevamento oggetti, lo fai a un livello più fine e regionale dell’immagine. Nel primo caso potresti perdere il segnale utile alla classificazione, mentre nel secondo il segnale può essere preservato in modo più adatto al caso d’uso.
Per addestrare un modello personalizzato servono dati etichettati. Nel contesto del rilevamento oggetti, sono immagini con le corrispondenti coordinate dei bounding box e le etichette. Ovvero le coordinate (x,y) dell’angolo in basso a sinistra e in alto a destra + la classe.
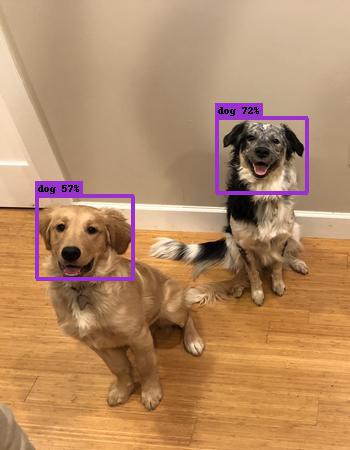
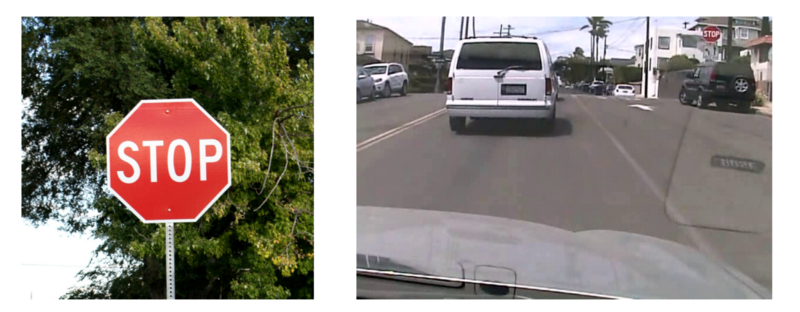
La domanda che viene posta sempre è: per fare rilevamento oggetti sul problema X, di quante immagini ho bisogno? È più importante capire bene in quali scenari verrà distribuito il modello. È fondamentale avere un gran numero (ad esempio, > 100 e potenzialmente >1000) di immagini rappresentative per classe. Rappresentative significa che devono corrispondere alla gamma di scenari in cui il modello verrà usato. Se stai costruendo un modello per il rilevamento di segnali stradali da far girare in auto, devi usare immagini scattate in diverse condizioni meteo, di luce e di fotocamera, nel loro contesto appropriato. I modelli di rilevamento non sono magici, anzi piuttosto “ottusi”. Se il modello non ha abbastanza dati per apprendere schemi generali, non andrà bene in produzione.
Tipicamente, un framework di rilevamento oggetti prevede tre passaggi.
Esistono diversi approcci per generare proposte di regione. In origine, l’algoritmo ‘selective search’ veniva usato per generare proposte di oggetti. Lillie Weng fornisce una spiegazione approfondita di questo algoritmo nel suo blog post. In breve, la selective search è un approccio basato sul clustering che cerca di raggruppare i pixel e generare proposte a partire dai cluster formati.
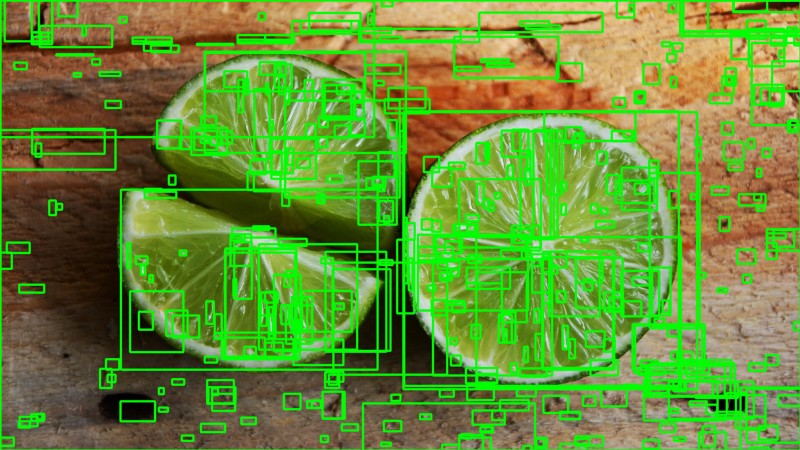
Altri approcci usano caratteristiche visive più complesse estratte dall’immagine per generare le regioni (ad esempio, basandosi sulle feature di un modello di deep learning) o adottano un approccio brute-force. Questi approcci brute-force sono simili a una finestra scorrevole applicata all’immagine, su diversi rapporti e scale. Queste regioni sono generate automaticamente, senza considerare le caratteristiche dell’immagine.
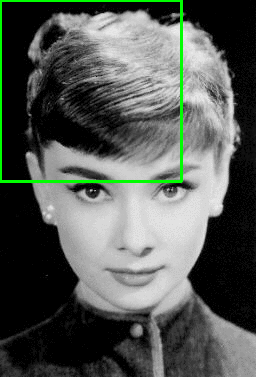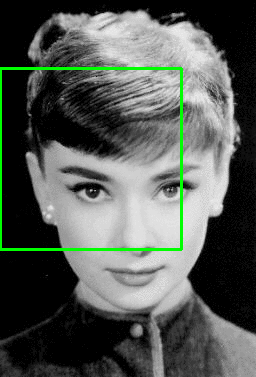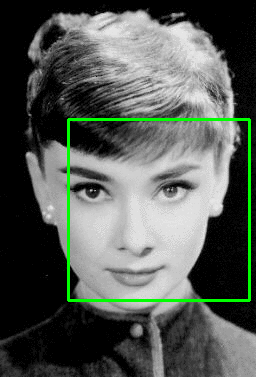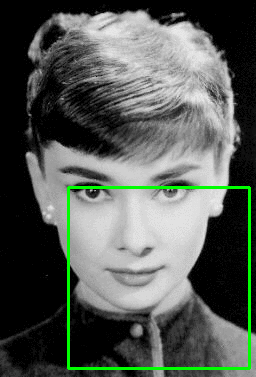
Un importante compromesso nella generazione delle proposte è tra il numero di regioni e la complessità computazionale. Più regioni generi, più è probabile trovare l’oggetto. D’altra parte, se generi esaustivamente tutte le possibili proposte, ad esempio, non riuscirai a far girare il rilevatore in tempo reale. In alcuni casi è possibile usare informazioni specifiche del problema per ridurre il numero di ROI. Ad esempio, i pedoni hanno in genere un rapporto di circa 1,5, quindi non ha senso generare ROI con un rapporto di 0,25.
L’obiettivo dell’estrazione delle feature è ridurre un’immagine a dimensioni variabili a un insieme fisso di caratteristiche visive. I modelli di classificazione sono in genere costruiti usando forti metodi di estrazione di feature. Che si basino su approcci tradizionali di computer vision, come metodi a filtri, istogrammi, ecc., o su metodi di deep learning, hanno tutti lo stesso obiettivo: estrarre dall’immagine in input caratteristiche rappresentative per il compito e usare tali feature per determinare la classe dell’immagine. Nei framework di rilevamento, si usano spesso modelli di classificazione preaddestrati per estrarre feature visive, poiché tendono a generalizzare piuttosto bene. Ad esempio, un modello addestrato sul dataset MS COCO è in grado di estrarre feature piuttosto generiche. Per migliorare il modello, però, è consigliabile sperimentare approcci diversi. Il mio post sul transfer learning offre una chiara distinzione tra i diversi tipi di transfer learning, con relativi pro e contro.
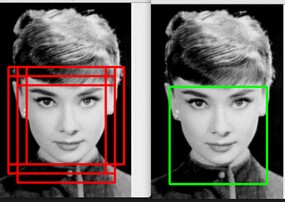
L’idea generale della non-maximum suppression è ridurre il numero di rilevamenti in un frame al numero effettivo di oggetti presenti. Se l’oggetto nel frame è piuttosto grande e sono state generate più di 2000 proposte, è probabile che alcune di queste si sovrappongano molto tra loro e con l’oggetto. Guarda questo video su Coursera per saperne di più sulla NMS. Le tecniche NMS sono in genere standard tra i vari framework di rilevamento, ma è un passaggio importante che può richiedere la messa a punto di iperparametri a seconda dello scenario.
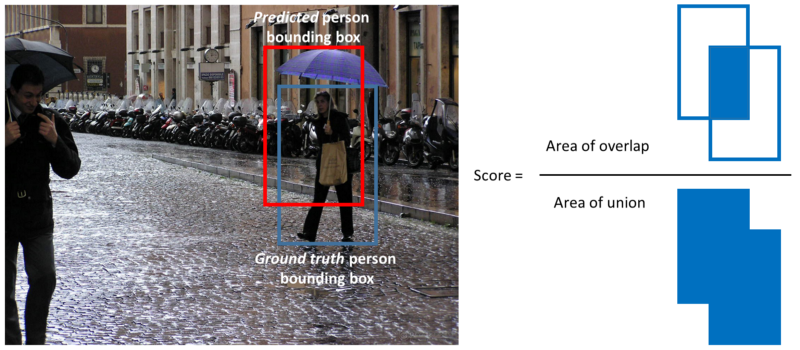
La metrica di valutazione più comune usata nei compiti di riconoscimento di oggetti è la ‘mAP’, che sta per ‘mean average precision’. È un numero da 0 a 100 e valori più alti sono in genere migliori, ma è diverso dalla metrica di accuratezza nella classificazione.
Ogni bounding box ha un punteggio associato (probabilità che il box contenga un oggetto). In base alle previsioni, si calcola una curva precision-recall (curva PR) per ogni classe variando la soglia sul punteggio. L’average precision (AP) è l’area sotto la curva PR. Prima si calcola l’AP per ogni classe, poi si fa la media tra le classi. Il risultato finale è la mAP.
Nota che un rilevamento è un vero positivo se ha un ‘intersection over union’ (IoU o overlap) con il box di verità a terra superiore a una certa soglia (di solito 0,5). Invece di usare mAP, in genere si usa mAP@0.5 o mAP@0.25 per riferirsi all’IoU utilizzato.
La TensorFlow Detection API riunisce molte delle idee sopra in un unico pacchetto, permettendoti di iterare rapidamente tra diverse configurazioni usando il backend di TensorFlow. Con l’API, definisci il modello di rilevamento tramite file di configurazione, e la TensorFlow Detection API si occupa di mettere insieme tutti gli elementi necessari.
Per capire meglio quali sono i diversi componenti supportati, dai un’occhiata alla ‘cartella protos’ che contiene le definizioni delle funzioni. In particolare, i protos train, eval, ssd, faster_rcnn e preprocessing sono importanti quando si effettua il fine-tuning di un modello.
L’architettura SSD è stata pubblicata nel 2016 da ricercatori di Google. Presenta un modello di rilevamento oggetti con una singola rete neurale profonda che combina proposte di regione ed estrazione di feature.
Si usa un set di box di default su diversi rapporti d’aspetto e scale, applicati alle feature map. Poiché queste feature map si ottengono facendo passare un’immagine attraverso una rete di classificazione, l’estrazione delle feature per i bounding box può essere eseguita in un solo passaggio. Per ogni box di default si generano punteggi per ogni categoria di oggetto. Per adattarsi meglio ai box di verità a terra si calcolano offset di aggiustamento per ciascun box.
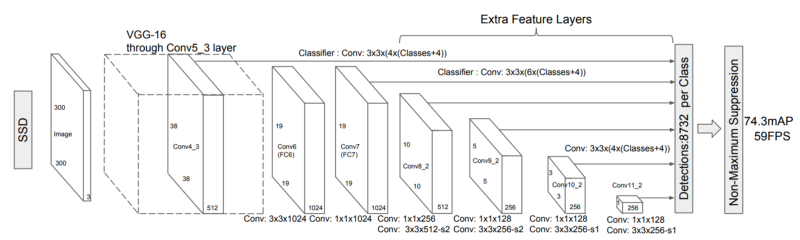
Diverse feature map nella rete convoluzionale corrispondono a diversi campi ricettivi e vengono usate per gestire in modo naturale oggetti a scale differenti. Poiché tutto il calcolo è incapsulato in un’unica rete, si ottengono velocità computazionali piuttosto elevate (ad esempio, per input 300 × 300 si raggiungono 59 FPS).
Per l’utilizzo esamineremo i diversi file di configurazione di esempio per SSD. Diversi parametri sono importanti quando si sfrutta l’architettura SSD e li vedremo uno per uno.
Innanzitutto, le diverse reti di classificazione hanno punti di forza e debolezze differenti (vedi questo post per una panoramica). Ad esempio, la rete Inceptionv3 è addestrata per rilevare bene oggetti a scale diverse, mentre l’architettura ResNet raggiunge un’accuratezza complessiva molto alta. Mobilenet, invece, è una rete addestrata per ridurre al minimo le risorse computazionali richieste. Le prestazioni della rete di estrazione feature su ImageNet, il numero di parametri e il dataset originale su cui è stata addestrata sono un buon proxy per il compromesso prestazioni/velocità. L’estrattore di feature è definito nella sezione ‘feature_extractor’.
Un secondo insieme di parametri riguarda le impostazioni dei box di default e dei rapporti d’aspetto. A seconda del tipo di problema, vale la pena analizzare i vari rapporti d’aspetto e scale dei bounding box nei dati etichettati. Impostare rapporti e scale farà sì che la rete non esegua calcoli inutili. Puoi regolarli nella sezione ‘ssd_anchor_generator’. Nota che aggiungere più scale e rapporti d’aspetto porterà a prestazioni migliori, ma in genere con rendimenti decrescenti.
In terzo luogo, durante l’addestramento è importante impostare la dimensione dell’immagine e le opzioni di data augmentation nelle sezioni ‘data_augmentation_options’ e ‘image_resizer’. Un’immagine più grande rende meglio perché gli oggetti piccoli sono spesso difficili da rilevare, ma ha un costo computazionale significativo. La data augmentation è particolarmente importante nel contesto di SSD per riuscire a rilevare oggetti a scale diverse (anche scale che potrebbero non essere presenti nei dati di training).
Infine, regolare la sezione ‘train_config’, impostando tassi di apprendimento e dimensioni dei batch, è importante per ridurre l’overfitting e dipenderà molto dalla dimensione del tuo dataset.
Faster R-CNN è stato sviluppato da ricercatori di Microsoft. Si basa su R-CNN, che usava un approccio multipasso al rilevamento. R-CNN usava la Selective search per determinare proposte di regione, le faceva passare attraverso una rete di classificazione e poi usava una SVM per classificare le diverse regioni.
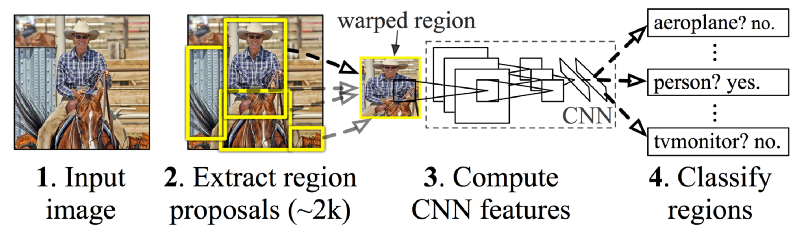
Faster R-CNN, simile a SSD, è un approccio end-to-end. Invece di usare bounding box di default, Faster R-CNN ha una Region Proposal Network (RPN) per generare un set fisso di regioni. La RPN usa le feature convoluzionali della rete di classificazione, abilitando proposte di regione quasi a costo zero. La RPN è implementata come una rete completamente convoluzionale che predice i limiti degli oggetti e i punteggi di oggettualità in ogni posizione.
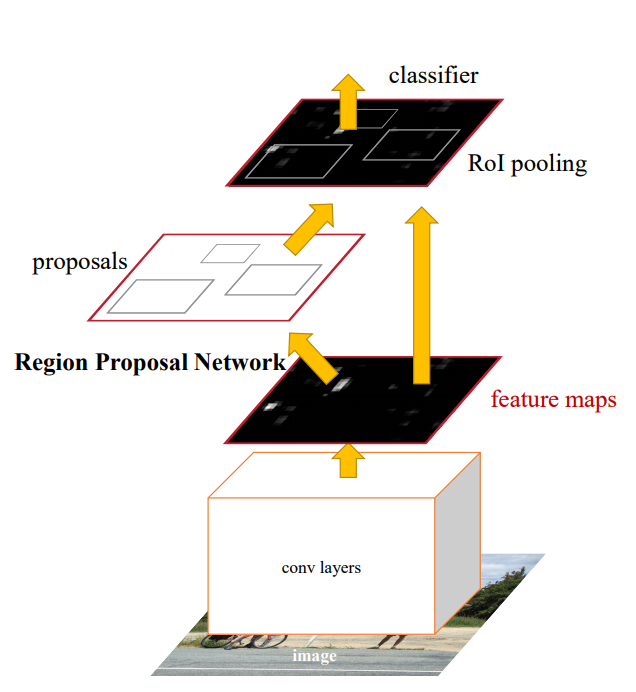
Nota che la RPN ha un impianto simile alla rete SSD (cioè non predice bounding box dal nulla). La RPN lavora con finestre scorrevoli sulle feature map. In ogni posizione della finestra scorrevole, o anchor, si calcola un insieme di proposte con varie scale e rapporti d’aspetto. Come in SSD, l’output della RPN sono bounding box ‘aggiustati’ in base agli anchor.
I diversi componenti sono combinati in un unico assetto e vengono addestrati end-to-end o in più fasi (per migliorare la stabilità). Un’altra interpretazione della RPN è che guida l’‘attenzione’ della rete verso regioni interessanti.
Gran parte dei dettagli d’uso di Faster R-CNN sono simili a quelli di SSD. In termini di mAP grezza, Faster R-CNN in genere supera SSD, ma richiede molta più potenza computazionale.
Una sezione importante per il rilevatore Fast-RCNN è ‘first_stage_anchor_generator’, che definisce gli anchor generati dalla RPN. Gli stride in questa sezione definiscono i passi della finestra scorrevole. Nota in particolare che, quando tenti di rilevare oggetti piccoli, se lo stride è troppo grande potresti perderli.
Esistono molte altre architetture per il rilevamento oggetti che non ho trattato. In particolare, per le applicazioni in tempo reale, Yolov2 è spesso citata come architettura importante (abbastanza simile a SSD). Aggiornerò questo post quando verrà aggiunta alla TensorFlow Detection API.
Se hai domande, sarò felice di leggerle nei commenti. Seguimi su Medium o Twitter se vuoi ricevere aggiornamenti sui miei post!
Scopri di più sul Machine Learning
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



