
Last chance! 50% off DataCamp Premium
Sale ends in
डीप लर्निंग आधारित कंप्यूटर विज़न मॉडलों में हालिया प्रगति के साथ, ऑब्जेक्ट डिटेक्शन अनुप्रयोग पहले से कहीं अधिक आसानी से विकसित किए जा सकते हैं। उल्लेखनीय प्रदर्शन सुधारों के अलावा, इन तकनीकों ने बड़े पैमाने पर इमेज डेटासेट्स का लाभ उठाकर बड़े डेटासेट की आवश्यकता को भी कम किया है। साथ ही, वर्तमान दृष्टिकोण जो पूर्ण एंड-टू-एंड पाइपलाइनों पर केंद्रित हैं, उनके कारण प्रदर्शन में काफी सुधार हुआ है, जिससे रीयल-टाइम उपयोग के मामले संभव हुए हैं।
जिस तरह मैंने विभिन्न इमेज क्लासिफिकेशन आर्किटेक्चर पर एक ब्लॉगपोस्ट लिखा था, उसी तरह मैं दो ऑब्जेक्ट डिटेक्शन आर्किटेक्चर पर जाऊंगा। मैं SSD और Faster RCNN पर चर्चा करूंगा, जो वर्तमान में Tensorflow Detection API में उपलब्ध हैं।
सबसे पहले मैं ऑब्जेक्ट डिटेक्शन की कुछ मुख्य अवधारणाओं पर जाऊंगा, और फिर बताऊंगा कि इन्हें SSD और Faster RCNN में कैसे लागू किया जाता है।
लोग अक्सर इमेज क्लासिफिकेशन और ऑब्जेक्ट डिटेक्शन परिदृश्यों को लेकर भ्रमित हो जाते हैं। सामान्यतः, यदि आप किसी इमेज को किसी श्रेणी में वर्गीकृत करना चाहते हैं, तो आप इमेज क्लासिफिकेशन का उपयोग करते हैं। दूसरी ओर, यदि आपका उद्देश्य इमेज में वस्तुओं के स्थान की पहचान करना है, और उदाहरण के लिए किसी वस्तु के इंस्टैंसेज़ की संख्या गिनना है, तो आप ऑब्जेक्ट डिटेक्शन का उपयोग कर सकते हैं।
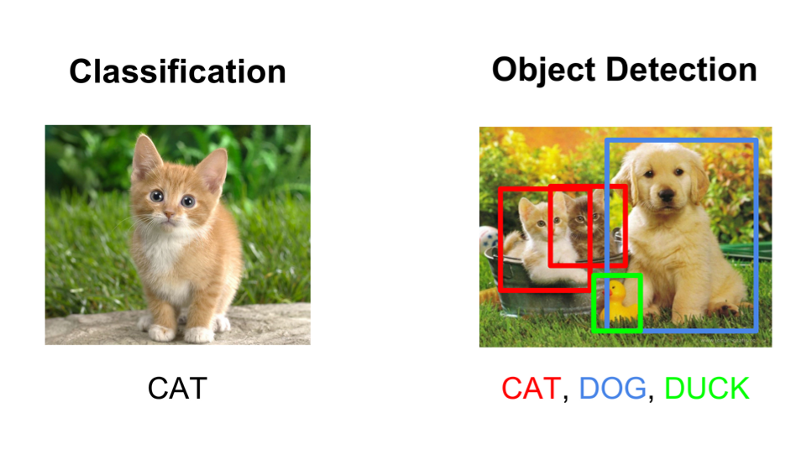
हालाँकि, इन दोनों परिदृश्यों में कुछ ओवरलैप भी है। यदि आप किसी इमेज को किसी श्रेणी में वर्गीकृत करना चाहते हैं, तो ऐसा हो सकता है कि ऑब्जेक्ट या वे विशेषताएँ जो श्रेणीकरण के लिए आवश्यक हैं, पूर्ण इमेज की तुलना में बहुत छोटी हों। ऐसी स्थिति में, भले ही आपको वस्तु के सटीक स्थान या संख्या में रुचि न हो, ऑब्जेक्ट डिटेक्शन इमेज क्लासिफिकेशन की तुलना में बेहतर प्रदर्शन दे सकता है।
कल्पना कीजिए कि आपको सर्किट बोर्ड की जाँच करनी है और उन्हें दोषपूर्ण या सही के रूप में वर्गीकृत करना है। जबकि यह मूलतः क्लासिफिकेशन समस्या है, दोष इतने छोटे हो सकते हैं कि इमेज क्लासिफिकेशन मॉडल से वे दिखाई न दें। ऑब्जेक्ट डिटेक्शन डेटासेट बनाना अधिक समय लेगा, फिर भी संभवतः यह बेहतर मॉडल देगा।
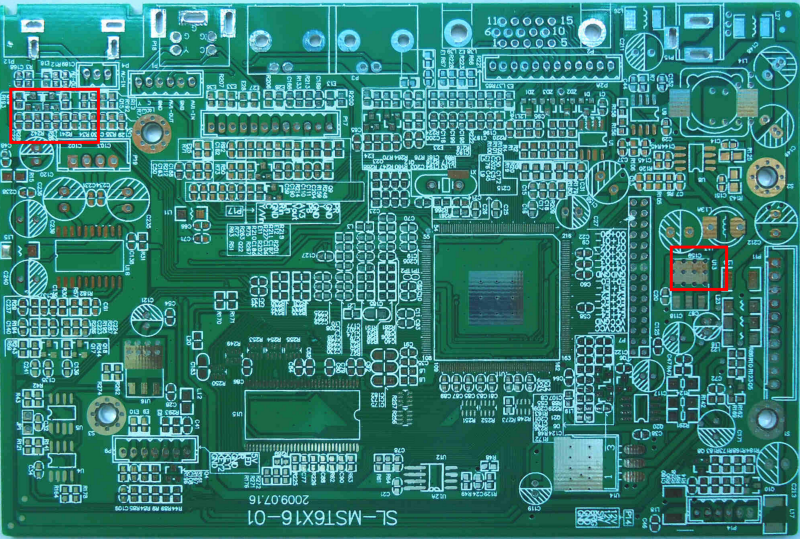
इमेज क्लासिफिकेशन मॉडल के साथ, आप पूर्ण इमेज के इमेज फीचर्स (पारंपरिक या डीप लर्निंग तरीकों से) जनरेट करते हैं। ये फीचर्स इमेज के संकलन होते हैं। ऑब्जेक्ट डिटेक्शन में, आप यह कार्य इमेज के अधिक सूक्ष्म, दानेदार, क्षेत्रीय स्तर पर करते हैं। पहले मामले में आप क्लासिफिकेशन संकेत खो सकते हैं, जबकि दूसरे में यह संकेत उस रूप में संरक्षित हो सकता है जो उपयोग के मामले के लिए अधिक उपयुक्त है।
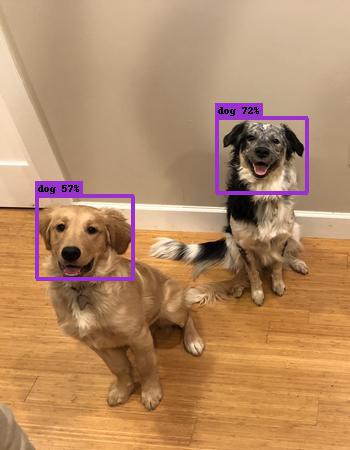
कस्टम मॉडल को प्रशिक्षित करने के लिए, आपको लेबल किया हुआ डेटा चाहिए। ऑब्जेक्ट डिटेक्शन के संदर्भ में लेबल्ड डेटा वे इमेज हैं जिनके साथ बॉन्डिंग बॉक्स निर्देशांक और लेबल होते हैं। अर्थात, नीचे-बाएँ और ऊपर-दाएँ (x,y) निर्देशांक + क्लास।
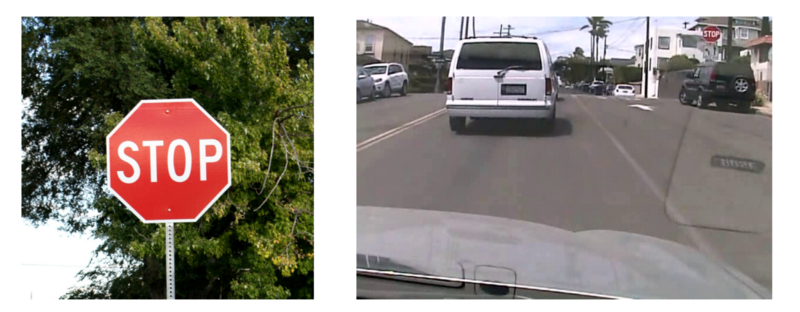
एक प्रश्न जो हमेशा पूछा जाता है, वह यह है: समस्या X पर ऑब्जेक्ट डिटेक्शन करने के लिए मुझे कितनी तस्वीरों की आवश्यकता है? इसके बजाय, यह समझना अधिक महत्वपूर्ण है कि मॉडल किन परिदृश्यों में तैनात किया जाएगा। यह अत्यावश्यक है कि प्रति क्लास बड़ी संख्या (उदाहरण के लिए, > 100 और संभावित रूप से >1000) की प्रतिनिधि इमेज उपलब्ध हों। यहाँ प्रतिनिधि का अर्थ है कि वे उन परिदृश्यों की रेंज के अनुरूप हों जिनमें मॉडल का उपयोग किया जाएगा। यदि आप एक ट्रैफिक साइन डिटेक्शन मॉडल बना रहे हैं जो कार में चलेगा, तो आपको अलग-अलग मौसम, प्रकाश और कैमरा स्थितियों में, उनके उपयुक्त संदर्भ में ली गई इमेज का उपयोग करना होगा। ऑब्जेक्ट डिटेक्शन मॉडल जादुई नहीं होते, बल्कि काफ़ी सरल होते हैं। यदि मॉडल के पास सामान्य पैटर्न सीखने के लिए पर्याप्त डेटा नहीं है, तो वह प्रोडक्शन में अच्छा प्रदर्शन नहीं करेगा।
आम तौर पर, ऑब्जेक्ट डिटेक्शन फ्रेमवर्क में तीन चरण होते हैं।
रीजन प्रपोज़ल्स जनरेट करने के लिए कई अलग-अलग दृष्टिकोण मौजूद हैं। मूल रूप से, ‘सेलेक्टिव सर्च’ एल्गोरिद्म का उपयोग ऑब्जेक्ट प्रपोज़ल्स जनरेट करने के लिए किया जाता था। Lillie Weng ने अपने ब्लॉग पोस्ट में इस एल्गोरिद्म की विस्तृत व्याख्या दी है। संक्षेप में, सेलेक्टिव सर्च एक क्लस्टरिंग-आधारित दृष्टिकोण है जो पिक्सल्स को समूहित करने और बने हुए क्लस्टर्स के आधार पर प्रपोज़ल्स जनरेट करने का प्रयास करता है।
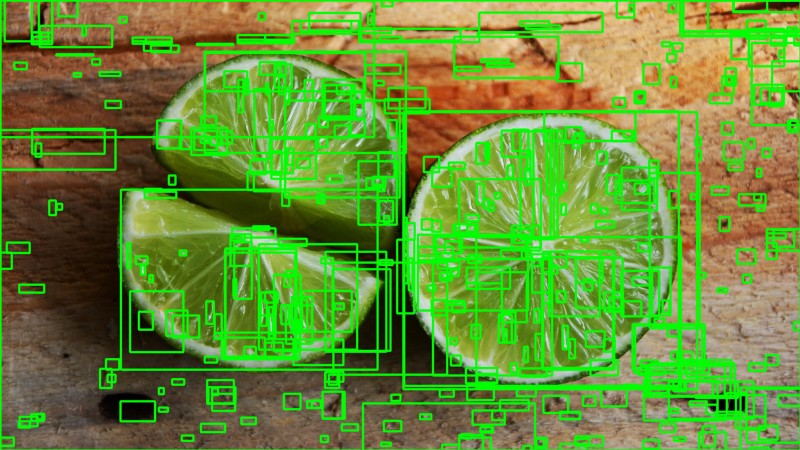
अन्य दृष्टिकोण इमेज से निकाले गए अधिक जटिल विज़ुअल फीचर्स का उपयोग करके रीजन जनरेट करते हैं (उदाहरण के लिए, डीप लर्निंग मॉडल के फीचर्स के आधार पर) या रीजन जनरेशन के लिए ब्रूट-फोर्स दृष्टिकोण अपनाते हैं। ये ब्रूट-फोर्स दृष्टिकोण स्लाइडिंग विंडो के समान होते हैं जो इमेज पर विभिन्न अनुपातों और स्केल्स पर लागू होती है। ये रीजन स्वतः जनरेट होते हैं, इमेज फीचर्स को ध्यान में लिए बिना।
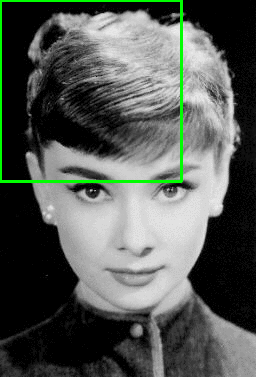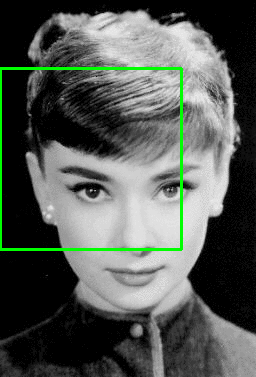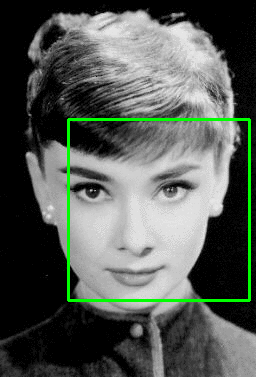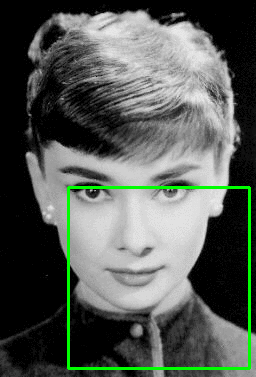
रीजन प्रपोज़ल जनरेशन में एक महत्वपूर्ण संतुलन रीजन की संख्या और कम्प्यूटेशनल जटिलता के बीच होता है। जितने अधिक रीजन आप जनरेट करेंगे, वस्तु को ढूँढने की संभावना उतनी ही अधिक होगी। दूसरी ओर, यदि आप सभी संभावित प्रपोज़ल्स को थकाऊ ढंग से जनरेट करते हैं, तो उदाहरण के लिए, ऑब्जेक्ट डिटेक्टर को रीयल-टाइम में चलाना संभव नहीं होगा। कुछ मामलों में, समस्या-विशिष्ट जानकारी का उपयोग करके ROI की संख्या को कम करना संभव है। उदाहरण के लिए, पैदल चलने वालों का अनुपात आमतौर पर लगभग 1.5 होता है, इसलिए 0.25 अनुपात वाले ROI जनरेट करना उपयोगी नहीं है।
फ़ीचर एक्सट्रैक्शन का लक्ष्य एक परिवर्तनशील आकार की इमेज को विज़ुअल फीचर्स के एक निश्चित सेट में घटाना है। इमेज क्लासिफिकेशन मॉडल आमतौर पर मजबूत विज़ुअल फ़ीचर एक्सट्रैक्शन तरीकों का उपयोग करके बनाए जाते हैं। चाहे वे पारंपरिक कंप्यूटर विज़न तरीकों, जैसे फ़िल्टर-आधारित तरीकों, हिस्टोग्राम तरीकों आदि पर आधारित हों, या डीप लर्निंग तरीकों पर, सभी का उद्देश्य समान है: इनपुट इमेज से ऐसे फीचर्स निकालना जो मौजूदा कार्य के लिए प्रतिनिधि हों और इन फीचर्स का उपयोग करके इमेज की क्लास निर्धारित करना। ऑब्जेक्ट डिटेक्शन फ्रेमवर्क में, लोग आमतौर पर विज़ुअल फीचर्स निकालने के लिए प्रीट्रेन्ड इमेज क्लासिफिकेशन मॉडलों का उपयोग करते हैं, क्योंकि ये काफ़ी अच्छी तरह सामान्यीकरण करते हैं। उदाहरण के लिए, MS CoCo डेटासेट पर प्रशिक्षित एक मॉडल काफ़ी सामान्य फीचर्स निकालने में सक्षम होता है। हालाँकि, मॉडल को बेहतर बनाने के लिए विभिन्न दृष्टिकोणों के साथ प्रयोग करने की सलाह दी जाती है। ट्रांसफर लर्निंग पर मेरे ब्लॉग पोस्ट में ट्रांसफर लर्निंग के विभिन्न प्रकारों के साथ-साथ उनके फायदे और नुकसान स्पष्ट रूप से बताए गए हैं।
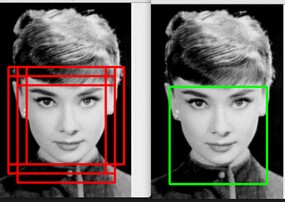
नॉन-मैक्सिमम सप्रेशन का सामान्य विचार किसी फ़्रेम में डिटेक्शनों की संख्या को वास्तविक वस्तुओं की संख्या तक घटाना है। यदि फ़्रेम में वस्तु काफ़ी बड़ी है और 2000 से अधिक ऑब्जेक्ट प्रपोज़ल्स जनरेट किए गए हैं, तो यह काफ़ी संभव है कि इनमें से कुछ का एक-दूसरे के साथ और वस्तु के साथ पर्याप्त ओवरलैप होगा। NMS के बारे में अधिक जानने के लिए Coursera पर यह वीडियो देखें। NMS तकनीकें आमतौर पर विभिन्न डिटेक्शन फ्रेमवर्क्स में मानक होती हैं, लेकिन यह एक महत्वपूर्ण चरण है जिसमें परिदृश्य के आधार पर हाइपरपैरामीटर ट्यूनिंग की आवश्यकता हो सकती है।
ऑब्जेक्ट रिकग्निशन कार्यों में सबसे आम मूल्यांकन मीट्रिक ‘mAP’ है, जिसका अर्थ है ‘मीन एवरेज प्रिसिशन’। यह 0 से 100 तक की संख्या होती है और उच्च मान आमतौर पर बेहतर होते हैं, लेकिन इसका मान क्लासिफिकेशन में एक्यूरसी मीट्रिक से अलग होता है।
प्रत्येक बॉन्डिंग बॉक्स के साथ एक स्कोर जुड़ा होता है (बॉक्स में ऑब्जेक्ट होने की संभावना)। प्रेडिक्शन्स के आधार पर स्कोर थ्रेशोल्ड को बदलते हुए प्रत्येक क्लास के लिए एक प्रिसिशन-रिकॉल कर्व (PR कर्व) निकाला जाता है। एवरेज प्रिसिशन (AP) PR कर्व के नीचे का क्षेत्रफल है। पहले प्रत्येक क्लास के लिए AP निकाला जाता है, और फिर विभिन्न क्लासों पर औसत लिया जाता है। अंतिम परिणाम mAP होता है।
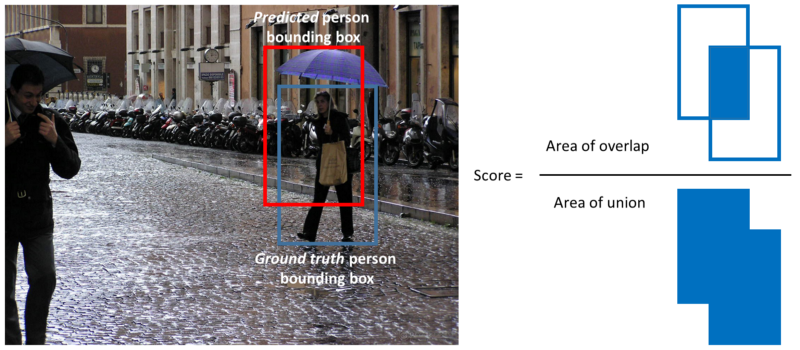
ध्यान दें कि कोई डिटेक्शन तभी ट्रू पॉज़िटिव होता है जब उसके और ग्राउंड-ट्रुथ बॉक्स के बीच ‘इंटरसेक्शन ओवर यूनियन’ (IoU या ओवरलैप) किसी थ्रेशोल्ड (आमतौर पर 0.5) से अधिक हो। mAP के बजाय हम आमतौर पर mAP@0.5 या mAP@0.25 का उपयोग करते हैं ताकि प्रयुक्त IoU को संदर्भित किया जा सके।
Tensorflow Detection API उपर्युक्त कई विचारों को एक ही पैकेज में समेटता है, जिससे आप Tensorflow बैकएंड का उपयोग करके अलग-अलग कॉन्फ़िगरेशन पर तेजी से इटरेट कर सकते हैं। इस API के साथ, आप कॉन्फ़िगरेशन फ़ाइलों का उपयोग करके ऑब्जेक्ट डिटेक्शन मॉडल परिभाषित करते हैं, और Tensorflow Detection API सभी आवश्यक तत्वों को एक साथ संरचित करने के लिए ज़िम्मेदार होता है।
यह बेहतर समझने के लिए कि कौन-कौन से घटक समर्थित हैं, ‘protos folder’ देखें जिसमें फ़ंक्शन डेफिनिशन हैं। विशेष रूप से, train, eval, ssd, faster_rcnn और preprocessing प्रोटोस किसी मॉडल को फाइन-ट्यून करते समय महत्वपूर्ण होते हैं।
SSD आर्किटेक्चर 2016 में Google के शोधकर्ताओं द्वारा प्रकाशित किया गया था। यह एक सिंगल डीप न्यूरल नेटवर्क का उपयोग करते हुए रीजनल प्रपोज़ल्स और फ़ीचर एक्सट्रैक्शन को संयोजित करके ऑब्जेक्ट डिटेक्शन मॉडल प्रस्तुत करता है।
विभिन्न आस्पेक्ट रेशियो और स्केल्स पर डिफ़ॉल्ट बॉक्स का एक सेट उपयोग किया जाता है और इन्हें फीचर मैप्स पर लागू किया जाता है। चूँकि ये फीचर मैप्स इमेज को इमेज क्लासिफिकेशन नेटवर्क से पास करके प्राप्त किए जाते हैं, इसलिए बॉन्डिंग बॉक्स के लिए फ़ीचर एक्सट्रैक्शन एक ही चरण में किया जा सकता है। प्रत्येक डिफ़ॉल्ट बॉन्डिंग बॉक्स में प्रत्येक ऑब्जेक्ट श्रेणी के लिए स्कोर जनरेट किए जाते हैं। ग्राउंड ट्रुथ बॉक्स के साथ बेहतर मेल बैठाने के लिए प्रत्येक बॉक्स के लिए एडजस्टमेंट ऑफ़सेट्स की गणना की जाती है।
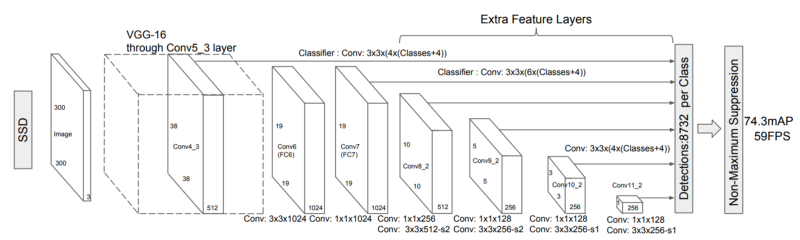
कन्वोल्यूशनल नेटवर्क में अलग-अलग फीचर मैप्स अलग-अलग रिसेप्टिव फ़ील्ड्स से मेल खाते हैं और विभिन्न स्केल्स पर ऑब्जेक्ट्स को स्वाभाविक रूप से संभालने के लिए उपयोग किए जाते हैं। चूँकि सारी गणना एक ही नेटवर्क में निहित है, इसलिए काफ़ी उच्च कम्प्यूटेशनल स्पीड प्राप्त होती है (उदाहरण के लिए, 300 × 300 इनपुट के लिए 59 FPS)।
उपयोग के लिए हम SSD के विभिन्न सैंपल कॉन्फ़िगरेशन फ़ाइलों की जाँच करेंगे। SSD आर्किटेक्चर का लाभ उठाते समय कई पैरामीटर्स महत्वपूर्ण होते हैं और हम उन्हें एक-एक करके देखेंगे।
पहले, विभिन्न क्लासिफिकेशन नेटवर्क की अलग-अलग ताकतें और कमजोरियाँ होती हैं (एक अवलोकन के लिए यह ब्लॉग पोस्ट देखें)। उदाहरण के लिए Inceptionv3 नेटवर्क को विभिन्न स्केल्स पर ऑब्जेक्ट्स को अच्छी तरह पहचानने के लिए प्रशिक्षित किया गया है, जबकि ResNet आर्किटेक्चर समग्र रूप से बहुत उच्च एक्यूरसी प्राप्त करता है। दूसरी ओर, Mobilenet एक ऐसा नेटवर्क है जिसे आवश्यक कम्प्यूटेशनल संसाधनों को न्यूनतम करने के लिए प्रशिक्षित किया गया है। ImageNet पर फीचर एक्सट्रैक्शन नेटवर्क का प्रदर्शन, पैरामीटर्स की संख्या और वह मूल डेटासेट जिस पर इसे प्रशिक्षित किया गया था, प्रदर्शन/गति संतुलन के अच्छे संकेतक हैं। फीचर एक्सट्रैक्टर ‘feature_extractor’ सेक्शन में परिभाषित किया जाता है।
दूसरा स्पष्ट पैरामीटर्स सेट डिफ़ॉल्ट बॉक्स और आस्पेक्ट रेशियो की सेटिंग्स हैं। समस्या के प्रकार के आधार पर, लेबल्ड डेटा के बॉन्डिंग बॉक्स के विभिन्न आस्पेक्ट रेशियो और स्केल्स का विश्लेषण करना उपयोगी है। आस्पेक्ट रेशियो और स्केल्स सेट करने से यह सुनिश्चित होगा कि नेटवर्क अनावश्यक गणनाएँ न करे। आप इन्हें ‘ssd_anchor_generator’ सेक्शन में बदल सकते हैं। ध्यान दें कि अधिक स्केल्स और आस्पेक्ट रेशियो जोड़ने से प्रदर्शन बेहतर होगा, लेकिन आमतौर पर घटते लाभ के साथ।
तीसरे, मॉडल को प्रशिक्षित करते समय ‘data_augmentation_options’ और ‘image_resizer’ सेक्शनों में इमेज साइज़ और डेटा ऑग्मेंटेशन विकल्प सेट करना महत्वपूर्ण है। बड़ा इमेज साइज़ बेहतर प्रदर्शन करेगा क्योंकि छोटे ऑब्जेक्ट्स को अक्सर पहचानना कठिन होता है, लेकिन इसकी कम्प्यूटेशनल लागत काफ़ी होगी। डेटा ऑग्मेंटेशन विशेष रूप से SSD के संदर्भ में महत्वपूर्ण है ताकि विभिन्न स्केल्स पर ऑब्जेक्ट्स को पहचानने में सक्षम हो सकें (यहाँ तक कि उन स्केल्स पर भी जो प्रशिक्षण डेटा में मौजूद नहीं हो सकते)।
अंत में, ‘train_config’ को ट्यून करना, लर्निंग रेट्स और बैच साइज़ सेट करना ओवरफिटिंग को कम करने के लिए महत्वपूर्ण है, और यह काफी हद तक आपके डेटासेट के आकार पर निर्भर करेगा।
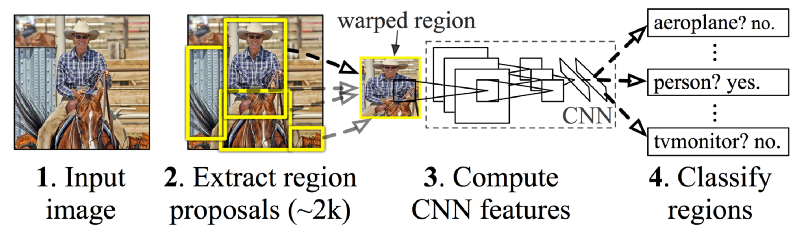
Faster R-CNN Microsoft के शोधकर्ताओं द्वारा विकसित किया गया था। यह R-CNN पर आधारित है, जिसने ऑब्जेक्ट डिटेक्शन के लिए बहु-चरणीय दृष्टिकोण अपनाया था। R-CNN ने रीजन प्रपोज़ल्स निर्धारित करने के लिए Selective search का उपयोग किया, इन्हें क्लासिफिकेशन नेटवर्क से गुजारा और फिर विभिन्न क्षेत्रों को वर्गीकृत करने के लिए SVM का उपयोग किया।
Faster R-CNN, SSD के समान, एंड-टू-एंड दृष्टिकोण है। डिफ़ॉल्ट बॉन्डिंग बॉक्स का उपयोग करने के बजाय, Faster R-CNN में एक रीजन प्रपोज़ल नेटवर्क (RPN) होता है जो निश्चित संख्या में रीजन जनरेट करता है। RPN इमेज क्लासिफिकेशन नेटवर्क से कन्वोल्यूशनल फीचर्स का उपयोग करता है, जिससे लगभग मुफ्त में रीजन प्रपोज़ल्स मिलते हैं। RPN को एक पूर्णतः कन्वोल्यूशनल नेटवर्क के रूप में लागू किया गया है जो प्रत्येक स्थान पर ऑब्जेक्ट की सीमाएँ और ऑब्जेक्टनेस स्कोर की भविष्यवाणी करता है।
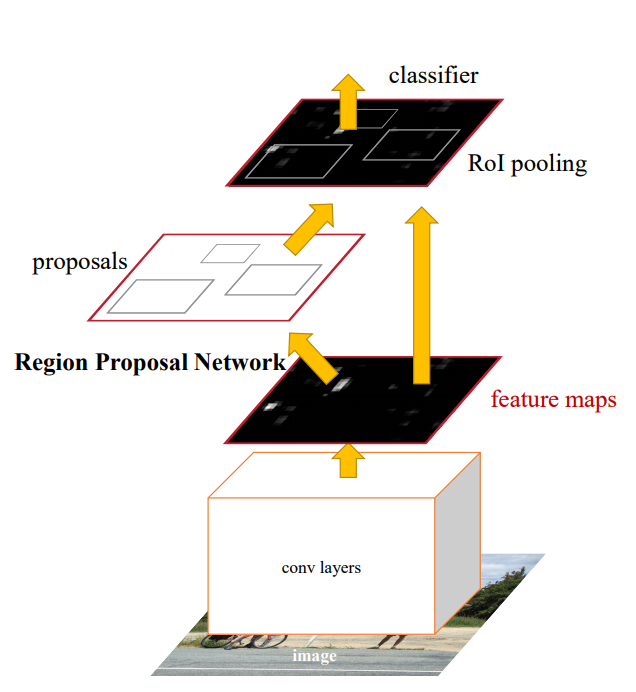
ध्यान दें कि RPN की संरचना SSD नेटवर्क के समान है (अर्थात यह हवा में से बॉन्डिंग बॉक्स की भविष्यवाणी नहीं करता)। RPN नेटवर्क फीचर मैप्स पर स्लाइडिंग विंडो के साथ काम करता है। प्रत्येक स्लाइडिंग-विंडो स्थान या एंकर पर, विभिन्न स्केल्स और आस्पेक्ट रेशियो के साथ प्रपोज़ल्स का एक सेट निकाला जाता है। SSD के समान, RPN का परिणाम एंकरों के आधार पर ‘समायोजित’ बॉन्डिंग बॉक्स होते हैं।
विभिन्न घटकों को एक ही सेटअप में संयोजित किया जाता है और या तो एंड-टू-एंड या कई चरणों में प्रशिक्षित किया जाता है (स्थिरता में सुधार हेतु)। RPN की एक अन्य व्याख्या यह है कि यह नेटवर्क का ‘अटेंशन’ रुचिकर क्षेत्रों की ओर निर्देशित करता है।
Faster R-CNN के अधिकांश उपयोग सम्बन्धी विवरण SSD के समान हैं। कच्चे mAP की दृष्टि से, Faster R-CNN आमतौर पर SSD से बेहतर प्रदर्शन करता है, लेकिन इसे काफ़ी अधिक कम्प्यूटेशनल शक्ति की आवश्यकता होती है।
Fast-RCNN डिटेक्टर के लिए एक महत्वपूर्ण सेक्शन ‘first_stage_anchor_generator’ है, जो RPN द्वारा जनरेट किए गए एंकरों को परिभाषित करता है। इस सेक्शन में स्ट्राइड्स स्लाइडिंग विंडो के स्टेप्स को परिभाषित करते हैं। विशेष रूप से छोटे ऑब्जेक्ट्स का पता लगाने का प्रयास करते समय ध्यान दें (यदि स्ट्राइड बहुत बड़ा है, तो आप उन्हें चूक सकते हैं)।
हालाँकि Faster-RCNN पेपर के लेखकों द्वारा व्यापक डेटा ऑग्मेंटेशन का उपयोग नहीं किया गया था, फिर भी छोटे डेटासेट्स के साथ काम करते समय इसका उपयोग करने की सलाह दी जाती है।
और भी कई ऑब्जेक्ट डिटेक्शन आर्किटेक्चर हैं, जिन पर मैंने चर्चा नहीं की है। विशेषकर रीयल-टाइम अनुप्रयोगों को देखते हुए, Yolov2 को अक्सर एक महत्वपूर्ण आर्किटेक्चर के रूप में लिया जाता है (SSD से काफ़ी समान)। जब भी इसे Tensorflow Detection API में जोड़ा जाएगा, मैं इस ब्लॉग पोस्ट को अपडेट करूँगा।
यदि आपके कोई प्रश्न हैं, तो मुझे कमेंट्स में पढ़कर खुशी होगी। मेरे Medium या Twitter पर फ़ॉलो करें यदि आप मेरे ब्लॉग पोस्ट के अपडेट प्राप्त करना चाहते हैं!
मशीन लर्निंग के बारे में और जानें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}