Khóa học
Tìm hiểu Machine Learning
2 giờ
311.4K
Với những tiến bộ gần đây trong các mô hình thị giác máy tính dựa trên học sâu, các ứng dụng phát hiện đối tượng trở nên dễ phát triển hơn bao giờ hết. Bên cạnh những cải thiện đáng kể về hiệu năng, các kỹ thuật này cũng tận dụng được các bộ dữ liệu ảnh khổng lồ để giảm nhu cầu về dữ liệu lớn. Ngoài ra, với các phương pháp hiện nay tập trung vào các pipeline đầu-cuối hoàn chỉnh, hiệu năng cũng được cải thiện đáng kể, cho phép các trường hợp sử dụng thời gian thực.
Tương tự như bài viết tôi đã viết về các kiến trúc phân loại ảnh khác nhau, tôi sẽ đi qua hai kiến trúc phát hiện đối tượng. Tôi sẽ thảo luận về SSD và Faster R-CNN, hiện đều có sẵn trong TensorFlow Detection API.
Đầu tiên, tôi sẽ điểm qua một số khái niệm then chốt trong phát hiện đối tượng, sau đó minh họa cách chúng được triển khai trong SSD và Faster R-CNN.
Mọi người thường nhầm lẫn giữa các kịch bản phân loại ảnh và phát hiện đối tượng. Nói chung, nếu bạn muốn phân loại một ảnh vào một danh mục nhất định, bạn dùng phân loại ảnh. Ngược lại, nếu mục tiêu của bạn là xác định vị trí của các đối tượng trong ảnh, và, ví dụ, đếm số lượng thể hiện của một đối tượng, bạn có thể dùng phát hiện đối tượng.
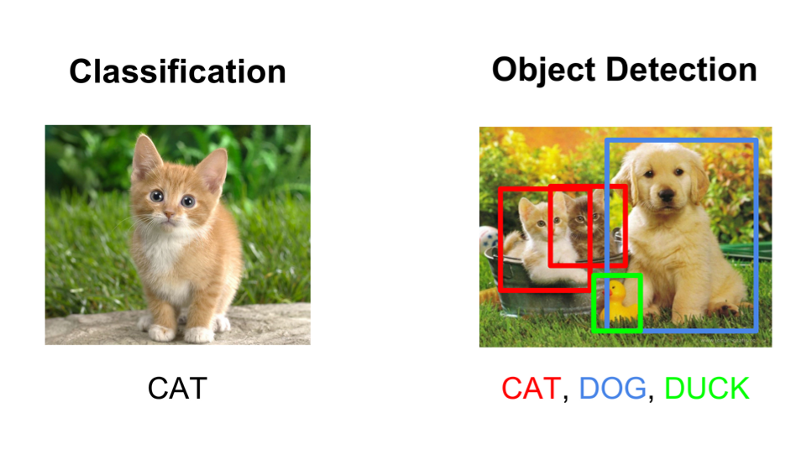
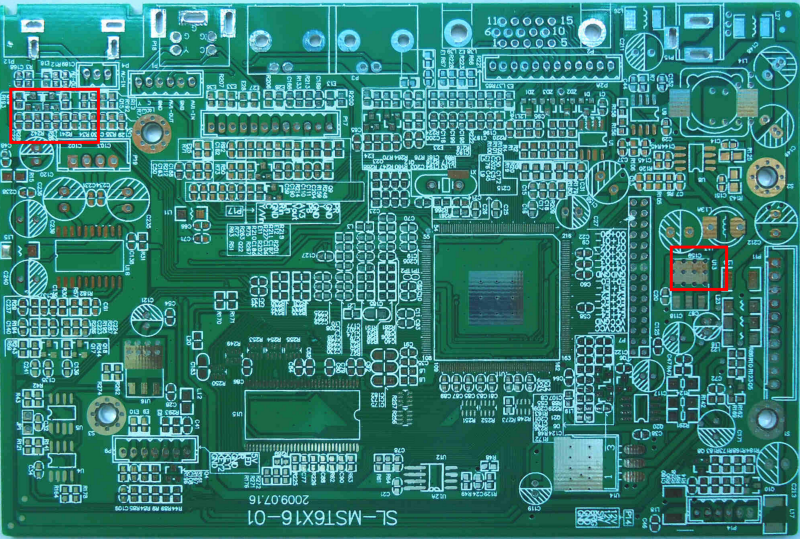
Tuy nhiên, có một chút giao thoa giữa hai kịch bản này. Nếu bạn muốn phân loại một ảnh vào một danh mục, có thể xảy ra trường hợp đối tượng hoặc các đặc trưng cần thiết để thực hiện phân loại quá nhỏ so với toàn bộ ảnh. Khi đó, bạn sẽ đạt hiệu năng tốt hơn với phát hiện đối tượng thay vì phân loại ảnh, ngay cả khi bạn không quan tâm đến vị trí chính xác hoặc số lượng của đối tượng.
Hãy tưởng tượng bạn cần kiểm tra các bảng mạch và phân loại chúng là lỗi hay đạt. Dù về bản chất đây là một bài toán phân loại, các lỗi có thể quá nhỏ để mô hình phân loại ảnh nhận thấy. Xây dựng một bộ dữ liệu phát hiện đối tượng sẽ tốn thời gian hơn, nhưng rất có thể sẽ cho ra một mô hình tốt hơn.
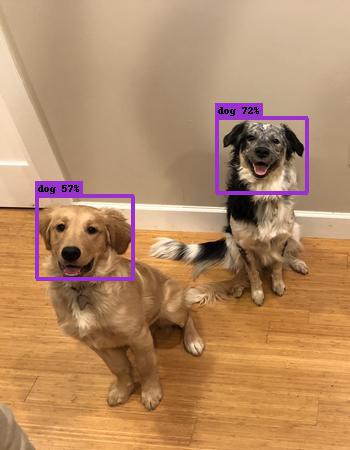
Với một mô hình phân loại ảnh, bạn tạo ra các đặc trưng ảnh (thông qua các phương pháp truyền thống hoặc học sâu) của toàn bộ ảnh. Những đặc trưng này là các tổng hợp của ảnh. Với phát hiện đối tượng, bạn làm điều này ở mức chi tiết, cục bộ hơn trên các vùng của ảnh. Ở trường hợp đầu, bạn có thể đánh mất tín hiệu phân loại, trong khi ở trường hợp sau, tín hiệu có thể được giữ lại theo cách phù hợp hơn với mục đích sử dụng.
Để huấn luyện một mô hình tùy chỉnh, bạn cần dữ liệu đã gán nhãn. Dữ liệu gán nhãn trong bối cảnh phát hiện đối tượng là những ảnh kèm theo tọa độ hộp giới hạn và nhãn. Tức là, các tọa độ (x,y) của góc dưới bên trái và góc trên bên phải + lớp.
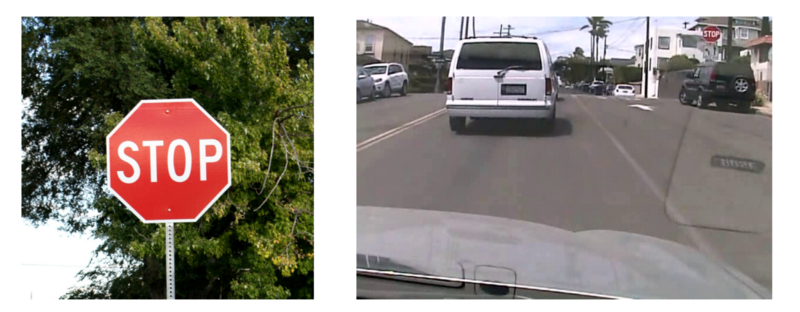
Một câu hỏi luôn được đặt ra là: để phát hiện đối tượng cho bài toán X, tôi cần bao nhiêu bức ảnh? Thay vào đó, điều quan trọng hơn là hiểu đúng các kịch bản mà mô hình sẽ được triển khai. Điều tối quan trọng là có một số lượng lớn (ví dụ, > 100 và có thể >1000) ảnh đại diện cho mỗi lớp. Đại diện ở đây nghĩa là chúng phải tương ứng với dải kịch bản mà mô hình sẽ được sử dụng. Nếu bạn xây dựng một mô hình phát hiện biển báo giao thông chạy trên ô tô, bạn phải dùng các ảnh chụp trong nhiều điều kiện thời tiết, ánh sáng và camera khác nhau trong bối cảnh phù hợp. Các mô hình phát hiện đối tượng không phải phép màu và thực ra khá “ngu ngốc”. Nếu mô hình không có đủ dữ liệu để học các mẫu chung, nó sẽ không hoạt động tốt trong môi trường sản xuất.
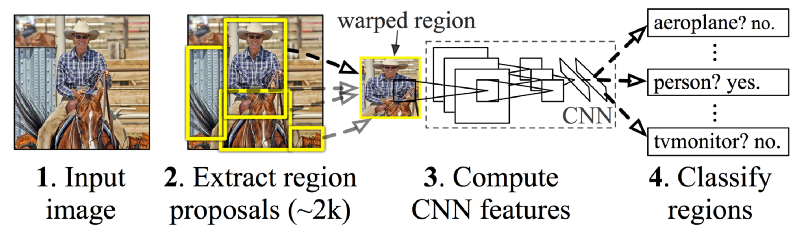
Thông thường, có ba bước trong một khung phát hiện đối tượng.
Có một số cách tiếp cận khác nhau để tạo đề xuất vùng. Ban đầu, thuật toán ‘selective search’ được dùng để tạo đề xuất đối tượng. Lillie Weng cung cấp một giải thích kỹ lưỡng về thuật toán này trong bài blog của cô ấy. Tóm lại, selective search là một phương pháp dựa trên phân cụm, cố gắng nhóm các điểm ảnh và tạo đề xuất dựa trên các cụm sinh ra.
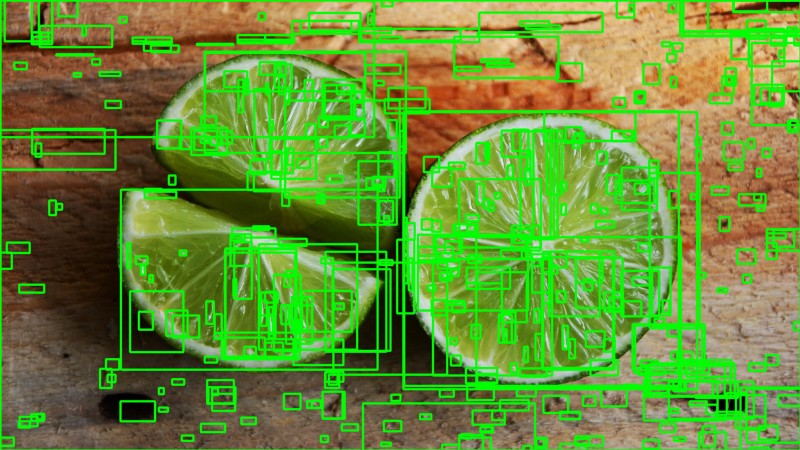
Các cách tiếp cận khác sử dụng các đặc trưng thị giác phức tạp hơn được trích xuất từ ảnh để tạo vùng (ví dụ, dựa trên các đặc trưng từ một mô hình học sâu) hoặc áp dụng phương pháp vét cạn để tạo vùng. Các phương pháp vét cạn này giống với một cửa sổ trượt áp dụng lên ảnh, qua nhiều tỉ lệ khung và thang đo. Những vùng này được tạo tự động, không tính đến các đặc trưng của ảnh.
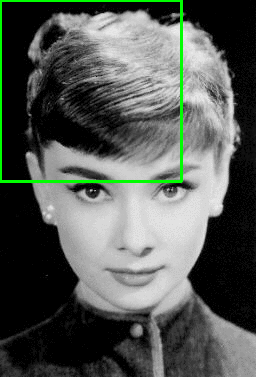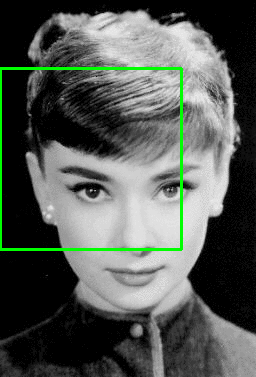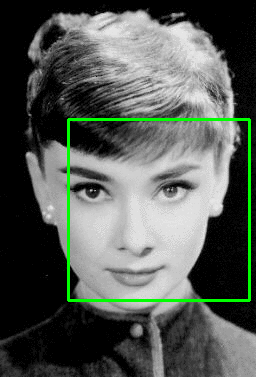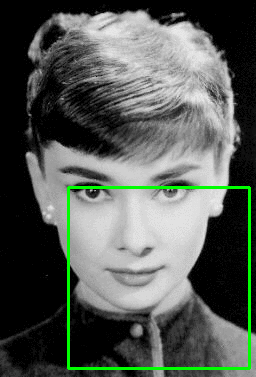
Một đánh đổi quan trọng khi tạo đề xuất vùng là số lượng vùng so với độ phức tạp tính toán. Bạn tạo càng nhiều vùng thì càng có khả năng tìm được đối tượng. Ở chiều ngược lại, nếu bạn tạo cạn kiệt mọi đề xuất có thể, ví dụ, sẽ không thể chạy bộ phát hiện đối tượng theo thời gian thực. Trong một số trường hợp, có thể sử dụng thông tin đặc thù bài toán để giảm số lượng ROI. Ví dụ, người đi bộ thường có tỉ lệ khoảng 1,5, nên không cần tạo ROI với tỉ lệ 0,25.
Mục tiêu của trích xuất đặc trưng là rút gọn một ảnh kích thước biến đổi thành một tập đặc trưng thị giác cố định. Các mô hình phân loại ảnh thường được xây dựng bằng các phương pháp trích xuất đặc trưng thị giác mạnh. Dù dựa trên các cách tiếp cận thị giác máy tính truyền thống, như dựa trên bộ lọc, phương pháp histogram, v.v., hay phương pháp học sâu, tất cả đều có cùng mục tiêu: trích xuất các đặc trưng từ ảnh đầu vào đại diện cho tác vụ cần làm và dùng các đặc trưng này để xác định lớp của ảnh. Trong các khung phát hiện đối tượng, người ta thường dùng các mô hình phân loại ảnh đã huấn luyện trước để trích xuất đặc trưng thị giác, vì chúng có xu hướng khái quát khá tốt. Ví dụ, một mô hình được huấn luyện trên bộ dữ liệu MS COCO có thể trích xuất các đặc trưng khá tổng quát. Tuy nhiên, để cải thiện mô hình, nên thử nghiệm với các cách tiếp cận khác nhau. Bài viết của tôi về học chuyển giao nêu rõ sự khác biệt giữa các loại học chuyển giao cũng như ưu, nhược điểm của chúng.
Ý tưởng chung của non-maximum suppression (NMS) là giảm số lượng phát hiện trong một khung hình xuống bằng với số lượng đối tượng thực tế. Nếu đối tượng trong khung hình khá lớn và có hơn 2000 đề xuất đối tượng được tạo ra, rất có khả năng một số trong đó sẽ chồng lấn đáng kể lên nhau và lên đối tượng. Xem video này trên Coursera để tìm hiểu thêm về NMS. Các kỹ thuật NMS thường là tiêu chuẩn chung giữa các khung phát hiện khác nhau, nhưng đây là một bước quan trọng có thể cần tinh chỉnh siêu tham số tùy theo kịch bản.
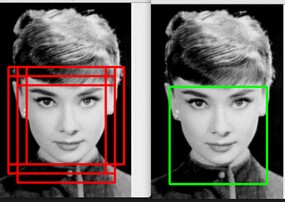
Chỉ số đánh giá phổ biến nhất dùng trong các tác vụ nhận dạng đối tượng là ‘mAP’, viết tắt của ‘mean average precision’. Đây là một con số từ 0 đến 100 và giá trị cao hơn thường tốt hơn, nhưng giá trị này khác với chỉ số accuracy trong phân loại.
Mỗi hộp giới hạn sẽ có một điểm số đi kèm (xác suất hộp đó chứa một đối tượng). Dựa trên các dự đoán, một đường cong precision-recall (PR curve) được tính cho mỗi lớp bằng cách thay đổi ngưỡng điểm số. Average precision (AP) là diện tích dưới đường cong PR. Trước tiên tính AP cho mỗi lớp, rồi lấy trung bình trên các lớp khác nhau. Kết quả cuối cùng là mAP.
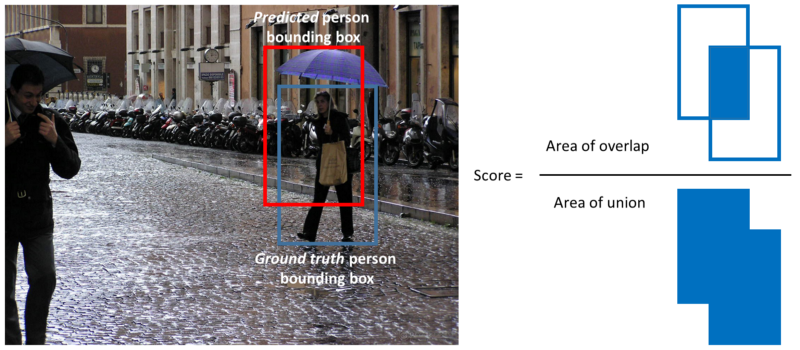
Lưu ý rằng một phát hiện là dương tính thật nếu nó có ‘intersection over union’ (IoU hay độ chồng lấn) với hộp ground-truth lớn hơn một ngưỡng nào đó (thường là 0,5). Thay vì dùng mAP, ta thường dùng mAP@0.5 hoặc mAP@0.25 để chỉ IoU đã sử dụng.
TensorFlow Detection API tập hợp nhiều ý tưởng đã nêu ở trên vào một gói duy nhất, cho phép bạn nhanh chóng lặp qua các cấu hình khác nhau với backend TensorFlow. Với API này, bạn định nghĩa mô hình phát hiện đối tượng bằng các tệp cấu hình, và TensorFlow Detection API chịu trách nhiệm ghép nối tất cả các thành phần cần thiết.
Để hiểu rõ hơn về các thành phần được hỗ trợ, hãy xem ‘thư mục protos’ chứa các định nghĩa hàm. Đặc biệt, các protos về train, eval, ssd, faster_rcnn và preprocessing rất quan trọng khi tinh chỉnh một mô hình.
Kiến trúc SSD được công bố năm 2016 bởi các nhà nghiên cứu từ Google. Nó trình bày một mô hình phát hiện đối tượng dùng một mạng nơ-ron sâu đơn lẻ kết hợp đề xuất vùng và trích xuất đặc trưng.
Một tập các hộp mặc định với nhiều tỉ lệ khung hình và thang đo khác nhau được dùng và áp lên các feature map. Vì các feature map này được tính bằng cách đưa ảnh qua một mạng phân loại ảnh, việc trích xuất đặc trưng cho các hộp giới hạn có thể thực hiện trong một bước. Điểm số được tạo cho mỗi danh mục đối tượng trong từng hộp giới hạn mặc định. Để phù hợp hơn với các hộp ground truth, các độ lệch hiệu chỉnh được tính cho mỗi hộp.
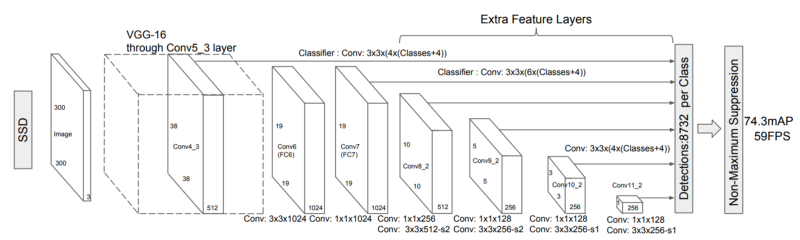
Các feature map khác nhau trong mạng tích chập tương ứng với các vùng tiếp nhận khác nhau và được dùng để xử lý tự nhiên các đối tượng ở các thang đo khác nhau. Vì toàn bộ tính toán được gói gọn trong một mạng và đạt tốc độ tính toán khá cao (ví dụ, với đầu vào 300 × 300 đạt 59 FPS).
Về cách dùng, chúng ta sẽ xem xét các tệp cấu hình mẫu cho SSD. Một số tham số quan trọng khi tận dụng kiến trúc SSD và chúng ta sẽ đi qua lần lượt.
Đầu tiên, các mạng phân loại khác nhau có điểm mạnh, điểm yếu khác nhau (xem bài viết này để có cái nhìn tổng quan). Ví dụ, mạng Inceptionv3 được huấn luyện để phát hiện đối tượng tốt ở nhiều thang đo, trong khi kiến trúc ResNet đạt độ chính xác rất cao nói chung. Còn Mobilenet là mạng được huấn luyện để tối thiểu hóa tài nguyên tính toán cần thiết. Hiệu năng của mạng trích xuất đặc trưng trên ImageNet, số lượng tham số và bộ dữ liệu gốc mà nó được huấn luyện là thước đo tốt cho đánh đổi hiệu năng/tốc độ. Trình trích xuất đặc trưng được định nghĩa trong phần ‘feature_extractor’.
Tập tham số rõ ràng thứ hai là các thiết lập cho hộp mặc định và tỉ lệ khung hình. Tùy thuộc vào loại bài toán, đáng để phân tích các tỉ lệ khung và thang đo của các hộp giới hạn trong dữ liệu gán nhãn. Thiết lập tỉ lệ khung và thang đo sẽ giúp mạng không phải thực hiện các phép tính không cần thiết. Bạn có thể tinh chỉnh các mục này trong phần ‘ssd_anchor_generator’. Lưu ý rằng việc thêm nhiều thang đo và tỉ lệ khung sẽ cải thiện hiệu năng, nhưng thường với lợi ích giảm dần.
Thứ ba, khi huấn luyện mô hình, điều quan trọng là thiết lập kích thước ảnh và các tùy chọn tăng cường dữ liệu trong các phần ‘data_augmentation_options’ và ‘image_resizer’. Ảnh kích thước lớn hơn sẽ cho hiệu năng tốt hơn vì các đối tượng nhỏ thường khó phát hiện, nhưng sẽ tốn đáng kể chi phí tính toán. Tăng cường dữ liệu đặc biệt quan trọng trong bối cảnh SSD để có thể phát hiện đối tượng ở các thang đo khác nhau (kể cả các thang đo có thể không xuất hiện trong dữ liệu huấn luyện).
Cuối cùng, tinh chỉnh ‘train_config’, thiết lập tốc độ học và kích thước batch là quan trọng để giảm quá khớp, và sẽ phụ thuộc nhiều vào kích thước bộ dữ liệu bạn có.
Faster R-CNN được phát triển bởi các nhà nghiên cứu tại Microsoft. Nó dựa trên R-CNN, vốn sử dụng cách tiếp cận nhiều giai đoạn để phát hiện đối tượng. R-CNN dùng Selective search để xác định đề xuất vùng, đưa chúng qua một mạng phân loại và sau đó dùng SVM để phân loại các vùng khác nhau.
Faster R-CNN, tương tự SSD, là một cách tiếp cận đầu-cuối. Thay vì dùng các hộp mặc định, Faster R-CNN có một Mạng Đề xuất Vùng (RPN) để tạo một tập vùng cố định. RPN sử dụng các đặc trưng tích chập từ mạng phân loại ảnh, cho phép tạo đề xuất vùng gần như không tốn chi phí. RPN được triển khai như một mạng hoàn toàn tích chập dự đoán biên hộp đối tượng và điểm số “tính đối tượng” tại mỗi vị trí.
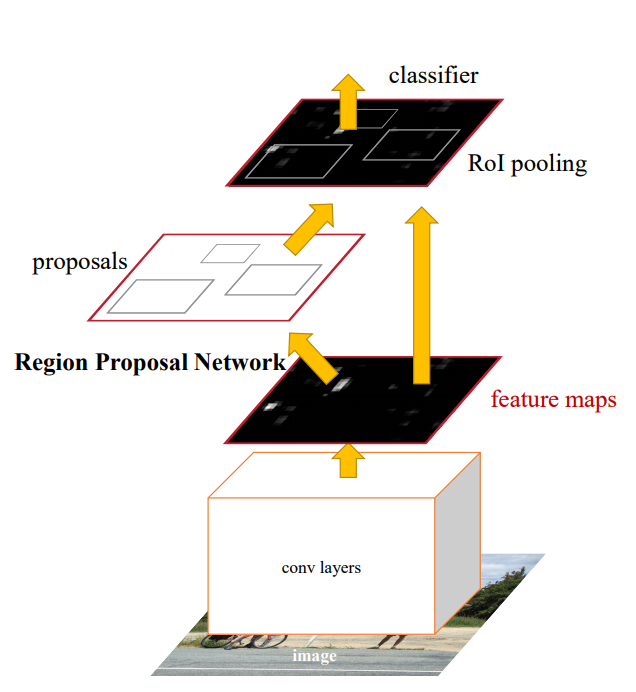
Lưu ý rằng RPN có thiết lập tương tự mạng SSD (tức là nó không dự đoán hộp giới hạn từ hư không). Mạng RPN hoạt động với các cửa sổ trượt trên các feature map. Tại mỗi vị trí cửa sổ trượt hay anchor, một tập đề xuất được tính với nhiều thang đo và tỉ lệ khung khác nhau. Tương tự SSD, đầu ra của RPN là các hộp giới hạn được “hiệu chỉnh” dựa trên các anchor.
Các thành phần khác nhau được kết hợp trong một thiết lập duy nhất và được huấn luyện hoặc đầu-cuối hoặc theo nhiều giai đoạn (để cải thiện ổn định). Một cách diễn giải khác về RPN là nó dẫn dắt “sự chú ý” của mạng tới các vùng thú vị.
Hầu hết chi tiết sử dụng của Faster R-CNN tương tự như của SSD. Xét về mAP thô, Faster R-CNN thường vượt trội hơn SSD, nhưng đòi hỏi sức mạnh tính toán lớn hơn nhiều.
Một phần quan trọng đối với bộ phát hiện Fast-RCNN là ‘first_stage_anchor_generator’, phần này định nghĩa các anchor do RPN tạo ra. Các bước nhảy (stride) trong phần này xác định bước của cửa sổ trượt. Lưu ý đặc biệt khi cố gắng phát hiện các đối tượng nhỏ (nếu stride quá lớn, bạn có thể bỏ lỡ chúng).
Mặc dù các tác giả của bài báo Faster-RCNN không dùng tăng cường dữ liệu rộng rãi, vẫn khuyến nghị sử dụng khi làm việc với các bộ dữ liệu nhỏ hơn.
Còn có nhiều kiến trúc phát hiện đối tượng khác mà tôi chưa đề cập. Đặc biệt khi xét các ứng dụng thời gian thực, Yolov2 thường được nhắc đến như một kiến trúc quan trọng (khá giống SSD). Tôi sẽ cập nhật bài viết này bất cứ khi nào nó được thêm vào TensorFlow Detection API.
Nếu bạn có bất kỳ câu hỏi nào, tôi rất vui được đọc trong phần bình luận. Theo dõi tôi trên Medium hoặc Twitter nếu bạn muốn nhận cập nhật về các bài viết của tôi!
Tìm hiểu thêm về Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
