Cursus
Inzicht in Machine Learning
2 uur
313.7K
Door recente vooruitgang in op deep learning gebaseerde computervisiemodellen is het ontwikkelen van objectdetectietoepassingen makkelijker dan ooit. Naast aanzienlijke prestatieverbeteringen maken deze technieken ook gebruik van enorme afbeeldingsdatasets om de behoefte aan grote datasets te verkleinen. Bovendien is de prestatie door huidige benaderingen die zich richten op volledige end-to-end-pijplijnen sterk verbeterd, wat realtime toepassingen mogelijk maakt.
Net als in de blogpost die ik schreef over verschillende architecturen voor beeldclassificatie, bespreek ik hier twee objectdetectie-architecturen. Ik ga in op SSD en Faster RCNN, die beide momenteel beschikbaar zijn in de TensorFlow Detection API.
Eerst behandel ik een aantal kernconcepten in objectdetectie, gevolgd door een illustratie van hoe deze zijn geïmplementeerd in SSD en Faster RCNN.
Mensen verwarren beeldclassificatie en objectdetectie vaak. In het algemeen gebruik je beeldclassificatie als je een afbeelding in een bepaalde categorie wilt indelen. Als je daarentegen de locatie van objecten in een afbeelding wilt bepalen en bijvoorbeeld het aantal exemplaren van een object wilt tellen, dan kun je objectdetectie gebruiken.
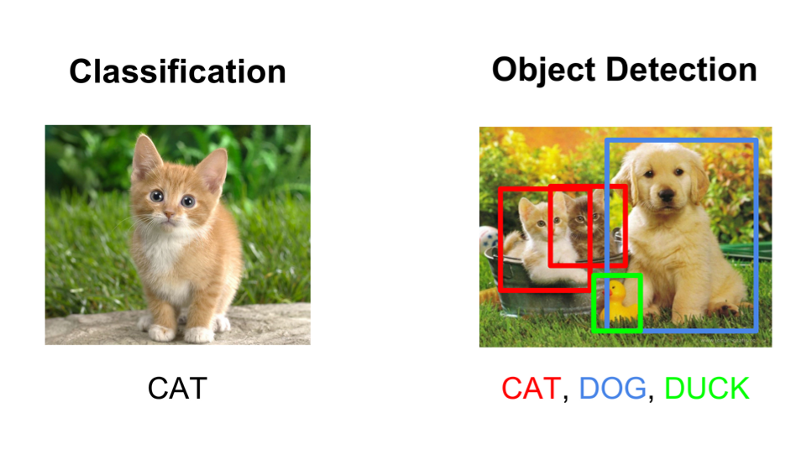
Er is echter enige overlap tussen deze twee scenario’s. Als je een afbeelding in een bepaalde categorie wilt indelen, kan het gebeuren dat het object of de kenmerken die nodig zijn voor de categorisatie te klein zijn ten opzichte van de volledige afbeelding. In dat geval behaal je mogelijk betere prestaties met objectdetectie dan met beeldclassificatie, zelfs als je niet geïnteresseerd bent in de exacte locatie of aantallen van het object.
Stel dat je printplaten moet controleren en ze wilt classificeren als defect of correct. Hoewel het in essentie een classificatieprobleem is, kunnen de defecten te klein zijn om op te vallen met een beeldclassificatiemodel. Het opbouwen van een objectdetectiedataset kost meer tijd, maar leidt waarschijnlijk tot een beter model.
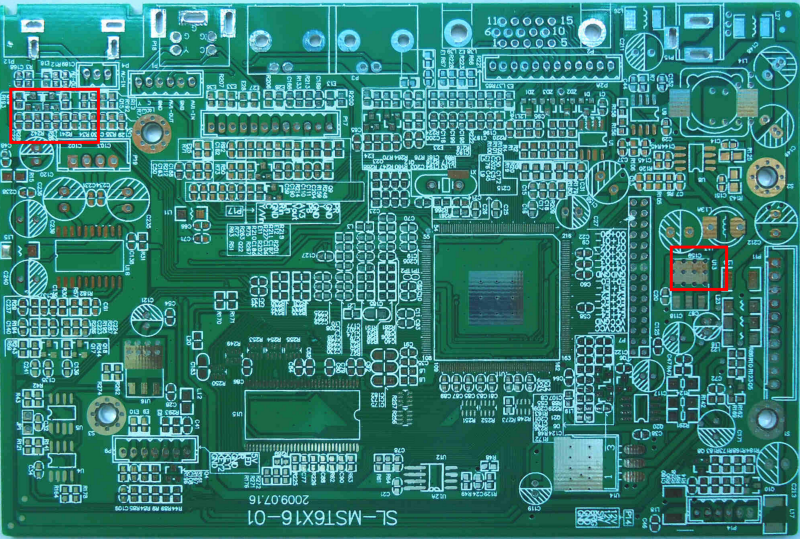
Met een beeldclassificatiemodel genereer je afbeeldingskenmerken (via traditionele of deep learning-methoden) van de volledige afbeelding. Deze kenmerken zijn aggregaten van de afbeelding. Bij objectdetectie doe je dit op een fijnmaziger, regionaal niveau van de afbeelding. In het eerste geval kun je het classificatiesignaal kwijtraken, terwijl in het tweede geval het signaal behouden kan blijven op een manier die geschikter is voor de usecase.
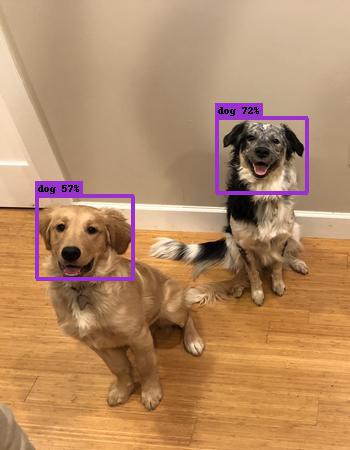
Om een aangepast model te trainen, heb je gelabelde data nodig. Gelabelde data in de context van objectdetectie zijn afbeeldingen met bijbehorende coördinaten van begrenzingsvakken (bounding boxes) en labels. Dat wil zeggen: de linkerbeneden- en rechterboven-(x,y)-coördinaten + de klasse.
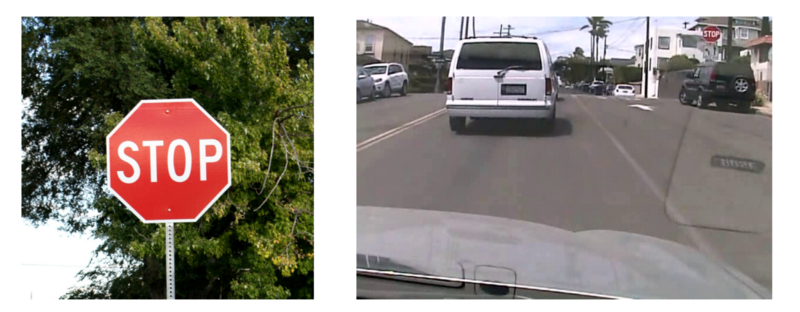
Een veelgestelde vraag is: hoeveel foto’s heb ik nodig om objectdetectie te doen voor probleem X? Het is belangrijker om goed te begrijpen in welke scenario’s het model zal worden ingezet. Het is cruciaal dat er per klasse een groot aantal (bijvoorbeeld > 100 en mogelijk >1000) representatieve afbeeldingen beschikbaar zijn. Representatief betekent hier dat ze overeenkomen met het bereik aan scenario’s waarin het model wordt gebruikt. Als je een model voor verkeersborddetectie bouwt dat in een auto zal draaien, moet je afbeeldingen gebruiken die zijn genomen onder verschillende weers-, licht- en cameraomstandigheden, in de juiste context. Objectdetectiemodellen zijn geen magie en eigenlijk tamelijk dom. Als het model niet genoeg data heeft om algemene patronen te leren, zal het in productie niet goed presteren.
Typisch zijn er drie stappen in een objectdetectieframework.
Er bestaan verschillende benaderingen om regio-voorstellen te genereren. Oorspronkelijk werd het ‘selective search’-algoritme gebruikt om objectvoorstellen te genereren. Lillie Weng geeft in haar blogpost een grondige uitleg van dit algoritme. Kort gezegd is selective search een op clustering gebaseerde aanpak die probeert pixels te groeperen en voorstellen te genereren op basis van de gevormde clusters.
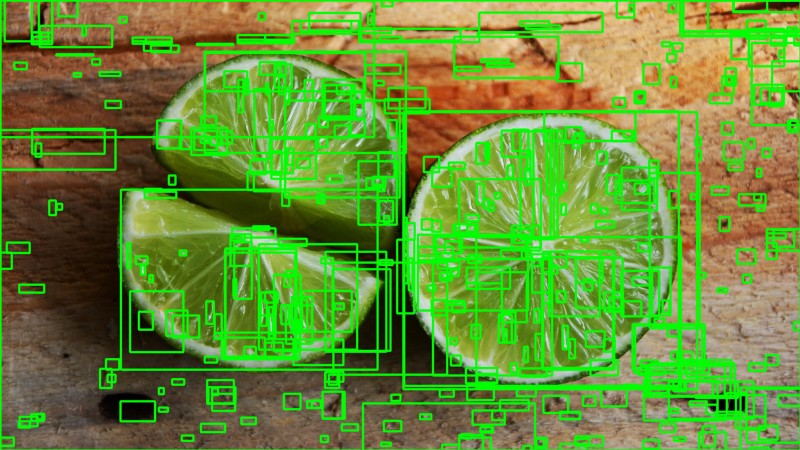
Andere benaderingen gebruiken complexere visuele kenmerken die uit de afbeelding zijn geëxtraheerd om regio’s te genereren (bijvoorbeeld op basis van de kenmerken van een deep learning-model) of hanteren een brute-force benadering voor regiogeneratie. Deze brute-force-benaderingen lijken op een schuivend venster dat op de afbeelding wordt toegepast, over verschillende verhoudingen en schalen. Deze regio’s worden automatisch gegenereerd, zonder rekening te houden met de afbeeldingskenmerken.
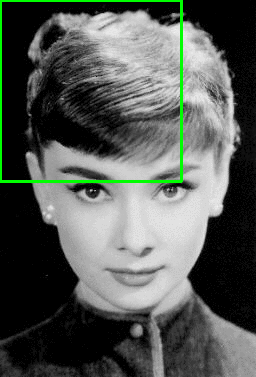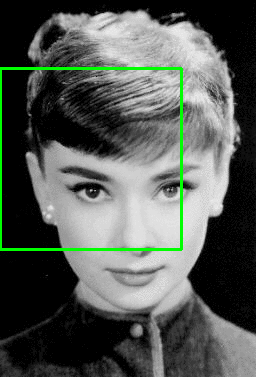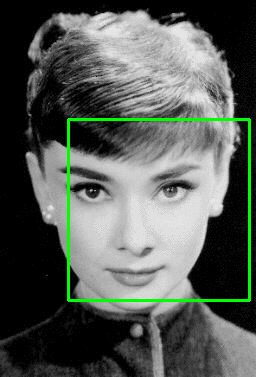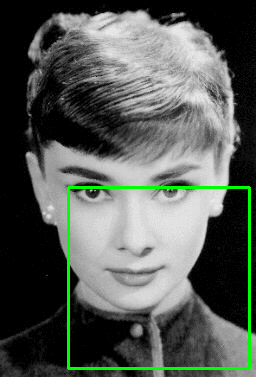
Een belangrijke afweging bij het genereren van regio-voorstellen is het aantal regio’s versus de computationele complexiteit. Hoe meer regio’s je genereert, hoe groter de kans dat je het object vindt. Aan de andere kant: als je uitputtend alle mogelijke voorstellen genereert, is het bijvoorbeeld niet mogelijk om de objectdetector realtime te laten draaien. In sommige gevallen is het mogelijk om probleem-specifieke informatie te gebruiken om het aantal ROI’s te verminderen. Zo hebben voetgangers doorgaans een verhouding van ongeveer 1,5, dus is het niet zinvol om ROI’s te genereren met een verhouding van 0,25.
Het doel van kenmerkextractie is om een afbeelding van variabele grootte terug te brengen tot een vaste set visuele kenmerken. Modellen voor beeldclassificatie zijn doorgaans opgebouwd met sterke methoden voor kenmerkextractie. Of ze nu gebaseerd zijn op traditionele computervisiemethoden, zoals filtergebaseerde benaderingen, histogrammethoden, enzovoort, of op deep learning: ze hebben allemaal exact hetzelfde doel: kenmerken uit de invoerafbeelding halen die representatief zijn voor de taak, en deze gebruiken om de klasse van de afbeelding te bepalen. In objectdetectieframeworks gebruiken mensen doorgaans voorgetrainde beeldclassificatiemodellen om visuele kenmerken te extraheren, omdat deze redelijk goed generaliseren. Een model dat bijvoorbeeld is getraind op de MS COCO-dataset kan vrij generieke kenmerken extraheren. Om het model te verbeteren is het echter aan te raden te experimenteren met verschillende benaderingen. Mijn blogpost over transfer learning geeft een duidelijk onderscheid tussen de verschillende soorten transfer learning en hun voor- en nadelen.
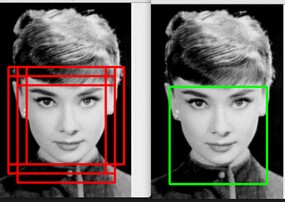
Het algemene idee van non-maximum suppression is om het aantal detecties in een frame terug te brengen tot het werkelijke aantal aanwezige objecten. Als het object in het frame vrij groot is en er meer dan 2000 objectvoorstellen zijn gegenereerd, is het vrij waarschijnlijk dat sommige daarvan aanzienlijke overlap hebben met elkaar en met het object. Bekijk deze video op Coursera om meer te leren over NMS. NMS-technieken zijn doorgaans standaard over de verschillende detectieframeworks, maar het is een belangrijke stap waarvoor mogelijk hyperparametertuning nodig is, afhankelijk van het scenario.
De meest gebruikte evaluatiemaatstaf bij objectherkenningstaken is ‘mAP’, wat staat voor ‘mean average precision’. Het is een getal van 0 tot 100 en hogere waarden zijn doorgaans beter, maar de betekenis ervan verschilt van de accuracymetriek bij classificatie.
Elke bounding box heeft een bijbehorende score (de waarschijnlijkheid dat het vak een object bevat). Op basis van de voorspellingen wordt voor elke klasse een precision-recall-curve (PR-curve) berekend door de scoredrempel te variëren. De average precision (AP) is de oppervlakte onder de PR-curve. Eerst wordt de AP voor elke klasse berekend en vervolgens gemiddeld over de verschillende klassen. Het eindresultaat is de mAP.
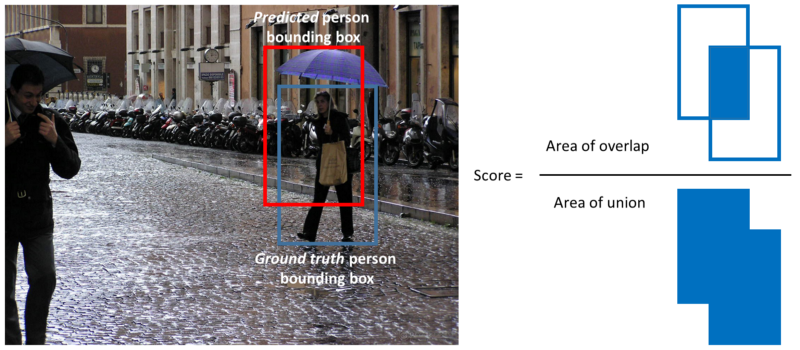
Let op: een detectie is een true positive als de ‘intersection over union’ (IoU of overlap) met de groundtruth-box groter is dan een bepaalde drempel (meestal 0,5). In plaats van mAP gebruiken we meestal mAP@0.5 of mAP@0.25 om te verwijzen naar de gebruikte IoU.
De TensorFlow Detection API brengt veel van de hierboven genoemde ideeën samen in één pakket, zodat je snel kunt itereren over verschillende configuraties met de TensorFlow-backend. Met de API definieer je het objectdetectiemodel via configuratiebestanden, en de TensorFlow Detection API is verantwoordelijk voor het samenstellen van alle noodzakelijke elementen.
Om beter te begrijpen welke verschillende componenten worden ondersteund, kun je een kijkje nemen in de ‘protos-map’ met functiedefinities. Vooral de train-, eval-, ssd-, faster_rcnn- en preprocessing-protos zijn belangrijk bij het finetunen van een model.
De SSD-architectuur werd in 2016 gepubliceerd door onderzoekers van Google. Het presenteert een objectdetectiemodel met één enkel deep neural network dat regiovoorstellen en kenmerkextractie combineert.
Er wordt een set standaardvakken over verschillende beeldverhoudingen en schalen gebruikt en toegepast op de feature maps. Omdat deze feature maps worden berekend door een afbeelding door een beeldclassificatienetwerk te sturen, kan de kenmerkextractie voor de bounding boxes in één stap plaatsvinden. Voor elke objectcategorie in elk van de standaardvakken worden scores gegenereerd. Om beter aan te sluiten op de groundtruth-vakken worden aanpassings-offsets berekend voor elk vak.
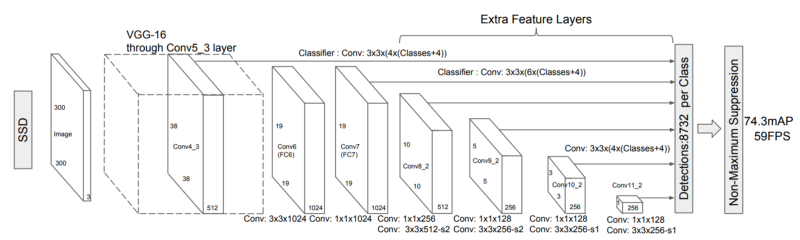
Verschillende feature maps in het convolutionele netwerk komen overeen met verschillende receptieve velden en worden gebruikt om objecten op verschillende schalen natuurlijk te verwerken. Omdat alle berekening in één netwerk is ondergebracht, worden vrij hoge snelheden behaald (bijvoorbeeld 59 FPS voor invoer van 300 × 300).
Voor het gebruik bekijken we de verschillende voorbeeldconfiguratiebestanden voor SSD. Verschillende parameters zijn belangrijk bij het benutten van de SSD-architectuur en we lopen ze één voor één door.
Ten eerste hebben verschillende classificatienetwerken verschillende sterktes en zwaktes (zie deze blogpost voor een overzicht). Het Inceptionv3-netwerk is bijvoorbeeld getraind om objecten goed op verschillende schalen te detecteren, terwijl de ResNet-architectuur over het algemeen zeer hoge nauwkeurigheid behaalt. Mobilenet daarentegen is een netwerk dat is getraind om de benodigde rekenbronnen te minimaliseren. De prestaties van het kenmerkextractienetwerk op ImageNet, het aantal parameters en de originele dataset waarop het is getraind, zijn een goede graadmeter voor de afweging tussen prestaties en snelheid. De feature extractor wordt gedefinieerd in de sectie ‘feature_extractor’.
Een tweede, voor de hand liggende set parameters zijn de instellingen voor de standaardvakken en beeldverhoudingen. Afhankelijk van het type probleem is het de moeite waard de verschillende beeldverhoudingen en schalen van de bounding boxes in de gelabelde data te analyseren. Het instellen van de beeldverhoudingen en schalen zorgt ervoor dat het netwerk geen onnodige berekeningen uitvoert. Je kunt deze afstellen in de sectie ‘ssd_anchor_generator’. Let op: meer schalen en beeldverhoudingen toevoegen leidt tot betere prestaties, maar meestal met afnemende meeropbrengst.
Ten derde is het bij het trainen van het model belangrijk om de afbeeldingsgrootte en data-augmentatie-opties in te stellen in de secties ‘data_augmentation_options’ en ‘image_resizer’. Een grotere afbeeldingsgrootte presteert beter omdat kleine objecten vaak lastig te detecteren zijn, maar dit brengt een aanzienlijke rekenslag met zich mee. Data-augmentatie is vooral in de context van SSD belangrijk om objecten op verschillende schalen te kunnen detecteren (zelfs op schalen die mogelijk niet in de trainingsdata aanwezig zijn).
Tot slot is het afstellen van de ‘train_config’, inclusief het instellen van de leersnelheden en batchgroottes, belangrijk om overfitting te verminderen en hangt dit sterk af van de omvang van je dataset.
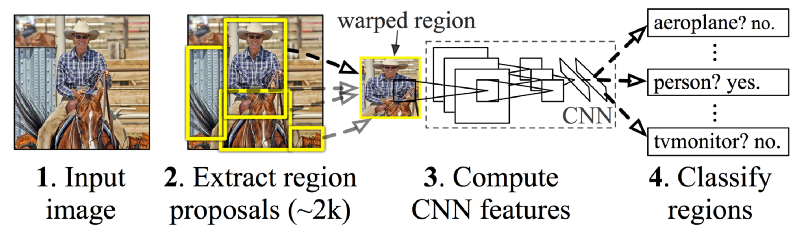
Faster R-CNN is ontwikkeld door onderzoekers bij Microsoft. Het is gebaseerd op R-CNN, dat een meerfasige aanpak voor objectdetectie gebruikte. R-CNN gebruikte Selective Search om regiovoorstellen te bepalen, stuurde deze door een classificatienetwerk en gebruikte vervolgens een SVM om de verschillende regio’s te classificeren.
Faster R-CNN is, net als SSD, een end-to-end-benadering. In plaats van standaard-bounding boxes te gebruiken, heeft Faster R-CNN een Region Proposal Network (RPN) om een vaste set regio’s te genereren. De RPN gebruikt de convolutionele kenmerken uit het beeldclassificatienetwerk, waardoor regiovoorstellen vrijwel kosteloos zijn. De RPN is geïmplementeerd als een volledig convolutioneel netwerk dat op elke positie objectgrenzen en objectness-scores voorspelt.
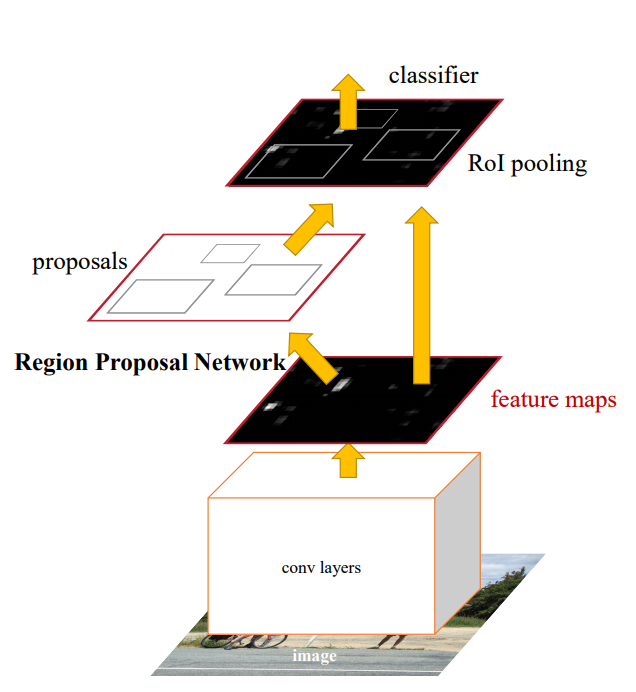
Let op: de RPN heeft een vergelijkbare opzet als het SSD-netwerk (d.w.z. het voorspelt geen bounding boxes uit het niets). Het RPN-netwerk werkt met schuivende vensters over de feature maps. Op elke sliding-window-locatie, of ‘anchor’, wordt een set voorstellen berekend met verschillende schalen en beeldverhoudingen. Net als bij SSD zijn de uitkomsten van de RPN ‘aangepaste’ bounding boxes, gebaseerd op de anchors.
De verschillende componenten worden in één opzet gecombineerd en worden ofwel end-to-end of in meerdere fasen getraind (om de stabiliteit te verbeteren). Een andere interpretatie van de RPN is dat het de ‘aandacht’ van de netwerken naar interessante regio’s leidt.
De meeste gebruiksdetails van Faster R-CNN lijken op die van SSD. In termen van ruwe mAP presteert Faster R-CNN doorgaans beter dan SSD, maar het vereist aanzienlijk meer rekenkracht.
Een belangrijke sectie voor de Fast-RCNN-detector is de ‘first_stage_anchor_generator’, die de anchors definieert die door de RPN worden gegenereerd. De strides in deze sectie definiëren de stappen van het schuivende venster. Let vooral op het detecteren van kleine objecten (als de stride te groot is, kun je ze missen).
Hoewel door de auteurs van het Faster-RCNN-paper geen uitgebreide data-augmentatie werd gebruikt, is het nog steeds aan te raden dit toe te passen bij kleinere datasets.
Er zijn nog verschillende andere objectdetectie-architecturen waarop ik niet ben ingegaan. Zeker bij realtime toepassingen wordt Yolov2 vaak genoemd als een belangrijke architectuur (redelijk vergelijkbaar met SSD). Ik werk deze blogpost bij zodra deze is toegevoegd aan de TensorFlow Detection API.
Als je vragen hebt, lees ik die graag in de comments. Volg me op Medium of Twitter als je updates over mijn blogposts wilt ontvangen!
Leer meer over machine learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

