

课程
Python 中的 A/B 测试
4 小时
13.1K
实践并学习路径你的进步。
使用 Google 继续如果您接触过推断统计,尤其是假设检验和回归,您很可能已经认识了 p 值。而只要接触过 p 值,您很可能就知道,或者至少有所怀疑,p 值很脆弱、可以被操纵——这种担心并非多余。
事实上,这种操纵行为已经有了专门的称呼,就是 p-hacking。有时,它也被称为数据挖捞(data dredging)、数据窥探(data snooping)、数据捕鱼(data fishing)以及膨胀偏差(inflation bias)。本文将对此进行深入探讨。
首先,快速回顾一下 p 值是什么。p 值中的“p”代表概率(probability)。具体来说,p 值是在原假设为真时,观察到与当前结果同样极端或更极端结果的概率。对真实原假设的这种错误拒绝也被称为第一类错误,或假阳性错误。通常,我们获取 p 值是为了与显著性水平(记作α)进行比较,显著性水平是当原假设为真时,我们容许拒绝它的概率。
因此,如果 p 值大于显著性水平,我们就无法拒绝原假设,维持原判。相反,如果 p 值小于或等于显著性水平,我们就可以拒绝原假设,转而支持备择假设,此时我们称结果具有统计显著性。
如果这段关于 p 值的快速回顾有任何不清楚的地方,也别担心!您可以学习我们的统计学入门理论课程,迅速掌握必要的基础知识。
获得“统计显著”的结果听起来就像成功,因此极具诱惑力。在商业中,这意味着您有新的、有趣或值得关注的内容可以汇报。在学术界,这意味着您发现了某些东西,并可能发表在期刊上。
由于这是通往整个令人兴奋世界的钥匙,数据从业者和研究人员往往会过度关注研究中的 p 值,而忽略其他因素,甚至包括显著性水平。几十年来最常用的显著性水平是 0.05,因此形成了一种简单的惯例:一旦得到低于 0.05 的 p 值,就可以立刻大肆庆祝。
进一步的结果是,一些研究者会陷入 p-hacking 的误区,有时是主观故意,但通常是无意为之——通过使用某些方法降低 p 值以达到统计显著,而在规范测试下原本并不会得到这样的结论。
无论是否出于主观意图,很多环节都可能出错,并导致 p-hacking。导致 p-hacking 的方法可称为 p-hacks,它们可能发生在实验的任何阶段。
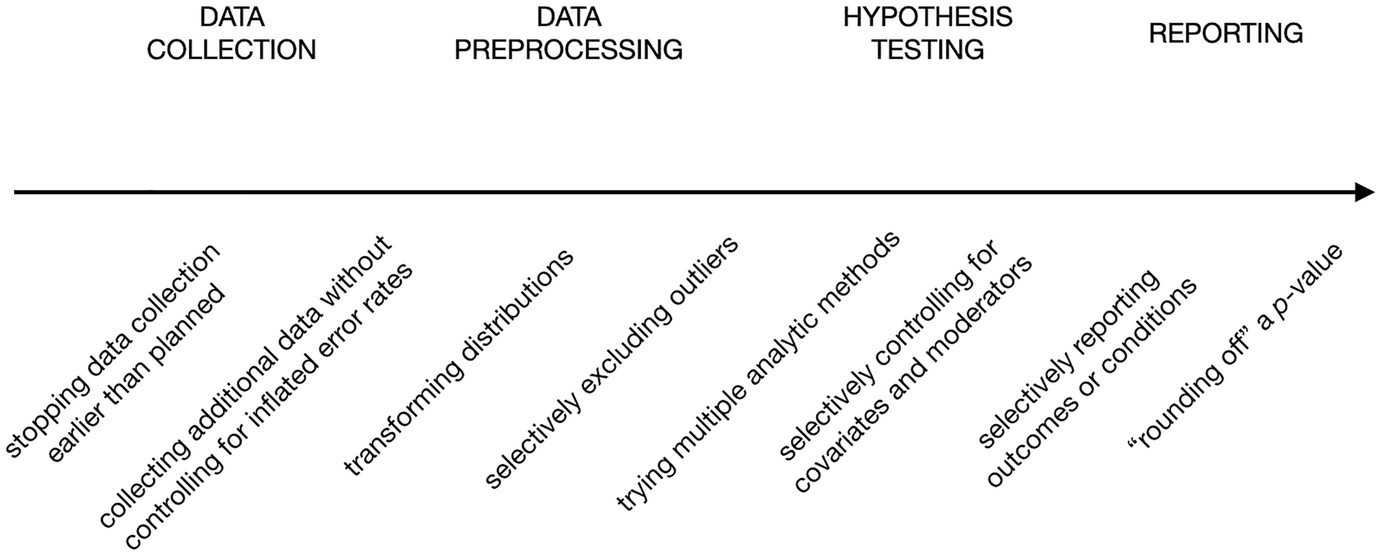
在其书籍章节《p-Hacking 的多种形式》中,Dorota Reis 和 Malte Friese 给出了一份并不穷尽的 p-hacks 列表,覆盖从数据收集一直到结果报告的各个阶段,如下图所示。
p-hacks 的示例。来源:Avoiding Questionable Research Practices in Applied Psychology。
我们从左到右逐一看看它们的含义:
请注意,这些 p-hack 大多依赖于一遍遍重复运行实验,每次都对本应预先确定的实验基础进行微调。
但即便不做这些微调,仅仅反复运行同一实验、并且只在结果具有统计显著时才对外报告,也可能是 p-hack,因为只要实验运行次数足够多,总有可能某次返回较低的 p 值。下面这幅来自xkcd 的漫画很好地说明了这一点。
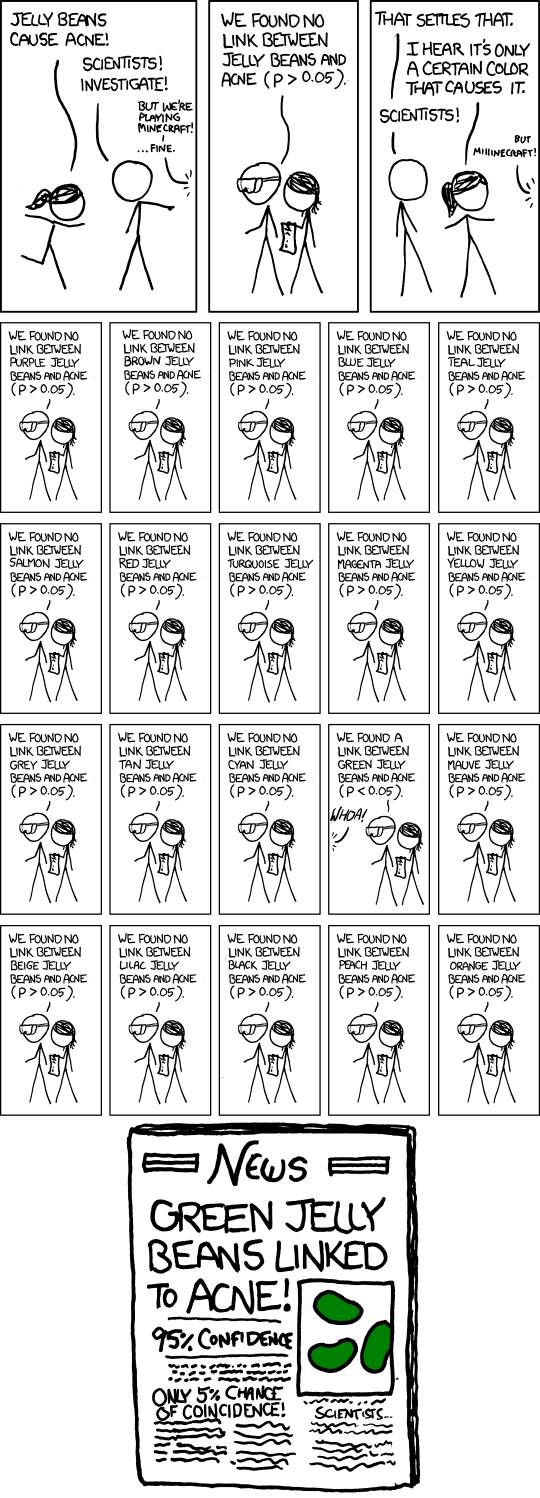
“Significant”漫画。来源:xkcd。
P-hacking 是一种非常普遍的现象。2010 年代早期,许多综述性研究开始发现,发表在多个领域知名期刊上的研究中,有很大比例很可能存在 p-hacking,尤其是在心理学和医学领域,同时也包括社会科学和人文学科。
例如,2015 年,一项由弗吉尼亚大学学者主导的研究回顾了 2008 年发表在顶级期刊上的 100 篇心理学研究,发现其中不到一半可以复现。缺乏可重复性意味着研究在复现时无法得到相同结果,其中一部分原因就是 p-hacking。
另一项项目考察了癌症研究,发现 193 个实验中只有 50 个可复现。更早在 2009 年,一项研究注意到神经科学领域中有可疑数量的实验报告,在情绪、人格、社会认知与大脑 fMRI 活动之间出现了异常高的相关性。对这些实验作者的调查显示,他们依赖于选择性挑选数据子集,并仅报告能产生显著结果的部分,这与我们所说的事后替换类 p-hack 类似。
这些综述性研究的发现揭示了,p-hacking 连同其他可疑的研究做法,正在使长期受尊重的科学研究基础变得摇摇欲坠、漏洞百出。这场危机被称为可重复性危机,而这场危机至今仍在持续,学界也在不断讨论并寻求出路。
那么,p-hacking 到底有什么问题?
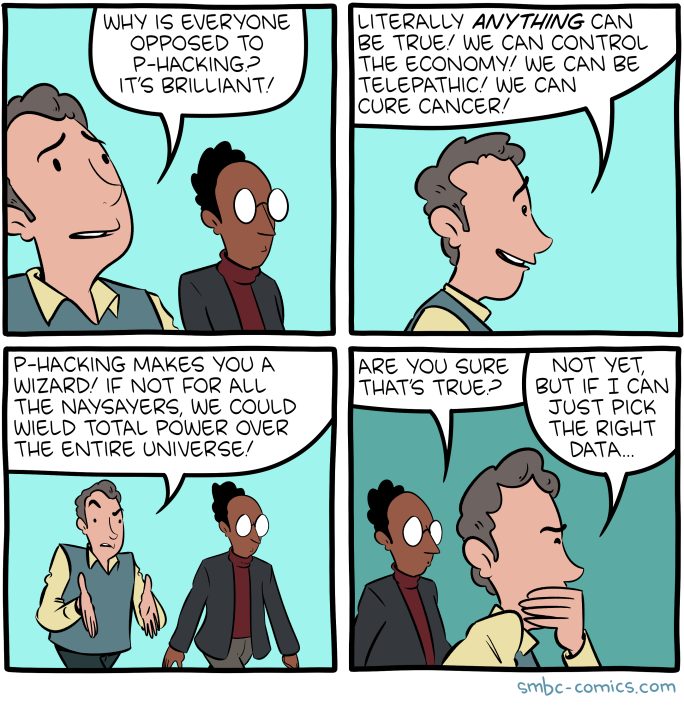
“P-hacking makes you a wizard(p-hacking 让你像个巫师)”。来源:SMBC Comics。
这个问题的答案似乎不言自明,但拆解一下 p-hacking 错误且不道德的原因,有助于我们更好地理解这场“伪显著性”问题的“重要性”。
p-hacking 的核心,无非是操纵方法学或操纵结果。若属主观故意,这就等同于无端说谎以谋私利(比如获得发表或认可)。若为无心之失,则如同走错了路,最终只能抵达假阳性的“海市蜃楼”。
实验——无论在科学领域还是商业领域——都会产生后果。它们旨在为决策提供依据,或在其结果之上继续推进。如果实验结果被捏造,依赖这些结果的决策就会失去根基,有时甚至会带来灾难性后果。
例如,肿瘤学和神经学等敏感领域的研究,会共同推动疗法和药物的开发。如果其中一些奠基性研究被操纵,将是巨大的灾难。
在商业中,错误决策可能导致多种后果:从推出失败产品、耗尽资源,到有人被解雇,甚至公司破产。一个看似简单的 p-hack 也可能引发“蝴蝶效应”。
可重复性危机已经引发了对科学整体的广泛质疑,这甚至反映到政治话语中。尽管面对科学发现时保持批判性思维始终有益,但若将所有经验性发现一概否定,只会导向无知与无根据的决策。
在商业中,在更小的尺度上,p-hacking 及类似可疑做法,会使企业领导者从数据驱动决策退回到仅凭感觉与直觉——这与整个数据科学领域所承诺并切实能够实现的目标恰恰相反。
人类知识以其累积性为基础。每一个小实验都是奠基石,铺就更宏大的知识结构。当越来越多的奠基石因 p-hacking 等可疑做法而变得不稳,知识累积的潜力就会变得不祥。甚至仅仅是寻找可用于搭建新实验的既有文献,都会变成如履薄冰的任务。
基于我们对 p-hacking 及其手法的了解,可以归纳出一些有助于识别 p-hack 的红旗信号。多数红旗仍需要好奇心、批判性思维与细致入微的洞察力来察觉,有些甚至依赖深厚的领域知识。
轰动性的实验结果往往值得持保留态度地对待。媒体与社交平台常会追捧此类研究,但像“巧克力能导致减肥”这样的结论,显然不应被轻易视为定论。
在商业中,某项小改动就能让利润提升 100% 的测试,同样可被视为耸动。
遇到此类研究,如与您相关,请务必在接受结论前仔细核对其方法与结果。
警惕对方法学语焉不详,或未披露部分方法学要素的实验。公开初始假设、显著性水平、样本量、收集的变量、所选检验类型以及数据准备步骤,都是健全科学流程的必要条件。对上述任一要素含糊不清,都是红旗。
如果实验的数据准备包含变量变换,请仔细核查其背后原因,并要求明确说明。若未说明或理由不充分,这可能是 p-hacking 的直接信号。
小样本量会降低研究的统计功效,提高假阴性的风险。然而,当与选择性报告或 p-hacking 并存时,低功效研究也会使已发表文献中的假阳性比例升高。
在某些领域,小样本量是可接受且常见的,比如临床研究、环境研究、工程与质量控制。但总体而言,更大的样本量会带来更好的推断能力,从而降低假阳性与虚假的显著 p 值的可能性。
无论如何,如果小样本量没有得到合理解释,可能意味着统计功效不足,从而提高假阳性风险。在某些情况下,我认为这也可能暗示早停,即前文提到的特定 p-hacking 做法:一旦达到显著性就停止收集数据,而不是达到预定样本量后再停止。
效应量衡量变量之间关系的强度或幅度,为统计显著性提供语境。如果研究报告了统计显著性,却未给出清晰或有意义的效应量,就值得怀疑。
p 值可能表明结果不太可能由偶然导致,但如果没有效应量,我们很难判断其实际意义。在存在 p-hacking 的研究中,对效应量语焉不详,可能意味着研究者过度关注获得统计显著性,而忽略了其他考量。
当研究结果与原始假设显著背离时,应当引发疑问。这可能表明研究者在收集数据后,为迎合结果而修改了假设或方法——这被称为HARKing(Hypothesizing After Results are Known,结果已知后再提出假设)。
例如,若某实验声称检验了特定假设,但最终分析却聚焦在无关变量或结局上,这就可能暗示 p-hacking。务必将陈述的假设与最终结果进行比对,确保二者一致。
异常高的效应量可能是 p-hacking 的红旗。现实世界中的效应往往是小到中等,尤其在心理学、医学或社会科学等领域。与判断样本量是否合适类似,判断效应量是否合理,也需要深厚的领域专长。
如果一项研究报告的效应量异常之大,可能意味着数据被选择性操纵,或者样本在某种程度上存在偏差。研究者可能有意或无意地排除了会降低效应量的数据,从而让结果看起来比实际更“亮眼”(这就是事后替换类的 p-hack)。
当报告的 p 值恰好低于显著性阈值(例如在以 p < 0.05 为显著性标准的研究中,p = 0.049),这可能表明研究者进行了 p-hacking。
因为通过反复运行检验或微调变量,确实可能偶然得到勉强跨过显著性门槛的结果。如果结果模式总是徘徊在显著性水平之下,可能意味着研究者在达到预期结果后便停止数据收集(早停),或进行了选择性报告(事后替换)。
最有力的 p-hacking 指标之一是研究结果不可复现。如果其他研究者用相同的方法无法复现研究结果,可能意味着原始发现源于 p-hacking 或选择性报告。
可复现性是科学诚信的基石,无法持续复现的结果,很可能意味着原始分析存在缺陷或被操纵。
将上述红旗反向思考,我们也能总结出预防 p-hacking 的做法。过去十年里,作为对可重复性危机的回应,这些做法已在科学共同体的讨论中逐渐兴起。
扎实的统计学原理理解,是预防 p-hacking 的关键。当分析人员具备必要知识,就能更好地避免常见陷阱,比如误解 p 值,或不当处理多重比较。
以网站功能的 A/B 测试为例,有素养的分析师会明白 p 值并非终点:即便检验得到较低的 p 值,效应量也可能并不大,从而缺乏实际意义。理解统计显著与实际显著的区别,能帮助分析师不过度聚焦 p 值,避免走向 p-hacking,也就降低了为获取“更好结果”而操纵结论的可能性。
在科学研究中,预注册是在收集任何数据之前,就将研究或测试计划(包括假设、方法与分析技术)进行书面明确。通过“锁定”分析的执行方式,这一过程可防止 p-hacking,避免事后为追求显著结果而更改分析。
在商业环境中,数据团队也可采取类似做法。例如,在运行实验以评估新定价模型的影响之前,团队可以预先记录并在内部声明假设,明确将要检验的变量(如收入、获客率)、显著性水平与样本量。这样可确保团队坚持原计划,不会在看到初步结果后更改分析,避免事后替换与只“挑好看数据”的做法。
开放科学指将数据、方法与分析对他人开放,以供审查与复现。在商业中,尽管未必直接使用“开放科学”这一术语,但类似的透明实践对保证分析的完整性同样重要。
例如,公司在开展市场分析时,可以在内部与其他团队、审计人员或相关利益方共享原始数据与分析步骤,或系统性地加以文档化以便未来复现。透明度会抑制 p-hacking,因为任何人都可以核查方法学中的不一致或缺陷。在组织内,对方法和结果的开放能促进问责,确保结论建立在扎实、可复现的数据之上。
数据准备与变换步骤应始终有充分理由。若缺乏清晰的理由,剔除离群值或变换变量就可能被用来操纵结果、构建虚假叙事。
例如,在分析客户购买数据时,分析师可能会剔除某些数据点(如极端离群值),因为它们与模型不契合。但若没有正当理由——例如将其识别为真正的异常而非正态分布的一部分——这就可能构成 p-hacking。为防止这种情况,所有数据准备步骤(如排除某些时间段或应用对数变换)都应在分析报告中明确说明,以确保透明。
除了统计显著性,还必须报告并解释效应量。这样才能确保结果在实际层面也有意义,而不是仅仅依赖在大样本条件下获得的统计显著性。
在商业中,设想一次 A/B 测试:新的产品描述让转化率提升了 0.5%,样本量足够大,使结果达到统计显著。如果没有上下文,这一变化可能被误判为重要。然而,若关注效应量并评估“0.5% 的提升是否值得更换所有产品描述的成本”,企业就能避免仅凭 p 值作出决策。
我们提到,在同一数据上反复运行相同(或不同)检验,可能偶然得到显著结果,因此被视为 p-hack。但实际上,如果——且仅当——结合了校正方法,多次在同一数据上运行相同检验,反而有助于预防并警惕 p-hacking。校正方法是针对多重比较进行调整的统计技术。最常见的两种方法是 Bonferroni 校正和 Benjamini–Hochberg(BH)程序。
Bonferroni 校正通过下调 p 值阈值(显著性水平)来实现,将其除以所进行检验的数量。尽管它能有效减少假阳性,但可能过于保守,从而增加假阴性。
相比之下,BH 程序属于控制错误发现率(FDR)的方法,旨在在两类错误之间取得平衡。简而言之,BH 程序先将多重检验得到的所有 p 值从小到大排序,然后将每个 p 值与随排名递增的阈值进行比较。找到仍低于其阈值的最大 p 值,并将其及之前的所有 p 值判为显著。
在商业情境中,如果公司测试多个落地页版本,人们往往倾向于反复运行 A/B 测试,并在某个版本看起来显著更优时停止。为避免这种情况,分析师可应用多重检验校正,确保显著性发现并非仅由重复测试所致。
最后,重要的是承认并报告不显著的结果,而不是将其弃之不顾。科学界已有呼吁:只要遵循严格、预注册的方法学,就应允许发表“不显著”的实验结果,因为“没有发现”的发现,依然是发现!商业领域也可秉持相似的智慧。
例如,如果一场营销活动对销售没有显著影响,公司也应报告并重视这一发现。它同样提供有效信息,并可防止偏颇的报告导致不合理的商业决策。对不显著结果保持开放,有助于更诚实的分析,避免为“展示成功”而操纵数据的诱惑。
本文深入探讨了 p-hacking 的世界,即 p 值如何容易受到操纵。我们审视了各种 p-hack、它们的识别方式以及如何加以预防。
正如您所见,也如文中所述,防范 p-hacking 的重要一环是具备扎实的统计学知识。您可以通过我们的多门统计课程来实现这一点,例如理论课程统计学入门,或实践课程:Google 表格中的统计学入门、Python 统计学入门以及R 统计学入门。
与 DataCamp 一起学习
课程
课程
实践并学习路径你的进步。
使用 Google 继续