Se hai mai lavorato con la statistica inferenziale, in particolare con il test d’ipotesi e la regressione, probabilmente ti hanno già presentato il p-value. E se hai mai lavorato con i p-value, sai, o almeno sospetti, che sono vulnerabili e possono essere manipolati, e avresti ragione.
Di fatto, questa manipolazione ha un nome dedicato: p-hacking. Talvolta viene anche chiamata data dredging, data snooping, data fishing e inflation bias. Ed è proprio questo l’argomento dell’articolo.
Cos’è un p-value?
Per prima cosa, rinfreschiamo velocemente la memoria su cos’è un p-value. La “p” di p-value sta per probabilità. In particolare, il p-value è la probabilità di osservare risultati tanto estremi quanto quelli ottenuti, assumendo che l’ipotesi nulla sia vera. Questo rigetto errato è anche chiamato errore di Tipo I, o falso positivo. In genere lo si calcola per confrontarlo con il livello di significatività (indicato con α), ovvero la probabilità tollerata di rigettare l’ipotesi nulla quando è vera.
Di conseguenza, se il p-value è maggiore del livello di significatività, non rigettiamo l’ipotesi nulla e la manteniamo. Al contrario, se il p-value è minore o uguale al livello di significatività, possiamo rigettare l’ipotesi nulla a favore dell’alternativa e, in tal caso, diciamo che i risultati sono statisticamente significativi.
Se qualcosa in questo breve ripasso sui p-value non ti è chiaro, non ti preoccupare! Puoi seguire il nostro corso teorico Introduzione alla statistica e acquisire rapidamente i fondamentali necessari.
Introduzione al p-hacking
Raggiungere risultati “statisticamente significativi” suona molto come un successo e, quindi, è allettante. Nel business, significherebbe avere qualcosa di nuovo, interessante o desiderabile da raccontare. In ambito accademico, significa aver scoperto qualcosa che poi può essere pubblicato sulle riviste.
E poiché è la chiave di tutto questo entusiasmo, i professionisti dei dati e i ricercatori sono tentati di concentrarsi eccessivamente sui p-value dei loro studi, trascurando il resto, persino il livello di significatività. Dato che per decenni il livello di significatività più comune è stato 0,05, è diventata una facile convenzione dire che, se raggiungi un p-value inferiore a 0,05, puoi toglierti il cappotto e festeggiare subito.
Di conseguenza, alcuni ricercatori cadono nella trappola del p-hacking, talvolta intenzionalmente, ma di solito in modo involontario, applicando metodi che possono abbassare il p-value fino a renderlo statisticamente significativo, nei casi in cui un test corretto avrebbe mostrato il contrario.
Come funziona il p-hacking
Che sia intenzionale o meno, ci sono molti modi in cui le cose possono andare storte portando al p-hacking. I metodi che conducono al p-hacking possono essere chiamati p-hack e possono verificarsi in qualsiasi fase degli esperimenti.
Nel loro capitolo The Myriad Forms of p-Hacking, Dorota Reis e Malte Friese propongono un elenco non esaustivo di p-hack nelle diverse fasi degli esperimenti, dalla raccolta dei dati fino al reporting, rappresentati nel grafico seguente.
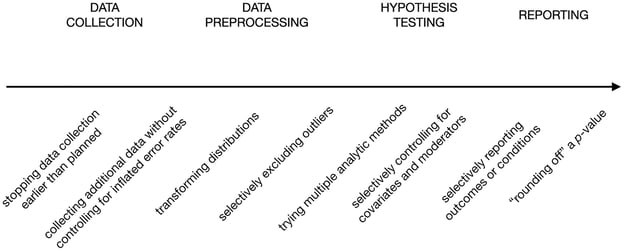
Esempi di p-hack. Fonte: Avoiding Questionable Research Practices in Applied Psychology.
Vediamo cosa significa ciascuno, da sinistra a destra:
- Interruzione opzionale (optional stopping): significa interrompere la raccolta dei dati quando gli individui raccolti portano a un p-value significativo, e non quando è soddisfatta la dimensione campionaria richiesta.
- Raccogliere dati aggiuntivi: è come un’estensione della pratica precedente. Raccogliere più dati può talvolta ridurre il p-value anche quando non c’è un vero effetto sottostante.
- Trasformazione delle distribuzioni: la trasformazione può essere una parte necessaria della preparazione dei dati, ma quando si provano più trasformazioni e si sceglie quella che porta a un p-value significativo, questo è p-hacking.
- Esclusione selettiva degli outlier: come per la trasformazione delle distribuzioni, gestire gli outlier è un passaggio essenziale nella preparazione dei dati e ci sono vari metodi per rilevarli ed escluderli. Quando si sceglie a posteriori il metodo che porta a significatività statistica, questo è p-hacking.
- Provare più metodi analitici: significa eseguire diversi tipi di test d’ipotesi e scegliere quello che porta a un risultato significativo.
- Modellazione multipla: provare diversi modelli di variabili e scegliere quello che porta alla significatività statistica, ignorando il ragionamento teorico di base dietro la scelta, è anch’esso p-hacking.
- Sostituzione post hoc: significa sostituire o ignorare un insieme di punti dati o condizioni che producono un p-value maggiore, sia tra un giro e l’altro di test d’ipotesi sia in fase di reporting dei risultati.
- Arrotondare un p-value: questo è il p-hack più palese perché consiste nell’arrotondare il p-value quando è leggermente sopra il livello di significatività; quindi non raggiunge nemmeno davvero un p-value manipolato statisticamente significativo, ma finge di farlo.
Nota che la maggior parte di questi p-hack dipende dal ripetere l’esperimento più e più volte, modificando ogni volta ciò che dovrebbe essere una base predefinita dell’esperimento.
Ma anche senza modifiche, il semplice ripetere lo stesso esperimento e riportare il risultato solo quando è statisticamente significativo può essere p-hacking, perché c’è sempre la possibilità che, se un esperimento viene eseguito abbastanza volte, restituisca prima o poi un p-value basso. Il fumetto qui sotto di xkcd illustra questa idea.
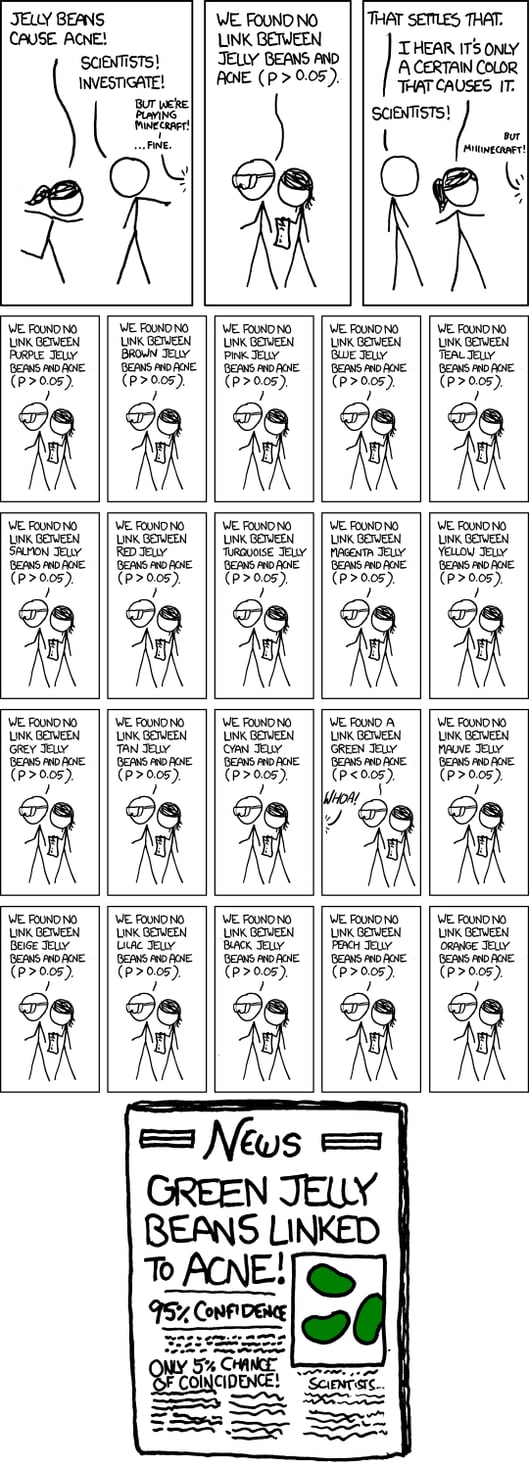
Fumetto “Significant”. Fonte: xkcd.
Esempi reali di p-hacking
Il p-hacking è un fenomeno molto diffuso. All’inizio degli anni 2010, molte rassegne hanno iniziato a scoprire che una grande percentuale della ricerca pubblicata su riviste autorevoli in vari campi è probabilmente frutto di p-hacking, soprattutto nei campi della psicologia e della medicina, ma anche nelle scienze sociali e nelle discipline umanistiche.
Per esempio, nel 2015, uno studio guidato da un accademico dell’Università della Virginia che ha rivisto 100 studi di psicologia pubblicati sulle principali riviste nel 2008 ha scoperto che meno della metà di questi studi era replicabile. La mancanza di riproducibilità significa che gli studi, se ripetuti, non portano allo stesso risultato, a volte a causa del p-hacking.
Un altro progetto che ha esaminato studi sul cancro ha rilevato che solo 50 esperimenti su 193 sono replicabili. Ancora prima, nel 2009, uno studio ha osservato un numero sospetto di esperimenti nel campo delle neuroscienze che riportavano correlazioni insolitamente elevate tra emozioni, personalità, cognizione sociale e attività cerebrale tramite fMRI. Dopo aver intervistato gli autori di questi esperimenti, è emerso che si basavano su una strategia di scelta selettiva di sottoinsiemi di dati e riportavano solo quelli che davano un risultato significativo: un p-hack simile a ciò che abbiamo chiamato sostituzione post hoc.
Le scoperte di queste rassegne hanno messo in luce come il p-hacking, insieme ad altre pratiche discutibili, stia rendendo instabili e piene di falle le basi della ricerca scientifica a lungo rispettata. Una crisi chiamata crisi di replicabilità, che è tuttora in corso tra molte discussioni e sforzi per uscirne.
Perché il p-hacking è non etico
Dunque, perché il p-hacking è un problema?
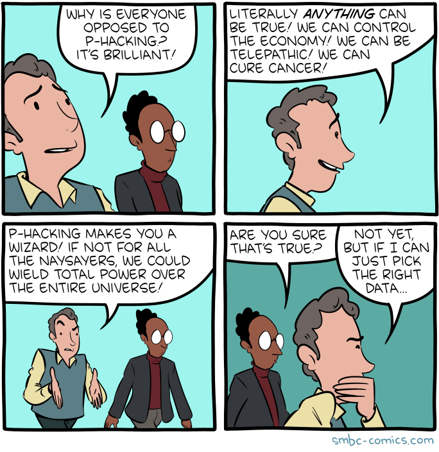
“P-hacking makes you a wizard”. Fonte: SMBC Comics.
La domanda può sembrare troppo ovvia, ma analizzare i motivi per cui il p-hacking è sbagliato e non etico ci aiuta anche a capire meglio la “significatività” del problema della significatività falsificata.
Semplicemente, è manipolatorio
Alla base, il p-hacking non è altro che il risultato di manipolare la metodologia o i risultati. Se fatto intenzionalmente, equivale semplicemente a mentire senza altra ragione se non il tornaconto personale (come farsi pubblicare o riconoscere). Se fatto involontariamente, è come imboccare la strada sbagliata e arrivare infine solo al miraggio dei falsi positivi.
Può portare a decisioni errate e conseguenze disastrose
Gli esperimenti, sia nel mondo scientifico sia nel business, hanno conseguenze. Si fanno per prendere decisioni o per costruire ulteriormente sui risultati. Se i risultati sono fabbricati, le decisioni dipendenti saranno infondate e, a volte, ciò può portare a conseguenze disastrose.
Per esempio, le ricerche in ambiti sensibili come oncologia e neurologia possono contribuire collettivamente allo sviluppo di terapie e farmaci. Sarebbe un disastro se parte della ricerca fondativa fosse manipolata.
Nel business, le decisioni sbagliate possono andare in molte direzioni: dal lancio di un prodotto destinato a fallire, allo spreco di risorse, al licenziamento di qualcuno, fino alla bancarotta. Un semplice p-hack può creare un effetto farfalla.
Erode la fiducia nel metodo scientifico
La crisi di replicabilità ha portato a ampio scetticismo sulla scienza nel suo complesso, espresso persino nel discorso politico. Sebbene il pensiero critico sia sempre utile anche nel ricevere risultati scientifici, respingere ogni riscontro empirico può portare a una disperazione di ignoranza e decisioni infondate.
Nel business, su scala minore, il p-hacking e pratiche simili possono spingere i leader a tornare indietro dalle decisioni data-driven, facendo affidamento solo su intuito e sensazioni — esattamente il contrario di ciò che la data science nel suo complesso promette e può effettivamente offrire.
Scuote la natura cumulativa della conoscenza
La conoscenza umana si basa sulla sua natura cumulativa. Ogni piccolo esperimento è un mattone che spiana la strada a una struttura conoscitiva più grande. Quando un numero crescente di questi mattoni diventa instabile a causa di pratiche discutibili come il p-hacking, il potenziale di tale accumulo diventa sfortunato. Persino la semplice pratica di trovare letteratura pregressa su cui costruire un nuovo esperimento diventa una missione insidiosa, come trovare un percorso in un campo minato.
Campanelli d’allarme e come rilevare il p-hacking
Sulla base di ciò che ora sappiamo del p-hacking e dei suoi metodi, possiamo dedurre alcuni campanelli d’allarme che aiutano a rilevarlo. La maggior parte di questi segnali richiede comunque una mente curiosa, pensiero critico e occhi attenti. Alcuni dipendono persino da un’ampia conoscenza del dominio.
Risultati eccessivamente sensazionalistici
Risultati sensazionalistici sono di solito troppo sospetti per essere accettati senza riserve. Di solito ripresi da stampa e social, studi che dichiarano cose come “il cioccolato può portare a perdere peso” non sembrano pronti per essere presi per buoni.
Nel business, un test che promette un aumento del profitto del 100% grazie all’introduzione di una piccola funzionalità su un sito può essere considerato ugualmente sensazionalistico.
Di fronte a tali studi, se ti riguardano, verifica sempre due volte metodologia e risultati prima di accettarne le conclusioni.
Scarsa trasparenza nella metodologia
Attenzione agli esperimenti che non sono chiari sulla loro metodologia o che non dichiarano alcune componenti metodologiche. Essere aperti su ipotesi iniziali, livello di significatività, dimensione del campione, variabili raccolte, tipo di test scelto e passi di preparazione dei dati è essenziale per una procedura scientifica solida. L’oscurità su uno qualsiasi di questi elementi è un campanello d’allarme.
Se la preparazione dei dati dell’esperimento include trasformazioni di variabili, verifica due volte il motivo della misura: la giustificazione dovrebbe essere dichiarata. Se non lo è, o non è convincente, questo può indicare direttamente p-hacking.
Campione troppo piccolo e non giustificato
Un campione piccolo riduce la potenza statistica dello studio, aumentando il rischio di falsi negativi. Tuttavia, se combinato con reporting selettivo o p-hacking, anche studi a bassa potenza possono contribuire a un tasso più alto di falsi positivi nella letteratura pubblicata.
In alcuni domini, piccole dimensioni campionarie sono accettabili e comuni, come nella ricerca clinica, negli studi ambientali, nell’ingegneria e nel controllo qualità. Ma in generale, campioni più grandi portano a inferenze migliori e quindi a minore probabilità di falsi positivi e p-value non veritieri.
In ogni caso, se un campione piccolo non è giustificato, ciò può indicare mancanza di potenza statistica, che aumenta il rischio di falsi positivi. In alcuni casi può anche suggerire un’interruzione anticipata, la pratica specifica di p-hacking citata prima, in cui la raccolta dati termina una volta raggiunta la significatività anziché quando si è raggiunta la dimensione campionaria pianificata.
Effect size poco chiaro
L’effect size misura l’intensità o l’ampiezza della relazione tra variabili, fornendo contesto alla significatività statistica di un risultato. Se uno studio riporta significatività statistica ma non fornisce un effect size chiaro o significativo, suscita sospetti.
Un p-value può indicare che il risultato è poco probabile per caso, ma senza un effect size è difficile determinarne la rilevanza pratica. Negli studi frutto di p-hacking, l’assenza di chiarezza sull’effect size può indicare che i ricercatori si sono concentrati troppo sull’ottenere la significatività statistica, a prescindere da altre considerazioni
Incoerenza tra ipotesi dichiarata e risultato
Quando i risultati di uno studio deviano significativamente dall’ipotesi originaria, dovrebbero sorgere domande. Potrebbe essere il segno che i ricercatori hanno modificato ipotesi o metodi dopo aver raccolto i dati per adattarli ai risultati — una pratica conosciuta come HARKing (Hypothesizing After Results are Known).
Per esempio, se un esperimento sostiene di aver testato un’ipotesi specifica ma l’analisi finale sembra concentrarsi su variabili o risultati non correlati, ciò può suggerire p-hacking. Confronta sempre l’ipotesi dichiarata con i risultati finali per verificare che siano allineati.
Effect size insolitamente elevato
Un effect size insolitamente alto può essere un campanello d’allarme per p-hacking. In molti casi, gli effetti reali sono piccoli o moderati, specialmente in campi come psicologia, medicina o scienze sociali. Come per la valutazione della dimensione campionaria, capire la plausibilità di un effect size richiede notevole competenza di dominio.
Se uno studio riporta un effect size insolitamente grande, potrebbe indicare che i dati sono stati selezionati in modo manipolatorio o che il campione è in qualche modo distorto. I ricercatori potrebbero escludere consapevolmente o inconsapevolmente dati che ridurrebbero l’effect size, per far sembrare i risultati più impressionanti di quanto non siano davvero (il p-hack della sostituzione post hoc).
Un p-value appena sotto il livello di significatività
Quando il p-value riportato è appena sotto la soglia di significatività (ad esempio, p = 0,049 in uno studio dove p < 0,05 è il cutoff per la significatività), potrebbe indicare che i ricercatori hanno fatto p-hacking.
Questo perché eseguire ripetutamente test o modificare variabili può portare, per caso, a un risultato che supera di poco la soglia. Un pattern di risultati che gravitano costantemente appena sotto la soglia suggerisce che i ricercatori potrebbero aver interrotto la raccolta dati una volta ottenuto il risultato desiderato (interruzione anticipata) o aver riportato selettivamente alcune analisi (sostituzione post hoc).
Non replicabilità
Uno degli indicatori più forti di p-hacking è quando i risultati di uno studio non sono replicabili. Se ricercatori indipendenti non riescono a replicare i risultati usando la stessa metodologia, potrebbe significare che i risultati originali sono frutto di p-hacking o reporting selettivo.
La replicabilità è un pilastro dell’integrità scientifica e risultati che non possono essere riprodotti in modo consistente suggeriscono che l’analisi originale fosse viziata o manipolata.
Segnali positivi e come prevenire il p-hacking
Ribaltando i campanelli d’allarme sopra, possiamo anche individuare modi per prevenire il p-hacking. Questi approcci sono già emersi nel dibattito della comunità scientifica nell’ultimo decennio come risposta alla crisi di replicabilità.
Conoscenza statistica
Una solida comprensione dei principi statistici è essenziale per prevenire il p-hacking. Quando gli analisti hanno le conoscenze necessarie, sono più attrezzati per evitare trappole comuni, come interpretare male i p-value o gestire in modo improprio i confronti multipli.
Per esempio, nell’A/B testing per una funzionalità di un sito, un analista informato capirà che il p-value non è l’obiettivo finale: anche se il test produce un p-value basso, potrebbe comunque avere un effect size non abbastanza grande e quindi nessuna rilevanza pratica. Capire la differenza tra significatività statistica e pratica aiuta gli analisti a non concentrarsi troppo sul p-value, evitando pratiche di p-hacking e riducendo la probabilità di manipolare i risultati per ottenere un esito più favorevole.
Pre-registrazione
La pre-registrazione nella ricerca scientifica consiste nel delineare il piano di ricerca o di test, comprese ipotesi, metodi e tecniche di analisi, prima di raccogliere qualsiasi dato. Questo processo previene il p-hacking perché vincola in anticipo le decisioni su come verrà condotta l’analisi, rendendo più difficile modificarla a posteriori per ottenere un risultato significativo.
Nel business, pratiche simili possono essere adottate anche a livello di team dati. Per esempio, prima di eseguire un esperimento per misurare l’impatto di un nuovo modello di pricing, il team può pre-documentare e dichiarare internamente l’ipotesi, specificando le variabili che saranno testate (ad es., ricavi, tasso di acquisizione clienti), il livello di significatività e la dimensione campionaria. Questo assicura che il team resti fedele al piano originale e non cambi l’analisi dopo aver visto i risultati iniziali, evitando pratiche di sostituzione post hoc e di selezione dei soli dati con esito favorevole.
Open science
Per open science si intende rendere disponibili dati, metodi e analisi per la revisione e la replica da parte di altri. Nel business, anche se il termine "open science" potrebbe non essere usato direttamente, pratiche simili di trasparenza sono importanti per garantire l’integrità delle analisi.
Per esempio, un’azienda che conduce un’analisi di mercato può condividere i dati grezzi e i passaggi analitici internamente con altri team, auditor o stakeholder interessati, o documentarli sistematicamente per repliche future. Questa trasparenza scoraggia il p-hacking, perché chiunque può verificare discrepanze o difetti metodologici. In un’organizzazione, essere aperti su metodi e risultati favorisce la responsabilità e aiuta a garantire che le conclusioni derivino da dati solidi e riproducibili.
I passaggi di preparazione e trasformazione dei dati dovrebbero essere sempre ben giustificati. Senza una chiara giustificazione, rimuovere outlier o trasformare variabili può essere usato per manipolare i risultati e creare una narrazione falsa.
Per esempio, analizzando i dati di acquisto dei clienti, un analista potrebbe escludere alcuni punti (ad es., outlier estremi) che non sembrano adattarsi al modello. Tuttavia, senza una ragione valida — come identificarli come vere anomalie piuttosto che parte della distribuzione normale — ciò potrebbe essere una forma di p-hacking. Per prevenirlo, ogni passaggio di preparazione (come escludere certi periodi o applicare trasformazioni logaritmiche) dovrebbe essere esplicitamente giustificato nel report, garantendo trasparenza.
Dichiarare e considerare l’effect size
Oltre alla significatività statistica, è fondamentale riportare e interpretare gli effect size. Questo assicura che i risultati siano significativi in termini pratici e non solo “gonfiati” dalla significatività dovuta a grandi campioni.
Nel business, considera un A/B test in cui una nuova descrizione prodotto aumenta i tassi di conversione dello 0,5%, ma la dimensione del campione è abbastanza grande da rendere il risultato statisticamente significativo. Senza contesto, questa variazione potrebbe essere interpretata come rilevante. Tuttavia, concentrandosi sull’effect size e chiedendosi se uno 0,5% giustifica il costo di cambiare tutte le descrizioni, le aziende evitano decisioni basate solo sui p-value.
Consentire più esecuzioni dell’esperimento, ma con metodi di correzione
Abbiamo detto che eseguire lo stesso test (o test diversi) sugli stessi dati può portare a un risultato significativo per caso e, quindi, lo abbiamo considerato p-hacking. Ma in realtà ripetere lo stesso test sugli stessi dati più volte può essere una buona misura per prevenire e tenere a bada il p-hacking, se — e solo se — è combinato con metodi di correzione, ovvero tecniche statistiche che aggiustano per il fatto che si effettuano confronti multipli. I due metodi di correzione più comuni sono la correzione di Bonferroni e la procedura di Benjamini–Hochberg (BH).
La Bonferroni prevede di abbassare la soglia del p-value (il livello di significatività) dividendola per il numero di test eseguiti. Pur riducendo efficacemente la probabilità di falsi positivi, può essere eccessivamente conservativa, aumentando il rischio di falsi negativi.
Al contrario, la procedura BH è una delle tecniche di controllo del False Discovery Rate (FDR) che mirano a bilanciare la probabilità dei due tipi di errore. In breve, la BH ordina innanzitutto tutti i p-value dei test multipli dal più piccolo al più grande. Ogni p-value viene poi confrontato con una soglia che aumenta con il suo rango. Si identifica il p-value più grande che è ancora sotto la sua soglia e tutti i p-value fino a quel punto sono considerati significativi.
In un contesto business, se un’azienda testa diverse versioni di una landing page, è allettante eseguire molti A/B test e fermarsi quando una versione sembra andare significativamente meglio. Per evitarlo, l’analista può applicare correzioni per tenere conto dei test multipli. In questo modo si assicura che le evidenze significative non siano solo il risultato dei ripetuti tentativi.
Considerare i risultati non significativi
Infine, è importante riconoscere e riportare i risultati non significativi anziché scartarli. La comunità scientifica ha da tempo proposto di pubblicare esperimenti con risultati non significativi purché seguano una metodologia rigorosa e preregistrata, perché la scoperta di una non scoperta è pur sempre una scoperta! Una saggezza simile si applica nel business.
Per esempio, se una campagna marketing non ha un impatto significativo sulle vendite, un’azienda dovrebbe comunque riportare e considerare questo risultato. Fornisce informazioni preziose e impedisce un reporting distorto che potrebbe portare a decisioni aziendali ingiustificate. Essere aperti sui risultati non significativi contribuisce a un’analisi più onesta ed evita la tentazione di manipolare i dati per mostrare un successo.
Conclusione
In questo articolo abbiamo esplorato a fondo il mondo del p-hacking, dove il p-value può essere vulnerabile alla manipolazione. Abbiamo visto i vari p-hack, come possono essere rilevati e come possono essere prevenuti.
Come vedi, e come abbiamo detto, una parte fondamentale della consapevolezza sul p-hacking è possedere solide conoscenze statistiche. Puoi acquisirle tramite i nostri vari corsi di statistica, come il corso teorico Introduzione alla statistica, o i corsi pratici Introduzione alla statistica in Google Sheets, Introduzione alla statistica in Python e Introduzione alla statistica in R.



 Abid Ali Awan• 10 min


 Tim Lu• 12 min
Se hai mai lavorato con la statistica inferenziale, in particolare con il test d’ipotesi e la regressione, probabilmente ti hanno già presentato il p-value. E se hai mai lavorato con i p-value, sai, o almeno sospetti, che sono vulnerabili e possono essere manipolati, e avresti ragione.
Di fatto, questa manipolazione ha un nome dedicato: p-hacking. Talvolta viene anche chiamata data dredging, data snooping, data fishing e inflation bias. Ed è proprio questo l’argomento dell’articolo.
Cos’è un p-value?
Per prima cosa, rinfreschiamo velocemente la memoria su cos’è un p-value. La “p” di p-value sta per probabilità. In particolare, il p-value è la probabilità di osservare risultati tanto estremi quanto quelli ottenuti, assumendo che l’ipotesi nulla sia vera. Questo rigetto errato è anche chiamato errore di Tipo I, o falso positivo. In genere lo si calcola per confrontarlo con il livello di significatività (indicato con α), ovvero la probabilità tollerata di rigettare l’ipotesi nulla quando è vera.
Di conseguenza, se il p-value è maggiore del livello di significatività, non rigettiamo l’ipotesi nulla e la manteniamo. Al contrario, se il p-value è minore o uguale al livello di significatività, possiamo rigettare l’ipotesi nulla a favore dell’alternativa e, in tal caso, diciamo che i risultati sono statisticamente significativi.
Se qualcosa in questo breve ripasso sui p-value non ti è chiaro, non ti preoccupare! Puoi seguire il nostro corso teorico Introduzione alla statistica e acquisire rapidamente i fondamentali necessari.
Introduzione al p-hacking
Raggiungere risultati “statisticamente significativi” suona molto come un successo e, quindi, è allettante. Nel business, significherebbe avere qualcosa di nuovo, interessante o desiderabile da raccontare. In ambito accademico, significa aver scoperto qualcosa che poi può essere pubblicato sulle riviste.
E poiché è la chiave di tutto questo entusiasmo, i professionisti dei dati e i ricercatori sono tentati di concentrarsi eccessivamente sui p-value dei loro studi, trascurando il resto, persino il livello di significatività. Dato che per decenni il livello di significatività più comune è stato 0,05, è diventata una facile convenzione dire che, se raggiungi un p-value inferiore a 0,05, puoi toglierti il cappotto e festeggiare subito.
Di conseguenza, alcuni ricercatori cadono nella trappola del p-hacking, talvolta intenzionalmente, ma di solito in modo involontario, applicando metodi che possono abbassare il p-value fino a renderlo statisticamente significativo, nei casi in cui un test corretto avrebbe mostrato il contrario.
Come funziona il p-hacking
Che sia intenzionale o meno, ci sono molti modi in cui le cose possono andare storte portando al p-hacking. I metodi che conducono al p-hacking possono essere chiamati p-hack e possono verificarsi in qualsiasi fase degli esperimenti.
Nel loro capitolo The Myriad Forms of p-Hacking, Dorota Reis e Malte Friese propongono un elenco non esaustivo di p-hack nelle diverse fasi degli esperimenti, dalla raccolta dei dati fino al reporting, rappresentati nel grafico seguente.
Esempi di p-hack. Fonte: Avoiding Questionable Research Practices in Applied Psychology.
Vediamo cosa significa ciascuno, da sinistra a destra:
Nota che la maggior parte di questi p-hack dipende dal ripetere l’esperimento più e più volte, modificando ogni volta ciò che dovrebbe essere una base predefinita dell’esperimento.
Ma anche senza modifiche, il semplice ripetere lo stesso esperimento e riportare il risultato solo quando è statisticamente significativo può essere p-hacking, perché c’è sempre la possibilità che, se un esperimento viene eseguito abbastanza volte, restituisca prima o poi un p-value basso. Il fumetto qui sotto di xkcd illustra questa idea.
Fumetto “Significant”. Fonte: xkcd.
Esempi reali di p-hacking
Il p-hacking è un fenomeno molto diffuso. All’inizio degli anni 2010, molte rassegne hanno iniziato a scoprire che una grande percentuale della ricerca pubblicata su riviste autorevoli in vari campi è probabilmente frutto di p-hacking, soprattutto nei campi della psicologia e della medicina, ma anche nelle scienze sociali e nelle discipline umanistiche.
Per esempio, nel 2015, uno studio guidato da un accademico dell’Università della Virginia che ha rivisto 100 studi di psicologia pubblicati sulle principali riviste nel 2008 ha scoperto che meno della metà di questi studi era replicabile. La mancanza di riproducibilità significa che gli studi, se ripetuti, non portano allo stesso risultato, a volte a causa del p-hacking.
Un altro progetto che ha esaminato studi sul cancro ha rilevato che solo 50 esperimenti su 193 sono replicabili. Ancora prima, nel 2009, uno studio ha osservato un numero sospetto di esperimenti nel campo delle neuroscienze che riportavano correlazioni insolitamente elevate tra emozioni, personalità, cognizione sociale e attività cerebrale tramite fMRI. Dopo aver intervistato gli autori di questi esperimenti, è emerso che si basavano su una strategia di scelta selettiva di sottoinsiemi di dati e riportavano solo quelli che davano un risultato significativo: un p-hack simile a ciò che abbiamo chiamato sostituzione post hoc.
Le scoperte di queste rassegne hanno messo in luce come il p-hacking, insieme ad altre pratiche discutibili, stia rendendo instabili e piene di falle le basi della ricerca scientifica a lungo rispettata. Una crisi chiamata crisi di replicabilità, che è tuttora in corso tra molte discussioni e sforzi per uscirne.
Perché il p-hacking è non etico
Dunque, perché il p-hacking è un problema?
“P-hacking makes you a wizard”. Fonte: SMBC Comics.
La domanda può sembrare troppo ovvia, ma analizzare i motivi per cui il p-hacking è sbagliato e non etico ci aiuta anche a capire meglio la “significatività” del problema della significatività falsificata.
Semplicemente, è manipolatorio
Alla base, il p-hacking non è altro che il risultato di manipolare la metodologia o i risultati. Se fatto intenzionalmente, equivale semplicemente a mentire senza altra ragione se non il tornaconto personale (come farsi pubblicare o riconoscere). Se fatto involontariamente, è come imboccare la strada sbagliata e arrivare infine solo al miraggio dei falsi positivi.
Può portare a decisioni errate e conseguenze disastrose
Gli esperimenti, sia nel mondo scientifico sia nel business, hanno conseguenze. Si fanno per prendere decisioni o per costruire ulteriormente sui risultati. Se i risultati sono fabbricati, le decisioni dipendenti saranno infondate e, a volte, ciò può portare a conseguenze disastrose.
Per esempio, le ricerche in ambiti sensibili come oncologia e neurologia possono contribuire collettivamente allo sviluppo di terapie e farmaci. Sarebbe un disastro se parte della ricerca fondativa fosse manipolata.
Nel business, le decisioni sbagliate possono andare in molte direzioni: dal lancio di un prodotto destinato a fallire, allo spreco di risorse, al licenziamento di qualcuno, fino alla bancarotta. Un semplice p-hack può creare un effetto farfalla.
Erode la fiducia nel metodo scientifico
La crisi di replicabilità ha portato a ampio scetticismo sulla scienza nel suo complesso, espresso persino nel discorso politico. Sebbene il pensiero critico sia sempre utile anche nel ricevere risultati scientifici, respingere ogni riscontro empirico può portare a una disperazione di ignoranza e decisioni infondate.
Nel business, su scala minore, il p-hacking e pratiche simili possono spingere i leader a tornare indietro dalle decisioni data-driven, facendo affidamento solo su intuito e sensazioni — esattamente il contrario di ciò che la data science nel suo complesso promette e può effettivamente offrire.
Scuote la natura cumulativa della conoscenza
La conoscenza umana si basa sulla sua natura cumulativa. Ogni piccolo esperimento è un mattone che spiana la strada a una struttura conoscitiva più grande. Quando un numero crescente di questi mattoni diventa instabile a causa di pratiche discutibili come il p-hacking, il potenziale di tale accumulo diventa sfortunato. Persino la semplice pratica di trovare letteratura pregressa su cui costruire un nuovo esperimento diventa una missione insidiosa, come trovare un percorso in un campo minato.
Campanelli d’allarme e come rilevare il p-hacking
Sulla base di ciò che ora sappiamo del p-hacking e dei suoi metodi, possiamo dedurre alcuni campanelli d’allarme che aiutano a rilevarlo. La maggior parte di questi segnali richiede comunque una mente curiosa, pensiero critico e occhi attenti. Alcuni dipendono persino da un’ampia conoscenza del dominio.
Risultati eccessivamente sensazionalistici
Risultati sensazionalistici sono di solito troppo sospetti per essere accettati senza riserve. Di solito ripresi da stampa e social, studi che dichiarano cose come “il cioccolato può portare a perdere peso” non sembrano pronti per essere presi per buoni.
Nel business, un test che promette un aumento del profitto del 100% grazie all’introduzione di una piccola funzionalità su un sito può essere considerato ugualmente sensazionalistico.
Di fronte a tali studi, se ti riguardano, verifica sempre due volte metodologia e risultati prima di accettarne le conclusioni.
Scarsa trasparenza nella metodologia
Attenzione agli esperimenti che non sono chiari sulla loro metodologia o che non dichiarano alcune componenti metodologiche. Essere aperti su ipotesi iniziali, livello di significatività, dimensione del campione, variabili raccolte, tipo di test scelto e passi di preparazione dei dati è essenziale per una procedura scientifica solida. L’oscurità su uno qualsiasi di questi elementi è un campanello d’allarme.
Trasformazioni dei dati non necessarie
Se la preparazione dei dati dell’esperimento include trasformazioni di variabili, verifica due volte il motivo della misura: la giustificazione dovrebbe essere dichiarata. Se non lo è, o non è convincente, questo può indicare direttamente p-hacking.
Campione troppo piccolo e non giustificato
Un campione piccolo riduce la potenza statistica dello studio, aumentando il rischio di falsi negativi. Tuttavia, se combinato con reporting selettivo o p-hacking, anche studi a bassa potenza possono contribuire a un tasso più alto di falsi positivi nella letteratura pubblicata.
In alcuni domini, piccole dimensioni campionarie sono accettabili e comuni, come nella ricerca clinica, negli studi ambientali, nell’ingegneria e nel controllo qualità. Ma in generale, campioni più grandi portano a inferenze migliori e quindi a minore probabilità di falsi positivi e p-value non veritieri.
In ogni caso, se un campione piccolo non è giustificato, ciò può indicare mancanza di potenza statistica, che aumenta il rischio di falsi positivi. In alcuni casi può anche suggerire un’interruzione anticipata, la pratica specifica di p-hacking citata prima, in cui la raccolta dati termina una volta raggiunta la significatività anziché quando si è raggiunta la dimensione campionaria pianificata.
Effect size poco chiaro
L’effect size misura l’intensità o l’ampiezza della relazione tra variabili, fornendo contesto alla significatività statistica di un risultato. Se uno studio riporta significatività statistica ma non fornisce un effect size chiaro o significativo, suscita sospetti.
Un p-value può indicare che il risultato è poco probabile per caso, ma senza un effect size è difficile determinarne la rilevanza pratica. Negli studi frutto di p-hacking, l’assenza di chiarezza sull’effect size può indicare che i ricercatori si sono concentrati troppo sull’ottenere la significatività statistica, a prescindere da altre considerazioni
Incoerenza tra ipotesi dichiarata e risultato
Quando i risultati di uno studio deviano significativamente dall’ipotesi originaria, dovrebbero sorgere domande. Potrebbe essere il segno che i ricercatori hanno modificato ipotesi o metodi dopo aver raccolto i dati per adattarli ai risultati — una pratica conosciuta come HARKing (Hypothesizing After Results are Known).
Per esempio, se un esperimento sostiene di aver testato un’ipotesi specifica ma l’analisi finale sembra concentrarsi su variabili o risultati non correlati, ciò può suggerire p-hacking. Confronta sempre l’ipotesi dichiarata con i risultati finali per verificare che siano allineati.
Effect size insolitamente elevato
Un effect size insolitamente alto può essere un campanello d’allarme per p-hacking. In molti casi, gli effetti reali sono piccoli o moderati, specialmente in campi come psicologia, medicina o scienze sociali. Come per la valutazione della dimensione campionaria, capire la plausibilità di un effect size richiede notevole competenza di dominio.
Se uno studio riporta un effect size insolitamente grande, potrebbe indicare che i dati sono stati selezionati in modo manipolatorio o che il campione è in qualche modo distorto. I ricercatori potrebbero escludere consapevolmente o inconsapevolmente dati che ridurrebbero l’effect size, per far sembrare i risultati più impressionanti di quanto non siano davvero (il p-hack della sostituzione post hoc).
Un p-value appena sotto il livello di significatività
Quando il p-value riportato è appena sotto la soglia di significatività (ad esempio, p = 0,049 in uno studio dove p < 0,05 è il cutoff per la significatività), potrebbe indicare che i ricercatori hanno fatto p-hacking.
Questo perché eseguire ripetutamente test o modificare variabili può portare, per caso, a un risultato che supera di poco la soglia. Un pattern di risultati che gravitano costantemente appena sotto la soglia suggerisce che i ricercatori potrebbero aver interrotto la raccolta dati una volta ottenuto il risultato desiderato (interruzione anticipata) o aver riportato selettivamente alcune analisi (sostituzione post hoc).
Non replicabilità
Uno degli indicatori più forti di p-hacking è quando i risultati di uno studio non sono replicabili. Se ricercatori indipendenti non riescono a replicare i risultati usando la stessa metodologia, potrebbe significare che i risultati originali sono frutto di p-hacking o reporting selettivo.
La replicabilità è un pilastro dell’integrità scientifica e risultati che non possono essere riprodotti in modo consistente suggeriscono che l’analisi originale fosse viziata o manipolata.
Segnali positivi e come prevenire il p-hacking
Ribaltando i campanelli d’allarme sopra, possiamo anche individuare modi per prevenire il p-hacking. Questi approcci sono già emersi nel dibattito della comunità scientifica nell’ultimo decennio come risposta alla crisi di replicabilità.
Conoscenza statistica
Una solida comprensione dei principi statistici è essenziale per prevenire il p-hacking. Quando gli analisti hanno le conoscenze necessarie, sono più attrezzati per evitare trappole comuni, come interpretare male i p-value o gestire in modo improprio i confronti multipli.
Per esempio, nell’A/B testing per una funzionalità di un sito, un analista informato capirà che il p-value non è l’obiettivo finale: anche se il test produce un p-value basso, potrebbe comunque avere un effect size non abbastanza grande e quindi nessuna rilevanza pratica. Capire la differenza tra significatività statistica e pratica aiuta gli analisti a non concentrarsi troppo sul p-value, evitando pratiche di p-hacking e riducendo la probabilità di manipolare i risultati per ottenere un esito più favorevole.
Pre-registrazione
La pre-registrazione nella ricerca scientifica consiste nel delineare il piano di ricerca o di test, comprese ipotesi, metodi e tecniche di analisi, prima di raccogliere qualsiasi dato. Questo processo previene il p-hacking perché vincola in anticipo le decisioni su come verrà condotta l’analisi, rendendo più difficile modificarla a posteriori per ottenere un risultato significativo.
Nel business, pratiche simili possono essere adottate anche a livello di team dati. Per esempio, prima di eseguire un esperimento per misurare l’impatto di un nuovo modello di pricing, il team può pre-documentare e dichiarare internamente l’ipotesi, specificando le variabili che saranno testate (ad es., ricavi, tasso di acquisizione clienti), il livello di significatività e la dimensione campionaria. Questo assicura che il team resti fedele al piano originale e non cambi l’analisi dopo aver visto i risultati iniziali, evitando pratiche di sostituzione post hoc e di selezione dei soli dati con esito favorevole.
Open science
Per open science si intende rendere disponibili dati, metodi e analisi per la revisione e la replica da parte di altri. Nel business, anche se il termine "open science" potrebbe non essere usato direttamente, pratiche simili di trasparenza sono importanti per garantire l’integrità delle analisi.
Per esempio, un’azienda che conduce un’analisi di mercato può condividere i dati grezzi e i passaggi analitici internamente con altri team, auditor o stakeholder interessati, o documentarli sistematicamente per repliche future. Questa trasparenza scoraggia il p-hacking, perché chiunque può verificare discrepanze o difetti metodologici. In un’organizzazione, essere aperti su metodi e risultati favorisce la responsabilità e aiuta a garantire che le conclusioni derivino da dati solidi e riproducibili.
Giustificare scelte nella preparazione e trasformazione dei dati
I passaggi di preparazione e trasformazione dei dati dovrebbero essere sempre ben giustificati. Senza una chiara giustificazione, rimuovere outlier o trasformare variabili può essere usato per manipolare i risultati e creare una narrazione falsa.
Per esempio, analizzando i dati di acquisto dei clienti, un analista potrebbe escludere alcuni punti (ad es., outlier estremi) che non sembrano adattarsi al modello. Tuttavia, senza una ragione valida — come identificarli come vere anomalie piuttosto che parte della distribuzione normale — ciò potrebbe essere una forma di p-hacking. Per prevenirlo, ogni passaggio di preparazione (come escludere certi periodi o applicare trasformazioni logaritmiche) dovrebbe essere esplicitamente giustificato nel report, garantendo trasparenza.
Dichiarare e considerare l’effect size
Oltre alla significatività statistica, è fondamentale riportare e interpretare gli effect size. Questo assicura che i risultati siano significativi in termini pratici e non solo “gonfiati” dalla significatività dovuta a grandi campioni.
Nel business, considera un A/B test in cui una nuova descrizione prodotto aumenta i tassi di conversione dello 0,5%, ma la dimensione del campione è abbastanza grande da rendere il risultato statisticamente significativo. Senza contesto, questa variazione potrebbe essere interpretata come rilevante. Tuttavia, concentrandosi sull’effect size e chiedendosi se uno 0,5% giustifica il costo di cambiare tutte le descrizioni, le aziende evitano decisioni basate solo sui p-value.
Consentire più esecuzioni dell’esperimento, ma con metodi di correzione
Abbiamo detto che eseguire lo stesso test (o test diversi) sugli stessi dati può portare a un risultato significativo per caso e, quindi, lo abbiamo considerato p-hacking. Ma in realtà ripetere lo stesso test sugli stessi dati più volte può essere una buona misura per prevenire e tenere a bada il p-hacking, se — e solo se — è combinato con metodi di correzione, ovvero tecniche statistiche che aggiustano per il fatto che si effettuano confronti multipli. I due metodi di correzione più comuni sono la correzione di Bonferroni e la procedura di Benjamini–Hochberg (BH).
La Bonferroni prevede di abbassare la soglia del p-value (il livello di significatività) dividendola per il numero di test eseguiti. Pur riducendo efficacemente la probabilità di falsi positivi, può essere eccessivamente conservativa, aumentando il rischio di falsi negativi.
Al contrario, la procedura BH è una delle tecniche di controllo del False Discovery Rate (FDR) che mirano a bilanciare la probabilità dei due tipi di errore. In breve, la BH ordina innanzitutto tutti i p-value dei test multipli dal più piccolo al più grande. Ogni p-value viene poi confrontato con una soglia che aumenta con il suo rango. Si identifica il p-value più grande che è ancora sotto la sua soglia e tutti i p-value fino a quel punto sono considerati significativi.
In un contesto business, se un’azienda testa diverse versioni di una landing page, è allettante eseguire molti A/B test e fermarsi quando una versione sembra andare significativamente meglio. Per evitarlo, l’analista può applicare correzioni per tenere conto dei test multipli. In questo modo si assicura che le evidenze significative non siano solo il risultato dei ripetuti tentativi.
Considerare i risultati non significativi
Infine, è importante riconoscere e riportare i risultati non significativi anziché scartarli. La comunità scientifica ha da tempo proposto di pubblicare esperimenti con risultati non significativi purché seguano una metodologia rigorosa e preregistrata, perché la scoperta di una non scoperta è pur sempre una scoperta! Una saggezza simile si applica nel business.
Per esempio, se una campagna marketing non ha un impatto significativo sulle vendite, un’azienda dovrebbe comunque riportare e considerare questo risultato. Fornisce informazioni preziose e impedisce un reporting distorto che potrebbe portare a decisioni aziendali ingiustificate. Essere aperti sui risultati non significativi contribuisce a un’analisi più onesta ed evita la tentazione di manipolare i dati per mostrare un successo.
Conclusione
In questo articolo abbiamo esplorato a fondo il mondo del p-hacking, dove il p-value può essere vulnerabile alla manipolazione. Abbiamo visto i vari p-hack, come possono essere rilevati e come possono essere prevenuti.
Come vedi, e come abbiamo detto, una parte fondamentale della consapevolezza sul p-hacking è possedere solide conoscenze statistiche. Puoi acquisirle tramite i nostri vari corsi di statistica, come il corso teorico Introduzione alla statistica, o i corsi pratici Introduzione alla statistica in Google Sheets, Introduzione alla statistica in Python e Introduzione alla statistica in R.