

कोर्स
Python में A/B Testing
4 घंटा
13.2K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंयदि आपने कभी अनुमानात्मक सांख्यिकी के साथ काम किया है, खासकर परिकल्पना परीक्षण और रिग्रेशन में, तो संभव है कि आपको p-वैल्यू से परिचय कराया गया हो। और यदि आपने p-वैल्यू के साथ काम किया है, तो आप शायद जानते हैं—या कम से कम अंदाज़ा लगाते हैं—कि p-वैल्यू संवेदनशील होते हैं और इनमें हेरफेर किया जा सकता है, और आप सही होंगे।
दरअसल, इस तरह के हेरफेर के लिए एक खास शब्द भी प्रचलित है—पी-हैकिंग। कभी‑कभी इसे डेटा ड्रेजिंग, डेटा स्नूपिंग, डेटा फिशिंग और इन्फ्लेशन बायस भी कहा जाता है। यह लेख इसी विषय में गहराई से उतरता है।
सबसे पहले, जल्दी से याद कर लें कि p-वैल्यू क्या है। p-वैल्यू में ‘p’ का अर्थ probability यानी संभावना है। विशेष रूप से, p-वैल्यू वह संभावना है कि शून्य परिकल्पना सही मानते हुए, हमें प्राप्त परिणामों जितने या उनसे भी अधिक चरम परिणाम देखने को मिलें। इस गलत अस्वीकृति को टाइप I त्रुटि या फॉल्स पॉज़िटिव त्रुटि भी कहा जाता है। आमतौर पर इसे महत्त्व स्तर (जिसे α से दर्शाया जाता है) से तुलना करने के लिए निकाला जाता है, जो शून्य परिकल्पना सही होते हुए भी उसे अस्वीकार करने की स्वीकृत संभावना होती है।
तार्किक रूप से, यदि p-वैल्यू महत्त्व स्तर से अधिक हो, तो हम शून्य परिकल्पना को अस्वीकार नहीं करते और उसी पर टिके रहते हैं। दूसरी ओर, यदि p-वैल्यू महत्त्व स्तर से कम या बराबर हो, तो हम वैकल्पिक परिकल्पना के पक्ष में शून्य परिकल्पना को अस्वीकार कर सकते हैं, और इस स्थिति में कहते हैं कि परिणाम सांख्यिकीय रूप से महत्वपूर्ण हैं।
यदि p-वैल्यू पर यह छोटा सा पुनर्स्मरण आपको समझ में नहीं आया, तो चिंतित न हों! आप हमारा Introduction to Statistics सैद्धांतिक पाठ्यक्रम ले सकते हैं और आवश्यक मूलभूत समझ जल्दी विकसित कर सकते हैं।
“सांख्यिकीय रूप से महत्वपूर्ण” परिणामों तक पहुँचना सफलता जैसा लगता है, और इसलिए लुभावना है। व्यवसाय में, इसका मतलब होगा कि आपके पास रिपोर्ट करने के लिए कुछ नया, रोचक या वांछनीय है। अकादमिक जगत में, आपने कुछ खोजा है और उसे जर्नल्स में प्रकाशित किया जा सकता है।
और चूँकि यह पूरे उत्साहजनक संसार की कुंजी है, डेटा प्रोफेशनल्स और शोधकर्ता अपने अध्ययनों के p-वैल्यू पर जरूरत से ज्यादा केंद्रित होने के लिए आकर्षित होते हैं और बाकी कुछ नहीं—यहाँ तक कि महत्त्व स्तर भी—पर ध्यान नहीं देते। और दशकों से सबसे आम तौर पर माना गया महत्त्व स्तर 0.05 रहा है, इसलिए यह कहना एक आसान परंपरा बन गई कि यदि आपका p-वैल्यू 0.05 से नीचे पहुँच गया है, तो तुरंत जश्न मनाने को तैयार हो जाइए।
इसके परिणामस्वरूप, कुछ शोधकर्ता p-वैल्यू को कृत्रिम रूप से कम करने वाली विधियों को अपनाकर—कभी जानबूझकर, पर अक्सर अनजाने में—पी-हैकिंग की गलती में पड़ जाते हैं, जबकि उचित परीक्षण इसके विपरीत दिखाता।
चाहे जानबूझकर हो या नहीं, कई तरह से चीजें गलत हो सकती हैं और पी-हैकिंग की ओर ले जा सकती हैं। जो तरीके पी-हैकिंग तक ले जाते हैं, उन्हें p-hacks कहा जा सकता है, और ये प्रयोगों के किसी भी चरण पर हो सकते हैं।
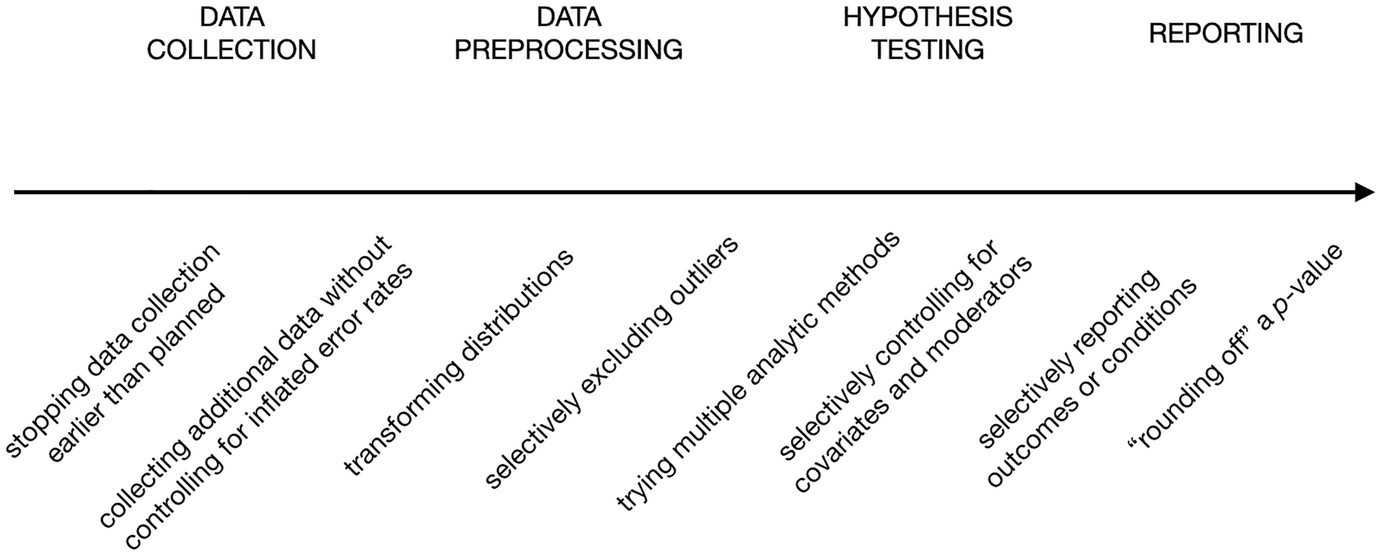
अपनी किताब के चैप्टर The Myriad Forms of p-Hacking में, डोरोता रीस और मॉल्टे फ्रीज़े ने प्रयोगों के विभिन्न चरणों—डेटा संग्रह से लेकर रिपोर्टिंग तक—में p-hacks की एक अपूर्ण सूची दी है, जिसे निम्नलिखित ग्राफ में दिखाया गया है।
p-hacks के उदाहरण। स्रोत: Avoiding Questionable Research Practices in Applied Psychology।
आइए बाएँ से दाएँ, प्रत्येक का अर्थ देखें:
ध्यान दें कि इन अधिकांश p-hacks में प्रयोग को बार‑बार चलाना शामिल है, और हर बार उन बातों से छेड़छाड़ करना जो प्रयोग के लिए पहले से तय आधार होनी चाहिए।
परंतु बिना किसी छेड़छाड़ के भी, एक ही प्रयोग को दोहराते रहना और केवल तब परिणाम रिपोर्ट करना जब वह सांख्यिकीय रूप से महत्वपूर्ण हो, p-hack हो सकता है, क्योंकि हमेशा संभावना रहती है कि कोई भी प्रयोग पर्याप्त बार चलाया जाए तो किसी समय कम p-वैल्यू लौटाए। नीचे का कॉमिक xkcd से इस विचार को दर्शाता है।
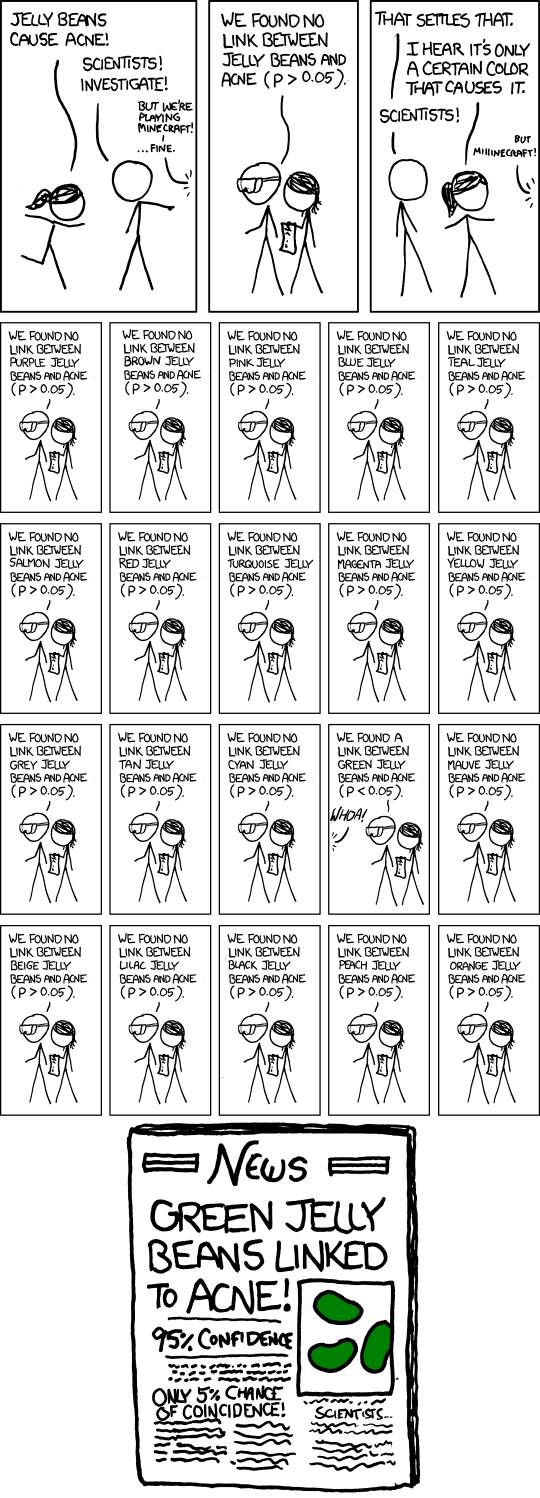
“Significant” कॉमिक। स्रोत: xkcd।
पी-हैकिंग काफी व्यापक परिघटना है। 2010 के शुरुआती वर्षों में, कई समीक्षा अध्ययनों ने पाया कि विभिन्न क्षेत्रों के प्रतिष्ठित जर्नलों में प्रकाशित शोध का बड़ा हिस्सा संभावित रूप से p-हैक्ड है—खासकर मनोविज्ञान और चिकित्सा में, लेकिन सामाजिक विज्ञान और मानविकी में भी।
उदाहरण के लिए, 2015 में वर्जीनिया विश्वविद्यालय के एक विद्वान द्वारा नेतृत्व किए गए अध्ययन ने 2008 में शीर्ष जर्नलों में प्रकाशित 100 मनोविज्ञान अध्ययनों की समीक्षा की और पाया कि इन अध्ययनों में से आधे से भी कम दोहराए जा सकते हैं। पुनरुत्पादकता की कमी का मतलब है कि अध्ययन दोबारा करने पर वही परिणाम नहीं देते—कभी‑कभी p-हैकिंग के कारण।
एक और परियोजना जिसने कैंसर अध्ययनों की जाँच की, पाया कि 193 में से केवल 50 प्रयोग दोहराए जा सकते हैं। इससे भी पहले, 2009 में, एक अध्ययन ने न्यूरोसाइंस में असामान्य रूप से उच्च सहसंबंधों की रिपोर्ट करने वाले प्रयोगों की संदिग्ध संख्या नोट की—जिनमें भावनाएँ, व्यक्तित्व, सामाजिक संज्ञान और fMRI के जरिए देखी गई मस्तिष्क गतिविधि शामिल थीं। इन प्रयोगों के लेखकों का सर्वेक्षण करने पर पता चला कि उन्होंने डेटा के उपसमुच्चयों को चयनात्मक रूप से चुनने की रणनीति अपनाई और केवल उन्हीं पर रिपोर्ट किया जो महत्त्वपूर्ण परिणाम दे रहे थे—एक p-hack जो हमारे पोस्ट-हॉक रिप्लेसमेंट के समान है।
इन समीक्षा अध्ययनों के निष्कर्षों ने उजागर किया कि p-हैकिंग, अन्य संदिग्ध शोध प्रथाओं के साथ मिलकर, लंबे समय से सम्मानित वैज्ञानिक शोध की नींव को अस्थिर और खोखला बना रही है। इस संकट को रिप्लिकेबिलिटी क्राइसिस कहा गया है, जो अब भी जारी है और इससे निकलने के लिए कई चर्चाएँ व प्रयास चल रहे हैं।
तो आखिर पी-हैकिंग समस्या क्यों है?
“P-hacking makes you a wizard”। स्रोत: SMBC Comics।
सवाल का जवाब बहुत स्पष्ट लग सकता है, लेकिन पी-हैकिंग क्यों गलत और अनैतिक है—इसके कारणों का विश्लेषण हमें “फर्जी महत्त्व” की समस्या के “महत्त्व” को बेहतर समझने में मदद करता है।
पी-हैकिंग मूलतः कार्यप्रणाली या परिणामों में हेरफेर का नतीजा है। यदि जानबूझकर किया जाए, तो यह बिना किसी उचित कारण केवल स्वार्थ (जैसे प्रकाशित होना या मान्यता पाना) के लिए झूठ बोलने जैसा है। यदि अनजाने में हो, तो यह गलत राह पर चलने और अंततः मृगतृष्णा जैसे फॉल्स पॉज़िटिव्स तक पहुँचने जैसा है।
वैज्ञानिक क्षेत्र हो या व्यवसाय, प्रयोगों के परिणाम होते हैं। इन्हें निर्णय लेने या आगे इनके आधार पर निर्माण करने के लिए किया जाता है। यदि प्रयोगों के परिणाम गढ़े गए हों, तो उन पर निर्भर निर्णय निराधार होंगे और कभी‑कभी विनाशकारी परिणाम ला सकते हैं।
उदाहरण के लिए, ऑन्कोलॉजी और न्यूरोलॉजी जैसे संवेदनशील क्षेत्रों में शोध सामूहिक रूप से उपचारों और दवाओं के विकास में योगदान दे सकता है। यदि कुछ बुनियादी शोध में हेरफेर किया गया हो, तो यह आपदा होगी।
व्यवसाय में, गलत निर्णय कई दिशाओं में जा सकते हैं—असफल उत्पाद लॉन्च करना, संसाधनों को बर्बाद करना, किसी को नौकरी से निकालना, यहाँ तक कि दिवालियापन तक। एक साधारण p-hack तितली प्रभाव पैदा कर सकता है।
रिप्लिकेबिलिटी क्राइसिस ने व्यापक संदेहवाद को जन्म दिया है—पूरे विज्ञान के प्रति—जो राजनीतिक विमर्श तक में व्यक्त हुआ है। यद्यपि आलोचनात्मक सोच वैज्ञानिक निष्कर्ष प्राप्त करते समय भी उपयोगी होती है, पर हर अनुभवजन्य निष्कर्ष को खारिज करना अज्ञान और निराधार निर्णयों के निराशाजनक दौर में ले जा सकता है।
व्यवसाय में, छोटे पैमाने पर, पी-हैकिंग और इसी तरह की संदिग्ध प्रथाएँ व्यावसायिक नेताओं को डेटा-आधारित निर्णयों से हटाकर केवल अनुमान और अंतर्ज्ञान पर लौटने को मजबूर कर सकती हैं—जो डेटा साइंस के पूरे क्षेत्र के वादे और वास्तविक क्षमता के ठीक विपरीत है।
मानव ज्ञान अपनी संचयी प्रकृति पर आधारित है। हर छोटा प्रयोग एक निर्माण खंड है जो बड़े ज्ञान ढाँचे का मार्ग प्रशस्त करता है। जब ऐसे निर्माण खंडों की बढ़ती संख्या p-हैकिंग जैसी संदिग्ध प्रथाओं के कारण डगमगाने लगती है, तो ऐसी संचिति की क्षमता पर विपत्ति आती है। यहाँ तक कि नए प्रयोग के लिए पूर्ववर्ती साहित्य ढूँढ़ने का सरल काम भी बारूदी सुरंगों के मैदान में रास्ता बनाने जैसा पेचीदा बन जाता है।
अब तक जो हम पी-हैकिंग और उसकी विधियों के बारे में जानते हैं, उसके आधार पर हम कुछ रेड फ्लैग्स निकाल सकते हैं जो p-hacks का पता लगाने में मदद कर सकते हैं। इन अधिकांश संकेतों को नोटिस करने के लिए जिज्ञासु मन, आलोचनात्मक सोच और आत्मनिरीक्षण की नज़र चाहिए। कुछ मामलों में व्यापक डोमेन ज्ञान पर भी निर्भरता होती है।
सनसनीखेज प्रयोग परिणाम बिना शक की गुंजाइश के लेने लायक नहीं होते। आमतौर पर प्रेस और सोशल मीडिया इन्हें लपक लेते हैं—जैसे “चॉकलेट वजन कम कर सकती है” जैसी घोषणाएँ—जो सहज ही संदेहास्पद लगती हैं।
व्यवसाय में, किसी छोटे फीचर से वेबसाइट के मुनाफे में 100% वृद्धि का वादा करने वाला परीक्षण भी समान रूप से सनसनीखेज माना जा सकता है।
ऐसे अध्ययनों से टकराएँ, और यदि वे आपके लिए मायने रखते हैं, तो निष्कर्ष स्वीकार करने से पहले हमेशा कार्यप्रणाली और परिणामों की दोबारा जाँच करें।
ऐसे प्रयोगों से सावधान रहें जो अपनी कार्यप्रणाली पर स्पष्ट न हों या जिनमें कुछ घटकों की घोषणा न की गई हो। प्रारंभिक परिकल्पनाएँ, महत्त्व स्तर, नमूना आकार, एकत्रित चर, चुने गए परीक्षण का प्रकार और डेटा तैयारी के चरणों पर खुलापन, सुदृढ़ वैज्ञानिक प्रक्रिया के लिए आवश्यक है। इनमें से किसी भी घटक पर अस्पष्टता एक रेड फ्लैग है।
यदि प्रयोग की डेटा तैयारी में चर का रूपांतरण शामिल है, तो उसके पीछे के कारण की जाँच करें—औचित्य घोषित होना चाहिए। यदि न हो, या अविश्वसनीय हो, तो यह पी-हैकिंग का सीधा संकेत हो सकता है।
छोटा नमूना आकार अध्ययन की सांख्यिकीय शक्ति को कम करता है, जिससे फॉल्स नेगेटिव का जोखिम बढ़ता है। हालाँकि, चयनात्मक रिपोर्टिंग या पी-हैकिंग के साथ मिलकर, कम शक्ति वाले अध्ययन प्रकाशित साहित्य में फॉल्स पॉज़िटिव की उच्च दर में भी योगदान कर सकते हैं।
कुछ क्षेत्रों में, छोटे नमूना आकार स्वीकार्य और सामान्य होते हैं, जैसे क्लिनिकल रिसर्च, पर्यावरणीय अध्ययन, इंजीनियरिंग और क्वालिटी कंट्रोल। पर सामान्यतः, बड़े नमूना आकार बेहतर अनुमान तक ले जाते हैं और इस प्रकार फॉल्स पॉज़िटिव व अवास्तविक महत्त्वपूर्ण p-वैल्यू की संभावना कम होती है।
किसी भी स्थिति में, यदि छोटे नमूना आकार का औचित्य न दिया गया हो, तो यह सांख्यिकीय शक्ति की कमी का संकेत हो सकता है, जो फॉल्स पॉज़िटिव के जोखिम को बढ़ाता है। कुछ मामलों में यह शुरुआती रोक (early stopping) का भी संकेत दे सकता है—वह खास p-hack जिसका ऊपर उल्लेख हुआ—जहाँ डेटा संग्रह नियोजित नमूना आकार पूरा होने के बजाय, महत्त्व मिलते ही रोक दिया जाता है।
इफेक्ट साइज (प्रभाव आकार) चर के बीच संबंध की शक्ति या परिमाण को मापता है और परिणाम की सांख्यिकीय महत्त्वता को संदर्भ देता है। यदि कोई अध्ययन केवल सांख्यिकीय महत्त्व की रिपोर्ट करे पर स्पष्ट या सार्थक प्रभाव आकार न दे, तो शंका उठती है।
p-वैल्यू यह दिखा सकता है कि परिणाम संयोग से होने की संभावना कम है, पर प्रभाव आकार के बिना निष्कर्षों का व्यावहारिक महत्त्व तय करना मुश्किल है। p-हैक्ड अध्ययनों में प्रभाव आकार पर अस्पष्टता यह संकेत दे सकती है कि शोधकर्ताओं ने सांख्यिकीय महत्त्व प्राप्त करने पर ही अत्यधिक ध्यान दिया, अन्य बातों की परवाह किए बिना।
जब किसी अध्ययन के परिणाम मूल परिकल्पना से काफी अलग हों, तो प्रश्न उठने चाहिए। यह संकेत हो सकता है कि शोधकर्ताओं ने परिणामों के अनुरूप परिकल्पना या विधियाँ एकत्रीकरण के बाद बदलीं—एक प्रथा जिसे HARKing (Hypothesizing After Results are Known) कहा जाता है।
उदाहरण के लिए, यदि कोई प्रयोग किसी विशिष्ट परिकल्पना के परीक्षण का दावा करता है, पर अंतिम विश्लेषण असंबंधित चर या निष्कर्षों पर केंद्रित दिखे, तो यह पी-हैकिंग का संकेत हो सकता है। हमेशा घोषित परिकल्पना की अंतिम परिणामों से तुलना करें ताकि वे सुसंगत हों।
असामान्य रूप से बड़ा प्रभाव आकार p-हैकिंग का रेड फ्लैग हो सकता है। कई मामलों में, वास्तविक दुनिया के प्रभाव छोटे से मध्यम होते हैं—खासकर मनोविज्ञान, चिकित्सा या सामाजिक विज्ञान में। जैसे उचित नमूना आकार का आकलन, प्रभाव आकार की यथार्थता समझना भी गहन डोमेन विशेषज्ञता माँगता है।
यदि कोई अध्ययन असामान्य रूप से बड़े प्रभाव आकार की रिपोर्ट करता है, तो संकेत हो सकता है कि डेटा चयनात्मक रूप से बदला गया है या नमूना किसी प्रकार से पक्षपाती है। शोधकर्ता जानबूझकर या अनजाने में ऐसे डेटा को हटा सकते हैं जो प्रभाव आकार घटा दे—ताकि निष्कर्ष वास्तविक से अधिक प्रभावशाली दिखें (पोस्ट-हॉक रिप्लेसमेंट p-hack)।
जब रिपोर्ट किया गया p-वैल्यू महत्त्व सीमा से बस थोड़ा नीचे हो (जैसे p = 0.049 जबकि सीमा p < 0.05 है), तो संकेत हो सकता है कि शोधकर्ताओं ने p-हैकिंग की है।
क्योंकि परीक्षणों को बार‑बार चलाना या चरों में हेरफेर करना, संयोगवश ऐसा परिणाम दे सकता है जो बस सीमा के पार चला जाए। बार‑बार सीमारेखा के ठीक नीचे टिके रहने वाले परिणामों का पैटर्न संकेत देता है कि शोधकर्ताओं ने महत्त्व प्राप्त करते ही डेटा संग्रह रोक दिया (early stopping) या कुछ विश्लेषणों को ही चयनात्मक रूप से रिपोर्ट किया (पोस्ट-हॉक रिप्लेसमेंट)।
पी-हैकिंग का सबसे प्रबल संकेत तब होता है जब किसी अध्ययन के निष्कर्ष दोहराए नहीं जा सकते। यदि स्वतंत्र शोधकर्ता वही कार्यप्रणाली अपनाकर परिणामों को दोहरा नहीं पाते, तो संकेत हो सकता है कि मूल निष्कर्ष p-हैकिंग या चयनात्मक रिपोर्टिंग का परिणाम थे।
प्रतिकृत्यता वैज्ञानिक अखंडता का आधारशिला है, और जो परिणाम निरंतर रूप से पुन:उत्पादित नहीं हो पाते, वे दर्शाते हैं कि मूल विश्लेषण त्रुटिपूर्ण या हेरफेर किया हुआ हो सकता है।
उपरोक्त रेड फ्लैग्स को उलटकर, हम पी-हैकिंग को रोकने के तरीके भी निकाल सकते हैं। पिछले दशक में वैज्ञानिक समुदाय में चल रही चर्चाओं में, रिप्लिकेबिलिटी क्राइसिस के जवाब में ऐसे तरीकों पर जोर बढ़ा है।
पी-हैकिंग रोकने के लिए सांख्यिकीय सिद्धांतों की ठोस समझ आवश्यक है। जब विश्लेषकों के पास आवश्यक ज्ञान होता है, तो वे आम जालों से बचने में सक्षम होते हैं—जैसे p-वैल्यू की गलत व्याख्या या मल्टीपल कम्पेरिज़न्स का अनुचित प्रबंधन।
उदाहरण के लिए, किसी वेबसाइट फीचर के A/B परीक्षण में, समझदार विश्लेषक जानता है कि p-वैल्यू अंतिम लक्ष्य नहीं है; भले ही परीक्षण में p-वैल्यू कम आए, प्रभाव आकार पर्याप्त बड़ा न हो सकता है और इस प्रकार व्यावहारिक महत्त्व न निकले। सांख्यिकीय और व्यावहारिक महत्त्व के अंतर को समझना विश्लेषकों को p-वैल्यू पर अति‑केन्द्रण से बचाता है—जो p-hacking की ओर ले जा सकता है—और इस तरह अधिक अनुकूल परिणाम के लिए परिणामों में हेरफेर की संभावना घटती है।
वैज्ञानिक शोध में पूर्व-पंजीकरण का अर्थ है, डेटा एकत्र करने से पहले शोध या परीक्षण योजना—परिकल्पनाएँ, विधियाँ और विश्लेषण तकनीकें—का खाका बनाना। यह प्रक्रिया विश्लेषण कैसे किया जाएगा, इस पर फैसलों को पहले से तय कर देती है, जिससे पोस्ट-हॉक बदलाव द्वारा महत्त्वपूर्ण परिणाम “निकालने” की गुंजाइश कम हो जाती है।
व्यवसाय में, डेटा टीमों के स्तर पर समान प्रथाएँ अपनाई जा सकती हैं। उदाहरण के लिए, नए प्राइसिंग मॉडल के प्रभाव को मापने के लिए प्रयोग चलाने से पहले, टीम परिकल्पना का पूर्व‑दस्तावेजीकरण और आंतरिक घोषणा कर सकती है—कौन से चर (जैसे राजस्व, ग्राहक अधिग्रहण दर) जाँचे जाएँगे, महत्त्व स्तर क्या होगा, नमूना आकार कितना होगा। इससे टीम मूल योजना पर टिकी रहती है और शुरुआती परिणाम देखकर विश्लेषण को बदलने से बचती है—पोस्ट-हॉक रिप्लेसमेंट व चेरी‑पिकिंग जैसी प्रथाओं से दूर रहते हुए।
ओपन साइंस का अर्थ है डेटा, विधियाँ और विश्लेषण को दूसरों के लिए समीक्षा और पुनरुत्पादन हेतु उपलब्ध कराना। व्यवसाय में, भले “ओपन साइंस” शब्द सीधे न इस्तेमाल हो, पर इसी तरह की पारदर्शिता विश्लेषण की अखंडता सुनिश्चित करने के लिए महत्त्वपूर्ण है।
उदाहरण के लिए, कोई कंपनी अपने बाज़ार विश्लेषण का कच्चा डेटा और विश्लेषण चरणों को आंतरिक रूप से अन्य टीमों, लेखा परीक्षकों या संबंधित हितधारकों के साथ साझा कर सकती है, या भविष्य में पुनरुत्पादन के लिए व्यवस्थित रूप से दस्तावेजीकृत कर सकती है। यह पारदर्शिता p-हैकिंग को हतोत्साहित करती है क्योंकि कोई भी कार्यप्रणाली में विसंगतियाँ या खामियाँ जाँच सकता है। किसी संगठन में तरीकों और परिणामों पर खुलापन जवाबदेही को बढ़ाता है और सुनिश्चित करता है कि निष्कर्ष ठोस, पुनरुत्पादनीय डेटा पर आधारित हों।
डेटा तैयारी और रूपांतरण के चरणों का हमेशा ठोस औचित्य होना चाहिए। स्पष्ट औचित्य के बिना आउटलायर हटाना या चर का रूपांतरण, परिणामों में हेरफेर कर गलत कथा गढ़ने के लिए इस्तेमाल हो सकता है।
उदाहरण के लिए, ग्राहक खरीद डेटा का विश्लेषण करते समय, कोई विश्लेषक कुछ डेटा बिंदुओं (जैसे अतिवादी आउटलायर) को हटा सकता है जो मॉडल में फ़िट नहीं होते दिखते। परंतु यदि वैध कारण—जैसे उन्हें सामान्य वितरण का हिस्सा न होकर वास्तविक विसंगति सिद्ध करना—न दिया जाए, तो यह पी-हैकिंग का रूप हो सकता है। इसे रोकने के लिए, हर डेटा तैयारी चरण (जैसे कुछ समयावधि को निकालना या लॉग रूपांतरण लगाना) विश्लेषण रिपोर्ट में स्पष्ट रूप से औचित्य सहित दर्ज होना चाहिए—ताकि पारदर्शिता बनी रहे।
सांख्यिकीय महत्त्व से आगे बढ़कर प्रभाव आकार की रिपोर्टिंग और व्याख्या करना आवश्यक है। इससे सुनिश्चित होता है कि परिणाम व्यावहारिक रूप से सार्थक हैं और केवल बड़े नमूना आकार के कारण सांख्यिकीय महत्त्व पर सवार नहीं हैं।
व्यवसाय में, मान लें कि किसी A/B परीक्षण में नई उत्पाद विवरणिका से कन्वर्ज़न रेट 0.5% बढ़ता है, और नमूना आकार इतना बड़ा है कि परिणाम सांख्यिकीय रूप से महत्त्वपूर्ण हो जाता है। संदर्भ के बिना इसे सार्थक समझ लिया जा सकता है। पर प्रभाव आकार पर ध्यान देकर—और यह पूछकर कि क्या 0.5% वृद्धि सभी विवरणिकाएँ बदलने की लागत को उचित ठहराती है—कंपनियाँ केवल p-वैल्यू के आधार पर निर्णय लेने से बच सकती हैं।
हमने कहा कि एक ही डेटा पर एक ही (या अलग) परीक्षणों को कई बार चलाना संयोग से महत्त्वपूर्ण परिणाम लौटा सकता है, और इसलिए इसे p-hack माना। पर वास्तव में, यदि—और केवल यदि—इसे सुधार विधियों के साथ जोड़ा जाए, तो एक ही डेटा पर कई बार परीक्षण चलाना पी-हैकिंग से सतर्क रहने और उसे रोकने का अच्छा उपाय हो सकता है। ये सांख्यिकीय तकनीकें इस तथ्य के लिए समायोजन करती हैं कि कई तुलनाएँ की जा रही हैं। दो सबसे आम सुधार विधियाँ हैं—बॉनफेरोनी करेक्शन और बेनजामिनी‑होचबर्ग (BH) प्रक्रिया।
बॉनफेरोनी में p-वैल्यू थ्रेशहोल्ड (महत्त्व स्तर) को नीचे समायोजित करना शामिल है—इसे किए गए परीक्षणों की संख्या से विभाजित करके। जबकि यह फॉल्स पॉज़िटिव की संभावना घटाने में प्रभावी है, यह अत्यधिक रूढ़िवादी हो सकता है और फॉल्स नेगेटिव की संभावना बढ़ा सकता है।
इसके विपरीत, BH प्रक्रिया फॉल्स डिस्कवरी रेट (FDR) नियंत्रण तकनीकों में से एक है, जो दोनों प्रकार की त्रुटियों की संभावना के बीच संतुलन साधने का प्रयास करती है। संक्षेप में, BH प्रक्रिया पहले कई परीक्षणों से प्राप्त सभी p-वैल्यू को छोटे से बड़े क्रम में रैंक करती है। फिर प्रत्येक p-वैल्यू की तुलना उसके रैंक के साथ बढ़ने वाली सीमा से होती है। जो सबसे बड़ा p-वैल्यू अपनी सीमा से नीचे होता है, उसकी पहचान की जाती है और उस बिंदु तक के सभी p-वैल्यू को महत्त्वपूर्ण माना जाता है।
व्यवसायिक संदर्भ में, यदि कोई कंपनी लैंडिंग पेज के कई संस्करण जाँच रही है, तो कई A/B परीक्षण चलाना और जब कोई संस्करण महत्त्वपूर्ण रूप से बेहतर दिखे तो रुक जाना लुभावना हो सकता है। इससे बचने के लिए, विश्लेषक कई परीक्षणों के लिए करेक्शन लागू कर सकता है। ऐसा करने से सुनिश्चित होता है कि कोई भी महत्त्वपूर्ण निष्कर्ष केवल बार‑बार परीक्षण के कारण नहीं है।
अंततः, गैर‑महत्त्वपूर्ण परिणामों को नज़रअंदाज़ करने के बजाय उन्हें स्वीकारना और रिपोर्ट करना आवश्यक है। वैज्ञानिक समुदाय में ऐसी माँगें उठी हैं कि जब तक कठोर पूर्व‑पंजीकृत कार्यप्रणाली का पालन किया गया हो, तब तक गैर‑महत्त्वपूर्ण परिणामों वाले प्रयोगों के प्रकाशन की अनुमति हो—क्योंकि “कोई निष्कर्ष न मिलना” भी एक निष्कर्ष हो सकता है! व्यवसाय में भी इसी समझदारी का पालन किया जा सकता है।
उदाहरण के लिए, यदि कोई मार्केटिंग अभियान बिक्री पर महत्त्वपूर्ण प्रभाव नहीं डालता, तो कंपनी को फिर भी इस खोज की रिपोर्ट और समीक्षा करनी चाहिए। यह मूल्यवान जानकारी देती है और पक्षपाती रिपोर्टिंग से बचाती है, जो निराधार व्यवसायिक निर्णयों तक ले जा सकती है। गैर‑महत्त्वपूर्ण परिणामों के प्रति खुला रहना अधिक ईमानदार विश्लेषण में योगदान देता है और मात्र “सफलता दिखाने” के लिए डेटा में हेरफेर के प्रलोभन से बचाता है।
इस लेख में, हमने पी-हैकिंग की दुनिया को गहराई से समझा—जहाँ p-वैल्यू में हेरफेर की गुंजाइश होती है। हमने विभिन्न p-hacks, उनका पता कैसे लगाएँ और उन्हें कैसे रोकें—इन सभी पर नज़र डाली।
जैसा कि आपने देखा, और जैसा हमने कहा, पी-हैकिंग के प्रति जागरूक रहने का बड़ा हिस्सा ठोस सांख्यिकीय ज्ञान पर निर्भर है। आप यह हमारे विभिन्न सांख्यिकी पाठ्यक्रमों के माध्यम से हासिल कर सकते हैं—जैसे हमारा सैद्धांतिक Introduction to Statistics, या हमारे व्यवहारिक कोर्स Introduction to Statistics in Google sheets, Introduction to Statistics in Python और Introduction to Statistics in R।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें