课程
Python 中的时间序列机器学习
4 小时
54.3K
时间是数据分析中的基本维度。随着时间推移,数值可能波动、呈现趋势或保持稳定。当我们分析数据随时间的演变时,我们就在处理时间序列。
时间序列分析中的一项常见任务是调整数据中日期和时间的频率,这一技术称为重采样。在本教程中,我们将使用功能强大的 Pandas 库来直观、高效地处理时间序列。
我们将从基础开始,逐步深入到更高级的重采样技术。我们会提供实用示例并分享最佳实践,确保时间序列分析既有效又高效。
如果您想进一步了解时间序列,请查看这门关于在 Python 中操作时间序列数据的课程。
与按照类别对数据进行分组类似,重采样允许我们将数据按不同的时间间隔进行分组。这对于数据清洗和深入的时间序列分析都很有价值。例如,在比较两条时间序列之前,我们可能需要将它们对齐到相同的频率。
重采样主要有两种类型:
我们可以通过 pandas 的两种主要方法进行重采样:.asfreq() 和 .resample()。
要开始使用这些方法,首先需要按惯例导入别名为 pd 的 pandas 库。我们还将导入 matplotlib 来可视化结果。
import pandas as pd
import matplotlib.pyplot as plt
先从 .asfreq() 方法开始。该方法将时间序列转换为指定频率,并返回与该频率的新索引对齐的原始数据。
我们将使用一个包含马德里 1997 至 2015 年每日气温读数的数据集。在进行重采样之前,先做一些预处理步骤。
url = 'https://raw.githubusercontent.com/jcanalesluna/courses_materials/master/datasets/Madrid%20Daily%20Weather%201997-2015.csv'
df = pd.read_csv(url, usecols=['CET', 'Max TemperatureC', 'Mean TemperatureC', 'Min TemperatureC'])

# Change column names
df.columns = ['time', 'max_temp', 'mean_temp', 'min_temp']

# Convert string column to datetime
df['time'] = pd.to_datetime(df['time'])

# Set time column as index
df = df.set_index('time')

df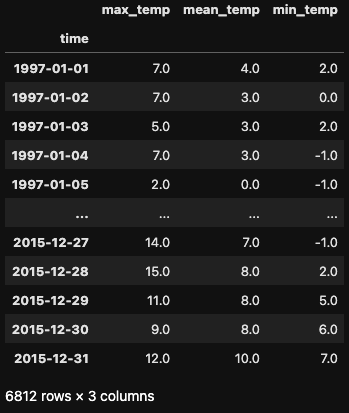
为了说明上采样,假设我们想将每日气温读数转换为每小时读数。我们可以使用 .asfreq() 方法,并设置参数 freq='H' 来实现。
df_hour = df.asfreq('H')
df_hour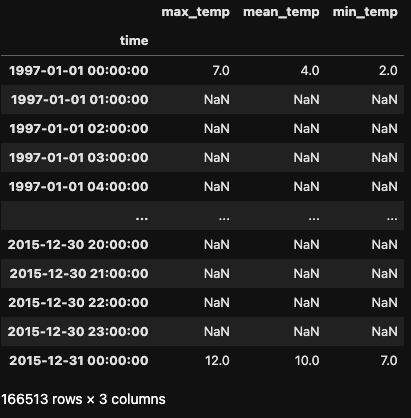
得到的数据集明显更大,因为新增了按小时而非按日的行。默认情况下,.asfreq() 会取原始索引中的第一个条目,并将其余小时填充为空值。
结果数据集会大得多,因为创建了按小时而非按日的数据行。默认情况下,.asfreq() 会取原始索引中的第一个条目,并为其余小时创建空值。
Pandas 提供三种策略来填充这些空值:
ffill):将最后一个有效观测值向前传播。bfill):使用下一个有效观测值来填补空缺。前两种策略通过 .asfreq() 方法的 method 参数实现,而指定填充值则通过 fill_value 参数设置。
df_mean_temp = df[['mean_temp']]
df_mean_temp_hour= df_mean_temp.asfreq('H')

df_mean_temp_hour['ffill'] = df_mean_temp.asfreq('H', method='ffill')
df_mean_temp_hour['bfill'] = df_mean_temp.asfreq('H', method='bfill')
df_mean_temp_hour['value'] = df_mean_temp.asfreq('H', fill_value=0)
df_mean_temp_hour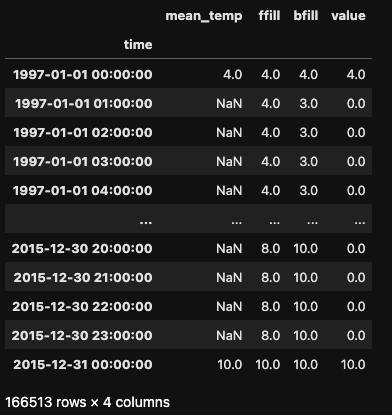
接下来看看下采样。假设我们想将每日频率改为月度频率。我们可以使用 .asfreq() 并设置参数 freq='M' 来完成。
在这种情况下,我们将数据频率从每日降低到每月。与原始 DataFrame 的 6,812 行相比,得到的 DataFrame 只有 228 行。
df_month = df.asfreq(freq='M')
df_month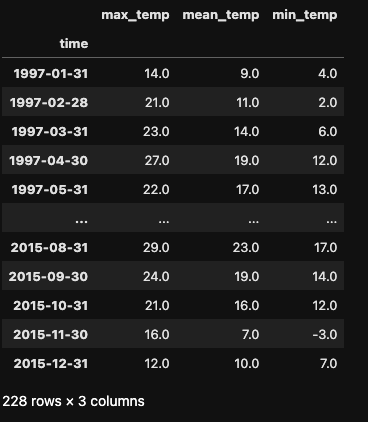
请注意,.asfreq() 只是选择每个月的最后一天,并用该日的数值代表整个月。它不会执行任何聚合(例如计算月平均气温)。要进行这类聚合,我们将在下一节使用 .resample() 方法。
虽然 .asfreq() 便于以不同频率展示时间序列数据,但当需要在重采样的同时进行聚合时,.resample() 才是首选工具。
.resample() 的工作方式与 .groupby() 类似:它在指定时间间隔内对数据进行分组,然后对每个分组应用一个或多个函数。这些函数的结果会被分配到该区间内的一个新日期上。
我们既可以使用 .resample() 进行上采样(填充或插值缺失数据),也可以进行下采样(聚合数据)。
让我们回到按小时转换的例子,看看使用 .resample() 如何进行上采样。调用 .resample() 会返回一个 Resampler 对象,我们随后可以再调用其他方法以获得一个 DataFrame。
print(df.resample('H'))DatetimeIndexResampler [freq=<Hour>, axis=0, closed=left, label=left, convention=start, origin=start_day]关于上采样,.resample() 可以完成与 .asfreq() 相同的任务。
df.mean_temp.resample('H').asfreq()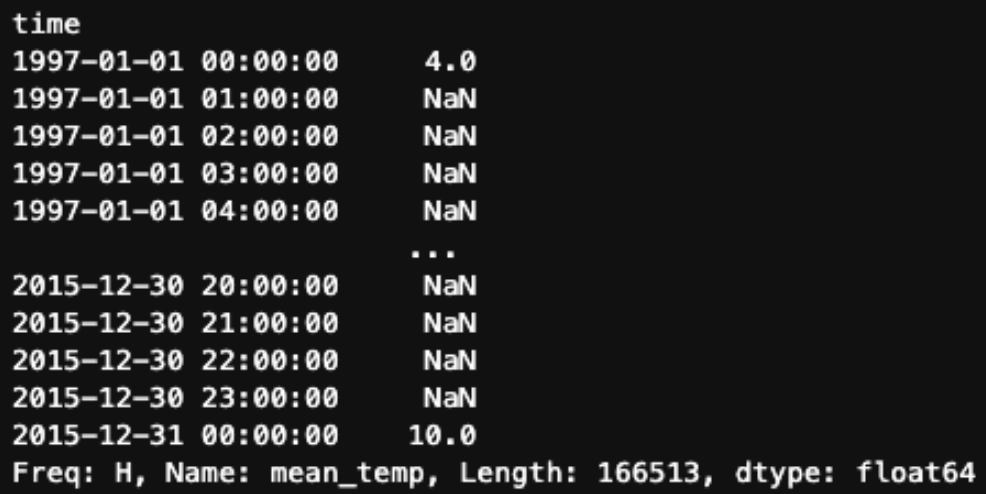
我们也可以应用与 .asfreq() 相同的填充与插值策略。例如,使用向前填充:
df.mean_temp.resample('H').ffill()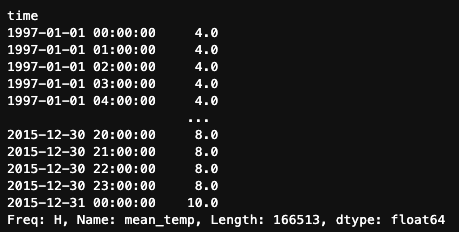
但 .resample() 还提供了 .asfreq() 不具备的其他方法。例如,我们可以使用 .interpolate() 方法,它通过在现有数据点之间连成直线来估计新时间点的值。
df.mean_temp.resample('H').interpolate()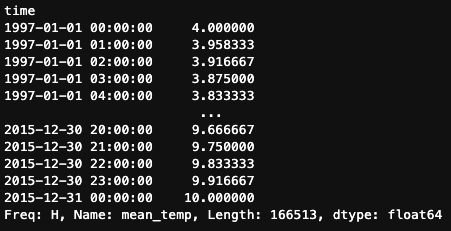
.resample() 在下采样方面尤为出色,因为它允许我们应用多种聚合方法来汇总数据。比如,让我们使用 .resample() 分别计算马德里气温的月平均值和季度中位数。
df.mean_temp.resample('M').mean()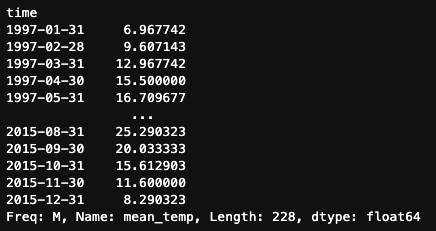
df.mean_temp.resample('Q').median()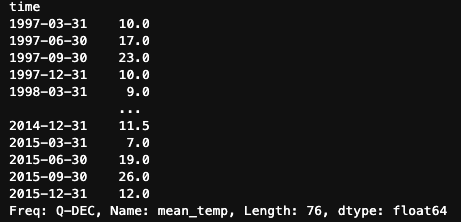
除了我们已经介绍的基础操作外,Pandas 的重采样方法还可以处理更复杂的场景。下面来看看一些最常见的用法。
重采样允许我们按照特定需求创建具有定制频率的新时间序列。常用频率包括:
W:每周频率(以周日结束)M:月末频率Q:季末频率H:每小时频率不过,根据需求,Pandas 还提供了更多选项。我们可以基于起始或结束日期定义频率,使用工作日而非日历日,甚至创建完全自定义的频率。
df.mean_temp.resample('M').mean() # calendar month end
df.mean_temp.resample('MS').mean() # calendar month start
df.mean_temp.resample('BM').mean() # business calendar end
df.mean_temp.resample('BMS').mean() # business calendar start与 groupby() 方法类似,.resample() 允许我们同时应用多种聚合。可以使用 .agg() 方法并传入一个聚合函数列表,例如 mean、median 和 standard deviation。
df.mean_temp.resample('M').agg(['mean','median','std'])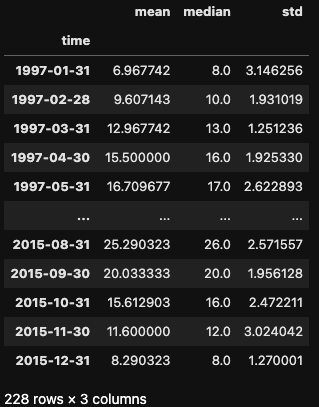
Pandas 在处理大型数据集方面有高度优化,但随着 DataFrame 规模的增长,处理与操作的计算开销也会增加,尤其是在上采样过程中。想象一下将每小时的时间序列重采样到每秒——得到的 DataFrame 可能会非常庞大!
如果在大型数据集上遇到性能问题,可以采用以下策略:
幸运的是,pandas 2.0 及更高版本引入了更高效的处理技术。您可以在这篇关于 Pandas 2.0 的文章中了解更多。
重采样是时间序列分析中的基础技术,它通过聚合(下采样)或插值(上采样)来调整数据的频率。我们已经了解 pandas 如何提供 .asfreq() 和 .resample() 等强大工具,使这一过程直观且高效。
若想加深对 Python 中重采样与时间序列处理的理解,请参考以下资源:
通过这些课程深入学习时间序列!
课程
课程
课程